
Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
11.1K
Kimi K2.7 Code è il modello di punta per il coding di Moonshot, pensato per attività pratiche di sviluppo software come scrivere e fare debug del codice, orientarsi in codebase estese e gestire lavori di ingegneria multi‑step.
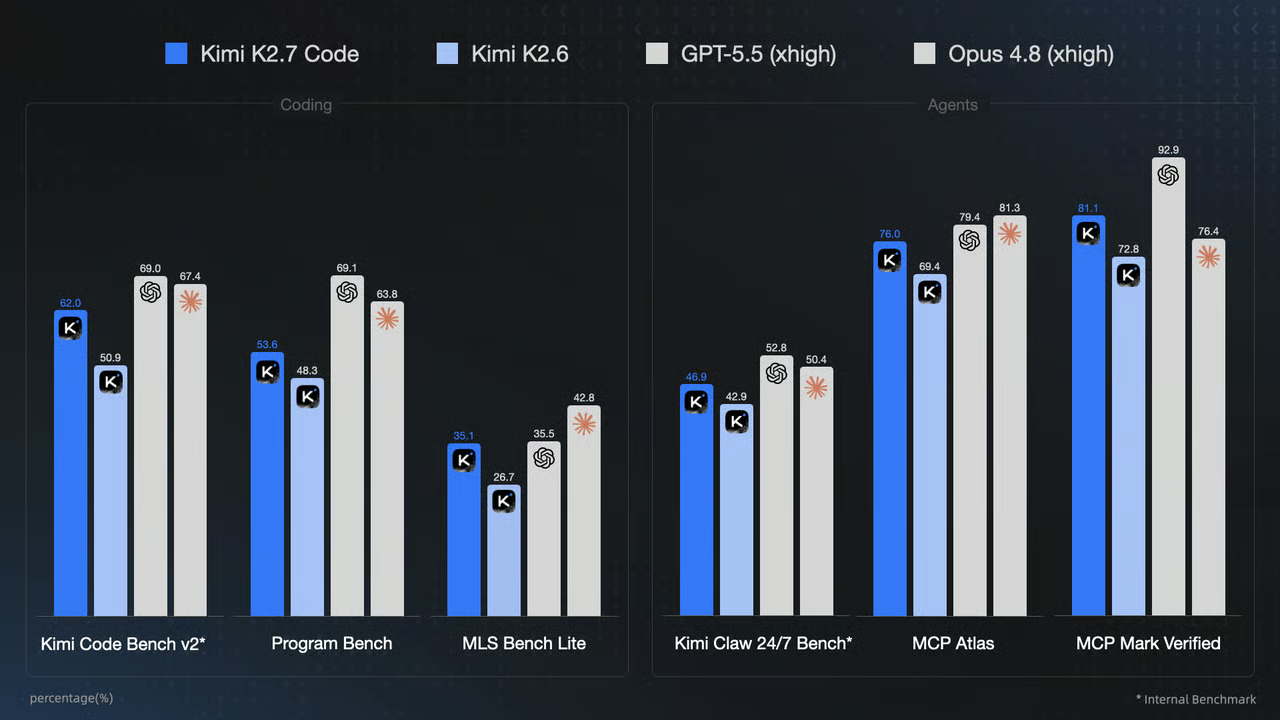
Fonte: Kimi K2.7 Code: Open-Source Agentic Coding Model
Abbinato a Pi, un agente di coding leggero e altamente estensibile, crea un ambiente di sviluppo locale flessibile che supporta skill, pacchetti, tool da riga di comando, memoria persistente e test del browser senza aggiungere complessità inutile.
Invece di installare un MCP per ogni attività, Pi può combinare il ragionamento di Kimi con strumenti affidabili per sviluppatori come GitHub CLI, Vercel CLI, Hugging Face CLI, pytest, Ruff e uv.
Questo rende possibile ricercare, costruire, testare, distribuire e mantenere progetti reali da un unico workflow agentico per il coding.
In questa guida ti mostro come configurare Kimi K2.7 Code con Pi dall’inizio alla fine.
Configurerai la tua chiave API Moonshot, aggiungerai Olostep per la ricerca, Context7 per la documentazione aggiornata, Webwright per i test del browser e Hermes Memory per il contesto tra sessioni.
Installerai anche temi e skill di ingegneria utili, collegherai CLI pratiche per GitHub, Vercel e Hugging Face, creerai un progetto Python di data science riproducibile e testerai l’intero workflow costruendo, validando e pubblicando una piccola applicazione di machine learning.
Ti consiglio anche la mia guida su come eseguire Kimi K2.7 Code in locale.
Pi è un agente di coding leggero che gira direttamente nel tuo terminale.
Può lavorare con i file locali, eseguire comandi, usare skill e pacchetti installati e connettersi al tuo modello di coding preferito.
Scegli il comando di installazione per il tuo sistema operativo.
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS o Linux
curl -fsSL https://pi.dev/install.sh | shPuoi anche installare Pi tramite npm:
npm install -g --ignore-scripts @earendil-works/pi-coding-agentPrima di usare Kimi K2.7 Code in Pi, aggiungi la tua chiave API Moonshot come variabile d’ambiente.
Pi potrà così accedervi automaticamente quando selezioni Moonshot come provider del modello.
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"Chiudi e riapri PowerShell dopo aver eseguito questo comando. La nuova variabile d’ambiente sarà disponibile solo nelle nuove sessioni del terminale.
Git Bash, macOS o Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"Questo comando vale solo per la sessione del terminale corrente. Per mantenere la chiave disponibile dopo il riavvio del terminale, aggiungi la stessa riga al profilo della tua shell, ad esempio ~/.bashrc o ~/.zshrc.
Tieni privata la tua chiave API. Non aggiungerla a repository Git, notebook pubblici, screenshot, file .env.example o AGENTS.md.
Una volta impostata la chiave, avvia Pi:
piPoi apri il selettore dei modelli:
/model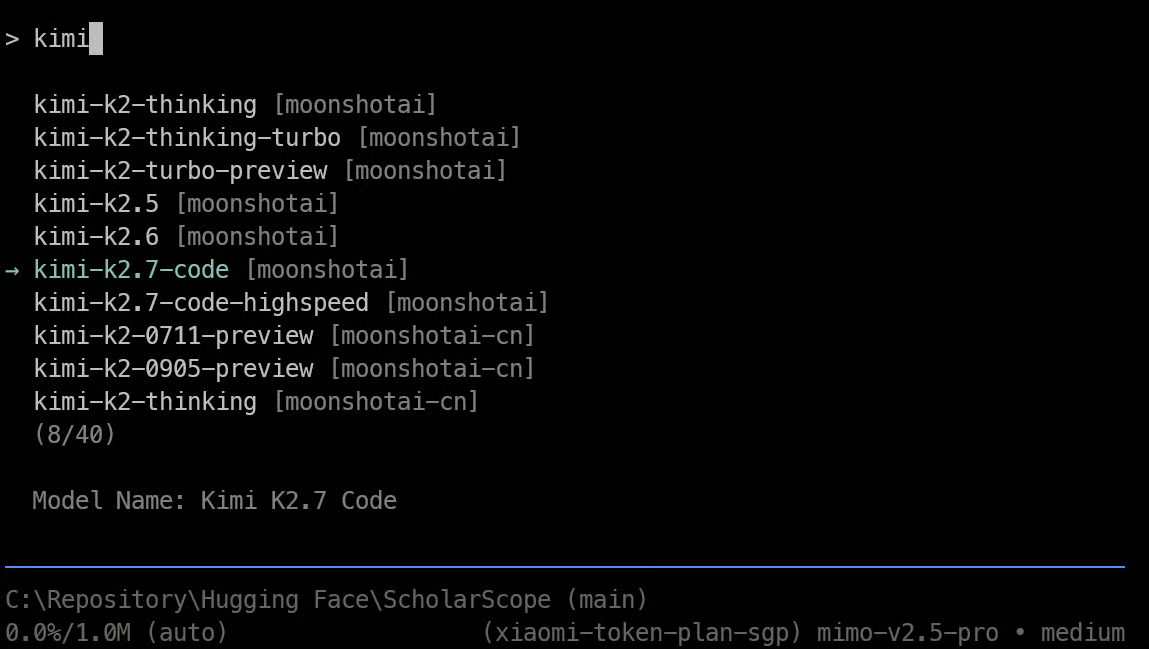
Scegli moonshotai come provider e seleziona kimi-k2.7-code.
Pi dovrebbe rilevare automaticamente la variabile d’ambiente MOONSHOT_API_KEY e usarla per l’autenticazione.
Olostep dà a Pi accesso a workflow di ricerca per web search, scraping, crawling della documentazione, debugging ed estrazione strutturata dei dati.
Aiuta Pi a trovare informazioni aggiornate quando un’attività richiede più della conoscenza incorporata nel modello.
Prima di continuare, crea un account Olostep, genera una chiave API e salvala in locale come variabile d’ambiente denominata OLOSTEP_API_KEY.
Questo permette a Pi e a qualsiasi script che crea di autenticarsi con Olostep senza memorizzare segreti nei file del progetto.
Poi installa le skill Olostep direttamente nella directory globale delle skill di Pi:
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills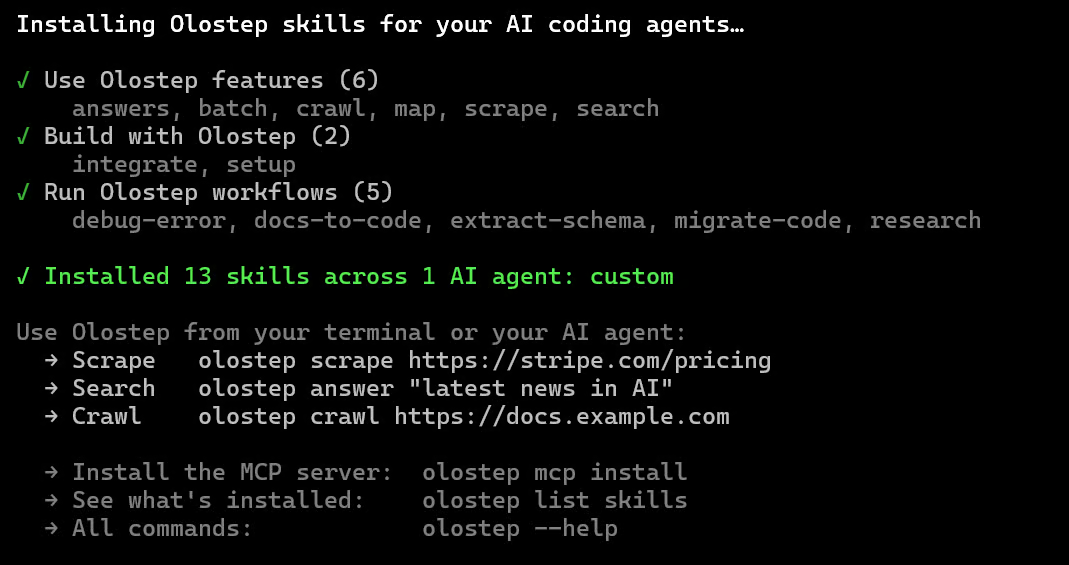
Installa le skill Olostep in:
~/.pi/agent/skills/Context7 dà a Pi accesso a documentazione di libreria aggiornata e specifica per versione e a esempi di codice. Questo aiuta a prevenire l’uso di API obsolete quando Pi lavora con framework, SDK e pacchetti Python in rapida evoluzione.
Prima dell’installazione, crea un account Context7, genera una chiave API dalla dashboard Context7 e salvala in locale come variabile d’ambiente denominata CONTEXT7_API_KEY.
Tieni la chiave privata e non fare commit nel tuo repository né includerla in screenshot, notebook o file di istruzioni del progetto.
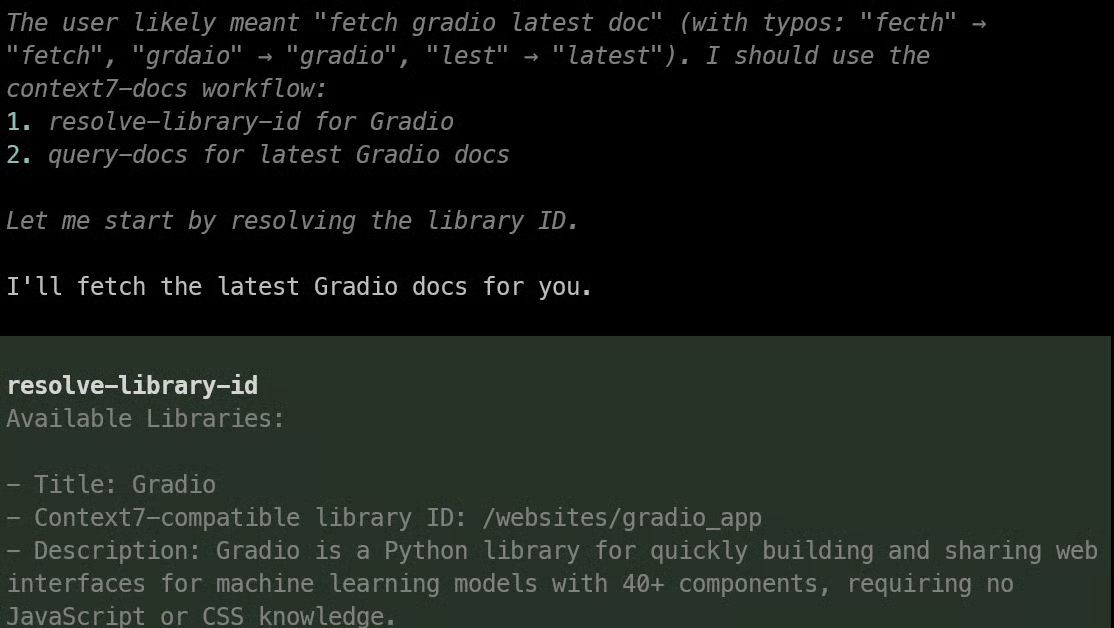
Installa il pacchetto ufficiale Context7 per Pi:
pi install npm:@upstash/context7-piQuesto aggiunge strumenti di documentazione Context7, una skill che guida Pi a usarli quando serve e il comando /c7-docs per ricerche manuali.
Dopo aver riavviato Pi, potrà recuperare la documentazione rilevante prima di scrivere codice che dipende da librerie esterne.
Pi supporta pacchetti di temi di terze parti, semplificando il miglioramento dell’interfaccia del terminale senza cambiare il funzionamento dell’agente.
Il pacchetto @spences10/pi-themes include diversi temi scuri curati, tra cui Catppuccin Mocha, Dracula, Gruvbox Dark, Nord, One Dark e Tokyo Night.
Installa il pacchetto community dei temi:
pi install npm:@spences10/pi-themesPoi apri Pi:
piApri il menu impostazioni:
/settings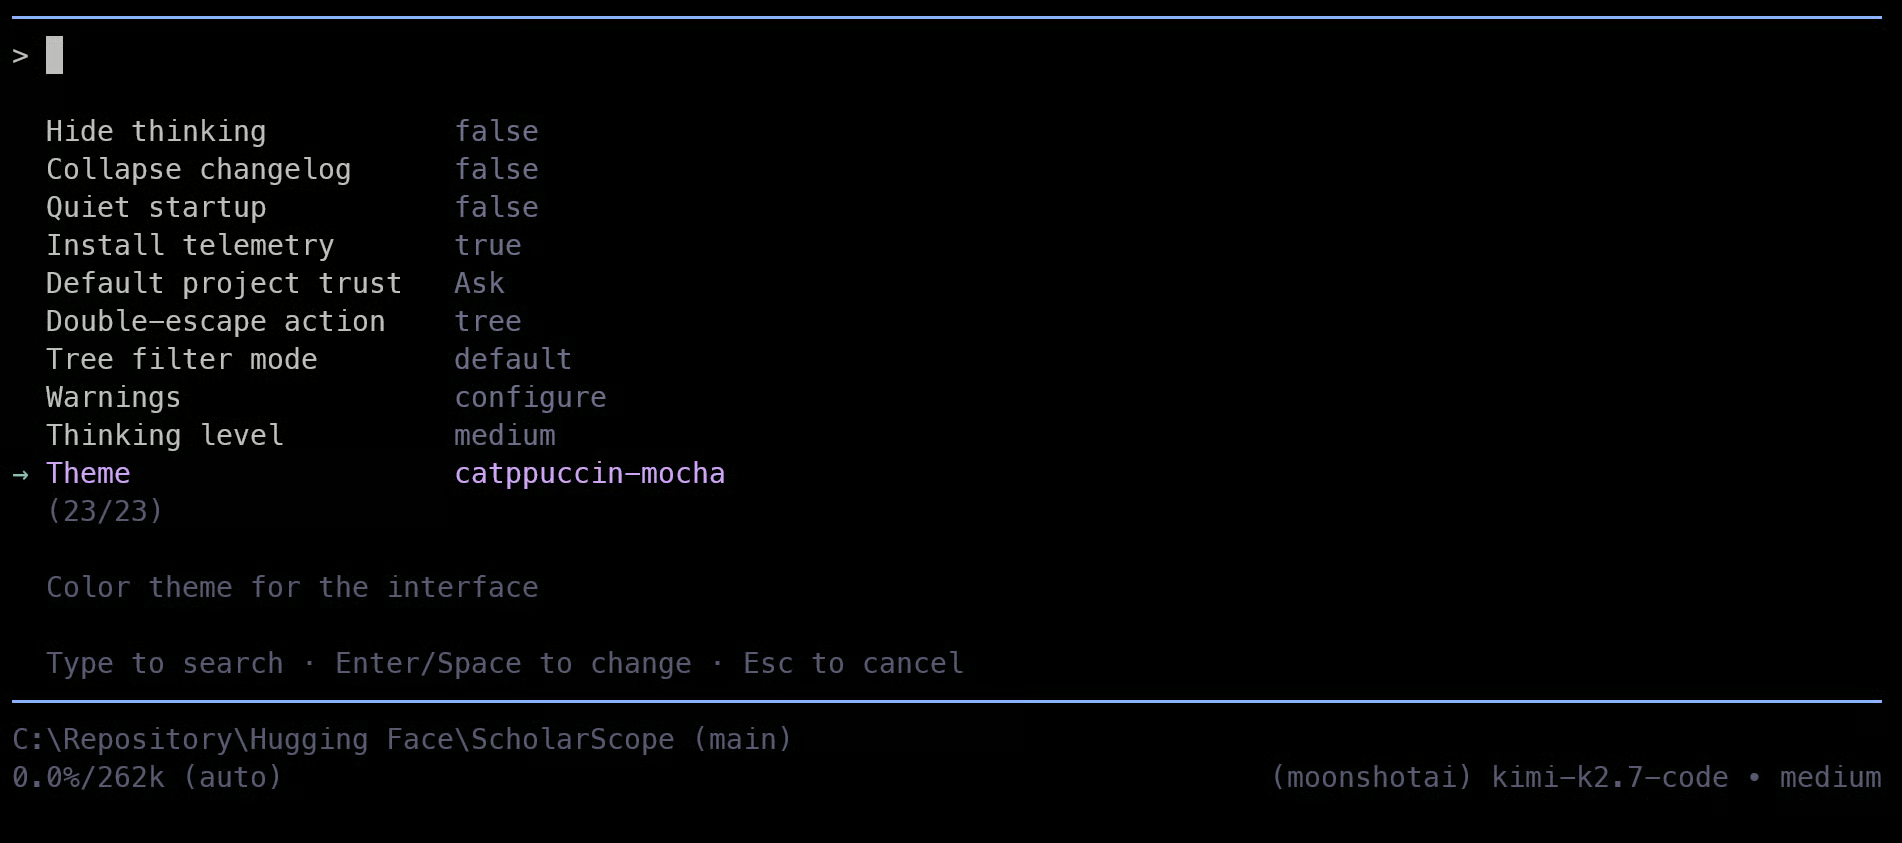
Seleziona Catppuccin Mocha tra i temi disponibili. È un tema scuro pulito, ad alto contrasto, ottimo come predefinito per sessioni di coding più lunghe.
Puoi cambiare tema in qualsiasi momento tramite /settings. Pi supporta anche temi locali e basati su pacchetto, così potrai personalizzare l’interfaccia più avanti senza cambiare modello, strumenti o setup del progetto.
Pi può essere esteso con workflow di ingegneria riutilizzabili che lo rendono più coerente nella pianificazione, nel debugging, nei test, nelle revisioni del codice, nella scrittura di documentazione e nella preparazione dei progetti per il passaggio di consegne o il rilascio.
Il pacchetto @barlevalon/skills fornisce workflow portabili SKILL.md per queste comuni attività di ingegneria del software.
Installa il pacchetto delle skill:
pi install npm:@barlevalon/skills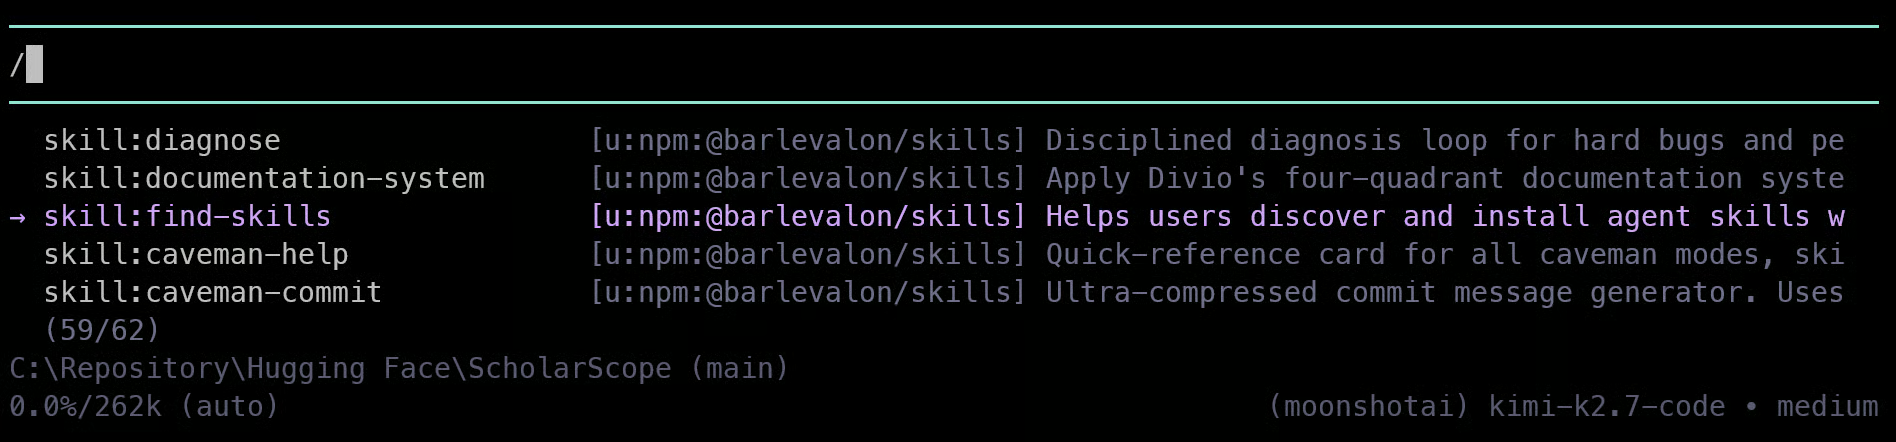
Poi installa Hypa per evitare che output lunghi del terminale occupino la finestra di contesto di Pi:
pi install npm:@hypabolic/pi-hypaHypa riscrive automaticamente i comandi shell supportati attraverso un layer locale di compressione. Mantiene le evidenze importanti, come errori e risultati finali, riducendo i log ripetitivi da installazioni di pacchetti, suite di test, esecuzioni di modelli, build e deploy.
Il pacchetto Pi installa anche Hypa come dipendenza e crea uno shim locale best‑effort del comando hypa.
Non ti serve un MCP, un’estensione o un pacchetto per ogni servizio che usi.
Per workflow comuni come gestire repository, distribuire un’applicazione, controllare i log o pubblicare un modello, un tool da riga di comando autenticato è spesso più semplice, affidabile e facile da usare per Pi.
GitHub CLI permette a Pi di lavorare con repository, pull request, issue, release e GitHub Actions direttamente dal terminale. Installalo su Windows con:
winget install --id GitHub.cli --source wingetPoi accedi:
gh auth loginUsa GitHub CLI quando vuoi che Pi ispezioni un repository, crei o riveda pull request, controlli l’esecuzione dei workflow, gestisca le issue o pubblichi un progetto su GitHub.
Vercel CLI permette a Pi di distribuire applicazioni web, ispezionare progetti, vedere i log dei deploy e gestire variabili d’ambiente dal terminale.
npm install -g vercel
vercel login
Usa Vercel CLI per deploy di anteprima, release in produzione, troubleshooting dei deploy, collegamento dei progetti e verifica delle variabili d’ambiente.
L’attuale tool da riga di comando di Hugging Face è hf, incluso nel pacchetto huggingface_hub. Installalo con:
pip install -U huggingface_hubPoi autenticati:
hf auth loginUsa Hugging Face CLI per creare e gestire repository di modelli, dataset e Space; caricare file di progetto; scaricare modelli o dataset; e confermare quale account è attualmente autenticato.
I test unitari sono utili per verificare la logica Python, ma non mostrano se un utente reale riesce a usare la tua applicazione.
Webwright permette a Pi di eseguire test basati su browser con Playwright contro app locali o distribuite, inclusi front‑end Streamlit, Gradio, FastAPI, progetti React o Next.js, anteprime Vercel e Hugging Face Spaces.
Installa Webwright in Pi:
pi install npm:pi-webwrightPoi installa Chromium per Playwright:
npx playwright install chromium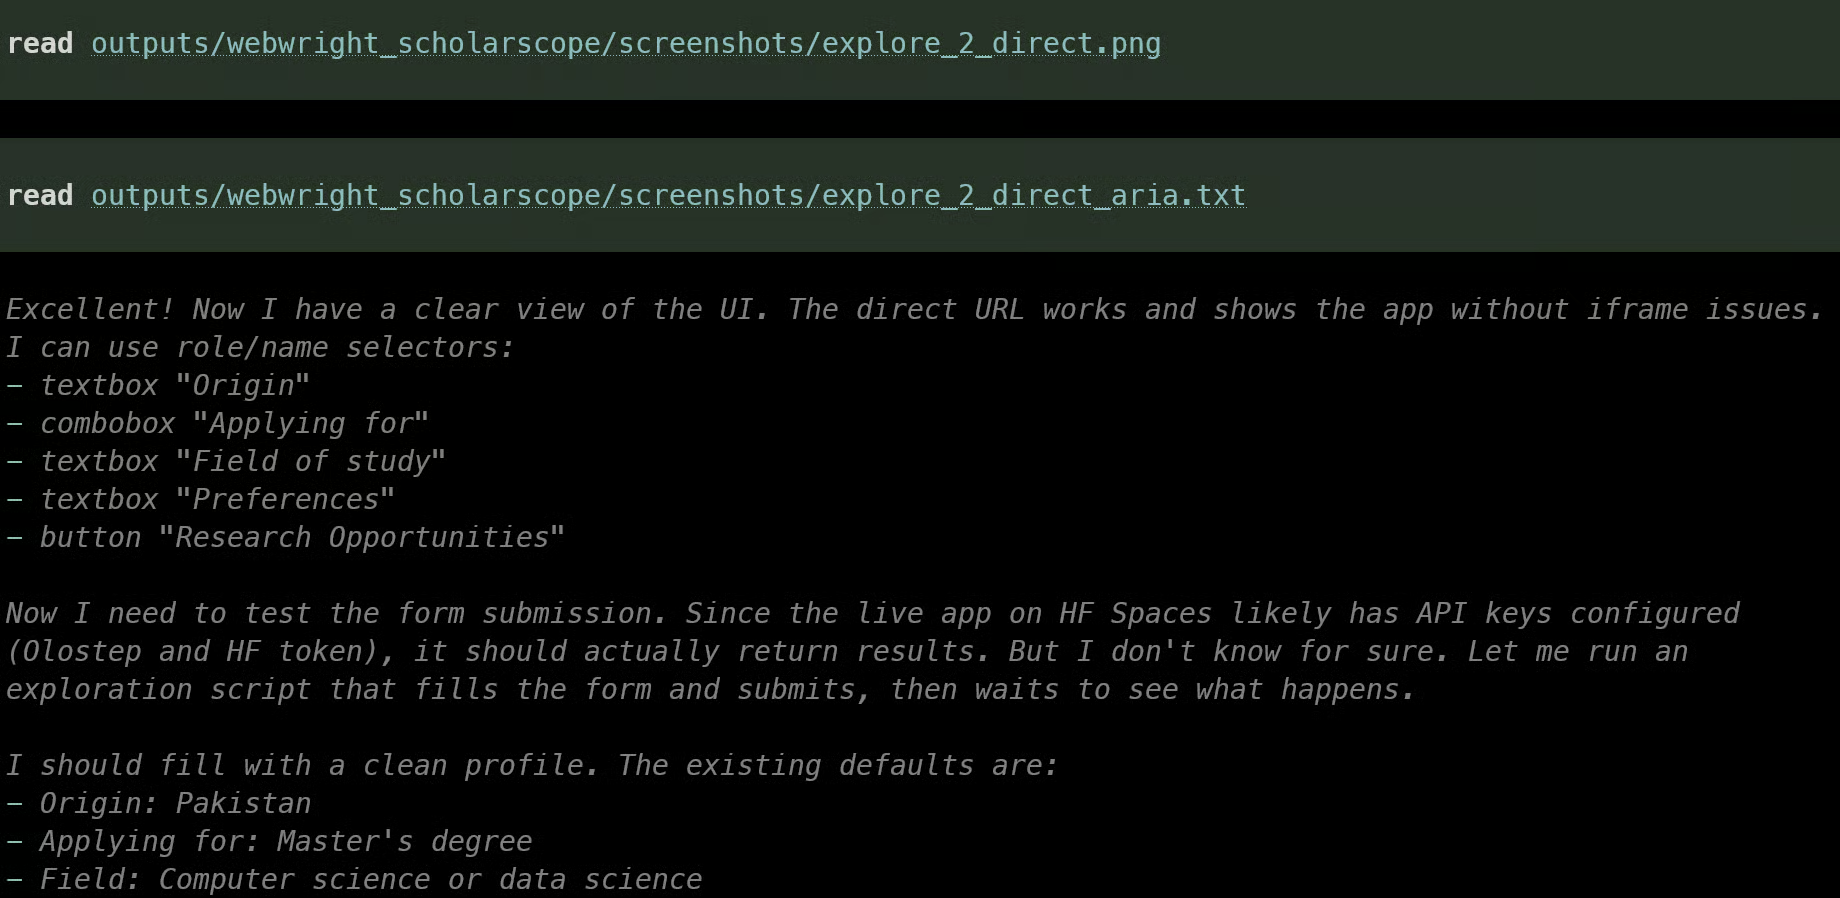
Webwright permette a Pi di aprire l’app in Chromium, testare il flusso utente principale, interagire con form o upload di file, verificare che i risultati vengano renderizzati correttamente, ispezionare gli errori del browser e salvare screenshot e log.
Il pacchetto include una skill per i test del browser progettata per workflow ispezionabili e basati su artifact.
Pi inizia ogni nuova sessione con un contesto limitato dal lavoro precedente.
Hermes Memory aggiunge memoria locale e persistente, così Pi può cercare nelle sessioni precedenti, mantenere il contesto utile del progetto, consolidare informazioni ripetute e scansionare la presenza di segreti.
Gira in locale, quindi non ti serve una chiave API separata per una memoria in hosting.
Installa Hermes Memory:
pi install npm:pi-hermes-memoryRiavvia Pi dopo l’installazione.
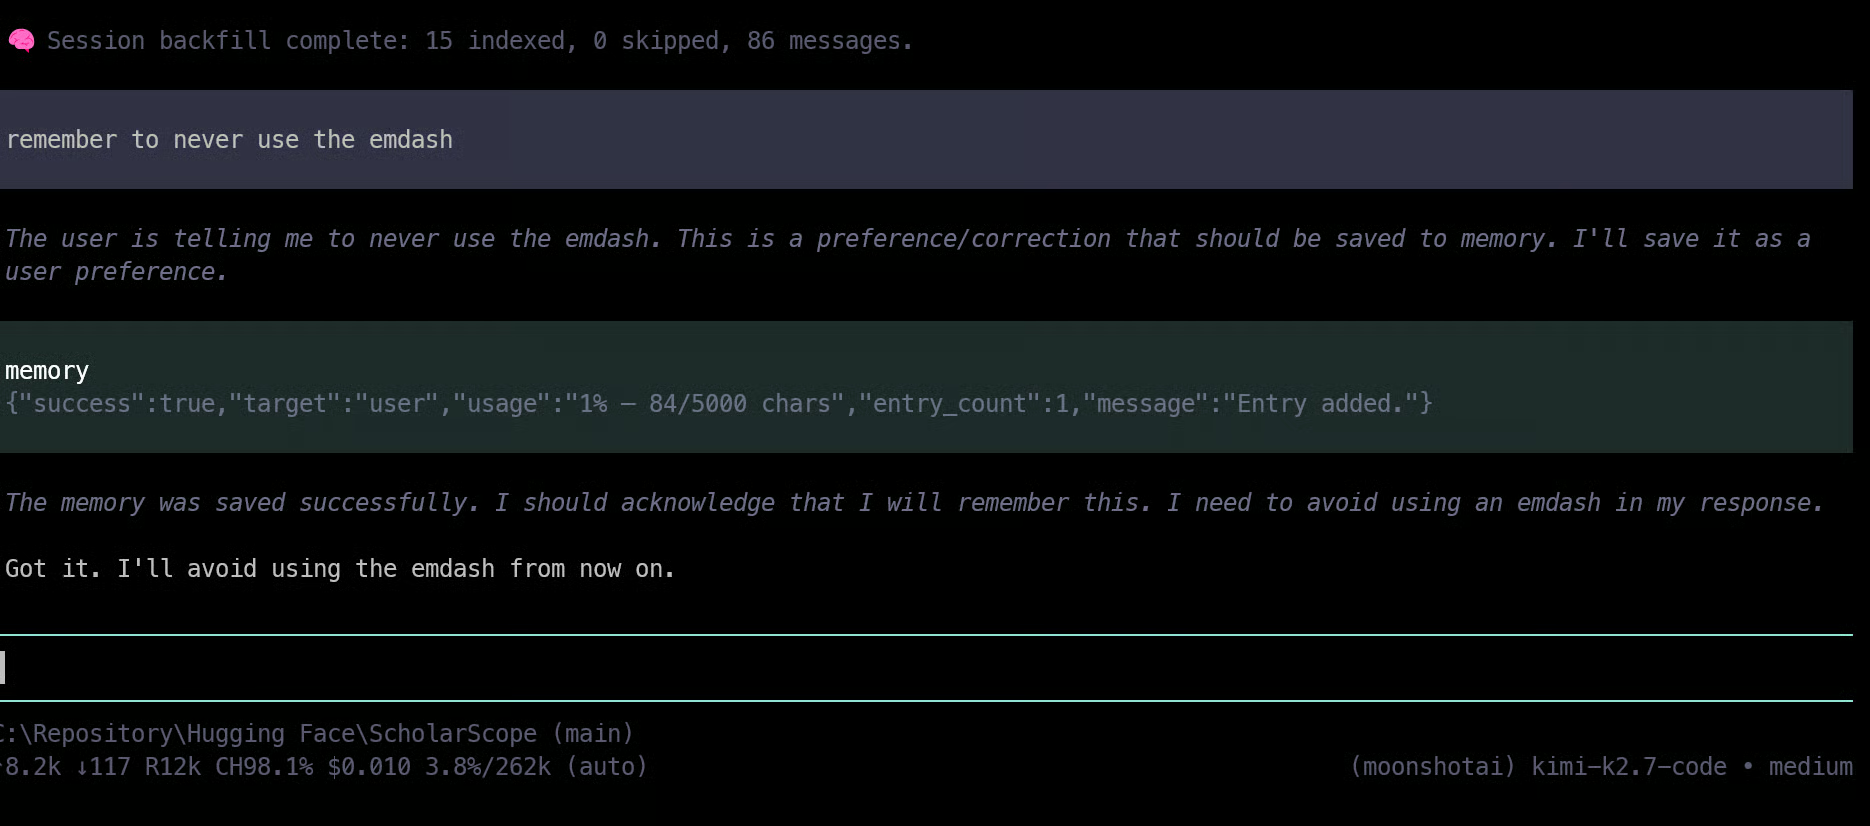
Usa Hermes Memory insieme a una documentazione di progetto chiara:
Mantieni MEMORY.md e docs/decisions/ come fonte di verità visibile per il tuo progetto.
Hermes Memory aiuta Pi a proseguire il lavoro tra sessioni, mentre i file Markdown rendono il contesto facile da ispezionare per te o per un altro contributor in seguito.
Un setup Pi solido ha bisogno anche di una struttura di progetto chiara.
Questo mantiene ordinati esperimenti, codice, test, dati e risultati, così Pi può apportare modifiche senza mescolare il lavoro temporaneo dei notebook con codice di pipeline riutilizzabile.
Crea un nuovo progetto e inizializzalo con uv:
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
Usa questa struttura:
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
Tieni in src/ il codice riutilizzabile per caricamento dati, preprocessing, training e valutazione.
Usa notebooks/ solo per esplorazione ed esperimenti rapidi.
Archivia i file sorgente invariati in data/raw/, i dati puliti in data/processed/ e salva grafici, metriche e output del modello in reports/.
Crea un file AGENTS.md così che Pi segua il workflow giusto quando lavora nel repository:
# Project Rules

- Use Olostep for current research and Context7 for library documentation.
- Inspect the dataset, missing values, duplicates, leakage risks, class balance, and baseline before training.
- Keep reusable logic in `src/`, not notebooks.
- Add tests when changing preprocessing or evaluation behaviour.
- Run formatting, linting, and tests before declaring work complete.
- Record important decisions in `docs/decisions/`.
Questo offre a Pi un workflow ripetibile per costruire progetti di data science più facili da testare, mantenere e migliorare.
È il momento di testare l’intero setup di Pi in un progetto reale. In questo esempio, ho chiesto a Pi di creare un’applicazione riproducibile di classificazione binaria per la previsione del placement degli studenti usando fattori come performance accademiche, tirocini, progetti, certificazioni e skill.
Avvia Pi dalla cartella del tuo progetto:
piPoi dai a Pi il seguente prompt:
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
Dopo che il workflow del modello funziona, crea una piccola interfaccia Streamlit o Gradio e testala in Chromium con Webwright, includendo il percorso utente principale, il rendering dei risultati, gli errori della console, screenshot e log.
Riporta accuracy, F1 pesato, F1 macro, un confronto con il baseline e una matrice di confusione. Inizializza e invia il repository con GitHub CLI.
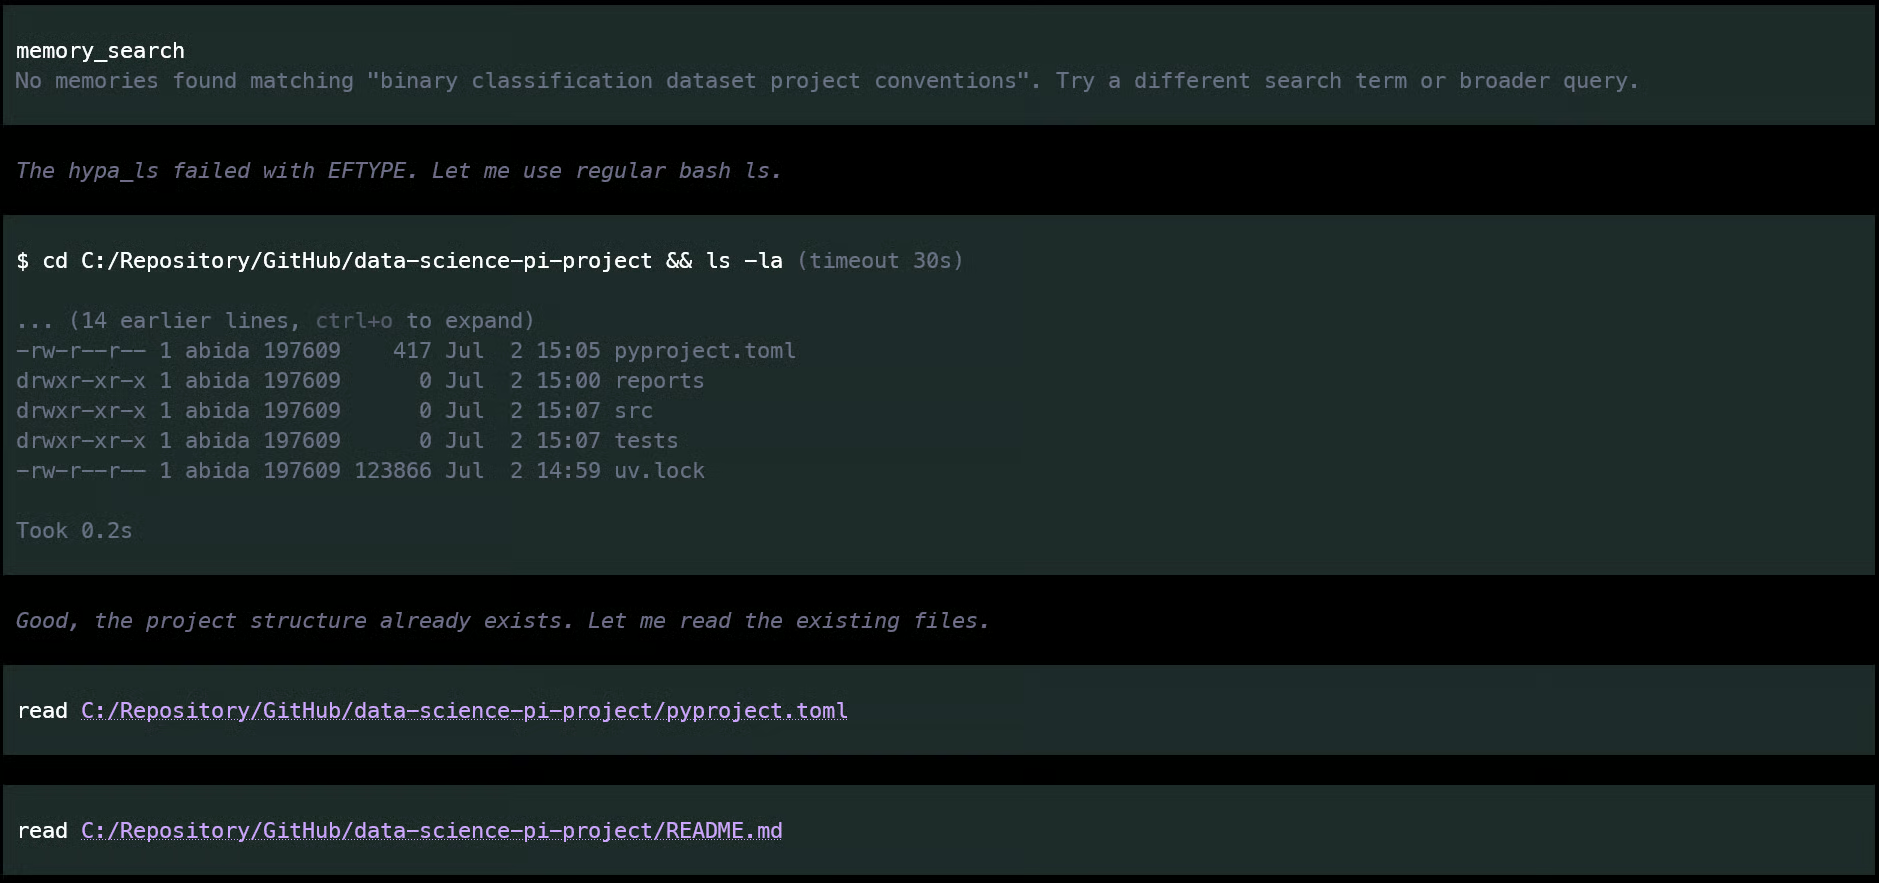
Pi ha prima controllato Hermes Memory per eventuale contesto precedente relativo al progetto.
Come mostrato nello screenshot, non ha trovato nulla di utile, quindi è passato a ispezionare la directory del progetto corrente.
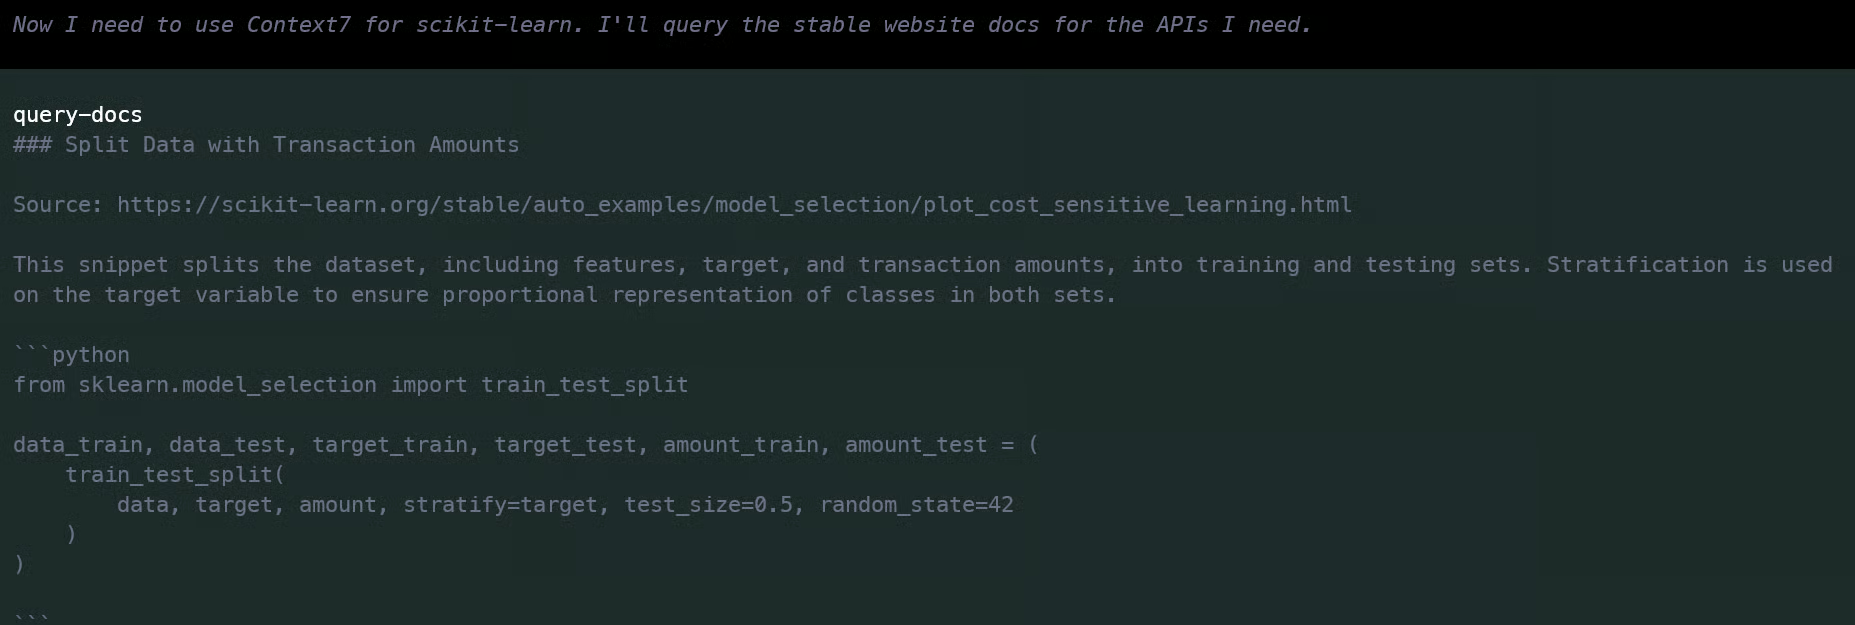
Una volta compresa la struttura delle directory, ha usato Context7 per controllare la documentazione aggiornata di Python e scikit‑learn prima di scrivere i file del progetto.
Questo è utile perché aiuta l’agente a usare API aggiornate invece di affidarsi a esempi obsoleti.
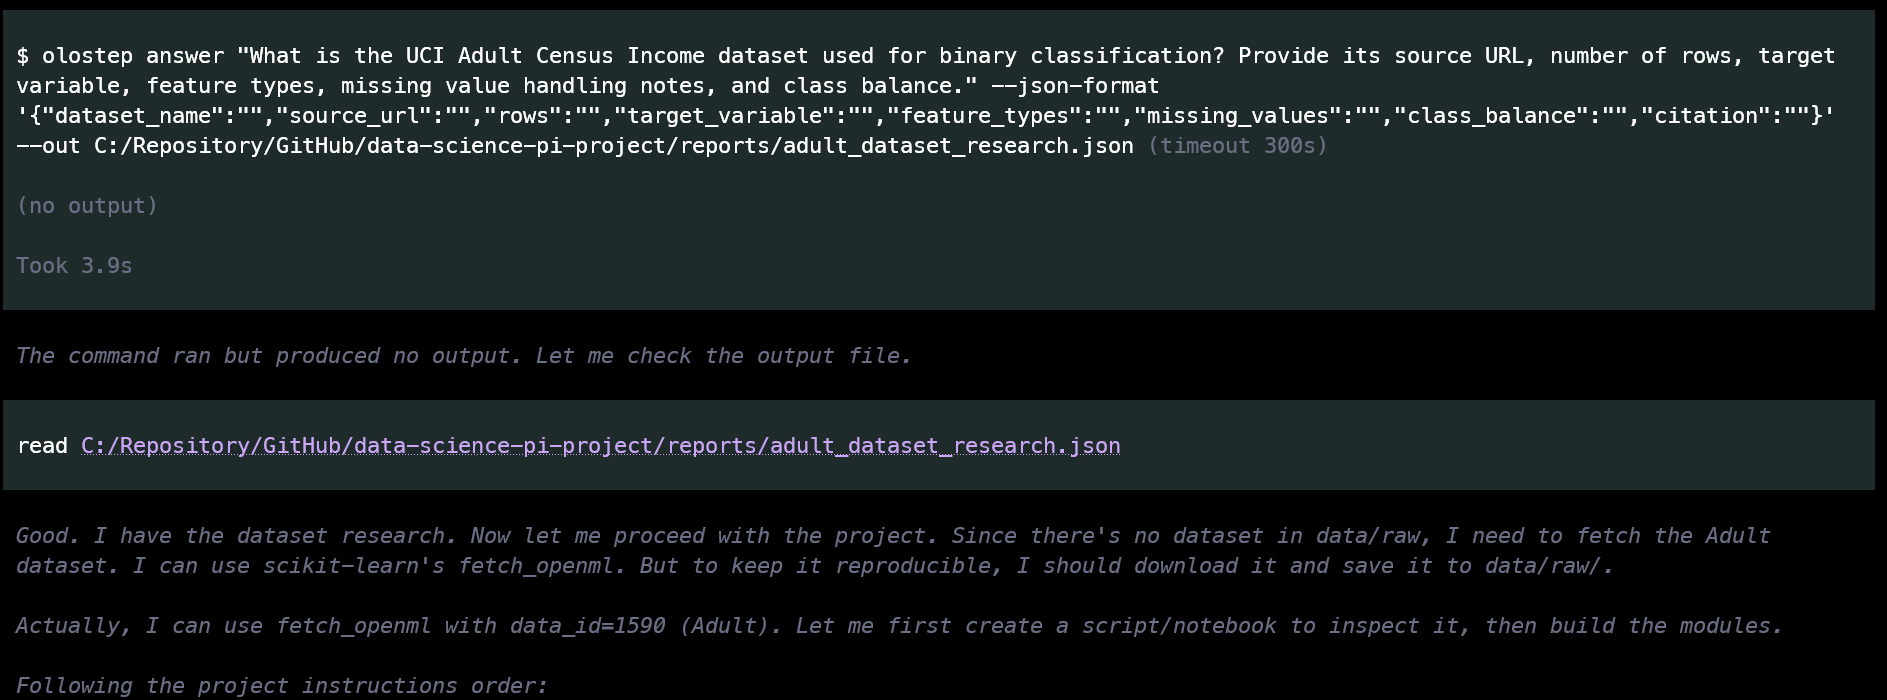
Successivamente, Pi ha usato la skill di ricerca Olostep per cercare un dataset adatto e raccogliere informazioni rilevanti per il progetto.
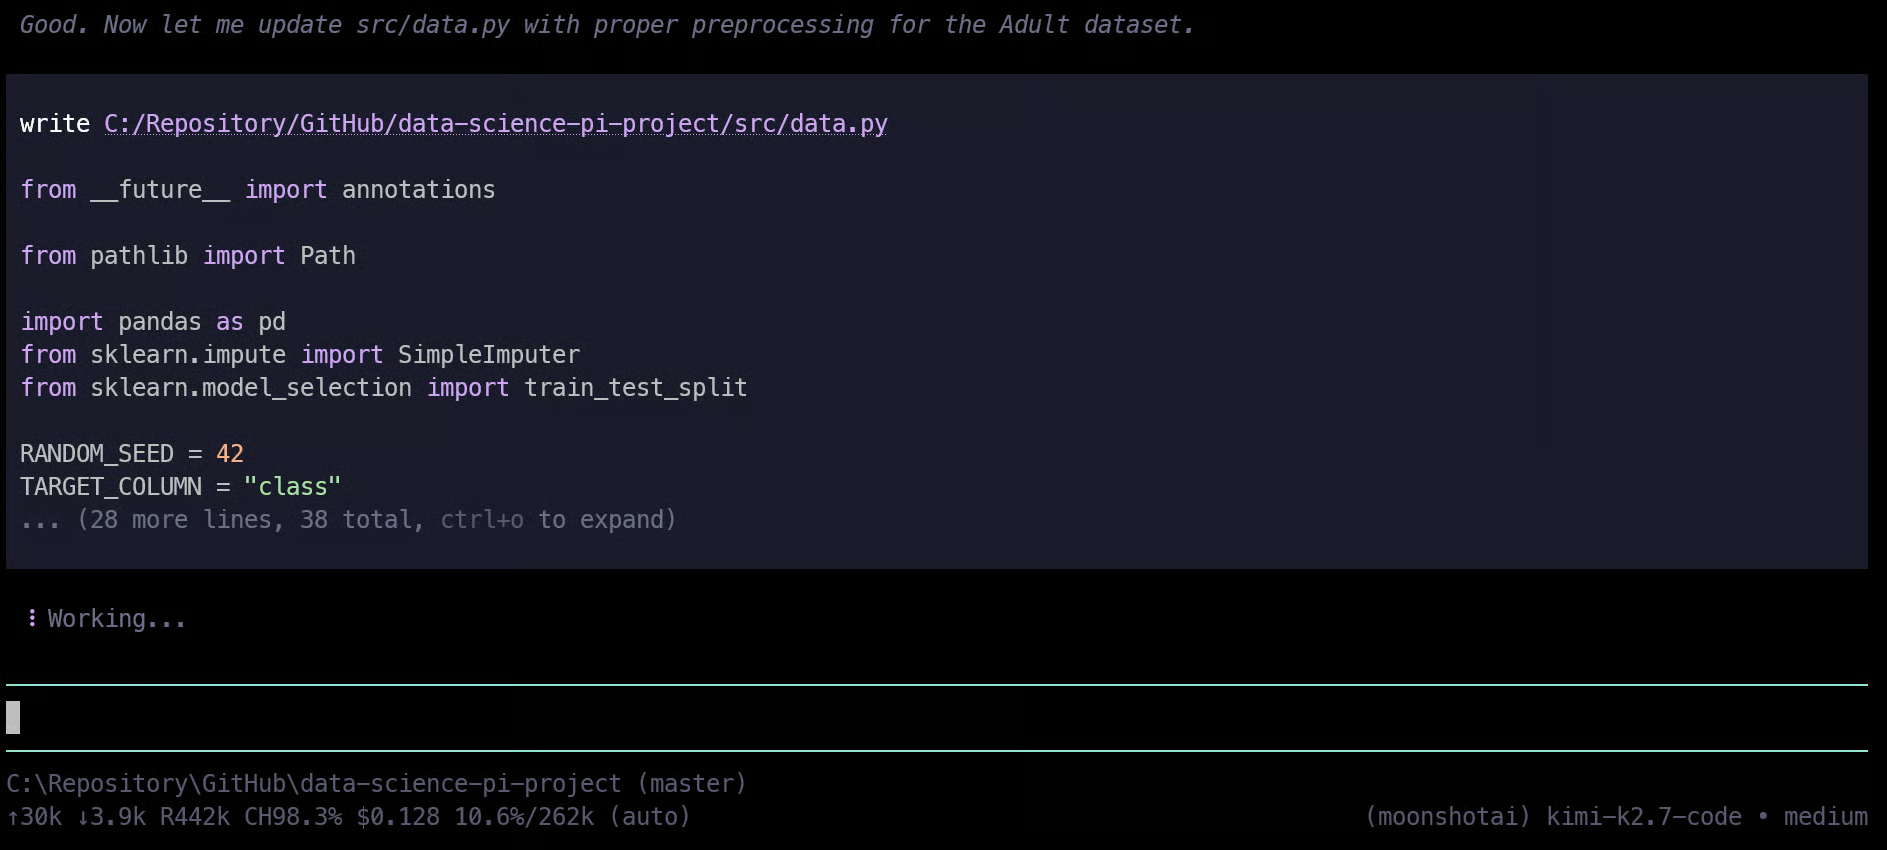
Dopo aver raccolto abbastanza contesto, ha iniziato a creare i file uno per uno, inclusi pipeline di preprocessing, codice di training, script di valutazione, test, README e istruzioni del progetto.
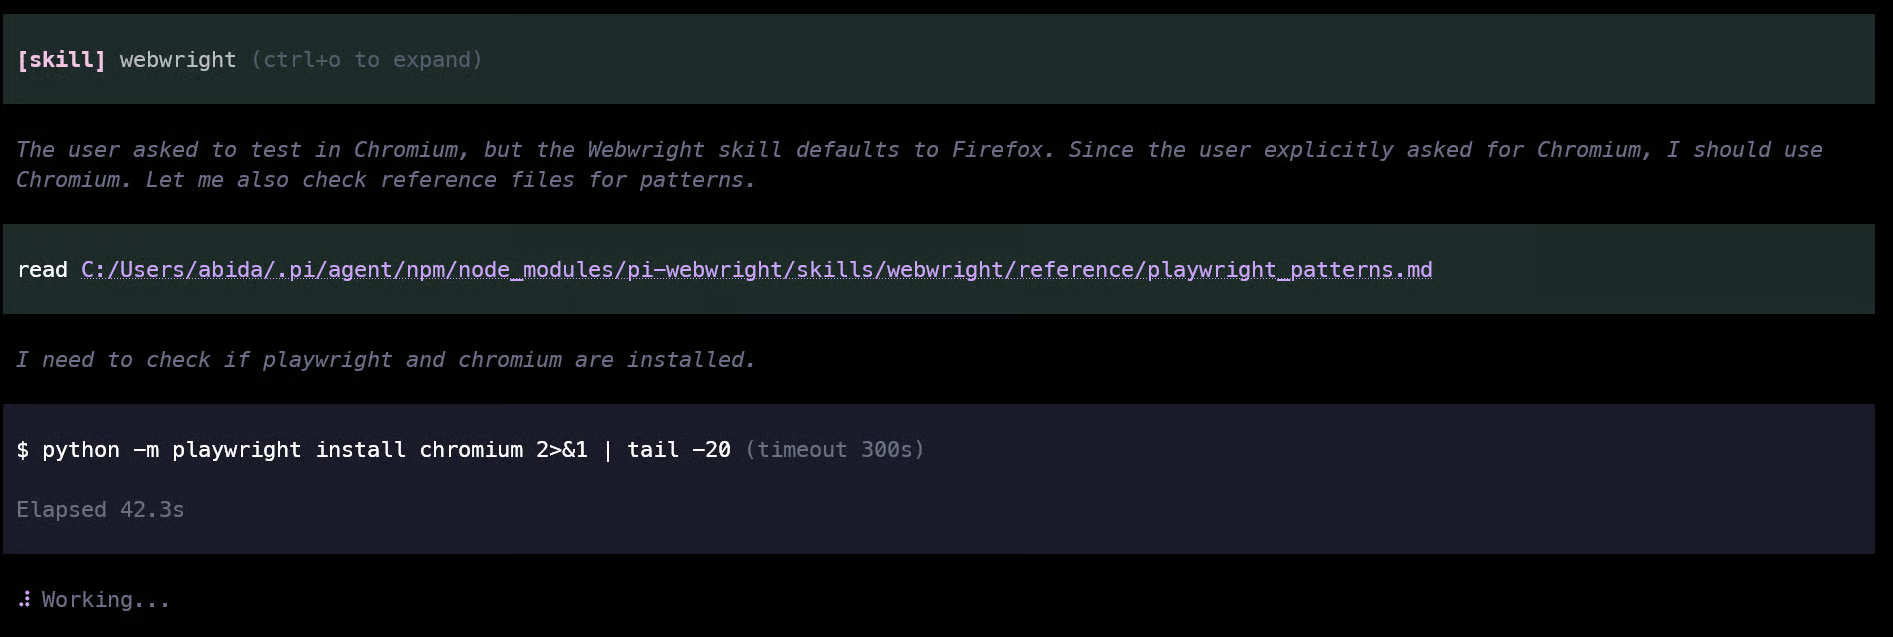
Completato il workflow di machine learning, Pi ha creato una piccola applicazione Streamlit.
Ha quindi installato Chromium per Playwright e ha usato Webwright per testare l’interfaccia in un browser reale.
Il test del browser ha verificato il flusso utente principale, controllato che i risultati venissero renderizzati correttamente, ispezionato gli errori della console e salvato screenshot e log.
Pi ha anche eseguito i test Python e i check del progetto prima di generare il riepilogo finale.
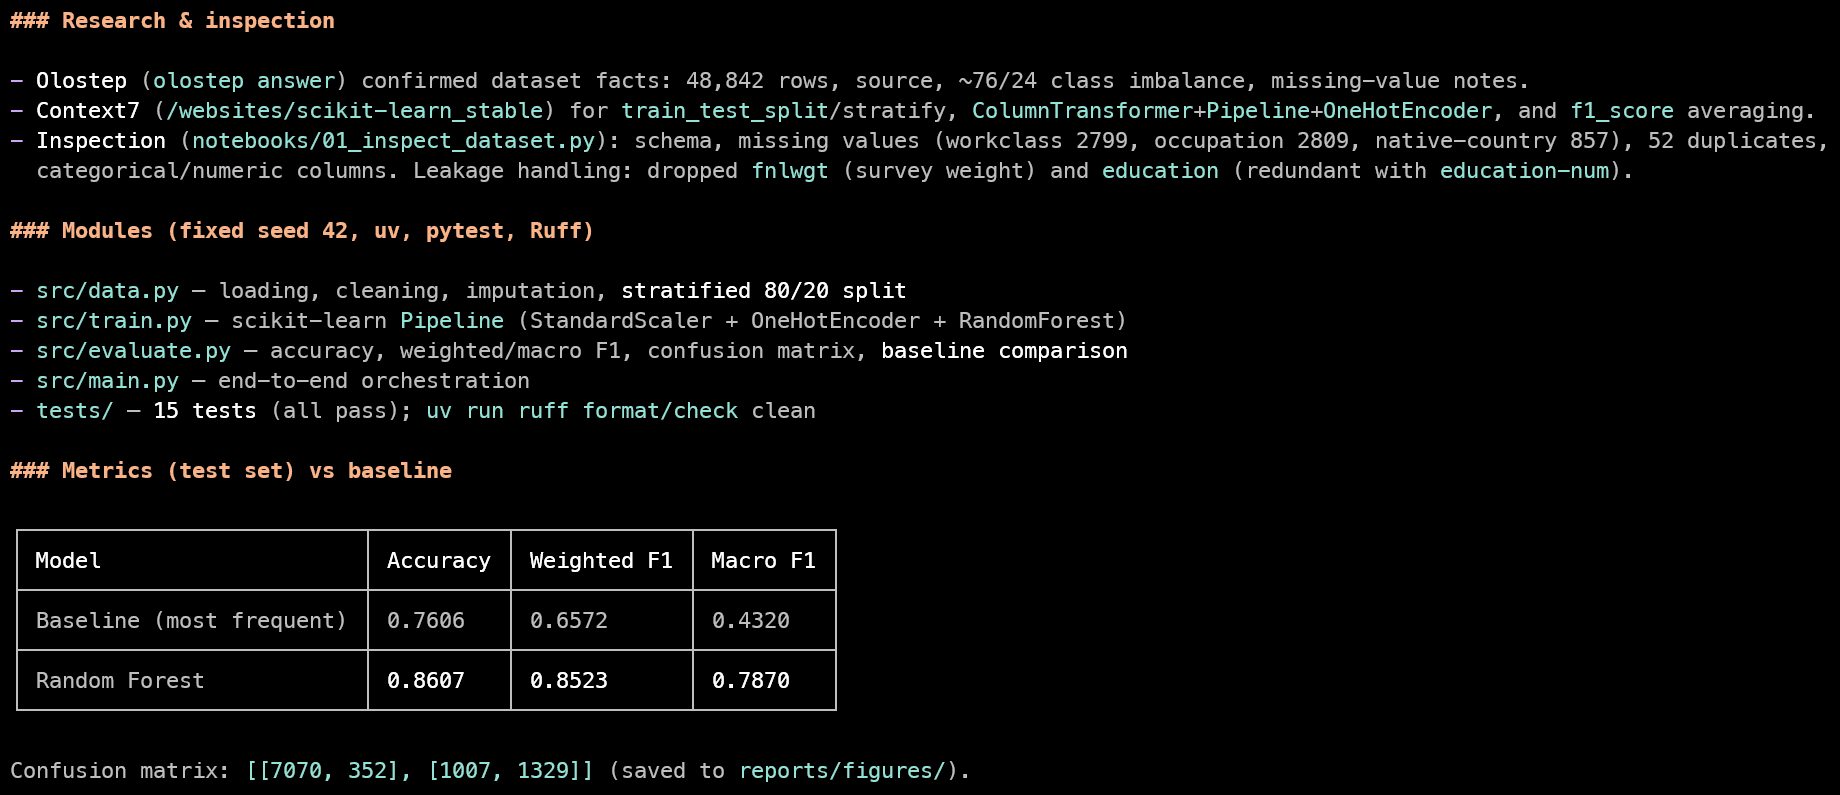
In questo test, il modello finale ha raggiunto circa l’86% di accuracy e un F1 di 0,85.
Pi ha poi fatto commit delle modifiche, creato un repository GitHub e pushato il progetto completo su GitHub.
Il repository include il README, la struttura del progetto, il codice sorgente, i test, i file di valutazione del modello e l’applicazione Streamlit:
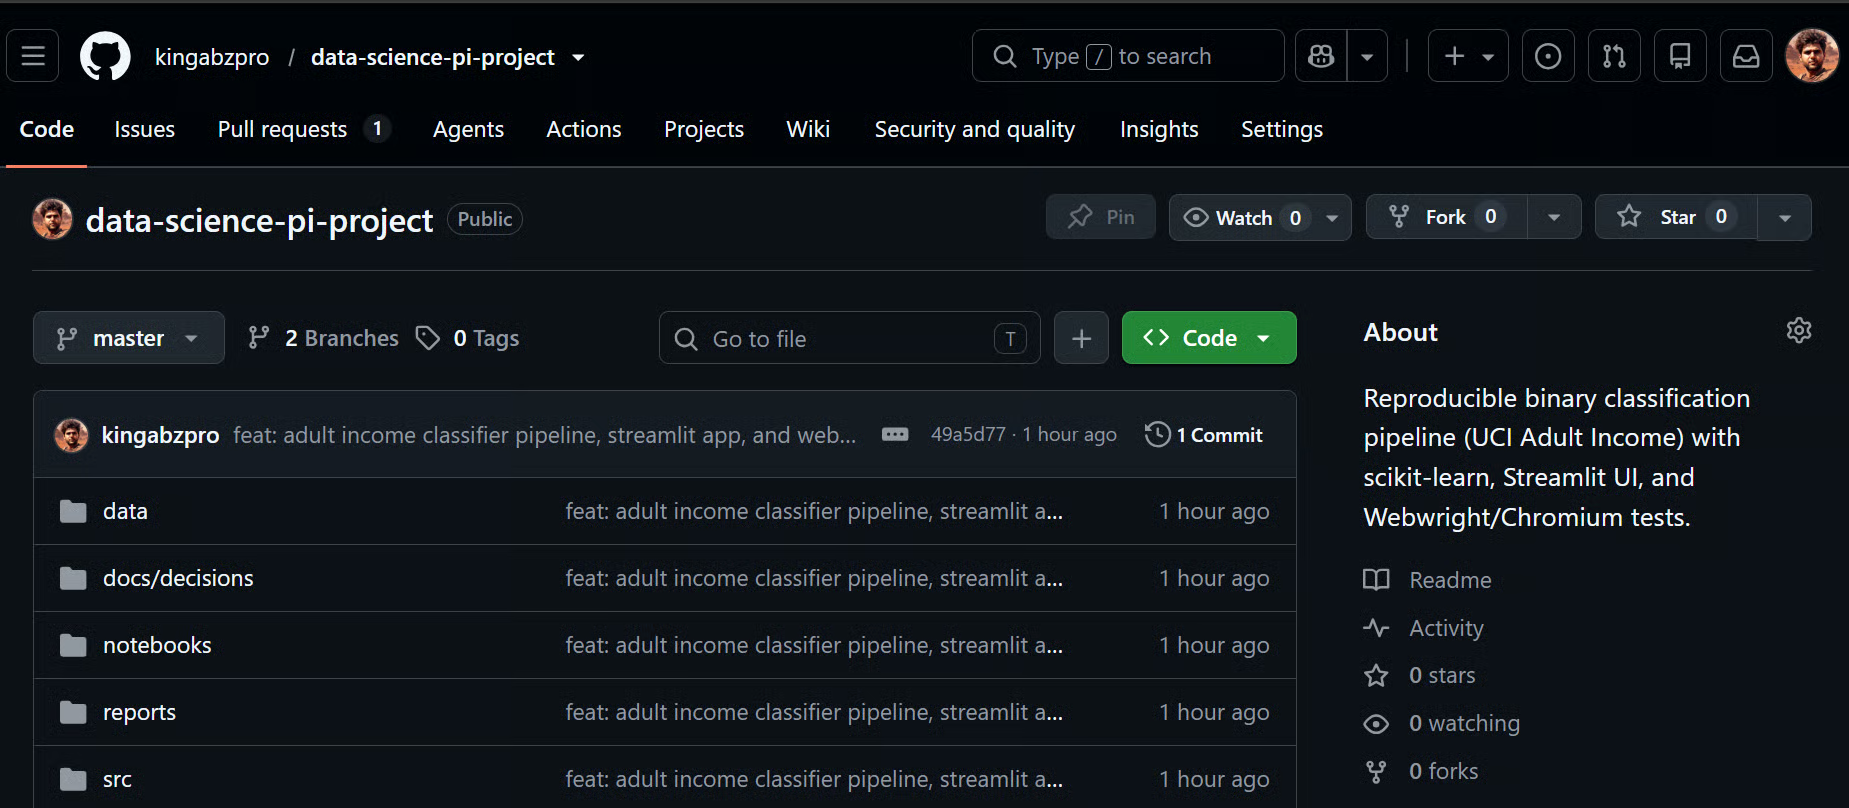
Fonte: kingabzpro/data-science-pi-project
Puoi eseguire l’applicazione in locale con:
streamlit run app.py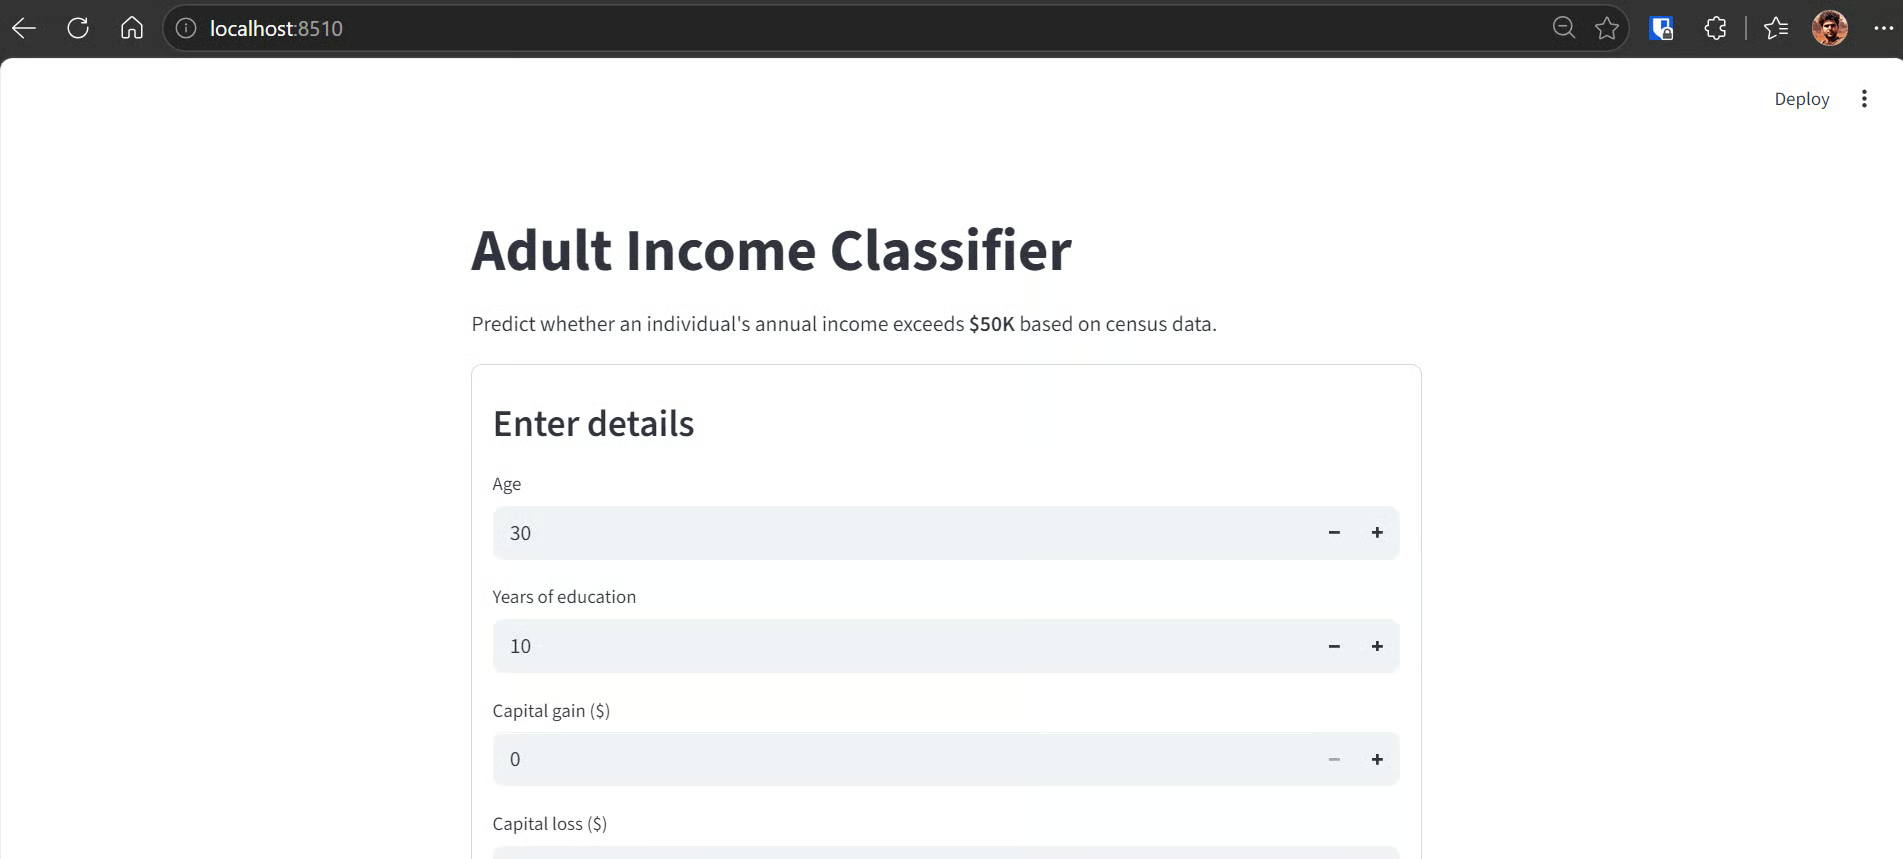
L’interfaccia è pulita e facile da navigare e il modello restituisce rapidamente le previsioni.
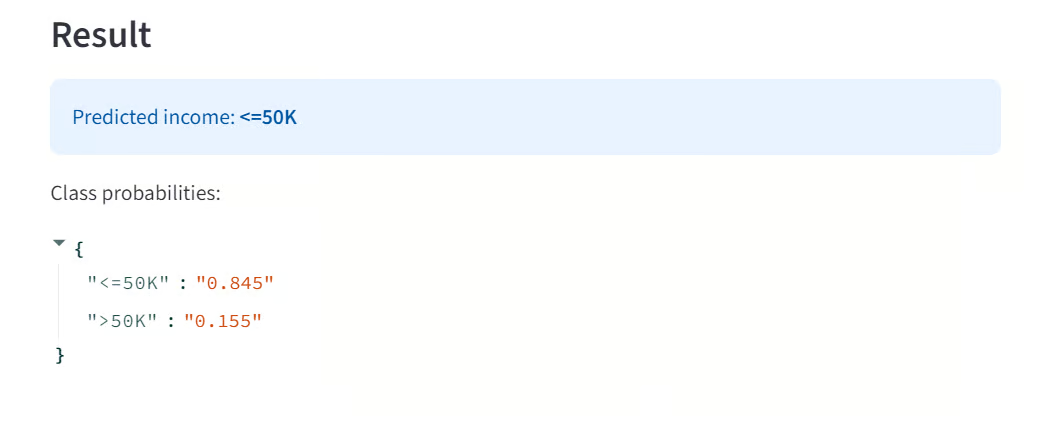
Ancora più importante, questo test mostra il valore dell’intero setup: Pi può ricercare il task, ispezionare i dati, usare la documentazione aggiornata, costruire la pipeline, creare un’interfaccia, testare l’esperienza nel browser, validare il modello e pubblicare il progetto finito con un unico workflow.
Kimi K2.7 Code e Pi si sono rivelati una combinazione potente per il lavoro di coding pratico.
Kimi è veloce, capace e gestisce bene le attività ingegneristiche multi‑step senza complicare decisioni semplici.
Se usi l’API invece di un abbonamento al coding, vale la pena considerare di aggiungere almeno 10 $ di crediti per accedere al tier di utilizzo superiore ed evitare di raggiungere troppo in fretta i limiti giornalieri.
Quello che mi ha colpito di più è quanto poco coordinamento manuale serva al workflow una volta completata la configurazione.
Con un prompt dettagliato, Pi ha controllato Hermes Memory per il contesto rilevante del progetto, ha rivisto la directory del progetto, ha usato Context7 per verificare la documentazione aggiornata di Streamlit e scikit‑learn e ha usato Olostep per ricercare il dataset e l’impostazione del problema.
Da lì, ha creato i file del progetto, costruito la pipeline di machine learning, sviluppato l’app Streamlit e testato l’interfaccia con Webwright e Playwright.
Pi ha anche eseguito i test Python, controllato le metriche del modello, rivisto il comportamento del browser, generato un riepilogo finale, fatto commit delle modifiche e pushato il repository completato su GitHub.
Nel complesso, il setup è sembrato meno come gestire manualmente un assistente di coding e più come dare una direzione chiara a un workflow di sviluppo automatizzato.
Una volta collegati gli strumenti giusti, Pi ha gestito gran parte del lavoro pesante mentre Kimi forniva velocità e ragionamento per mantenere il processo fluido.
Vuoi approfondire come funzionano gli agenti AI sotto il cofano? Ti consiglio il corso di DataCamp Building Scalable Agentic Systems per imparare i principi di design, i framework di test e i protocolli (come MCP) necessari per portare gli agenti AI dal proof‑of‑concept alla produzione.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



