
Khóa học
Lập trình với AI dành cho Developer
1 giờ 30 phút
11.1K
Kimi K2.7 Code là mẫu mô hình lập trình chủ lực của Moonshot, được xây dựng cho các tác vụ phát triển phần mềm thực tiễn như viết và gỡ lỗi mã, điều hướng các codebase lớn và xử lý công việc kỹ thuật nhiều bước.
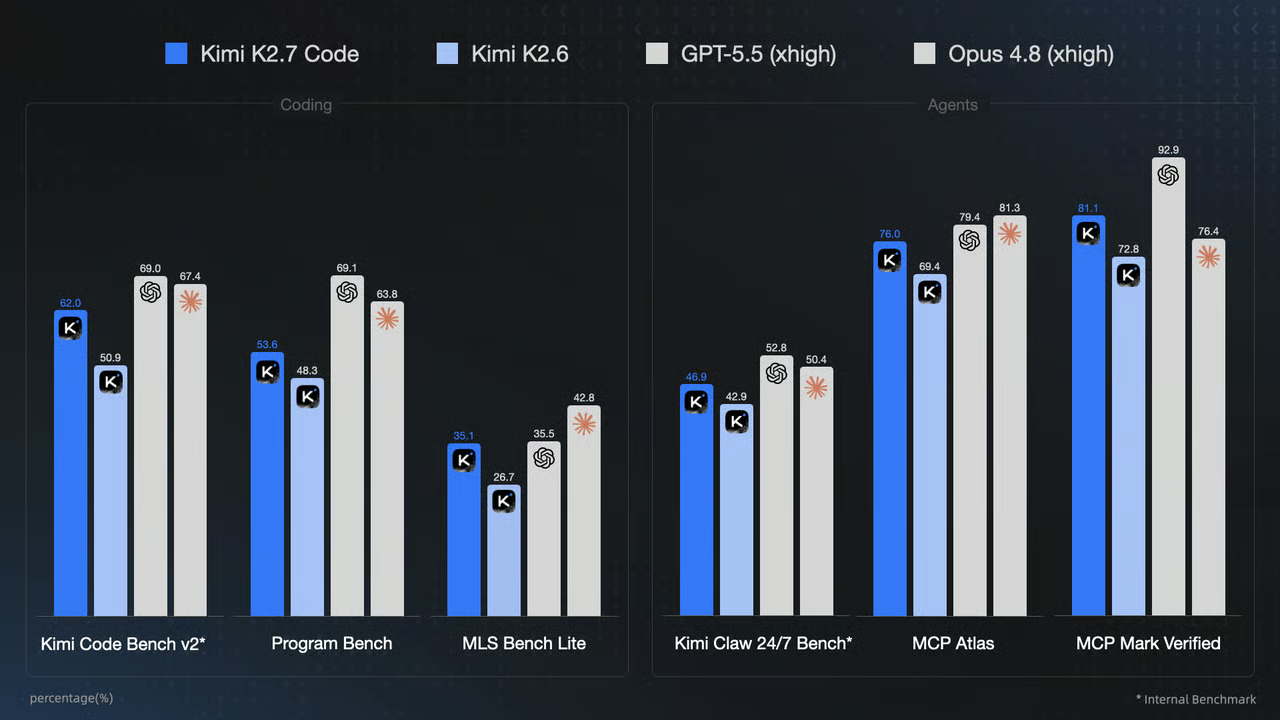
Nguồn: Kimi K2.7 Code: Open-Source Agentic Coding Model
Kết hợp với Pi, một tác tử lập trình gọn nhẹ và cực kỳ mở rộng, nó tạo nên môi trường phát triển cục bộ linh hoạt, hỗ trợ kỹ năng, gói, công cụ dòng lệnh, bộ nhớ bền và kiểm thử trình duyệt mà không thêm độ phức tạp không cần thiết.
Thay vì cài đặt một MCP cho mọi tác vụ, Pi có thể kết hợp khả năng suy luận của Kimi với các công cụ developer đáng tin cậy như GitHub CLI, Vercel CLI, Hugging Face CLI, pytest, Ruff và uv.
Điều này giúp có thể nghiên cứu, xây dựng, kiểm thử, triển khai và duy trì dự án thực chỉ với một quy trình tác tử lập trình.
Trong hướng dẫn này, tôi sẽ chỉ bạn cách thiết lập Kimi K2.7 Code với Pi từ đầu đến cuối.
Bạn sẽ cấu hình khóa API Moonshot, thêm Olostep cho nghiên cứu, Context7 cho tài liệu cập nhật, Webwright cho kiểm thử trình duyệt và Hermes Memory cho ngữ cảnh xuyên phiên.
Bạn cũng sẽ cài đặt các chủ đề và kỹ năng kỹ thuật hữu ích, kết nối các CLI thực tiễn cho GitHub, Vercel và Hugging Face, tạo một dự án khoa học dữ liệu Python có thể tái lập, và kiểm thử toàn bộ quy trình bằng cách xây dựng, xác thực và xuất bản một ứng dụng học máy nhỏ.
Tôi cũng khuyên bạn xem hướng dẫn của tôi về cách chạy Kimi K2.7 Code cục bộ.
Pi là một tác tử lập trình gọn nhẹ chạy trực tiếp trong terminal.
Nó có thể làm việc với tệp cục bộ, chạy lệnh, dùng kỹ năng và gói đã cài, và kết nối với mô hình lập trình bạn ưa thích.
Chọn lệnh cài đặt phù hợp với hệ điều hành của bạn.
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS hoặc Linux
curl -fsSL https://pi.dev/install.sh | shBạn cũng có thể cài Pi thông qua npm:
npm install -g --ignore-scripts @earendil-works/pi-coding-agentTrước khi dùng Kimi K2.7 Code trong Pi, hãy thêm khóa API Moonshot của bạn như một biến môi trường.
Khi bạn chọn Moonshot làm nhà cung cấp mô hình, Pi sẽ tự động truy cập khóa này.
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"Đóng và mở lại PowerShell sau khi chạy lệnh này. Biến môi trường mới chỉ khả dụng trong các phiên terminal mở sau đó.
Git Bash, macOS, hoặc Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"Lệnh này chỉ áp dụng cho phiên terminal hiện tại. Để giữ khóa khả dụng sau khi khởi động lại terminal, hãy thêm cùng dòng vào profile shell của bạn, chẳng hạn ~/.bashrc hoặc ~/.zshrc.
Giữ kín khóa API của bạn. Không đưa nó vào kho Git, notebook công khai, ảnh chụp màn hình, tệp .env.example hay AGENTS.md.
Khi đã đặt khóa, khởi chạy Pi:
piSau đó mở bộ chọn mô hình:
/model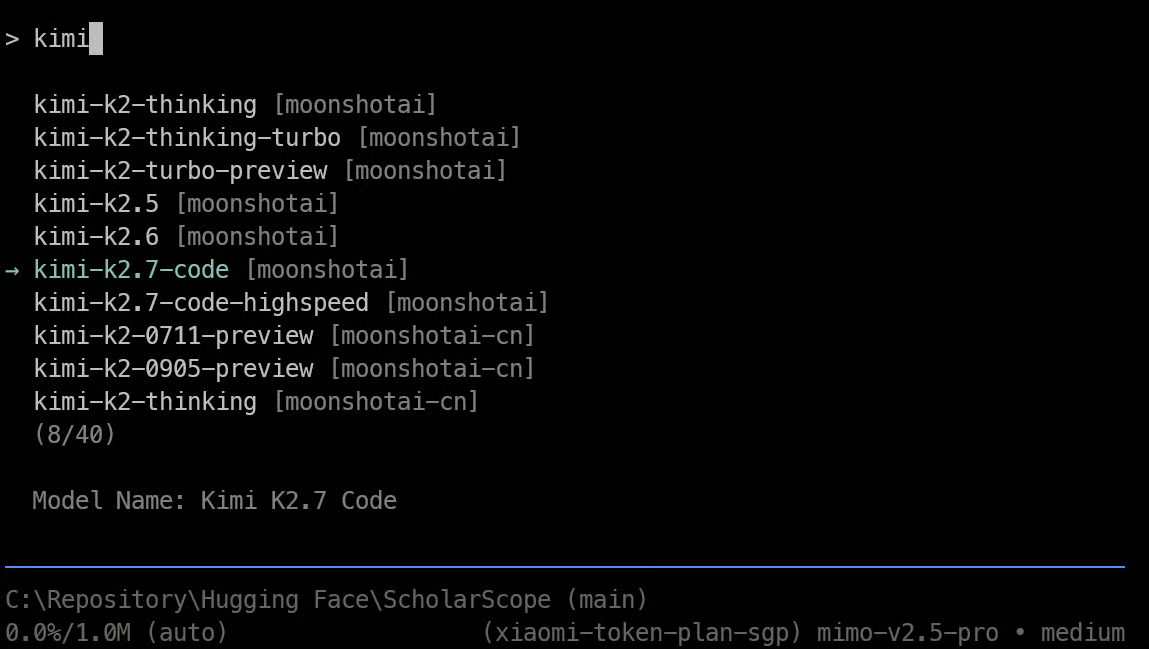
Chọn moonshotai làm nhà cung cấp và chọn kimi-k2.7-code.
Pi sẽ tự động phát hiện biến môi trường MOONSHOT_API_KEY và dùng nó để xác thực.
Olostep cho phép Pi truy cập các quy trình nghiên cứu cho tìm kiếm web, trích xuất, thu thập tài liệu, gỡ lỗi và trích xuất dữ liệu có cấu trúc.
Nó giúp Pi tìm thông tin cập nhật khi một tác vụ cần nhiều hơn kiến thức sẵn có của mô hình.
Trước khi tiếp tục, hãy tạo tài khoản Olostep, tạo khóa API và lưu cục bộ như biến môi trường tên OLOSTEP_API_KEY.
Điều này cho phép Pi và các script nó tạo ra xác thực với Olostep mà không lưu bí mật trong tệp dự án của bạn.
Tiếp theo, cài đặt kỹ năng Olostep trực tiếp vào thư mục kỹ năng toàn cục của Pi:
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills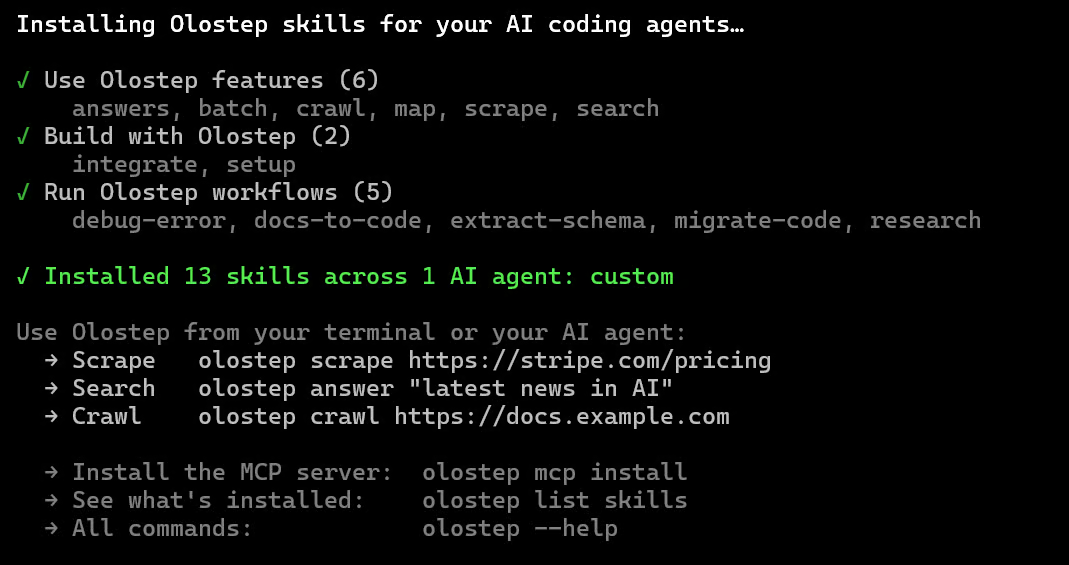
Nó cài kỹ năng Olostep vào:
~/.pi/agent/skills/Context7 cho phép Pi truy cập tài liệu thư viện hiện hành theo phiên bản và ví dụ mã. Điều này giúp tránh dùng API lỗi thời khi Pi làm việc với framework, SDK và gói Python thay đổi nhanh.
Trước khi cài đặt, hãy tạo tài khoản Context7, tạo khóa API từ bảng điều khiển Context7 và lưu cục bộ như biến môi trường tên CONTEXT7_API_KEY.
Giữ khóa riêng tư và không commit vào kho của bạn hay đưa vào ảnh chụp màn hình, notebook, hoặc tệp hướng dẫn dự án.
Cài gói Context7 chính thức cho Pi:
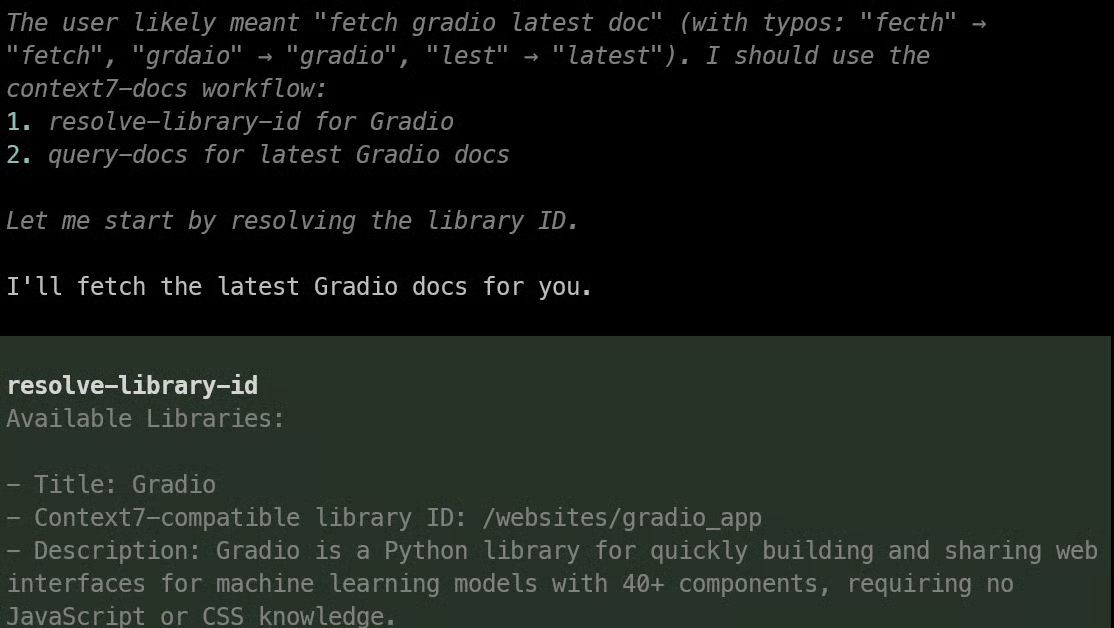
pi install npm:@upstash/context7-piĐiều này bổ sung công cụ tài liệu Context7, một kỹ năng hướng dẫn Pi dùng chúng khi cần và lệnh /c7-docs cho tra cứu thủ công.
Sau khi khởi động lại Pi, nó có thể lấy tài liệu liên quan trước khi viết mã phụ thuộc vào thư viện bên ngoài.
Pi hỗ trợ các gói chủ đề của bên thứ ba, giúp cải thiện giao diện terminal dễ dàng mà không thay đổi cách tác tử hoạt động.
Gói @spences10/pi-themes gồm nhiều chủ đề tối được trau chuốt như Catppuccin Mocha, Dracula, Gruvbox Dark, Nord, One Dark và Tokyo Night.
Cài gói chủ đề cộng đồng:
pi install npm:@spences10/pi-themesSau đó mở Pi:
piMở menu cài đặt:
/settings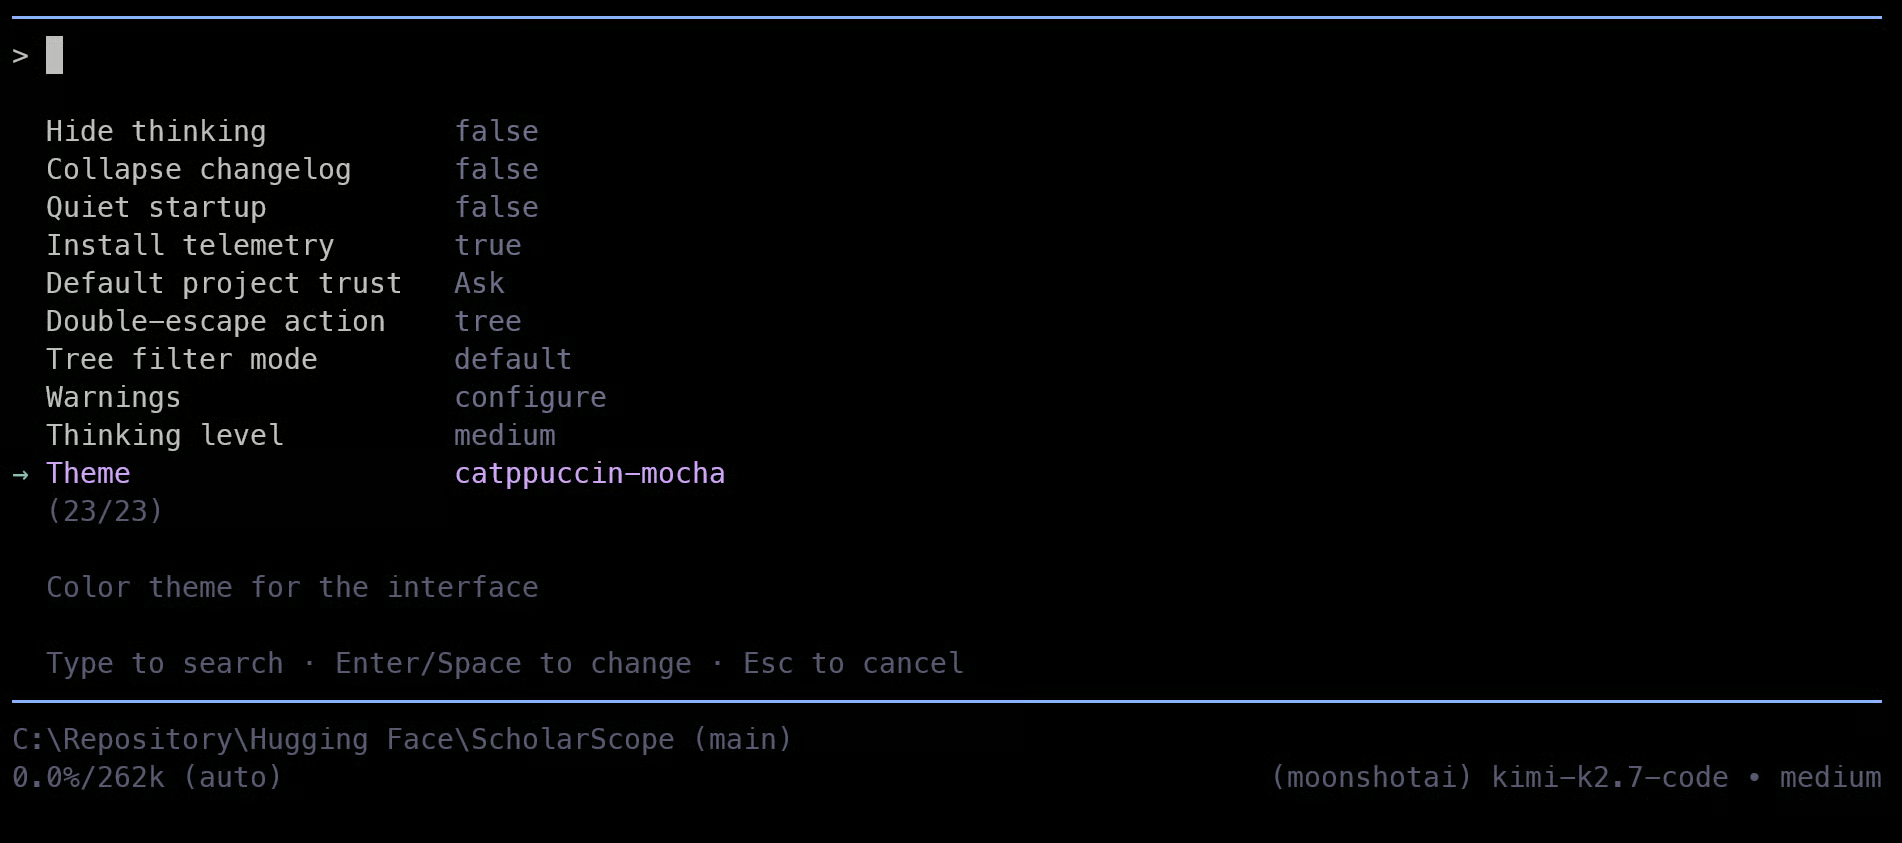
Chọn Catppuccin Mocha trong các chủ đề sẵn có. Đây là chủ đề tối sạch sẽ, độ tương phản tốt, phù hợp làm mặc định cho các phiên lập trình dài.
Bạn có thể chuyển chủ đề bất cứ lúc nào qua /settings. Pi cũng hỗ trợ chủ đề lưu cục bộ và chủ đề dạng gói, vì vậy bạn có thể tùy chỉnh giao diện sau này mà không cần thay đổi mô hình, công cụ hoặc thiết lập dự án.
Pi có thể được mở rộng với các quy trình kỹ thuật có thể tái dùng, giúp nó nhất quán hơn khi lập kế hoạch, gỡ lỗi, kiểm thử, rà soát mã, viết tài liệu và chuẩn bị dự án để bàn giao hoặc phát hành.
Gói @barlevalon/skills cung cấp các quy trình SKILL.md di động cho các tác vụ kỹ thuật phần mềm phổ biến này.
Cài gói kỹ năng:
pi install npm:@barlevalon/skills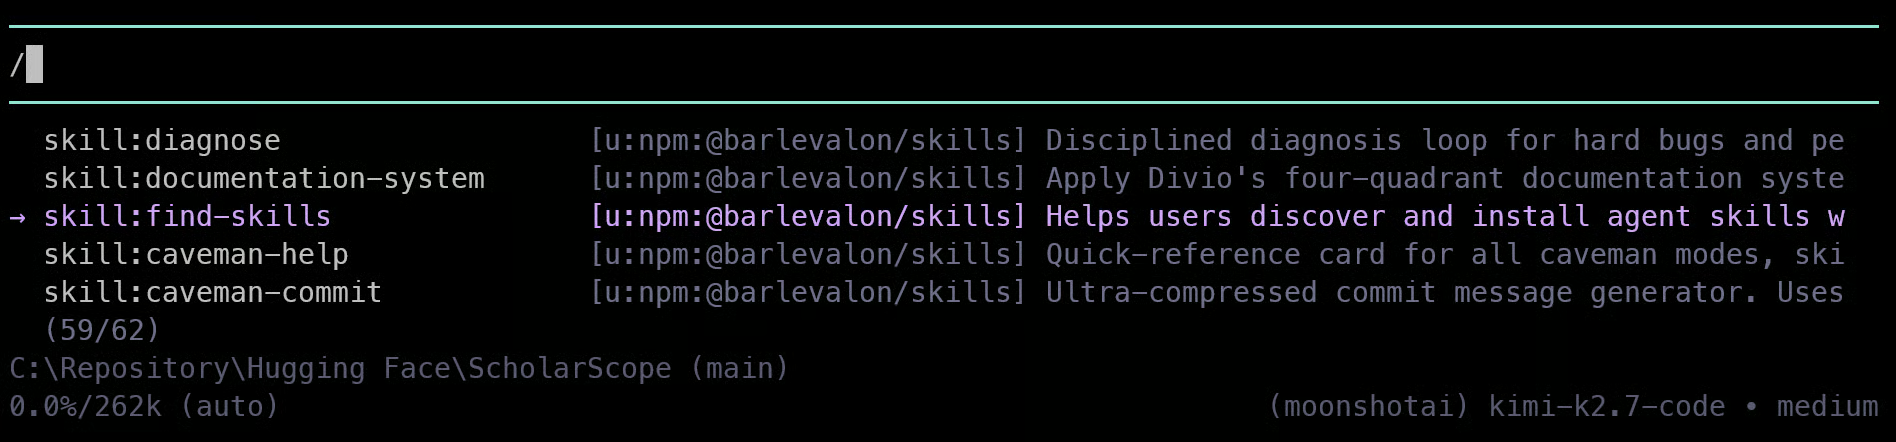
Tiếp theo, cài Hypa để ngăn đầu ra terminal dài chiếm dụng cửa sổ ngữ cảnh của Pi:
pi install npm:@hypabolic/pi-hypaHypa tự động viết lại các lệnh shell được hỗ trợ qua một lớp nén cục bộ. Nó giữ lại bằng chứng quan trọng như lỗi và kết quả cuối cùng, đồng thời giảm log lặp lại từ cài đặt gói, bộ kiểm thử, chạy mô hình, build và triển khai.
Gói Pi cũng cài Hypa như một phụ thuộc và tạo một shim lệnh hypa cục bộ theo khả năng tốt nhất.
Bạn không cần MCP, extension hay gói cho mọi dịch vụ bạn dùng.
Với các quy trình phổ biến như quản lý repository, triển khai ứng dụng, kiểm tra log hay xuất bản mô hình, một công cụ dòng lệnh đã xác thực thường đơn giản hơn, đáng tin cậy hơn và dễ dùng hơn cho Pi.
GitHub CLI cho phép Pi làm việc với repository, pull request, issue, phát hành và GitHub Actions trực tiếp từ terminal. Cài trên Windows với:
winget install --id GitHub.cli --source wingetSau đó đăng nhập:
gh auth loginDùng GitHub CLI khi bạn muốn Pi kiểm tra một repository, tạo hoặc rà soát pull request, kiểm tra lượt chạy workflow, quản lý issue hoặc xuất bản dự án lên GitHub.
Vercel CLI cho phép Pi triển khai ứng dụng web, kiểm tra dự án, xem log triển khai và quản lý biến môi trường từ terminal.
npm install -g vercel
vercel login
Dùng Vercel CLI cho triển khai preview, phát hành production, khắc phục sự cố triển khai, liên kết dự án và kiểm tra biến môi trường.
Công cụ dòng lệnh hiện tại của Hugging Face là hf, được đi kèm với gói huggingface_hub. Cài đặt với:
pip install -U huggingface_hubSau đó xác thực:
hf auth loginDùng Hugging Face CLI để tạo và quản lý kho mô hình, dataset và Space; tải lên tệp dự án; tải xuống mô hình hoặc dataset; và xác nhận tài khoản hiện đang xác thực.
Kiểm thử đơn vị hữu ích để kiểm tra logic Python, nhưng chúng không cho thấy người dùng thực có thể dùng ứng dụng của bạn hay không.
Webwright cho phép Pi chạy kiểm thử dựa trên trình duyệt với Playwright đối với ứng dụng cục bộ hoặc đã triển khai, bao gồm Streamlit, Gradio, front-end FastAPI, dự án React hoặc Next.js, bản preview Vercel và Hugging Face Spaces.
Cài Webwright trong Pi:
pi install npm:pi-webwrightSau đó cài Chromium cho Playwright:
npx playwright install chromium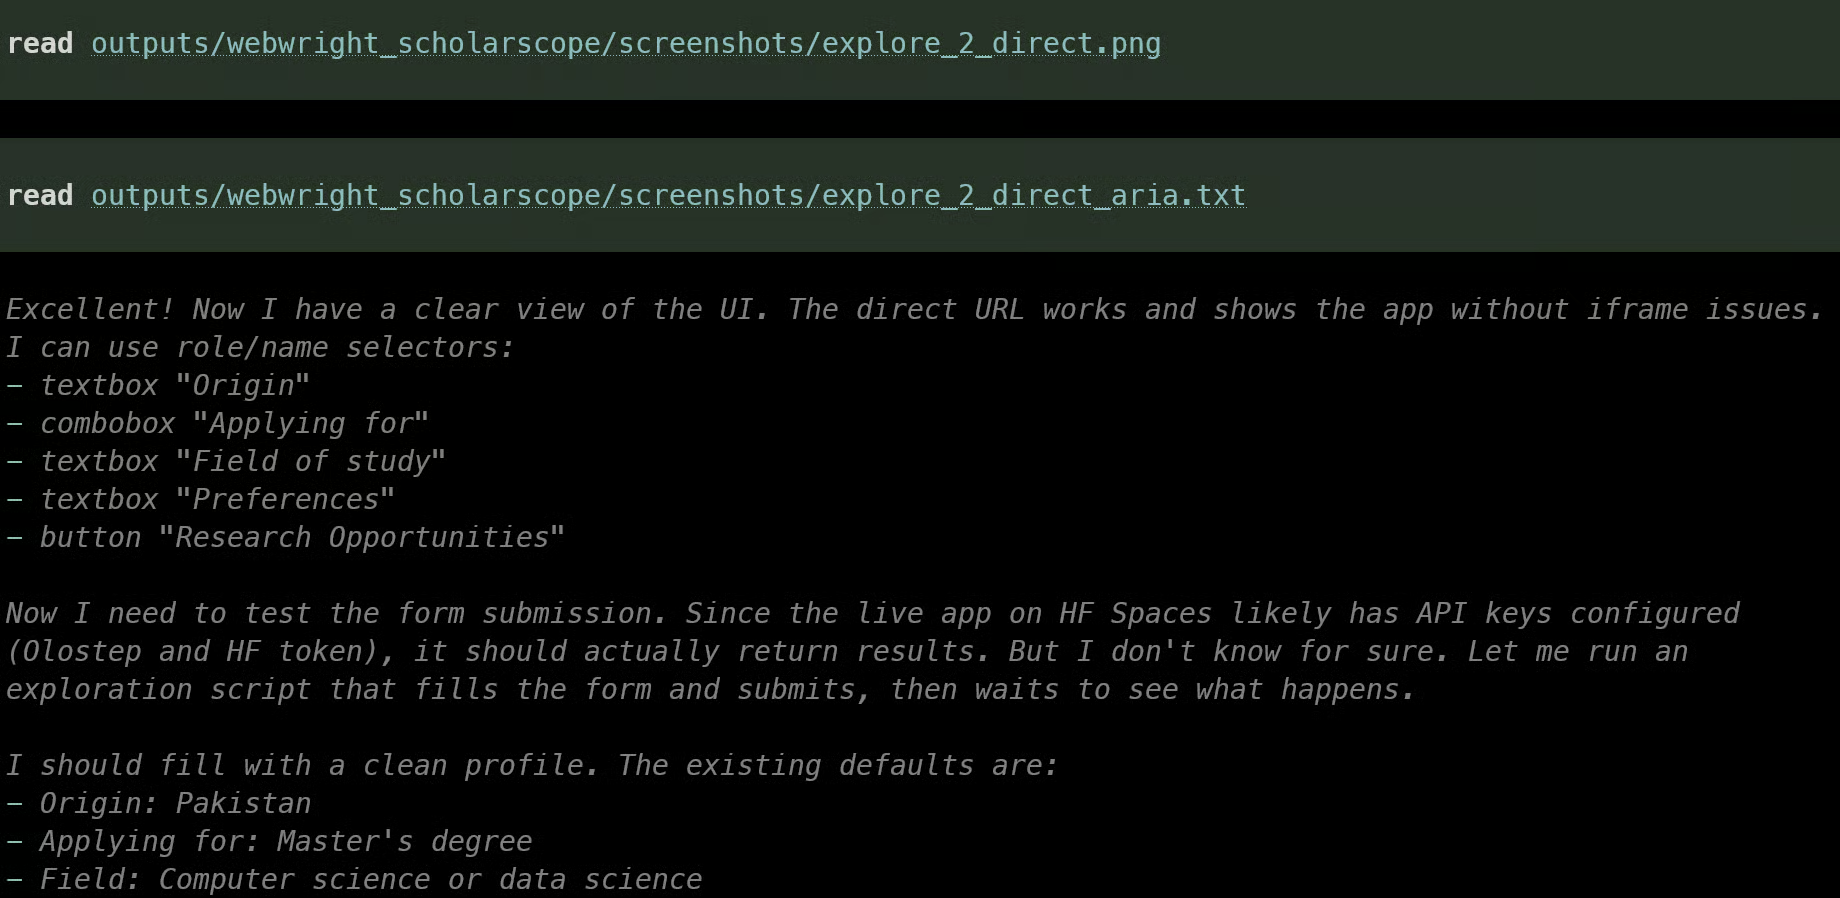
Webwright cho phép Pi mở ứng dụng trong Chromium, kiểm thử luồng người dùng chính, tương tác với biểu mẫu hoặc tải tệp, kiểm tra kết quả hiển thị đúng, kiểm tra lỗi trình duyệt và lưu ảnh chụp màn hình cùng log.
Gói này bao gồm một kỹ năng kiểm thử trình duyệt được thiết kế cho quy trình dựa trên hiện vật, có thể kiểm tra.
Pi bắt đầu mỗi phiên mới với ngữ cảnh hạn chế từ công việc trước đó.
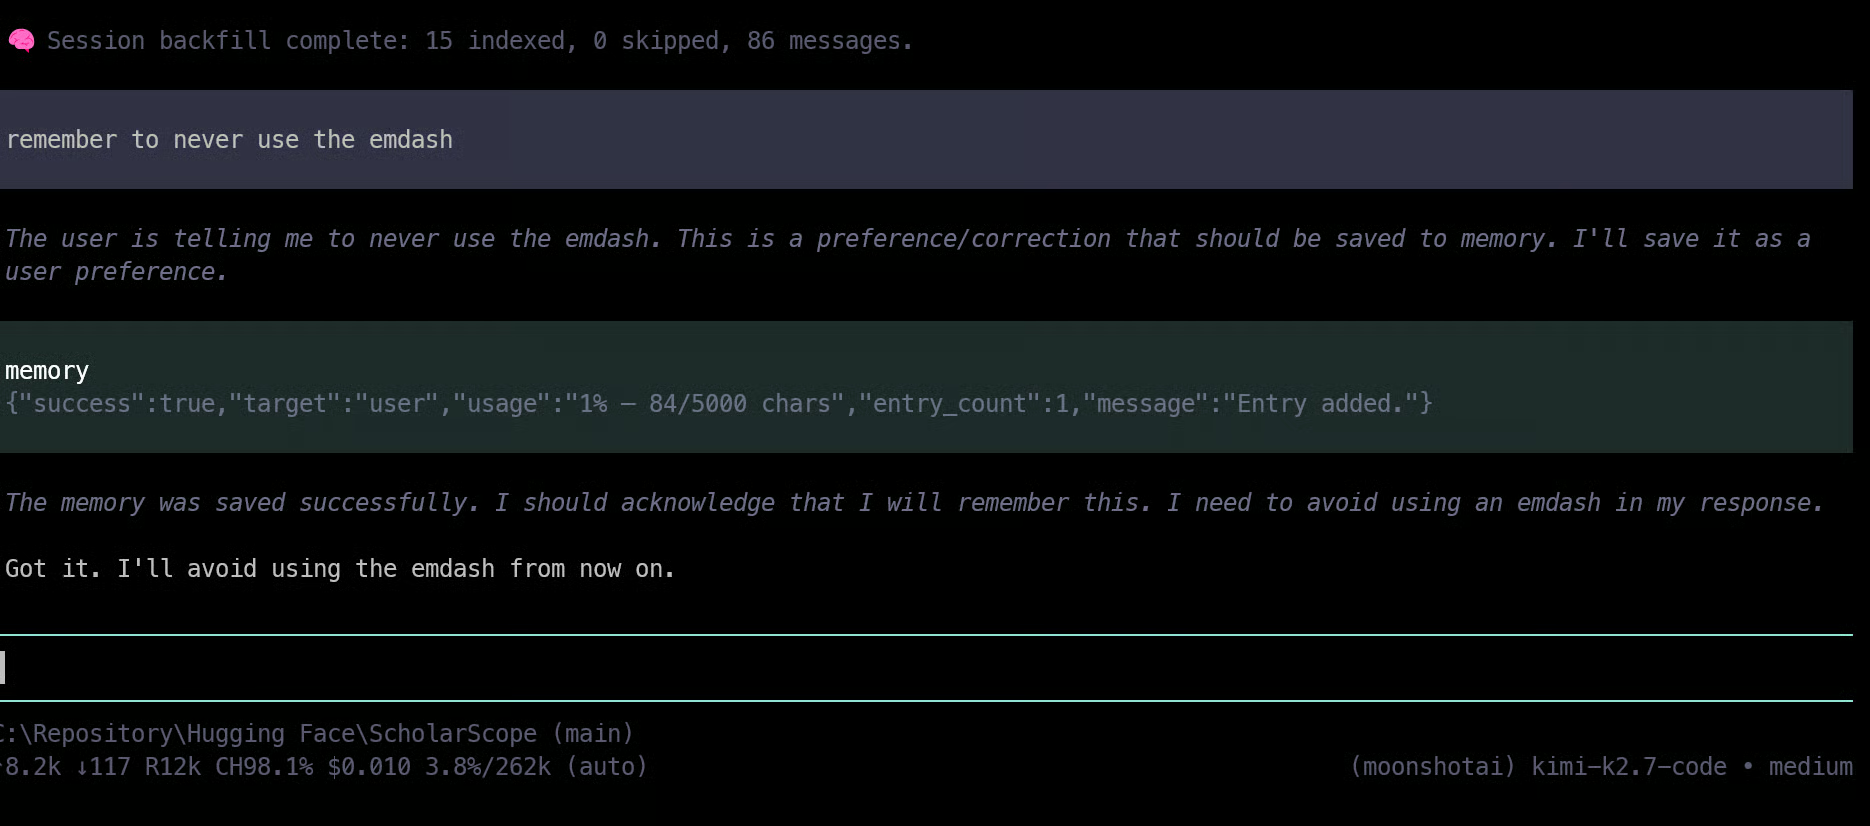
Hermes Memory bổ sung bộ nhớ cục bộ, bền vững để Pi có thể tìm kiếm các phiên trước, giữ lại ngữ cảnh hữu ích của dự án, hợp nhất thông tin lặp lại và quét tìm bí mật.
Nó chạy cục bộ, vì vậy bạn không cần khóa API bộ nhớ lưu trữ riêng.
Cài Hermes Memory:
pi install npm:pi-hermes-memoryKhởi động lại Pi sau khi cài đặt.
Dùng Hermes Memory song song với tài liệu dự án rõ ràng:
Giữ MEMORY.md và docs/decisions/ làm nguồn chân lý hiển thị cho dự án của bạn.
Hermes Memory giúp Pi tiếp tục công việc xuyên phiên, trong khi các tệp Markdown giúp bạn hoặc cộng tác viên khác dễ dàng kiểm tra ngữ cảnh sau này.
Một thiết lập Pi tốt cũng cần cấu trúc dự án rõ ràng.
Điều này giúp bạn tổ chức thí nghiệm, mã, kiểm thử, dữ liệu và kết quả, để Pi có thể thay đổi mà không lẫn lộn công việc tạm thời trong notebook với mã pipeline có thể tái dùng.
Tạo dự án mới và khởi tạo bằng uv:
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
Dùng cấu trúc này:
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
Giữ mã nạp dữ liệu, tiền xử lý, huấn luyện và đánh giá có thể tái dùng trong src/.
Chỉ dùng notebooks/ cho khám phá và thí nghiệm nhanh.
Lưu tệp nguồn chưa đổi ở data/raw/, dữ liệu đã làm sạch ở data/processed/, và lưu biểu đồ, chỉ số, đầu ra mô hình trong reports/.
Tạo tệp AGENTS.md để Pi làm theo đúng quy trình khi làm việc trong repository:
# Project Rules

- Use Olostep for current research and Context7 for library documentation.
- Inspect the dataset, missing values, duplicates, leakage risks, class balance, and baseline before training.
- Keep reusable logic in `src/`, not notebooks.
- Add tests when changing preprocessing or evaluation behaviour.
- Run formatting, linting, and tests before declaring work complete.
- Record important decisions in `docs/decisions/`.
Điều này mang đến cho Pi một quy trình lặp lại để xây dựng các dự án khoa học dữ liệu dễ kiểm thử, bảo trì và cải tiến.
Giờ là lúc kiểm thử toàn bộ thiết lập Pi trong một dự án thực. Trong ví dụ này, tôi yêu cầu Pi xây dựng một ứng dụng phân loại nhị phân có thể tái lập để dự đoán cơ hội được tuyển dụng của sinh viên dựa trên các yếu tố như thành tích học tập, thực tập, dự án, chứng chỉ và kỹ năng.
Khởi chạy Pi từ bên trong thư mục dự án của bạn:
piSau đó đưa cho Pi lời nhắc sau:
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
Sau khi quy trình mô hình hoạt động, hãy xây dựng một giao diện Streamlit hoặc Gradio nhỏ và kiểm thử nó trong Chromium với Webwright, bao gồm hành trình người dùng chính, hiển thị kết quả, lỗi console, ảnh chụp màn hình và log.
Báo cáo độ chính xác, F1 trọng số, F1 macro, so sánh baseline và ma trận nhầm lẫn. Khởi tạo và đẩy repository bằng GitHub CLI.
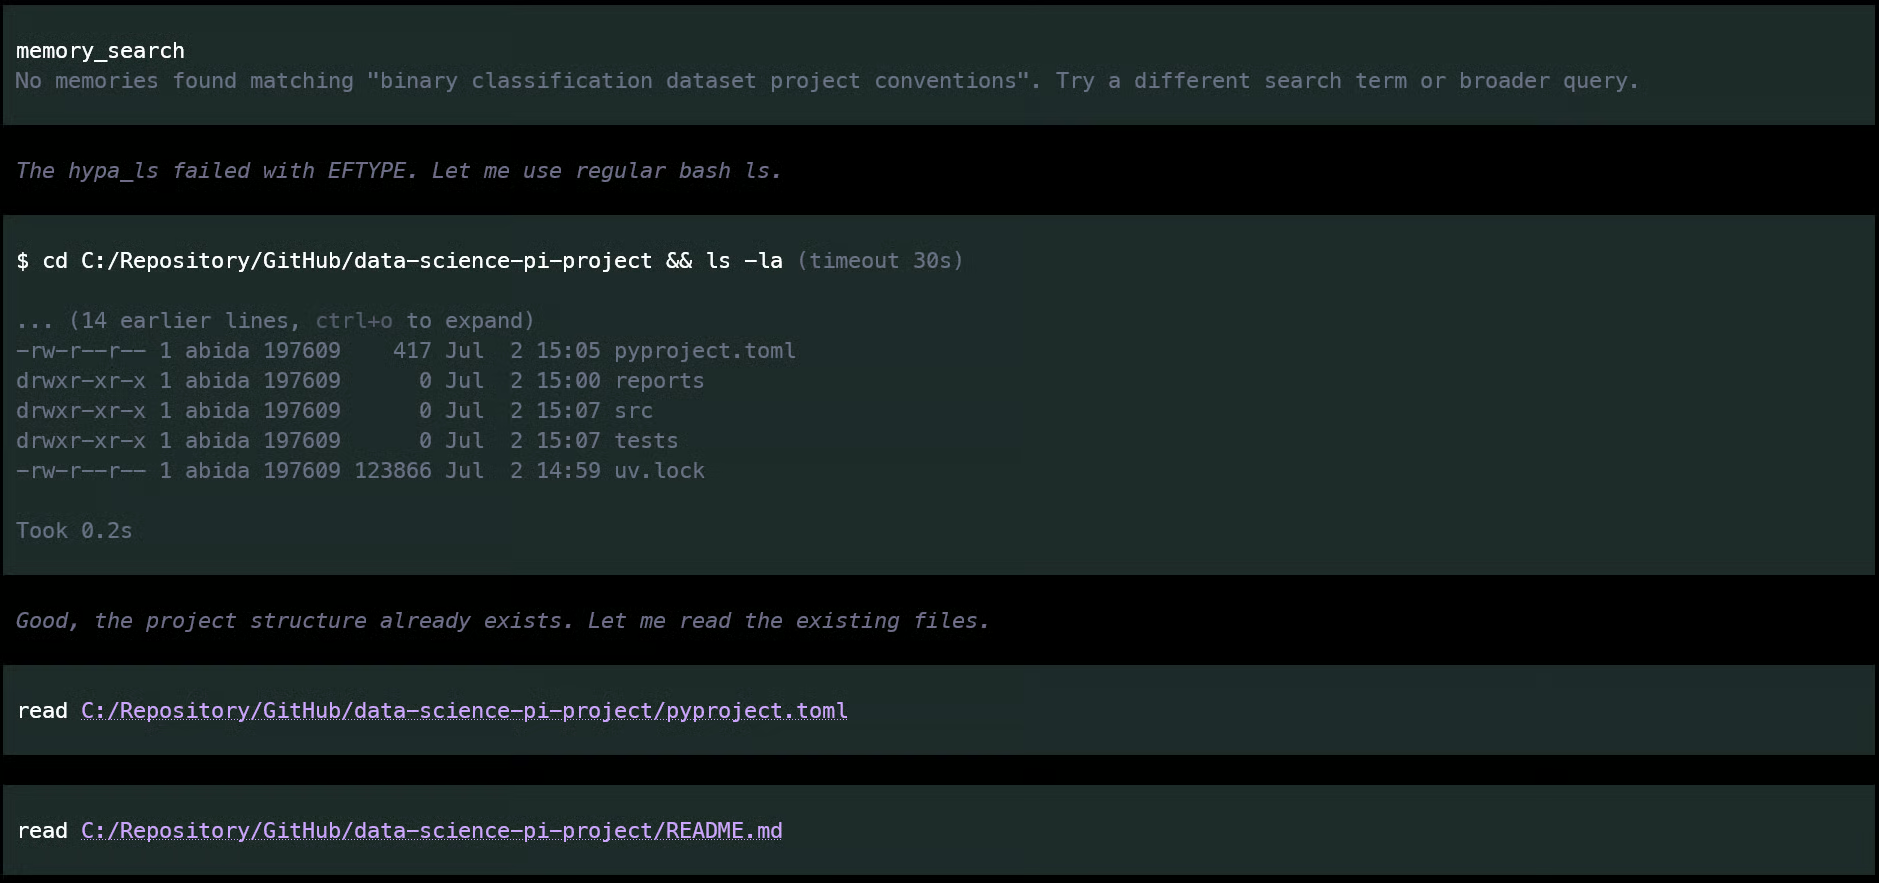
Pi đầu tiên kiểm tra Hermes Memory để tìm ngữ cảnh trước đó liên quan đến dự án.
Như ảnh chụp màn hình cho thấy, nó không tìm thấy gì hữu ích, nên chuyển sang kiểm tra thư mục dự án hiện tại.
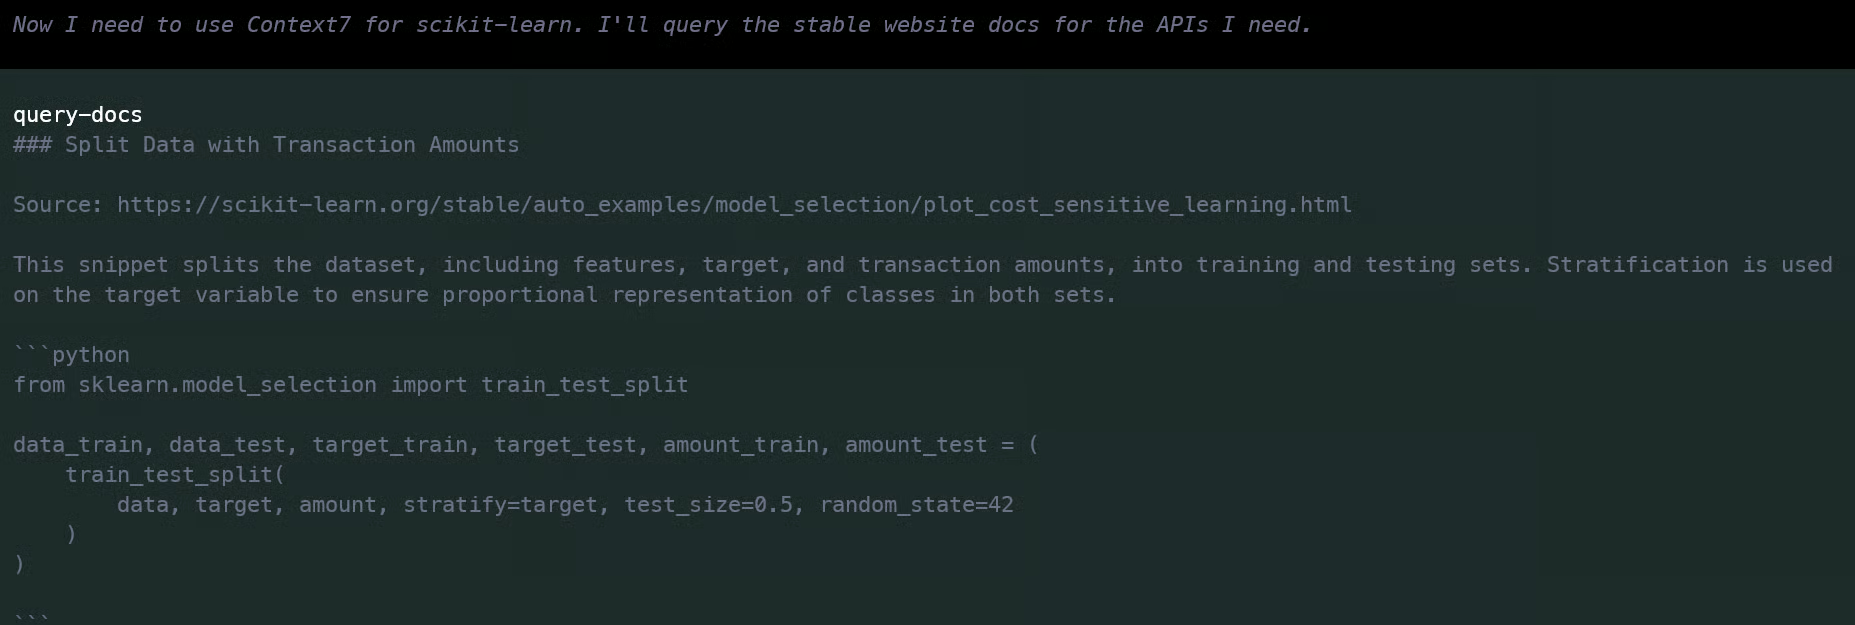
Khi đã hiểu cấu trúc thư mục, Pi dùng Context7 để kiểm tra tài liệu Python và scikit-learn hiện tại trước khi viết các tệp dự án.
Điều này hữu ích vì nó giúp tác tử dùng API hiện hành thay vì dựa vào ví dụ lỗi thời.
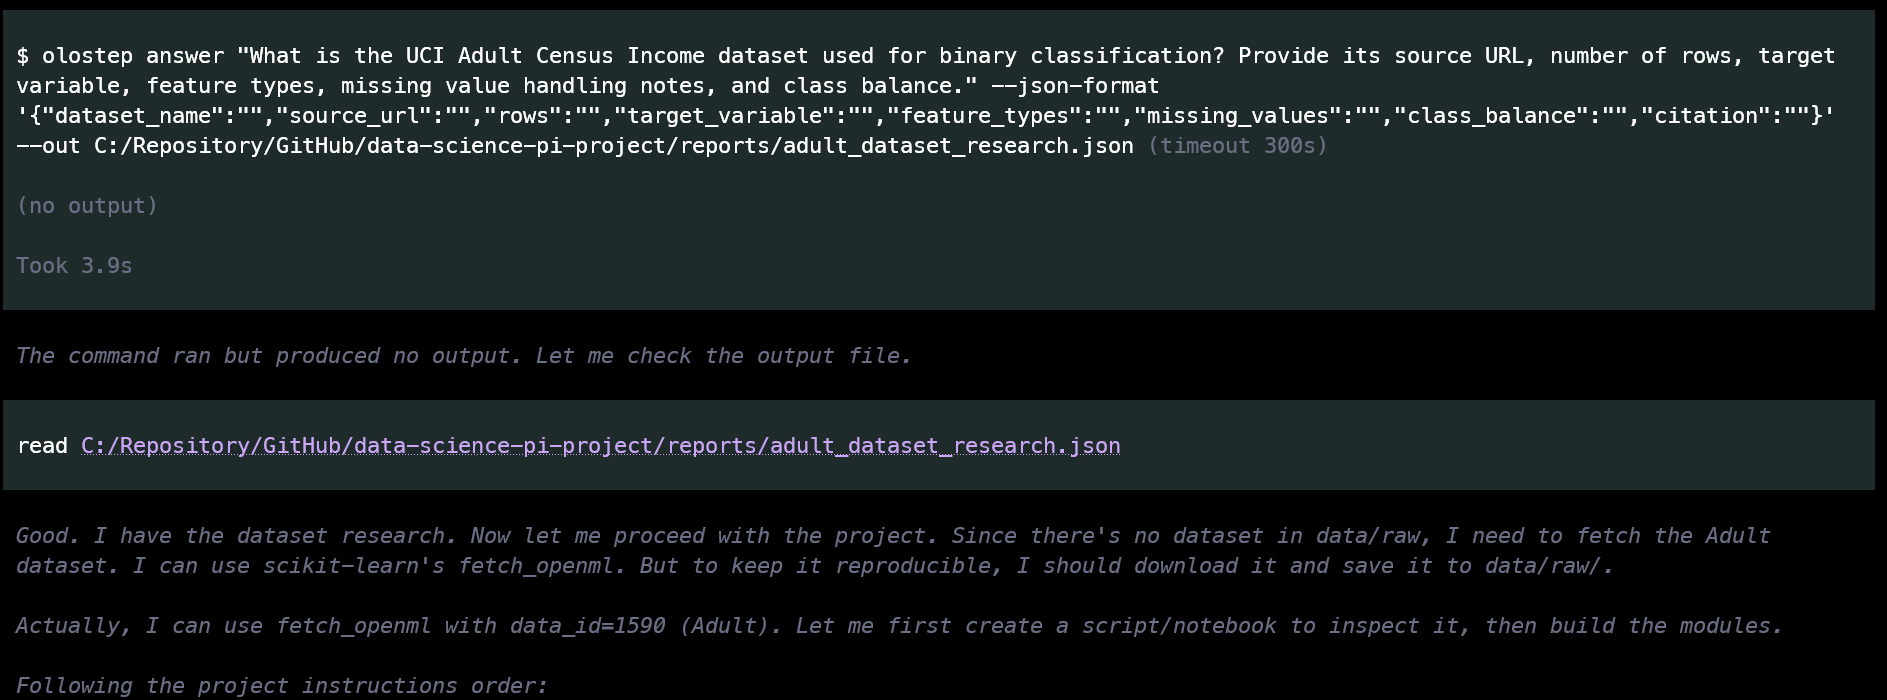
Tiếp theo, Pi dùng kỹ năng nghiên cứu Olostep để tìm dataset phù hợp và thu thập thông tin liên quan cho dự án.
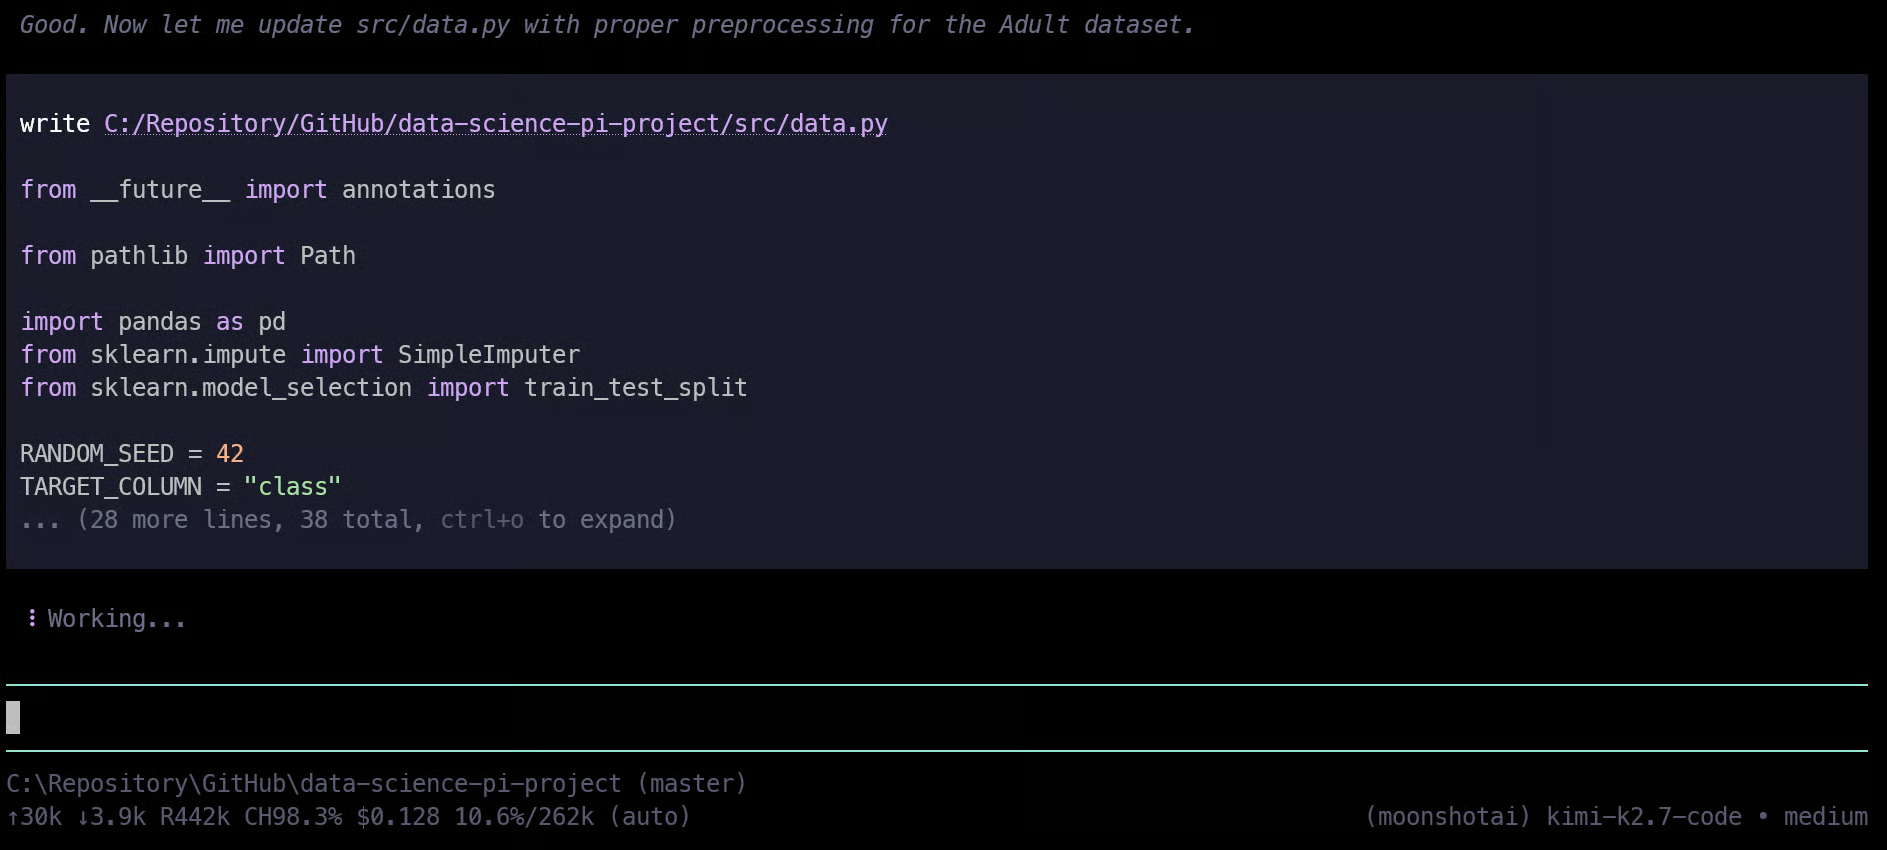
Sau khi thu thập đủ ngữ cảnh, nó bắt đầu tạo tệp lần lượt, bao gồm pipeline tiền xử lý, mã huấn luyện, script đánh giá, kiểm thử, README và hướng dẫn dự án.
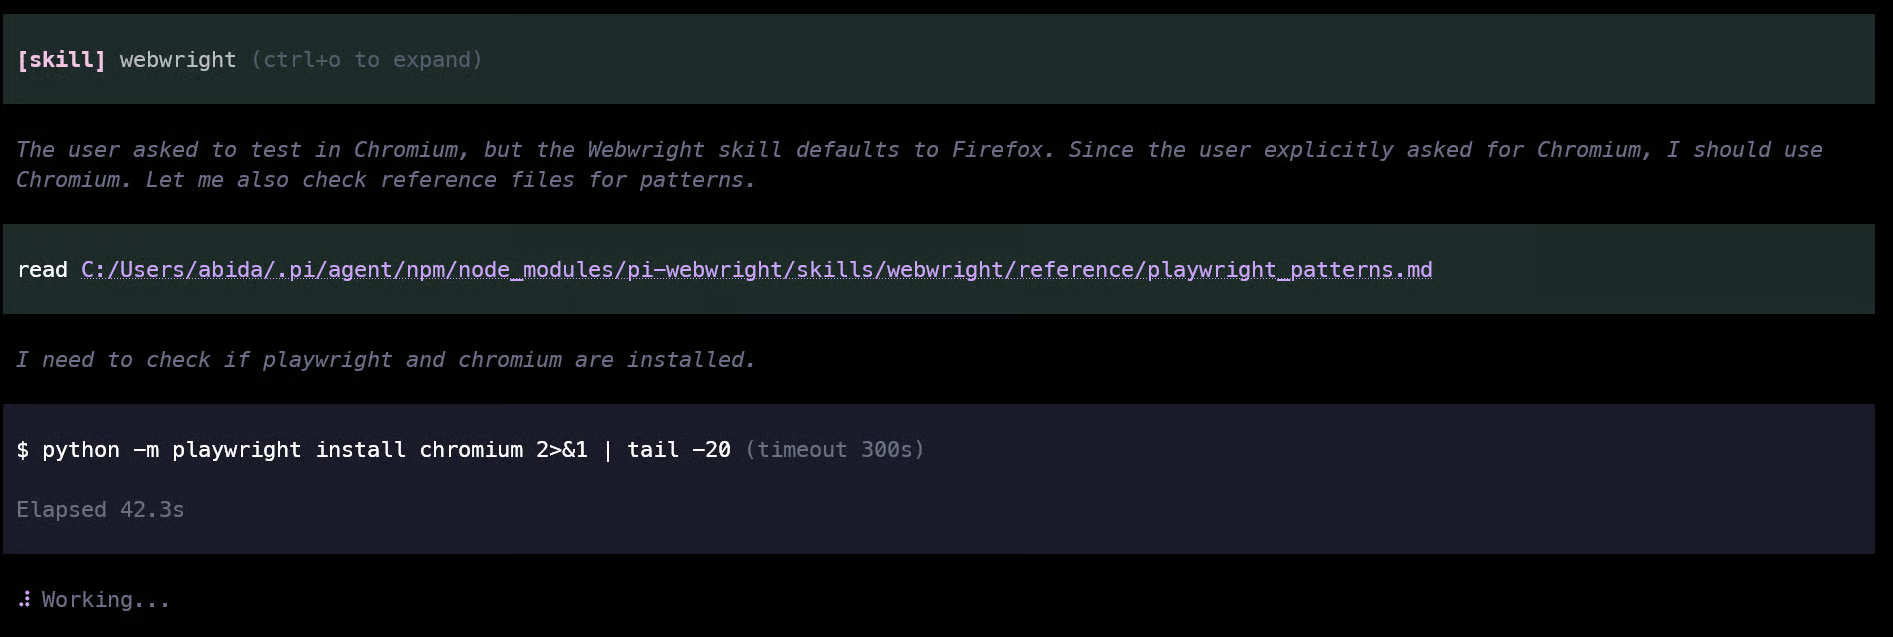
Sau khi quy trình học máy hoàn tất, Pi tạo một ứng dụng Streamlit nhỏ.
Sau đó nó cài Chromium cho Playwright và dùng Webwright để kiểm thử giao diện trong trình duyệt thực.
Bài kiểm thử trên trình duyệt kiểm tra luồng người dùng chính, xác minh kết quả hiển thị đúng, kiểm tra lỗi console và lưu ảnh chụp màn hình cùng log.
Pi cũng chạy kiểm thử Python và kiểm tra dự án trước khi tạo tóm tắt cuối cùng.
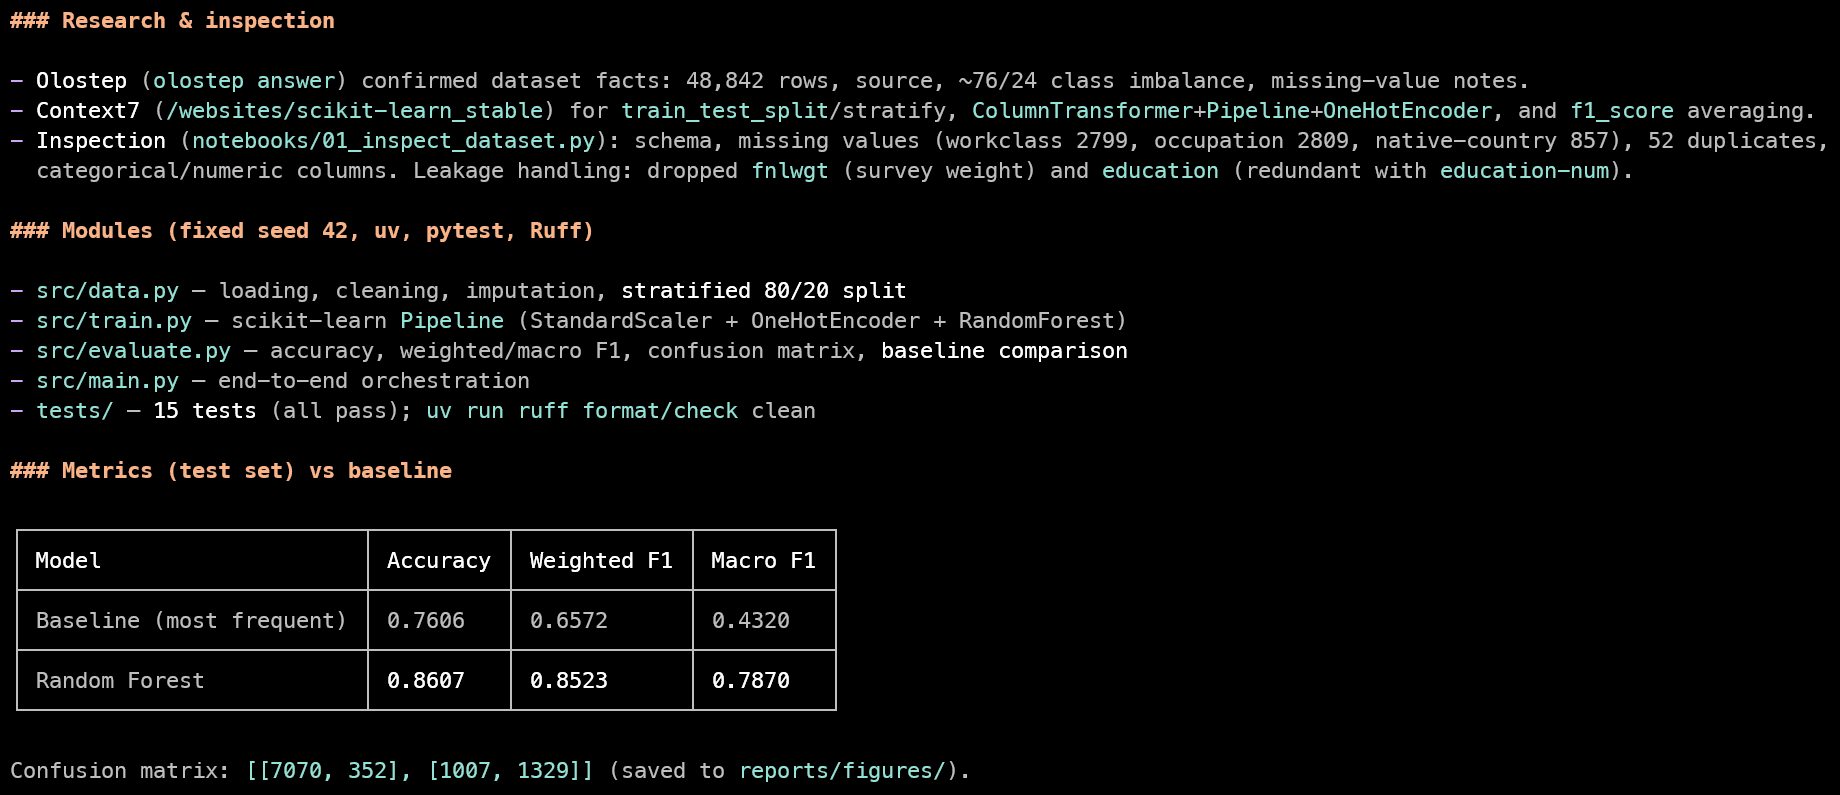
Trong bài kiểm thử này, mô hình cuối đạt khoảng 86% độ chính xác và điểm F1 0,85.
Sau đó Pi commit thay đổi, tạo một repository GitHub và đẩy toàn bộ dự án lên GitHub.
Repository bao gồm README, cấu trúc dự án, mã nguồn, kiểm thử, tệp đánh giá mô hình và ứng dụng Streamlit:
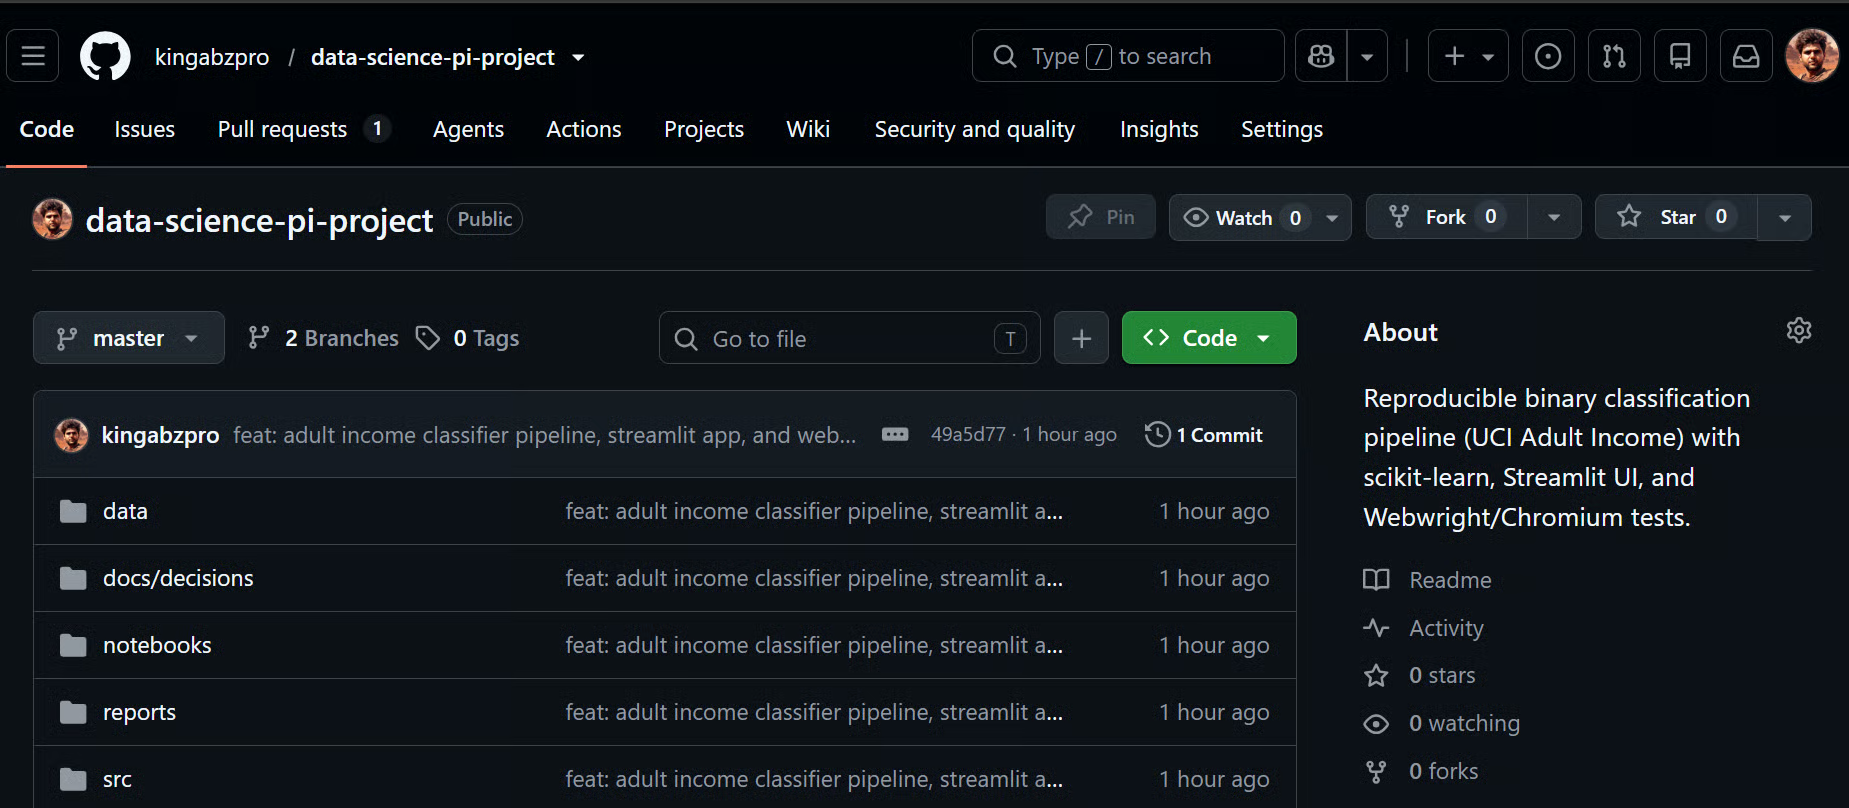
Nguồn: kingabzpro/data-science-pi-project
Bạn có thể chạy ứng dụng cục bộ với:
streamlit run app.py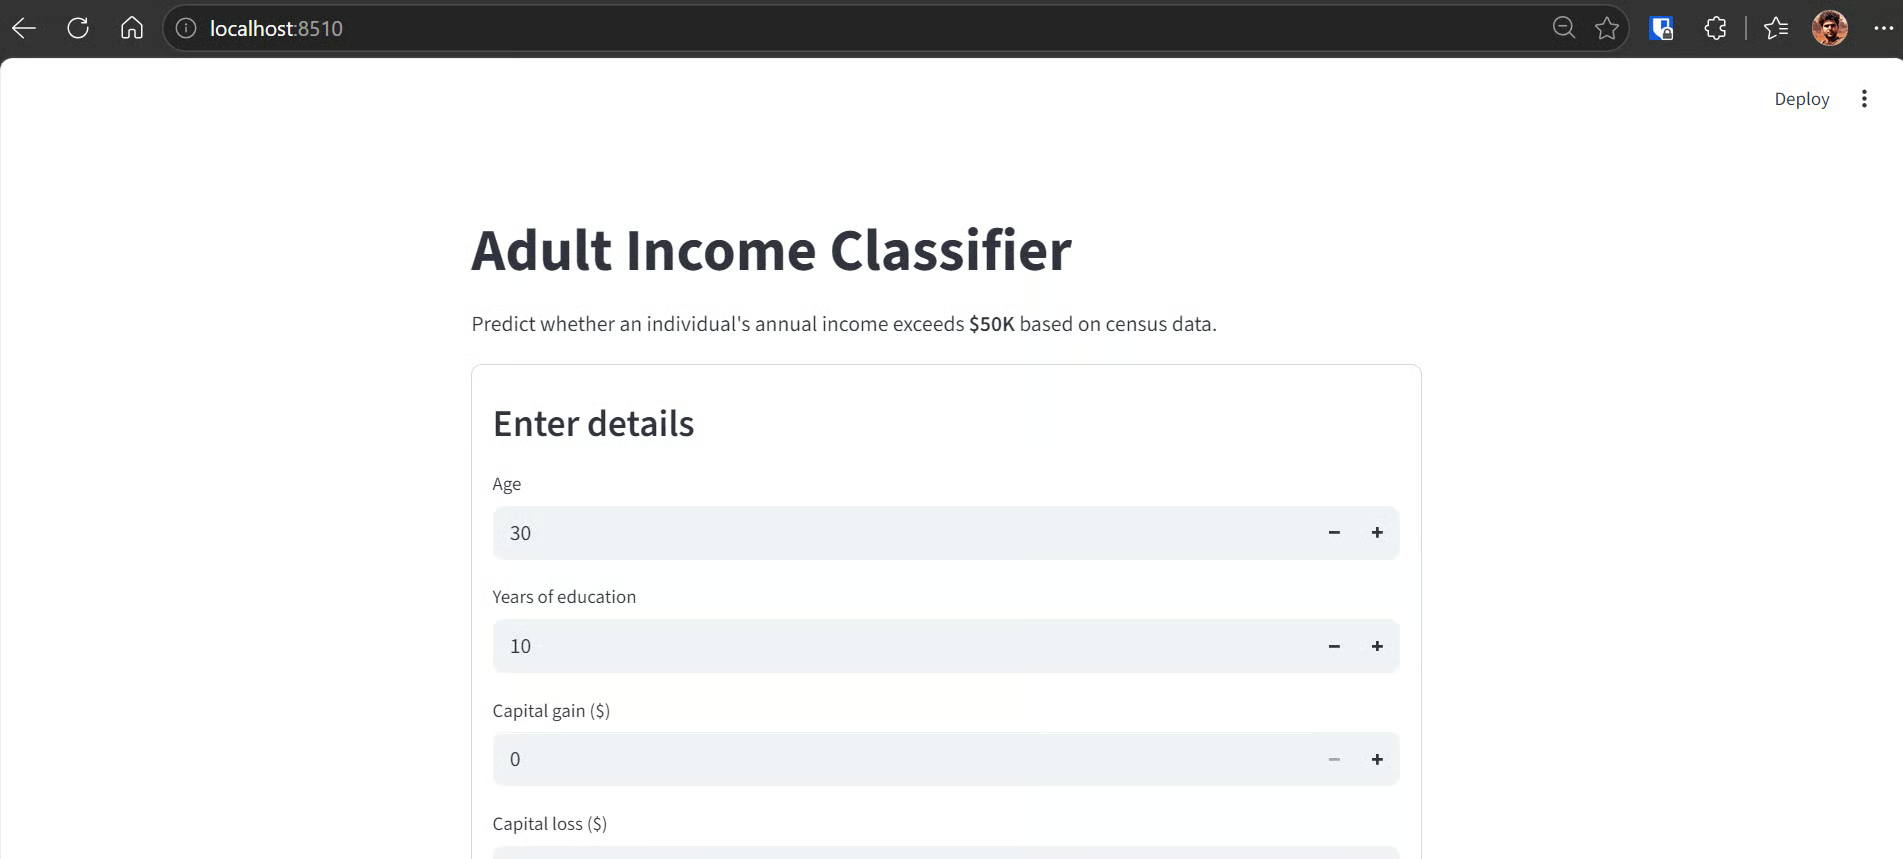
Giao diện sạch, dễ điều hướng và mô hình trả kết quả nhanh.
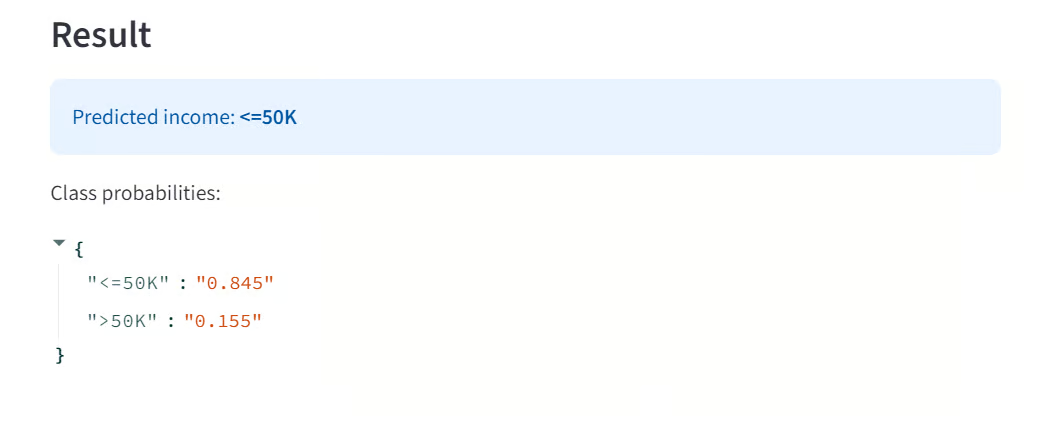
Quan trọng hơn, bài kiểm thử này cho thấy giá trị của toàn bộ thiết lập: Pi có thể nghiên cứu tác vụ, kiểm tra dữ liệu, dùng tài liệu cập nhật, xây dựng pipeline, tạo giao diện, kiểm thử trải nghiệm trình duyệt, xác thực mô hình và xuất bản dự án hoàn chỉnh chỉ trong một quy trình.
Kimi K2.7 Code và Pi đã chứng tỏ là một bộ đôi mạnh mẽ cho công việc lập trình thực tế.
Kimi nhanh, mạnh và xử lý tốt các tác vụ kỹ thuật nhiều bước mà không làm phức tạp hóa các quyết định đơn giản.
Nếu bạn dùng API thay vì gói đăng ký lập trình, cân nhắc nạp ít nhất $10 tín dụng để truy cập bậc sử dụng cao hơn và tránh chạm giới hạn hằng ngày quá nhanh.
Điều khiến tôi ấn tượng nhất là quy trình gần như không cần điều phối thủ công sau khi mọi thứ được thiết lập.
Chỉ với một lời nhắc chi tiết, Pi kiểm tra Hermes Memory để tìm ngữ cảnh dự án liên quan, rà soát thư mục dự án, dùng Context7 để xác minh tài liệu Streamlit và scikit-learn hiện hành, và dùng Olostep để nghiên cứu dataset và thiết lập bài toán.
Từ đó, nó tạo tệp dự án, xây pipeline học máy, phát triển ứng dụng Streamlit và kiểm thử giao diện với Webwright và Playwright.
Pi cũng chạy kiểm thử Python, kiểm tra chỉ số mô hình, rà soát hành vi trình duyệt, tạo tóm tắt cuối, commit thay đổi và đẩy repository hoàn chỉnh lên GitHub.
Tổng thể, thiết lập này giống như đưa ra chỉ dẫn rõ ràng cho một quy trình phát triển tự động hơn là tự tay quản lý một trợ lý lập trình.
Khi đã kết nối đúng công cụ, Pi đảm nhiệm phần lớn khối lượng công việc, còn Kimi cung cấp tốc độ và suy luận cần thiết để giữ cho quá trình trôi chảy.
Muốn đi sâu hơn vào cách tác tử AI vận hành bên dưới? Tôi khuyên bạn học khóa Building Scalable Agentic Systems của DataCamp để tìm hiểu nguyên tắc thiết kế, khung kiểm thử và các giao thức (như MCP) cần thiết để đưa tác tử AI từ thử nghiệm đến sản xuất.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
