
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
11.1K
Kimi K2.7 Code Moonshot का फ़्लैगशिप कोडिंग मॉडल है, जिसे व्यावहारिक सॉफ़्टवेयर डेवलपमेंट कार्यों—जैसे कोड लिखना और डिबग करना, बड़े कोडबेस में नेविगेट करना, और मल्टी-स्टेप इंजीनियरिंग काम संभालना—के लिए बनाया गया है।
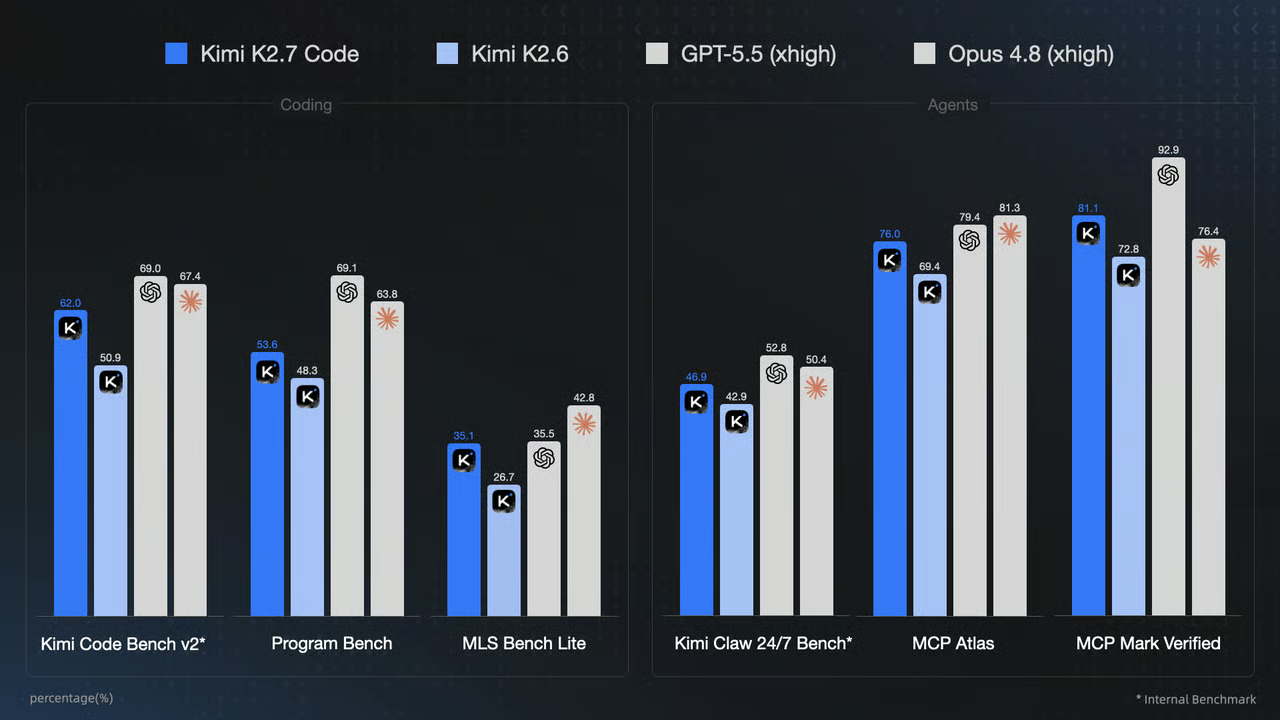
स्रोत: Kimi K2.7 Code: ओपन-सोर्स एजेंटिक कोडिंग मॉडल
इसे Pi—एक हल्का और अत्यधिक एक्स्टेंसिबल कोडिंग एजेंट—के साथ पेयर करने पर यह एक लचीला लोकल डेवलपमेंट वातावरण बनाता है जो स्किल्स, पैकेज, कमांड-लाइन टूल, स्थायी मेमोरी और ब्राउज़र टेस्टिंग को बिना अनावश्यक जटिलता जोड़े सपोर्ट करता है।
हर कार्य के लिए MCP इंस्टॉल करने के बजाय, Pi Kimi की तर्क-क्षमता को भरोसेमंद डेवलपर टूल्स—जैसे GitHub CLI, Vercel CLI, Hugging Face CLI, pytest, Ruff, और uv—के साथ जोड़ सकता है।
इससे एक ही कोडिंग-एजेंट वर्कफ़्लो से वास्तविक प्रोजेक्ट्स पर रिसर्च, बिल्ड, टेस्ट, डिप्लॉय और मेंटेन करना संभव हो जाता है।
इस गाइड में, मैं आपको शुरू से अंत तक Pi के साथ Kimi K2.7 Code सेट अप करना सिखाऊंगा।
आप अपना Moonshot API की कॉन्फ़िगर करेंगे, रिसर्च के लिए Olostep, नवीनतम डॉक्यूमेंटेशन के लिए Context7, ब्राउज़र टेस्टिंग के लिए Webwright, और क्रॉस-सेशन संदर्भ के लिए Hermes Memory जोड़ेंगे।
आप उपयोगी थीम्स और इंजीनियरिंग स्किल्स भी इंस्टॉल करेंगे, GitHub, Vercel, और Hugging Face के व्यावहारिक CLI से कनेक्ट करेंगे, एक पुनरुत्पाद्य Python डेटा-साइंस प्रोजेक्ट बनाएँगे, और एक छोटा मशीन लर्निंग एप्लिकेशन बनाकर, वैलिडेट कर के और प्रकाशित करके पूरे वर्कफ़्लो का परीक्षण करेंगे।
मैं यह गाइड भी देखने की सलाह देता/देती हूँ: Kimi K2.7 Code को लोकली कैसे चलाएँ.
Pi एक हल्का कोडिंग एजेंट है जो सीधे आपके टर्मिनल में चलता है।
यह आपके लोकल फ़ाइलों के साथ काम कर सकता है, कमांड चला सकता है, इंस्टॉल की गई स्किल्स और पैकेज का उपयोग कर सकता है, और आपके पसंदीदा कोडिंग मॉडल से कनेक्ट हो सकता है।
अपने ऑपरेटिंग सिस्टम के लिए इंस्टॉलेशन कमांड चुनें।
Windows PowerShell
powershell -c "irm https://pi.dev/install.ps1 | iex"macOS या Linux
curl -fsSL https://pi.dev/install.sh | shआप npm के माध्यम से भी Pi इंस्टॉल कर सकते हैं:
npm install -g --ignore-scripts @earendil-works/pi-coding-agentPi में Kimi K2.7 Code का उपयोग करने से पहले, अपना Moonshot API की एक environment variable के रूप में जोड़ें।
इसके बाद जब आप मॉडल प्रोवाइडर के रूप में Moonshot चुनेंगे, तो Pi स्वचालित रूप से इस की तक पहुँच सकता है।
Windows PowerShell
setx MOONSHOT_API_KEY "your_moonshot_api_key"इस कमांड को चलाने के बाद PowerShell को बंद करके फिर खोलें। नया environment variable केवल नये खुले टर्मिनल सेशंस में उपलब्ध होगा।
Git Bash, macOS, या Linux
export MOONSHOT_API_KEY="your_moonshot_api_key"यह कमांड केवल मौजूदा टर्मिनल सेशन पर लागू होती है। टर्मिनल रीस्टार्ट करने के बाद भी की उपलब्ध रखने के लिए, यही लाइन अपने शेल प्रोफ़ाइल, जैसे ~/.bashrc या ~/.zshrc में जोड़ें।
अपनी API की को निजी रखें। इसे Git रिपॉजिटरी, सार्वजनिक नोटबुक, स्क्रीनशॉट्स, .env.example फ़ाइलों या AGENTS.md में न जोड़ें।
की सेट हो जाने पर, Pi लॉन्च करें:
piफिर मॉडल सेलेक्टर खोलें:
/model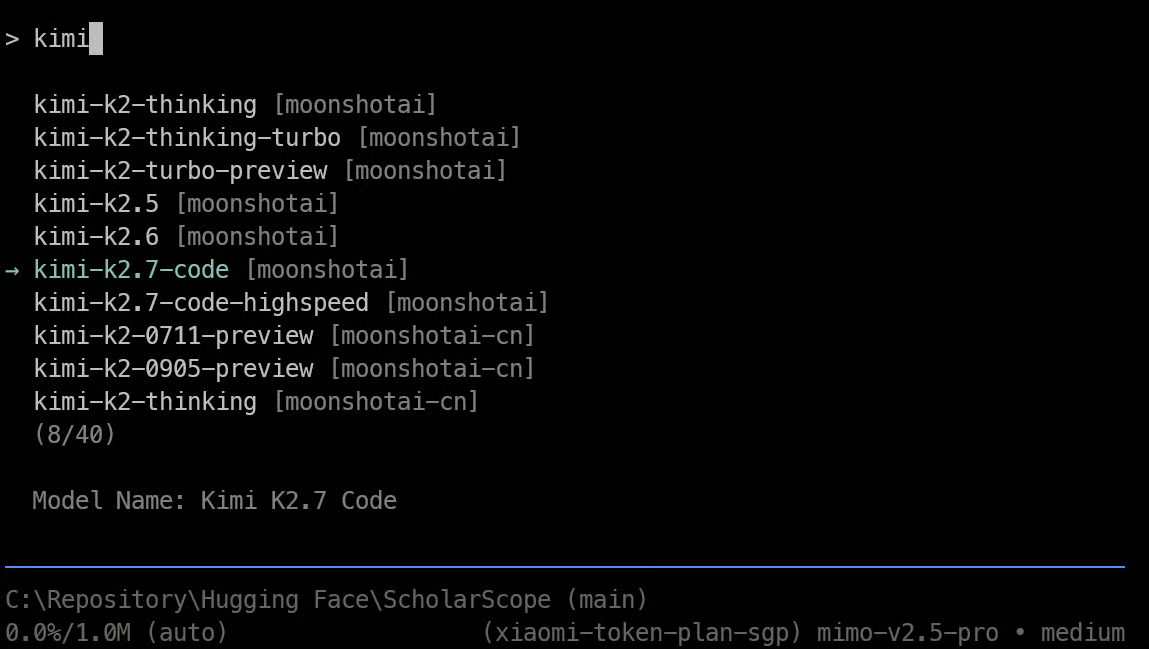
प्रोवाइडर के रूप में moonshotai चुनें और kimi-k2.7-code सेलेक्ट करें।
Pi को स्वचालित रूप से MOONSHOT_API_KEY environment variable का पता चल जाना चाहिए और यह ऑथेंटिकेशन के लिए इसका उपयोग करेगा।
Olostep Pi को वेब सर्च, स्क्रैपिंग, डॉक्यूमेंटेशन क्रॉलिंग, डिबगिंग और स्ट्रक्चर्ड डेटा एक्सट्रैक्शन जैसे रिसर्च वर्कफ़्लो तक पहुँच देता है।
जब किसी कार्य के लिए मॉडल के बिल्ट-इन नॉलेज से अधिक की ज़रूरत हो, तब यह Pi को वर्तमान जानकारी खोजने में मदद करता है।
आगे बढ़ने से पहले, एक Olostep खाता बनाएँ, एक API की जनरेट करें, और इसे लोकली OLOSTEP_API_KEY नामक environment variable के रूप में सहेजें।
इससे Pi और इसके द्वारा बनाए गए किसी भी स्क्रिप्ट को आपके प्रोजेक्ट फ़ाइलों में सीक्रेट्स स्टोर किए बिना Olostep के साथ ऑथेंटिकेट करने की सुविधा मिलती है।
इसके बाद, Olostep स्किल्स को सीधे Pi की ग्लोबल स्किल्स डायरेक्टरी में इंस्टॉल करें:
npx -y olostep-cli@latest add skills \
 --no-global \
 --agent-skills-dir ~/.pi/agent/skills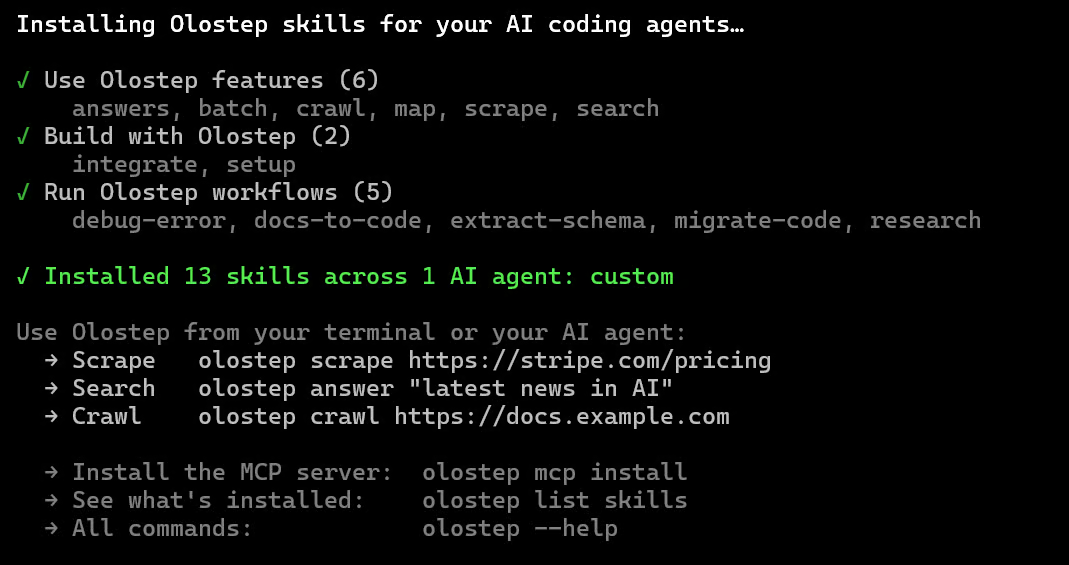
यह Olostep स्किल्स को यहाँ इंस्टॉल करता है:
~/.pi/agent/skills/Context7 Pi को वर्तमान, संस्करण-विशिष्ट लाइब्रेरी डॉक्यूमेंटेशन और कोड उदाहरणों तक पहुँच देता है। यह तेज़ी से बदलते फ़्रेमवर्क, SDKs और Python पैकेज के साथ काम करते समय पुरानी API उपयोग से बचाता है।
इंस्टॉलेशन से पहले, एक Context7 खाता बनाएँ, Context7 डैशबोर्ड से API की जनरेट करें, और इसे लोकली CONTEXT7_API_KEY नामक environment variable के रूप में सहेजें।
की को निजी रखें और इसे अपनी रिपॉजिटरी में कमिट न करें या स्क्रीनशॉट्स, नोटबुक्स, या प्रोजेक्ट निर्देश फ़ाइलों में शामिल न करें।
Pi के लिए आधिकारिक Context7 पैकेज इंस्टॉल करें:
pi install npm:@upstash/context7-piयह Context7 डॉक्यूमेंटेशन टूल्स, उन्हें ज़रूरत पड़ने पर उपयोग करने के लिए Pi को मार्गदर्शित करने वाली एक स्किल, और मैनुअल लुकअप के लिए /c7-docs कमांड जोड़ता है।
Pi को रीस्टार्ट करने के बाद, यह बाहरी लाइब्रेरी पर निर्भर कोड लिखने से पहले प्रासंगिक डॉक्यूमेंटेशन प्राप्त कर सकता है।
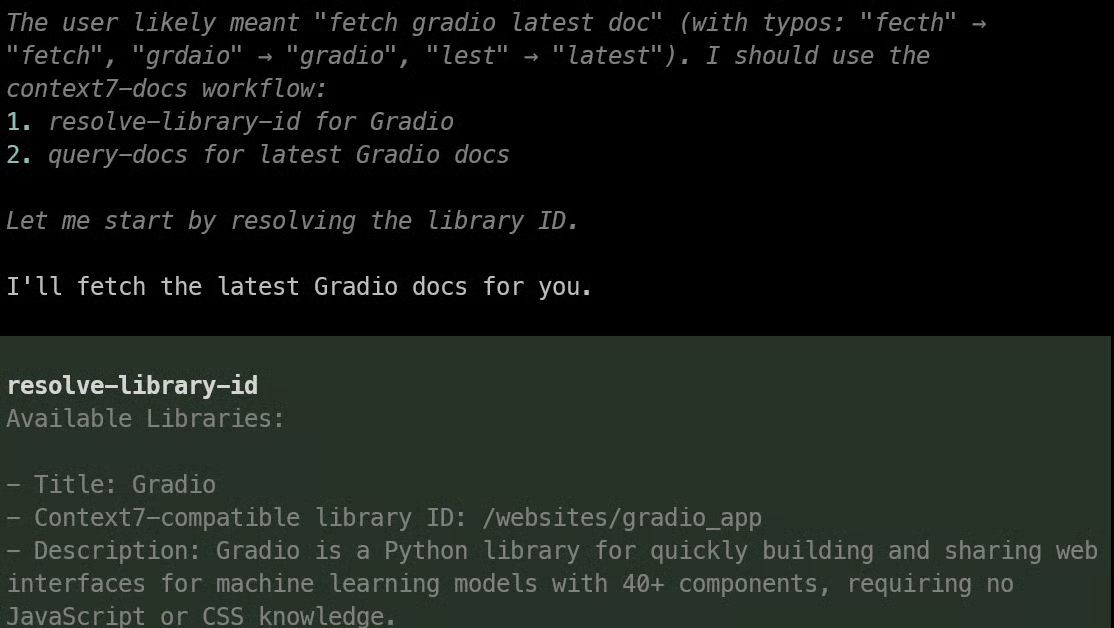
Pi थर्ड-पार्टी थीम पैकेज सपोर्ट करता है, जिससे एजेंट के काम करने के तरीके को बदले बिना टर्मिनल इंटरफ़ेस को बेहतर बनाना आसान हो जाता है।
@spences10/pi-themes पैकेज में कई परिष्कृत डार्क थीम्स शामिल हैं, जैसे Catppuccin Mocha, Dracula, Gruvbox Dark, Nord, One Dark, और Tokyo Night।
कम्युनिटी थीम पैकेज इंस्टॉल करें:
pi install npm:@spences10/pi-themesफिर Pi खोलें:
piसेटिंग्स मेनू खोलें:
/settings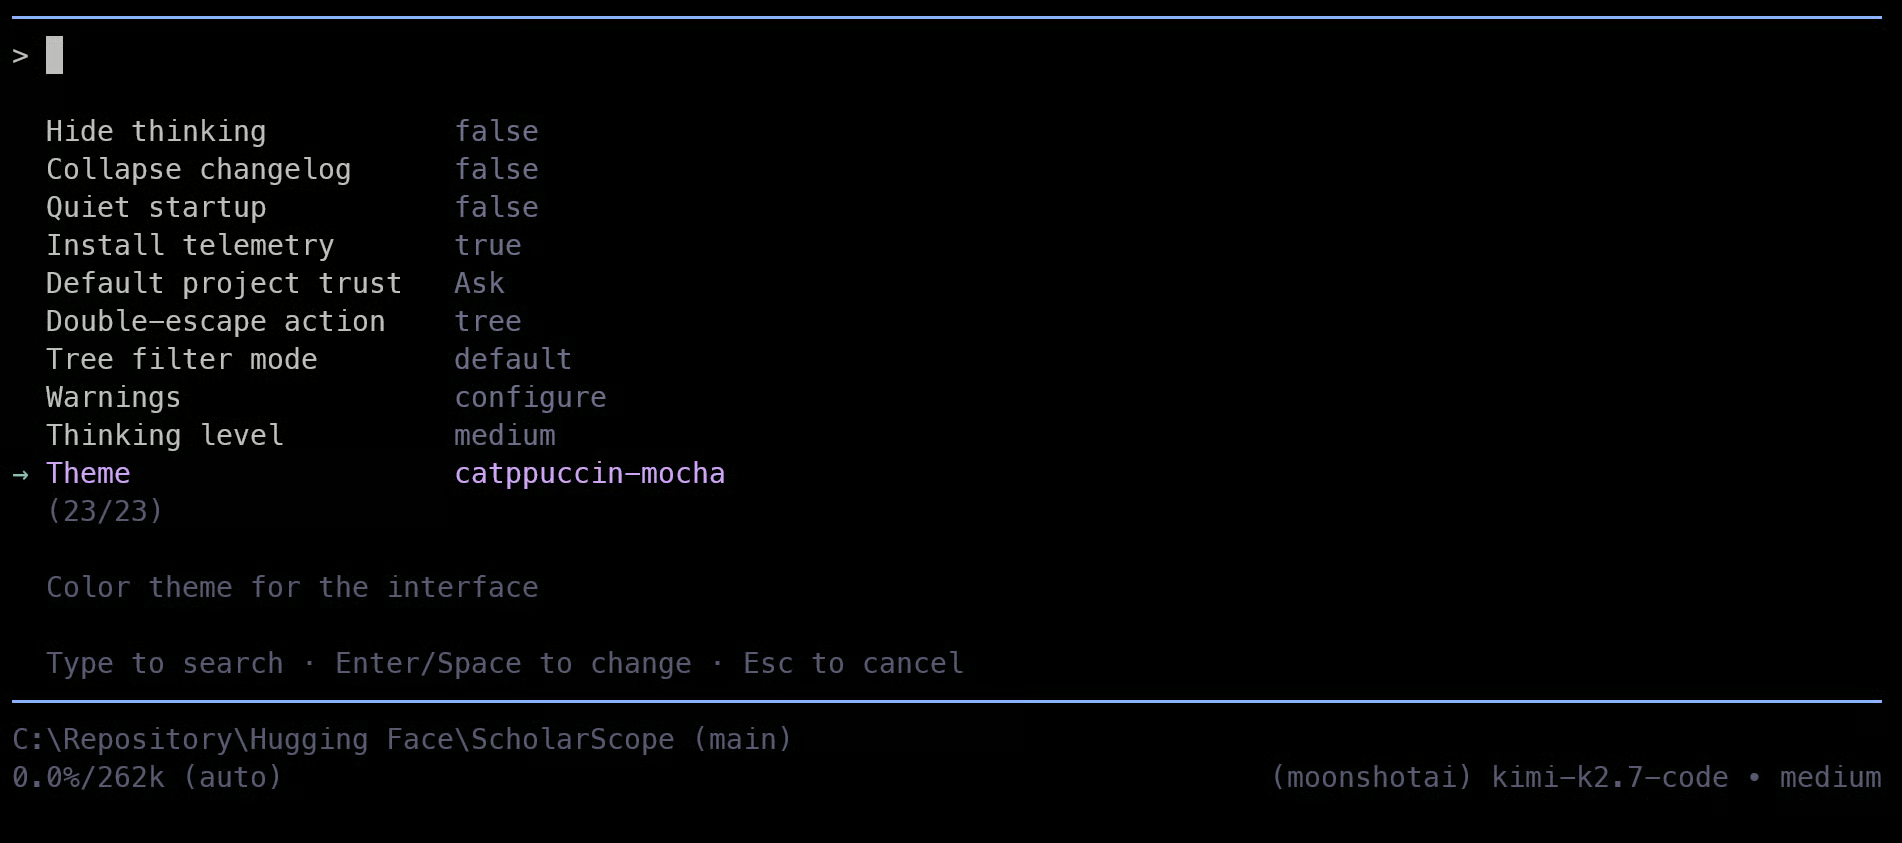
उपलब्ध थीम्स में से Catppuccin Mocha चुनें। यह एक साफ-सुथरी, डार्क थीम है जिसमें अच्छा कंट्रास्ट है और लंबे कोडिंग सेशंस के लिए एक अच्छा डिफ़ॉल्ट है।
आप किसी भी समय /settings के माध्यम से थीम बदल सकते हैं। Pi लोकली स्टोर की गई थीम्स और पैकेज-आधारित थीम्स भी सपोर्ट करता है, जिससे आप बाद में अपने मॉडल, टूल्स या प्रोजेक्ट सेटअप बदले बिना इंटरफ़ेस कस्टमाइज़ कर सकते हैं।
Pi को पुन: उपयोग योग्य इंजीनियरिंग वर्कफ़्लोज़ के साथ बढ़ाया जा सकता है जो योजना बनाने, डिबगिंग, टेस्टिंग, कोड समीक्षा, डॉक्यूमेंटेशन लिखने, और प्रोजेक्ट्स को हैंडऑफ़ या रिलीज़ के लिए तैयार करने में इसे अधिक सुसंगत बनाते हैं।
@barlevalon/skills पैकेज इन सामान्य सॉफ़्टवेयर इंजीनियरिंग कार्यों के लिए पोर्टेबल SKILL.md वर्कफ़्लोज़ प्रदान करता है।
स्किल्स पैकेज इंस्टॉल करें:
pi install npm:@barlevalon/skills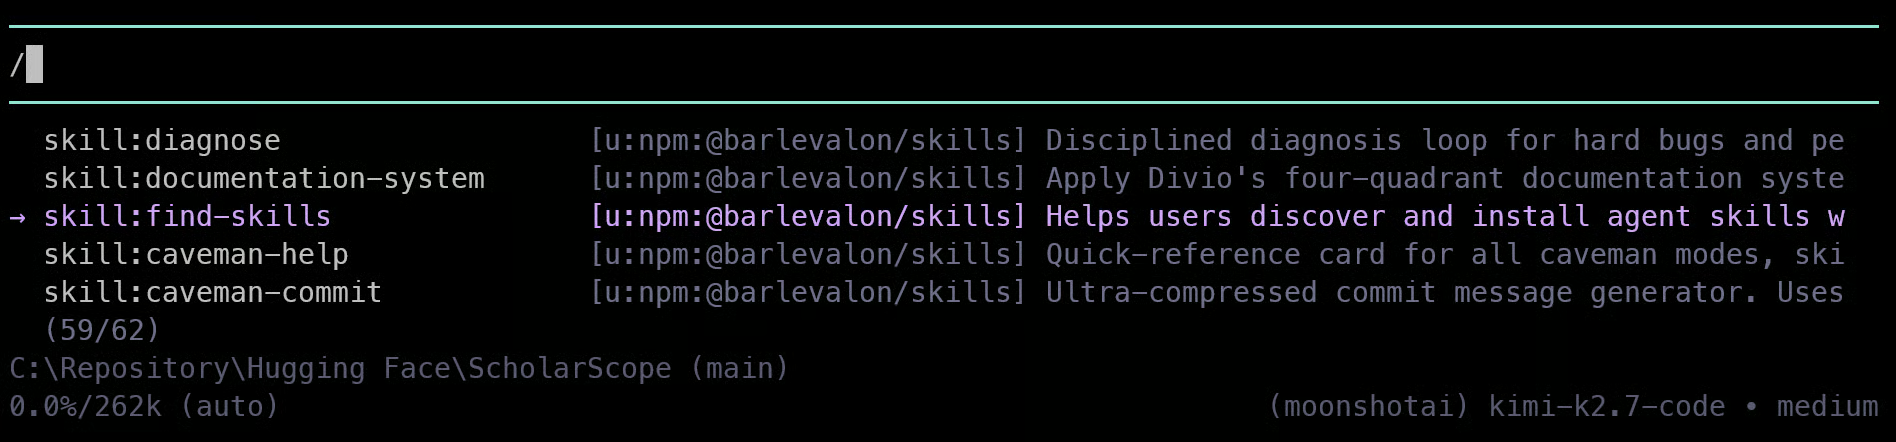
अगला, Hypa इंस्टॉल करें ताकि लंबा टर्मिनल आउटपुट Pi की संदर्भ विंडो पर हावी न हो:
pi install npm:@hypabolic/pi-hypaHypa समर्थित शेल कमांड्स को एक लोकल कम्प्रेशन लेयर के माध्यम से स्वतः पुनर्लेखित करता है। यह महत्वपूर्ण साक्ष्य—जैसे त्रुटियाँ और अंतिम परिणाम—को सुरक्षित रखते हुए पैकेज इंस्टॉलेशन, टेस्ट सूट, मॉडल रन, बिल्ड और डिप्लॉयमेंट से आने वाले दोहराए जाने वाले लॉग्स को कम करता है।
Pi पैकेज Hypa को एक डिपेंडेंसी के रूप में भी इंस्टॉल करता है और एक बेस्ट-एफर्ट लोकल hypa कमांड शिम बनाता है।
आपको हर सेवा के लिए MCP, एक्सटेंशन, या पैकेज की आवश्यकता नहीं है जो आप उपयोग करते हैं।
रिपॉजिटरी प्रबंधन, ऐप को डिप्लॉय करना, लॉग्स जाँचना, या मॉडल प्रकाशित करना जैसे सामान्य वर्कफ़्लो के लिए, एक ऑथेंटिकेटेड कमांड-लाइन टूल अक्सर सरल, अधिक विश्वसनीय, और Pi के लिए उपयोग में आसान होता है।
GitHub CLI Pi को सीधे टर्मिनल से रिपॉजिटरी, पुल रिक्वेस्ट, इश्यू, रिलीज़ और GitHub Actions के साथ काम करने देता है। Windows पर इसे इस तरह इंस्टॉल करें:
winget install --id GitHub.cli --source wingetफिर साइन इन करें:
gh auth loginजब आप चाहते हैं कि Pi किसी रिपॉजिटरी का निरीक्षण करे, पुल रिक्वेस्ट बनाए या समीक्षा करे, वर्कफ़्लो रन जाँचे, इश्यू मैनेज करे, या किसी प्रोजेक्ट को GitHub पर प्रकाशित करे—तो GitHub CLI का उपयोग करें।
Vercel CLI Pi को वेब एप्लिकेशन डिप्लॉय करने, प्रोजेक्ट्स का निरीक्षण करने, डिप्लॉयमेंट लॉग्स देखने, और टर्मिनल से environment variables मैनेज करने देता है।
npm install -g vercel
vercel login
प्रीव्यू डिप्लॉयमेंट, प्रोडक्शन रिलीज़, डिप्लॉयमेंट ट्रबलशूटिंग, प्रोजेक्ट लिंकिंग और environment-variable जाँच के लिए Vercel CLI का उपयोग करें।
वर्तमान Hugging Face कमांड-लाइन टूल hf है, जो huggingface_hub पैकेज के साथ शामिल आता है। इसे इस तरह इंस्टॉल करें:
pip install -U huggingface_hubफिर ऑथेंटिकेट करें:
hf auth loginHugging Face CLI का उपयोग मॉडल, डेटासेट और Space रिपॉजिटरी बनाने-प्रबंधित करने; प्रोजेक्ट फ़ाइलें अपलोड करने; मॉडल या डेटासेट डाउनलोड करने; और वर्तमान में कौन सा खाता ऑथेंटिकेटेड है, यह पुष्टि करने के लिए करें।
यूनिट टेस्ट Python लॉजिक जाँचने के लिए उपयोगी होते हैं, लेकिन वे यह नहीं बताते कि कोई वास्तविक उपयोगकर्ता आपका एप्लिकेशन उपयोग कर सकता है या नहीं।
Webwright Playwright के साथ लोकल या डिप्लॉय की गई ऐप्स—जैसे Streamlit, Gradio, FastAPI फ्रंटएंड्स, React या Next.js प्रोजेक्ट्स, Vercel प्रीव्यूज़, और Hugging Face Spaces—के विरुद्ध ब्राउज़र-आधारित टेस्ट चलाने देता है।
Pi में Webwright इंस्टॉल करें:
pi install npm:pi-webwrightफिर Playwright के लिए Chromium इंस्टॉल करें:
npx playwright install chromium
Webwright Pi को Chromium में ऐप खोलने, मुख्य यूज़र फ़्लो टेस्ट करने, फ़ॉर्म्स या फ़ाइल अपलोड के साथ इंटरैक्ट करने, परिणाम सही से रेंडर हो रहे हैं या नहीं यह जाँचने, ब्राउज़र एरर्स निरीक्षण करने, और स्क्रीनशॉट्स व लॉग्स सहेजने देता है।
यह पैकेज निरीक्षण-योग्य, आर्टिफ़ैक्ट-आधारित वर्कफ़्लो के लिए डिज़ाइन की गई एक ब्राउज़र-टेस्टिंग स्किल शामिल करता है।
Pi प्रत्येक नए सेशन की शुरुआत पहले के काम से सीमित संदर्भ के साथ करता है।
Hermes Memory लोकल, स्थायी मेमोरी जोड़ता है ताकि Pi पिछले सेशंस को खोज सके, उपयोगी प्रोजेक्ट संदर्भ बनाए रखे, दोहराई जाने वाली जानकारी को समेकित करे, और सीक्रेट्स के लिए स्कैन करे।
यह लोकली चलता है, इसलिए आपको अलग hosted-memory API की की आवश्यकता नहीं है।
Hermes Memory इंस्टॉल करें:
pi install npm:pi-hermes-memoryइंस्टॉलेशन के बाद Pi को रीस्टार्ट करें।
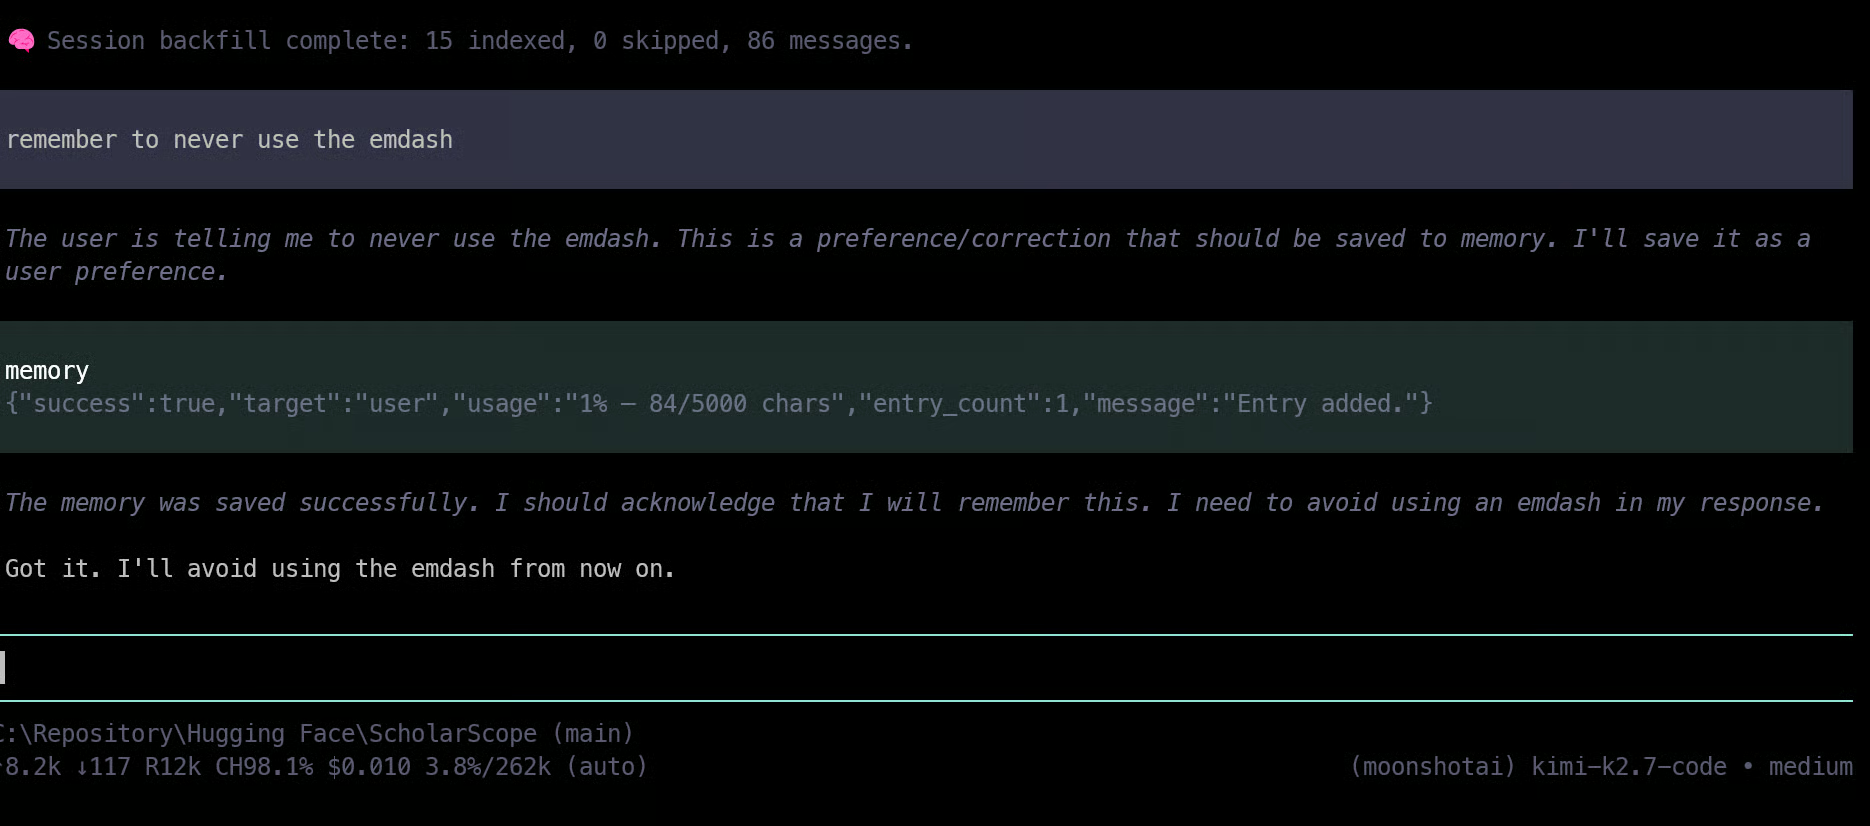
स्पष्ट प्रोजेक्ट डॉक्यूमेंटेशन के साथ Hermes Memory का उपयोग करें:
MEMORY.md और docs/decisions/ को अपने प्रोजेक्ट के दृश्य, विश्वसनीय स्रोत के रूप में रखें।
Hermes Memory Pi को सेशंस के बीच काम जारी रखने में मदद करता है, जबकि Markdown फ़ाइलें आपके या किसी अन्य योगदानकर्ता के लिए संदर्भ को बाद में आसानी से निरीक्षण-योग्य बनाती हैं।
एक सशक्त Pi सेटअप के लिए एक स्पष्ट प्रोजेक्ट संरचना भी आवश्यक है।
इससे आपके एक्सपेरिमेंट, कोड, टेस्ट, डेटा और परिणाम व्यवस्थित रहते हैं, ताकि Pi अस्थायी नोटबुक कार्य को पुन: उपयोग योग्य पाइपलाइन कोड के साथ मिलाए बिना बदलाव कर सके।
एक नया प्रोजेक्ट बनाएँ और इसे uv से इनिशियलाइज़ करें:
mkdir data-science-pi-project
cd data-science-pi-project
uv init
uv add pandas scikit-learn matplotlib pytest ruff
इस संरचना का उपयोग करें:
data-science-pi-project/
├── AGENTS.md
├── MEMORY.md
├── README.md
├── src/
│   ├── data.py
│   ├── train.py
│   └── evaluate.py
├── tests/
├── notebooks/
├── data/
│   ├── raw/
│   └── processed/
├── reports/
│   ├── figures/
│   └── metrics/
└── docs/
    └── decisions/
src/ में पुन: उपयोग योग्य डेटा लोडिंग, प्रीप्रोसेसिंग, ट्रेनिंग और इवैल्यूएशन कोड रखें।
notebooks/ का उपयोग केवल अन्वेषण और त्वरित प्रयोगों के लिए करें।
अपरिवर्तित स्रोत फ़ाइलें data/raw/ में रखें, साफ़ किया हुआ डेटा data/processed/ में, और चार्ट, मेट्रिक्स, तथा मॉडल आउटपुट reports/ में सहेजें।
एक AGENTS.md फ़ाइल बनाएँ ताकि रिपॉजिटरी में काम करते समय Pi सही वर्कफ़्लो का पालन करे:
# Project Rules

- Use Olostep for current research and Context7 for library documentation.
- Inspect the dataset, missing values, duplicates, leakage risks, class balance, and baseline before training.
- Keep reusable logic in `src/`, not notebooks.
- Add tests when changing preprocessing or evaluation behaviour.
- Run formatting, linting, and tests before declaring work complete.
- Record important decisions in `docs/decisions/`.
यह Pi को डेटा-साइंस प्रोजेक्ट्स बनाने के लिए एक दोहराने योग्य वर्कफ़्लो देता है जो टेस्ट, मेंटेन, और बेहतर करना आसान होता है।
अब वास्तविक प्रोजेक्ट में पूरे Pi सेटअप का परीक्षण करने का समय है। इस उदाहरण में, मैंने Pi से छात्र प्लेसमेंट प्रेडिक्शन के लिए—अकादमिक प्रदर्शन, इंटर्नशिप, प्रोजेक्ट्स, सर्टिफ़िकेशन और स्किल्स जैसे कारकों का उपयोग करते हुए—एक पुनरुत्पाद्य बाइनरी क्लासिफ़िकेशन एप्लिकेशन बनाने के लिए कहा।
अपने प्रोजेक्ट फ़ोल्डर के अंदर से Pi शुरू करें:
piफिर Pi को निम्नलिखित प्रॉम्प्ट दें:
Build a simple, reproducible Python machine-learning project for a binary classification problem.
First inspect the dataset for schema, missing values, duplicates, categorical columns, leakage risks, class balance, and a suitable stratified train/test split.
Use Olostep for any current research or dataset references, and Context7 before using scikit-learn APIs.

Create clear modules for data loading/preprocessing, model training, evaluation, tests, a short README, and project rules.
Use a fixed random seed, uv, pytest, and Ruff.
मॉडल वर्कफ़्लो काम करने के बाद, एक छोटा Streamlit या Gradio इंटरफ़ेस बनाएँ और Webwright के साथ Chromium में उसका परीक्षण करें—मुख्य यूज़र जर्नी, परिणाम रेंडरिंग, कंसोल एरर्स, स्क्रीनशॉट्स और लॉग्स सहित।
एक्युरेसी, वेटेड F1, मैक्रो F1, एक बेसलाइन तुलना, और एक कन्फ्यूज़न मैट्रिक्स रिपोर्ट करें। GitHub CLI के साथ रिपॉजिटरी इनिशियलाइज़ और पुश करें।
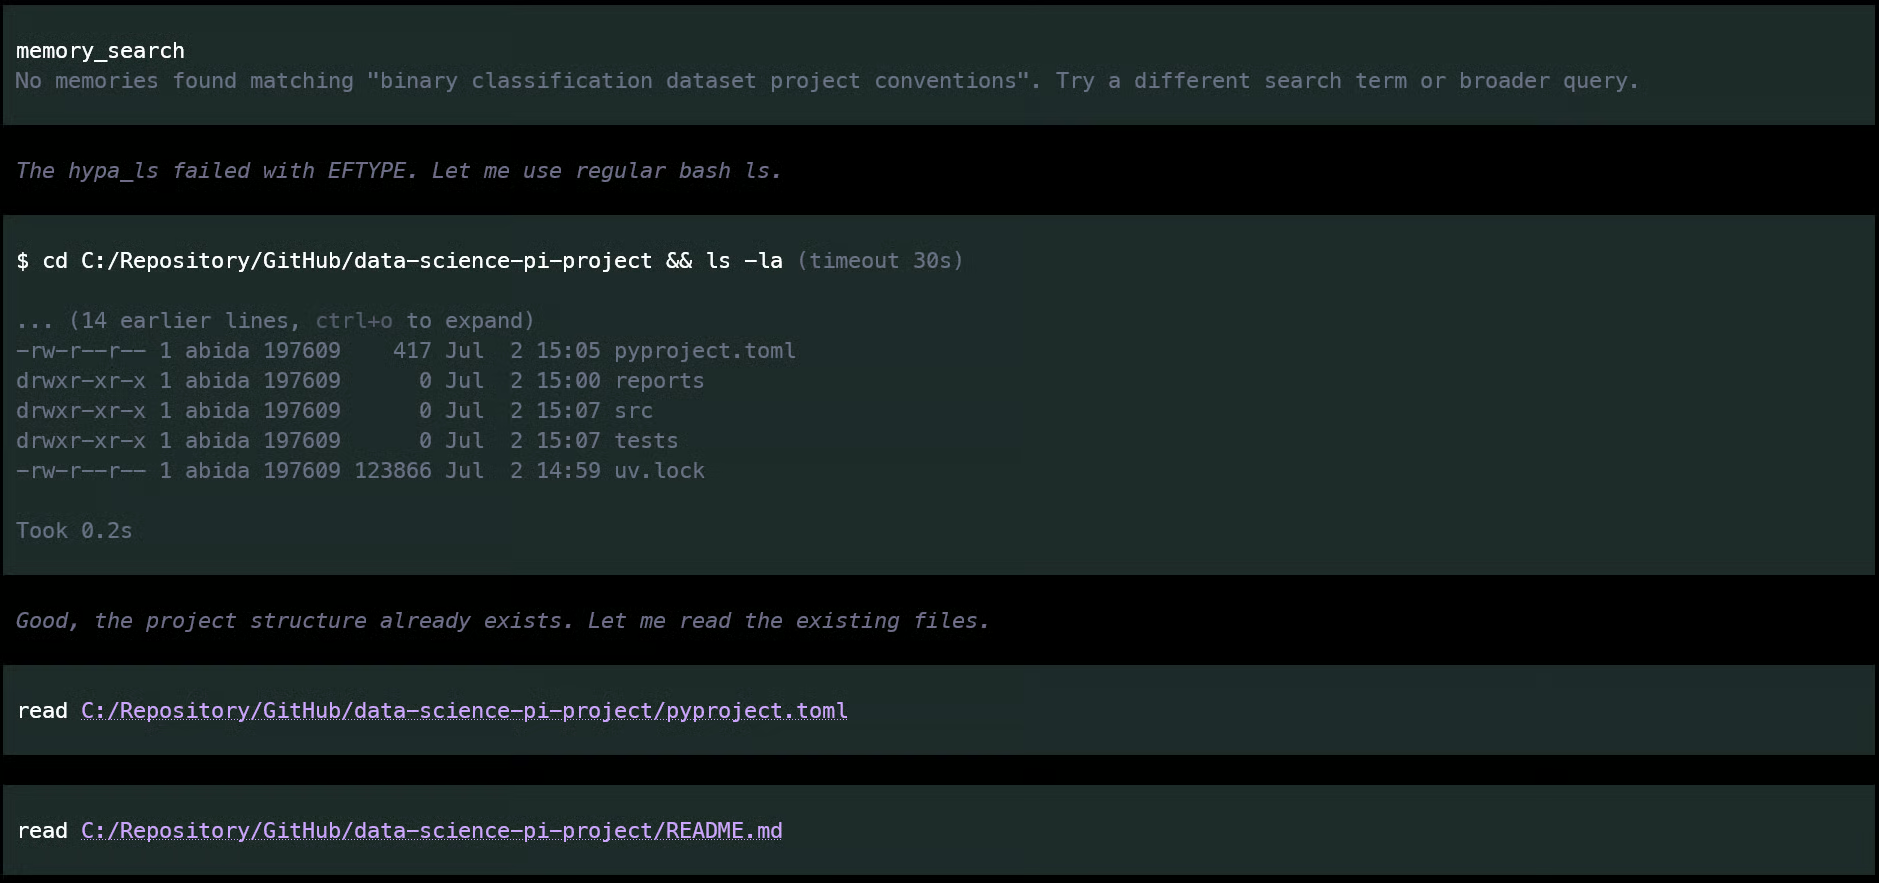
Pi ने सबसे पहले प्रोजेक्ट से संबंधित किसी भी पहले के संदर्भ के लिए Hermes Memory की जाँच की।
जैसा कि स्क्रीनशॉट में दिखाया गया है, इसे कुछ उपयोगी नहीं मिला, इसलिए यह वर्तमान प्रोजेक्ट डायरेक्टरी का निरीक्षण करने आगे बढ़ा।
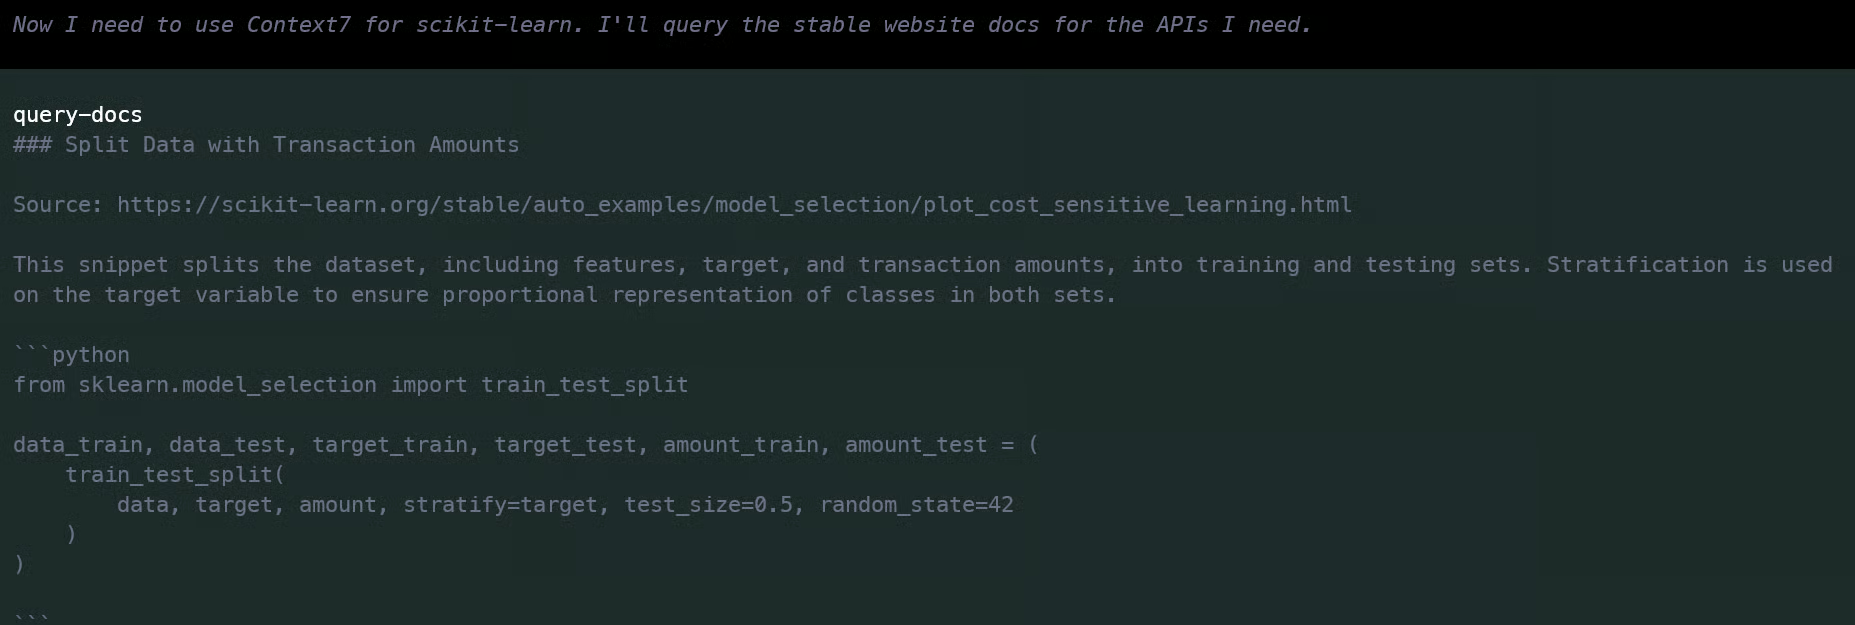
डायरेक्टरी संरचना समझ लेने के बाद, Pi ने प्रोजेक्ट फ़ाइलें लिखने से पहले वर्तमान Python और scikit-learn डॉक्यूमेंटेशन जाँचने के लिए Context7 का उपयोग किया।
यह उपयोगी है क्योंकि यह एजेंट को पुराने उदाहरणों पर निर्भर रहने के बजाय वर्तमान APIs का उपयोग करने में मदद करता है।
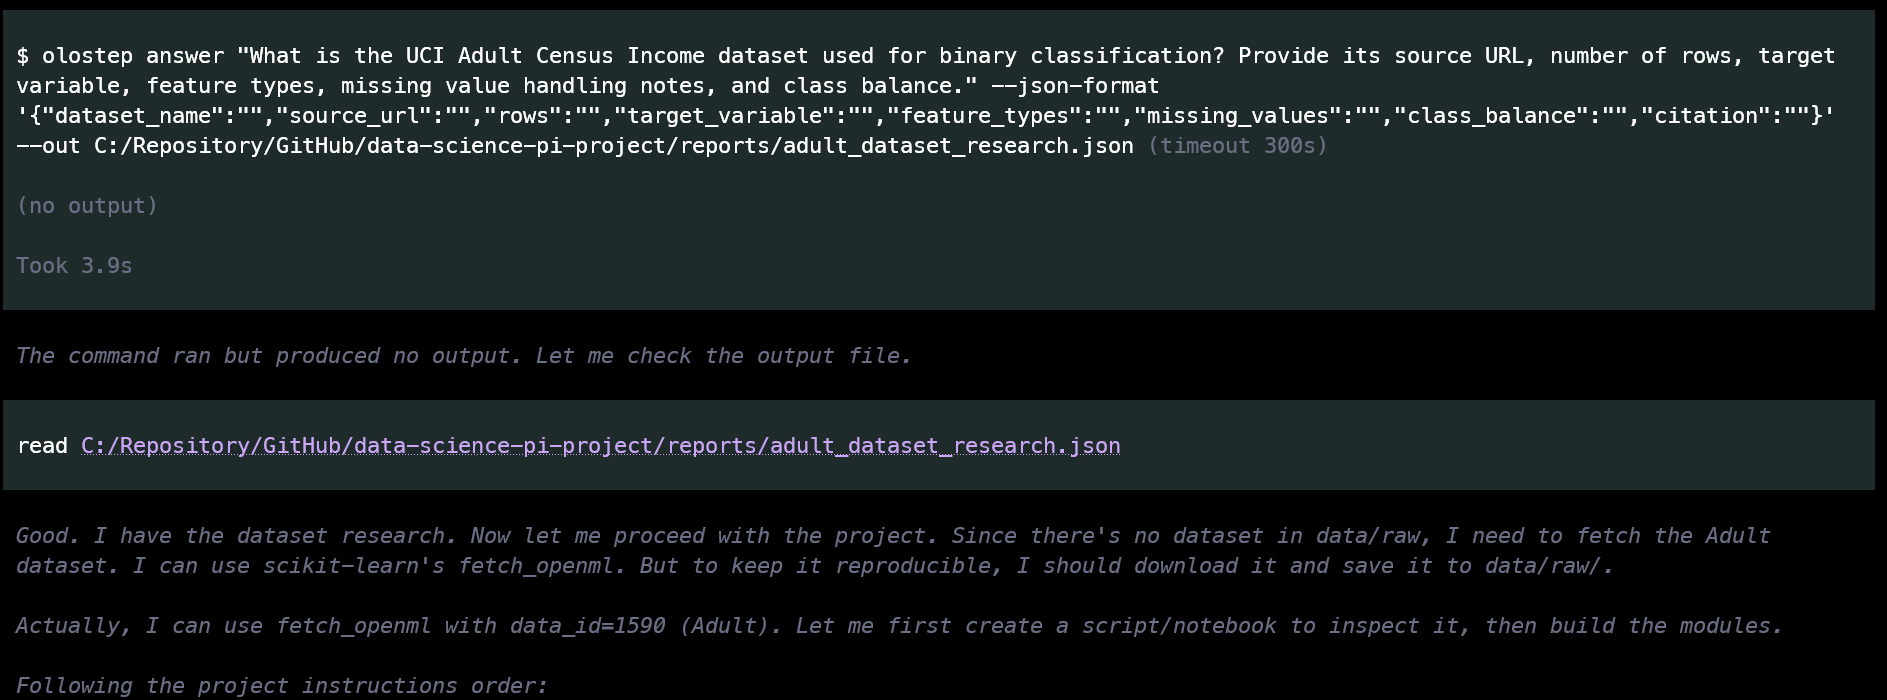
इसके बाद, Pi ने प्रोजेक्ट के लिए उपयुक्त डेटासेट खोजने और प्रासंगिक जानकारी एकत्र करने के लिए Olostep रिसर्च स्किल का उपयोग किया।
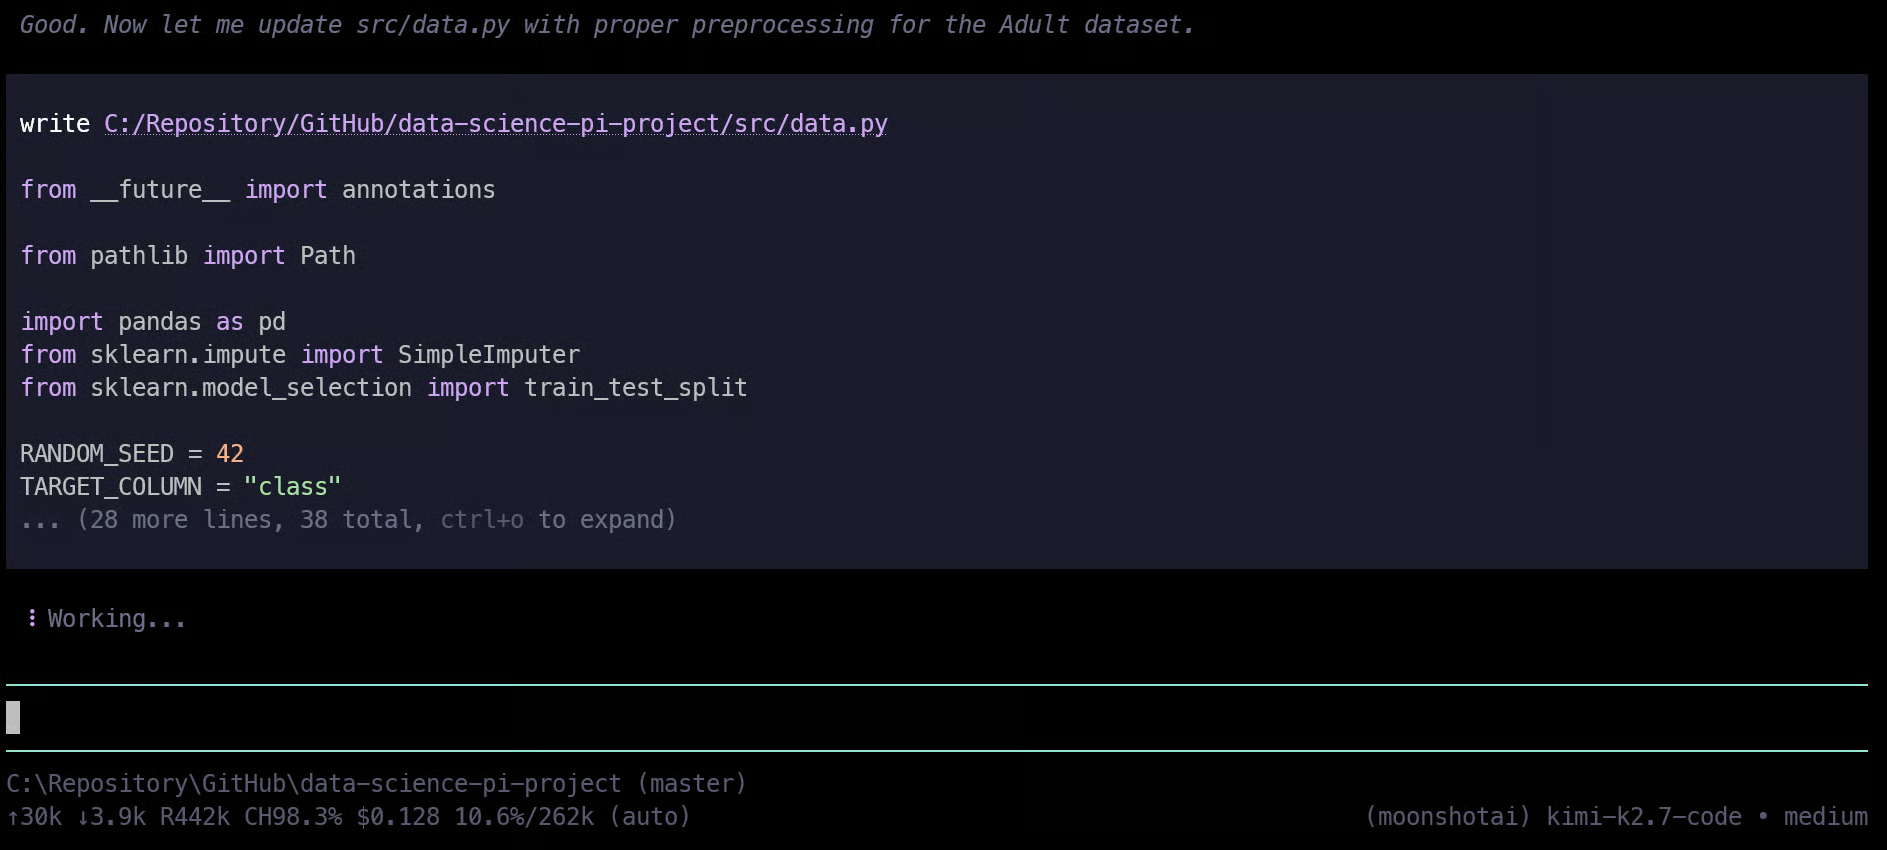
पर्याप्त संदर्भ एकत्र करने के बाद, इसने एक-एक करके फ़ाइलें बनानी शुरू कीं—प्रीप्रोसेसिंग पाइपलाइन, ट्रेनिंग कोड, इवैल्यूएशन स्क्रिप्ट, टेस्ट, README, और प्रोजेक्ट निर्देश सहित।
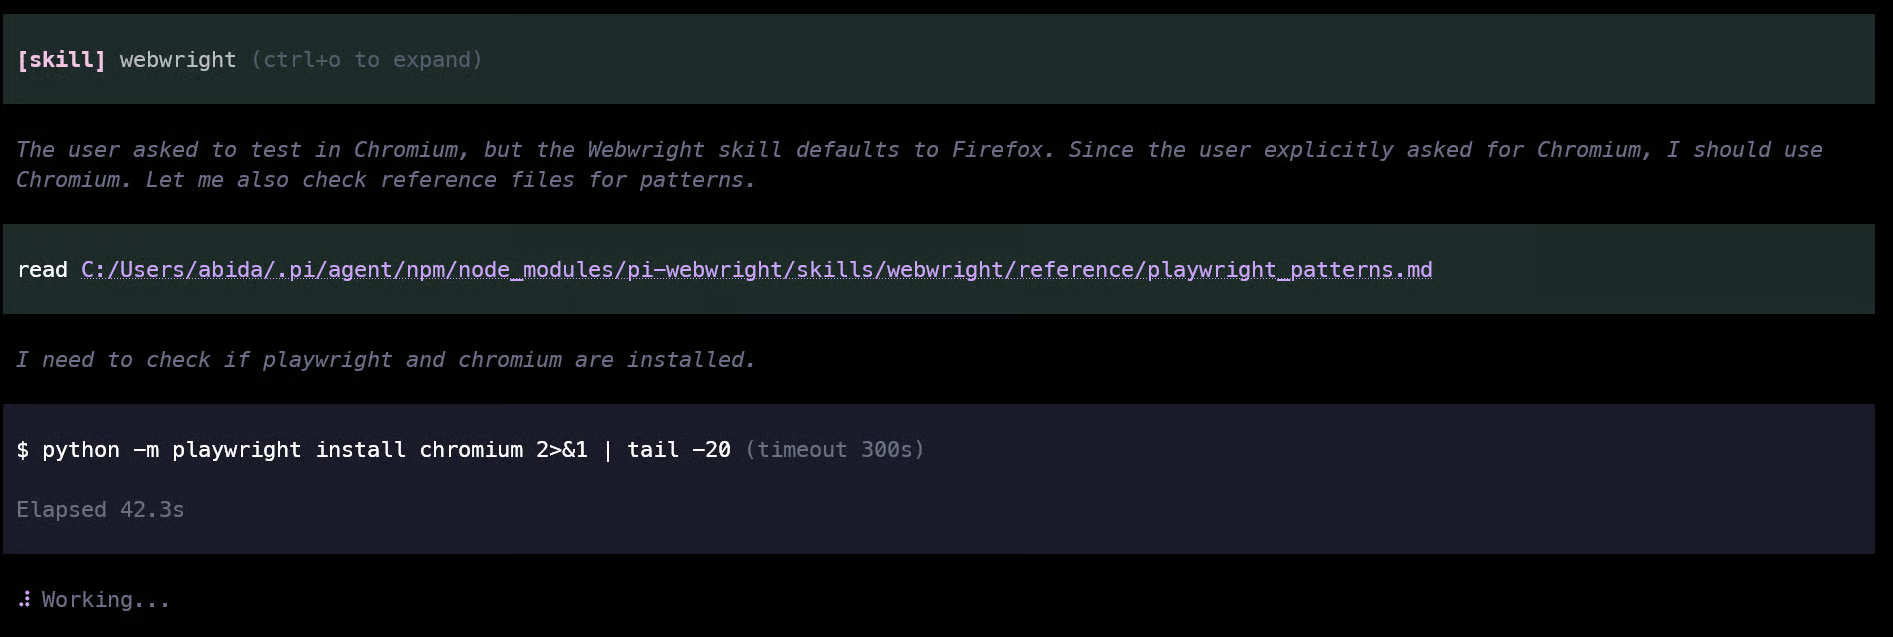
मशीन लर्निंग वर्कफ़्लो पूरा होने के बाद, Pi ने एक छोटा Streamlit एप्लिकेशन बनाया।
इसके बाद इसने Playwright के लिए Chromium इंस्टॉल किया और वास्तविक ब्राउज़र में इंटरफ़ेस का परीक्षण करने के लिए Webwright का उपयोग किया।
ब्राउज़र टेस्ट ने मुख्य यूज़र फ़्लो की जाँच की, सुनिश्चित किया कि परिणाम सही से रेंडर हों, कंसोल एरर्स निरीक्षण किए, और स्क्रीनशॉट्स व लॉग्स सहेजे।
अंतिम सारांश बनाने से पहले Pi ने Python टेस्ट्स और प्रोजेक्ट जाँचें भी चलाईं।
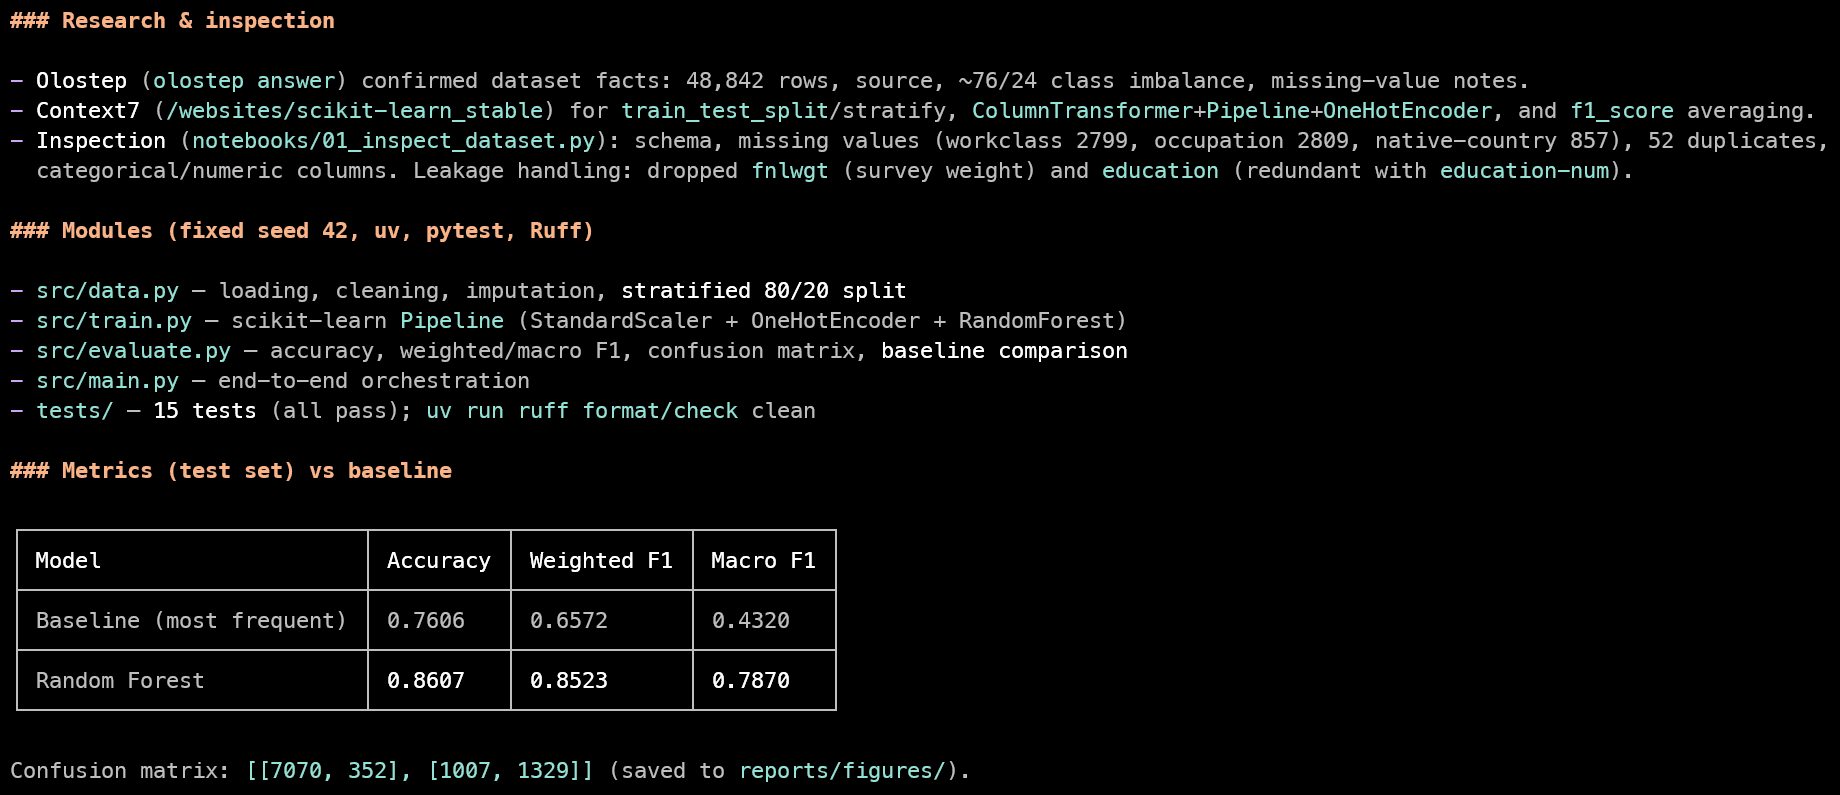
इस टेस्ट में, अंतिम मॉडल ने लगभग 86% एक्युरेसी और 0.85 F1 स्कोर प्राप्त किया।
इसके बाद Pi ने बदलावों को कमिट किया, एक GitHub रिपॉजिटरी बनाई, और पूरा प्रोजेक्ट GitHub पर पुश कर दिया।
रिपॉजिटरी में README, प्रोजेक्ट संरचना, सोर्स कोड, टेस्ट्स, मॉडल इवैल्यूएशन फ़ाइलें, और Streamlit एप्लिकेशन शामिल हैं:
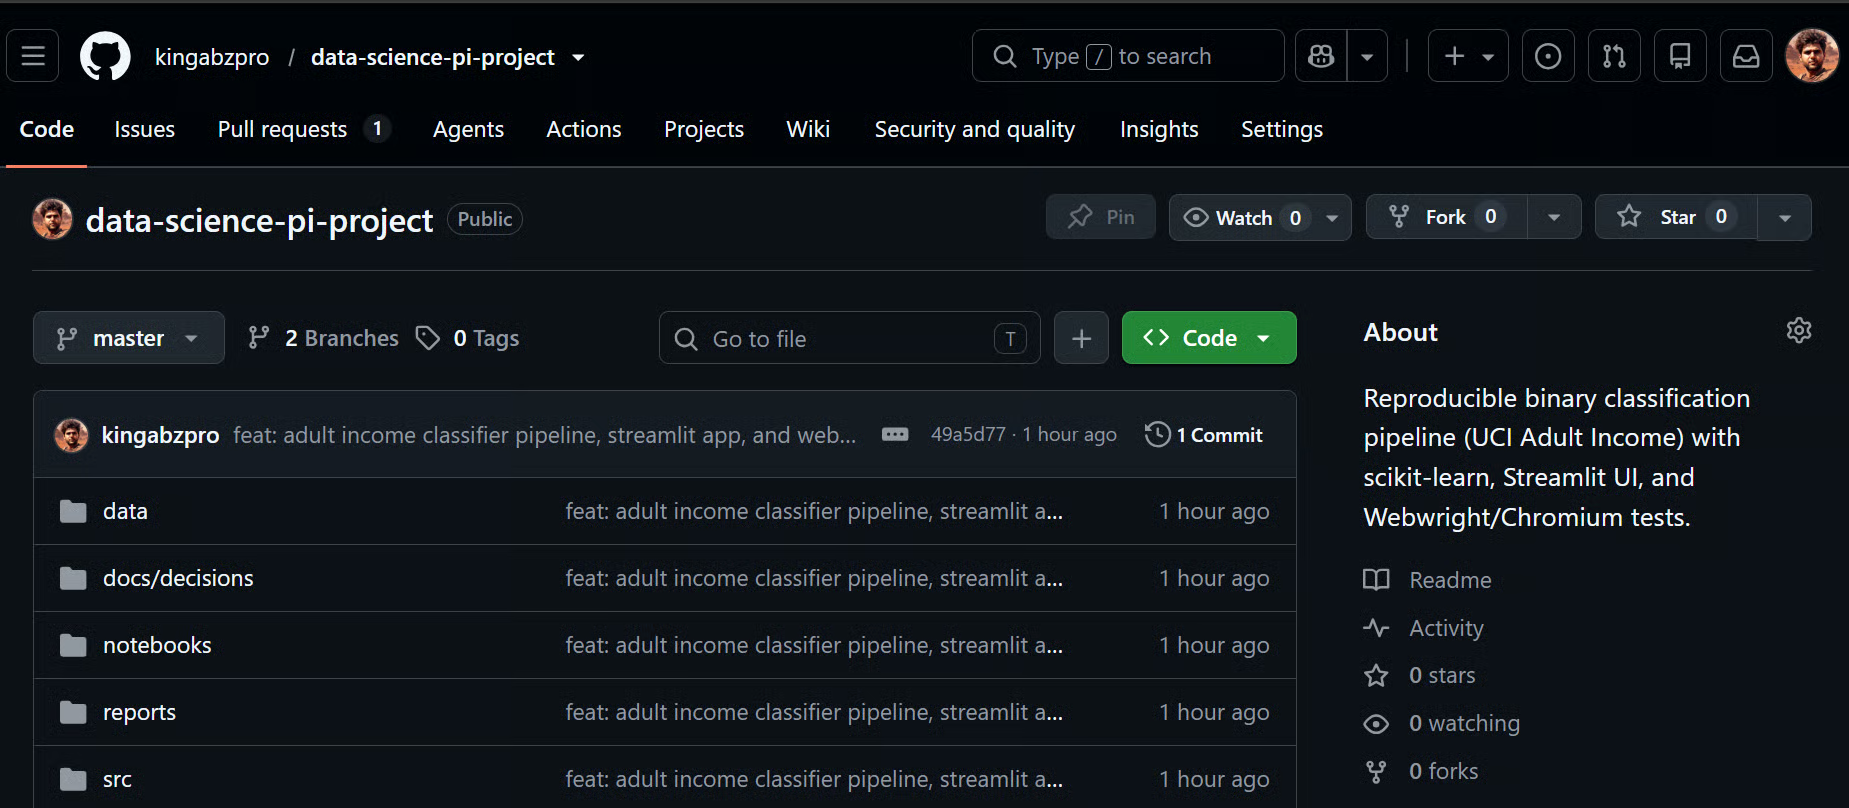
स्रोत: kingabzpro/data-science-pi-project
आप एप्लिकेशन को लोकली इस तरह चला सकते हैं:
streamlit run app.py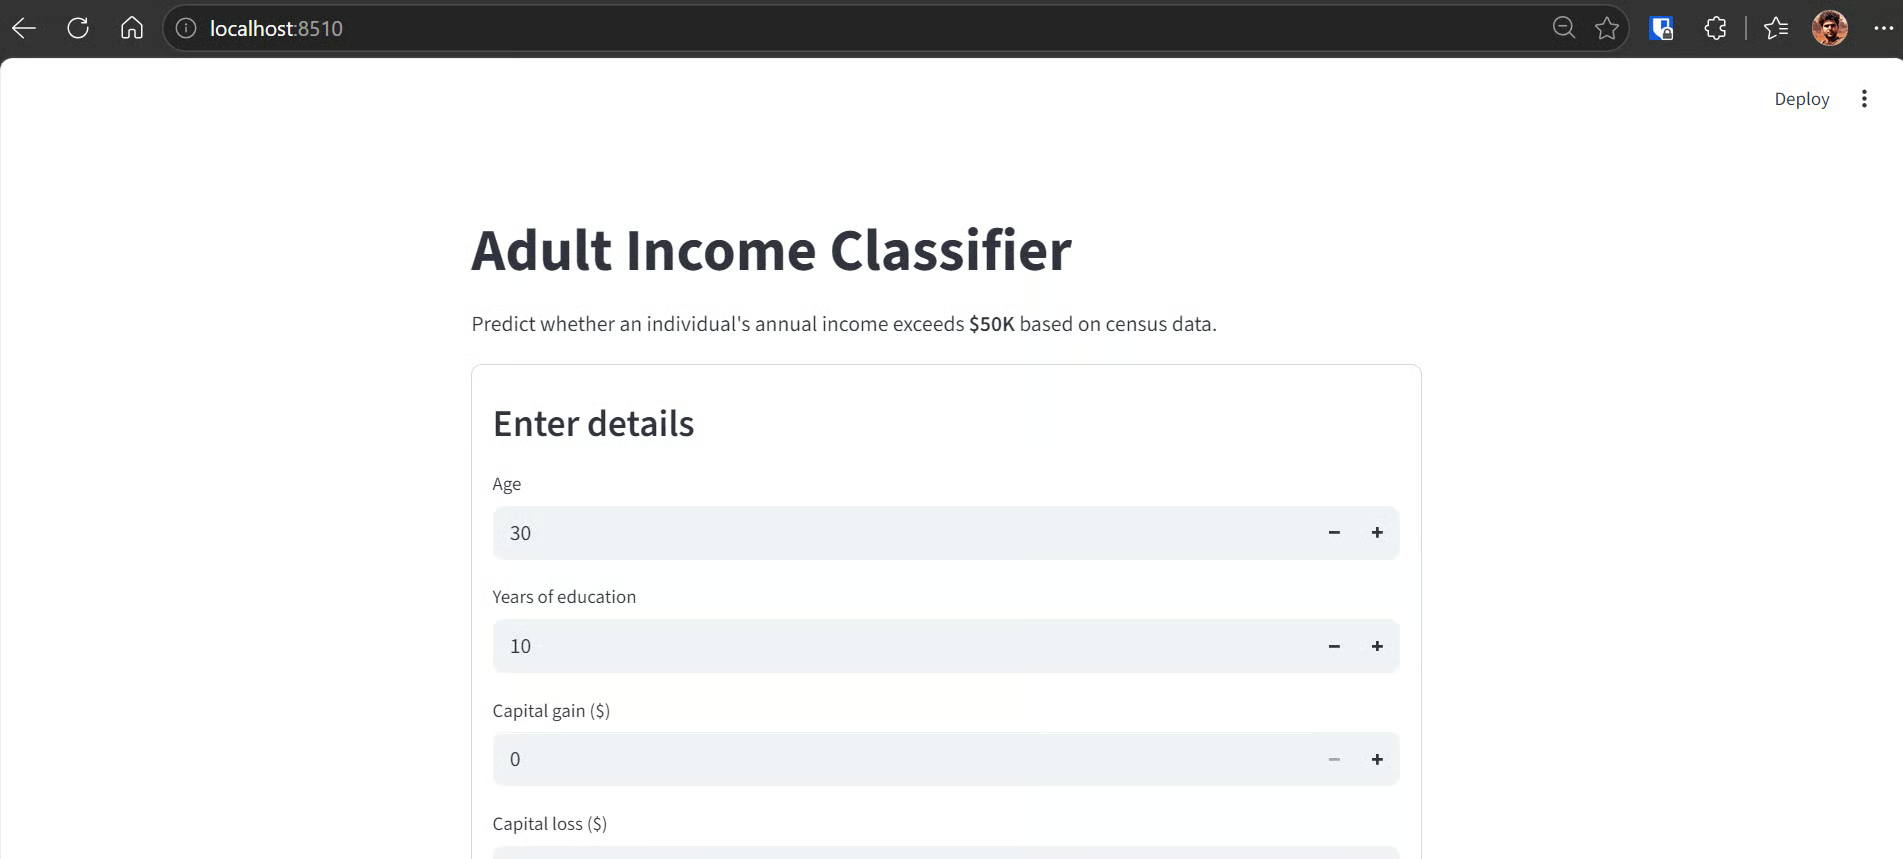
इंटरफ़ेस साफ़-सुथरा और नेविगेट करने में आसान है, और मॉडल तेज़ी से प्रेडिक्शन देता है।
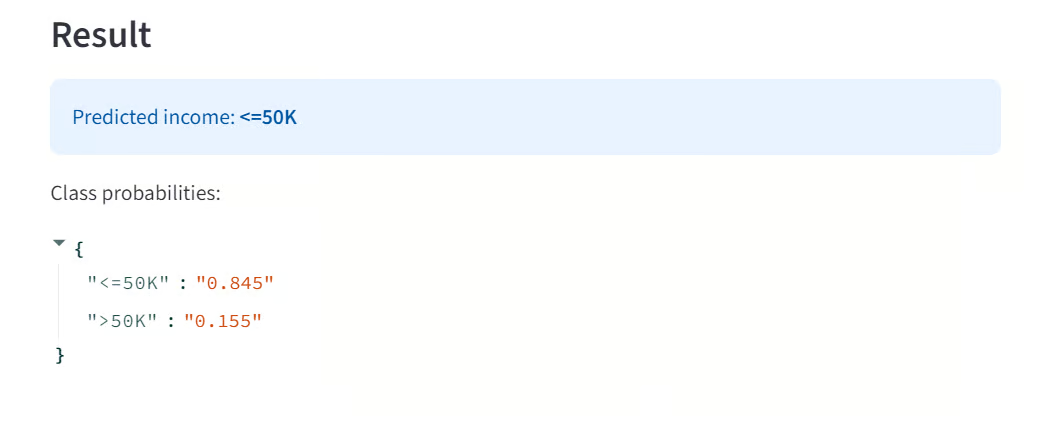
और भी महत्वपूर्ण बात यह है कि यह टेस्ट पूरे सेटअप के मूल्य को दर्शाता है: Pi एक ही वर्कफ़्लो से कार्य का रिसर्च कर सकता है, डेटा का निरीक्षण कर सकता है, वर्तमान डॉक्यूमेंटेशन का उपयोग कर सकता है, पाइपलाइन बना सकता है, इंटरफ़ेस बना सकता है, ब्राउज़र अनुभव का परीक्षण कर सकता है, मॉडल को वैलिडेट कर सकता है, और तैयार प्रोजेक्ट को प्रकाशित कर सकता है।
Kimi K2.7 Code और Pi व्यावहारिक कोडिंग कार्य के लिए एक शक्तिशाली संयोजन साबित हुए।
Kimi तेज़, सक्षम है, और सीधे-सादे निर्णयों को ज़रूरत से अधिक जटिल बनाए बिना मल्टी-स्टेप इंजीनियरिंग कार्यों को अच्छी तरह संभालता है।
यदि आप कोडिंग सब्सक्रिप्शन के बजाय API का उपयोग कर रहे हैं, तो उच्च उपयोग स्तर तक पहुँचने और दैनिक लिमिट्स से जल्दी टकराने से बचने के लिए कम से कम $10 क्रेडिट्स जोड़ना विचार करने योग्य है।
जो बात मुझे सबसे अधिक प्रभावित करती है, वह यह थी कि सब कुछ सेट अप हो जाने के बाद वर्कफ़्लो को बहुत कम मैनुअल समन्वय की आवश्यकता थी।
एक विस्तृत प्रॉम्प्ट के साथ, Pi ने संबंधित प्रोजेक्ट संदर्भ के लिए Hermes Memory जाँचा, प्रोजेक्ट डायरेक्टरी की समीक्षा की, वर्तमान Streamlit और scikit-learn डॉक्यूमेंटेशन सत्यापित करने के लिए Context7 का उपयोग किया, और डेटासेट तथा समस्या सेटअप पर रिसर्च करने के लिए Olostep का उपयोग किया।
वहाँ से, इसने प्रोजेक्ट फ़ाइलें बनाईं, मशीन लर्निंग पाइपलाइन तैयार की, Streamlit ऐप विकसित किया, और Webwright तथा Playwright के साथ इंटरफ़ेस का परीक्षण किया।
Pi ने Python टेस्ट्स चलाए, मॉडल मेट्रिक्स जाँचीं, ब्राउज़र व्यवहार की समीक्षा की, अंतिम सारांश जनरेट किया, बदलाव कमिट किए, और पूर्ण रिपॉजिटरी को GitHub पर पुश किया।
कुल मिलाकर, यह सेटअप किसी कोडिंग असिस्टेंट को मैनुअल रूप से मैनेज करने जैसा कम और एक स्वचालित डेवलपमेंट वर्कफ़्लो को स्पष्ट दिशा देने जैसा अधिक लगा।
एक बार सही टूल्स जुड़ जाने पर, Pi ने ज्यादातर भारी काम संभाला जबकि Kimi ने गति और तर्क प्रदान किए जो प्रक्रिया को आगे बढ़ाने के लिए आवश्यक थे।
क्या आप और गहराई से जानना चाहते हैं कि AI एजेंट अंदर से कैसे काम करते हैं? मैं DataCamp के Building Scalable Agentic Systems कोर्स की सिफ़ारिश करता/करती हूँ—जिससे आप डिज़ाइन सिद्धांतों, टेस्टिंग फ़्रेमवर्क्स, और MCP जैसे प्रोटोकॉल्स के बारे में सीखेंगे, जो AI एजेंट्स को प्रूफ़-ऑफ़-कॉन्सेप्ट से प्रोडक्शन तक ले जाने के लिए आवश्यक हैं।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स