Khóa học
ETL và ELT với Python
4 giờ
40.5K
Dữ liệu là yếu tố thiết yếu đối với doanh nghiệp và tổ chức, và nhiệm vụ tổ chức luồng dữ liệu chính là nơi data pipeline phát huy tác dụng. Vậy data pipeline là gì và bạn cần biết gì để tự xây dựng một pipeline?
Dữ liệu là mạch sống của các doanh nghiệp và tổ chức hiện đại, thúc đẩy việc ra quyết định, tạo ra insight và đổi mới. Tuy nhiên, quản lý và khai thác sức mạnh của dữ liệu có thể là một nhiệm vụ phức tạp và đáng ngại. Đây là lúc data pipeline xuất hiện. Nhưng chính xác thì data pipeline là gì?
Data pipeline là một hệ thống dùng để truy xuất dữ liệu từ nhiều nguồn khác nhau và dẫn nó tới một vị trí mới, chẳng hạn như cơ sở dữ liệu, kho lưu trữ hoặc ứng dụng, đồng thời thực hiện mọi chuyển đổi dữ liệu cần thiết (chuyển dữ liệu từ định dạng hoặc cấu trúc này sang định dạng hoặc cấu trúc khác) trên đường đi. Người dùng cuối của pipeline này có thể là nhà phân tích, nhà khoa học dữ liệu hoặc lãnh đạo doanh nghiệp.
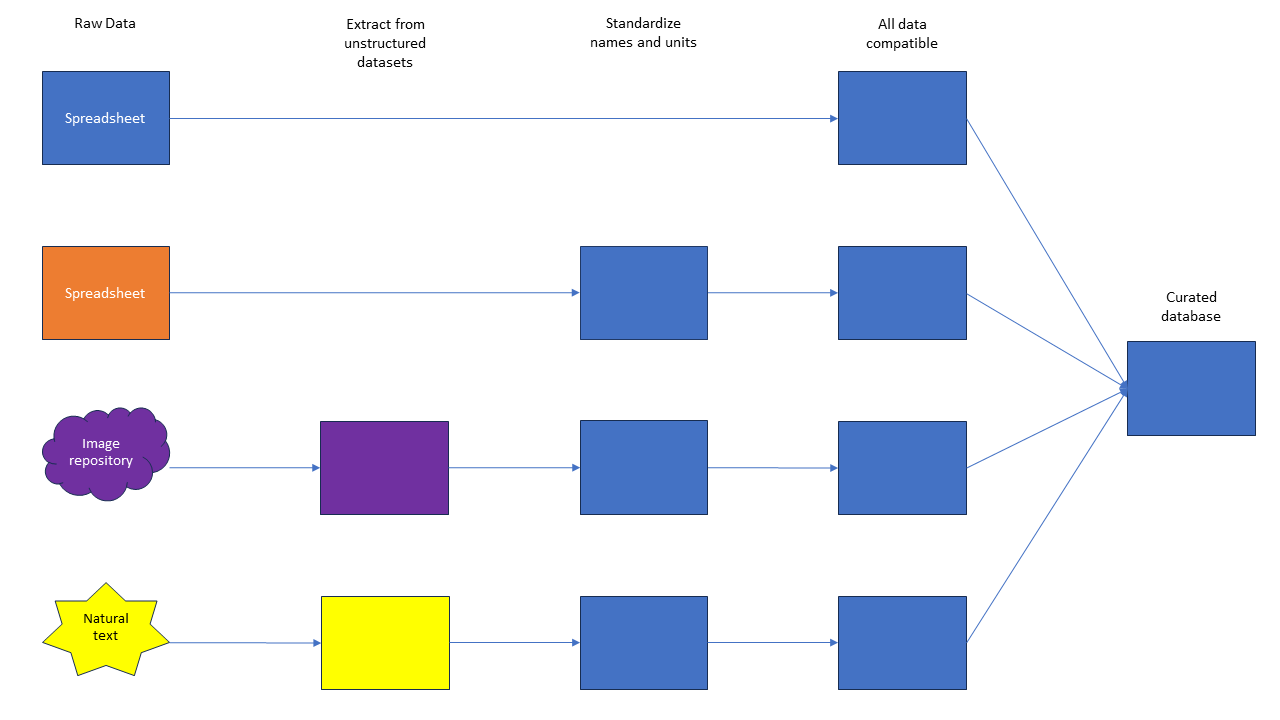
Hình 1: Ví dụ về một data pipeline đơn giản. Trong ví dụ này, bạn có bốn nguồn dữ liệu: hai có cấu trúc và hai phi cấu trúc. Thông qua một loạt bước, bạn trích xuất dữ liệu có cấu trúc từ các tập dữ liệu phi cấu trúc, chuẩn hóa tất cả tên gọi và đơn vị đo, và khi mọi dữ liệu đã tương thích, bạn có thể tạo một cơ sở dữ liệu tuyển chọn chứa toàn bộ thông tin cần thiết. Cơ sở dữ liệu này sau đó có thể được sử dụng bởi nhà phân tích, nhà khoa học hoặc lãnh đạo doanh nghiệp.
Nghe có vẻ đơn giản, nhưng đi kèm là vô số quyết định và đau đầu. Ở nhiều tổ chức, việc xây dựng và vận hành pipeline là một công việc riêng biệt do kỹ sư dữ liệu đảm trách. Ở nơi khác, đó chỉ là một trong nhiều nhiệm vụ của nhà khoa học dữ liệu. Ai duy trì pipeline thường phụ thuộc vào quy mô tổ chức, độ phức tạp của pipeline và nguồn lực tài chính.
Xây dựng một pipeline đáng tin cậy, an toàn và kịp thời là phần then chốt của việc ra quyết định dựa trên dữ liệu. Dù bạn muốn theo đuổi ngành kỹ thuật dữ liệu hay sự nghiệp ở bất kỳ phần nào khác của quy trình dữ liệu, hiểu về data pipeline sẽ rất có ích.
Bạn có thể tự hỏi vì sao cần xây dựng pipeline. Nếu bạn làm việc với các bộ dữ liệu có sẵn hoặc dữ liệu chỉ đến từ một nguồn, như trên Kaggle hay các bài tập của DataCamp, có lẽ bạn chẳng cần pipeline. Những bộ dữ liệu đã được tuyển chọn này vốn dĩ được thiết lập để nhà phân tích truy xuất và làm việc trực tiếp.
Tuy nhiên, nếu bạn muốn kết hợp thông tin từ nhiều nguồn, bạn có thể cần thiết lập một pipeline để đảm bảo toàn bộ dữ liệu có thể truy cập cho phân tích của mình.
Dưới đây là một số lý do chính để bạn cân nhắc sử dụng data pipeline:
Ví dụ, hãy tưởng tượng bạn muốn biết liệu GPA trung bình của học sinh trong một quận trường có tương quan với thu nhập bình quân của hạt hoặc với quy mô dân số hay không. Để phân tích này, bạn có thể cần lấy dữ liệu GPA từ mỗi quận trường, dữ liệu thu nhập từ IRS và quy mô dân số từ Cục Điều tra Dân số.
Bạn có thể thủ công lấy thông tin này một lần. Nhưng hãy tưởng tượng bạn cần lặp lại phân tích thường xuyên. Xây dựng một pipeline đáng tin cậy có thể giúp tự động hóa việc thu thập thông tin này, tiết kiệm thời gian và công sức.
Ngoài việc gom dữ liệu về một nơi, pipeline còn giúp bạn xử lý các điểm không nhất quán từ những nguồn khác nhau. Ví dụ, Cục Điều tra Dân số có thể nhận diện các hạt theo tên đầy đủ, trong khi IRS có thể dùng tên viết tắt.
Trong pipeline, bạn có thể thiết lập hệ thống chuẩn hóa cách nhận diện các hạt trong kho lưu trữ cuối cùng. Hoặc có thể dữ liệu dân số được ghi theo các đơn vị khác nhau ở từng mục, và bạn cần chuẩn hóa hệ đơn vị dùng ở đích cuối. Những thay đổi kiểu này gọi là chuyển đổi (transformation).
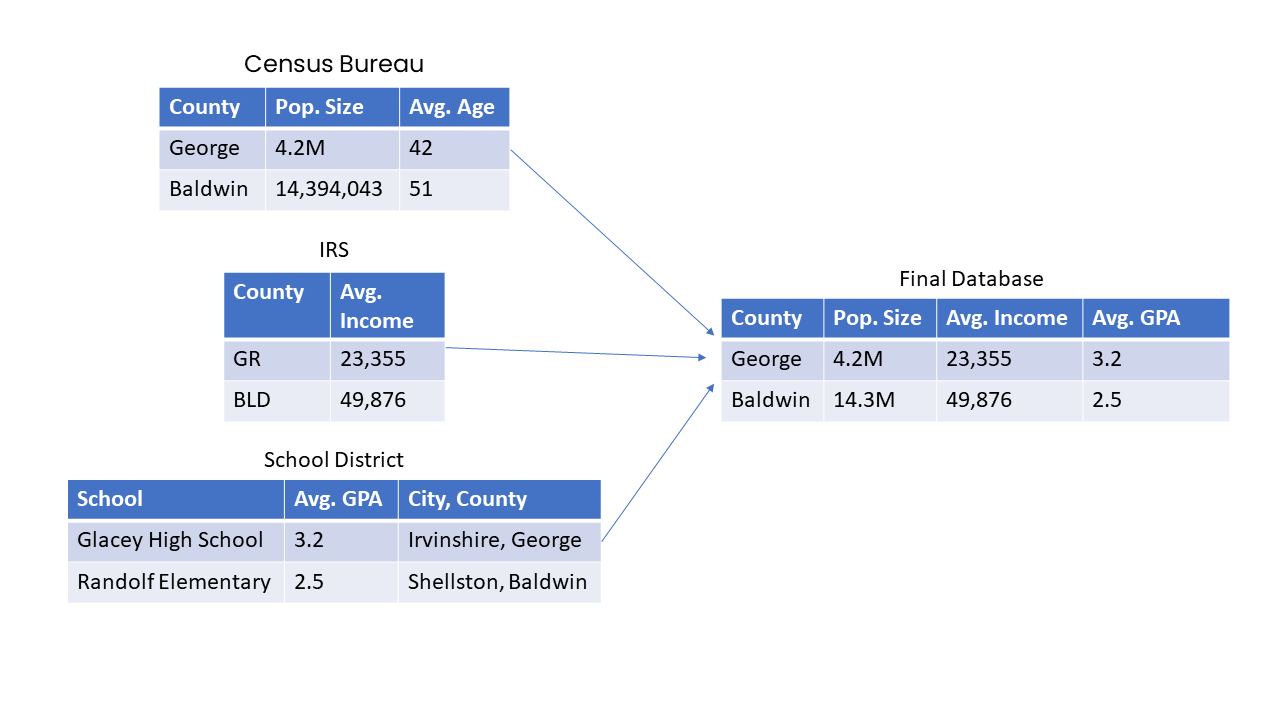
Hình 2: Khi kết hợp thông tin từ nhiều nguồn, có thể cần các chuyển đổi như đổi đơn vị và chuẩn hóa tên.
Data pipeline thường được phát triển và duy trì bởi kỹ sư dữ liệu.
Khi dữ liệu đã được thu thập, làm sạch và tổ chức ở cuối pipeline, nó có thể được truy xuất bởi nhiều bên liên quan, bao gồm nhà phân tích dữ liệu, nhà khoa học dữ liệu hoặc nhà phân tích kinh doanh.
Dữ liệu sau đó có thể được dùng cho phân tích thời gian thực, đẩy vào bảng điều khiển cập nhật liên tục, hoặc đưa vào mô hình học máy. Đôi khi, điểm cuối của pipeline có thể là một ứng dụng hoặc bảng điều khiển do lãnh đạo doanh nghiệp hay cá nhân sử dụng.
Pipeline được dùng trong hầu như mọi lĩnh vực tận dụng khối lượng dữ liệu lớn. Ở các tổ chức lớn, như trong ngành công nghệ, pipeline có thể phức tạp, chịu nhiều quy định và được quản lý bởi một đội ngũ kỹ sư chuyên trách.
Ở các tổ chức nhỏ hơn, ví dụ một nhà nghiên cứu đơn lẻ muốn thu thập dữ liệu từ nhiều cảm biến trên khắp thế giới, pipeline có thể rất đơn giản, chỉ với vài bước. Những ví dụ khác là một nhà môi giới chứng khoán thu thập thông tin tài chính để quyết định mua cổ phiếu, hoặc một hệ thống bệnh viện tập hợp hồ sơ bệnh nhân từ các đơn vị liên kết.
Pipeline cũng tối quan trọng đối với các mô hình học máy. Những mô hình này tiêu thụ lượng dữ liệu khổng lồ, và một pipeline đúng chuẩn là điều bắt buộc để vận hành trơn tru. Hướng dẫn MLOps này cung cấp thêm chi tiết về cách pipeline được dùng trong học máy.
Dữ liệu có thể được lưu trữ theo nhiều cách khác nhau, tùy thuộc vào loại dữ liệu và mục đích sử dụng. Ba thuật ngữ bạn có thể thường gặp liên quan đến lưu trữ dữ liệu là data lake, database và data warehouse. Hãy điểm qua từng khái niệm.
Data lake là một kho lưu trữ lớn, linh hoạt có thể chứa cả dữ liệu có cấu trúc và phi cấu trúc ở quy mô lớn. Nó cho phép tổ chức lưu dữ liệu thô, chưa xử lý từ nhiều nguồn, như nhật ký web, cảm biến, mạng xã hội, v.v., ở định dạng gốc.
Data lake nổi bật bởi tính đa dụng, cho phép nhà khoa học và nhà phân tích dữ liệu khám phá, chuyển đổi và phân tích dữ liệu theo nhiều cách. Chúng đặc biệt hữu ích cho các bài toán big data và phân tích nâng cao, nơi lược đồ và cấu trúc dữ liệu không được xác định trước, mang lại sự linh hoạt để trích xuất insight từ các nguồn đa dạng.
Database là hệ thống mục đích chung dùng để lưu trữ, quản lý và truy xuất dữ liệu có cấu trúc một cách hiệu quả. Dù có nét tương đồng với data warehouse, database thường dùng cho dữ liệu giao dịch, vận hành hàng ngày và ứng dụng thời gian thực. Có nhiều loại, gồm cơ sở dữ liệu quan hệ, NoSQL và in-memory, mỗi loại phù hợp với yêu cầu lưu trữ và xử lý khác nhau. Database đảm bảo toàn vẹn dữ liệu, hỗ trợ truy cập đồng thời và cung cấp nhiều cơ chế truy vấn, truy xuất dữ liệu.
Ngược lại, data warehouse là kho lưu trữ có cấu trúc cao và được tối ưu hóa để lưu, tổ chức và truy vấn dữ liệu có cấu trúc chủ yếu phục vụ mục đích phân tích. Chúng thường tuân theo lược đồ định sẵn, đảm bảo chất lượng và tính nhất quán dữ liệu, và được tối ưu cho các tác vụ truy vấn, lập báo cáo phức tạp.
Data warehouse lý tưởng cho doanh nghiệp muốn ra quyết định dựa trên dữ liệu lịch sử, vì chúng cung cấp nguồn sự thật duy nhất cho báo cáo và phân tích chuẩn hóa. Dữ liệu thường được trích xuất từ nhiều nguồn, chuyển đổi về định dạng nhất quán, rồi nạp vào data warehouse để phân tích.
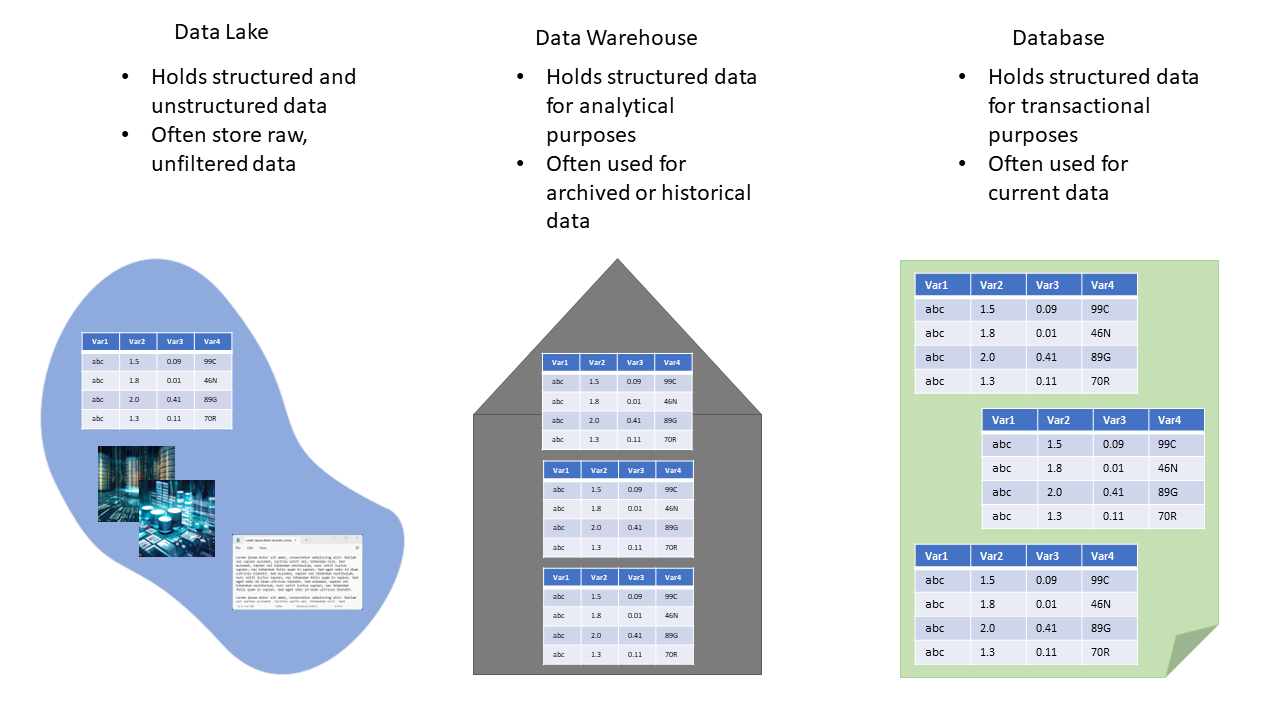
Hình 3: Minh họa một số khác biệt giữa data lake, data warehouse và database. Data lake có thể được dùng như bước tiền xử lý trong một pipeline kết thúc ở warehouse hoặc database.
Pipeline thường tuân theo một trong hai lược đồ chính: ETL (Extract, Transform, Load) hoặc ELT (Extract, Load, Transform).
ETL đi theo cách tiếp cận tuần tự. Trước tiên, dữ liệu được trích xuất từ nhiều hệ thống nguồn, có thể gồm cơ sở dữ liệu, tệp, API hoặc kho dữ liệu khác.
Sau khi trích xuất, dữ liệu được chuyển đổi để đáp ứng lược đồ, chất lượng và quy tắc nghiệp vụ mong muốn. Việc chuyển đổi có thể bao gồm làm sạch, tổng hợp và cấu trúc dữ liệu. Cuối cùng, dữ liệu đã chuyển đổi được nạp vào data warehouse hoặc hệ thống lưu trữ đích, thường ở định dạng tối ưu cho báo cáo và phân tích.
ETL hữu ích khi dữ liệu cần tái cấu trúc hoặc làm sạch đáng kể trước khi lưu trong data warehouse, vì nó đảm bảo dữ liệu sạch và sẵn sàng cho phân tích. Khóa học ETL với Python này cung cấp cái nhìn chi tiết về ETL bằng Python và SQL.
ELT thì đảo ngược thứ tự bước chuyển đổi. Trong ELT, dữ liệu trước tiên được trích xuất từ hệ thống nguồn và nạp vào data warehouse, hoặc đôi khi là data lake, ở dạng nguyên bản, chưa chuyển đổi đáng kể. Việc chuyển đổi và xử lý dữ liệu diễn ra ngay trong data warehouse.
Cách tiếp cận này tận dụng sức mạnh xử lý và tính linh hoạt của các data warehouse hiện đại và nền tảng big data, phù hợp khi bạn muốn lưu trữ lượng lớn dữ liệu thô và thực hiện chuyển đổi theo nhu cầu.
ELT thường được ưa chuộng khi bạn có giải pháp data warehouse có thể xử lý chuyển đổi phức tạp hiệu quả, như các data warehouse trên đám mây hoặc khung xử lý phân tán như Hadoop.
Có rất nhiều công cụ để phát triển pipeline. Việc chọn đúng công cụ phụ thuộc vào quy mô pipeline, nhu cầu mở rộng, nguồn kinh phí và mục tiêu pipeline. Bạn có thể tạo một pipeline hoàn chỉnh bằng Python và SQL (hoặc R và SQL), hoặc dùng một số công cụ thương mại.
Dưới đây là danh sách ngắn một vài công nghệ và công cụ thương mại phổ biến.
Bạn có thể xem danh sách các công cụ ETL tốt nhất và lý do sử dụng chúng trong một bài viết khác.
Bước đầu tiên để tạo data pipeline là thu thập dữ liệu đưa vào pipeline. Có nhiều nơi để lấy thông tin cập nhật trực tuyến, bao gồm trang web của chính phủ, mạng xã hội và một số tổ chức phi lợi nhuận. Thường thì các nguồn này có API khá dễ dùng.
API (application programming interface) về cơ bản là phần mềm cho phép truyền thông giữa hai hay nhiều ứng dụng. Ví dụ, bạn có thể tích hợp API của Twitter vào ứng dụng Python để ứng dụng đăng tweet hoặc “đọc” tweet thay bạn. Nó giống như một cầu nối.
Bạn có thể dùng API ở đầu pipeline để thu thập dữ liệu từ nhiều nguồn. Ví dụ, bạn có thể dùng API để thu thập dữ liệu hồ sơ doanh nghiệp từ SEC hoặc thu thập dữ liệu lâm sàng từ các bảng do NIH lưu trữ.
Một kỹ thuật khác để thu thập dữ liệu là web scraping. Đây là kỹ thuật dùng script viết riêng để thu thập thông tin từ một trang web trên Internet. Các thư viện Python như BeautifulSoup và Scrapy khiến quá trình này khá dễ dàng, nhưng bạn vẫn cần biết cách điều hướng qua html hoặc xml để tìm thông tin cần thiết.
Nếu bạn muốn học thêm về web scraping, DataCamp có tài liệu về Beautiful Soup của Python, web scraping bằng R và web scraping cho NLP.
Cũng có những dịch vụ web scraping không cần viết mã. Đây là một dịch vụ như vậy cho phép bạn thu thập thông tin từ một trang và theo dõi thay đổi của trang.
Quy trình thu thập dữ liệu của bạn có thể bao gồm hỗn hợp dữ liệu có cấu trúc (như bảng tính hoặc cơ sở dữ liệu) và dữ liệu phi cấu trúc (như văn bản hoặc hình ảnh).
Tùy vào mục tiêu cuối của pipeline, bạn có thể trích xuất thông tin từ dữ liệu phi cấu trúc để tạo bộ dữ liệu có cấu trúc đồng nhất, hoặc giữ lại một phần phi cấu trúc và chỉ cần đảm bảo end user có sẵn tham chiếu chéo phù hợp.
Dữ liệu có cấu trúc thường có thể trích xuất bằng truy vấn SQL hoặc công cụ ETL, trong khi dữ liệu phi cấu trúc có thể cần kỹ thuật xử lý ngôn ngữ tự nhiên (NLP) hoặc công cụ chuyên biệt.
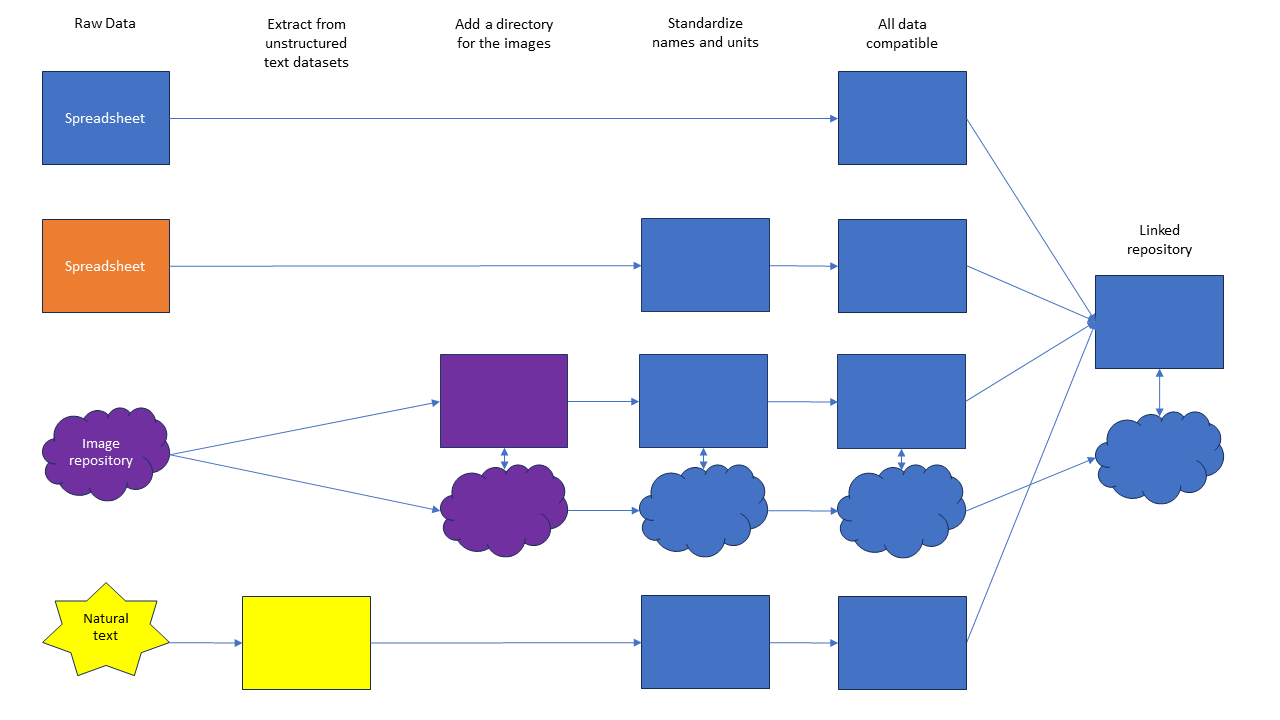
Hình 4: Ví dụ về data pipeline giữ nguyên dữ liệu phi cấu trúc ở đầu ra. Trong ví dụ này, chúng ta muốn tạo một kho chứa dữ liệu có cấu trúc đã tuyển chọn và các hình ảnh được liên kết. Đây cũng có thể là một data lake. Vì vậy, thay vì trích xuất dữ liệu có cấu trúc từ hình ảnh, chúng ta tạo một thư mục liên kết hình ảnh với dữ liệu liên quan trong cơ sở dữ liệu. Người dùng cuối có thể truy xuất ảnh thô cho mỗi hàng trong bảng tính khi cần. Ngoài ra, chúng ta cũng có thể phân tích hình ảnh và cung cấp ảnh đã tách hoặc loại bỏ một số phần. Để biết cách thực hiện, hãy xem hướng dẫn phân tích ảnh này.
Khi đã có nguồn dữ liệu và mục tiêu đầu ra, bạn có thể bắt đầu thiết lập pipeline.
Điều đầu tiên bạn cần làm là lập kế hoạch cho pipeline. Tôi gợi ý phác thảo trên giấy trước. Ở mép trái tờ giấy, ghi các nguồn dữ liệu, và ở mép phải, ghi mục tiêu cuối. Ở giữa, bạn liệt kê tất cả các bước cần có để đi từ nguồn đến mục tiêu.
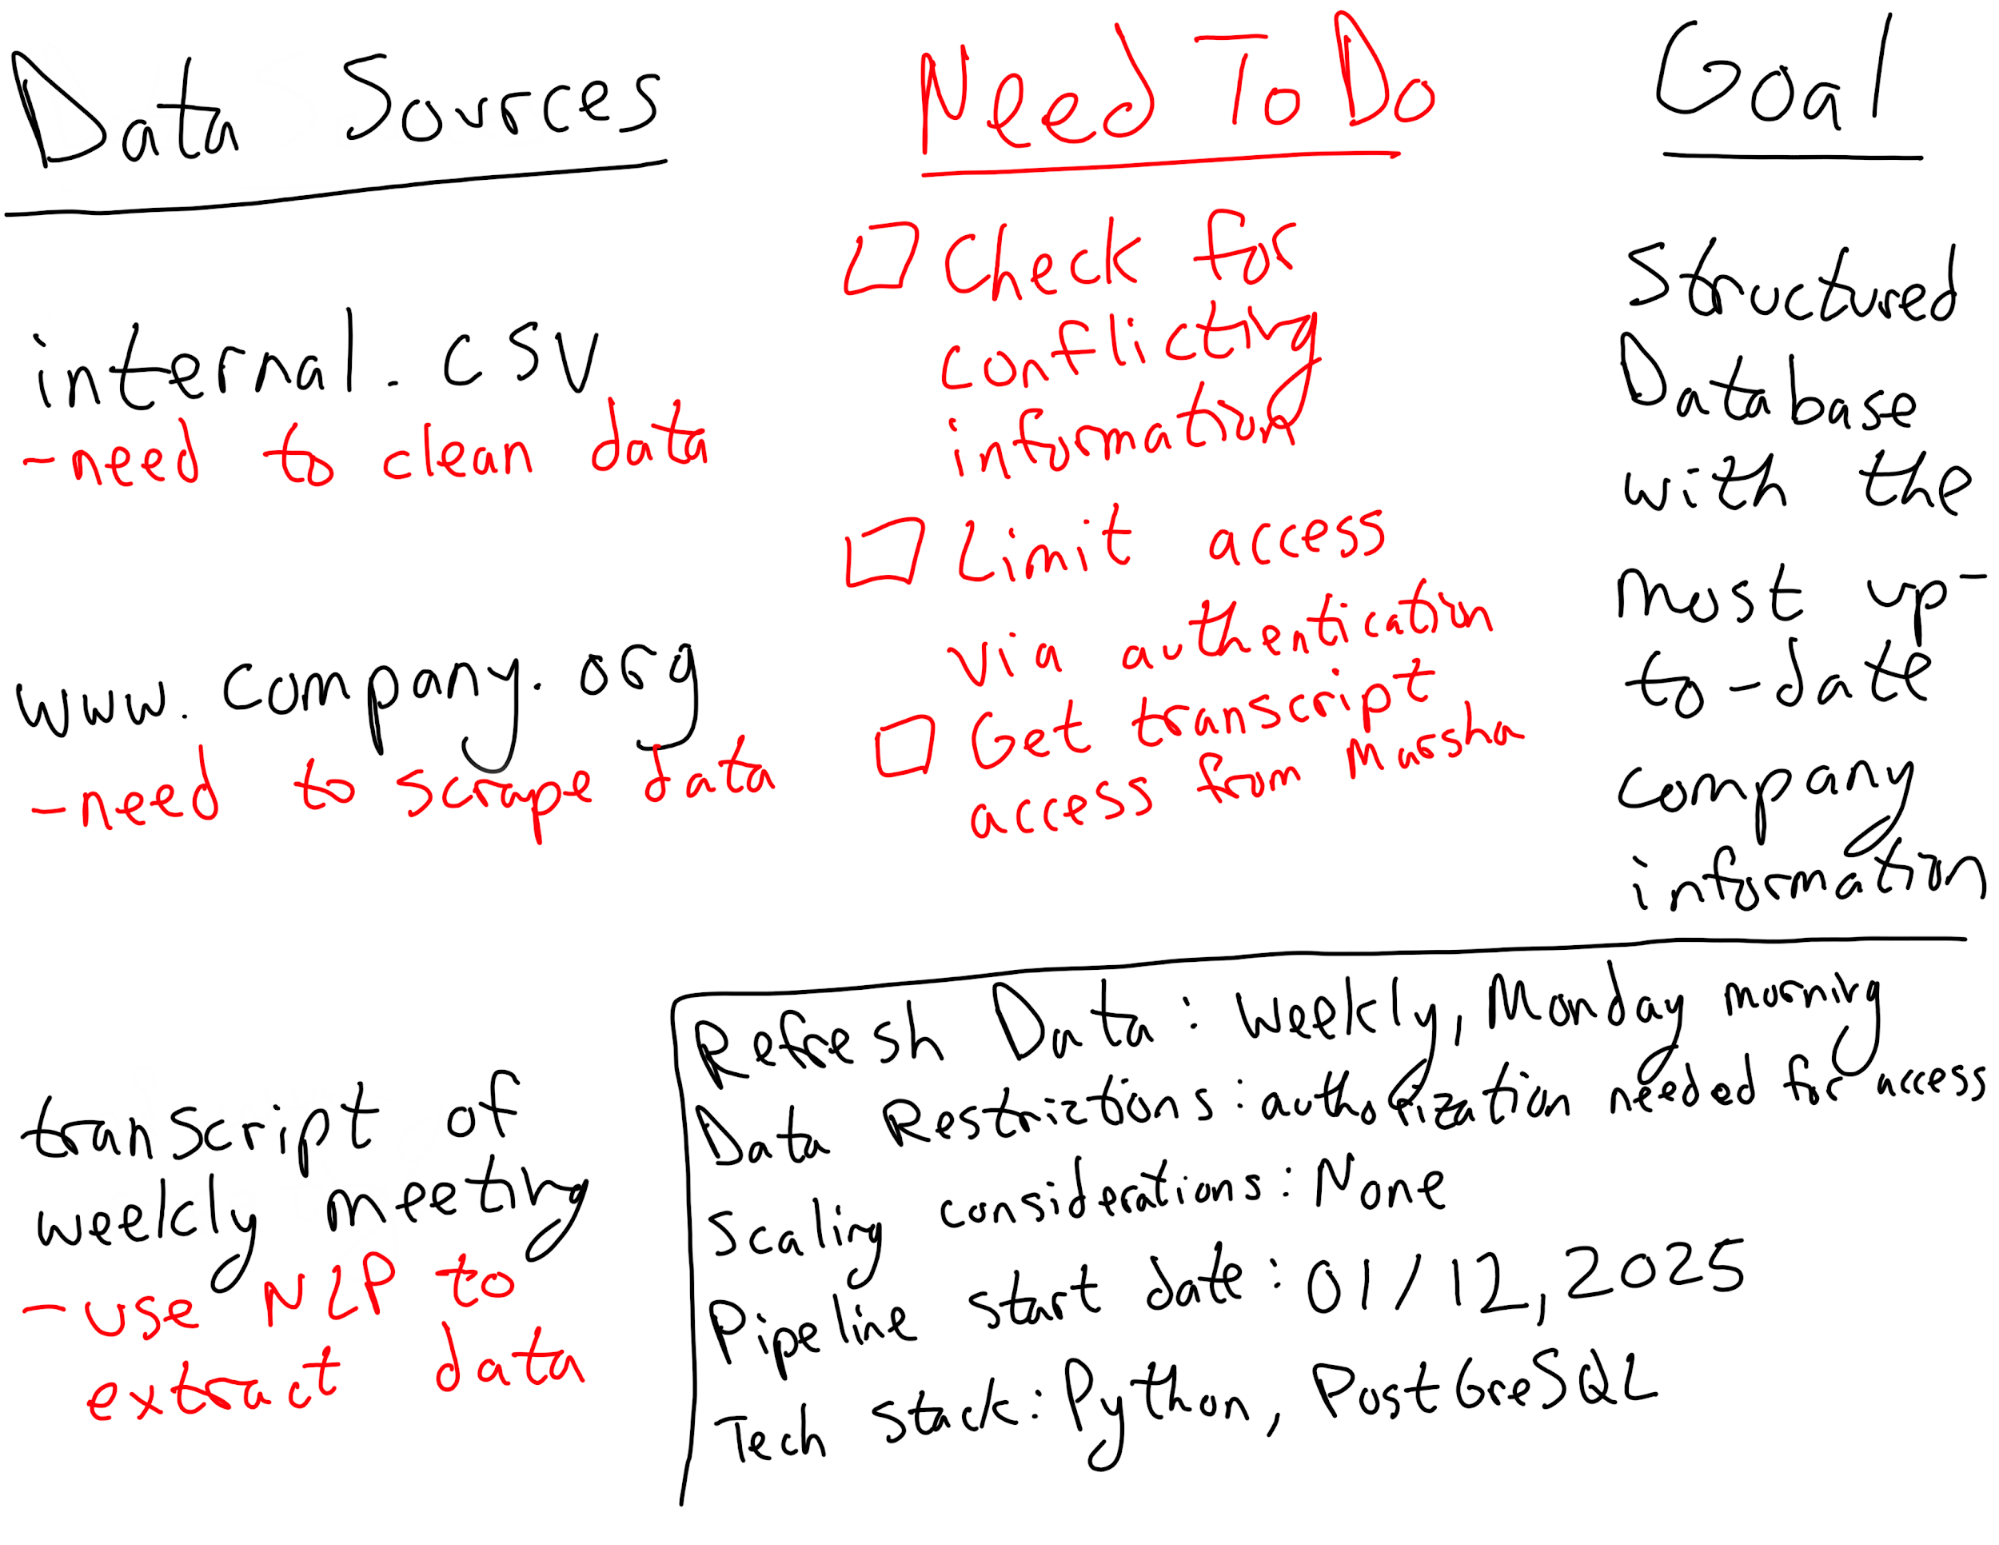
Hình 5: Ví dụ kế hoạch cho một pipeline.
Một số bước tiềm năng bạn cần bao gồm có thể là:
Khi đã vạch ra kế hoạch, bạn cần bắt tay xây dựng. Việc này có thể được lập trình hoàn toàn bằng ngôn ngữ yêu thích của bạn, hoặc kết hợp một hay nhiều dịch vụ hỗ trợ pipeline. Luôn ghi nhớ người dùng cuối và những gì họ cần trong suốt quá trình xây dựng pipeline.
Một quyết định then chốt là bạn muốn dữ liệu được cập nhật thường xuyên đến mức nào. Nếu cần thông tin mới nhất, bạn phải thiết lập pipeline xử lý thời gian thực. Tuy nhiên, nếu không cần độ chính xác ở mức đó, bạn có thể cân nhắc xử lý theo lô để tiết kiệm tài nguyên. Nghĩa là dữ liệu sẽ đi qua các bước của pipeline theo từng lô, ví dụ hàng tuần hoặc hàng ngày, thay vì liên tục.
Một điều khác cần lưu ý khi xây dựng pipeline là cách bạn sẽ bảo trì về sau. Bạn sẽ muốn tạo cơ chế giám sát hoạt động của pipeline và có khả năng phát hiện, khắc phục các sự cố bất ngờ.
Lỗi chính tả, mục nhập thiếu hoặc trùng lặp, và các loại tệp khác nhau chỉ là vài trong số nhiều thách thức mà pipeline có thể gặp phải lâu sau khi triển khai ban đầu. Xây dựng hệ thống xử lý lỗi và giám sát vững chắc có thể giúp bạn tránh nhiều phiền toái.
Để xem chi tiết hơn về thiết kế data pipeline, đặc biệt trong bối cảnh học máy, hãy xem Khóa học Designing Machine Learning Workflows in Python của DataCamp.
Như mọi thứ liên quan đến dữ liệu, điều quan trọng là thiết kế pipeline chỉ phức tạp ở mức cần thiết. Pipeline càng đơn giản càng dễ và rẻ để bảo trì, dễ cập nhật, và dễ hiểu nếu bạn cần bàn giao cho kỹ sư khác.
Ngay từ đầu quá trình thiết kế, cần đánh giá yêu cầu của dự án, bao gồm cả nhu cầu mở rộng dự kiến trong tương lai. Làm vậy sẽ giúp bạn chọn mức độ phức tạp hợp lý.
Ví dụ, nếu bạn cần một pipeline tạm thời để thu thập dữ liệu từ ba cảm biến trong vài tháng, bạn có thể cân nhắc một pipeline một bước đơn giản dùng tài nguyên miễn phí, phổ biến như Google Drive.
Tuy nhiên, nếu bạn có dữ liệu nhạy cảm hoặc cần thực hiện nhiều chuyển đổi, bạn có thể cần viết mã Python hoặc C# tùy biến kèm mã hóa cho pipeline.
Cuối cùng, bạn có thể đang thiết lập một pipeline hiện tại còn nhỏ, nhưng dự kiến mở rộng quy mô lớn trong vài năm tới. Trong trường hợp này, bạn có lẽ nên tạo pipeline với hạ tầng đủ sức xử lý việc mở rộng.
Sẽ rất cám dỗ khi thiết kế một pipeline nhỏ trước, rồi tính xây pipeline mới cho quy mô lớn khi cần. Cách đó có thể hiệu quả, nhưng hãy thận trọng!
Nhiều kỹ sư dữ liệu phải chắp vá một pipeline không được thiết kế cho quy mô hiện tại vì việc tạo mới bị coi là quá tốn kém hoặc tốn thời gian.
Dù sự đơn giản là then chốt, nếu bạn xây dựng pipeline dài hạn, hãy khôn ngoan khi tính đến các kế hoạch mở rộng dự kiến.
Một vài câu hỏi bạn có thể cân nhắc từ đầu dự án:
Một chiếc bẫy phổ biến mà kỹ sư trẻ hay mắc phải là chạy theo xu hướng thay vì dùng công cụ tốt nhất cho công việc.
Ví dụ điển hình là việc nhiều công ty cố gò ép AI sinh sinh vào ngăn xếp công nghệ dù không có bài toán phù hợp.
Là người làm dữ liệu, việc cập nhật công nghệ và xu hướng mới là quan trọng. Tuy nhiên, hãy đảm bảo bạn chọn công cụ phù hợp nhất với dự án thay vì chạy theo xu hướng có thể dẫn đến một pipeline kém chất lượng.
Khi đã có kế hoạch cho pipeline, việc cân nhắc các phương pháp tối ưu hóa là quan trọng. Bạn muốn nhận được dữ liệu cần thiết, với độ phân giải và tần suất làm mới mong muốn, đồng thời giảm thiểu tài nguyên tính toán tiêu thụ hoặc độ trễ khi dữ liệu đi qua pipeline.
Thành phần then chốt của tối ưu hóa pipeline là giám sát và ghi log luồng dữ liệu qua pipeline. Điều này cho bạn cái nhìn về nơi các nút thắt cổ chai có thể làm chậm luồng dữ liệu hoặc tiêu tốn nhiều tài nguyên.
Những nút thắt thường gặp có thể bao gồm nguồn dữ liệu chậm, giới hạn tài nguyên hoặc các chuyển đổi dữ liệu kém hiệu quả.
Sau khi xác định nút thắt, bạn có thể cân nhắc các cách tối ưu hiệu năng:
Một yếu tố tối ưu khác là tần suất làm mới dữ liệu. Nếu dữ liệu được làm mới qua pipeline mỗi phút, nhưng bạn chỉ cần cập nhật mỗi năm phút, thì giảm số lần làm mới không cần thiết có thể giải phóng bộ xử lý và giảm tiêu thụ năng lượng.
Một số loại dữ liệu chảy qua pipeline của bạn có thể có yêu cầu về bảo mật hoặc quyền riêng tư. Ví dụ, dữ liệu y tế chịu sự quản lý chặt chẽ của chính phủ Mỹ và đòi hỏi biện pháp bảo mật đáng kể hơn so với dữ liệu về thói quen xem truyền thông. Những ví dụ khác cần bảo mật cao là dữ liệu tài chính và mật khẩu.
Loại biện pháp bảo mật bạn áp dụng sẽ phụ thuộc vào mối quan ngại bảo mật của từng loại dữ liệu. Trong một số trường hợp, ẩn danh có thể là đủ, khi thông tin cá nhân được tách rời hoặc xóa khỏi tập dữ liệu. Điều này có thể dùng trong nghiên cứu y khoa khi không cần thông tin nhận dạng cá nhân, nhưng các thông tin khác trong hồ sơ là cần thiết.
Những biện pháp bảo mật khác bạn có thể cần gồm mã hóa và kiểm soát truy cập dữ liệu qua ủy quyền đăng nhập. Các phương pháp này có thể được dùng cho dữ liệu tài chính hoặc bí mật công ty.
Với mọi dữ liệu nhạy cảm, điều quan trọng là bạn nắm rõ và tuân thủ các quy định của chính phủ, như GDPR (Quy định Bảo vệ Dữ liệu Chung) hoặc HIPAA (Đạo luật Trách nhiệm và Khả năng Giải trình Bảo hiểm Y tế).
Tùy ngành và loại dữ liệu bạn xử lý, bạn có thể cần tuân thủ thêm các quy định khác như CCPA (Đạo luật Quyền riêng tư Người tiêu dùng California) hoặc FERPA (Đạo luật Quyền Giáo dục Gia đình và Quyền riêng tư).
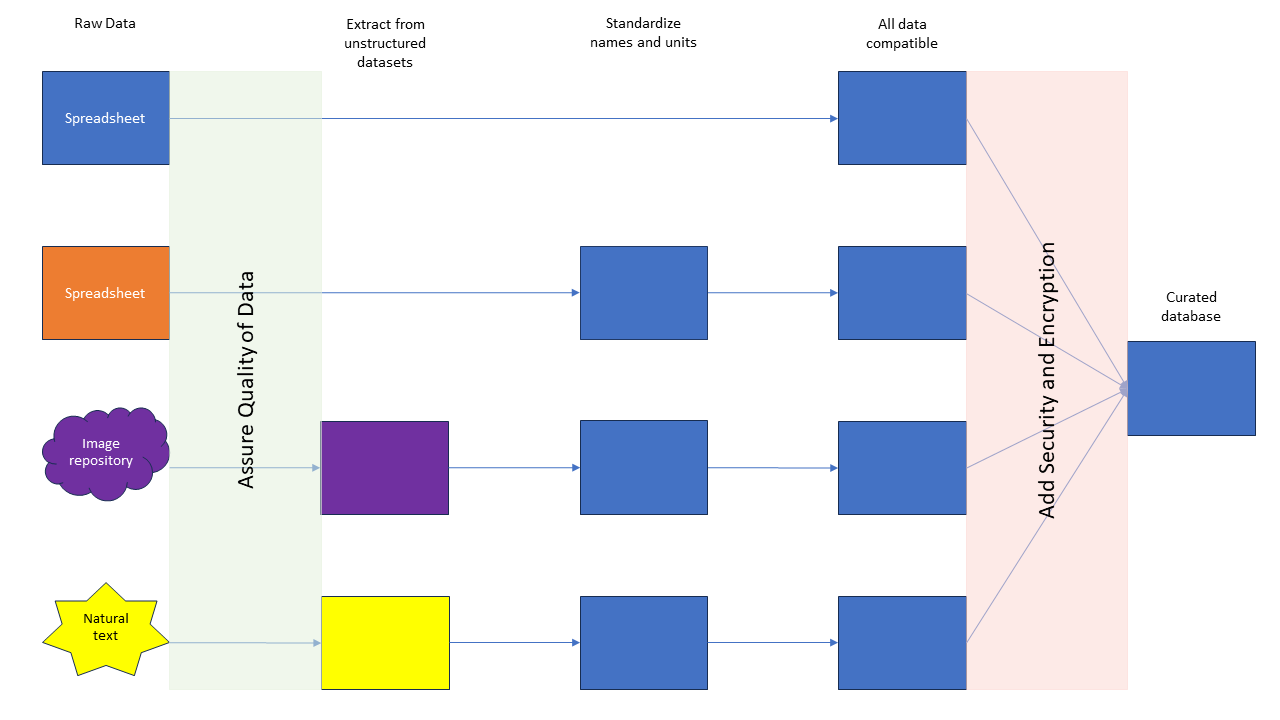
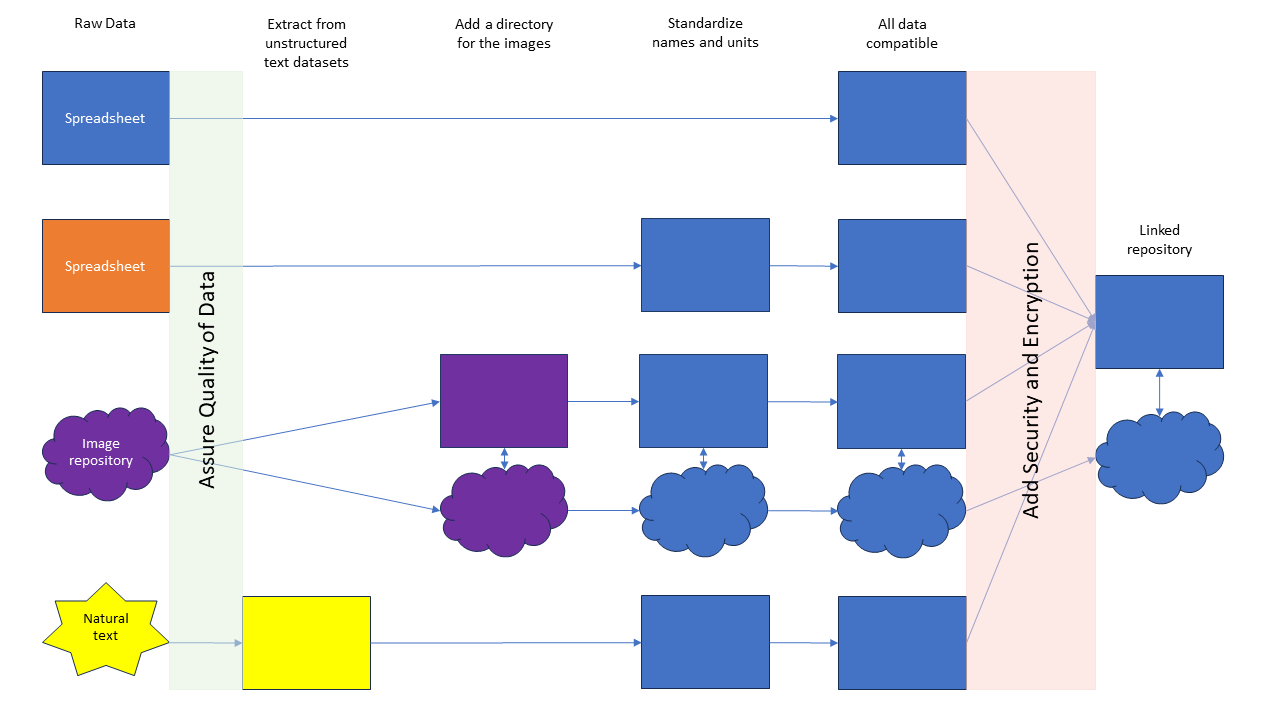
Hình 6: Ví dụ về việc thêm các bước đảm bảo chất lượng và bảo mật vào pipeline.
Data pipeline và những kỹ sư xây dựng chúng là những anh hùng thầm lặng trong thế giới dữ liệu. Họ cho phép dữ liệu luân chuyển liền mạch từ nơi này sang nơi khác, đồng thời tổ chức và sắp xếp chúng. Theo Statista, riêng năm 2020, thế giới đã tạo ra, tiêu thụ và lưu trữ 64,2 zettabyte dữ liệu, và con số này tăng lên mỗi năm.
Việc xây dựng và duy trì các data pipeline vững chắc ngày càng trở nên thiết yếu trong bối cảnh dữ liệu này. Nếu hướng dẫn này khiến bạn hứng thú với data pipeline, hãy xem khóa học nhập môn để có góc nhìn sâu hơn. Nếu bạn muốn học cách xây dựng data pipeline, hãy bắt đầu với khóa Python Data Engineering. Và nếu bạn muốn khởi đầu sự nghiệp và chứng minh năng lực với nhà tuyển dụng, hãy tham khảo Chứng chỉ Data Engineer của chúng tôi.
Bắt đầu học cách sử dụng Data Pipeline ngay hôm nay!
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
