
{count, plural, one {Kursus} other {Kursus}}
ETL dan ELT di Python
{hours} jam
40.2K
Data sangat penting bagi bisnis dan organisasi, dan tugas mengatur aliran semua data itulah yang membuat data pipeline berperan. Jadi, apa itu data pipeline, dan apa yang perlu Anda ketahui untuk membangun pipeline sendiri?
Data adalah darah kehidupan bagi bisnis dan organisasi modern, yang mendorong pengambilan keputusan, wawasan, dan inovasi. Namun, mengelola dan memanfaatkan kekuatan data bisa menjadi tugas yang kompleks dan menantang. Di sinilah data pipeline berperan. Tetapi, apa itu data pipeline?
Data pipeline adalah sistem untuk mengambil data dari berbagai sumber dan menyalurkannya ke lokasi baru, seperti basis data, repositori, atau aplikasi, serta melakukan transformasi data yang diperlukan (mengonversi data dari satu format atau struktur ke format atau struktur lain) sepanjang prosesnya. Pengguna akhir pipeline ini beragam, mulai dari analis hingga data scientist hingga pemimpin bisnis.
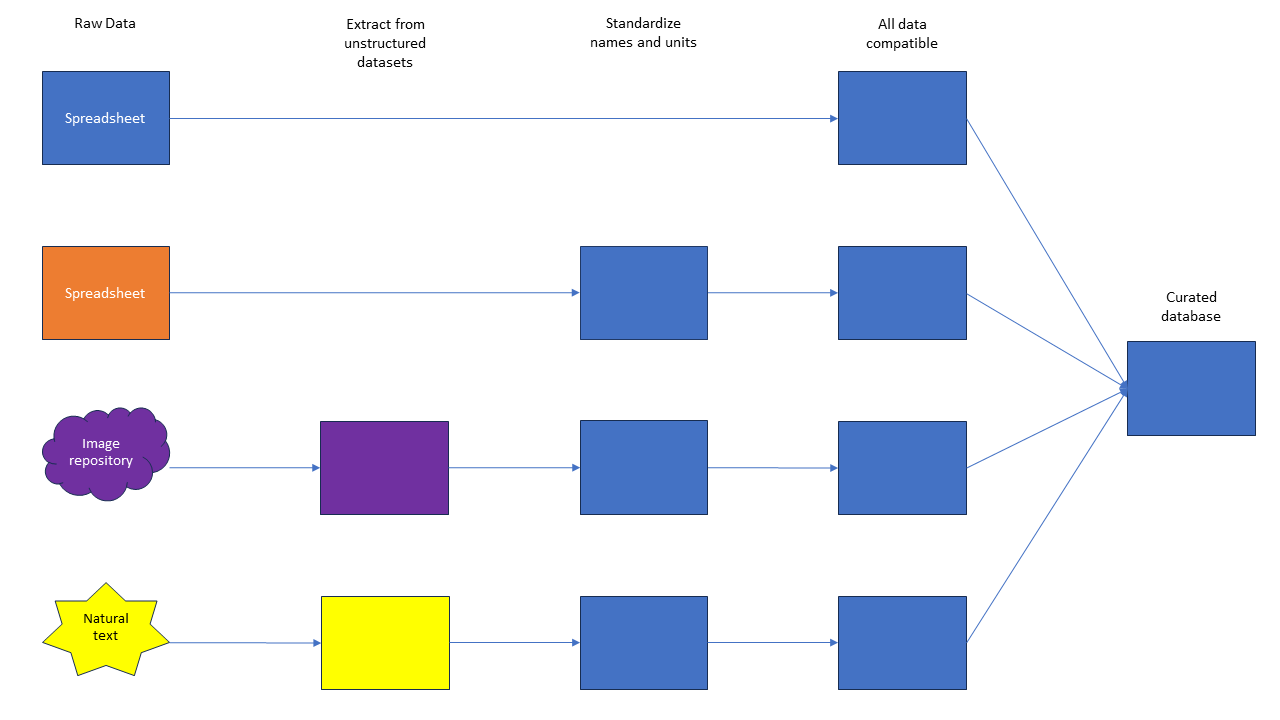
Gambar 1: Contoh data pipeline sederhana. Dalam contoh ini, Anda memiliki empat sumber data: dua terstruktur dan dua tidak terstruktur. Melalui serangkaian langkah, Anda mengekstrak data terstruktur dari kumpulan data tidak terstruktur, menstandarkan semua nama dan satuan, dan, setelah semua data kompatibel, Anda dapat membuat satu basis data terkurasi dengan semua informasi yang diperlukan. Basis data ini kemudian dapat digunakan oleh analis, ilmuwan, atau pemimpin bisnis.
Meskipun terdengar sederhana, ini disertai banyak tantangan dan keputusan. Di banyak organisasi, membangun dan memelihara pipeline merupakan pekerjaan tersendiri yang ditangani oleh data engineer. Di organisasi lain, ini hanyalah salah satu dari sekian banyak tugas yang dilakukan oleh data scientist. Siapa yang memelihara pipeline sering kali bergantung pada ukuran organisasi, kompleksitas pipeline, dan pendanaan yang tersedia.
Membangun pipeline yang andal, aman, dan tepat waktu merupakan bagian krusial dari pengambilan keputusan berbasis data. Baik Anda tertarik mengejar rekayasa data atau karier di bagian lain dari proses data, memahami data pipeline akan sangat bermanfaat.
Anda mungkin bertanya-tanya mengapa Anda perlu membangun pipeline sama sekali. Jika Anda telah bekerja dengan kumpulan data siap pakai atau data yang berasal dari satu sumber saja, seperti yang mungkin Anda temukan dari latihan Kaggle atau DataCamp, Anda mungkin tidak memerlukan pipeline sama sekali. Kumpulan data terkurasi ini sudah disiapkan agar analis dapat menarik dan mengolahnya secara langsung.
Namun, jika Anda ingin menggabungkan informasi dari banyak sumber, Anda mungkin perlu menyiapkan pipeline untuk memastikan semua data dapat diakses untuk analisis Anda.
Berikut beberapa alasan utama mengapa Anda mungkin mempertimbangkan menggunakan data pipeline:
Sebagai contoh, bayangkan Anda ingin mengetahui apakah rata-rata IPK siswa di sebuah distrik sekolah berkorelasi dengan pendapatan rata-rata di county atau dengan ukuran populasi. Untuk analisis ini, Anda mungkin perlu menarik data IPK dari setiap distrik sekolah dalam analisis Anda, data pendapatan dari IRS, dan ukuran populasi dari Biro Sensus.
Anda mungkin bisa menarik informasi ini secara manual sekali. Namun bayangkan Anda perlu mengulangi analisis ini secara berkala. Membangun pipeline yang andal dapat membantu Anda mengotomatisasi pengumpulan informasi ini, menghemat waktu dan mengurangi kerepotan.
Selain hanya mengumpulkan data di satu tempat, pipeline dapat membantu Anda menangani ketidakkonsistenan pada data dari berbagai sumber. Misalnya, Biro Sensus mungkin mengidentifikasi county dengan nama lengkap, sementara IRS mungkin mengidentifikasi county dengan nama yang disingkat.
Di dalam pipeline, Anda dapat menyiapkan sistem untuk menstandarkan cara county diidentifikasi di repositori akhir. Atau, mungkin populasi ditandai dengan satuan yang berbeda pada entri yang berbeda, dan Anda perlu menstandarkan sistem satuan yang digunakan di tujuan akhir Anda. Jenis perubahan seperti ini disebut transformasi.
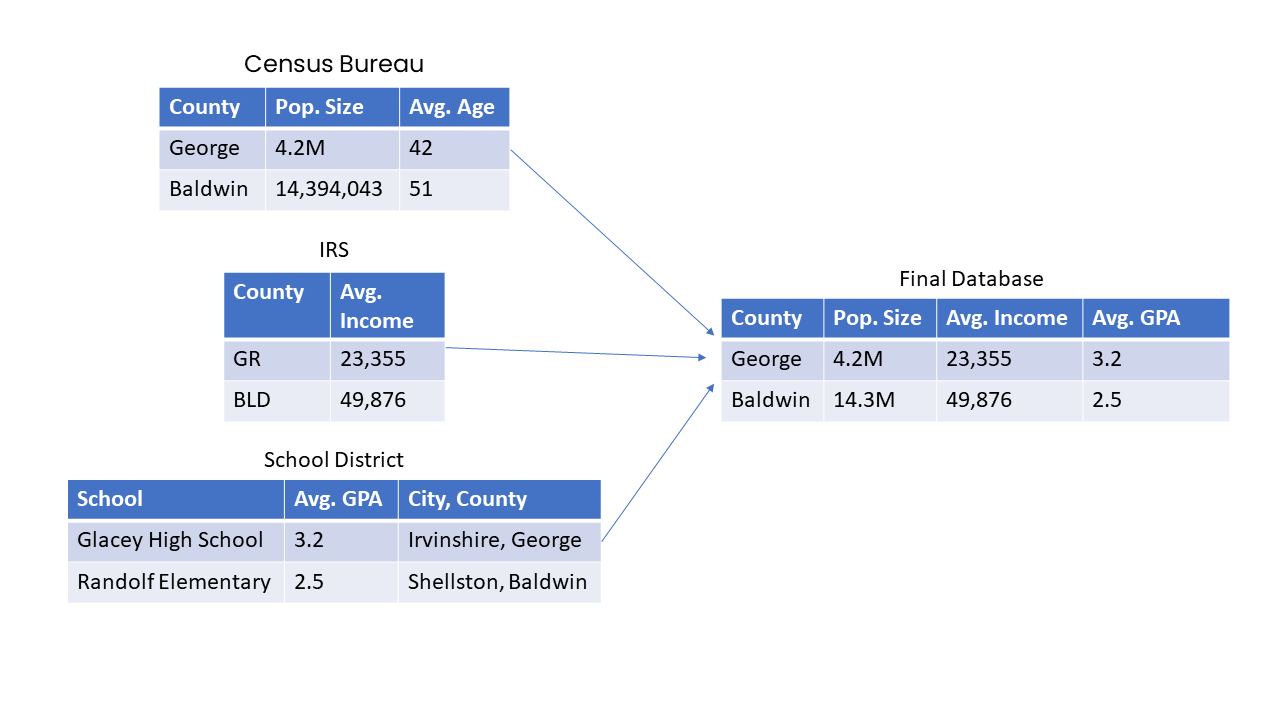
Gambar 2: Saat menggabungkan informasi dari berbagai sumber, transformasi seperti perubahan satuan dan standarisasi nama mungkin diperlukan.
Data pipeline umumnya dikembangkan dan dipelihara oleh data engineer.
Setelah data dikumpulkan, dibersihkan, dan diatur di akhir pipeline, data dapat diambil oleh berbagai pemangku kepentingan, termasuk data analyst, data scientist, atau business analyst.
Data tersebut kemudian dapat digunakan untuk analitik real-time, dimasukkan ke dasbor yang diperbarui, atau ditambahkan ke model pembelajaran mesin. Terkadang, akhir dari pipeline bisa berupa aplikasi atau dasbor yang digunakan oleh pemimpin bisnis atau individu.
Pipeline digunakan oleh hampir setiap sektor yang memanfaatkan data dalam jumlah besar. Di beberapa organisasi besar, seperti di sektor teknologi, pipeline mereka akan kompleks, sangat teregulasi, dan dikelola oleh tim engineer khusus.
Di organisasi yang lebih kecil, misalnya seorang peneliti tunggal yang mencoba mengumpulkan data dari banyak sensor di seluruh dunia, pipeline mungkin sangat lugas dan sederhana, hanya dengan beberapa langkah. Contoh lain di mana pipeline dapat digunakan adalah pialang saham yang mengumpulkan informasi keuangan untuk memutuskan saham mana yang akan dibeli atau sistem rumah sakit yang mengumpulkan rekam medis pasien dari berbagai afiliasi rumah sakitnya.
Pipeline juga krusial untuk model pembelajaran mesin. Model-model ini mengonsumsi data dalam jumlah besar, dan pipeline yang tepat sangat penting agar fungsinya berjalan mulus. Tutorial MLOps ini memberikan detail lebih lanjut tentang bagaimana pipeline digunakan dalam pembelajaran mesin.
Data dapat disimpan dengan beberapa cara berbeda, bergantung pada jenis data dan penggunaan yang Anda inginkan. Tiga istilah yang mungkin sering Anda temui terkait penyimpanan data adalah data lake, database, dan data warehouse. Mari singgung secara singkat masing-masing.
Data lake adalah repositori penyimpanan besar dan fleksibel yang dapat menampung data terstruktur dan tidak terstruktur dalam skala besar. Data lake memungkinkan organisasi menyimpan data mentah yang belum diproses dari berbagai sumber, seperti log web, sensor, media sosial, dan lainnya, dalam format aslinya.
Data lake dikenal karena versatilitasnya, karena memungkinkan data scientist dan analis untuk mengeksplorasi, mentransformasikan, dan menganalisis data dengan berbagai cara. Data lake sangat berharga untuk kasus penggunaan big data dan analitik lanjutan di mana skema dan struktur data tidak ditentukan sebelumnya, memberi organisasi fleksibilitas untuk mengekstrak wawasan dari beragam sumber data.
Database adalah sistem serbaguna yang digunakan untuk menyimpan, mengelola, dan mengambil data terstruktur secara efisien. Meskipun memiliki beberapa kesamaan dengan data warehouse, database biasanya digunakan untuk data transaksional, operasi harian, dan aplikasi real-time. Ada berbagai jenis, termasuk database relasional, NoSQL, dan in-memory, masing-masing sesuai untuk kebutuhan penyimpanan dan pemrosesan data tertentu. Database memastikan integritas data, mendukung akses bersamaan, dan menyediakan berbagai mekanisme untuk melakukan kueri dan pengambilan data.
Sebaliknya, data warehouse adalah repositori yang sangat terstruktur dan dioptimalkan yang dirancang untuk menyimpan, mengorganisasi, dan melakukan kueri pada data terstruktur terutama untuk tujuan analitis. Data warehouse biasanya mengikuti skema yang telah ditentukan, menegakkan kualitas dan konsistensi data, dan dioptimalkan untuk tugas kueri dan pelaporan yang kompleks.
Data warehouse ideal bagi bisnis yang ingin membuat keputusan berdasarkan data historis, karena menyediakan satu sumber kebenaran untuk pelaporan dan analitik yang terstandar. Data biasanya diekstraksi dari berbagai sumber, ditransformasikan ke format yang konsisten, dan dimuat ke dalam data warehouse untuk dianalisis.
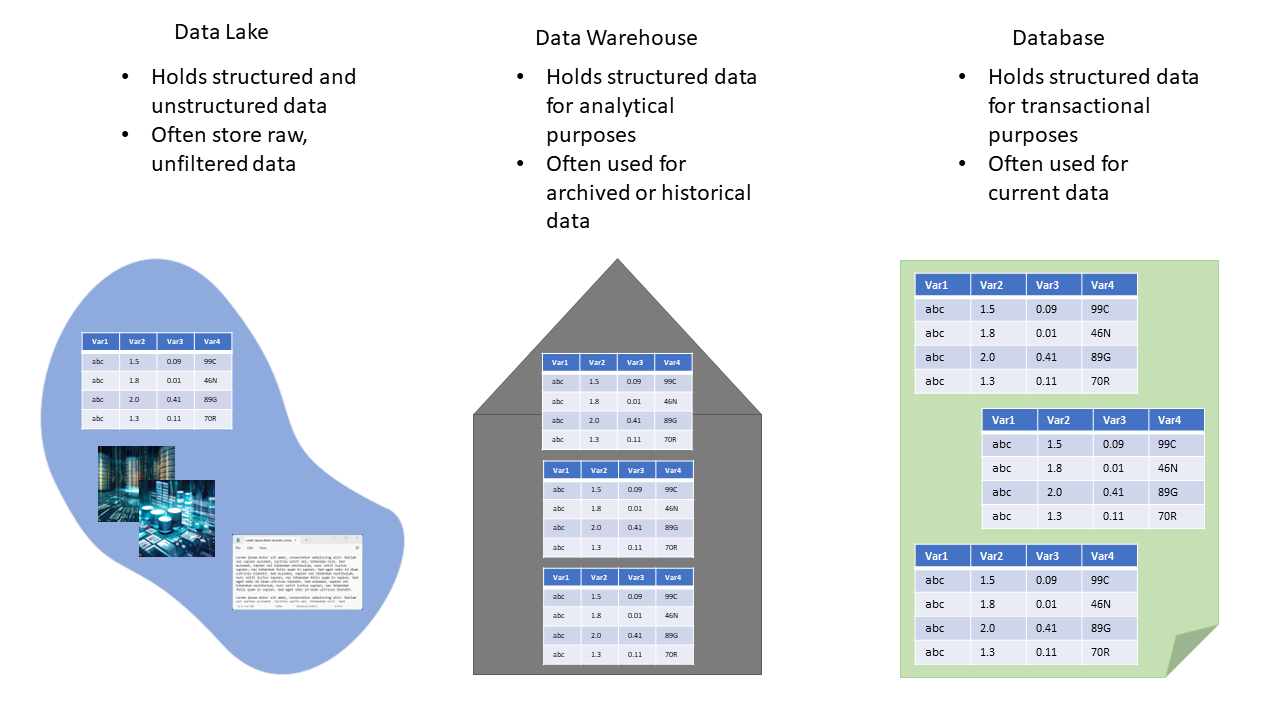
Gambar 3: Menampilkan beberapa perbedaan antara data lake, data warehouse, dan database. Data lake dapat digunakan sebagai langkah pendahulu dalam pipeline yang mungkin berakhir di warehouse atau database.
Pipeline umumnya mengikuti salah satu dari dua skema utama: ETL (Extract, Transform, Load) atau ELT (Extract, Load, Transform).
ETL mengikuti pendekatan berurutan. Pertama, data diekstraksi dari berbagai sistem sumber, yang dapat mencakup basis data, file, API, atau repositori data lainnya.
Setelah diekstraksi, data ditransformasikan agar sesuai dengan skema, kualitas, dan aturan bisnis yang diinginkan. Transformasi ini dapat melibatkan pembersihan, pengagregasian, dan penataan data. Terakhir, data yang telah ditransformasikan dimuat ke target data warehouse atau sistem penyimpanan, sering kali dalam format yang dioptimalkan untuk pelaporan dan analitik.
ETL bermanfaat ketika data memerlukan restrukturisasi atau pembersihan signifikan sebelum disimpan di data warehouse, karena memastikan data bersih dan siap dianalisis. Kursus ETL dengan Python ini memberikan gambaran mendetail tentang ETL menggunakan Python dan SQL.
ELT, di sisi lain, membalik urutan langkah transformasi. Dalam proses ELT, data terlebih dahulu diekstraksi dari sistem sumber dan dimuat ke dalam data warehouse, atau terkadang data lake, apa adanya, tanpa transformasi signifikan. Transformasi dan pemrosesan data terjadi di dalam data warehouse itu sendiri.
Pendekatan ini memanfaatkan daya pemrosesan dan fleksibilitas data warehouse modern serta platform big data, sehingga cocok untuk skenario di mana Anda ingin menyimpan data mentah dalam jumlah besar dan melakukan transformasi sesuai kebutuhan.
ELT sering dipilih ketika Anda memiliki solusi data warehousing yang dapat menangani transformasi kompleks secara efisien, seperti data warehouse berbasis cloud atau kerangka pemrosesan data terdistribusi seperti Hadoop.
Ada banyak alat yang tersedia untuk mengembangkan pipeline. Memilih yang tepat akan bergantung pada ukuran pipeline Anda, kebutuhan penskalaan, pendanaan yang tersedia, dan tujuan pipeline. Anda dapat membuat pipeline lengkap menggunakan Python dan SQL, (atau R dan SQL), atau Anda dapat menggunakan beberapa alat komersial yang beragam.
Berikut daftar singkat beberapa teknologi dan alat komersial yang umum.
Anda dapat melihat daftar alat ETL terbaik dan alasan menggunakannya di artikel terpisah.
Langkah pertama dalam membuat data pipeline adalah mengumpulkan data yang akan dimasukkan ke dalam pipeline. Ada beberapa tempat untuk mendapatkan informasi terkini secara online, termasuk laman web pemerintah, kanal media sosial, dan beberapa organisasi nirlaba. Sering kali, sumber-sumber ini memiliki API yang relatif mudah digunakan.
API (application programming interface) pada dasarnya adalah perangkat lunak yang memungkinkan komunikasi antara dua atau lebih aplikasi. Misalnya, Anda mungkin dapat mengintegrasikan API untuk Twitter ke dalam aplikasi Python Anda yang akan memungkinkan aplikasi Anda memublikasikan tweet atau “membaca” tweet atas nama Anda. Intinya, API adalah perantara.
Anda dapat menggunakan API di awal pipeline untuk mengumpulkan data dari berbagai sumber. Misalnya, Anda bisa menggunakan API untuk mengumpulkan data pengajuan perusahaan dari SEC atau untuk mengumpulkan data klinis dari tabel yang dikelola NIH.
Teknik lain yang digunakan untuk mengumpulkan data adalah web scraping. Ini adalah teknik yang menggunakan skrip kustom yang dirancang untuk mengumpulkan informasi dari sebuah halaman web di internet. Pustaka Python seperti BeautifulSoup dan Scrapy membuat proses ini cukup mudah, tetapi Anda tetap perlu bisa menavigasi html atau xml untuk menemukan informasi yang Anda perlukan.
Jika Anda ingin mempelajari lebih lanjut tentang web scraping, DataCamp memiliki materi tentang Beautiful Soup di Python, web scraping menggunakan R, dan web scraping untuk NLP.
Ada juga layanan web scraping tanpa kode yang tersedia. Berikut salah satu layanannya yang memungkinkan Anda mengumpulkan informasi dari sebuah laman web dan memantau perubahannya.
Proses pengumpulan data Anda mungkin melibatkan campuran data terstruktur (seperti spreadsheet atau basis data) dan data tidak terstruktur (seperti teks atau gambar).
Bergantung pada tujuan akhir pipeline Anda, Anda dapat mengekstrak informasi dari data tidak terstruktur untuk membuat kumpulan data terstruktur yang seragam, atau Anda dapat membiarkan sebagian tetap tidak terstruktur dan hanya memastikan pengacuan silang yang tepat tersedia bagi pengguna akhir.
Data terstruktur sering kali dapat diekstraksi menggunakan kueri SQL atau alat ETL, sementara data tidak terstruktur mungkin memerlukan teknik pemrosesan bahasa alami (NLP) atau alat khusus.
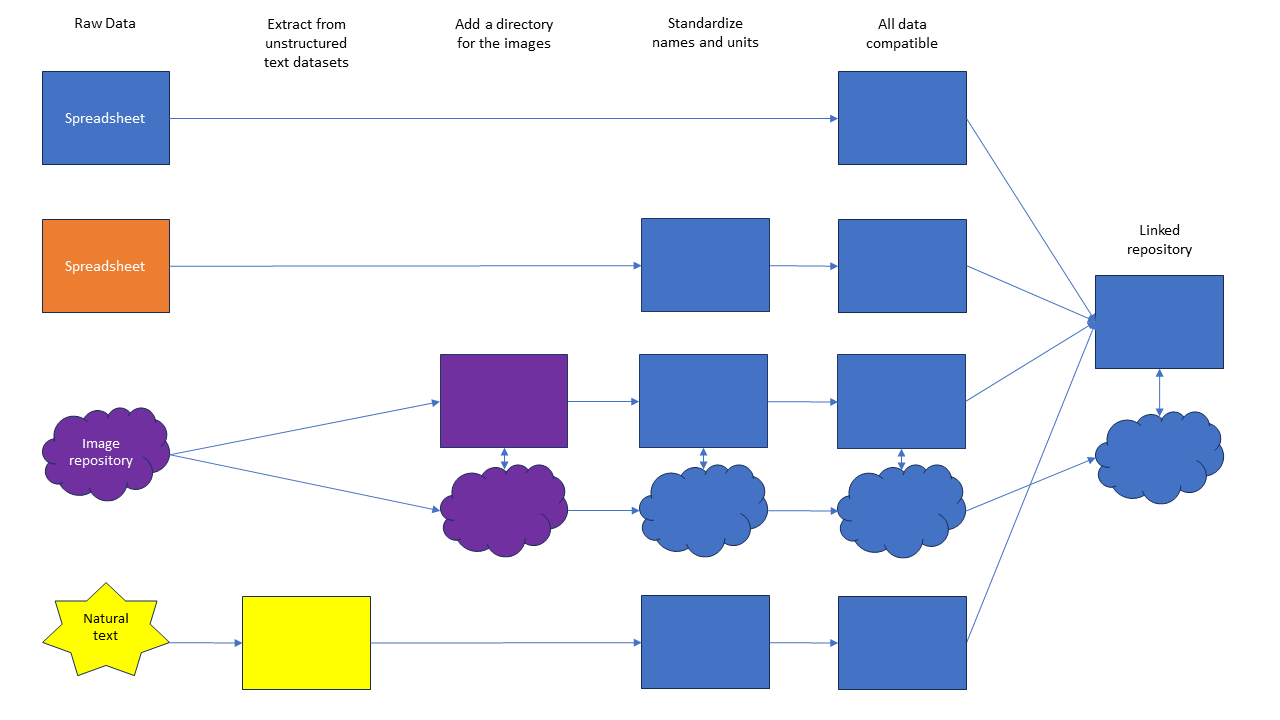
Gambar 4: Contoh data pipeline dengan data tidak terstruktur yang dibiarkan utuh di akhir. Dalam contoh ini, kita ingin membuat repositori data terstruktur terkurasi dan gambar terhubung. Ini juga bisa berupa data lake. Jadi, alih-alih mengekstrak data terstruktur dari gambar, kita membuat direktori yang menautkan gambar ke data relevan di basis data. Pengguna akhir kemudian dapat mengambil gambar mentah untuk setiap baris di spreadsheet, sesuai kebutuhan. Alternatifnya, kita bisa melakukan analisis gambar dan menyediakan gambar dengan bagian-bagian tertentu diisolasi atau dihapus. Untuk informasi cara melakukannya, lihat tutorial analisis gambar ini.
Setelah Anda memiliki sumber data dan tujuan akhir, Anda dapat mulai menyiapkan pipeline.
Hal pertama yang perlu Anda lakukan adalah merencanakan pipeline Anda. Saya menyarankan untuk memetakannya dulu di atas kertas. Di sisi paling kiri kertas, tulis sumber data Anda, dan di sisi paling kanan, tambahkan tujuan akhir Anda. Di antaranya, Anda dapat menguraikan semua langkah yang diperlukan untuk mencapai tujuan akhir dari sumber Anda.
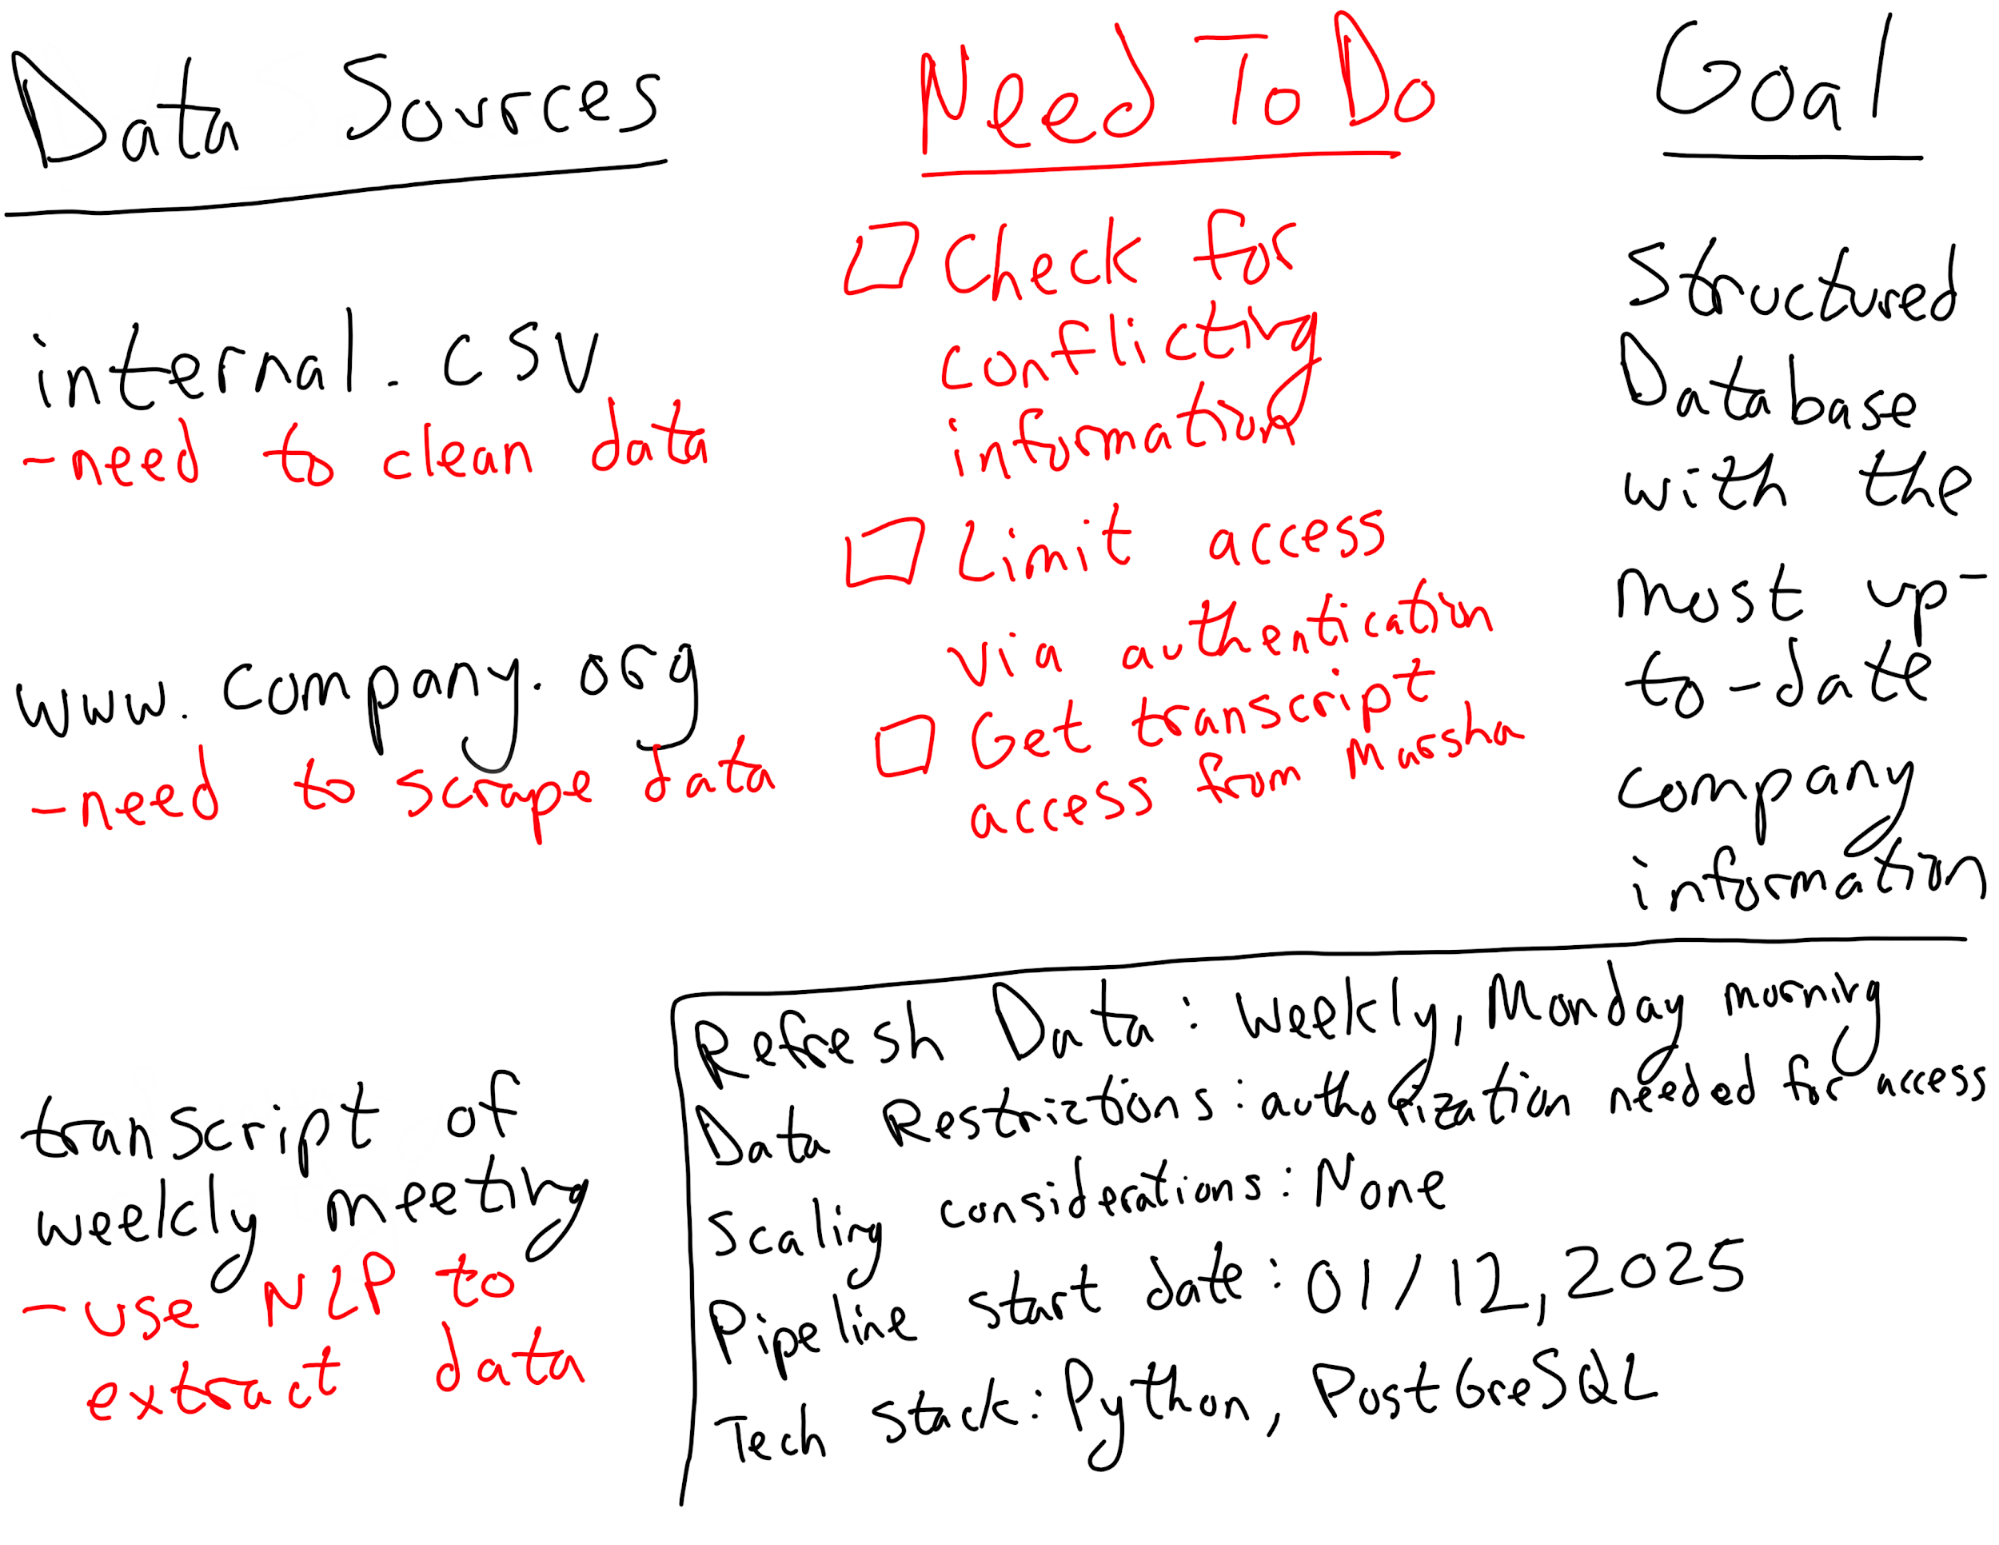
Gambar 5: Contoh rencana untuk sebuah pipeline.
Beberapa langkah potensial yang perlu Anda sertakan mungkin:
Setelah Anda memetakan rencana, Anda perlu mulai membangunnya. Ini bisa sepenuhnya dikodekan dalam bahasa pemrograman favorit Anda, atau dapat mencakup satu atau lebih layanan yang dirancang untuk mendukung pipeline. Penting untuk selalu mengingat pengguna akhir dan kebutuhan mereka sepanjang pembangunan pipeline.
Keputusan kunci yang perlu Anda buat adalah seberapa sering data ingin diperbarui. Jika informasi paling mutakhir diperlukan, Anda perlu menyiapkan pipeline yang dilengkapi untuk pemrosesan real-time. Namun, jika tingkat ketelitian ini tidak diperlukan, Anda dapat mempertimbangkan pemrosesan batch untuk menghemat sumber daya. Artinya data akan melalui langkah-langkah pipeline secara bertahap, misalnya seminggu sekali atau harian, alih-alih terus-menerus.
Hal lain yang perlu diingat saat membangun pipeline adalah bagaimana Anda akan memeliharanya ke depan. Anda perlu membuat cara untuk memantau fungsi pipeline dan dapat mendeteksi serta memperbaiki masalah tak terduga.
Salah ketik, entri yang tidak lengkap atau duplikat, dan jenis file yang berbeda hanyalah beberapa dari banyak tantangan yang mungkin dihadapi pipeline Anda jauh setelah penyiapan awalnya. Membuat sistem penanganan kesalahan dan pemantauan yang solid dapat menghemat banyak kerepotan.
Untuk tinjauan yang lebih mendalam tentang perancangan data pipeline, khususnya dalam konteks pembelajaran mesin, lihat kursus Designing Machine Learning Workflows in Python dari DataCamp.
Seperti halnya semua yang berkaitan dengan data, penting untuk membuat pipeline Anda hanya sekompleks yang diperlukan. Pipeline yang lebih sederhana lebih mudah dan lebih murah dipelihara, lebih mudah diperbarui, dan lebih mudah dipahami jika Anda perlu menyerahkan pipeline kepada engineer lain.
Di awal proses perancangan pipeline, penting untuk mengevaluasi kebutuhan proyek, termasuk setiap penskalaan yang diantisipasi di masa depan. Melakukannya akan membantu Anda memilih tingkat kompleksitas yang tepat.
Misalnya, jika Anda memerlukan pipeline sementara untuk mengumpulkan data dari tiga sensor berbeda selama beberapa bulan, Anda dapat mempertimbangkan pipeline satu langkah sederhana menggunakan sumber daya gratis yang banyak tersedia, seperti Google Drive.
Namun, jika Anda memiliki data sensitif atau perlu melakukan banyak transformasi, Anda mungkin perlu membuat kode Python atau C# kustom dengan enkripsi untuk pipeline tersebut.
Terakhir, Anda mungkin sedang menyiapkan pipeline yang saat ini kecil, tetapi Anda memperkirakan perluasan skala besar dalam beberapa tahun ke depan. Dalam kasus ini, Anda kemungkinan ingin membuat pipeline dengan infrastruktur yang cukup untuk menangani perluasan tersebut.
Menggoda untuk merancang pipeline yang lebih kecil terlebih dahulu dengan rencana membuat pipeline baru untuk skala yang lebih besar saat diperlukan. Itu bisa berhasil, tetapi berhati-hatilah!
Banyak data engineer ditugasi menambal pipeline yang tidak dirancang untuk skala saat ini karena membuat yang baru dianggap terlalu mahal atau memakan waktu.
Meskipun kesederhanaan adalah kunci, jika Anda membuat pipeline jangka panjang, bijaklah membangunnya dengan mempertimbangkan rencana perluasan yang diantisipasi.
Beberapa pertanyaan yang mungkin Anda pertimbangkan di awal proyek adalah:
Jebakan umum yang dialami engineer junior adalah mengikuti tren saat ini alih-alih menggunakan alat terbaik untuk pekerjaan tersebut.
Contoh seperti bagaimana banyak perusahaan mencoba memaksakan kecerdasan buatan generatif ke dalam tumpukan teknologi mereka tanpa use case yang baik.
Sebagai profesional data, penting bagi Anda untuk mengikuti teknologi dan tren baru. Namun, pastikan Anda memilih alat yang paling sesuai untuk proyek Anda, alih-alih mengikuti tren yang dapat menghasilkan pipeline yang buruk.
Setelah Anda memiliki rencana untuk pipeline, penting untuk mempertimbangkan metode optimisasi. Anda ingin mendapatkan data yang Anda perlukan, dengan resolusi dan laju penyegaran yang Anda inginkan, sambil meminimalkan sumber daya komputasi yang perlu dikonsumsi atau jeda waktu pergerakan data melalui pipeline.
Komponen kunci optimisasi pipeline adalah memantau dan mencatat aliran data melalui pipeline. Ini akan memberi Anda wawasan tentang di mana kemacetan mungkin memperlambat aliran data atau mengonsumsi lebih banyak sumber daya komputer.
Kemacetan umum dapat mencakup sumber data yang lambat, keterbatasan sumber daya, atau transformasi data yang tidak efisien.
Setelah Anda mengidentifikasi kemacetan, Anda dapat mempertimbangkan cara untuk mengoptimalkan kinerja:
Pertimbangan lain untuk optimisasi adalah laju penyegaran data. Jika data diperbarui melalui pipeline Anda setiap menit, tetapi Anda hanya memerlukan pembaruan setiap lima menit, maka mengurangi frekuensi penyegaran yang tidak perlu dapat membebaskan prosesor dan mengurangi konsumsi energi.
Jenis data tertentu yang mungkin mengalir melalui pipeline Anda dapat memiliki kekhawatiran keamanan atau privasi. Data medis, misalnya, sangat diatur oleh pemerintah AS dan memerlukan langkah-langkah keamanan yang jauh lebih besar dibandingkan data tentang kebiasaan menonton media. Contoh lain data yang memerlukan keamanan lebih adalah data keuangan dan kata sandi.
Jenis langkah keamanan yang Anda terapkan akan bergantung pada kekhawatiran keamanan untuk jenis data tersebut. Dalam beberapa kasus, anonimisasi mungkin sudah cukup, di mana informasi pribadi dipisahkan atau dihapus dari dataset. Ini dapat digunakan dalam penelitian medis ketika informasi identitas pribadi tidak diperlukan, tetapi informasi lain dalam rekam medis tetap diperlukan.
Langkah keamanan lain yang mungkin perlu Anda terapkan termasuk enkripsi dan pengendalian akses ke data melalui otorisasi login. Metode ini dapat digunakan untuk data keuangan atau rahasia perusahaan.
Untuk semua data sensitif, penting bagi Anda untuk memahami dan mematuhi peraturan pemerintah, seperti GDPR (General Data Protection Regulation) atau HIPAA (Health Insurance Portability and Accountability Act).
Bergantung pada industri Anda dan jenis data yang Anda tangani, Anda mungkin perlu mematuhi peraturan tambahan, seperti CCPA (California Consumer Privacy Act) atau FERPA (Family Educational Rights and Privacy Act).
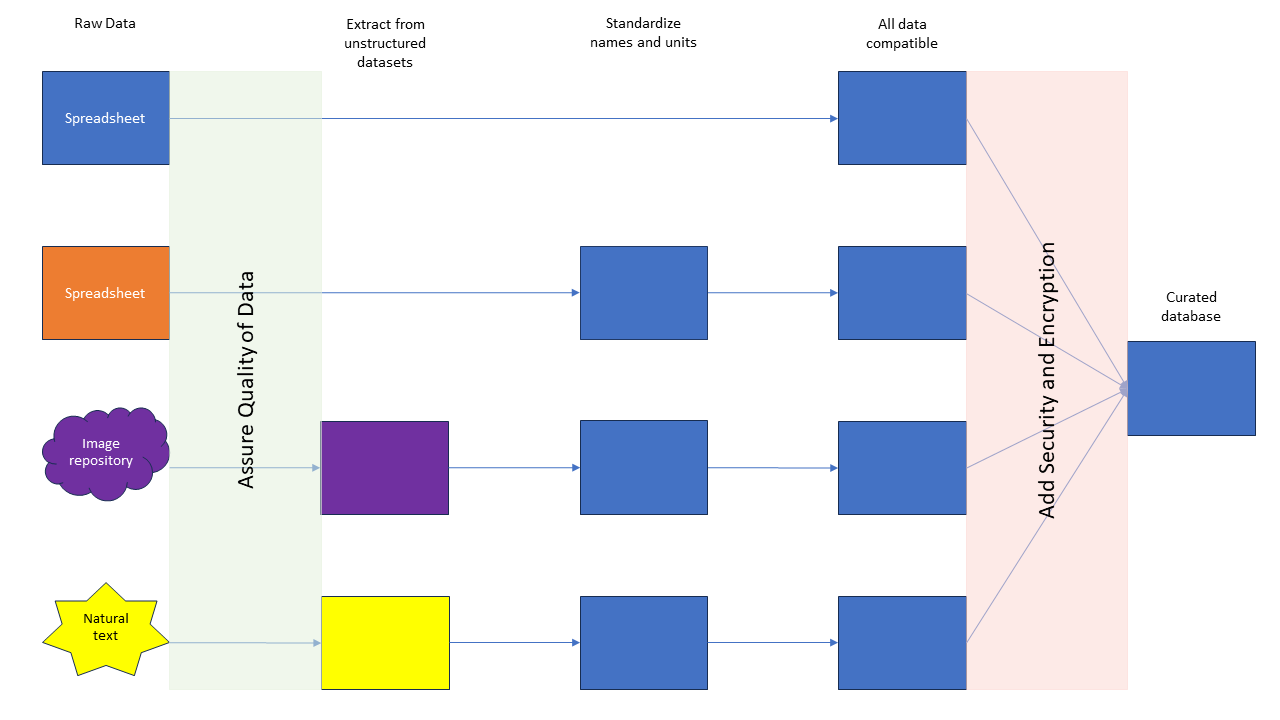
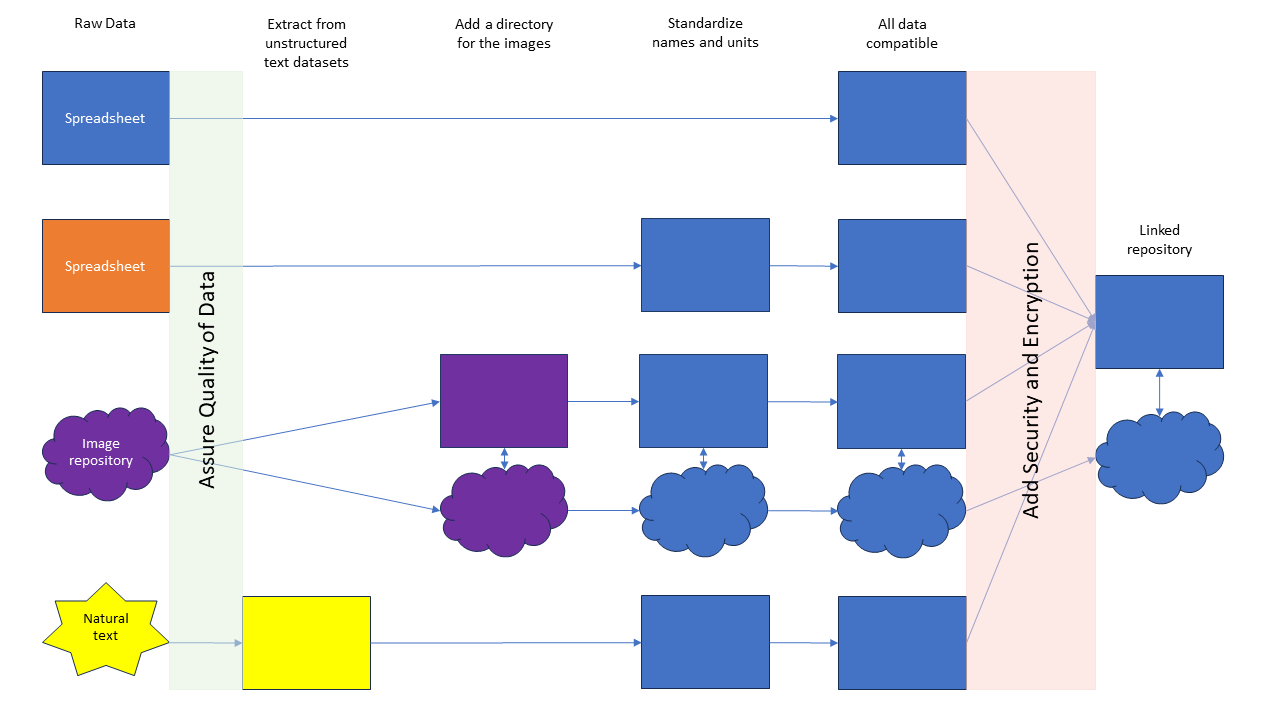
Gambar 6: Contoh penambahan langkah penjaminan mutu dan keamanan ke dalam pipeline.
Data pipeline dan para engineer yang membangunnya adalah pahlawan tanpa tanda jasa di dunia data. Mereka memungkinkan data mengalir mulus dari satu tempat ke tempat lain, sambil mengaturnya. Menurut Statista, dunia menghasilkan, mengonsumsi, dan menyimpan 64,2 zettabyte data hanya pada tahun 2020, dan angka ini meningkat setiap tahun.
Membangun dan memelihara data pipeline yang tangguh semakin krusial dalam lanskap data ini. Jika tutorial ini menumbuhkan ketertarikan Anda pada data pipeline, lihat kursus pengantar ini untuk tinjauan yang lebih mendalam. Jika Anda tertarik mempelajari cara membangun data pipeline, lihat kursus Python Data Engineering ini untuk memulai. Dan jika Anda ingin memulai karier dan membuktikan kredensial kepada pemberi kerja, lihat Sertifikasi Data Engineer kami.
Mulai Belajar Menggunakan Data Pipeline Hari Ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



