Curso
ETL y ELT en Python
4 h
39.5K
Los datos son esenciales para empresas y organizaciones, y organizar el flujo de toda esa información es precisamente donde brillan los data pipelines. Entonces, ¿qué son los data pipelines y qué necesitas saber para crear el tuyo?
Los datos son el motor de las organizaciones modernas: impulsan la toma de decisiones, los insights y la innovación. Sin embargo, gestionarlos y sacarles partido puede ser complejo y abrumador. Aquí es donde entran en juego los data pipelines. Pero, ¿qué son exactamente?
Un data pipeline es un sistema que recupera datos de múltiples fuentes y los canaliza hacia un nuevo destino, como una base de datos, un repositorio o una aplicación, realizando por el camino las transformaciones necesarias (convertir los datos de un formato o estructura a otra). Los usuarios finales de este pipeline pueden ser analistas, científicos de datos o responsables de negocio.
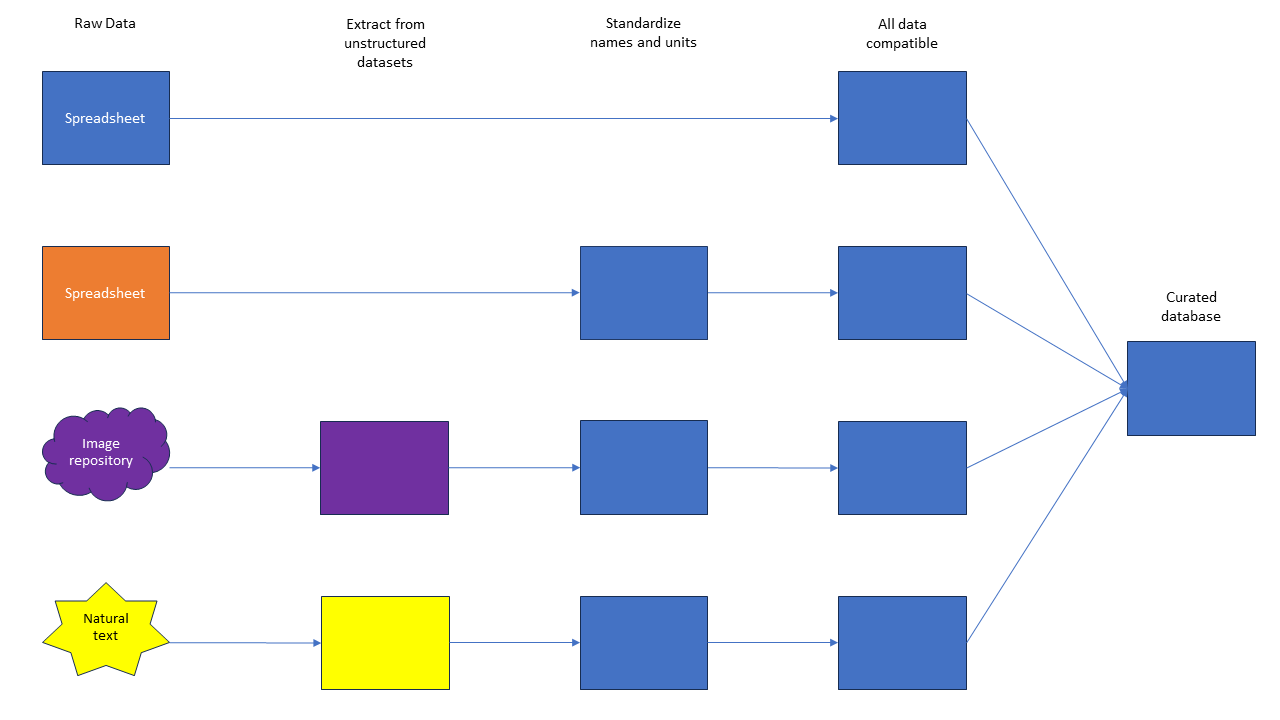
Figura 1: Ejemplo de un data pipeline sencillo. En este caso, hay cuatro fuentes de datos: dos estructuradas y dos no estructuradas. A través de varios pasos, extraes datos estructurados de los conjuntos no estructurados, estandarizas nombres y unidades y, cuando todo es compatible, creas una base de datos curada con toda la información necesaria. Esta base de datos podrá utilizarla un analista, un científico o un responsable de negocio.
Aunque suena sencillo, implica muchas decisiones y posibles dolores de cabeza. En muchas organizaciones, construir y mantener pipelines es un trabajo a tiempo completo de los data engineers. En otras, es solo una de las muchas tareas que asume un data scientist. Quién lo mantiene depende a menudo del tamaño de la organización, la complejidad de los pipelines y la financiación disponible.
Diseñar un pipeline fiable, seguro y puntual es clave para la toma de decisiones basada en datos. Tanto si te interesa la ingeniería de datos como cualquier otra parte del ciclo de datos, te conviene entender cómo funcionan los data pipelines.
Quizá te preguntes por qué necesitarías construir un pipeline. Si has trabajado con conjuntos de datos ya preparados o con datos de una única fuente, como los de ejercicios de Kaggle o DataCamp, probablemente no te haya hecho falta. Esos datasets curados ya están listos para que los analistas los utilicen directamente.
Sin embargo, si quieres combinar información de muchas fuentes, puede que necesites montar un pipeline para garantizar que todos los datos estén accesibles para tu análisis.
Algunas razones por las que te puede interesar usar data pipelines:
Imagina que quieres saber si la nota media (GPA) del alumnado en un distrito escolar se correlaciona con la renta media del condado o con el tamaño de la población. Para este análisis, quizá necesites obtener el GPA de cada distrito escolar, datos de ingresos del IRS y población de la Oficina del Censo.
Podrías recopilar esta información manualmente una vez. Pero si tuvieras que repetir el análisis con regularidad, construir un pipeline fiable te ayudaría a automatizar la recogida y te ahorraría tiempo y quebraderos de cabeza.
Además de centralizar la recogida, los pipelines te ayudan a resolver incoherencias entre fuentes. Por ejemplo, el Censo puede identificar condados por su nombre completo, mientras que el IRS usa abreviaturas.
Dentro del pipeline, puedes estandarizar cómo se identifican los condados en el repositorio final. O quizá la población esté registrada con unidades distintas y necesites unificar el sistema de unidades en el destino. A estos cambios los llamamos transformaciones.
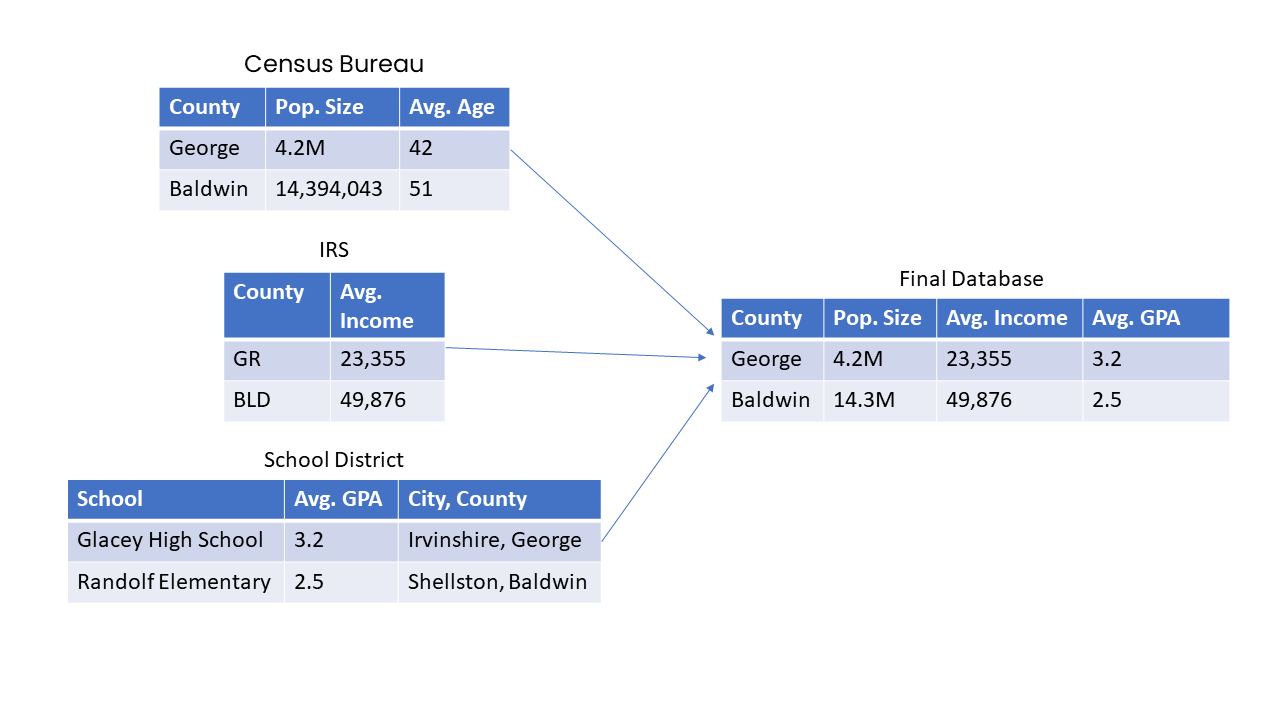
Figura 2: Al combinar información de distintas fuentes, pueden ser necesarias transformaciones como cambios de unidades y nombres estandarizados.
Los data pipelines suelen desarrollarlos y mantenerlos data engineers.
Una vez recopilados, limpiados y organizados los datos al final del pipeline, distintos perfiles pueden utilizarlos: data analysts, data scientists o business analysts.
Los datos pueden alimentar analítica en tiempo real, un panel que se actualiza o un modelo de machine learning. A veces, el final del pipeline es una aplicación o dashboard que usa un responsable de negocio o una persona usuaria.
Prácticamente todos los sectores que manejan grandes volúmenes de datos utilizan pipelines. En organizaciones grandes, como las tecnológicas, los pipelines son complejos, muy regulados y los gestiona un equipo especializado.
En organizaciones pequeñas, por ejemplo una persona investigadora que recoge datos de varios sensores en el mundo, el pipeline puede ser muy simple y con pocos pasos. Otros ejemplos: un bróker que recopila datos financieros para decidir qué acciones comprar o un sistema hospitalario que unifica historiales de sus centros afiliados.
Los pipelines también son cruciales para los modelos de machine learning. Estos modelos consumen enormes cantidades de datos, y contar con un pipeline adecuado es imprescindible para que funcionen bien. Este tutorial de MLOps explica con más detalle cómo se usan en machine learning.
Los datos pueden almacenarse de varias formas, según su tipo y el uso previsto. Tres términos habituales son data lakes, bases de datos y data warehouses. Veamos brevemente cada uno.
Un data lake es un repositorio grande y flexible que puede almacenar datos estructurados y no estructurados a escala. Permite guardar datos en bruto, sin procesar, de múltiples fuentes (logs web, sensores, redes sociales, etc.) en su formato nativo.
Su versatilidad permite a científicos y analistas de datos explorar, transformar y analizar la información de muchas maneras. Es especialmente útil en big data y analítica avanzada cuando el esquema no está predefinido, dando libertad para extraer insights de fuentes diversas.
Las bases de datos son sistemas de propósito general para almacenar, gestionar y recuperar eficientemente datos estructurados. Aunque comparten similitudes con los data warehouses, suelen usarse para datos transaccionales, operaciones del día a día y aplicaciones en tiempo real. Hay muchos tipos (relacionales, NoSQL, en memoria), cada uno para necesidades concretas. Garantizan la integridad, el acceso concurrente y distintos mecanismos de consulta.
Los data warehouses son repositorios muy estructurados y optimizados para almacenar, organizar y consultar datos estructurados con fines analíticos. Siguen un esquema predefinido, imponen calidad y consistencia y están optimizados para consultas y reporting complejos.
Son ideales para empresas que quieren decidir con datos históricos, ya que ofrecen una única fuente de verdad para informes y analítica estandarizada. Normalmente, los datos se extraen de varias fuentes, se transforman a un formato consistente y se cargan en el data warehouse para su análisis.
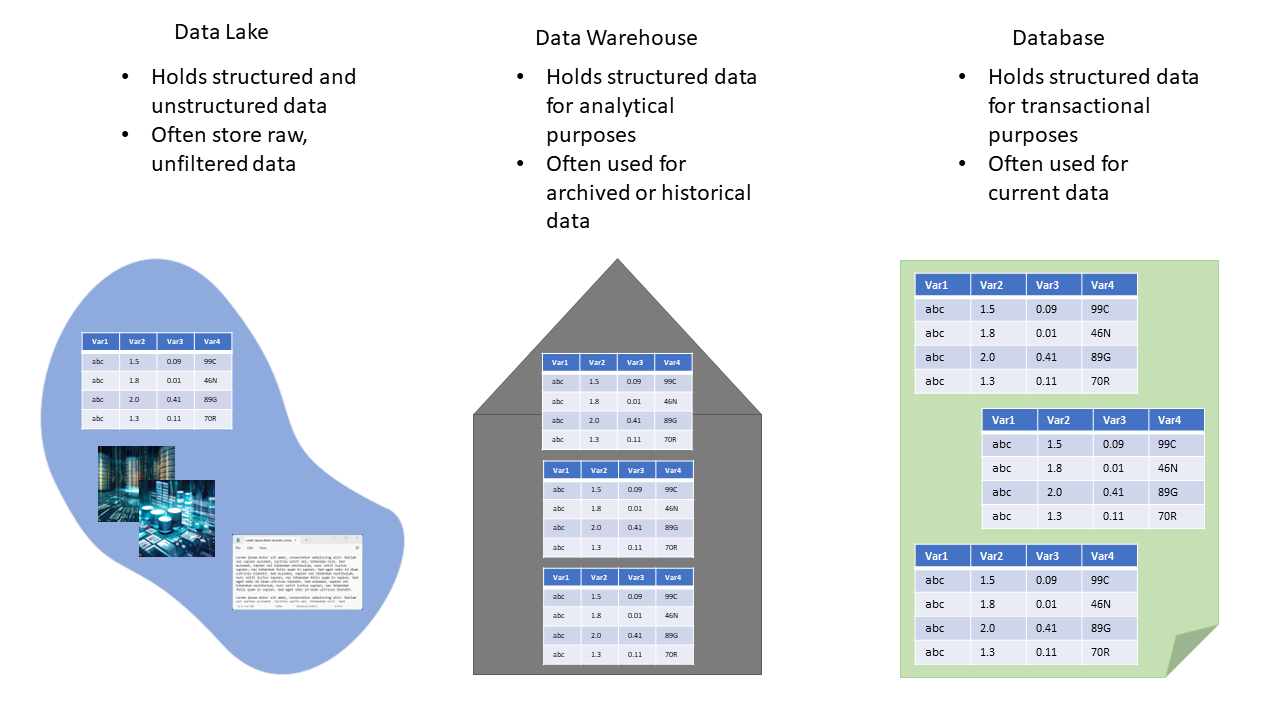
Figura 3: Diferencias entre un data lake, un data warehouse y una base de datos. Un data lake puede ser un paso previo en un pipeline que termine en un warehouse o en una base de datos.
Los pipelines suelen seguir uno de dos esquemas principales: ETL (Extract, Transform, Load) o ELT (Extract, Load, Transform).
ETL sigue un enfoque secuencial. Primero, se extraen datos de distintos orígenes: bases de datos, ficheros, APIs u otros repositorios.
Después, se transforman para ajustarlos al esquema deseado, la calidad y las reglas de negocio. Esta fase puede incluir limpiar, agregar y estructurar. Por último, los datos transformados se cargan en el data warehouse o sistema de almacenamiento objetivo, a menudo en un formato optimizado para reporting y analítica.
ETL es útil cuando los datos requieren una reestructuración o limpieza significativa antes de almacenarlos, garantizando que lleguen listos para el análisis. Este curso de ETL con Python ofrece una visión detallada usando Python y SQL.
ELT invierte el orden de la transformación. Primero se extraen los datos y se cargan tal cual en un data warehouse, o a veces en un data lake, sin transformaciones importantes. Las transformaciones y el procesamiento suceden dentro del propio warehouse.
Este enfoque aprovecha la potencia y flexibilidad de los data warehouses modernos y de las plataformas de big data, y es adecuado cuando quieres almacenar grandes volúmenes de datos en bruto y transformar bajo demanda.
ELT suele preferirse cuando tu solución de data warehousing gestiona bien transformaciones complejas, como los warehouses en la nube o frameworks distribuidos como Hadoop.
Hay muchas herramientas para desarrollar pipelines. Elegir bien depende del tamaño, las necesidades de escalado, el presupuesto y los objetivos. Puedes crear un pipeline completo con Python y SQL (o con R y SQL) o usar distintas herramientas comerciales.
Aquí tienes una lista breve de tecnologías y herramientas comerciales comunes.
Puedes consultar nuestra lista de las mejores herramientas ETL y cuándo usarlas en otro artículo.
El primer paso para crear un data pipeline es recopilar los datos que vas a introducir. Hay muchas fuentes actualizadas en internet, como páginas gubernamentales, redes sociales y algunas organizaciones sin ánimo de lucro. A menudo ofrecen una API fácil de usar.
Una API (application programming interface) es básicamente software que permite la comunicación entre dos o más aplicaciones. Por ejemplo, puedes integrar una API de Twitter en tu aplicación de Python para publicar o "leer" tweets en tu nombre. Es un intermediario.
Puedes usar una API al inicio del pipeline para recopilar datos de distintas fuentes. Por ejemplo, para obtener informes corporativos de la SEC o datos clínicos de tablas del NIH.
Otra técnica es el web scraping: scripts a medida que extraen información de páginas web. Librerías de Python como BeautifulSoup y Scrapy lo facilitan, pero necesitarás navegar por HTML o XML para encontrar lo que buscas.
Si quieres aprender más, en DataCamp tienes materiales sobre Beautiful Soup en Python, web scraping con R y web scraping para NLP.
También existen servicios sin código para scraping. Aquí tienes uno de ellos que permite recopilar información de una página y monitorizar cambios.
Tu proceso puede incluir una mezcla de datos estructurados (hojas de cálculo, bases de datos) y no estructurados (texto, imágenes).
Según el objetivo del pipeline, puedes extraer información de los no estructurados para crear un dataset uniforme, o dejar parte sin estructurar y asegurar un buen cruzado para el usuario final.
Los datos estructurados suelen extraerse con consultas SQL o herramientas ETL, mientras que los no estructurados pueden requerir técnicas de NLP o herramientas especializadas.
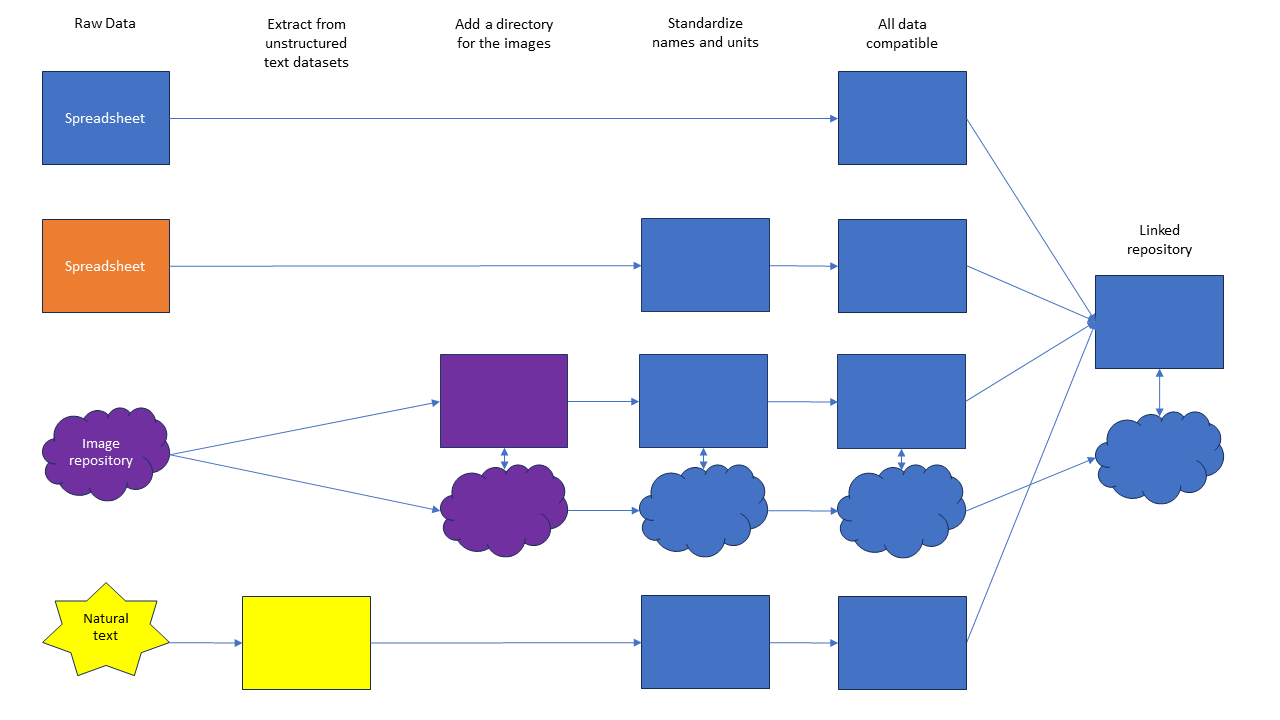
Figura 4: Ejemplo de data pipeline con datos no estructurados conservados al final. En este caso, queremos crear un repositorio de datos estructurados curados e imágenes vinculadas. Podría ser también un data lake. En lugar de extraer datos estructurados de las imágenes, creamos un directorio que vincula las imágenes con los datos relevantes en la base de datos. La persona usuaria puede recuperar la imagen en bruto para cada fila de la hoja de cálculo cuando la necesite. Alternativamente, podríamos haber analizado las imágenes y proporcionado una imagen con secciones aisladas o eliminadas. Para saber cómo hacerlo, consulta este tutorial de análisis de imágenes.
Cuando ya tienes las fuentes y un objetivo claro, puedes empezar a montar tu pipeline.
Lo primero es planificarlo. Te recomiendo dibujarlo en papel. A la izquierda, anota tus fuentes; a la derecha, tu objetivo final. En medio, detalla todos los pasos necesarios para ir de las fuentes al objetivo.
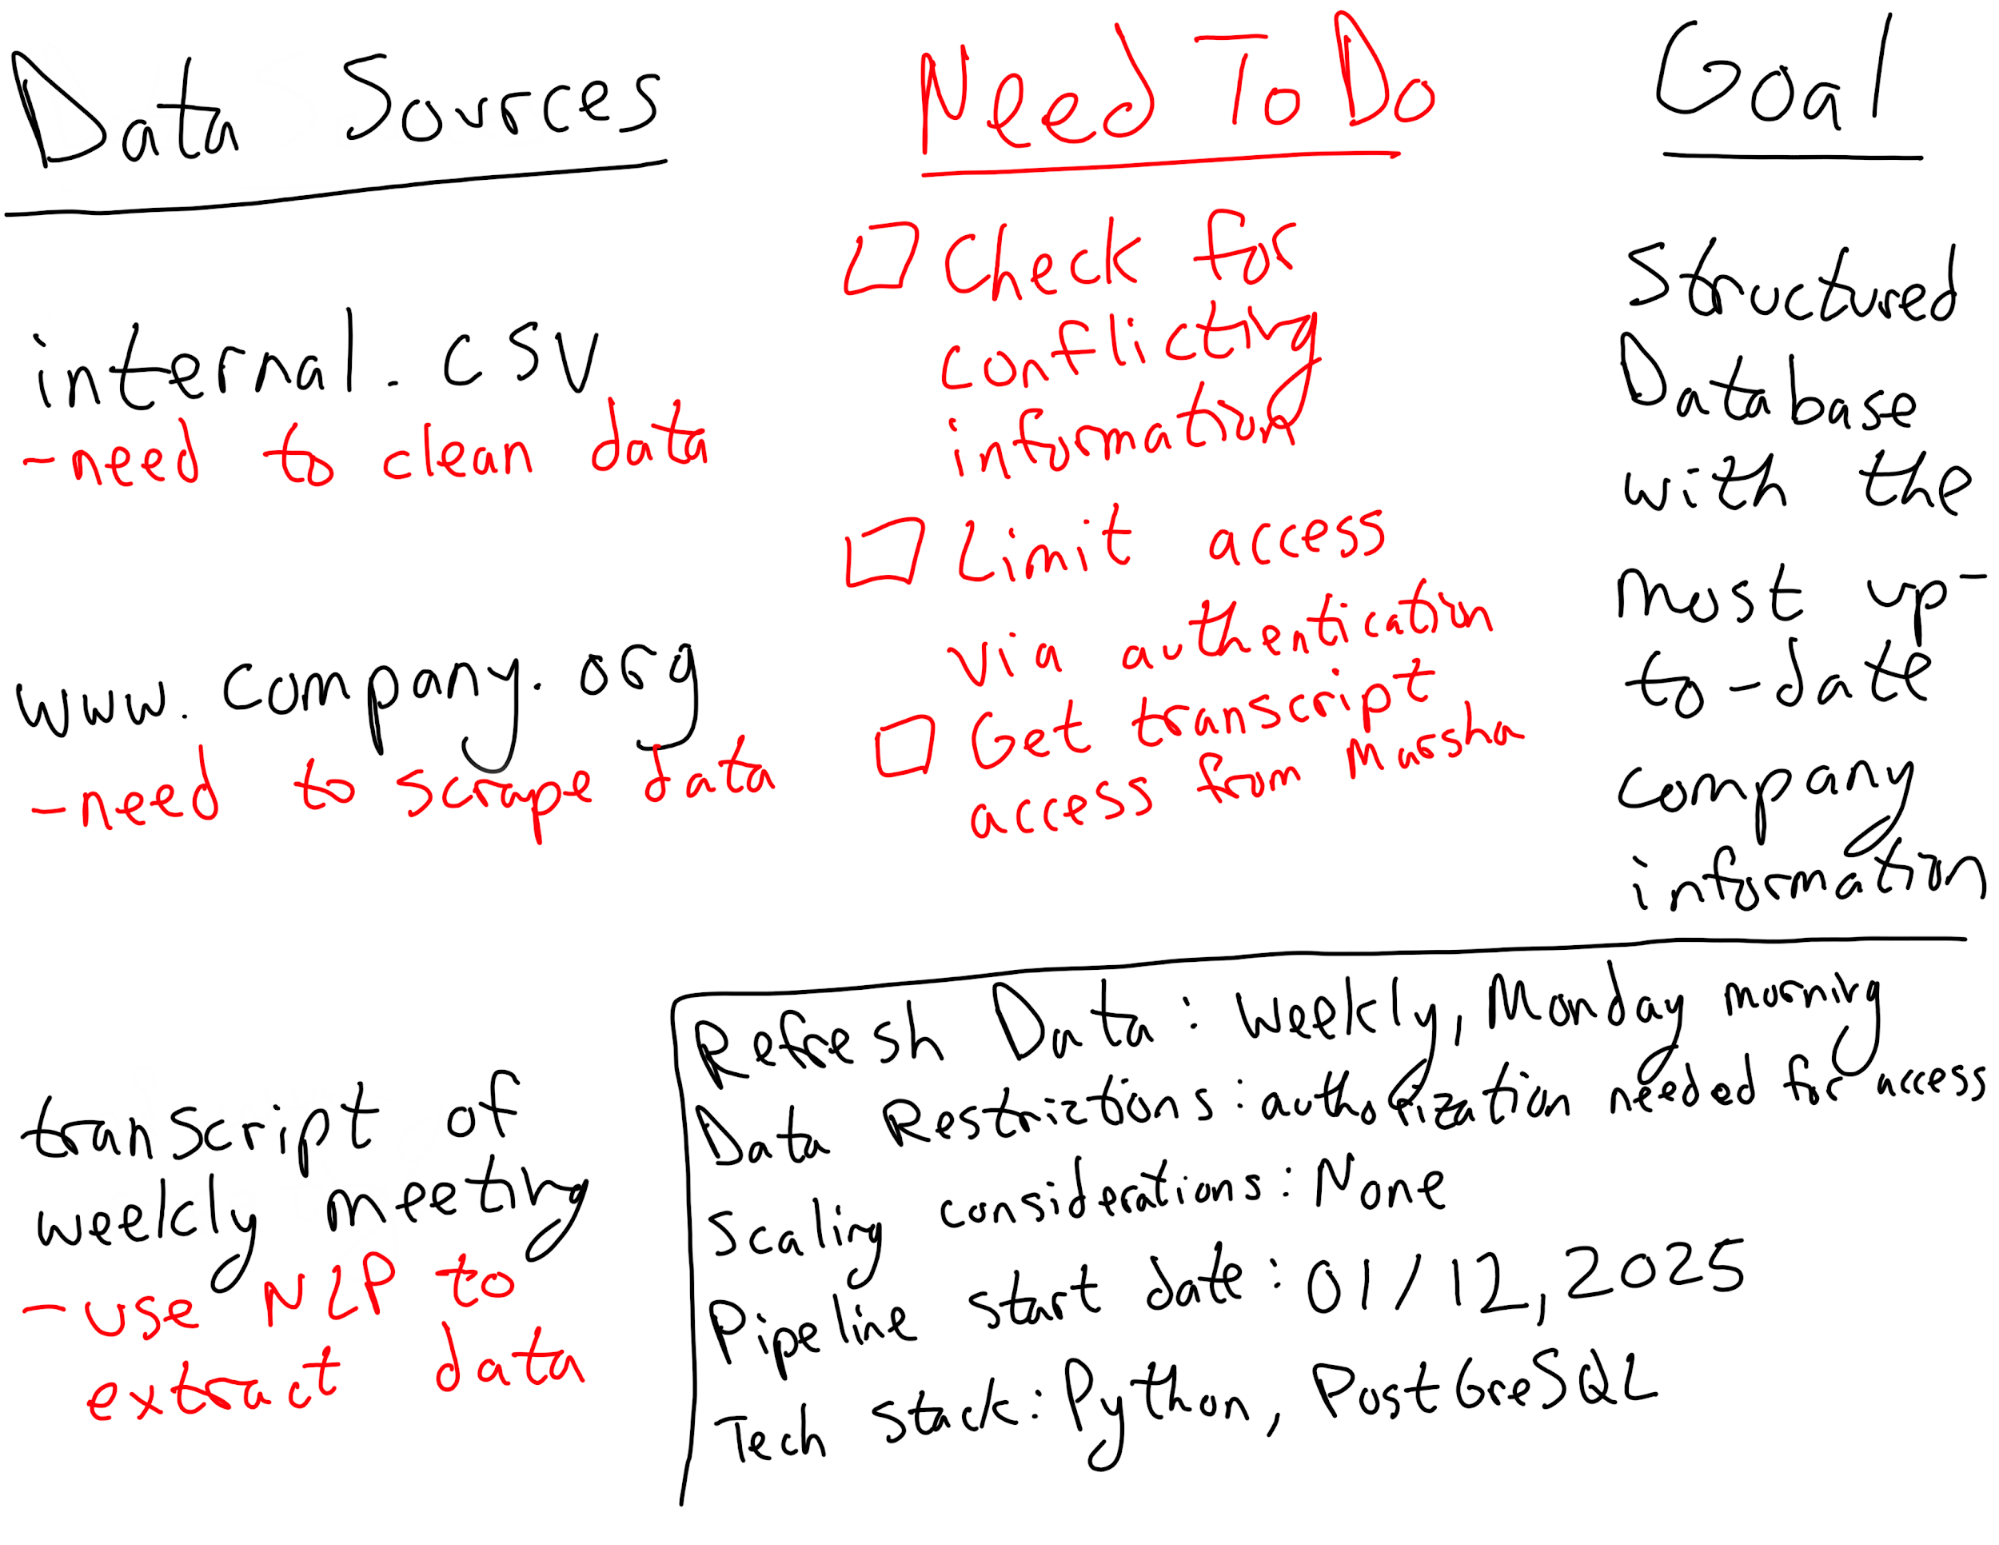
Figura 5: Plan de ejemplo para un pipeline.
Algunos pasos que quizá necesites incluir:
Con el plan definido, toca construir. Puedes programarlo todo en tu lenguaje favorito o incorporar uno o varios servicios pensados para pipelines. Mantén siempre en mente al usuario final y sus necesidades durante la construcción.
Una decisión clave es la frecuencia de actualización. Si necesitas información al minuto, tendrás que preparar un pipeline para procesamiento en tiempo real. Si no hace falta tanta inmediatez, considera el procesamiento por lotes para ahorrar recursos: los datos pasarán por los pasos en tandas, por ejemplo diaria o semanal, en lugar de continuamente.
También debes pensar desde el principio cómo lo vas a mantener. Necesitarás monitorizar su funcionamiento y detectar y corregir problemas inesperados.
Erratas, entradas incompletas o duplicadas y tipos de archivo distintos son solo algunos de los retos que pueden surgir mucho después del despliegue inicial. Un buen sistema de monitorización y gestión de errores te ahorrará muchos problemas.
Para un vistazo más detallado al diseño de data pipelines, especialmente en machine learning, echa un ojo al curso de DataCamp Designing Machine Learning Workflows in Python.
Como en todo proyecto de datos, haz tu pipeline tan complejo como sea necesario, y no más. Los pipelines simples son más baratos y fáciles de mantener, actualizar y traspasar a otra persona ingeniera.
Al inicio del diseño, evalúa los requisitos del proyecto, incluido el posible escalado futuro. Esto te ayudará a elegir el nivel de complejidad adecuado.
Por ejemplo, si necesitas un pipeline temporal para recopilar datos de tres sensores durante unos meses, quizá baste con un pipeline de un solo paso usando un recurso gratuito y común como Google Drive.
Si, en cambio, manejas datos sensibles o múltiples transformaciones, puede que necesites código a medida en Python o C# con cifrado.
Por último, quizá ahora montes un pipeline pequeño pero prevés una gran expansión en pocos años. En ese caso, crea una infraestructura preparada para crecer.
Puede ser tentador diseñar un pipeline pequeño con la idea de rehacerlo a mayor escala cuando toque. Puede funcionar, pero cuidado.
Muchos data engineers acaban parcheando un pipeline no diseñado para la escala actual porque crear uno nuevo se considera demasiado caro o lento.
Aunque la sencillez es clave, si tu pipeline es a largo plazo, conviene construirlo pensando en la expansión prevista.
Preguntas útiles al inicio:
Un error común en perfiles junior es dejarse llevar por tendencias en lugar de elegir la herramienta adecuada.
Un ejemplo reciente es intentar encajar IA generativa en el stack sin un buen caso de uso.
Como profesional de datos, mantente al día de tecnologías y tendencias, sí, pero elige lo que mejor encaje en tu proyecto para no acabar con un pipeline pobre.
Con el plan definido, toca pensar en cómo optimizar. Quieres obtener los datos con la resolución y frecuencia que necesitas, minimizando recursos computacionales y la latencia a lo largo del pipeline.
Un componente clave es monitorizar y registrar el flujo de datos. Te dará visibilidad de cuellos de botella que ralenticen el flujo o consuman demasiados recursos.
Los más comunes incluyen fuentes lentas, restricciones de recursos o transformaciones ineficientes.
Una vez identificados, puedes optimizar con:
Otra palanca de optimización es la tasa de refresco. Si actualizas cada minuto pero solo necesitas datos cada cinco, reducir la frecuencia liberará procesadores y bajará el consumo energético.
Algunos datos que fluyen por tus pipelines pueden implicar seguridad o privacidad. Los datos médicos, por ejemplo, están muy regulados en EE. UU. y requieren medidas de seguridad mucho mayores que datos sobre hábitos de consumo de medios. Otros ejemplos: datos financieros y contraseñas.
Las medidas de seguridad dependen del tipo de dato. En algunos casos, basta con anonimizar, desligando o eliminando la información personal. Esto puede usarse en investigación médica cuando no se necesita identificar a las personas.
Otras medidas incluyen cifrado y control de acceso mediante autenticación. Pueden aplicarse a datos financieros o secretos de empresa.
Con cualquier dato sensible, es esencial conocer y cumplir la normativa, como el RGPD (Reglamento General de Protección de Datos) o HIPAA (Health Insurance Portability and Accountability Act).
Según tu sector y los datos que manejes, puede que también debas cumplir con CCPA (California Consumer Privacy Act) o FERPA (Family Educational Rights and Privacy Act).
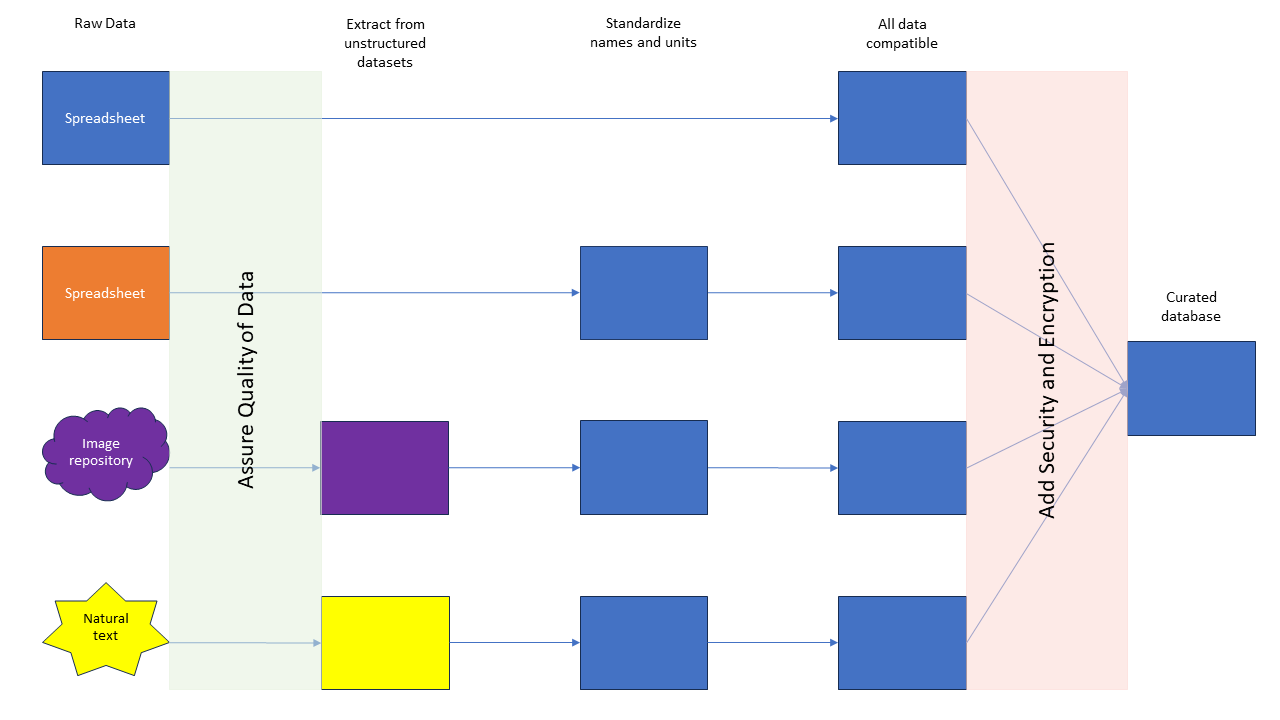
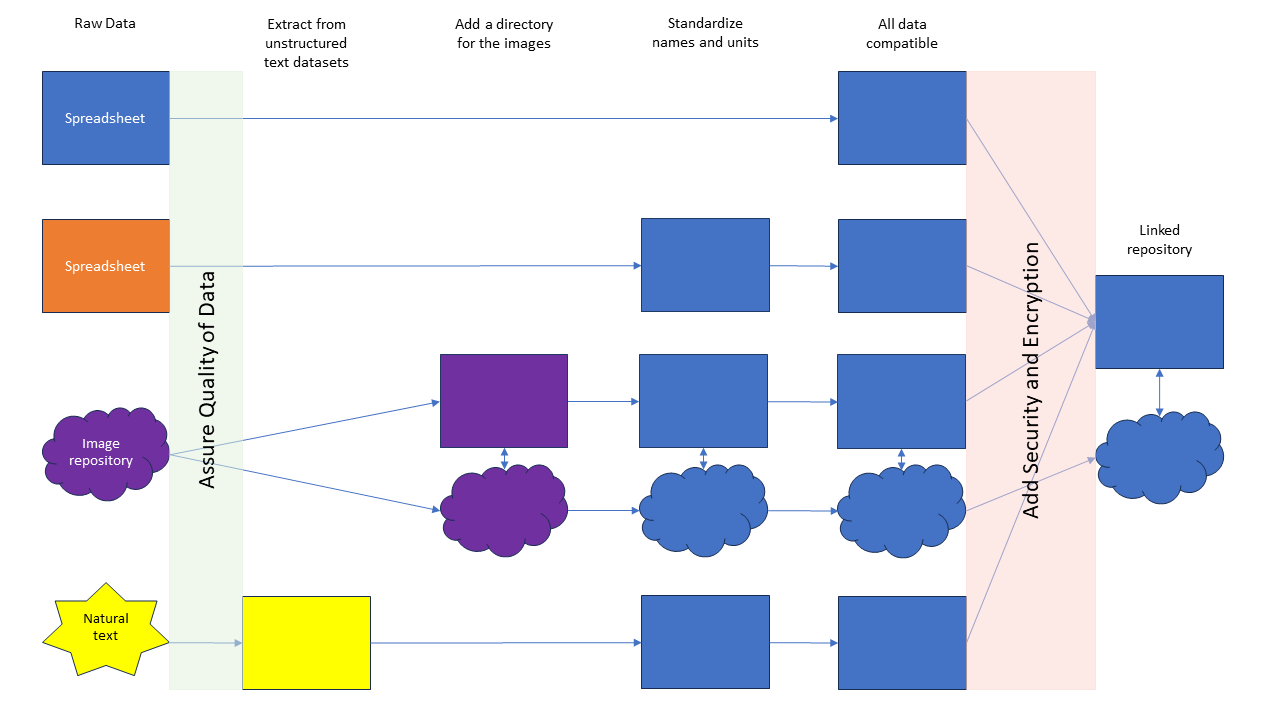
Figura 6: Ejemplo de cómo añadir pasos de aseguramiento de la calidad y seguridad a un pipeline.
Los data pipelines, y quienes los construyen, son los héroes anónimos del mundo de los datos. Permiten que la información fluya sin fricciones, bien organizada y lista para usarse. Según Statista, solo en 2020 el mundo generó, consumió y almacenó 64,2 zettabytes de datos, y la cifra crece cada año.
Construir y mantener data pipelines robustos es cada vez más crítico. Si este tutorial te ha despertado el interés, echa un vistazo a este curso introductorio para profundizar. Si quieres aprender a construirlos, empieza con este curso de Python Data Engineering. Y si quieres iniciar tu carrera y demostrar tus credenciales a las empresas, consulta nuestra Data Engineer Certification.
Nuestros programas de certificación te ayudan a destacar y a demostrar que tus aptitudes están preparadas para el trabajo a posibles empleadores.

¡Empieza hoy a aprender a usar data pipelines!
Curso
Curso
blog
Javier Canales Luna
15 min
blog
Abid Ali Awan
13 min
blog
Matt Crabtree
10 min
Tutorial
DataCamp Team
13 min
Tutorial
Karlijn Willems
15 min
Tutorial
Joleen Bothma
11 min