
Cours
ETL et ELT en Python
4 h
39.5K
Les données sont essentielles aux entreprises et organisations, et l’organisation de leurs flux est précisément le domaine des pipelines de données. Alors, qu’est-ce qu’un pipeline de données et que faut-il savoir pour en construire un vous-même ?
Les données sont le moteur des organisations modernes : elles alimentent la prise de décision, les insights et l’innovation. Mais exploiter cette richesse est souvent complexe. C’est là qu’interviennent les pipelines de données. Que recouvrent-ils ?
Un pipeline de données est un système qui récupère des données depuis différentes sources pour les acheminer vers une nouvelle destination (base de données, référentiel, application), en appliquant au passage les transformations nécessaires (conversion de format ou de structure). Les utilisateurs finaux peuvent être des analystes, des data scientists ou des décideurs.
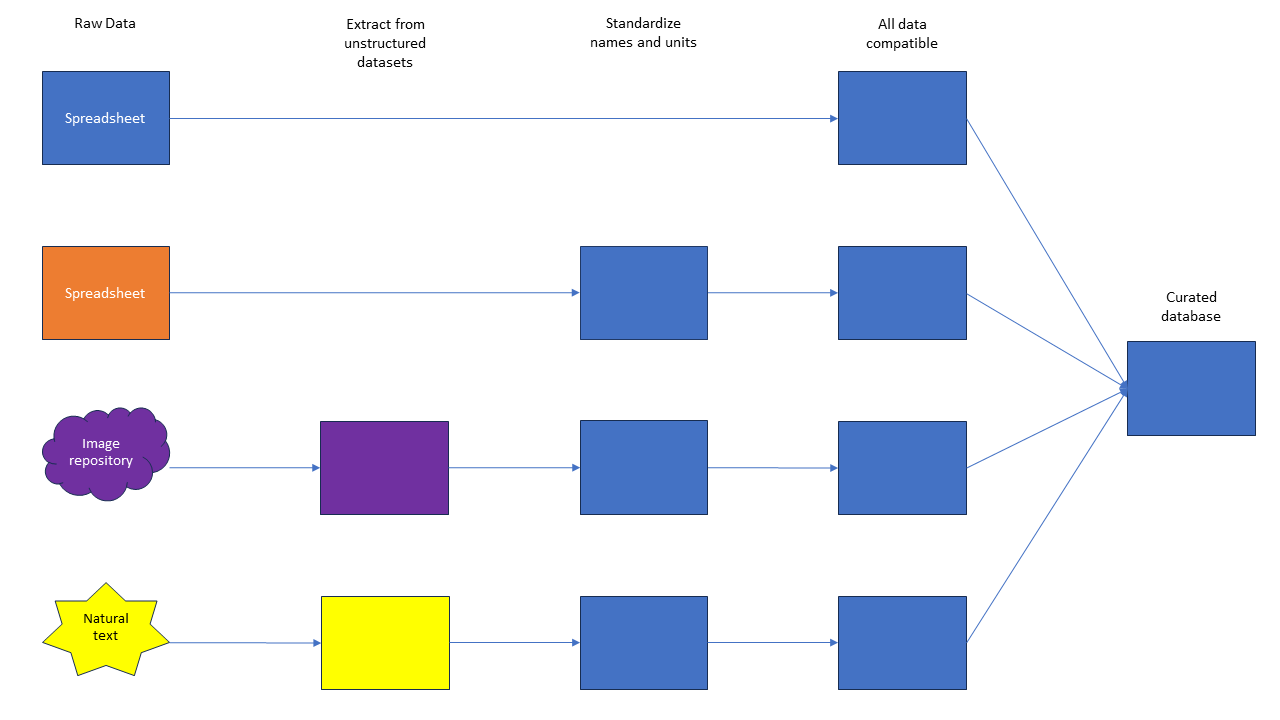
Figure 1 : exemple d’un pipeline de données simple. Ici, vous avez quatre sources : deux structurées et deux non structurées. Via une série d’étapes, vous extrayez des données structurées à partir des jeux non structurés, vous standardisez les libellés et les unités et, une fois la compatibilité assurée, vous créez une base de données unique et soignée contenant toutes les informations nécessaires. Cette base peut ensuite être utilisée par des analystes, des scientifiques ou des dirigeants.
En apparence simple, cette tâche implique pourtant de nombreux choix et écueils. Dans beaucoup d’organisations, la construction et la maintenance des pipelines constituent un métier à part entière, assuré par des data engineers. Ailleurs, ce n’est qu’une des nombreuses missions d’un data scientist. Le ou les responsables dépendent souvent de la taille de la structure, de la complexité des pipelines et des moyens disponibles.
Concevoir un pipeline fiable, sécurisé et ponctuel est essentiel à une prise de décision basée sur les données. Que vous visiez l’ingénierie des données ou tout autre maillon de la chaîne, comprendre les pipelines de données est un atout majeur.
Vous vous demandez peut-être pourquoi construire un pipeline. Si vous avez surtout travaillé avec des jeux de données prêts à l’emploi ou issus d’une seule source, comme sur Kaggle ou dans des exercices DataCamp, vous n’en aviez probablement pas besoin : ces jeux de données sont déjà préparés pour être utilisés directement par des analystes.
Mais si vous souhaitez croiser des informations issues de multiples sources, il peut être nécessaire de mettre en place un pipeline pour rendre toutes les données accessibles à votre analyse.
Voici quelques raisons majeures d’adopter des pipelines de données :
Par exemple, vous voulez savoir si la moyenne générale (GPA) des élèves d’un district scolaire est corrélée au revenu moyen du comté ou à la taille de la population. Pour cela, vous pourriez extraire les GPA par district, les revenus moyens via l’IRS et la population via le Census Bureau.
Vous pourriez le faire manuellement une fois. Mais si l’analyse doit être répétée régulièrement, construire un pipeline fiable vous permettra d’automatiser la collecte et de gagner du temps.
Au-delà de la simple centralisation, les pipelines aident à gérer les incohérences entre sources. Par exemple, le Census Bureau peut identifier les comtés par leur nom complet tandis que l’IRS utilise des abréviations.
Dans le pipeline, vous pouvez normaliser la manière d’identifier les comtés dans le référentiel final. Ou, si les unités de population diffèrent d’une entrée à l’autre, vous pouvez imposer un système d’unités unique dans la destination. Ces modifications sont des transformations.
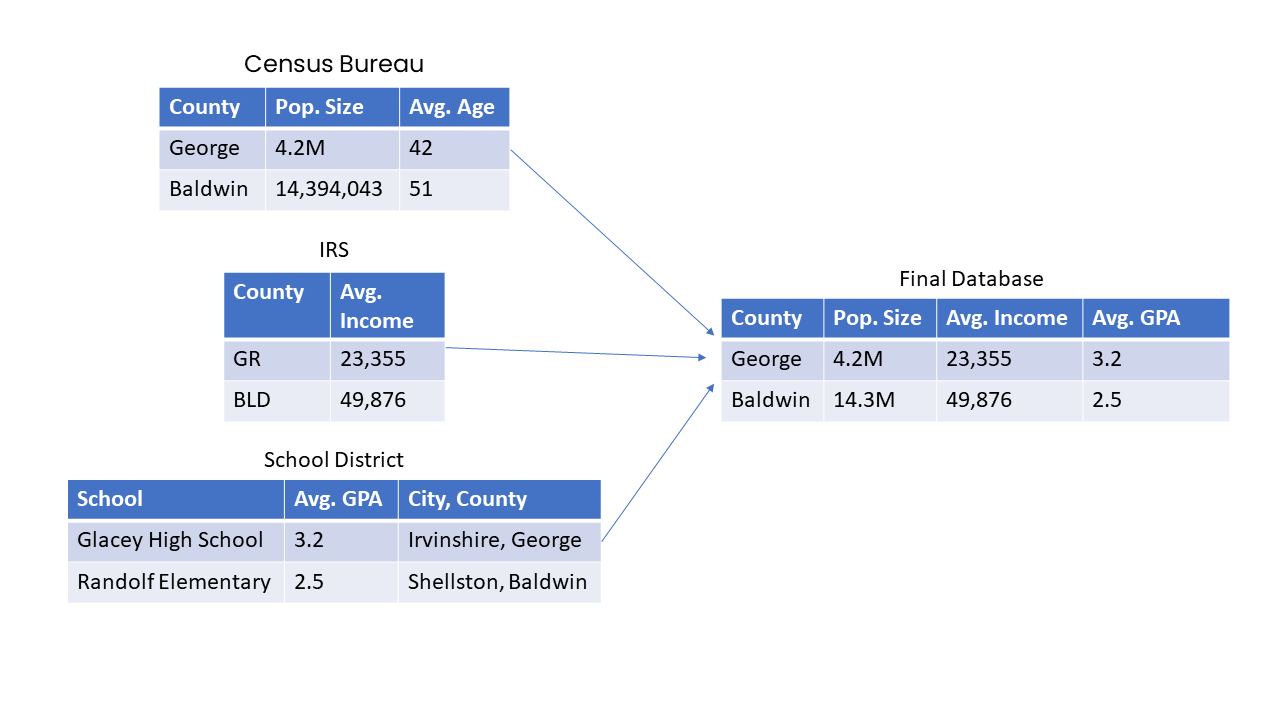
Figure 2 : lors de la combinaison d’informations issues de sources différentes, des transformations — changement d’unités, normalisation des noms — peuvent être nécessaires.
Les pipelines sont généralement développés et maintenus par des data engineers.
Une fois les données collectées, nettoyées et organisées au bout du pipeline, elles peuvent être exploitées par divers profils : data analysts, data scientists ou business analysts.
Elles peuvent servir à de l’analyse en temps réel, alimenter un tableau de bord mis à jour, ou être intégrées à un modèle de machine learning. Parfois, la sortie du pipeline est directement une application ou un tableau de bord pour un dirigeant ou un utilisateur final.
Les pipelines sont présents dans quasiment tous les secteurs manipulant de grands volumes de données. Dans de grandes entreprises, notamment tech, ils sont complexes, fortement encadrés et gérés par des équipes dédiées.
Dans des structures plus petites, comme un chercheur collectant des mesures de capteurs à travers le monde, le pipeline peut rester très simple, avec peu d’étapes. Autres exemples : un courtier agrégeant des données financières pour ses décisions d’achat, ou un groupe hospitalier consolidant les dossiers patients de ses établissements affiliés.
Les pipelines sont aussi cruciaux pour les modèles de machine learning, qui consomment d’énormes volumes de données ; une bonne tuyauterie est indispensable à leur bon fonctionnement. Ce tutoriel MLOps détaille l’usage des pipelines en machine learning.
Le stockage varie selon le type de données et l’usage visé. Trois notions reviennent souvent : data lake, base de données et data warehouse. Voyons-les brièvement.
Un data lake est un référentiel souple et massif pouvant accueillir des données structurées et non structurées à grande échelle. Il permet de stocker des données brutes, non traitées, issues de multiples sources (logs web, capteurs, réseaux sociaux, etc.) dans leur format natif.
Sa force : la polyvalence. Les data scientists et analystes peuvent y explorer, transformer et analyser les données de multiples façons. C’est particulièrement utile pour le big data et les analyses avancées où le schéma n’est pas défini à l’avance.
Les bases de données sont des systèmes généralistes pour stocker, gérer et retrouver efficacement des données structurées. Proches des data warehouses sur certains points, elles servent surtout à des données transactionnelles, aux opérations quotidiennes et aux applications temps réel. Relational, NoSQL ou in-memory, chaque type répond à des besoins spécifiques. Elles garantissent l’intégrité, l’accès concurrent et offrent des mécanismes de requêtage.
Un data warehouse est un référentiel fortement structuré et optimisé pour stocker, organiser et interroger des données structurées à des fins analytiques. Il suit un schéma prédéfini, impose qualité et cohérence, et excelle pour les requêtes et reportings complexes.
Idéal pour les décisions fondées sur l’historique, il fournit une source unique de vérité pour des analyses standardisées. Les données y sont extraites de diverses sources, transformées dans un format homogène puis chargées pour analyse.
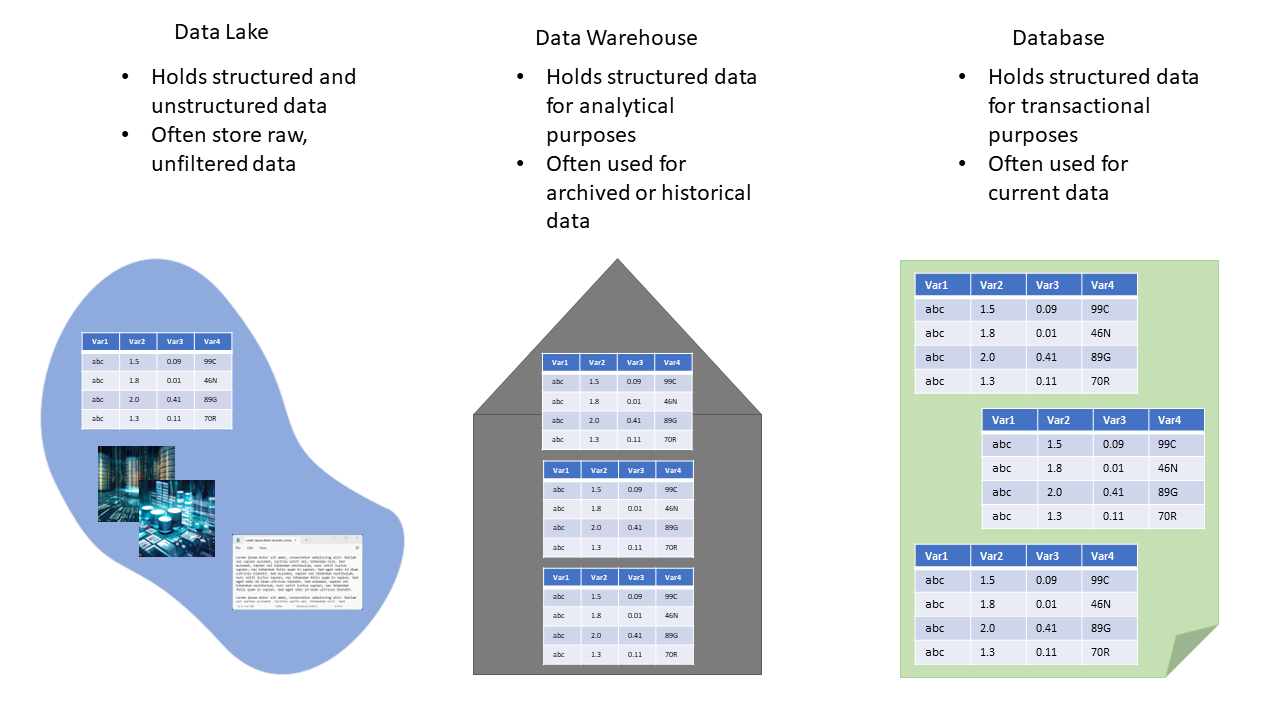
Figure 3 : principales différences entre un data lake, un data warehouse et une base de données. Un data lake peut précéder un entrepôt (warehouse) ou une base dans un pipeline.
Les pipelines suivent généralement deux grands schémas : ETL (Extract, Transform, Load) ou ELT (Extract, Load, Transform).
ETL est séquentiel. D’abord, on extrait les données depuis des systèmes sources (bases, fichiers, API, etc.).
Ensuite, on les transforme pour respecter le schéma cible, la qualité et les règles métier : nettoyage, agrégation, structuration. Enfin, on charge les données transformées dans le data warehouse ou le stockage cible, souvent optimisé pour le reporting et l’analyse.
L’ETL est pertinent quand les données nécessitent une restructuration ou un nettoyage important avant stockage, afin de garantir des données prêtes à l’analyse. Ce cours ETL with Python propose une vue détaillée d’ETL en Python et SQL.
ELT inverse l’ordre de la transformation. On extrait puis on charge d’abord les données, telles quelles, dans un data warehouse ou parfois un data lake. Les transformations sont réalisées ensuite, au sein même de l’entrepôt.
Cette approche exploite la puissance de calcul et la flexibilité des data warehouses modernes et des plateformes big data, idéale quand on souhaite stocker de grands volumes de données brutes et transformer à la demande.
L’ELT est souvent privilégié si votre solution d’entrepôt gère efficacement des transformations complexes, par exemple un data warehouse cloud ou des frameworks distribués comme Hadoop.
De nombreux outils existent pour concevoir des pipelines. Le bon choix dépendra de la taille, des besoins d’évolutivité, du budget et des objectifs. Vous pouvez bâtir un pipeline complet avec Python et SQL (ou R et SQL), ou recourir à des outils commerciaux.
Voici un aperçu de technologies et outils commerciaux courants.
Découvrez aussi notre sélection des meilleurs outils ETL et leurs usages.
La première étape consiste à collecter les données à injecter dans le pipeline. De nombreuses sources en ligne proposent des informations à jour : sites gouvernementaux, réseaux sociaux, associations, souvent via des API simples à utiliser.
Une API (application programming interface) est un logiciel intermédiaire permettant à des applications de communiquer. Par exemple, vous pouvez intégrer l’API de Twitter dans votre application Python pour publier ou « lire » des tweets en votre nom : un véritable passe-plat.
Vous pouvez recourir à des API en amont du pipeline pour collecter des données variées ; par exemple, des données de dépôts auprès de la SEC ou des données cliniques des tableaux de la NIH.
Autre technique : le web scraping, qui s’appuie sur un script sur mesure collectant des informations depuis des pages web. Des bibliothèques Python comme BeautifulSoup et Scrapy facilitent la tâche, mais il faut savoir naviguer dans le HTML ou le XML pour extraire ce dont vous avez besoin.
Pour aller plus loin, DataCamp propose des ressources sur Beautiful Soup en Python, le web scraping en R et le web scraping pour le NLP.
Il existe aussi des services no-code de scraping : en voici un exemple pour collecter des informations et surveiller les changements d’une page.
Votre collecte peut mêler données structurées (tableurs, bases) et non structurées (texte, images).
Selon votre objectif final, vous pouvez extraire des informations de vos données non structurées pour produire un jeu homogène et structuré, ou conserver une part non structurée en veillant à un bon système de référence croisée pour l’utilisateur final.
Les données structurées s’extraient souvent via des requêtes SQL ou des outils ETL, tandis que les données non structurées peuvent nécessiter du traitement du langage naturel (NLP) ou des outils spécialisés.
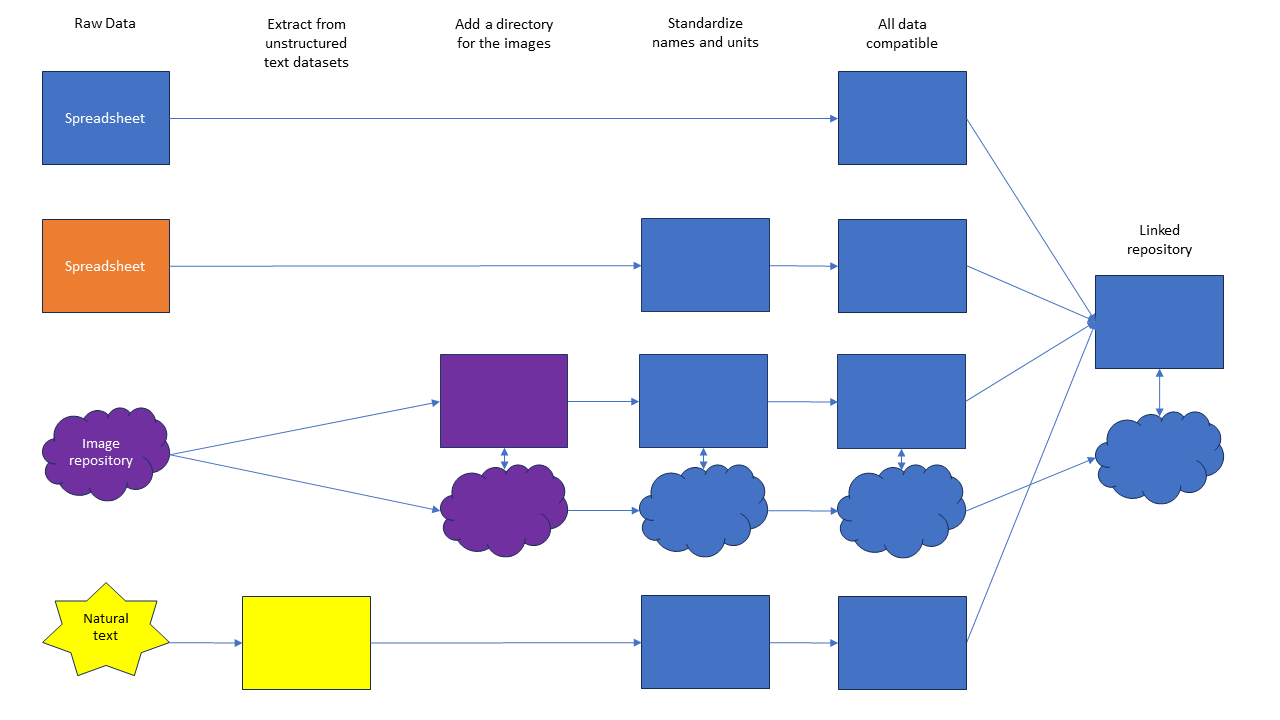
Figure 4 : exemple de pipeline conservant des données non structurées en sortie. Ici, nous voulons un référentiel de données structurées soignées, reliées à des images. Cela peut aussi s’apparenter à un data lake. Plutôt que d’extraire des données structurées des images, nous créons un répertoire qui lie chaque image aux données concernées dans la base. L’utilisateur peut ainsi récupérer l’image brute pour chaque ligne d’un tableur si besoin. Autre option : analyser les images et fournir une version annotée ou segmentée. Pour en savoir plus, consultez ce tutoriel d’analyse d’images.
Une fois les sources identifiées et l’objectif final clarifié, vous pouvez commencer la mise en place.
Commencez par planifier. Je vous conseille un schéma sur papier : à gauche, les sources ; à droite, l’objectif final ; entre les deux, les étapes nécessaires pour y parvenir.
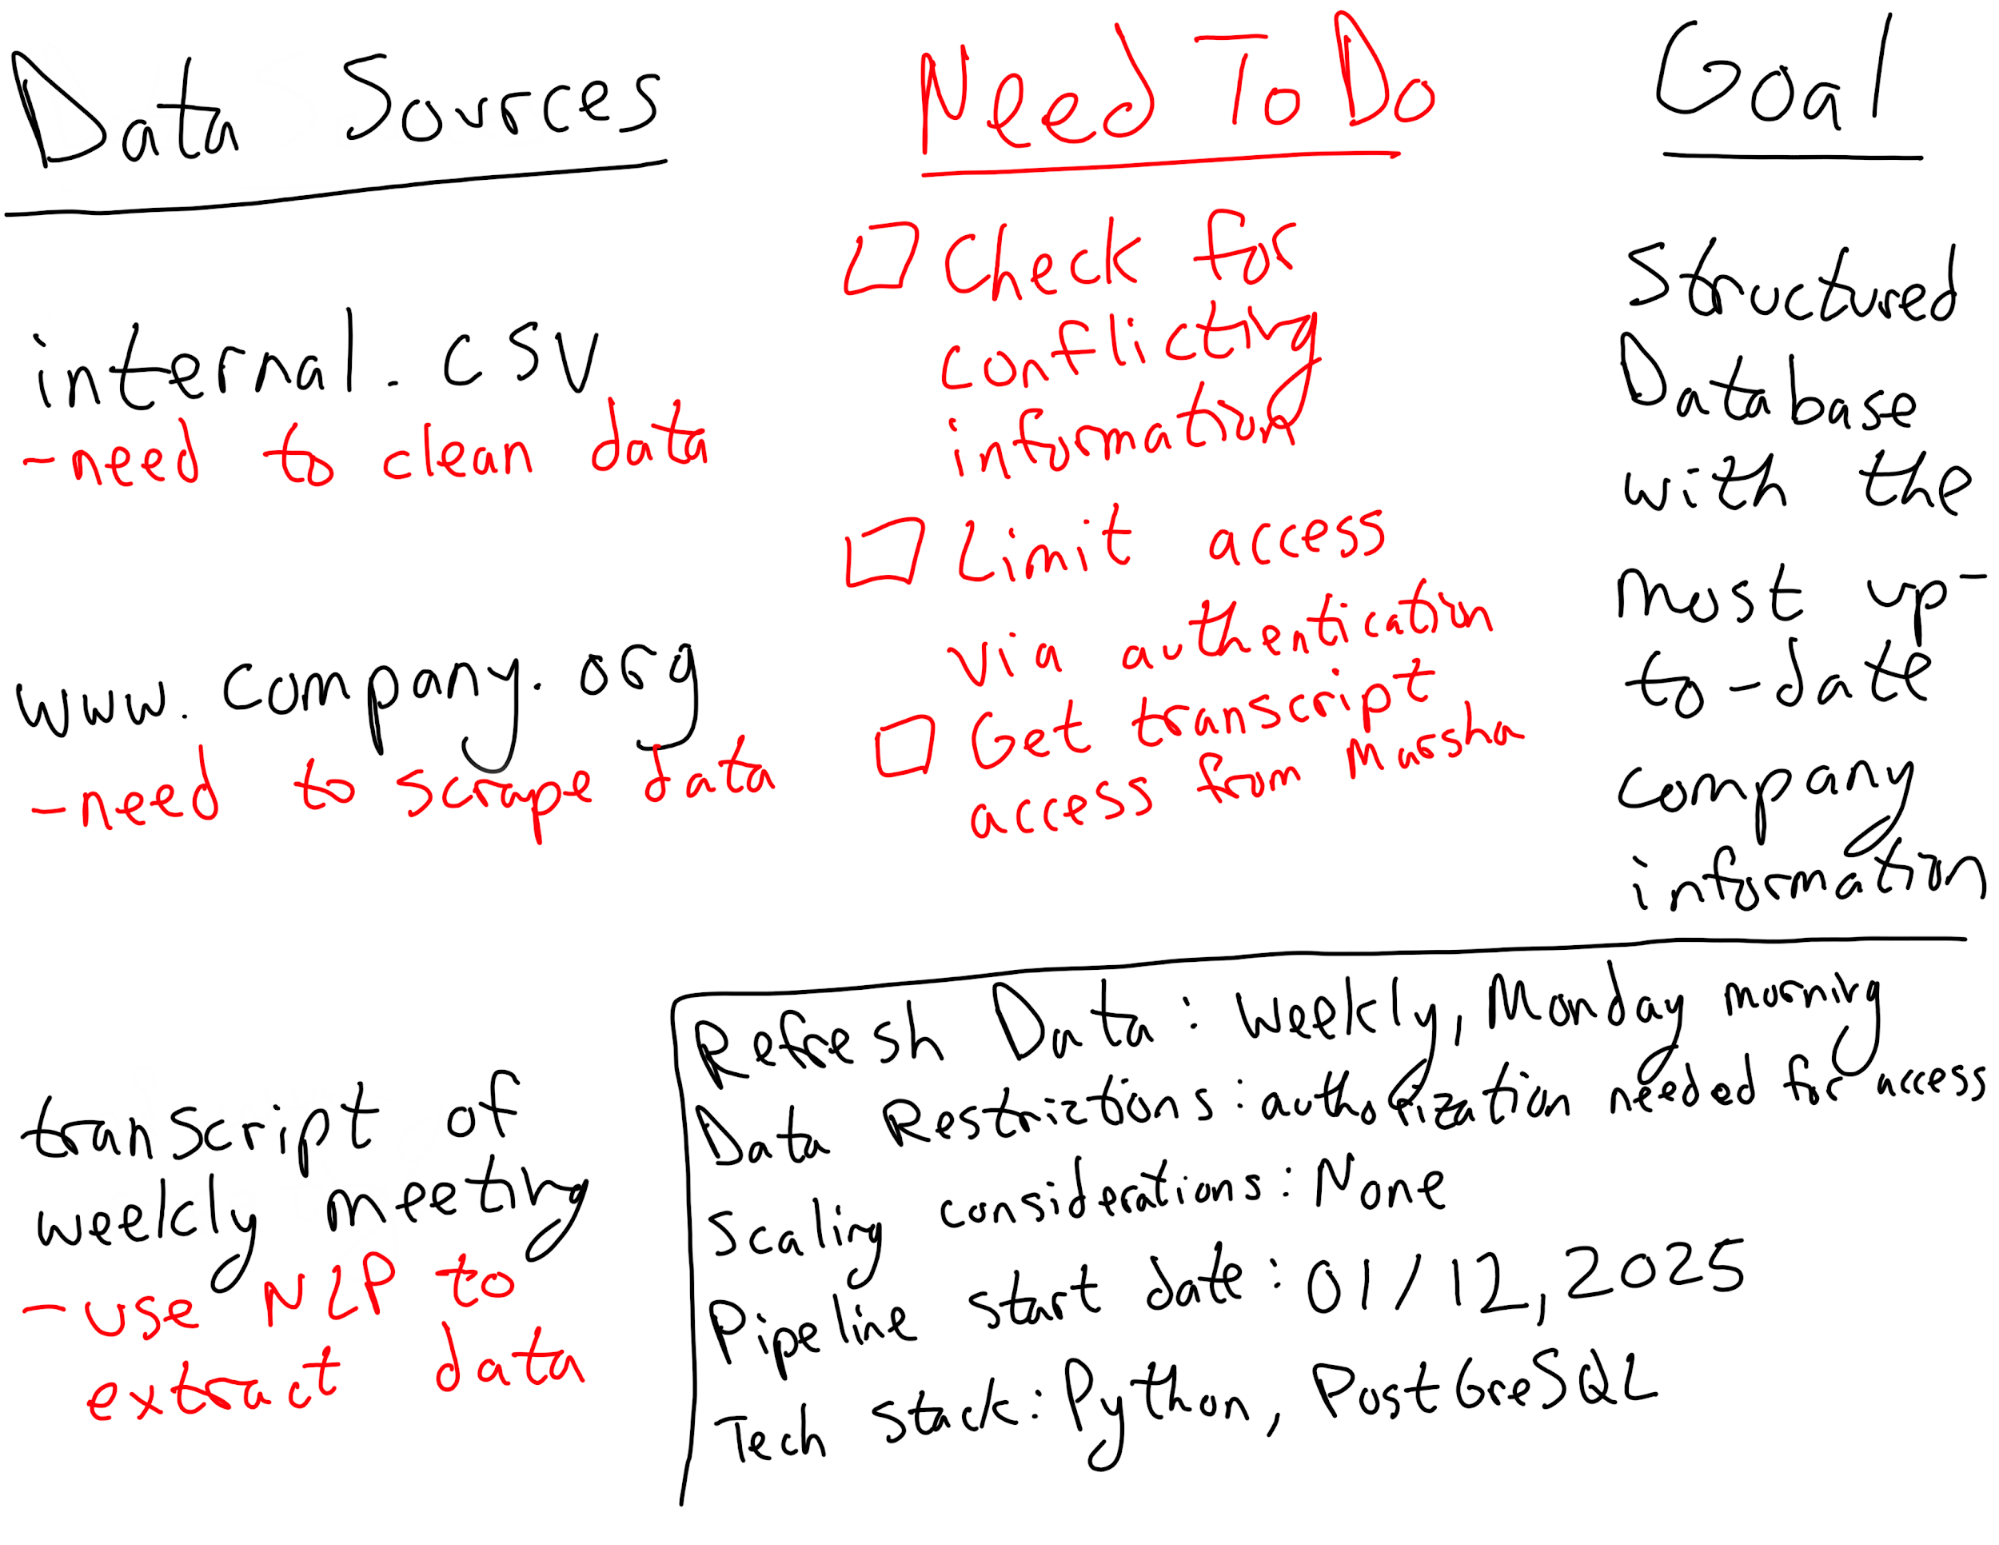
Figure 5 : exemple de plan pour un pipeline.
Parmi les étapes possibles :
Une fois le plan établi, passez à la construction. Entièrement en code dans votre langage favori, ou en combinant des services dédiés. Gardez en tête, tout au long, les besoins de l’utilisateur final.
Décision clé : la fréquence de mise à jour. Si l’information la plus fraîche est indispensable, optez pour un traitement temps réel. Sinon, le batch processing peut économiser des ressources : les données traversent alors les étapes par lots (quotidien, hebdomadaire) plutôt que de façon continue.
Anticipez la maintenance dès la construction. Prévoyez le monitoring du pipeline et la détection/correction d’anomalies.
Fautes de frappe, entrées incomplètes ou dupliquées, formats de fichiers variés : les défis ne manquent pas après la mise en service. Un dispositif robuste de journalisation et de gestion des erreurs vous évitera bien des tracas.
Pour un aperçu plus détaillé de la conception de pipelines, notamment en machine learning, découvrez le cours Designing Machine Learning Workflows in Python de DataCamp.
Comme toujours en data, faites aussi simple que possible : un pipeline léger coûte moins cher à maintenir, se met à jour plus facilement et sera plus compréhensible si vous devez le transmettre.
Dès la conception, évaluez les besoins du projet, y compris l’évolutivité future. Vous choisirez ainsi le juste niveau de complexité.
Par exemple, pour un pipeline temporaire agrégeant trois capteurs pendant quelques mois, une étape unique et un service gratuit et répandu (comme Google Drive) peuvent suffire.
En revanche, pour des données sensibles ou de multiples transformations, il faudra sans doute un code Python ou C# sur mesure avec chiffrement.
Enfin, si vous démarrez petit mais anticipez une forte montée en charge, concevez d’emblée une infrastructure à la hauteur.
La tentation est grande de démarrer petit avec l’idée de reconstruire plus tard. Cela peut fonctionner, mais prudence !
Beaucoup d’ingénieurs doivent rafistoler un pipeline inadapté à l’échelle actuelle, faute de budget ou de temps pour repartir de zéro.
Si la simplicité est clé, un pipeline pérenne doit intégrer les besoins d’extension prévisibles.
Quelques questions utiles en amont :
Piège classique des profils juniors : suivre la tendance au lieu de choisir l’outil adéquat.
Exemple : vouloir à tout prix intégrer de l’IA générative sans cas d’usage solide.
En tant que professionnel(le) des données, restez au fait des nouveautés, mais sélectionnez les outils pertinents pour votre projet, pas ceux dictés par la mode.
Une fois le plan établi, pensez optimisation. L’objectif : obtenir les données voulues, au bon niveau de détail et au bon rythme, tout en minimisant les ressources consommées et la latence d’acheminement.
Le suivi et la journalisation du flux sont fondamentaux : vous identifierez les goulots d’étranglement qui ralentissent ou surconsomment.
Sources lentes, ressources limitées, transformations inefficaces sont des causes typiques.
Une fois les points faibles repérés, plusieurs leviers :
Autre angle : ajuster le rafraîchissement. Si vos données sont actualisées chaque minute mais qu’une mise à jour toutes les cinq minutes suffit, réduire la fréquence libérera des ressources et baissera la consommation énergétique.
Certains flux peuvent véhiculer des données sensibles. Les données médicales, par exemple, sont très encadrées aux États-Unis et exigent des mesures bien plus strictes que des habitudes de visionnage média. Autres exemples : données financières et mots de passe.
Les mesures de sécurité dépendent du type de données. Parfois, l’anonymisation suffit (décorréler ou supprimer les identifiants personnels) — par exemple en recherche médicale quand l’information nominative n’est pas nécessaire.
D’autres cas imposent le chiffrement et un contrôle d’accès par authentification. C’est typiquement le cas pour des données financières ou des secrets d’entreprise.
Pour toute donnée sensible, maîtrisez et respectez la réglementation, comme le RGPD (Règlement général sur la protection des données) ou la HIPAA (Health Insurance Portability and Accountability Act).
Selon votre secteur et les données traitées, d’autres textes peuvent s’appliquer, tels que le CCPA (California Consumer Privacy Act) ou la FERPA (Family Educational Rights and Privacy Act).
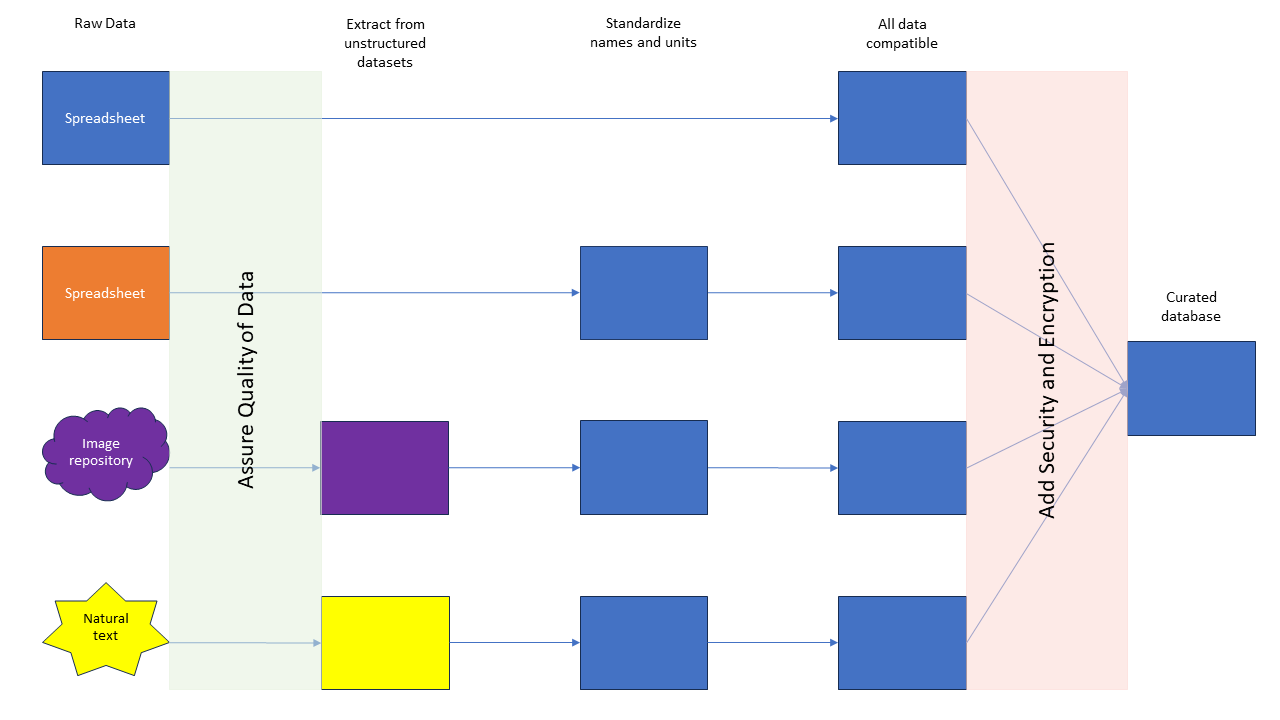
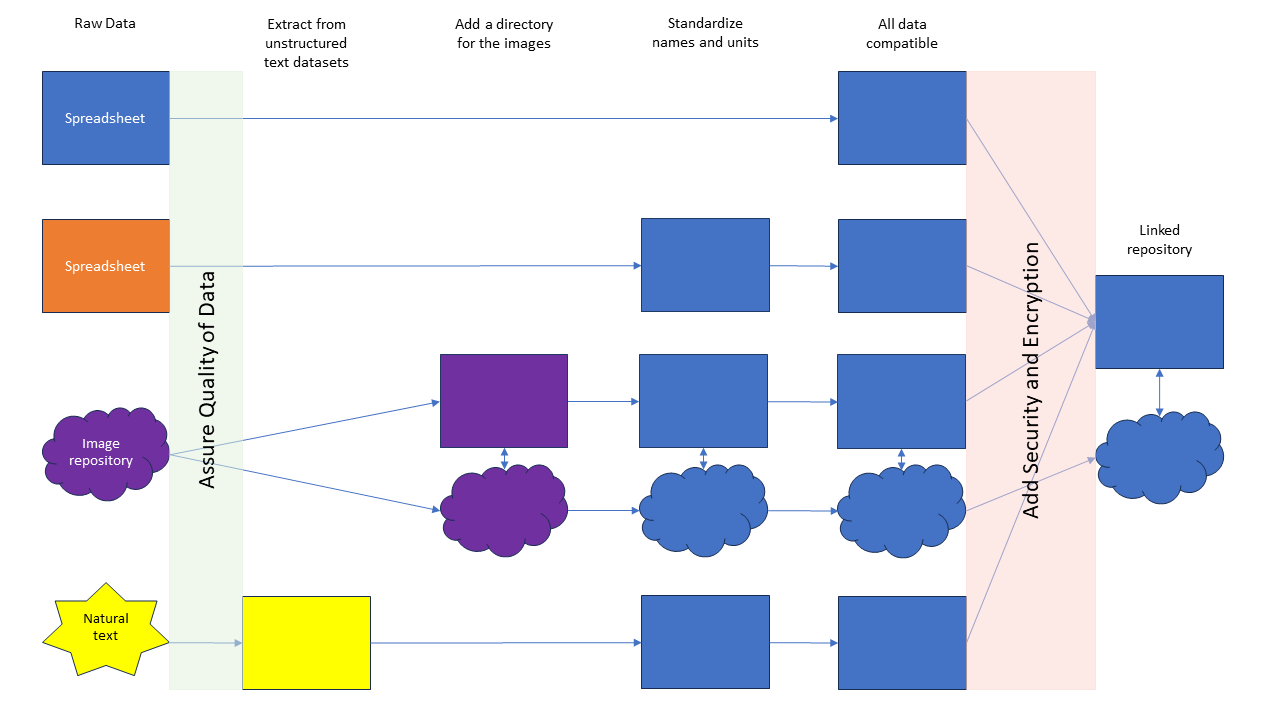
Figure 6 : exemple d’ajout d’étapes d’assurance qualité et de sécurité dans un pipeline.
Les pipelines de données, et celles et ceux qui les construisent, sont les héros discrets du monde de la data. Ils assurent un flux fluide, organisé et exploitable. Selon Statista, le monde a généré, consommé et stocké 64,2 zettabytes de données en 2020, un chiffre qui augmente chaque année.
Concevoir et maintenir des pipelines robustes devient donc de plus en plus critique. Si ce tutoriel a éveillé votre intérêt, explorez ce cours d’introduction pour aller plus loin. Pour apprendre à les construire, démarrez avec ce cours Python de data engineering. Et si vous souhaitez lancer votre carrière et attester vos compétences auprès des employeurs, découvrez notre Data Engineer Certification.
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.

Commencez à utiliser des pipelines de données dès aujourd’hui !
Cours
Cours