
Kurs
ETL und ELT mit Python
4 Std.
39.5K
Daten sind für Unternehmen und Organisationen unverzichtbar – und das Organisieren ihres Flusses ist genau die Stärke von Datenpipelines. Also: Was sind Datenpipelines, und was musst du wissen, um selbst eine zu bauen?
Daten sind das Lebenselixier moderner Unternehmen und Organisationen. Sie treiben Entscheidungen, Erkenntnisse und Innovationen voran. Allerdings ist der Umgang mit Daten und deren Nutzbarmachung oft komplex und herausfordernd. Genau hier kommen Datenpipelines ins Spiel. Aber was genau versteht man darunter?
Eine Datenpipeline ist ein System, das Daten aus verschiedenen Quellen abruft, sie in ein neues Ziel wie eine Datenbank, ein Repository oder eine Anwendung überführt und unterwegs bei Bedarf transformiert (also von einem Format oder einer Struktur in eine andere umwandelt). Die Nutzenden am Ende dieser Pipeline reichen von Analysten über Data Scientists bis hin zu Business-Verantwortlichen.
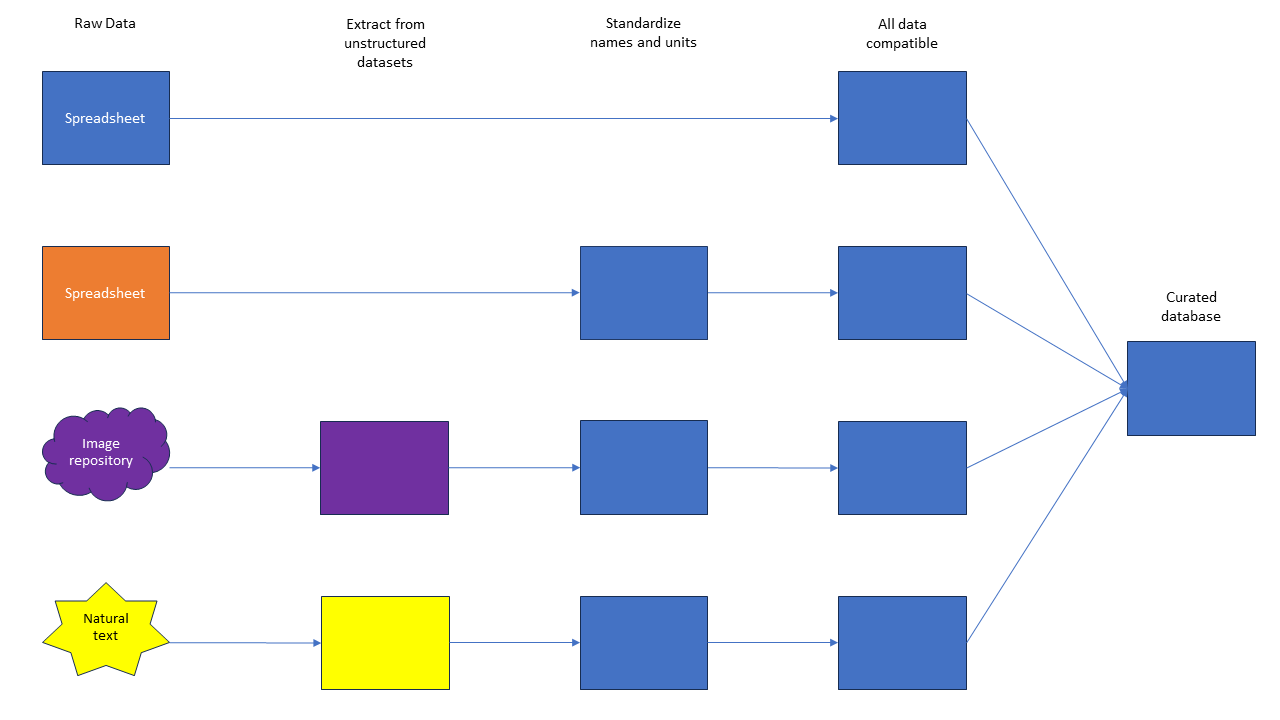
Abbildung 1: Beispiel für eine einfache Datenpipeline. In diesem Beispiel gibt es vier Datenquellen: zwei strukturierte und zwei unstrukturierte. Über mehrere Schritte werden strukturierte Informationen aus den unstrukturierten Daten extrahiert, alle Bezeichnungen und Einheiten vereinheitlicht und – sobald alles kompatibel ist – eine kuratierte Datenbank mit allen benötigten Informationen erstellt. Diese Datenbank kann dann von Analysten, Wissenschaftlern oder Business-Leadern genutzt werden.
So simpel das klingt, es steckt eine Menge Aufwand und viele Entscheidungen dahinter. In vielen Unternehmen ist der Aufbau und Betrieb von Pipelines eine eigene Aufgabe für Data Engineers. In anderen ist es nur eine von vielen Tätigkeiten, die ein Data Scientist übernimmt. Wer die Pipeline betreut, hängt oft von der Größe der Organisation, der Komplexität der Pipelines und den verfügbaren Mitteln ab.
Eine zuverlässige, sichere und aktuelle Pipeline ist ein zentraler Baustein für datenbasierte Entscheidungen. Ob du in die Data Engineering-Richtung gehen oder in einem anderen Bereich des Datenprozesses arbeiten willst – ein gutes Verständnis von Datenpipelines lohnt sich immer.
Vielleicht fragst du dich, warum du überhaupt eine Pipeline brauchst. Wenn du bisher mit fertigen Datensätzen oder Daten aus nur einer Quelle gearbeitet hast – wie bei Kaggle oder DataCamp-Übungen –, war eine Pipeline meist überflüssig. Diese kuratierten Datensätze sind bereits so aufbereitet, dass Analysten direkt damit arbeiten können.
Sobald du jedoch Informationen aus mehreren Quellen zusammenführen willst, brauchst du in der Regel eine Pipeline, damit alle Daten für deine Analyse zugänglich und nutzbar werden.
Hier sind einige wichtige Gründe, die für den Einsatz von Datenpipelines sprechen:
Angenommen, du willst wissen, ob der durchschnittliche GPA der Schüler in einem Schulbezirk mit dem durchschnittlichen Einkommen im County oder mit der Bevölkerungsgröße korreliert. Dafür brauchst du GPA-Daten aus jedem Schulbezirk in deiner Analyse, Einkommensdaten vom IRS und Bevölkerungszahlen vom Census Bureau.
Diese Informationen könntest du einmalig manuell zusammenstellen. Musst du die Analyse jedoch regelmäßig wiederholen, hilft dir eine zuverlässige Pipeline, die Datenerhebung zu automatisieren – das spart Zeit und Nerven.
Neben der Sammlung an einem Ort helfen Pipelines, Inkonsistenzen zwischen Quellen zu beheben. Das Census Bureau identifiziert Counties vielleicht mit dem vollen Namen, während der IRS Abkürzungen verwendet.
In der Pipeline kannst du festlegen, wie Counties im finalen Repository einheitlich benannt werden. Oder es gibt unterschiedliche Einheitensysteme bei der Bevölkerungszahl, die du vereinheitlichen musst. Solche Änderungen nennt man Transformationen.
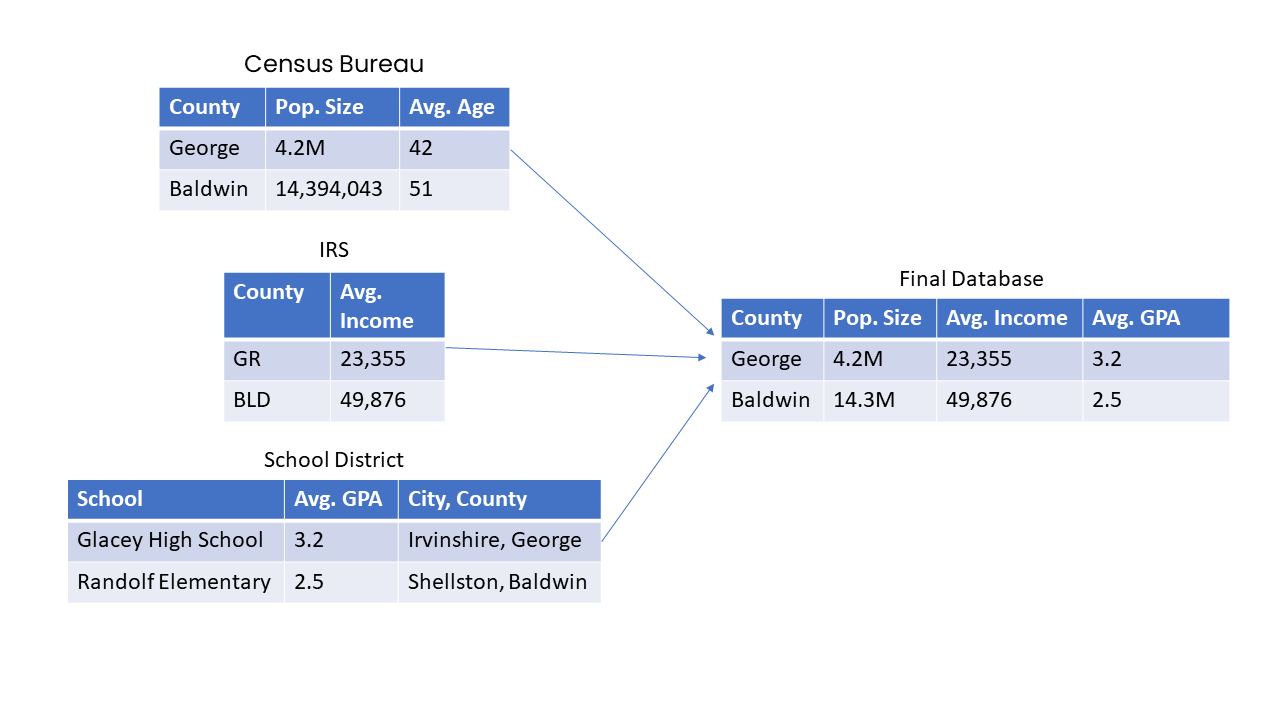
Abbildung 2: Bei der Kombination unterschiedlicher Quellen können Transformationen wie Einheitenwechsel und standardisierte Namen erforderlich sein.
Datenpipelines werden in der Regel von Data Engineers entwickelt und betreut.
Sind die Daten am Ende der Pipeline gesammelt, bereinigt und organisiert, können verschiedene Stakeholder wie Data Analysts, Data Scientists oder Business Analysts darauf zugreifen.
Die Daten lassen sich dann für Echtzeitanalysen nutzen, in ein sich aktualisierendes Dashboard einspeisen oder in ein Machine-Learning-Modell integrieren. Manchmal ist das Pipeline-Ende eine Anwendung oder ein Dashboard, das von Führungskräften oder Einzelpersonen genutzt wird.
Pipelines kommen praktisch in allen Branchen zum Einsatz, die große Datenmengen verarbeiten. In großen Tech-Unternehmen sind sie oft hochkomplex, streng reguliert und werden von spezialisierten Engineering-Teams betrieben.
In kleineren Organisationen – etwa eine einzelne Forscherin, die Daten von mehreren Sensoren weltweit erfasst – kann die Pipeline sehr schlank und überschaubar mit wenigen Schritten sein. Weitere Beispiele: Ein Broker sammelt Finanzinformationen zur Aktienauswahl oder ein Klinikverbund konsolidiert Patientendaten aus angeschlossenen Häusern.
Für Machine-Learning-Modelle sind Pipelines ebenfalls zentral. Diese Modelle benötigen enorme Datenmengen, und eine saubere Pipeline ist entscheidend für den reibungslosen Betrieb. Dieses MLOps-Tutorial zeigt im Detail, wie Pipelines im Machine Learning genutzt werden.
Je nach Datentyp und Einsatzzweck gibt es verschiedene Speicherarten. Drei Begriffe begegnen dir besonders häufig: Data Lakes, Datenbanken und Data Warehouses. Kurz erklärt:
Ein Data Lake ist ein großer, flexibler Speicher, der sowohl strukturierte als auch unstrukturierte Daten in großem Umfang aufnehmen kann. Er erlaubt es, rohe, unverarbeitete Daten aus verschiedensten Quellen – etwa Web-Logs, Sensoren, Social Media – im nativen Format abzulegen.
Data Lakes sind vielseitig: Data Scientists und Analysten können Daten explorieren, transformieren und auf vielfältige Weise analysieren. Sie sind besonders wertvoll für Big-Data- und Advanced-Analytics-Szenarien, in denen Schema und Struktur nicht vorab festgelegt sind.
Datenbanken sind Allzwecksysteme zum effizienten Speichern, Verwalten und Abrufen strukturierter Daten. Sie ähneln Data Warehouses in manchem, werden aber typischerweise für transaktionale Daten, tägliche Abläufe und Echtzeitanwendungen genutzt. Es gibt relationale, NoSQL- und In-Memory-Datenbanken – jeweils für unterschiedliche Anforderungen geeignet. Datenbanken sichern Datenintegrität, unterstützen parallelen Zugriff und bieten vielfältige Abfragemöglichkeiten.
Data Warehouses sind hingegen stark strukturierte, optimierte Speicher für analytische Zwecke. Sie folgen meist einem vordefinierten Schema, erzwingen Datenqualität und -konsistenz und sind für komplexe Abfragen und Reporting ausgelegt.
Sie sind ideal für Unternehmen, die auf Basis historischer Daten fundierte Entscheidungen treffen wollen – als „Single Source of Truth" für standardisierte Berichte und Analysen. Daten werden aus verschiedenen Quellen extrahiert, in ein einheitliches Format transformiert und für die Analyse ins Warehouse geladen.
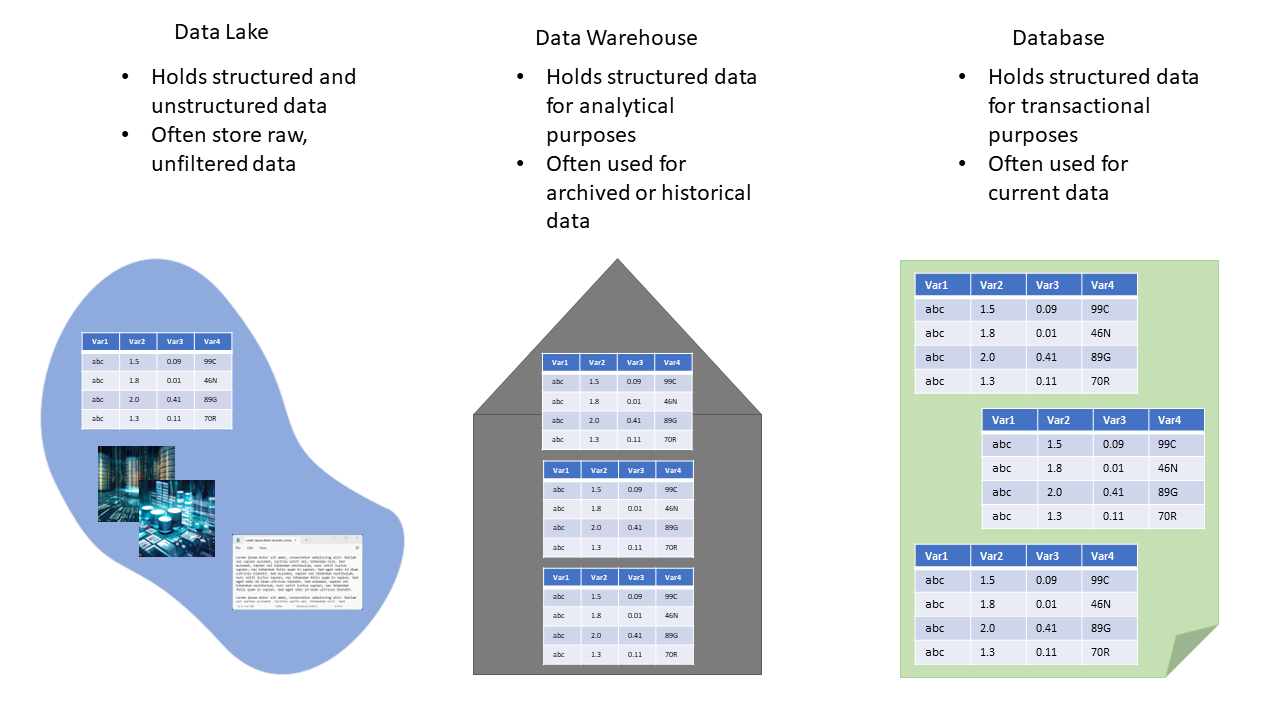
Abbildung 3: Unterschiede zwischen Data Lake, Data Warehouse und Datenbank. Ein Data Lake kann als vorgelagerter Schritt in einer Pipeline dienen, die in einem Warehouse oder einer Datenbank endet.
Pipelines folgen in der Regel einem von zwei Hauptschemata: ETL (Extract, Transform, Load) oder ELT (Extract, Load, Transform).
ETL ist sequentiell. Zuerst werden Daten aus verschiedenen Quellsystemen extrahiert – etwa aus Datenbanken, Dateien, APIs oder anderen Repositories.
Nach der Extraktion werden die Daten so transformiert, dass sie dem gewünschten Schema, der Qualität und den Business-Regeln entsprechen. Das umfasst z. B. Bereinigung, Aggregation und Strukturierung. Anschließend werden die transformierten Daten in das Zielsystem (meist ein Data Warehouse) geladen – oft in einem Format, das für Reporting und Analytik optimiert ist.
ETL ist vorteilhaft, wenn Daten vor dem Laden stark umgebaut oder bereinigt werden müssen, damit sie direkt analysierbar sind. Dieser ETL-mit-Python-Kurs bietet dir einen ausführlichen Überblick mit Python und SQL.
ELT kehrt die Reihenfolge der Transformation um. Zuerst werden die Daten aus den Quellsystemen extrahiert und unverändert in ein Data Warehouse oder auch in einen Data Lake geladen. Die Transformationen finden anschließend direkt im Warehouse statt.
Dieser Ansatz nutzt die Rechenleistung moderner Warehouses und Big-Data-Plattformen und eignet sich, wenn große Mengen Rohdaten gespeichert und Transformationen bei Bedarf ausgeführt werden sollen.
ELT ist oft erste Wahl, wenn das Data-Warehousing-System komplexe Transformationen effizient bewältigt – etwa cloudbasierte Warehouses oder verteilte Frameworks wie Hadoop.
Für den Pipeline-Aufbau gibt es viele Tools. Die richtige Wahl hängt von Größe, Skalierungsbedarf, Budget und Zielen ab. Du kannst eine vollständige Pipeline mit Python und SQL (oder mit R und SQL) umsetzen – oder auf diverse kommerzielle Lösungen setzen.
Hier eine kurze Liste verbreiteter kommerzieller Technologien und Tools.
Eine Übersicht über die besten ETL-Tools und ihre Einsatzgründe findest du in einem separaten Artikel.
Der erste Schritt beim Aufbau einer Pipeline ist die Datensammlung. Aktuelle Informationen findest du online zum Beispiel auf Regierungsseiten, in sozialen Netzwerken oder bei Non-Profits. Häufig stellen diese eine API bereit, die sich relativ einfach nutzen lässt.
Eine API (Application Programming Interface) ist im Kern Software, die die Kommunikation zwischen Anwendungen ermöglicht. Du kannst etwa eine Twitter-API in deine Python-App einbinden, damit sie in deinem Namen Tweets postet oder „liest". Sie fungiert also als Vermittler.
APIs kannst du am Anfang deiner Pipeline einsetzen, um Daten aus verschiedenen Quellen zu sammeln. Beispielsweise für Unternehmensmeldungen von der SEC oder für klinische Daten aus NIH-Tabellen.
Eine weitere Methode ist Web-Scraping. Dabei holt ein individuell geschriebenes Skript Informationen von Webseiten. Python-Bibliotheken wie BeautifulSoup und Scrapy machen das relativ einfach – du musst jedoch in HTML oder XML navigieren können, um die gewünschten Informationen zu finden.
Wenn du mehr über Web-Scraping lernen willst, hat DataCamp Inhalte zu Beautiful Soup in Python, Web-Scraping mit R und Web-Scraping für NLP.
Es gibt auch No-Code-Dienste für Web-Scraping. Hier ist ein solcher Service, mit dem du eine Seite auslesen und auf Änderungen überwachen kannst.
Bei der Erfassung können sowohl strukturierte Daten (z. B. Tabellen, Datenbanken) als auch unstrukturierte Daten (z. B. Texte, Bilder) anfallen.
Je nach Ziel deiner Pipeline extrahierst du aus unstrukturierten Daten Informationen, um einen einheitlich strukturierten Datensatz zu bilden – oder du belässt Teile unstrukturiert und sorgst für saubere Querverweise für die Endnutzung.
Strukturierte Daten lassen sich oft über SQL-Abfragen oder ETL-Tools beziehen, während unstrukturierte Daten Verfahren der natürlichen Sprachverarbeitung (NLP) oder Spezialtools erfordern.
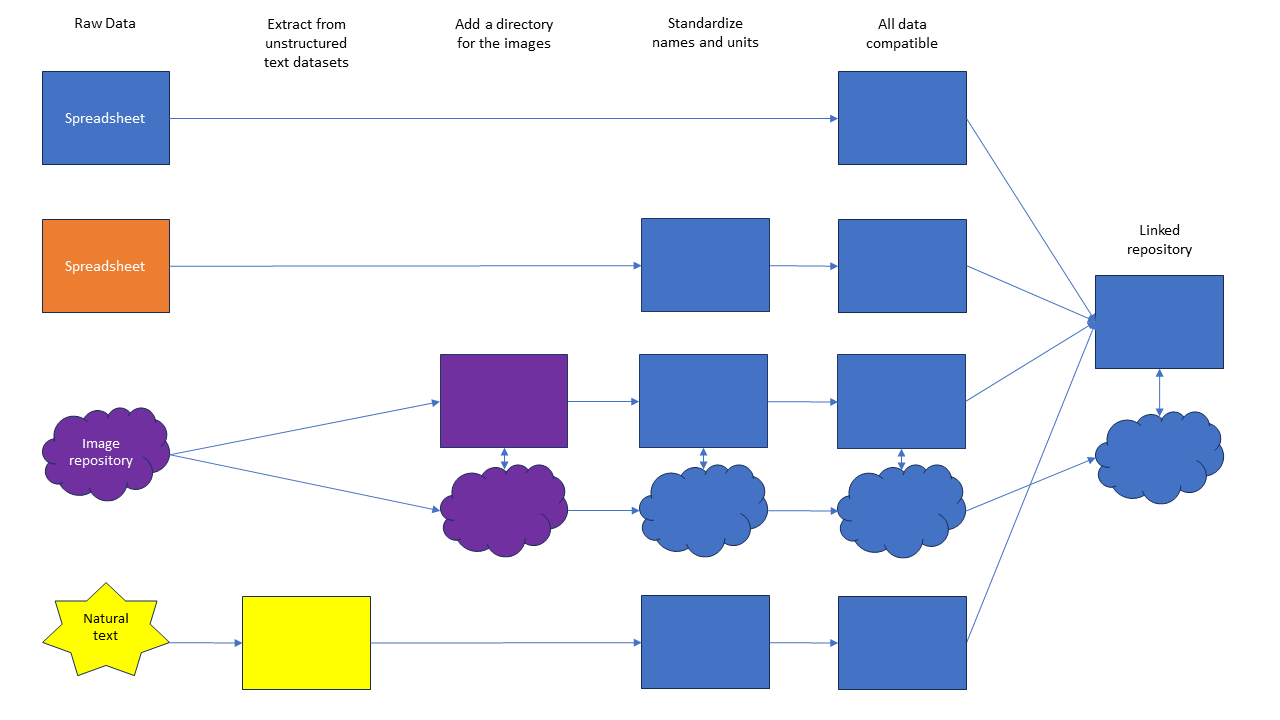
Abbildung 4: Beispiel einer Datenpipeline, in der unstrukturierte Daten am Ende erhalten bleiben. Hier wollen wir ein Repository aus kuratierten strukturierten Daten und verknüpften Bildern erstellen – alternativ ein Data Lake. Statt strukturierte Daten aus den Bildern zu extrahieren, erzeugen wir ein Verzeichnis, das Bilder mit den relevanten Datensätzen in der Datenbank verknüpft. Endnutzende können bei Bedarf zu jeder Tabellenzeile das Rohbild abrufen. Alternativ wäre eine Bildanalyse möglich, bei der Bildbereiche isoliert oder entfernt werden. Wie das geht, zeigt dieses Tutorial zur Bildanalyse.
Sobald Quellen feststehen und das Ziel klar ist, kannst du mit dem Setup deiner Pipeline starten.
Plane deine Pipeline zuerst. Am besten skizzierst du sie auf Papier: Links die Datenquellen, rechts das Endziel. Dazwischen listest du alle nötigen Schritte, um von den Quellen zum Ziel zu gelangen.
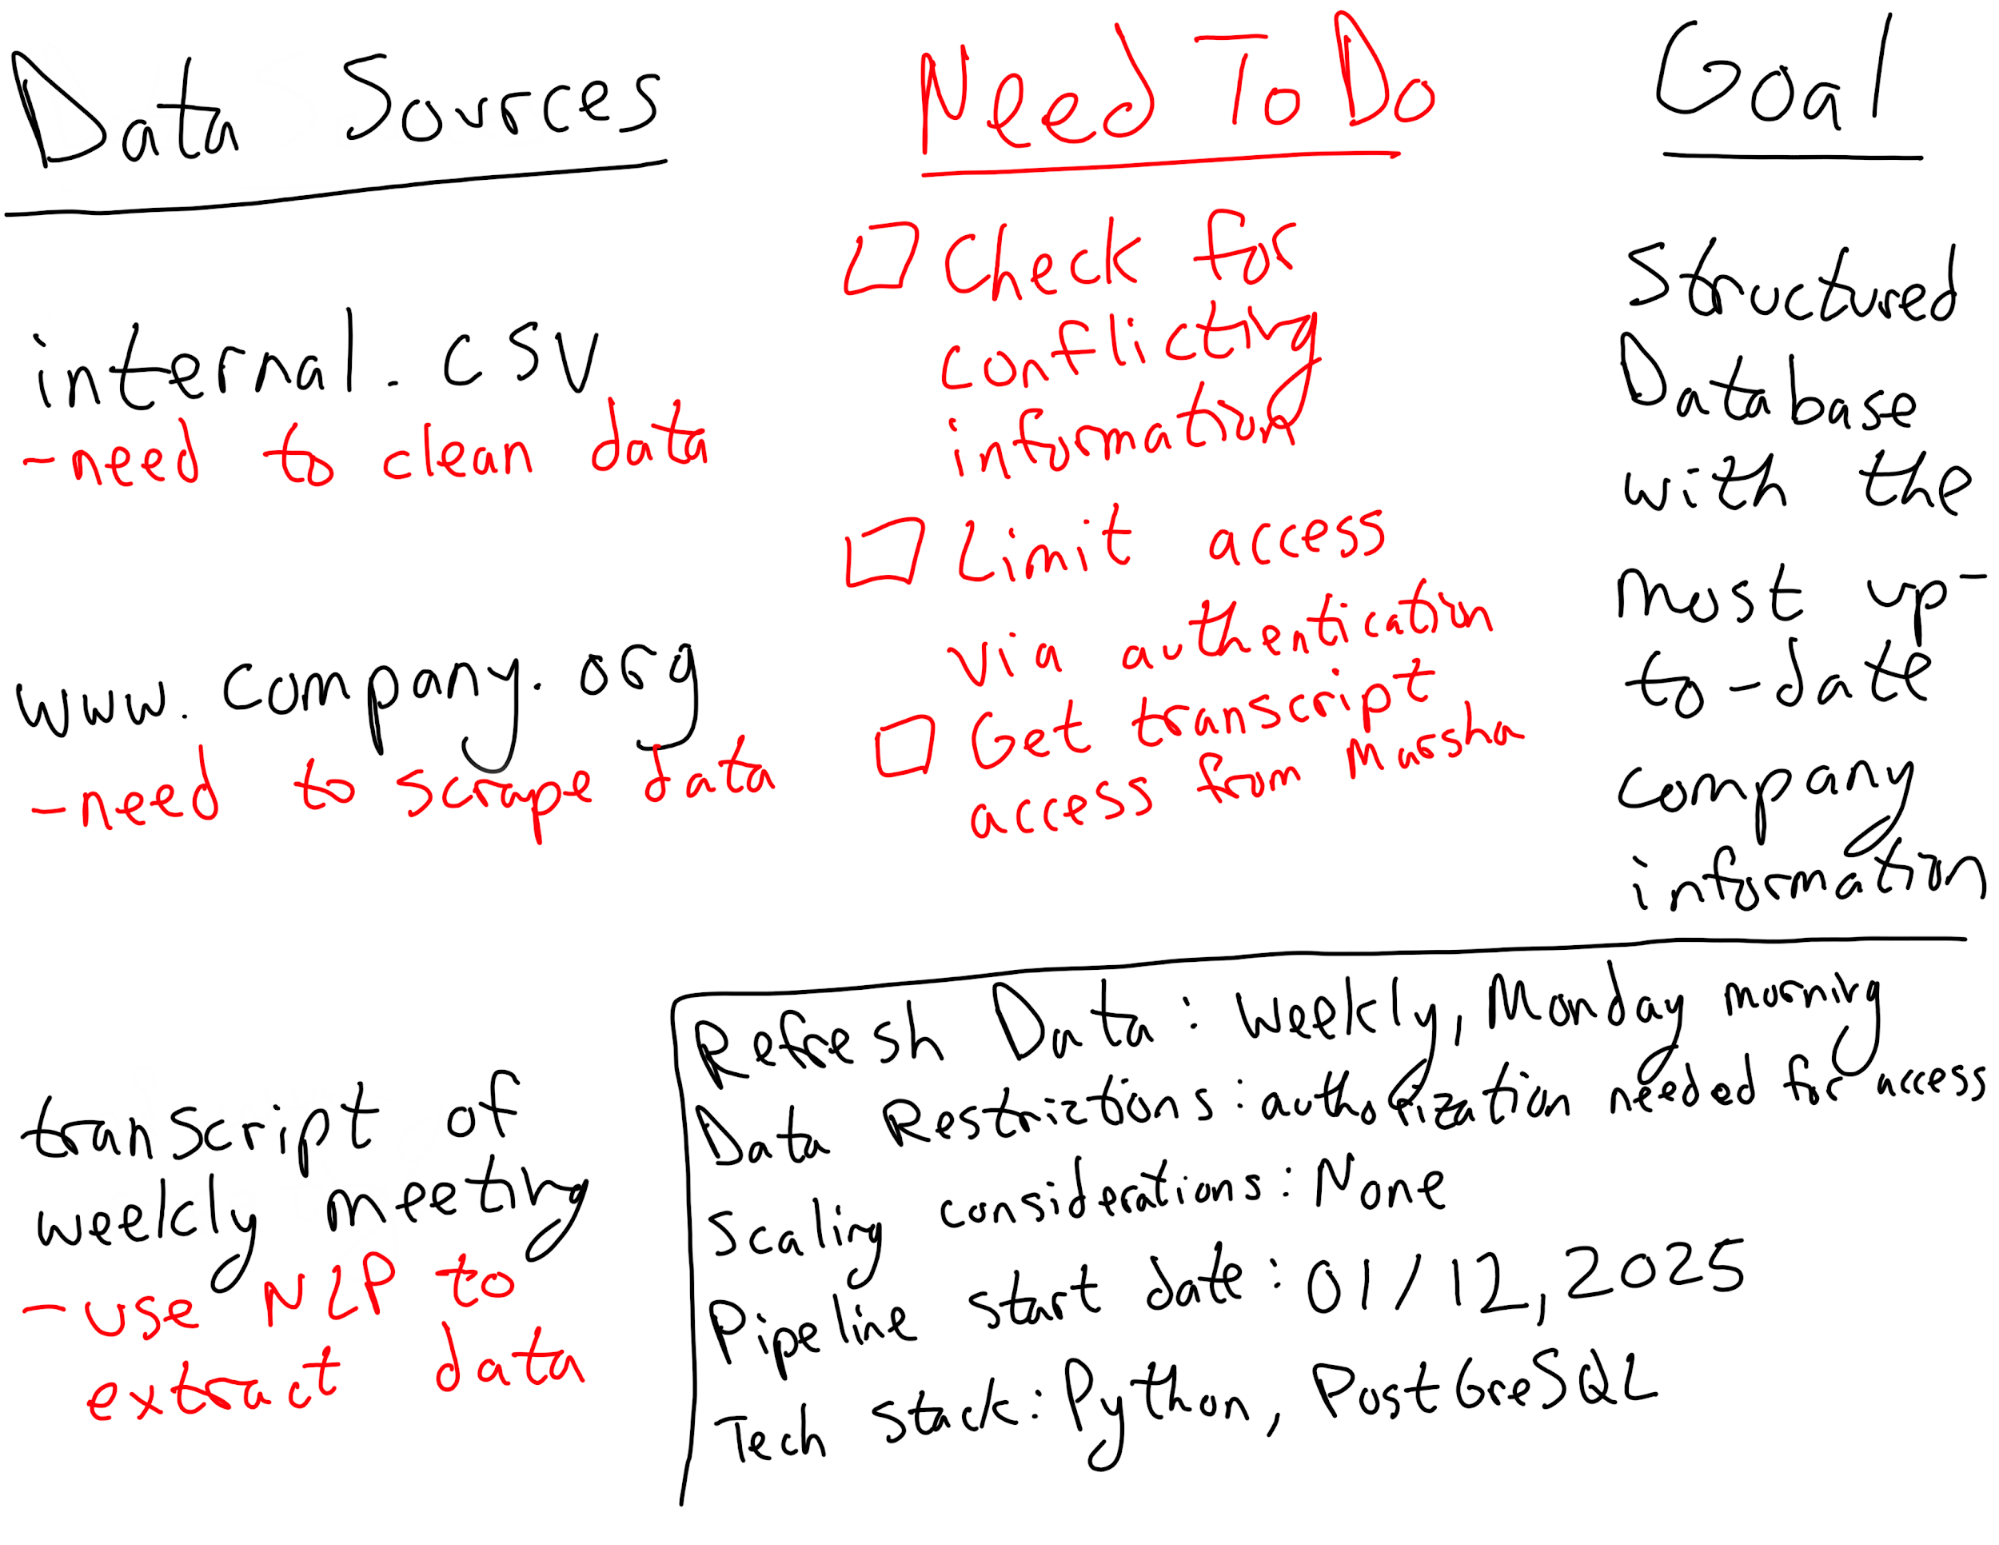
Abbildung 5: Beispielplan für eine Pipeline.
Mögliche Schritte sind unter anderem:
Steht der Plan, geht es an die Umsetzung – komplett in deiner bevorzugten Programmiersprache oder unterstützt durch passende Services. Behalte beim Aufbau stets die Endnutzenden und ihre Anforderungen im Blick.
Eine zentrale Entscheidung: Wie häufig sollen die Daten aktualisiert werden? Wenn du die neuesten Informationen brauchst, brauchst du eine Pipeline für Echtzeitverarbeitung. Ist das nicht nötig, kannst du Ressourcen sparen und auf Batch-Verarbeitung setzen – zum Beispiel tägliche oder wöchentliche Läufe statt kontinuierlicher Verarbeitung.
Denke frühzeitig daran, wie du die Pipeline später wartest. Du brauchst Monitoring, um Funktionen zu überwachen und unerwartete Probleme zu erkennen und zu beheben.
Tippfehler, unvollständige oder doppelte Einträge und unterschiedliche Dateiformate sind nur einige der Herausforderungen, die lange nach dem Go-live auftreten können. Ein robustes Fehler- und Monitoringkonzept spart dir viel Ärger.
Einen detaillierteren Blick auf das Design von Datenpipelines – insbesondere im Machine-Learning-Kontext – bietet der DataCamp-Kurs Designing Machine Learning Workflows in Python.
Wie immer bei Daten gilt: So einfach wie möglich, so komplex wie nötig. Schlanke Pipelines sind günstiger und leichter zu warten, einfacher zu aktualisieren und besser nachvollziehbar – auch wenn du sie an andere übergibst.
Am Anfang des Designs solltest du Anforderungen und mögliche Skalierung bewerten. So findest du die angemessene Komplexität.
Brauchst du zum Beispiel eine temporäre Pipeline, um einige Monate Daten von drei Sensoren zu sammeln, reicht vielleicht ein einfacher Ein-Schritt-Prozess mit einem frei verfügbaren Dienst wie Google Drive.
Hast du hingegen sensible Daten oder viele Transformationen, ist eigener Code in Python oder C# mit Verschlüsselung angebracht.
Oder du baust heute klein, erwartest aber in wenigen Jahren starkes Wachstum. Dann solltest du die Infrastruktur so wählen, dass sie die Expansion tragen kann.
Es ist verlockend, zunächst klein zu starten und später für größere Anforderungen eine neue Pipeline zu bauen. Das kann funktionieren – aber sei vorsichtig!
Viele Data Engineers müssen Pipelines flicken, die nie für die aktuelle Last konzipiert waren, weil ein Neubau als zu teuer oder zeitaufwendig gilt.
Simpel ist gut – aber bei langfristigen Pipelines solltest du absehbares Wachstum von Anfang an mitdenken.
Fragen, die du dir zu Projektbeginn stellen solltest:
Ein typischer Fehler von Junior-Engineers ist, Trends hinterherzulaufen statt die besten Werkzeuge für die Aufgabe zu wählen.
Viele Unternehmen versuchen etwa, Generative KI ohne tragfähigen Use Case in ihren Stack zu pressen.
Als Data Professional solltest du neue Technologien und Trends kennen – entscheide dich aber immer für das Tool, das dein Projekt wirklich voranbringt, statt blind dem Hype zu folgen.
Steht dein Pipeline-Plan, solltest du Optimierungen einplanen. Ziel ist, die gewünschten Daten mit passender Auflösung und Aktualisierungsfrequenz zu erhalten – bei minimalem Ressourcenverbrauch und geringer Verzögerung entlang der Pipeline.
Ein Schlüssel zur Optimierung ist das Überwachen und Protokollieren des Datenflusses. So erkennst du Engpässe, die den Fluss bremsen oder übermäßig Ressourcen binden.
Typische Bottlenecks sind langsame Datenquellen, Ressourcenengpässe oder ineffiziente Transformationen.
Hast du Bottlenecks identifiziert, helfen dir unter anderem diese Ansätze:
Auch die Refresh-Rate ist ein Hebel. Wenn Daten minütlich aktualisiert werden, du aber nur alle fünf Minuten neue Werte brauchst, senkt eine Reduktion der Aktualisierungen die Last und den Energieverbrauch.
Bestimmte Datentypen in deinen Pipelines erfordern besondere Sicherheits- oder Datenschutzmaßnahmen. Medizinische Daten sind beispielsweise in den USA stark reguliert und benötigen deutlich mehr Schutz als etwa Daten zu Mediennutzungsgewohnheiten. Weitere sensible Beispiele sind Finanzdaten und Passwörter.
Welche Maßnahmen du ergreifst, hängt vom Schutzbedarf ab. Mitunter genügt Anonymisierung, bei der personenbezogene Informationen entkoppelt oder gelöscht werden – etwa in der medizinischen Forschung, wenn Identifikationsmerkmale nicht nötig sind.
Weitere Maßnahmen sind Verschlüsselung und Zugriffskontrolle über Logins. Das ist etwa für Finanzdaten oder Betriebsgeheimnisse üblich.
Bei allen sensiblen Daten ist es wichtig, staatliche Vorgaben einzuhalten – zum Beispiel GDPR (General Data Protection Regulation) oder HIPAA (Health Insurance Portability and Accountability Act).
Je nach Branche und Datentypen können zusätzliche Vorgaben gelten, etwa CCPA (California Consumer Privacy Act) oder FERPA (Family Educational Rights and Privacy Act).
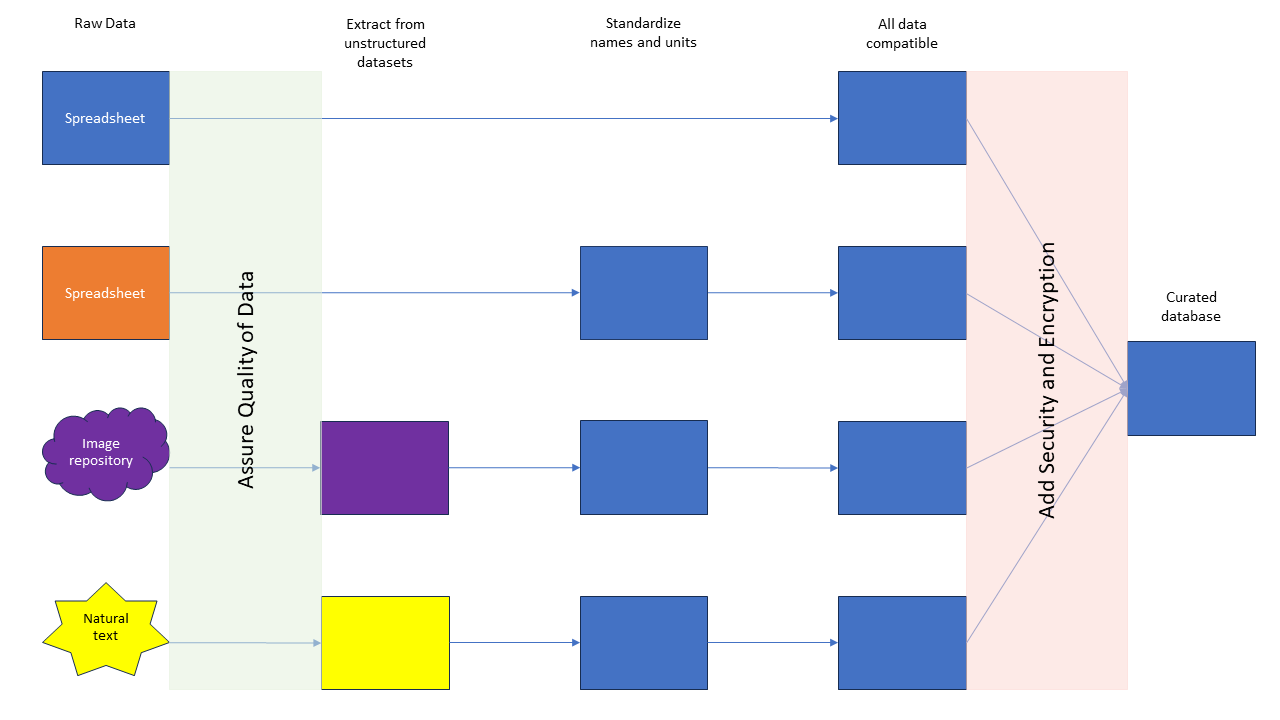
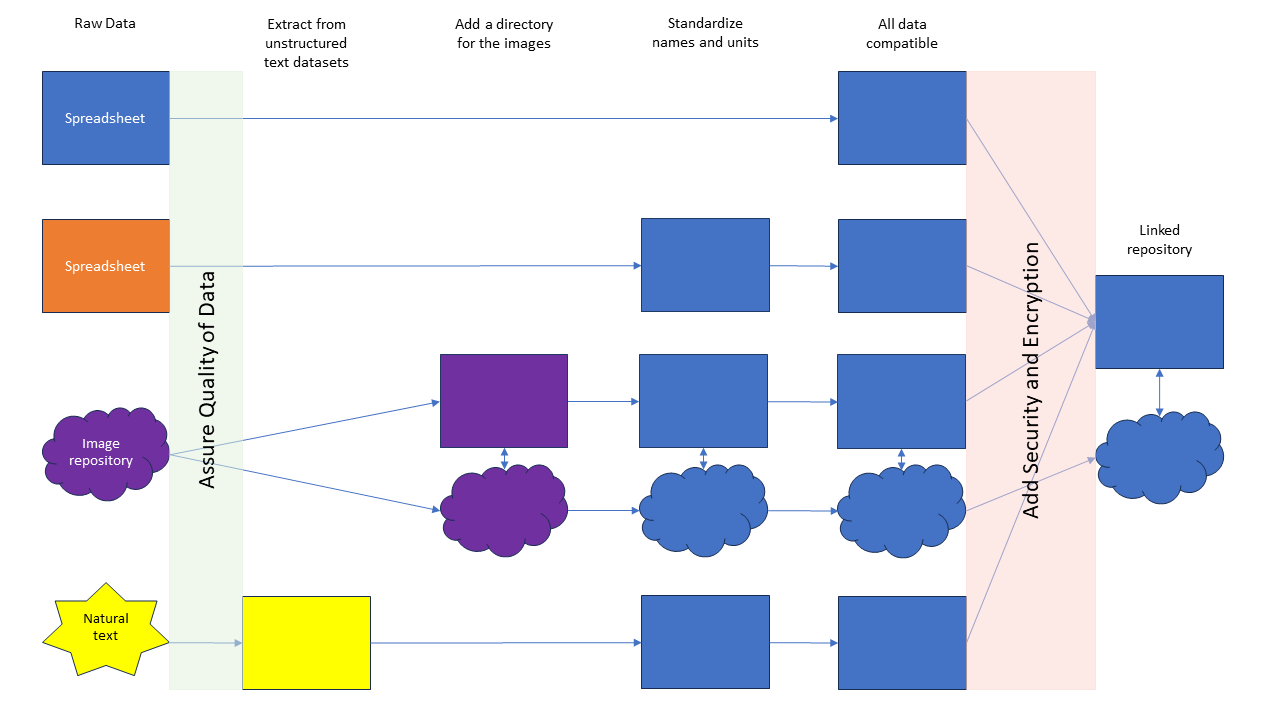
Abbildung 6: Beispiel für die Integration von Qualitätssicherung und Sicherheitsmaßnahmen in eine Pipeline.
Datenpipelines – und die Engineers dahinter – sind die unbesungenen Heldinnen und Helden der Datenwelt. Sie sorgen dafür, dass Daten reibungslos fließen, geordnet und aufbereitet werden. Laut Statista wurden allein 2020 weltweit 64,2 Zettabyte an Daten erzeugt, konsumiert und gespeichert – Tendenz steigend.
In einer solchen Datenwelt werden robuste Datenpipelines immer wichtiger. Wenn dich dieses Tutorial neugierig gemacht hat, wirf einen Blick in diesen Einführungskurs für einen tieferen Einstieg. Wenn du lernen willst, wie man Datenpipelines baut, starte mit diesem Python Data Engineering-Kurs. Und wenn du deine Karriere starten und deine Kompetenzen gegenüber Arbeitgebern belegen willst, schau dir unsere Data Engineer Certification an.
Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

Lerne noch heute, Datenpipelines zu nutzen!
Kurs
Kurs