
学习路径
机器学习基础知识 在 Python 中
16 小时
在机器学习中,衡量模型对现实结果的预测有多准确至关重要。无论您是在构建天气预报模型,还是在优化推荐系统,您都需要一种方法来量化预测与现实的接近程度。实现这一点的一个强大方法就是 KL 散度。
本文将探讨什么是 KL 散度、它为何重要、其直观含义、数学基础,以及展示其应用的实用示例。
如果您正在学习机器学习概念,我强烈建议查看 Python 机器学习基础技能路径。
KL 散度(Kullback–Leibler Divergence)是一种统计度量,用于衡量一个概率分布相对于另一个参考分布的“偏离”程度。
假设我们一起构建一个预测明日天气的模型。在底层,模型在“下注”——为各种可能结果分配概率。但有一个重要问题:
您如何衡量这些“下注”距离现实有多远?
我们需要一种方法来量化这种差异,而这正是 KL 散度的用武之地。它是一种数学工具,用来量化模型所相信的与真实情况之间的差距。
如前所述,KL 散度(更正式地称为 Kullback–Leibler 散度)是现代数据科学、机器学习与人工智能的基石。它告诉我们,以比特(bits)或纳特(nats,稍后会提到)为单位,当我们用一个概率分布(例如模型的预测 Q)去近似另一个(真实分布 P)时,会产生多少“额外的意外”或“信息损失”。
它在模型评估、神经网络正则化、贝叶斯更新,甚至数据压缩与高效传输中都扮演着裁判的角色。
为了更直观地理解 KL 散度的重要性,可以这样想:每当模型做出预测,其实就是在押注未来。KL 散度就是计分卡,用来计算这些赌注的代价。这个原则适用于广泛的机器学习主题,无论我们是在训练聊天机器人、诊断疾病,还是优化广告投放。
从数学上讲,KL 散度的定义如下:
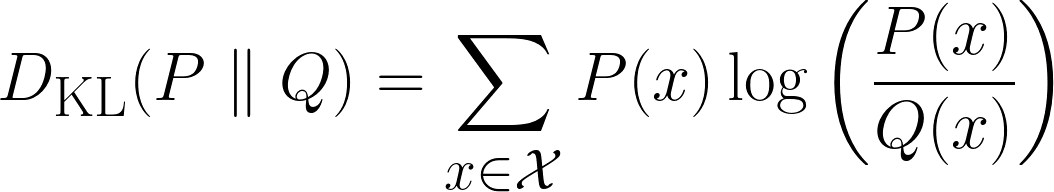
上面是离散情形下的公式,下面是连续情形下的公式。
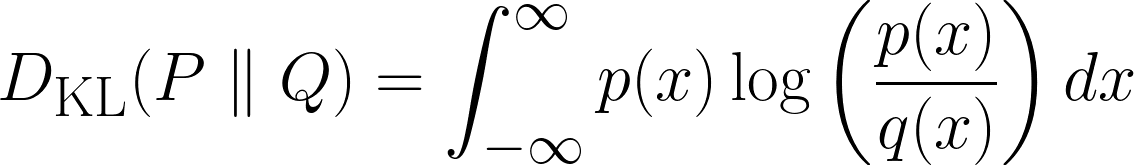
本节我们将从直觉出发推导 KL 散度。我们先来通过一系列问题展开。
“如果我完美猜中一次抛硬币的结果,您会惊讶吗?”我想您会有点惊讶,但不至于震惊。现在看第二种情形。
“如果我完美猜中一次掷骰子的结果,您会比上一个情形更惊讶吗?”我想您会说会,因为我猜中的概率更低。
最后一种情形:
“如果我准确猜中中奖的彩票号码,您现在会比上一种情形更惊讶吗?”我想您会说会,甚至完全震惊。为什么?
因为随着情形推进,我猜中正确结果的概率在降低,因此您对结果的惊讶在增加。我们观察到了一个关系:
事件发生的概率与“意外”呈反比关系。
更明确地说,随着事件概率降低,“意外”增大,反之亦然。
不过我们还能做一个有趣观察。回到掷骰子的例子,设想您连续掷同一个骰子 3 次,而我每次都猜对,您会比只猜对 1 次更惊讶多少?
您的惊讶不只是略高于一次猜中;而是显著更高,理想情况下高 3 倍。为什么?因为每一次新的猜中都会叠加您的不信任感。这不是简单地加一份固定的“意外”,而是将这种不可思议的感觉成倍放大。
因此,在尝试对“意外”做数学定义时,我们希望它具备:
初看要求颇多,可能以为数学定义会很复杂。其实不然!
上述要求都可以通过对对数函数的处理来满足。单独的对数函数(很多时候 log(x) 与 ln(x) 可互换使用)具有如下形状:
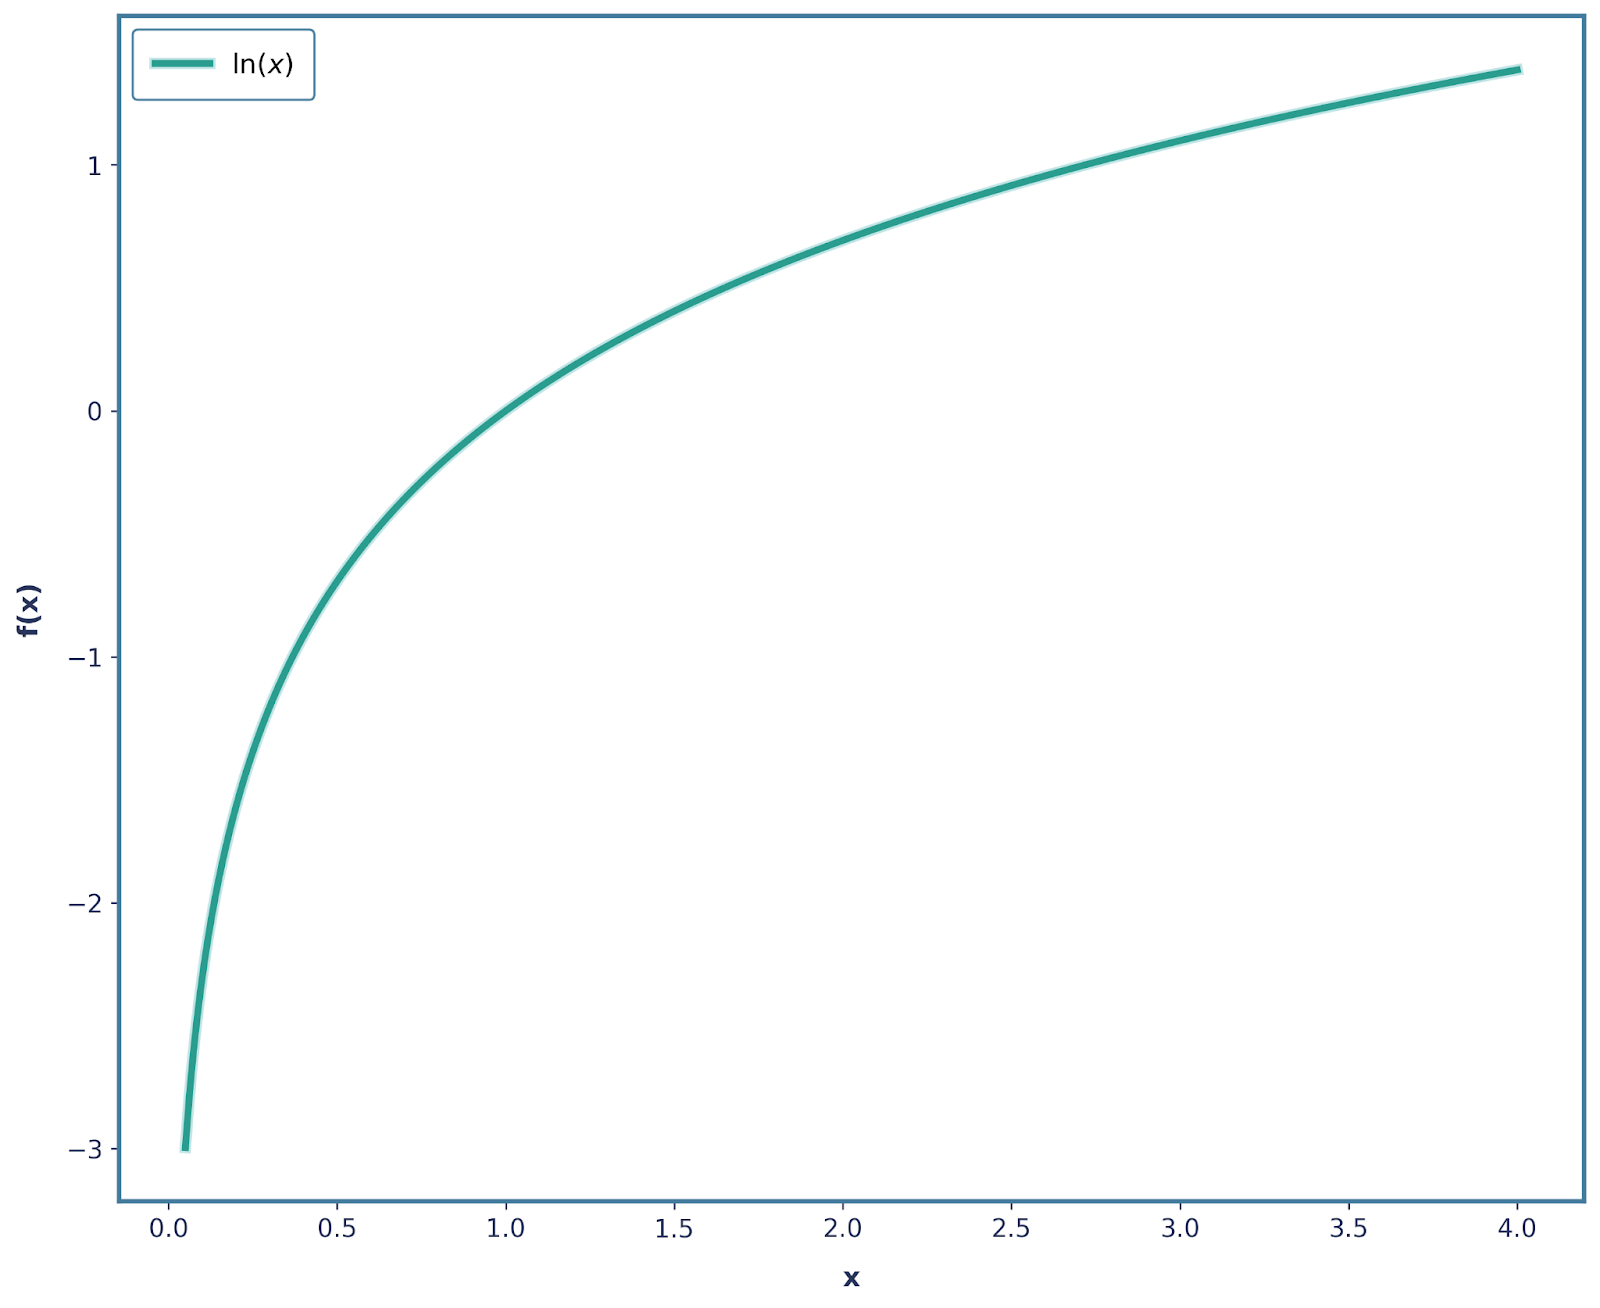
我们已经满足了不少要求。先聚焦可加性。还记得我们说过:如果两个独立事件发生,它们的总“意外”应是各自“意外”之和吗?这正是对数函数的特性!
具体如下:
在公平骰子上掷出 6 的概率为 1/6,我们将该事件的“意外”定义为:
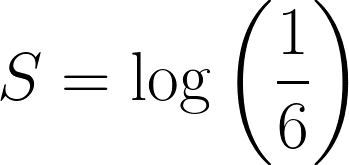
现在,考虑连续三次掷出 6 的事件,联合概率为:1/6 × 1/6 × 1/6 = 1/216。
对应的“意外”为:
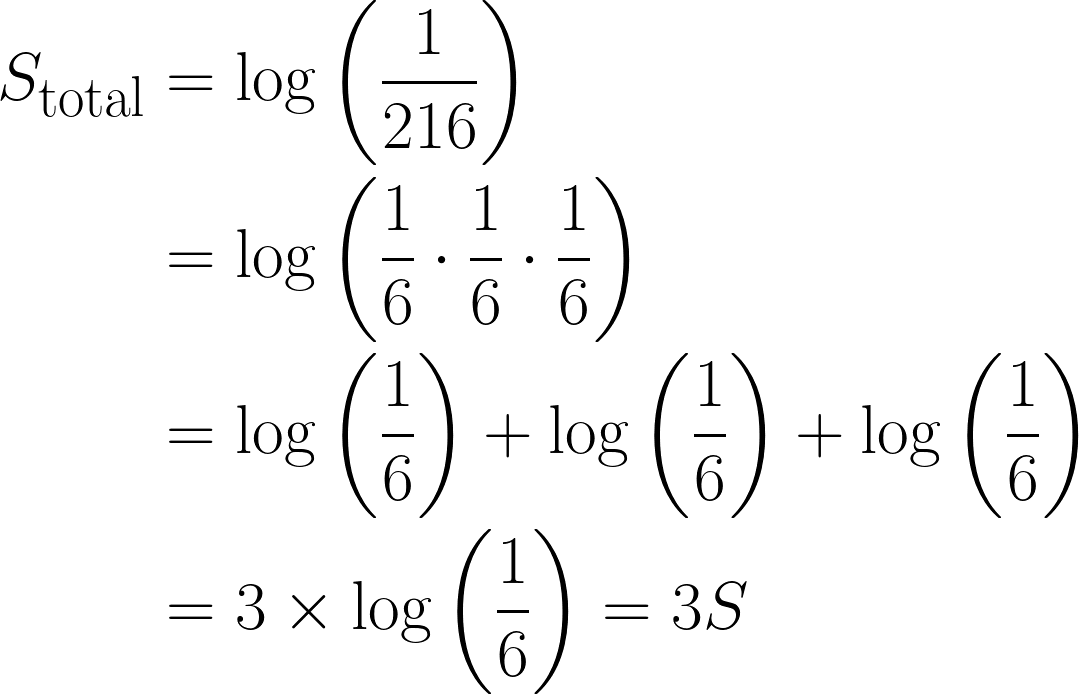
这是个重要观察:总“意外”因对数的作用增加了 3 倍。此外,这也满足性质 3,因为 log(1) = 0,表示完全确定的事件没有意外。
另外,性质 4 也满足,因为 log(x) 是连续单调函数!然而,性质 2 不满足,因为当概率降低时,我们的“意外”反而降低(变得更负)。
这个问题很好解决,加一个负号即可!于是函数变为 -log(x),其形状如下。
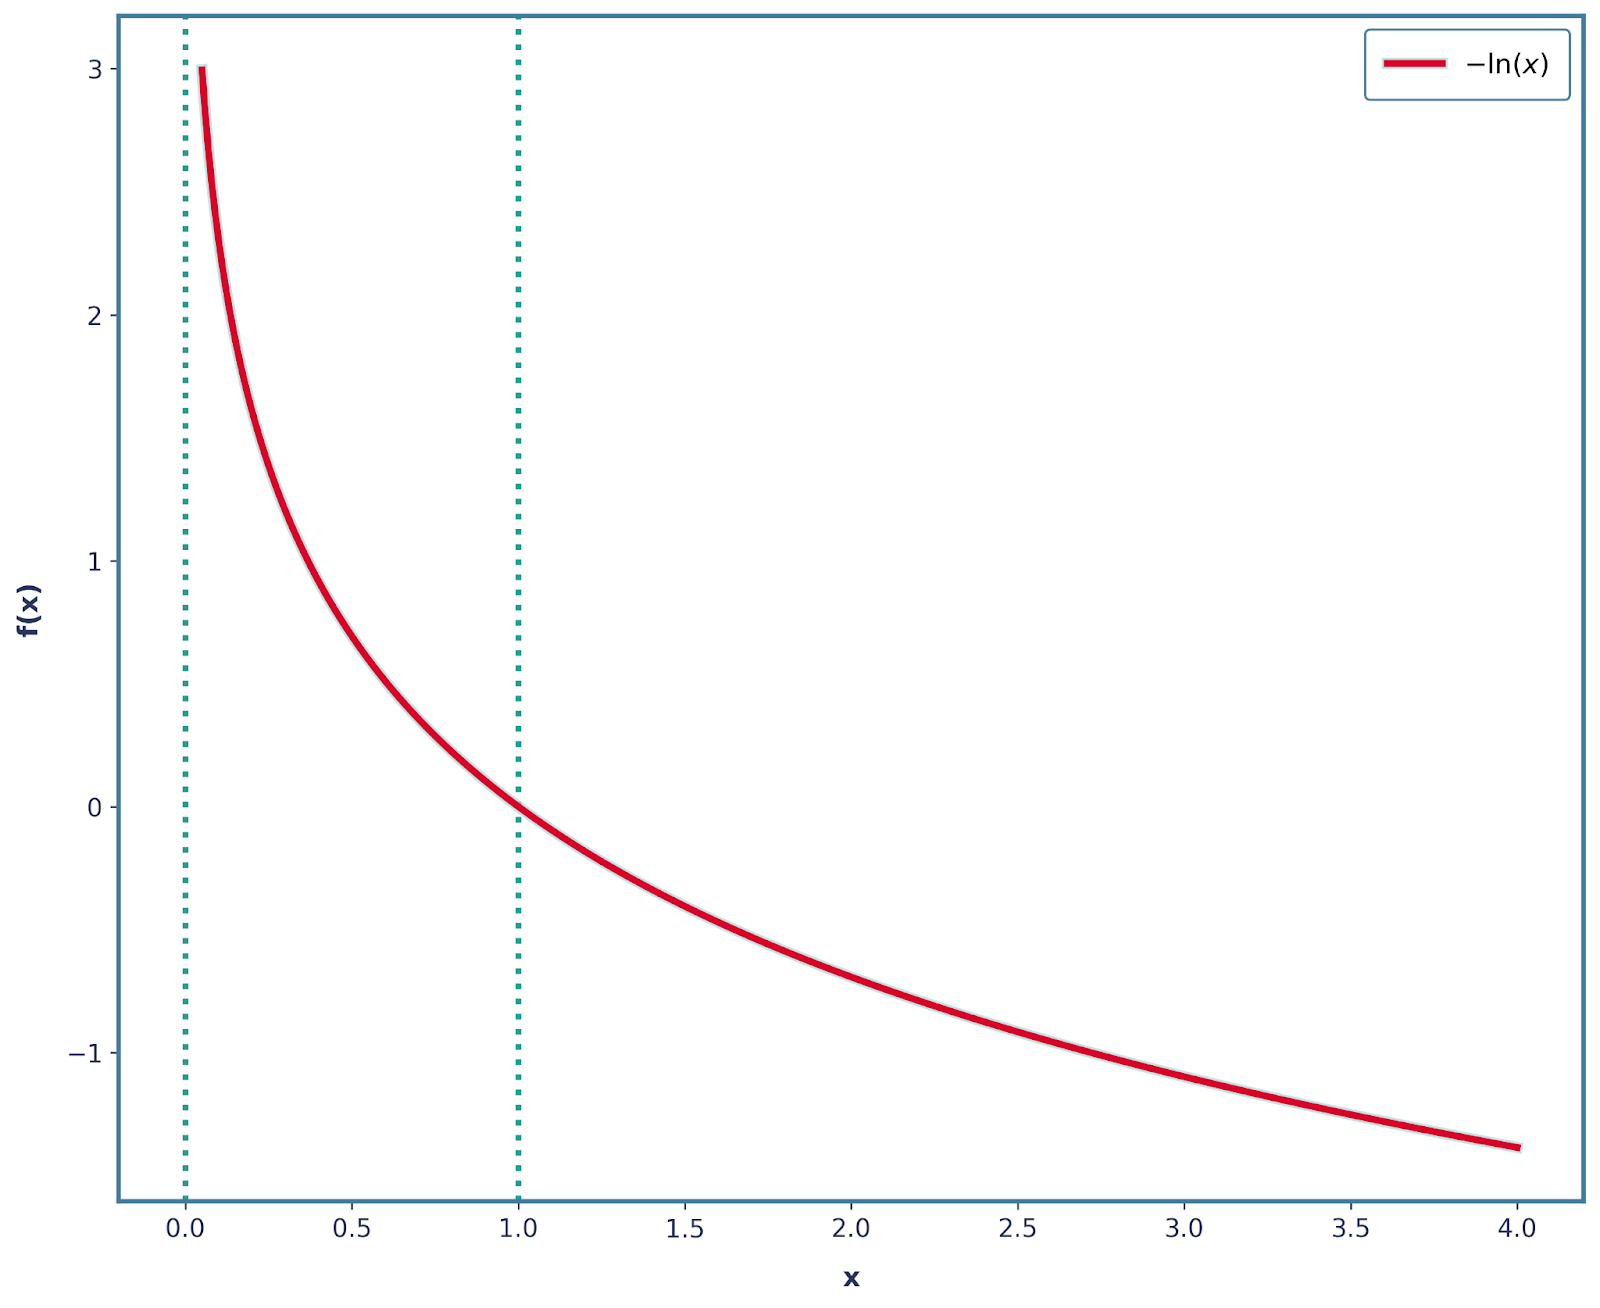
同样重要的是,其它三个性质在此更改后依然成立。因此,我们可以将“意外”数学定义为:

在机器学习中,我们关注的并非单个事件的“意外”,而是所有可能事件的平均“意外”。这就是期望“意外”。更具体地说,我们希望求的是分布的期望“意外”。
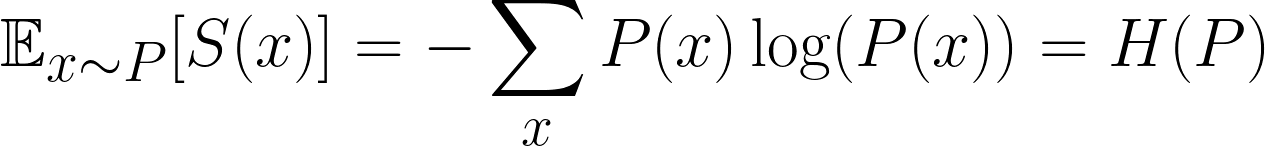
这是个著名公式,即期望“意外”,更常见的名称是“熵”。不过稍显混淆的是,我们常用 P 和 Q 表示分布,所以别把表示“概率”的 p 弄混了!
直观地说,我们所做的就是将每个结果的概率乘以其对应“意外”,然后对所有可能结果求和。
从此处开始,我们约定P(x)为真实的底层分布,而Q(x)是我们用来近似P(x)的分布(即Q(x)是“错误”的分布)。这在机器学习中非常常见——我们的模型不断尝试去估计真实世界。
现在来到关键问题:
如果我们用错误的分布来计算“意外”,会发生什么?
我们仍然可以计算“意外”,但不再用P(x),而是相对于Q(x)来衡量。这带来一个新的期望:
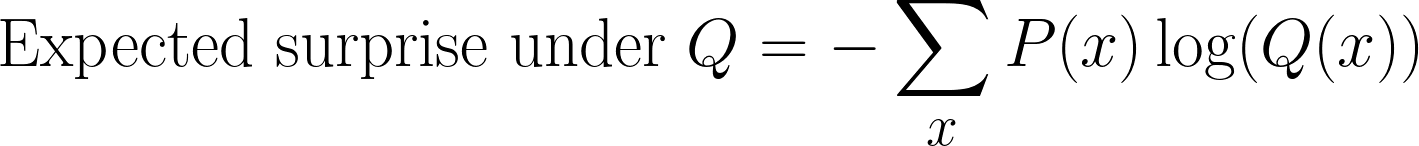
这是推导 KL 散度时常见的困惑点。我们仍然按照P(x)抽样(因为它是真实分布),但我们在用 Q(x)(我们的模型信念)来衡量“意外”。
这个量有时被称为P(x)与Q(x)之间的交叉熵。
截至目前,我们定义了两个量:
要得到 KL 散度公式,我们只需将两者相减,得到:
没错,您可能会问:为什么?
让我们回到“意外”的直觉。
因此,当我们通过相减来计算 KL 散度时,实际上是在询问:因为我们用了错误的分布Q(x)而不是真实分布P(x),我们要支付多少额外“意外”的代价。这是因错误信念而受到的惩罚。
还要注意一个重要点:如果Q(x)与P(x)相同,则 KL 散度等于 0。这很合理——如果模型预测与真实分布完全一致,就没有额外“意外”,因此也没有惩罚。
这与交叉熵不同:即使P(x)等于Q(x),交叉熵也不会变为零,而是等于P(x)的熵。
因此我们可以将KL 散度视为“锚定”在零处,只有当预测分布开始偏离真实分布时它才会增加。
很好,我们已经推导出了公式!为巩固概念,让我们做一个示例来加深理解。
假设我们要预测某位用户最喜欢的电影类型。根据历史数据,我们得到了四种电影类型上的真实分布(即这是我们的P(x))。
|
电影类型 |
概率 |
|
动作 |
0.4 |
|
喜剧 |
0.3 |
|
剧情 |
0.2 |
|
恐怖 |
0.1 |
现在我们一起训练了一个模型,预测如下(即这是我们的Q(x))。
|
电影类型 |
概率 |
|
动作 |
0.3 |
|
喜剧 |
0.4 |
|
剧情 |
0.2 |
|
恐怖 |
0.1 |
显然两个分布存在差异,但差多少?这正是我们要用 KL 散度来衡量的,公式如下:
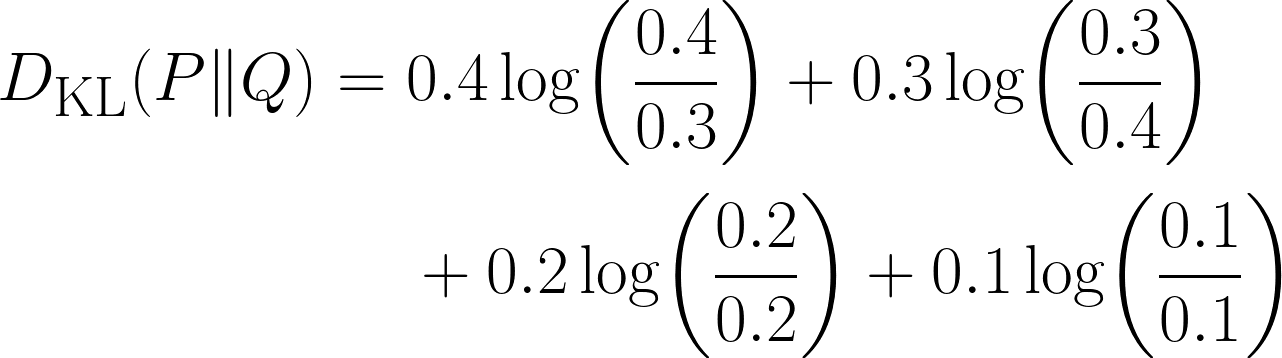
注意当两者在某个结果上的概率相同,该项就为 0。
我们也可以用 Python 解决上述问题:
import numpy as np
from scipy.stats import entropy      # Important module from scipy

P = np.array([0.4, 0.3, 0.2, 0.1])   # This is our true distribution
Q = np.array([0.3, 0.4, 0.2, 0.1])   # This is our model’s prediction

kl_nats = entropy(P, Q)              # natural log ⇒ nats
kl_bits = entropy(P, Q, base=2)      # log₂ ⇒ bits

print(f"KL(P‖Q) = {kl_nats} nats")
print(f"KL(P‖Q) = {kl_bits} bits")
这段代码相当简单直观,除了我们在代码里并没有直接使用“KL 散度”这个词!相反,我多次使用了entropy(熵)。
这引出一个重要点——KL 散度常被称为相对熵。因此我们实际上计算的是 KL 散度,因为entropy 模块计算的是两个分布之间的相对熵。
这可能让人困惑,所以我想稍作停顿,总结一下:
|
术语 |
记号 |
公式 |
|
熵(或香农熵) |
H(P) |
−∑Pi logPi |
|
交叉熵 |
H(P,Q) |
−∑Pi logQi |
|
KL 散度(或相对熵) |
D_KL (P∥Q) |
−∑Pᵢ · log(Qᵢ/Pᵢ) 或 ∑Pi* log(Pi/Qi) |
在用 KL 散度公式完成第一个示例后,我们来看看它一些最重要的性质。
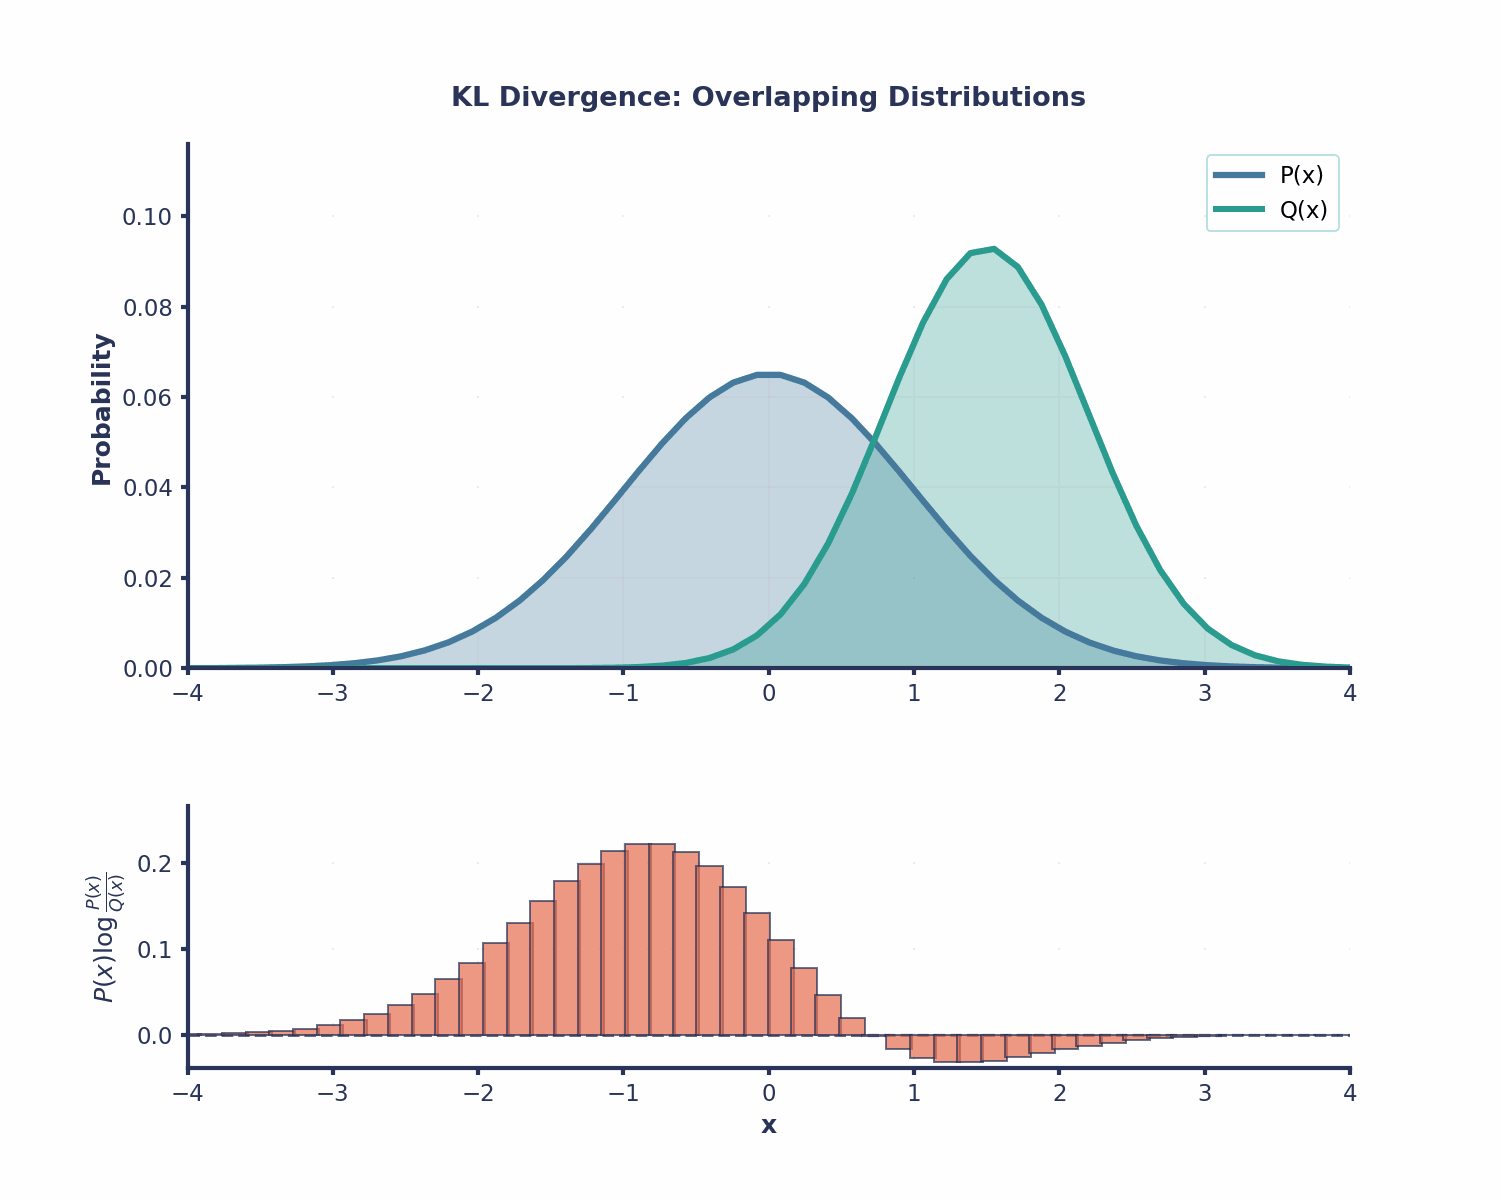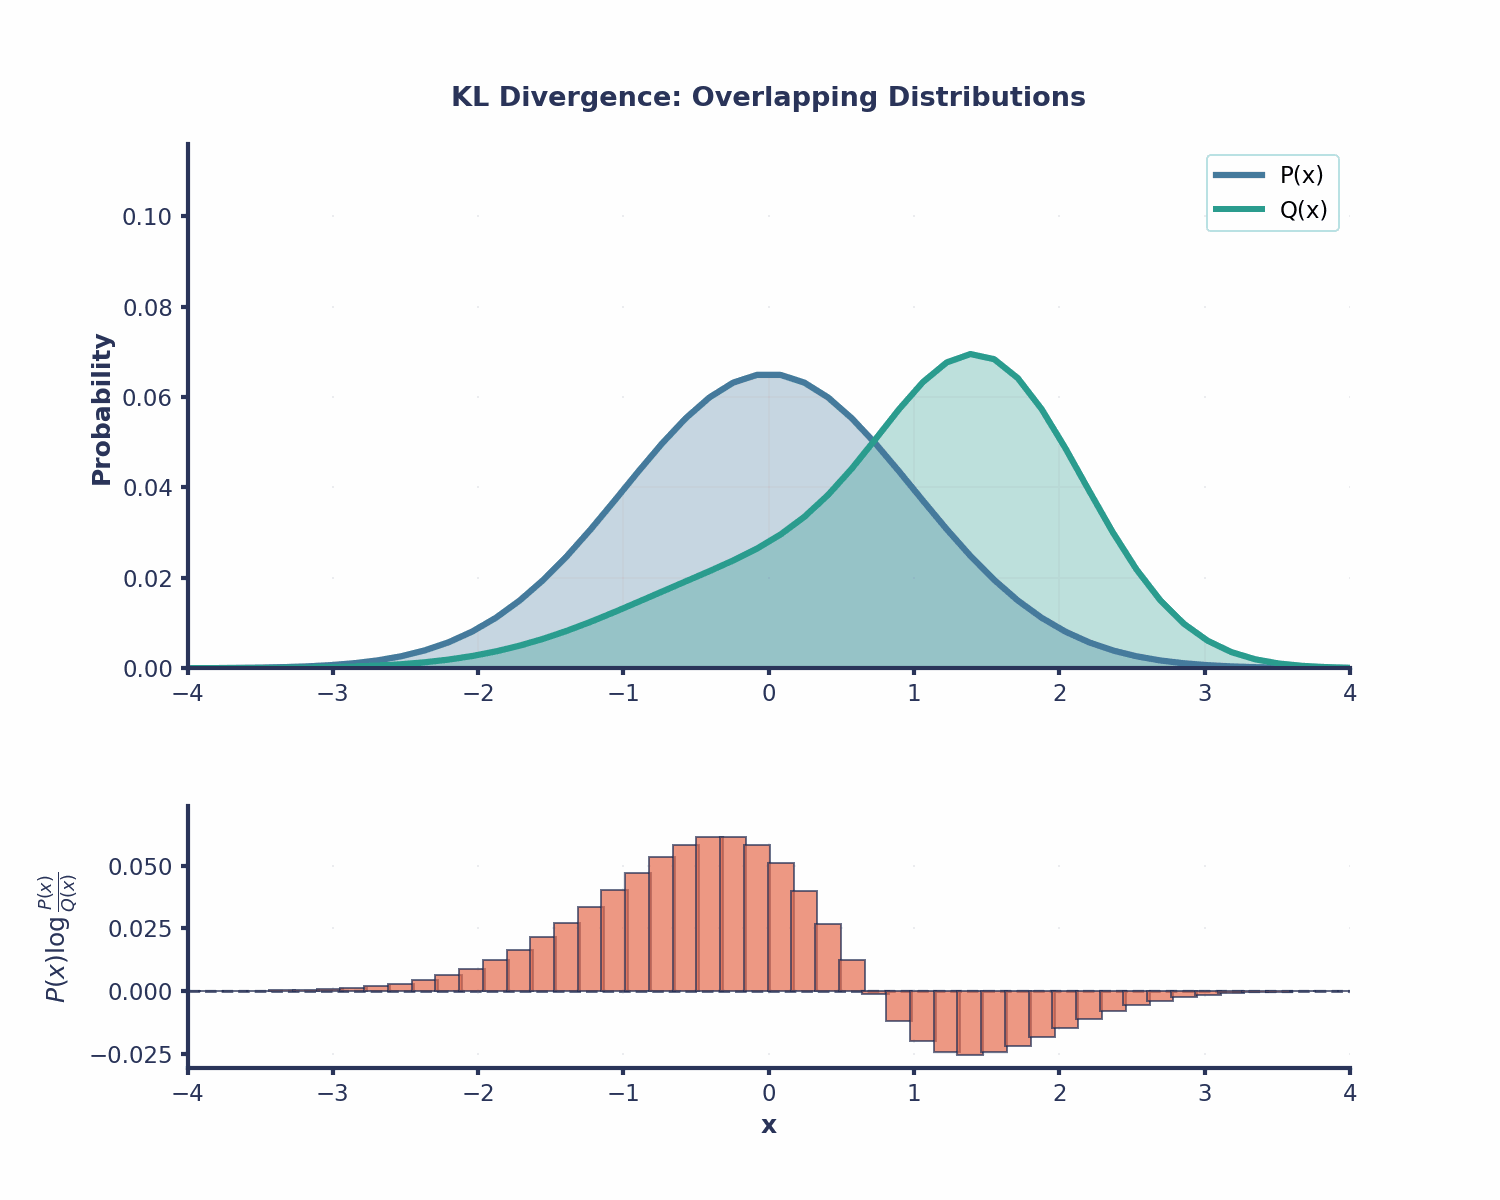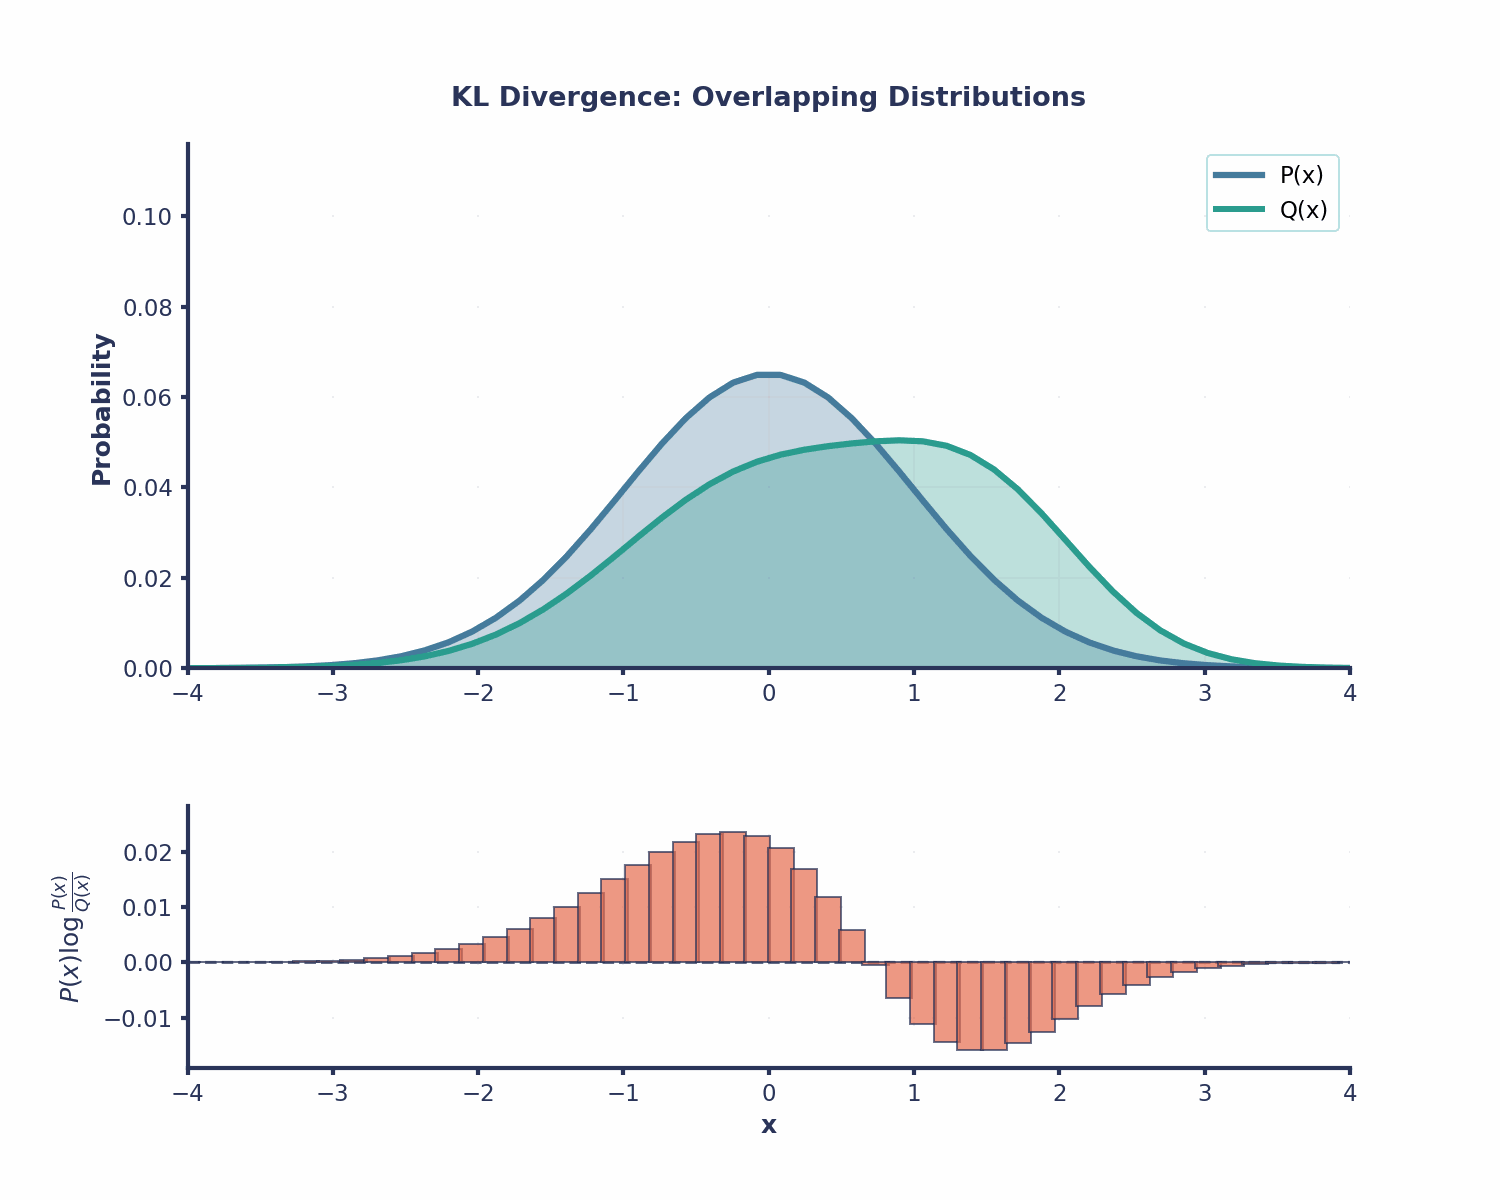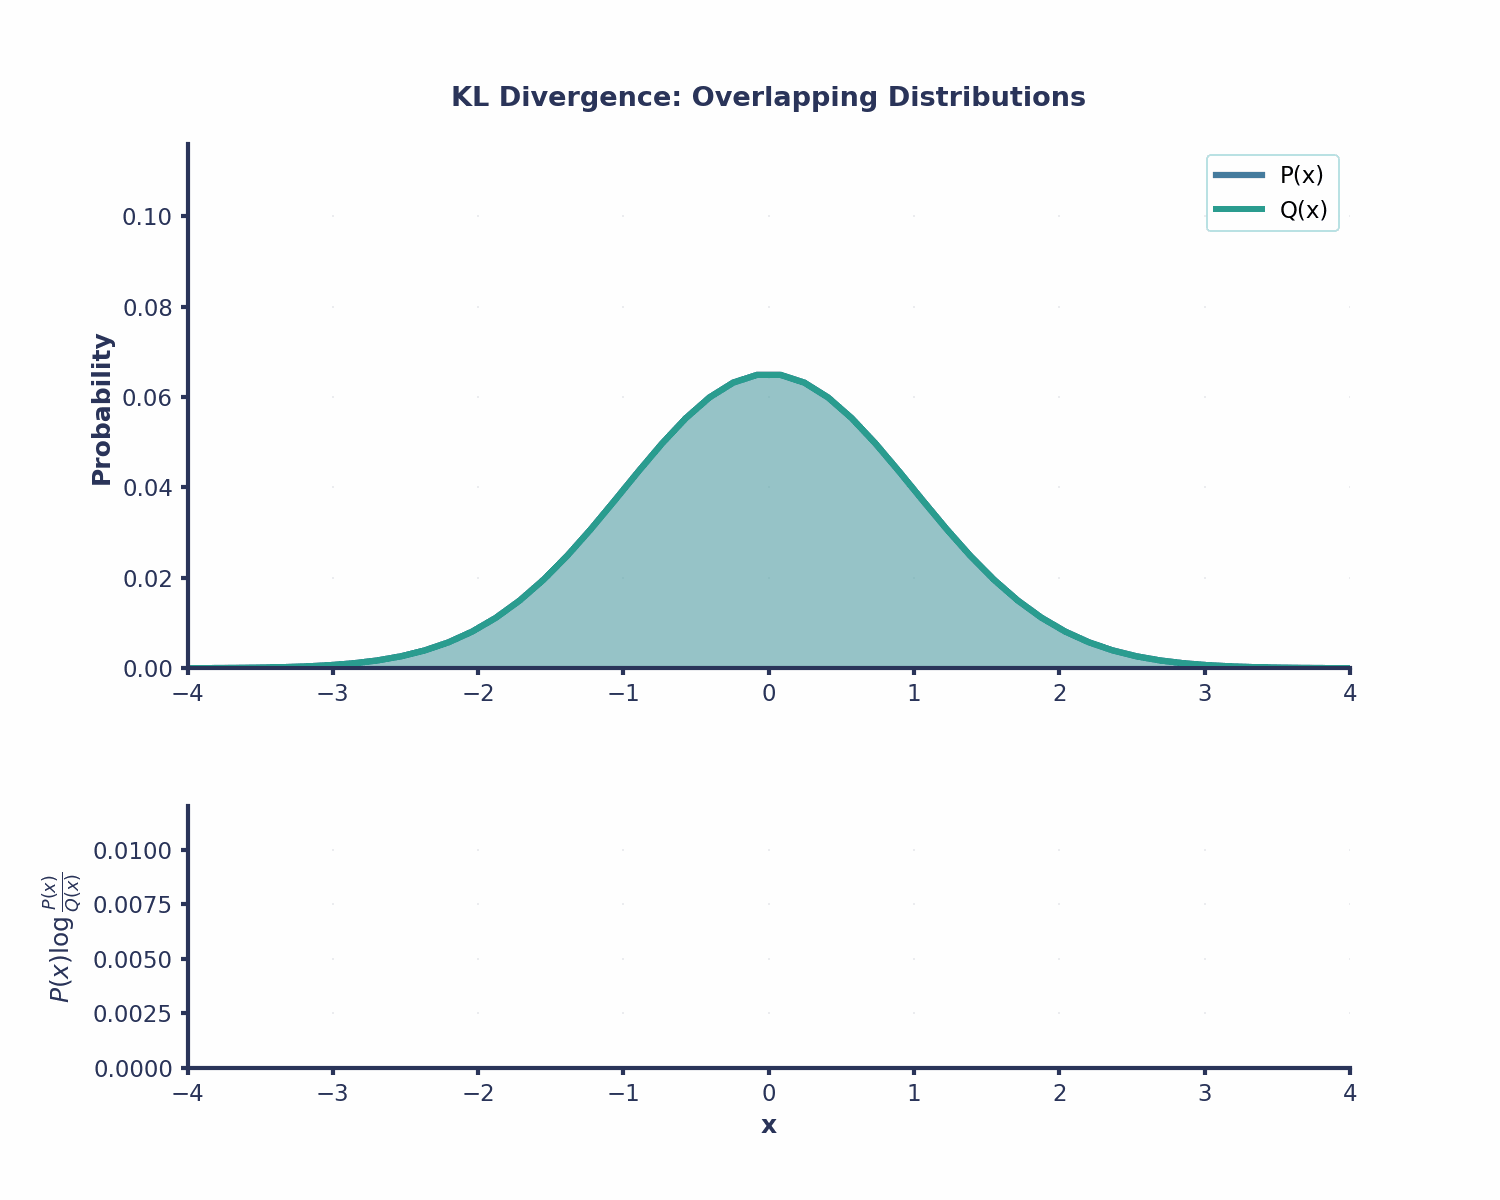
KL 散度在机器学习的许多领域都很有用:
KL 散度与极大似然估计(MLE)密切相关,后者是估计模型参数的基础方法。要了解更多关于 MLE 以及它如何补充本文概念的内容,请查看我的详细教程:极大似然估计(MLE)入门。
和所有方法一样,KL 散度也有局限。我们来具体看看:
您可能注意到我之前提到了 Jensen–Shannon 散度,下面我们简要介绍一下。

尽管它比 KL 散度稍复杂、计算量更大,但 Jensen–Shannon 散度是对称的。它仍不是严格意义上的距离度量,因为不满足三角不等式。不过,如果对 JS 散度开平方,则满足三角不等式,成为一个真正的度量。
它也是 KL 散度的平滑版本,始终介于 0 和 1 bit(当使用以 2 为底的对数时)之间。再看公式,每个 KL 项都是相对于共享的中点 M 来衡量的,既不是 P 也不是 Q,因此不会出现除以零,也就不会有无穷大。
简而言之,KL 散度是一个重要工具,用于衡量当我们让模型分布 Q 代替真实分布 P 时所付出的额外信息成本。若二者相同,则为 0;不同时变大,且始终非负。KL 散度连接了熵与交叉熵,并广泛出现于损失函数、变分推断与策略约束中。
当然,KL 散度虽好,它终究是我们在处理机器学习与深度学习问题时使用的工具。若要进一步应用,欢迎查看我们的Python 机器学习科学家职业路径以及机器学习工程师职业路径,两者都涵盖监督学习、无监督学习和深度学习。
如果您准备将 KL 散度与更多数学概念关联起来,推荐以下资源:
热门 DataCamp 课程
学习路径
学习路径
学习路径