
लर्निंग पाथ
मशीन लर्निंग फंडामेंटल्स में Python
16 घंटा
मशीन लर्निंग में यह मापना बेहद अहम है कि हमारे मॉडल वास्तविक दुनिया के नतीजों की कितनी सटीक भविष्यवाणी करते हैं। चाहे आप मौसम अनुमान मॉडल बना रहे हों या किसी सिफारिश प्रणाली को बेहतर कर रहे हों, आपको यह मापने का तरीका चाहिए कि आपकी भविष्यवाणियाँ वास्तविकता से कितनी मेल खाती हैं। इसे हासिल करने का एक प्रभावी तरीका है KL-Divergence.
इस लेख में, मैं बताऊंगा कि KL-Divergence क्या है, यह क्यों महत्वपूर्ण है, इसकी सहज व्याख्या, गणितीय नींव, और इसके उपयोग को दर्शाने वाले व्यावहारिक उदाहरण।
यदि आप मशीन लर्निंग की अवधारणाओं को एक्सप्लोर कर रहे हैं, तो मैं Machine Learning Fundamentals in Python स्किल ट्रैक देखने की सिफारिश करूंगा।
KL-Divergence (Kullback-Leibler Divergence) एक सांख्यिकीय माप है जिसका उपयोग यह निर्धारित करने के लिए किया जाता है कि एक प्रायिकता वितरण किसी दूसरे संदर्भ वितरण से कितना अलग है।
मान लीजिए हम साथ मिलकर कल के मौसम की भविष्यवाणी करने के लिए एक मॉडल बना रहे हैं। परदे के पीछे, हमारा मॉडल दांव लगा रहा होता है—संभावित नतीजों को प्रायिकताएँ सौंप रहा होता है। लेकिन एक महत्वपूर्ण सवाल यह है:
आप यह कैसे मापेंगे कि ये दांव वास्तविकता से कितने दूर हैं?
हमें इस अंतर को मात्रात्मक रूप से मापने का तरीका चाहिए, और यहीं KL-Divergence काम आता है। यह एक गणितीय उपकरण है जो यह मापता है कि हमारा मॉडल क्या मानता है और वास्तविकता क्या है, इनके बीच कितना अंतर है।
जैसा कि मैंने पहले कहा, KL-Divergence (औपचारिक रूप से Kullback-Leibler Divergence) आधुनिक डेटा साइंस, मशीन लर्निंग, और AI की रीढ़ है। यह हमें बिट्स या नैट्स में (इसके बारे में आगे) बताता है कि जब हम एक प्रायिकता वितरण (जैसे हमारे मॉडल की भविष्यवाणियाँ, Q) का उपयोग किसी दूसरे (वास्तविक सत्य, P) के सन्निकटन के रूप में करते हैं, तो हमें कितनी “अतिरिक्त हैरानी” या “सूचना-हानि” भुगतनी पड़ती है।
यह मॉडल मूल्यांकन, न्यूरल नेटवर्क्स में रेग्युलराइज़ेशन, बेयesian अपडेट्स, और यहाँ तक कि डेटा संपीड़न या संदेशों के कुशल संप्रेषण के पीछे निर्णायक की तरह काम करता है।
KL-Divergence के महत्व को समझने के लिए इसे यूँ सोचें: हर बार जब हमारा मॉडल भविष्यवाणी करता है, वह असल में भविष्य पर दांव लगा रहा होता है। KL-Divergence वह स्कोरकार्ड है जो इन दांवों की कीमत गिनता है। यही सिद्धांत मशीन लर्निंग के कई विषयों में लागू होता है—चाहे हम चैटबॉट प्रशिक्षित कर रहे हों, बीमारी का निदान कर रहे हों, या किसी विज्ञापन अभियान का अनुकूलन कर रहे हों।
गणितीय रूप से, KL-Divergence इस प्रकार परिभाषित है:
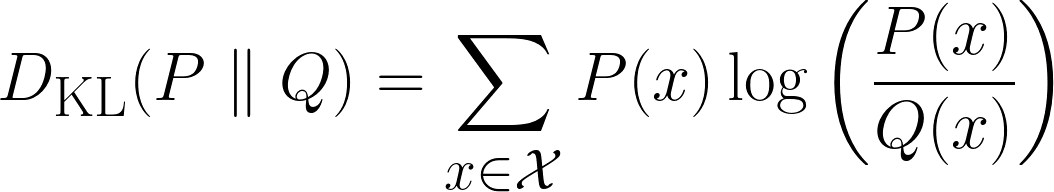
ऊपर वाला सूत्र विविक्त (discrete) मामलों के लिए है, और नीचे वाला सूत्र सतत (continuous) मामलों के लिए।
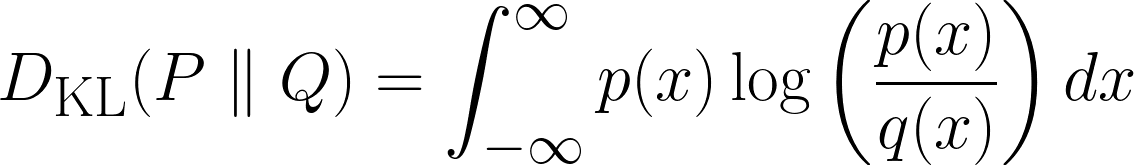
इस खंड में, हम KL-Divergence को सहज ढंग से व्युत्पन्न करेंगे। आइए कुछ सवालों से शुरुआत करते हैं।
“यदि आप सिक्का उछालें और मैं नतीजा बिल्कुल सही बता दूँ, तो क्या आप हैरान होंगे?” मेरा मानना है आप थोड़े तो हैरान होंगे, पर बिल्कुल चकित नहीं। अब दूसरा परिदृश्य देखें।
“यदि आप पासा फेंकें और मैं नतीजा बिल्कुल सही बता दूँ, तो क्या आप पिछले परिदृश्य से ज्यादा हैरान होंगे?” संभव है आप हाँ कहेंगे, क्योंकि मेरे लिए सही अंदाज़ा लगाना कम संभावित है।
अब आखिरी परिदृश्य:
“यदि मैं लॉटरी के विजेता नंबर सही-सही बता दूँ, तो क्या आप अब पिछले परिदृश्य से भी ज्यादा हैरान होंगे?” मेरा मानना है आप हाँ कहेंगे और पूरी तरह दंग रह जाएंगे। लेकिन क्यों?
क्योंकि जैसे-जैसे हम परिदृश्यों में आगे बढ़े, मेरे सही अनुमान की प्रायिकता घटती गई, और इसीलिए आपकी हैरानी बढ़ती गई। यानी हमने एक संबंध देखा:
किसी घटना की प्रायिकता और हैरानी का उलटा संबंध होता है।
साफ़ शब्दों में, जैसे-जैसे किसी घटना की प्रायिकता घटती है, हैरानी बढ़ती है, और इसके विपरीत।
यहाँ एक और दिलचस्प अवलोकन कर सकते हैं। पासे पर लौटें, और कल्पना करें कि आप वही पासा 3 बार फेंकते हैं, और मैं हर बार सही बता दूँ, तो आप एक बार सही बताने की तुलना में कितने ज्यादा हैरान होंगे?
आपकी हैरानी बस थोड़ी नहीं बढ़ेगी; यह नाटकीय रूप से बढ़ेगी, आदर्शतः तीन गुना। क्यों? क्योंकि हर नया सही अनुमान आपके अविश्वास को और मजबूत करता है। यह सिर्फ़ एक तय मात्रा नहीं जोड़ता—यह स्थिति की अविश्वसनीयता को गुणा कर देता है।
इसलिए, हैरानी को गणितीय रूप से परिभाषित करते समय, हम चाहते हैं कि उसमें ये गुण हों:
पहली नज़र में, इतने सारे मानदंड देखकर लगता है कि गणितीय परिभाषा जटिल होगी। लेकिन ऐसा नहीं है!
उपरोक्त सभी आवश्यकताओं को लॉगरिथ्म फ़ंक्शन का उपयोग कर पूरा किया जा सकता है। अकेला log फ़ंक्शन (अक्सर log(x) और ln(x) एक-दूसरे के स्थान पर लिखे जाते हैं) का आकार इस प्रकार होता है:
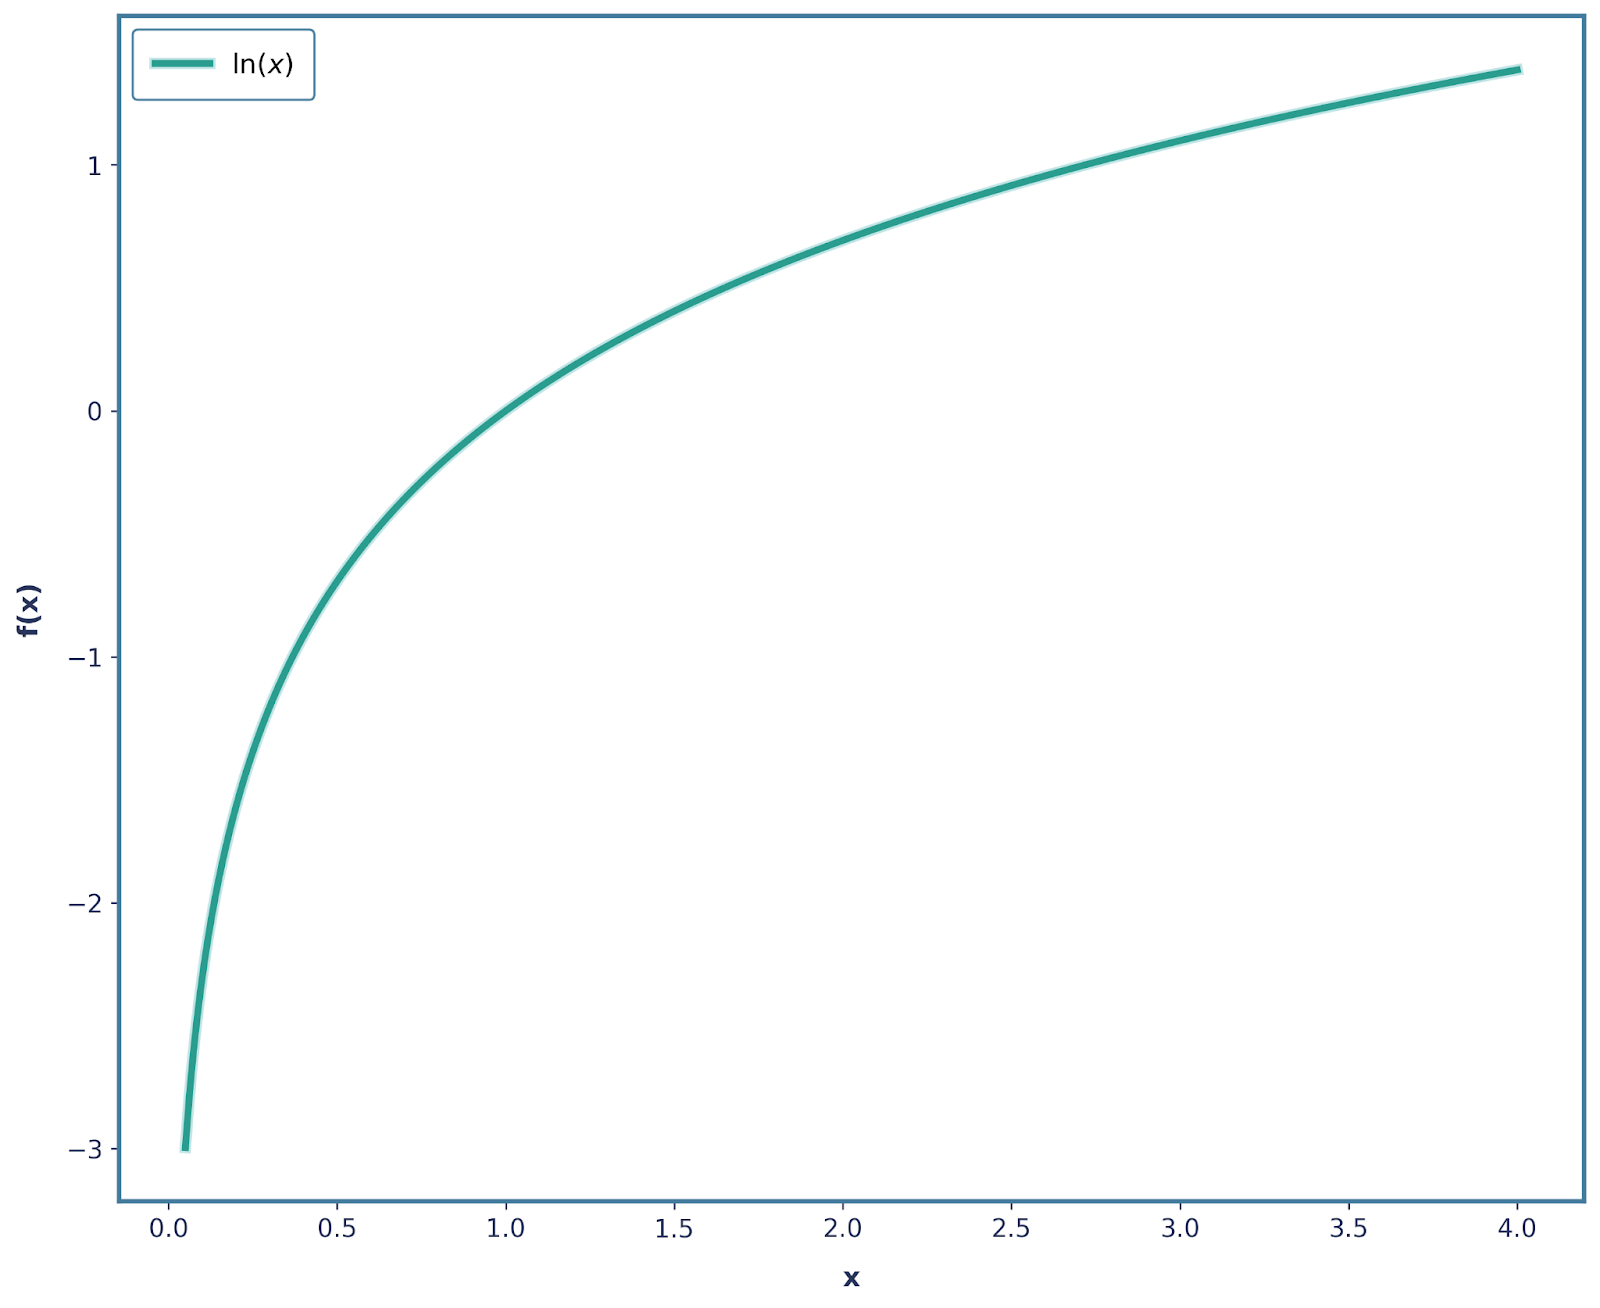
हम पहले ही अपने कई मानदंड पूरे कर चुके हैं। पहले योज्य गुण पर ध्यान दें। याद है हमने कहा था कि यदि दो स्वतंत्र घटनाएँ हों, तो उनकी कुल हैरानी व्यक्तिगत हैरानियों के योग के बराबर होनी चाहिए? यही तो log फ़ंक्शन करता है!
ऐसे समझें:
संतुलित पासे पर 6 आने की प्रायिकता ⅙ है, और हम घटना की हैरानी इस प्रकार परिभाषित करते हैं:
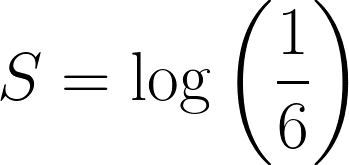
अब 6 का तीन बार लगातार आना लें, तो संयुक्त प्रायिकता होगी: ⅙ * ⅙ * ⅙ = 1/216.
हैरानी के हिसाब से यह होगा:
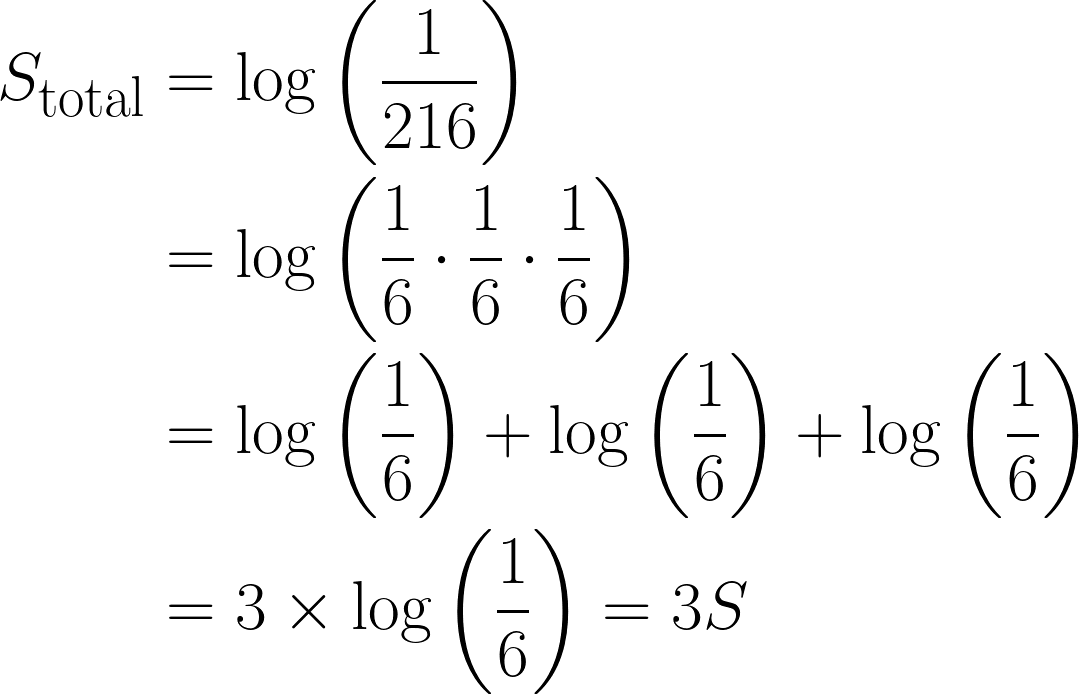
यह एक महत्वपूर्ण अवलोकन है, क्योंकि लॉगरिथ्म के कारण कुल हैरानी 3 गुना बढ़ गई। साथ ही, यह गुण 3 भी संतुष्ट करता है, जहाँ log(1) = 0 है, क्योंकि निश्चित घटना में हैरानी नहीं होती।
इसके अलावा, गुण 4 भी संतुष्ट है क्योंकि log(x) सतत एकसमान (monotonic) फ़ंक्शन है! हालांकि, गुण 2 संतुष्ट नहीं है, क्योंकि प्रायिकता घटने पर हमारी हैरानी घटती दिखाई देती है (मान और अधिक ऋणात्मक होता है)।
इसे हम आसानी से एक ऋण चिह्न लगाकर सुलझा सकते हैं! अतः हमारा फ़ंक्शन अब -log(x) है, जिसका आकार नीचे जैसा है।
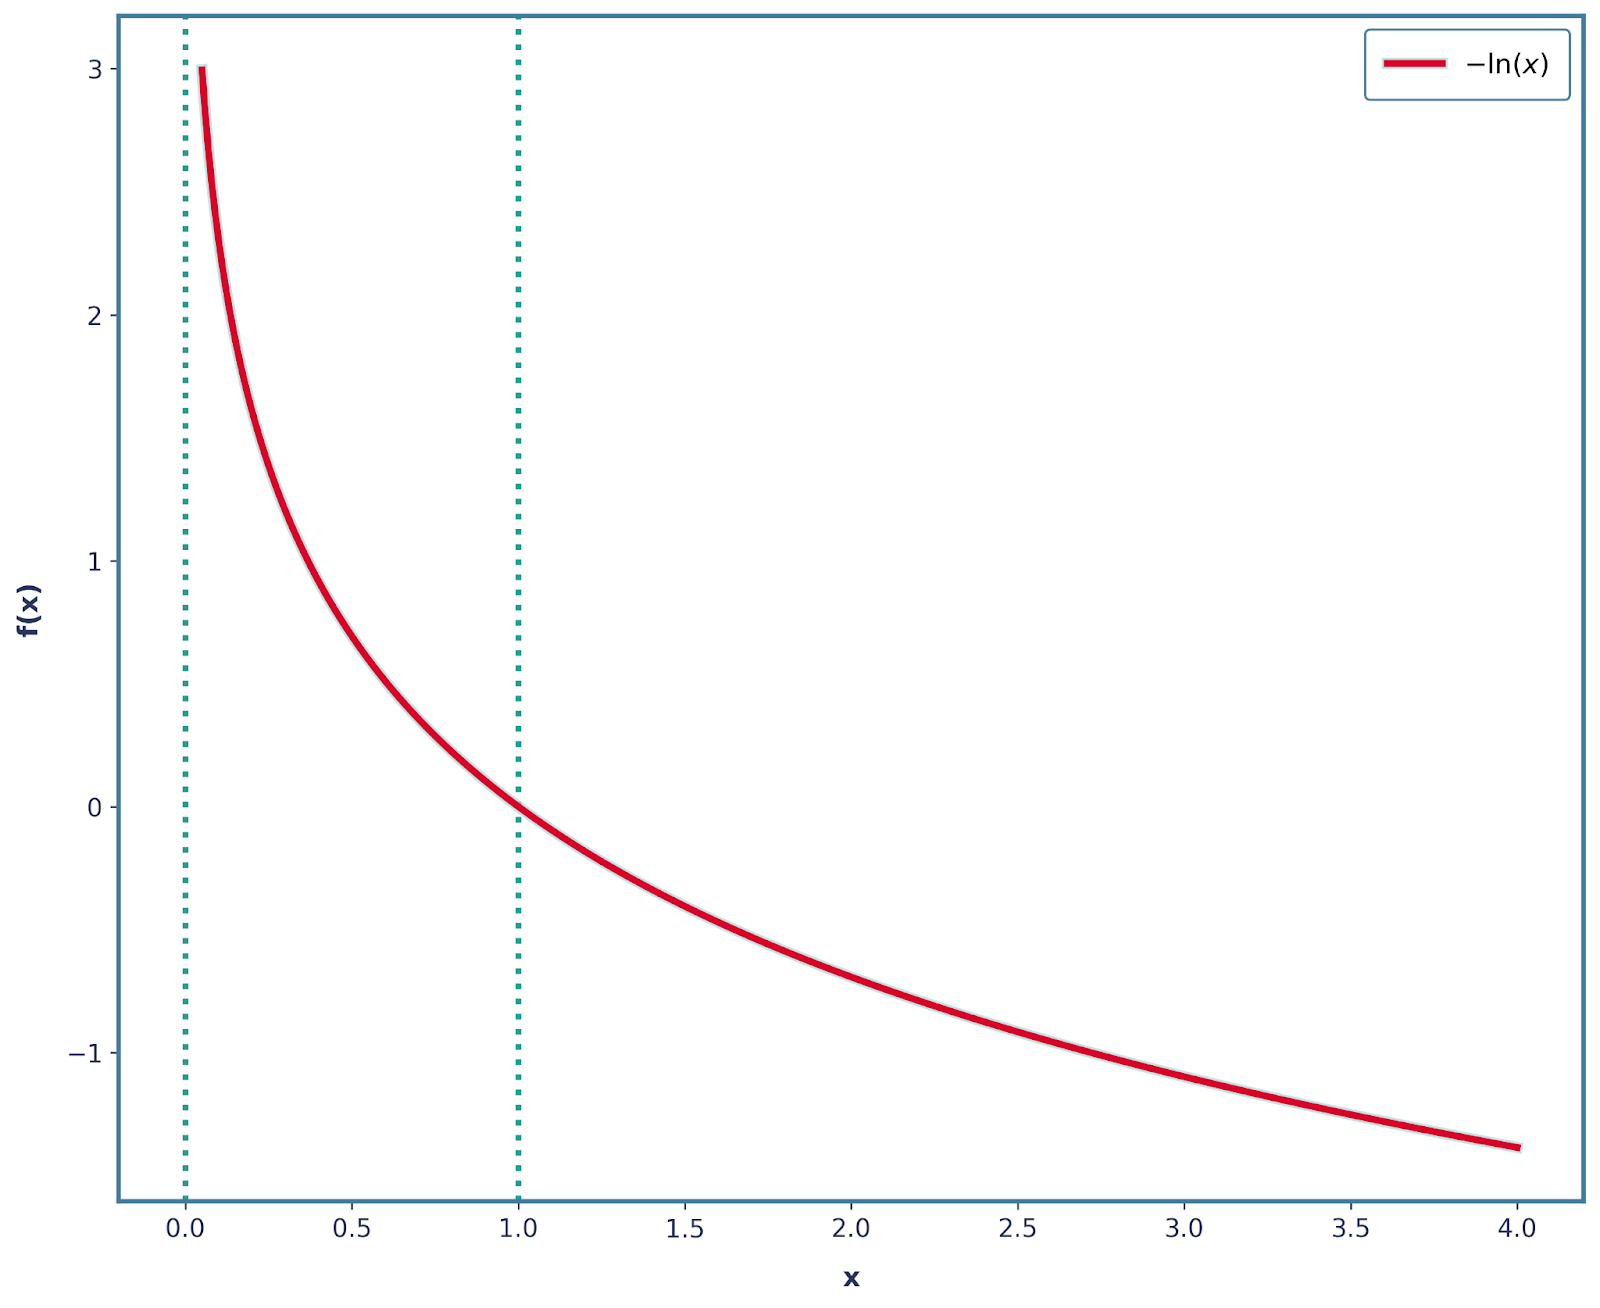
यह ध्यान देना भी महत्वपूर्ण है कि इस बदलाव के बाद भी बाकी तीनों गुण बने रहते हैं। इसलिए, हम हैरानी को गणितीय रूप से इस प्रकार परिभाषित कर सकते हैं:

मशीन लर्निंग में, हम सिर्फ़ एक घटना की हैरानी में नहीं, बल्कि सभी संभावित घटनाओं की औसत हैरानी में दिलचस्पी रखते हैं। इसे अपेक्षित हैरानी कहते हैं। और विशेष रूप से, हम वितरण की अपेक्षित हैरानी जानना चाहते हैं।
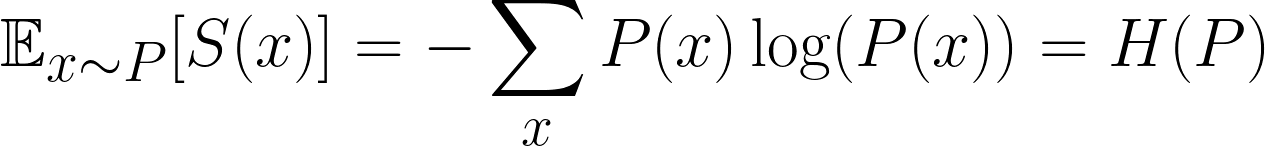
यह एक प्रसिद्ध सूत्र है, और यही अपेक्षित हैरानी है, जिसे आमतौर पर एंट्रॉपी कहते हैं। किंतु थोड़ा भ्रमित करने वाली बात यह है कि हम अक्सर अपने वितरणों को P और Q से दर्शाते हैं, तो छोटे p से भ्रमित न हों, जो प्रायिकता दर्शाता है!
सहज रूप से, हम जो कर रहे हैं वह यह कि हर संभावित नतीजे की प्रायिकता को उसकी हैरानी से गुणा कर रहे हैं, और फिर सभी नतीजों पर जोड़ रहे हैं।
अब से हम मान लेते हैं कि P(x) हमारा सही (सत्य) अंतर्निहित वितरण है और Q(x) वह वितरण है जिससे हम P(x) का सन्निकटन करने की कोशिश कर रहे हैं (अर्थात Q(X) “गलत” वितरण है)। यह मशीन लर्निंग में बहुत आम है—हमारे मॉडल लगातार वास्तविक दुनिया का अनुमान लगाने की कोशिश करते हैं।
तो अब बड़ा सवाल यह है:
यदि हम गलत वितरण का उपयोग करके अपनी हैरानी की गणना करें तो क्या होगा?
हम हैरानी फिर भी निकाल सकते हैं, लेकिन P(x) की जगह अब हम इसे Q(x) के सापेक्ष मापते हैं। इससे हमें एक नया अपेक्षित मान मिलता है:
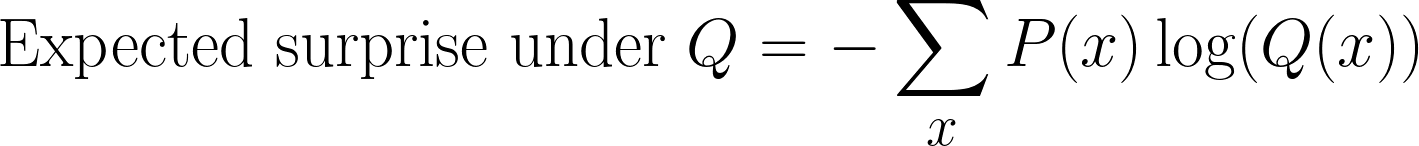
KL-Divergence निकालते समय यह कदम अक्सर भ्रमित करता है। हम अब भी P(x) के अनुसार सैंपलिंग कर रहे हैं (क्योंकि वही सही वितरण है), लेकिन हम हैरानी को Q(x) (हमारे मॉडल के विश्वास) से माप रहे हैं।
इसे कभी-कभी P(x) और Q(x) के बीच क्रॉस-एंट्रॉपी कहा जाता है।
अब तक हमने दो राशियों को परिभाषित किया है:
KL-Divergence का सूत्र पाने के लिए, हम बस इन दोनों राशियों का अंतर लेते हैं और यह प्राप्त करते हैं:
और हाँ, आपका सवाल होगा—क्यों?
आइए हैरानी की सहज समझ पर लौटें।
तो जब हम KL-Divergence की गणना इनका अंतर लेकर करते हैं, तो हम यह पूछ रहे होते हैं कि अतिरिक्त हैरानी कितनी चुकानी पड़ी क्योंकि हमने वास्तविक वितरण P(x) की जगह गलत वितरण Q(x) का उपयोग किया। यह गलत मान्यताओं के लिए दंड जैसा है।
एक और महत्वपूर्ण बात: यदि Q(x) और P(x) समान हों, तो KL-Divergence 0 होगा। यह तार्किक है—यदि हमारे मॉडल की भविष्यवाणियाँ सही वितरण से पूरी तरह मेल खाती हैं, तो कोई अतिरिक्त हैरानी नहीं होगी, और इसलिए कोई दंड नहीं।
यह क्रॉस-एंट्रॉपी से अलग है, जो P(x) = Q(x) होने पर भी शून्य नहीं होती; वह P(x) की एंट्रॉपी के बराबर होती है।
तो हम KL-Divergence को “शून्य पर एंकर” समझ सकते हैं, यानी यह तभी बढ़ना शुरू करता है जब हमारी अनुमानित वितरण वास्तविक वितरण से भटकना शुरू करता है।
सूत्र निकालने के लिए शाबाश! अब अवधारणा को पुख्ता करने के लिए एक उदाहरण देखें।
मान लें हमें किसी उपयोगकर्ता की पसंदीदा मूवी शैली का अनुमान लगाना है। पिछले डेटा से हमें चार शैलियों पर सही वितरण मिला है (यानी यह हमारा P(x) है)।
|
मूवी शैली |
प्रायिकता |
|
एक्शन |
0.4 |
|
कॉमेडी |
0.3 |
|
ड्रामा |
0.2 |
|
हॉरर |
0.1 |
अब हमने मिलकर जो मॉडल बनाया, उसने यह भविष्यवाणी की (यानी यह हमारा Q(x) है)।
|
मूवी शैली |
प्रायिकता |
|
एक्शन |
0.3 |
|
कॉमेडी |
0.4 |
|
ड्रामा |
0.2 |
|
हॉरर |
0.1 |
स्पष्ट है कि हमारे वितरण में कुछ अंतर है, पर कितना? यहीं हम KL-Divergence का उपयोग करेंगे, नीचे दिए गए सूत्र के साथ:
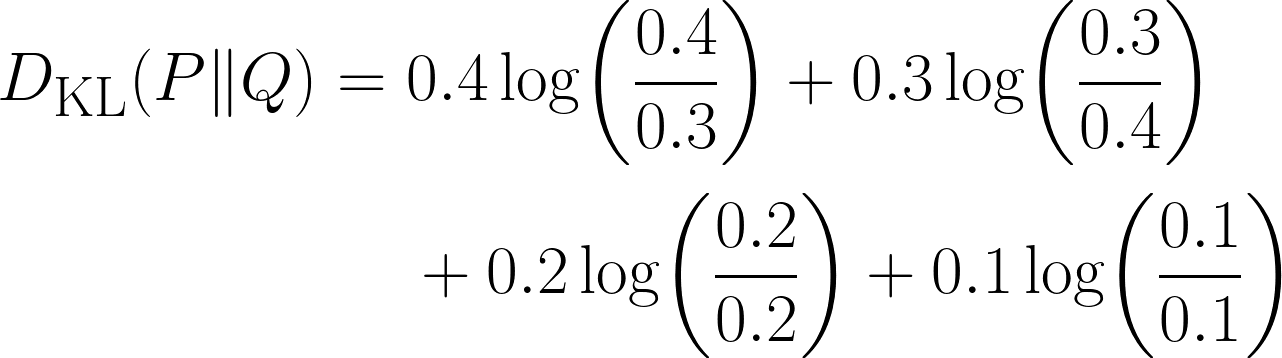
ध्यान दें कि जब किसी नतीजे पर दोनों वितरणों की प्रायिकता बराबर है, तो वह पद 0 हो जाता है।
ऊपर की समस्या को हम Python से भी हल कर सकते हैं:
import numpy as np
from scipy.stats import entropy      # Important module from scipy

P = np.array([0.4, 0.3, 0.2, 0.1])   # This is our true distribution
Q = np.array([0.3, 0.4, 0.2, 0.1])   # This is our model’s prediction

kl_nats = entropy(P, Q)              # natural log ⇒ nats
kl_bits = entropy(P, Q, base=2)      # log₂ ⇒ bits

print(f"KL(P‖Q) = {kl_nats} nats")
print(f"KL(P‖Q) = {kl_bits} bits")
यह कोड काफी सरल और सहज है, सिवाय इसके कि हमने कोड में कहीं भी KL-Divergence शब्द का उपयोग नहीं किया! इसके बजाय, मैंने कई बार entropy का उपयोग किया है।
यह हमें एक महत्वपूर्ण बिंदु पर लाता है—KL-Divergence को अक्सर Relative Entropy कहा जाता है। इसलिए, हम वास्तव में KL-Divergence ही निकाल रहे हैं क्योंकि entropy मॉड्यूल दो वितरणों के बीच सापेक्ष एंट्रॉपी की गणना करता है।
यह थोड़ा भ्रमित लग सकता है, इसलिए मैं संक्षेप में सबकुछ समेटना चाहूँगा:ing:
|
पद |
संकेतन |
सूत्र |
|
एंट्रॉपी या शैनन-एंट्रॉपी |
H(P) |
−∑Pi logPi |
|
क्रॉस-एंट्रॉपी |
H(P,Q) |
−∑Pi logQi |
|
KL-Divergence या सापेक्ष एंट्रॉपी |
D_KL (P∥Q) |
−∑Pᵢ · log(Qᵢ/Pᵢ) या ∑Pi* log(Pi/Qi) |
अब जब हमने KL-Divergence सूत्र का उपयोग करके अपना पहला उदाहरण निकाल लिया है, तो इसके कुछ महत्वपूर्ण गुणों पर नज़र डालें।
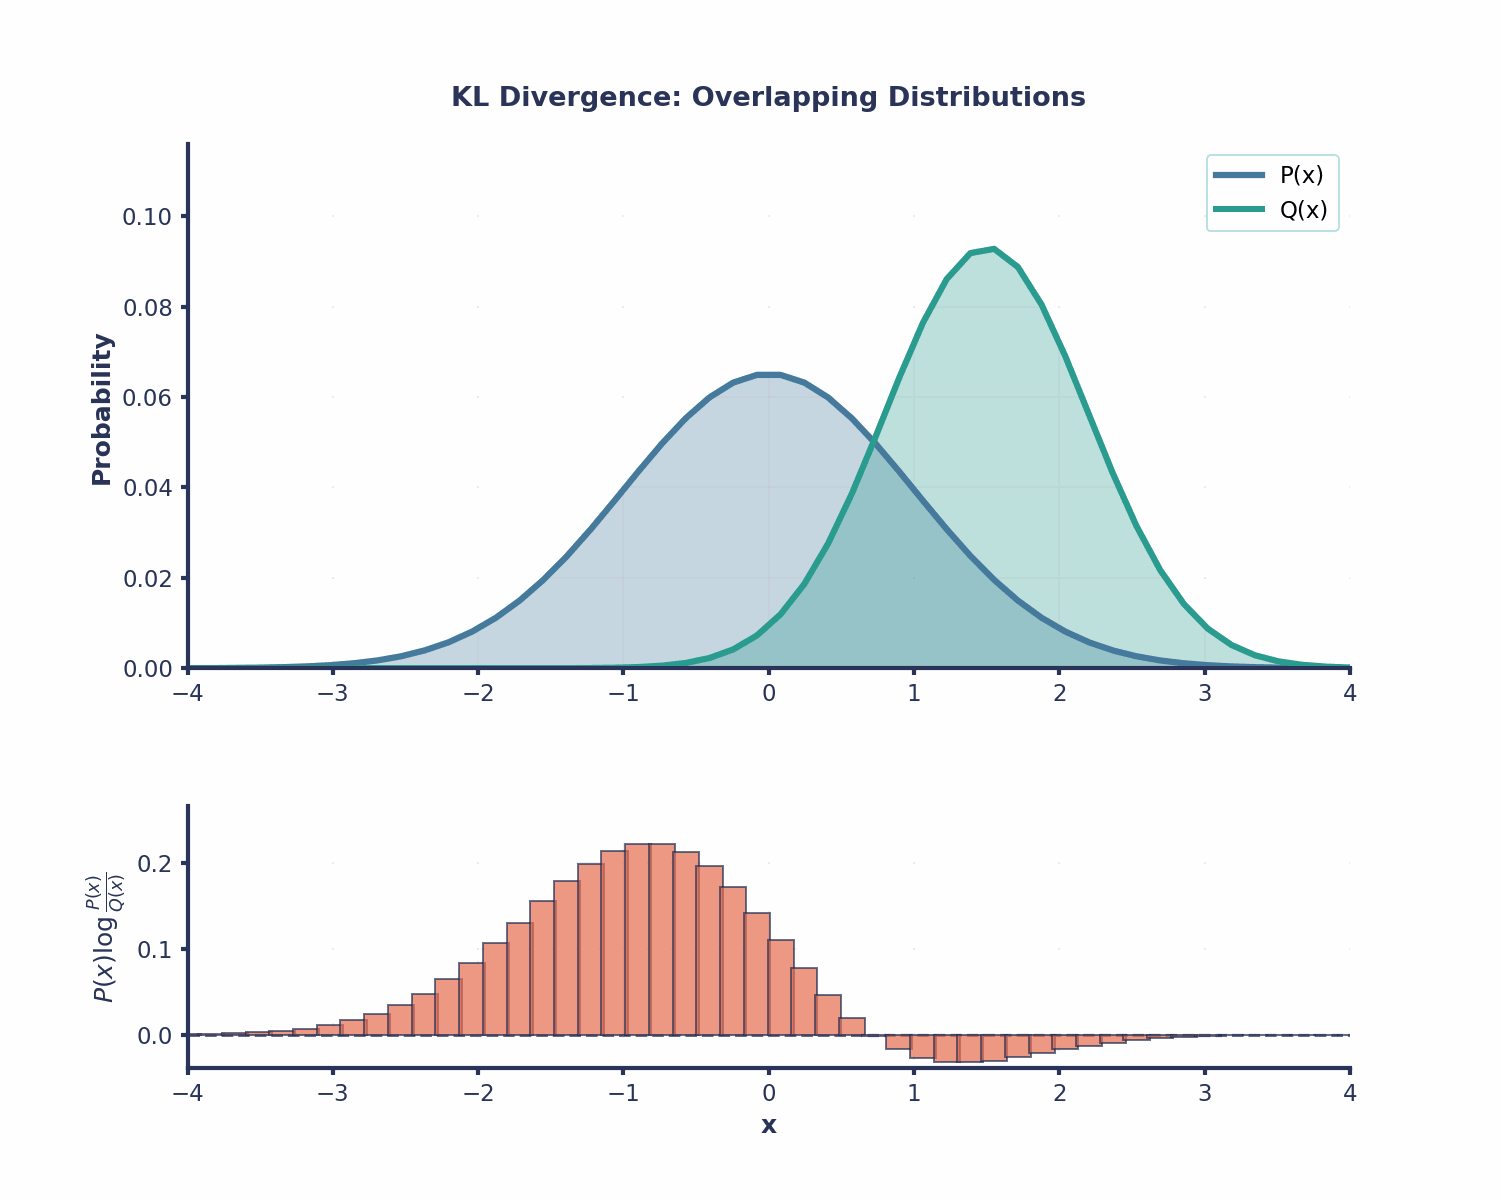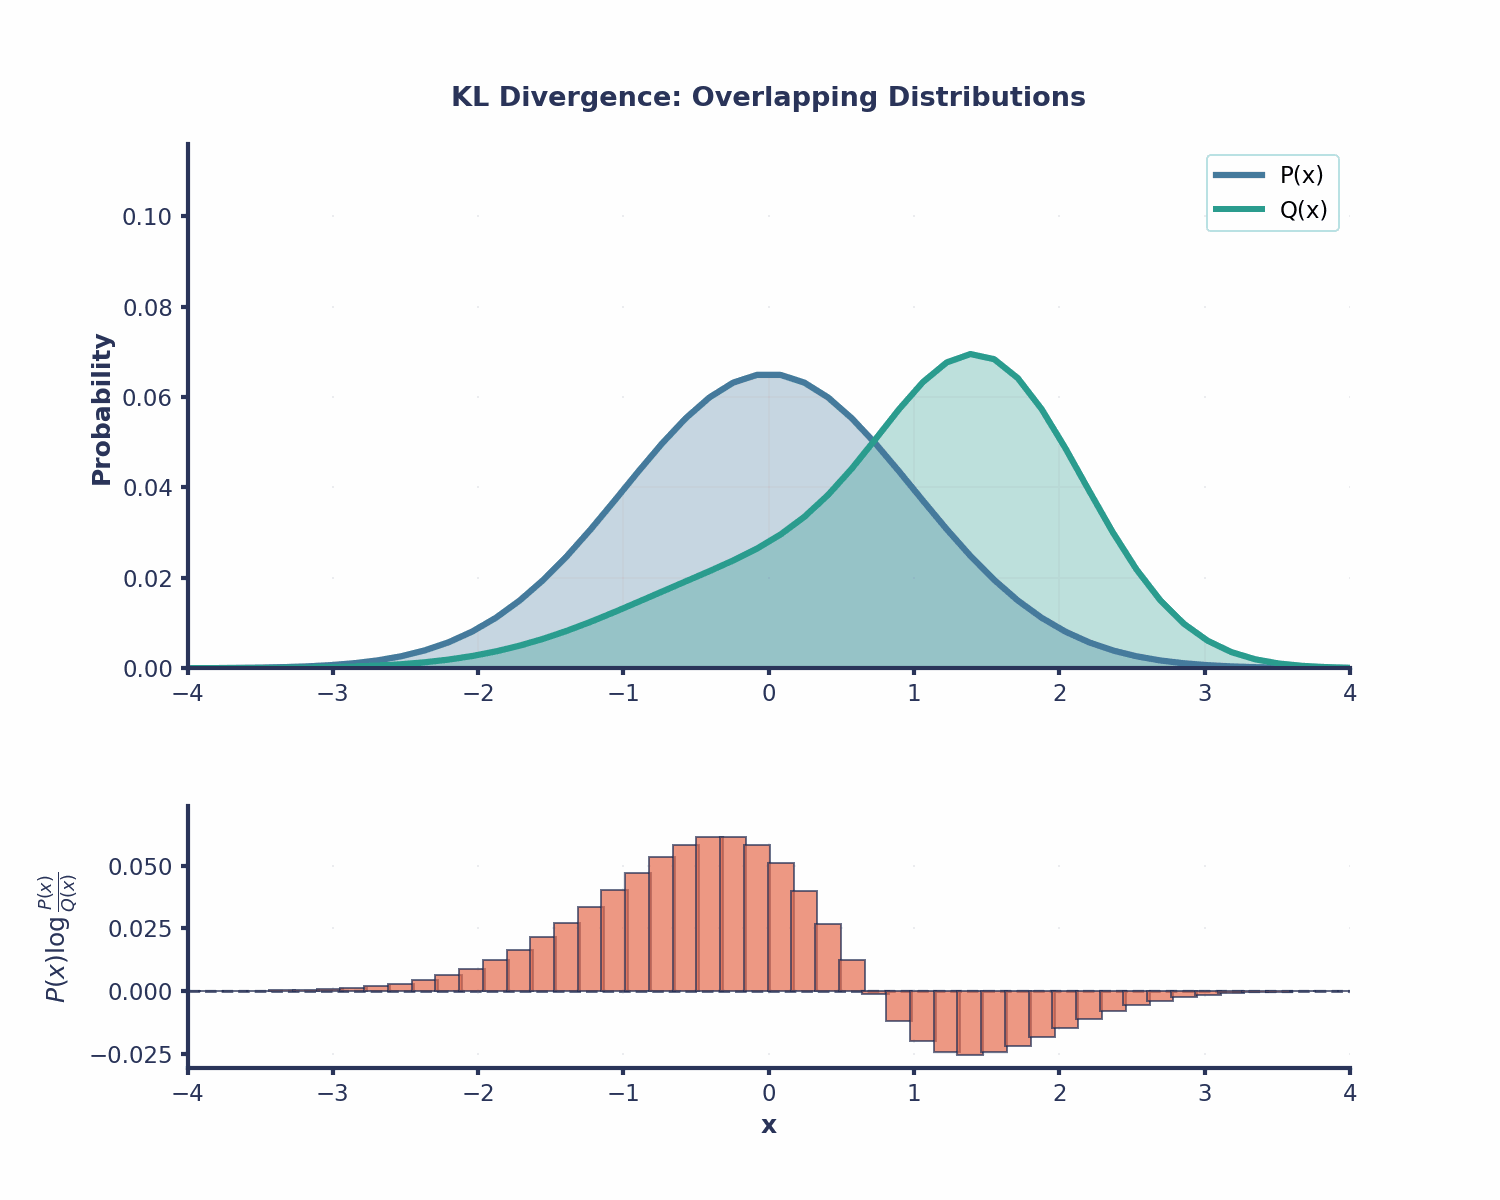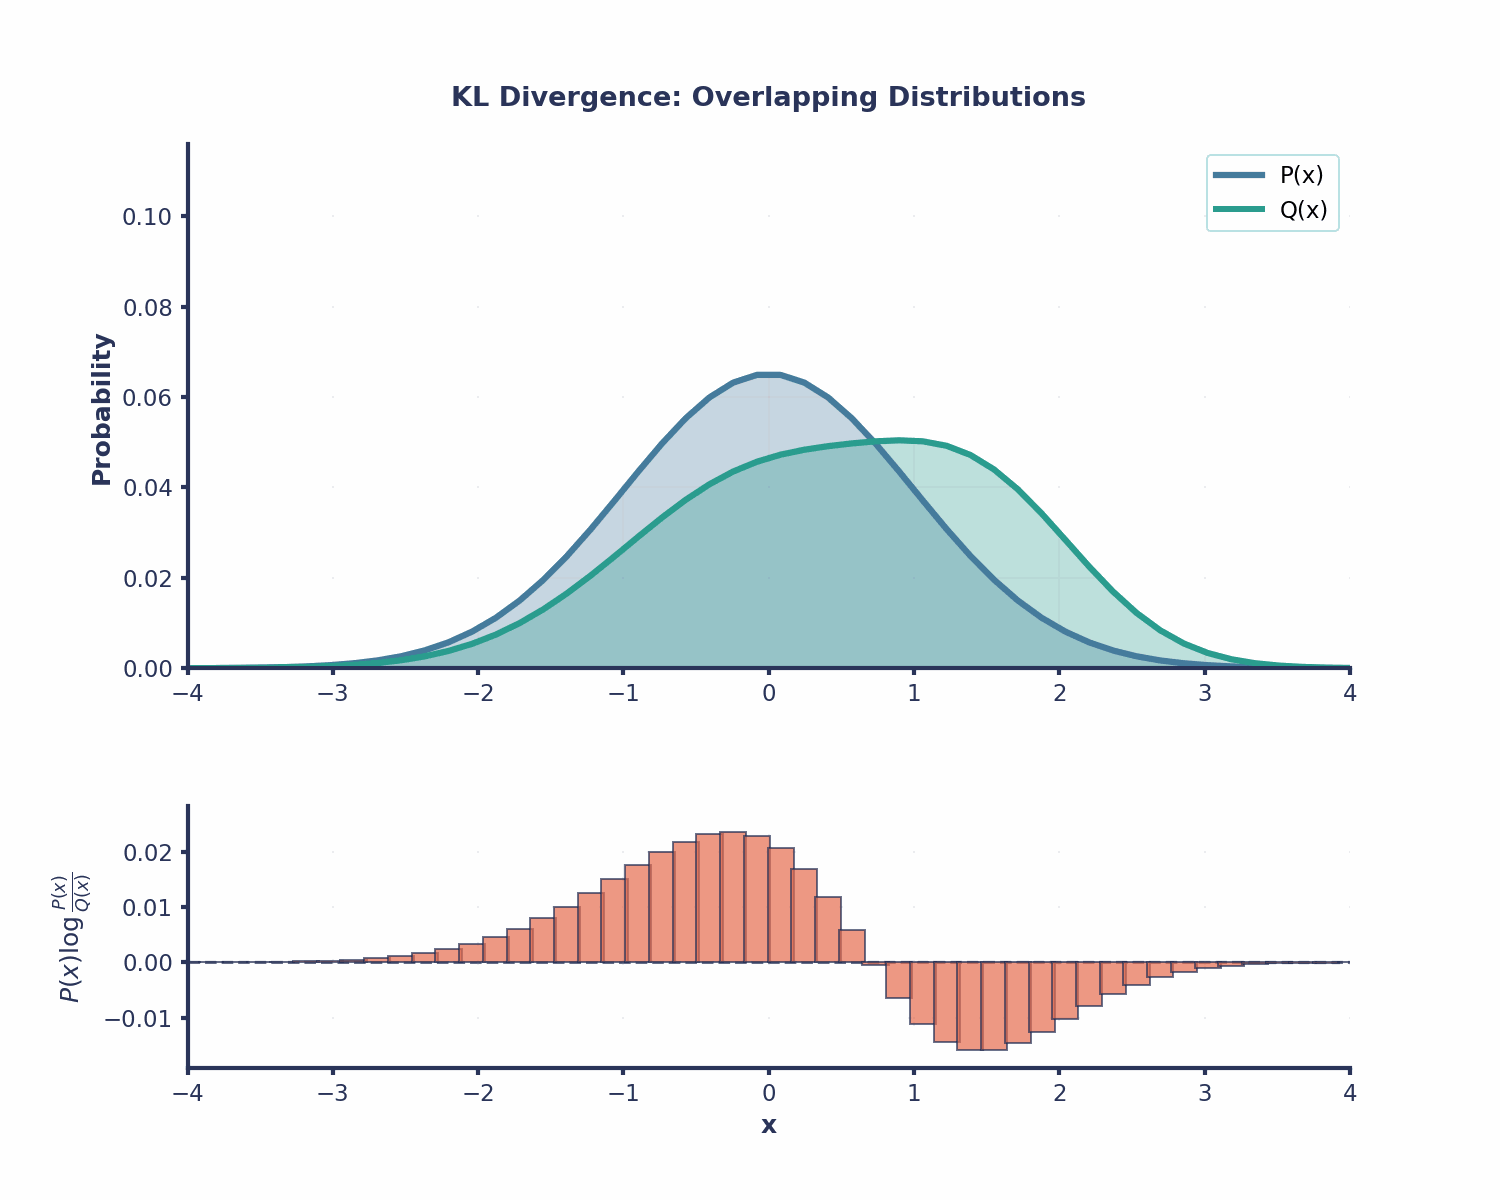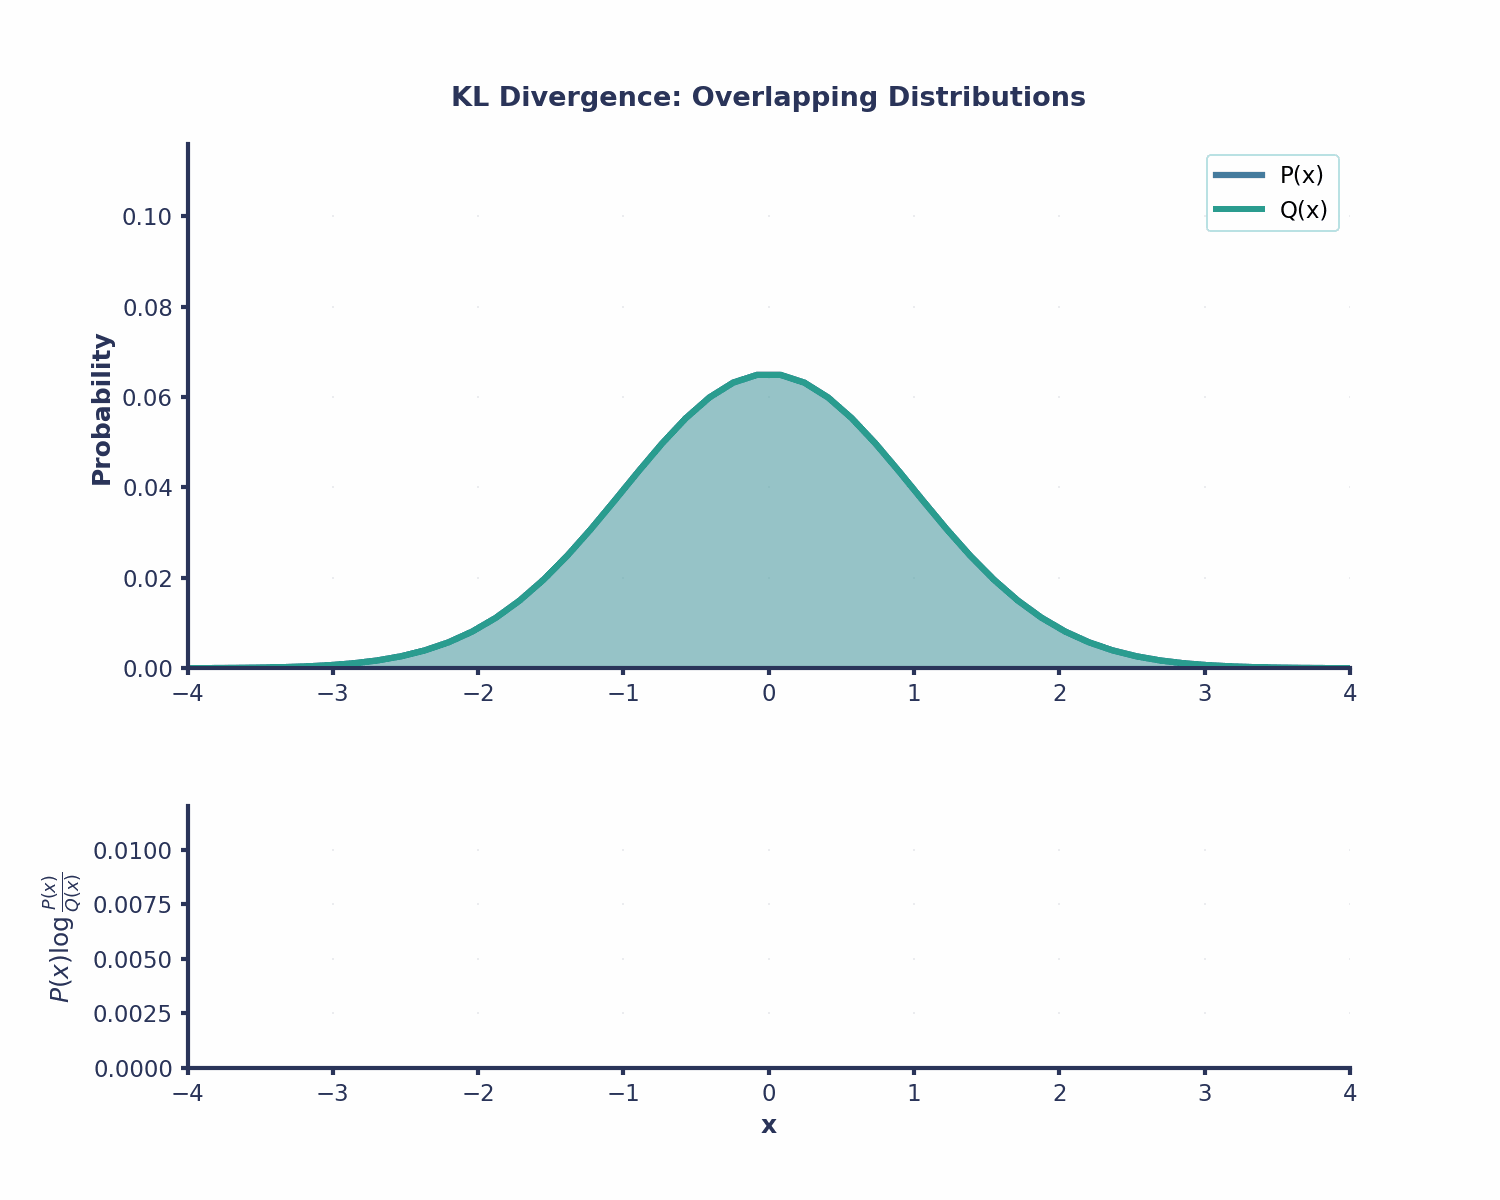
KL-Divergence मशीन लर्निंग के कई क्षेत्रों में उपयोगी है:
KL-Divergence का संबंध Maximum Likelihood Estimation (MLE) से काफ़ी क़रीबी है, जो मॉडल पैरामीटर्स का अनुमान लगाने की बुनियादी विधि है। MLE के बारे में और यह यहाँ बताई गई अवधारणाओं को कैसे पूरक करता है, जानने के लिए मेरा विस्तृत ट्यूटोरियल देखें: Introduction to Maximum Likelihood Estimation (MLE)।
हर चीज़ की तरह KL-Divergence के उपयोग में भी सीमाएँ हैं। आइए उन्हें विस्तार से देखें:
आपने देखा होगा कि मैंने Jensen–Shannon Divergence का ज़िक्र किया, तो इसे संक्षेप में समझते हैं।

हालाँकि यह KL-Divergence से थोड़ा अधिक जटिल और संगणकीय रूप से भारी है, Jensen–Shannon Divergence सममित (symmetric) है। यह फिर भी एक सच्चा दूरी मेट्रिक नहीं है क्योंकि यह त्रिभुज असमता (triangle inequality) संतुष्ट नहीं करता। लेकिन यदि हम JS-Divergence का वर्गमूल ले लें, तो यह त्रिभुज असमता संतुष्ट करता है और एक उचित मेट्रिक बन जाता है।
यह KL‑divergence का एक स्मूद संस्करण भी है जो हमेशा 0 और 1 बिट के बीच रहता है (यदि हम log base 2 लें)। यदि हम समीकरण पर फिर से नज़र डालें, तो हर KL पद साझा मध्यबिंदु M के सापेक्ष नापा जाता है; न P और न ही Q कभी शून्य से भाग देगा, इसलिए अनंतता नहीं आती।
संक्षेप में, KL‑Divergence वह महत्वपूर्ण उपकरण है जिससे हम वह अतिरिक्त सूचना-लागत मापते हैं जो तब आती है जब हम अपने मॉडल के वितरण Q को वास्तविक वितरण P के स्थानापन्न के रूप में उपयोग करते हैं। यदि दोनों समान हों तो यह शून्य होता है, अलग होने पर बढ़ता है, और हमेशा अऋणात्मक रहता है। KL-Divergence एंट्रॉपी और क्रॉस‑एंट्रॉपी को जोड़ता है, और यह लॉस फ़ंक्शंस, वेरिएशनल इन्फ़ेरेंस, और पॉलिसी constraints में दिखता है।
अब KL-Divergence बेहतरीन है, पर यह फिर भी एक उपकरण ही है जो हम मशीन लर्निंग और डीप लर्निंग की समस्याओं में उपयोग करते हैं। इसे और आगे लागू करने के लिए हमारे Machine Learning Scientist in Python करियर ट्रैक और Machine Learning Engineer करियर ट्रैक ज़रूर देखें, जिनमें पर्यवेक्षित, अप्रेक्षणीय, और डीप लर्निंग को कवर किया गया है।
यदि आप KL-Divergence को और गणितीय अवधारणाओं से जोड़ने के लिए तैयार हैं, तो ये संसाधन देखें:
शीर्ष DataCamp पाठ्यक्रम
लर्निंग पाथ
लर्निंग पाथ
लर्निंग पाथ