估计参数是统计分析和机器学习中的基础步骤。在众多可用方法中, 最大似然估计(MLE) 因其直观性、数学严谨性,以及对不同类型数据与模型的广泛适用性而被广泛采用。
在本文中,您将了解 MLE 是什么,通过详细推导与示例探索其数学基础,并掌握有效实现 MLE 的实用计算方法。
什么是最大似然估计(MLE)?
最大似然估计(MLE)是一种重要的 统计方法 ,用于 估计 概率分布的 参数 ,方法是 最大化似然函数。
就 MLE 在 统计推断 中的定位而言, 它是我们用来估计参数的最常见方法之一。
不过,您此时可能还有另一个问题: 什么是似然函数? 我们再展开讨论。
什么是似然函数?
我们可以将似然函数理解为:衡量某一组参数对您观测到的数据解释得有多好的一种方式。
换句话说,它回答的是:“给定这些参数取值,我看到这组数据的可能性有多大?” 但这里常见一个关于概率与似然的误解:
概率是从参数出发 预测数据 。 似然 衡量在给定观测数据的情况下,不同参数取值的合理性。对固定数据而言,它是参数的函数;相对地,概率是在固定参数下关于数据的函数。
因此,概括来说,似然函数以模型参数为输入,输出一个数值,用来表示在给定数据下这些参数有多“合理”。
似然函数的值越大,说明这些参数对您的数据解释得越好。
更直白地说,似然函数帮助我们为不同的参数选择“打分”,从而选出使观测数据“最可能”的那一组参数。
既然我们已理解了概率与似然的区别以及 MLE 的用途,下面进入其背后的数学。
如何推导 MLE 公式
在进入具体示例之前,先来看看一般情况下如何推导最大似然估计量(MLE)。我们将逐步讲解每一步及其背后的理由。
步骤 1:定义概率模型
假设我们有一个数据集:x₁, x₂, ..., xₙ。我们认为这些数据点来自一个依赖未知参数 θ(theta)的概率分布。 我们的主要目标是估计 θ。
例如,如果数据集与掷硬币有关,θ 可以是正面朝上的概率;如果数据是连续型的,如班级学生的身高,θ 可以是正态分布的均值。
步骤 2:写出似然函数
似然函数度量 当 θ 取不同数值时,观测到您的数据的可能性有多大 。其定义为:
直观上,我们在问:给定参数 θ 取某个具体值,观测到这组特定数据的概率是多少?
这组数据表示为在 θ 参数化的模型下,观测到各个数据点(x₁, x₂, ..., xₙ)的 联合概率 。
利用 概率的链式法则 ,我们可以将上式展开为:
不过,这个式子相当复杂!因此我们作出假设:数据点是 相互独立 ——更具体地, 在给定 θ 条件下独立 。
据此,我们可以将联合概率表示为各个概率的乘积:
由于我们的观测数据点在 给定 θ 条件下彼此独立 ,我们有如下等式:
这是因为我们假设一旦知道 θ 的取值,数据点 x₁ 与 x₂ 在条件上相互独立。
步骤 3:找到使似然最大的 θ 值
现在我们需要找到使似然函数 达到最大 的 θ(即让观测数据最可能发生):
不过请注意,我们的似然函数包含乘积。处理乘积会很繁琐,尤其当数据点很多时。为简化处理,我们对似然函数取 对数 ,将乘积转为求和。
这 就得到 对数似然 ,它具有一些有益性质:
对数将 乘积转为求和 ,尤其在求导时更易处理。 对数函数是 单调 的,因此最大化对数似然与最大化似然得到的 θ 相同。
步骤 4:求解最优值
现在我们可以进行求导,不过在机器学习中,我们通常希望损失函数可被最小化。幸运的是,这很容易实现。
在函数前加上负号(即乘以 -1),我们就需要 最小化 我们的损失函数,它现在被称为 负对数似然损失函数。
现在我们可以用微积分来求 θ 的取值:对对数似然关于 θ 求导、令其为 0,并解出 θ。这是因为函数在导数为 0(且二阶导数为正)处取得极小值。
因此,MLE 的最终方程为:
MLE 示例
既然我们已成功推导出 MLE 方程,接下来通过一些示例来加深理解。
掷骰子示例
从一个简单的离散示例开始:估计一枚可能带偏的骰子掷出 6 的概率。
假设我们 掷骰子 12 次 并记录结果。我们希望用 多项式(类别)分布 建模,但先聚焦于估计掷出 6 的概率 θ(theta)。在本例中:
参数(θ): 您要估计的取值——掷出 6 的概率 数据(x): 我们观测到的结果——12 次中出现 4 次 6
现在计算似然函数。由于我们在 12 次中掷出 4 次 6,得到:
之所以如此,是因为 12 次中有 4 次为 6——于是出现 θ⁴;另外 8 次不是 6——于是出现 (1 - θ)⁸ 项。
请注意,我们将这些概率 相乘 ,是因为我们假设它们 在条件上相互独立。
接下来按前文所述,取 负对数似然 ,得到如下方程:
最后,对该式 关于 θ 求导 并令其为 0(因为我们要找到极小点):
由此可得结论:θ 等于 ⅓。
注意: 如果得到多个 θ 解,还需要计算二阶导数,判断哪些 θ 会给出正值(以确认找到的是极小点)。下图中的示例函数也说明了这一点:
身高示例
接着看一个连续型示例——估计正态(高斯)分布的均值。
假设我们有 5 个人的身高数据:160、165、170、175、180(单位:厘米)。我们还假定这些数据来自一个 均值 μ 未知 、方差 σ² 已知(为简化,设 σ² = 25)的正态分布。
参数(μ): 您要估计的值(平均身高) 数据(x₁, x₂, ..., x₅): 观测到的身高
已知方差下的正态分布似然函数为:
虽然看上去很复杂,但取负对数会大幅简化。您也能看到在方程中使用对数的威力。得到的方程如下:
这里得到两个项,但注意第二项在求导时可以忽略,因为我们是 对 μ 求导 ,而第二项不含 μ。
我们已接近答案,但请注意括号中的 μ。
由于它是一个 常数 ,相加 n 次后就是 n*μ,因此可以直接乘以 n。
最终答案应当符合直觉:它在数学上即为将所有 x 求和后除以 n(观测数),这也正是 均值的定义 !
将我们的数据代入该式,可得均值为 170 厘米。
为了更直观,下面的动图展示了当我们改变 μ 时似然如何变化:
在这两个示例中,MLE 都为我们找到了在所选模型下使观测数据最可能发生的参数取值。显然,MLE 也可以用于 多参数 情形,只是计算会稍长一些!
编写 MLE 代码
理解了 MLE 的基本结构后,让我们看看如何用 Python 编码实现。我们将实现上一个(身高)示例的解法。
import numpy as np
from scipy. optimize import minimize
data = np. array( [ 160 , 165 , 170 , 175 , 180 ] )
sigma_squared = 25
def negative_log_likelihood ( mu) :
n = len ( data)
return 0.5 * n * np. log( 2 * np. pi * sigma_squared) + \
np. sum ( ( data - mu) ** 2 ) / ( 2 * sigma_squared)
result = minimize( negative_log_likelihood, x0= 170 )
estimated_mu = result. x[ 0 ]
print ( f"MLE estimate of mu: { estimated_mu} " ) 技术支持 计算策略与算法
注意在编写上述示例代码时,我们创建了一个 negative_log_likelihood() 函数,其中包含了计算 单变量高斯分布的 MLE 的主要逻辑。
一方面,可以说我们最终是把该方程“硬编码”出来,并借助 scipy.optimize 去最小化这个函数。当然,这完全可行,因为 高斯分布 有闭式解。
我们再来看计算 MLE 解的其他方法。
闭式解及其适用场景
如上所述,在一些幸运的情形下,我们可以 解析地 求解 MLE 方程,也就是说, 我们可以推导出参数估计的精确公式。这类解称为闭式解 ,通常简单、直观,且便于编码与计算。
一个重要的问题是:何时存在闭式解?
当 对数似然函数可微、凹(或具良好形状)且代数上可处理 时。 当模型 足够简单 ,通常只涉及一到两个参数,且 没有潜在(隐藏)变量 。
分布
估计参数
闭式 MLE 解
伯努利
p
\hat{p} = #number of success/n
二项分布
p
\hat{p} = x/n
泊松
λ
λ = 1/n*Σx_i
高斯/正态
μ
μ = 1/n*Σx_i
数值优化技术
对于更复杂的模型,解析解不存在或过于复杂。在这种情况下,我们使用 数值优化方法 ——通过迭代算法搜索使对数似然最大的参数。简要说明如下:
牛顿-拉夫森法: 该方法利用:
一阶导数 (梯度) 来确定斜率,以及 二阶导数 (Hessian) 来衡量曲率并相应调整步长。 其更新规则如下: 主要优点是在最优点附近 收敛快 。 但它需要计算二阶导数,在高维时可能 不稳定 或 开销大 。
拟牛顿法(如 BFGS):
仅用 一阶导数 来近似 Hessian 矩阵。 被 Python 中的常用库如 scipy.optimize.minimize 采用(默认即 BFGS)。 相较牛顿-拉夫森法,通常更 数值稳定 且适用面更广。
期望最大化(EM)算法:
当数据涉及 潜在(隐藏)变量 ——即未被直接观测但会影响数据的取值时,使用的专门优化技术。 该算法包含两个步骤:
E 步(期望): 利用当前参数估计与观测数据,计算对数似然的期望。 M 步(最大化): 最大化该期望的对数似然以更新参数估计。
MLE 的性质
从上述示例与推导可见,MLE 十分有用。更正式地,MLE 具有以下性质:
相合性(Consistency): 当样本量增加时,MLE 收敛于参数的真实值。 渐近正态性(Asymptotic Normality): 对大样本,MLE 的分布在真实参数值附近近似正态(钟形)。这是构造置信区间的基础。 有效性(Efficiency): 在所有无偏估计量中,MLE 达到可能的最小方差(至少在渐近意义下达到 Cramér-Rao 下界)。 不变性(Invariance): 若 θ̂ 是 θ 的 MLE,则对任意函数 g,g(θ̂) 是 g(θ) 的 MLE。换言之,MLE 在变换下保持不变。
不过,在以下情形下,MLE 可能不是最佳选择:
小样本: 样本量较小时,MLE 可能有偏。例如,方差的 MLE(σ̂²)往往低估真实方差(σ²)。 稳健性: MLE 对异常值与模型设定错误较为敏感。M-估计等替代方法可提供更稳健的估计。 贝叶斯替代: 最大后验(MAP)估计将先验信息与似然结合,提供贝叶斯视角,尤其在数据有限时往往更稳定。
跨统计建模的应用
本节我们看看 MLE 在机器学习与人工智能中的实际应用。
回归与分类
MLE 最重要的应用之一出现在 逻辑回归 中。在这里,我们估计某一结果属于某一类别(例如客户流失)的概率,方法是拟合参数以 最大化 观测结果的似然。
即便在 线性回归 中,如果我们假设误差服从正态分布,那么最小二乘解其实也是 MLE。
假设检验与模型选择
MLE 也可用于比较模型。
例如, 似然比检验(LRT) 可帮助我们检验向模型添加额外变量是否显著提升性能。其原理是比较两个模型的似然:一个更简单(原假设),一个更复杂(备择假设)。
我们还有 赤池信息准则(AIC) ,通过惩罚复杂度来避免过拟合。这些工具在金融、医学、市场营销等领域广泛使用。
如果您希望进一步探索除似然之外度量概率分布差异的方法,请查看我的教程:KL 散度详解 。
MLE 的局限与替代方案
尽管 MLE 功能强大,但也存在不足。我们快速回顾它的短板,以及可选替代方法。
MLE 的主要局限
对模型设定敏感: 如果模型错误(例如对偏斜数据使用正态分布),MLE 会给出误导性结果。 对异常值敏感: 少量异常点就可能严重扰动估计。 计算成本高: 对于参数众多或带约束的大模型,似然优化可能缓慢或不稳定。 多重解: 有时似然面存在多个峰(局部极大),使得寻找最优解变得棘手。
最大似然估计的替代方法
当 MLE 表现不佳时,可以考虑:
MAP(最大后验): 与 MLE 类似,但加入先验。这在数据有限时有助于稳定估计。 矩估计法: 将样本矩(如均值或方差)与理论矩匹配。精度不如 MLE,但计算非常容易。 最小二乘: 在如带高斯误差的线性回归等场景,最小二乘与 MLE 等价;当 MLE 过于复杂时,最小二乘仍可发挥作用。
不同方法适用于不同情境。MLE 未必总是答案,但往往是很好的起点。
结语
最大似然估计是进行 参数估计 最自然、最广泛使用的方法之一。其核心思想是让观测数据 尽可能“可能” ,因此可用于多种情境,如掷硬币、身高的高斯分布等。
MLE 能在不同模型间迁移并随数据规模扩展,兼具数学优雅与实践威力。尽管在小样本或数据杂乱时存在短板,但在学习 机器学习与人工智能 时,它仍是奠基性的工具。
如果您正走在机器学习之路上,欢迎查看我们的Python 机器学习科学家职业路径 ,涵盖监督、无监督与深度学习。
准备通过实践练习加深对最大似然估计的理解吗?以下资源可帮助您应用所学、获得上手体验:



估计参数是统计分析和机器学习中的基础步骤。在众多可用方法中,最大似然估计(MLE)因其直观性、数学严谨性,以及对不同类型数据与模型的广泛适用性而被广泛采用。
在本文中,您将了解 MLE 是什么,通过详细推导与示例探索其数学基础,并掌握有效实现 MLE 的实用计算方法。
什么是最大似然估计(MLE)?
最大似然估计(MLE)是一种重要的统计方法,用于估计概率分布的参数,方法是最大化似然函数。
就 MLE 在统计推断中的定位而言,它是我们用来估计参数的最常见方法之一。
不过,您此时可能还有另一个问题:什么是似然函数?我们再展开讨论。
什么是似然函数?
我们可以将似然函数理解为:衡量某一组参数对您观测到的数据解释得有多好的一种方式。
换句话说,它回答的是:“给定这些参数取值,我看到这组数据的可能性有多大?” 但这里常见一个关于概率与似然的误解:
因此,概括来说,似然函数以模型参数为输入,输出一个数值,用来表示在给定数据下这些参数有多“合理”。
似然函数的值越大,说明这些参数对您的数据解释得越好。
更直白地说,似然函数帮助我们为不同的参数选择“打分”,从而选出使观测数据“最可能”的那一组参数。
既然我们已理解了概率与似然的区别以及 MLE 的用途,下面进入其背后的数学。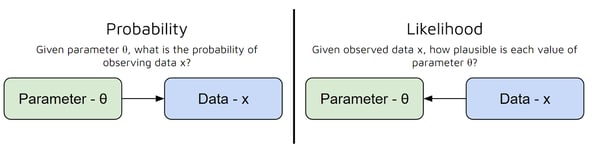
如何推导 MLE 公式
在进入具体示例之前,先来看看一般情况下如何推导最大似然估计量(MLE)。我们将逐步讲解每一步及其背后的理由。
步骤 1:定义概率模型
假设我们有一个数据集:x₁, x₂, ..., xₙ。我们认为这些数据点来自一个依赖未知参数 θ(theta)的概率分布。我们的主要目标是估计 θ。
例如,如果数据集与掷硬币有关,θ 可以是正面朝上的概率;如果数据是连续型的,如班级学生的身高,θ 可以是正态分布的均值。
步骤 2:写出似然函数
似然函数度量当 θ 取不同数值时,观测到您的数据的可能性有多大。其定义为:
直观上,我们在问:给定参数 θ 取某个具体值,观测到这组特定数据的概率是多少?
这组数据表示为在 θ 参数化的模型下,观测到各个数据点(x₁, x₂, ..., xₙ)的联合概率。
利用概率的链式法则,我们可以将上式展开为:
不过,这个式子相当复杂!因此我们作出假设:数据点是相互独立——更具体地,在给定 θ 条件下独立。
据此,我们可以将联合概率表示为各个概率的乘积:
由于我们的观测数据点在给定 θ 条件下彼此独立,我们有如下等式:
这是因为我们假设一旦知道 θ 的取值,数据点 x₁ 与 x₂ 在条件上相互独立。
步骤 3:找到使似然最大的 θ 值
现在我们需要找到使似然函数达到最大的 θ(即让观测数据最可能发生):
不过请注意,我们的似然函数包含乘积。处理乘积会很繁琐,尤其当数据点很多时。为简化处理,我们对似然函数取对数,将乘积转为求和。
这就得到对数似然,它具有一些有益性质:
步骤 4:求解最优值
现在我们可以进行求导,不过在机器学习中,我们通常希望损失函数可被最小化。幸运的是,这很容易实现。
在函数前加上负号(即乘以 -1),我们就需要最小化我们的损失函数,它现在被称为负对数似然损失函数。
现在我们可以用微积分来求 θ 的取值:对对数似然关于 θ 求导、令其为 0,并解出 θ。这是因为函数在导数为 0(且二阶导数为正)处取得极小值。
因此,MLE 的最终方程为:
MLE 示例
既然我们已成功推导出 MLE 方程,接下来通过一些示例来加深理解。
掷骰子示例
从一个简单的离散示例开始:估计一枚可能带偏的骰子掷出 6 的概率。
假设我们掷骰子 12 次并记录结果。我们希望用多项式(类别)分布建模,但先聚焦于估计掷出 6 的概率 θ(theta)。在本例中:
现在计算似然函数。由于我们在 12 次中掷出 4 次 6,得到:
之所以如此,是因为 12 次中有 4 次为 6——于是出现 θ⁴;另外 8 次不是 6——于是出现 (1 - θ)⁸ 项。
请注意,我们将这些概率相乘,是因为我们假设它们在条件上相互独立。
接下来按前文所述,取负对数似然,得到如下方程:
最后,对该式关于 θ 求导并令其为 0(因为我们要找到极小点):
由此可得结论:θ 等于 ⅓。
注意:如果得到多个 θ 解,还需要计算二阶导数,判断哪些 θ 会给出正值(以确认找到的是极小点)。下图中的示例函数也说明了这一点:
身高示例
接着看一个连续型示例——估计正态(高斯)分布的均值。
假设我们有 5 个人的身高数据:160、165、170、175、180(单位:厘米)。我们还假定这些数据来自一个均值 μ 未知、方差 σ² 已知(为简化,设 σ² = 25)的正态分布。
已知方差下的正态分布似然函数为:
虽然看上去很复杂,但取负对数会大幅简化。您也能看到在方程中使用对数的威力。得到的方程如下:
这里得到两个项,但注意第二项在求导时可以忽略,因为我们是对 μ 求导,而第二项不含 μ。
我们已接近答案,但请注意括号中的 μ。
由于它是一个常数,相加 n 次后就是 n*μ,因此可以直接乘以 n。
最终答案应当符合直觉:它在数学上即为将所有 x 求和后除以 n(观测数),这也正是均值的定义!
将我们的数据代入该式,可得均值为 170 厘米。
为了更直观,下面的动图展示了当我们改变 μ 时似然如何变化:
在这两个示例中,MLE 都为我们找到了在所选模型下使观测数据最可能发生的参数取值。显然,MLE 也可以用于多参数情形,只是计算会稍长一些!
编写 MLE 代码
理解了 MLE 的基本结构后,让我们看看如何用 Python 编码实现。我们将实现上一个(身高)示例的解法。
计算策略与算法
注意在编写上述示例代码时,我们创建了一个
negative_log_likelihood()函数,其中包含了计算单变量高斯分布的 MLE的主要逻辑。一方面,可以说我们最终是把该方程“硬编码”出来,并借助
scipy.optimize去最小化这个函数。当然,这完全可行,因为高斯分布有闭式解。我们再来看计算 MLE 解的其他方法。
闭式解及其适用场景
如上所述,在一些幸运的情形下,我们可以解析地求解 MLE 方程,也就是说,我们可以推导出参数估计的精确公式。这类解称为闭式解,通常简单、直观,且便于编码与计算。
一个重要的问题是:何时存在闭式解?
分布
估计参数
闭式 MLE 解
伯努利
p
\hat{p} = #number of success/n
二项分布
p
\hat{p} = x/n
泊松
λ
λ = 1/n*Σx_i
高斯/正态
μ
μ = 1/n*Σx_i
数值优化技术
对于更复杂的模型,解析解不存在或过于复杂。在这种情况下,我们使用数值优化方法——通过迭代算法搜索使对数似然最大的参数。简要说明如下:
MLE 的性质
从上述示例与推导可见,MLE 十分有用。更正式地,MLE 具有以下性质:
不过,在以下情形下,MLE 可能不是最佳选择:
跨统计建模的应用
本节我们看看 MLE 在机器学习与人工智能中的实际应用。
回归与分类
MLE 最重要的应用之一出现在逻辑回归中。在这里,我们估计某一结果属于某一类别(例如客户流失)的概率,方法是拟合参数以最大化观测结果的似然。
即便在线性回归中,如果我们假设误差服从正态分布,那么最小二乘解其实也是 MLE。
假设检验与模型选择
MLE 也可用于比较模型。
例如,似然比检验(LRT)可帮助我们检验向模型添加额外变量是否显著提升性能。其原理是比较两个模型的似然:一个更简单(原假设),一个更复杂(备择假设)。
我们还有赤池信息准则(AIC),通过惩罚复杂度来避免过拟合。这些工具在金融、医学、市场营销等领域广泛使用。
如果您希望进一步探索除似然之外度量概率分布差异的方法,请查看我的教程:KL 散度详解。
MLE 的局限与替代方案
尽管 MLE 功能强大,但也存在不足。我们快速回顾它的短板,以及可选替代方法。
MLE 的主要局限
最大似然估计的替代方法
当 MLE 表现不佳时,可以考虑:
不同方法适用于不同情境。MLE 未必总是答案,但往往是很好的起点。
结语
最大似然估计是进行参数估计最自然、最广泛使用的方法之一。其核心思想是让观测数据尽可能“可能”,因此可用于多种情境,如掷硬币、身高的高斯分布等。
MLE 能在不同模型间迁移并随数据规模扩展,兼具数学优雅与实践威力。尽管在小样本或数据杂乱时存在短板,但在学习机器学习与人工智能时,它仍是奠基性的工具。
如果您正走在机器学习之路上,欢迎查看我们的Python 机器学习科学家职业路径,涵盖监督、无监督与深度学习。
准备通过实践练习加深对最大似然估计的理解吗?以下资源可帮助您应用所学、获得上手体验: