

理解熵
交叉熵的概念可追溯至信息论领域,其中的信息熵(又称香农熵)由克劳德·香农在 1948 年的论文《A Mathematical Theory of Communication》中正式提出。在讨论交叉熵之前,先来了解熵。
熵用于度量系统中的随机性或无序程度。在信息论语境下,随机变量的熵是其可能结果所固有的平均不确定性、惊讶度或信息量。简单来说,它衡量事件的不确定性。
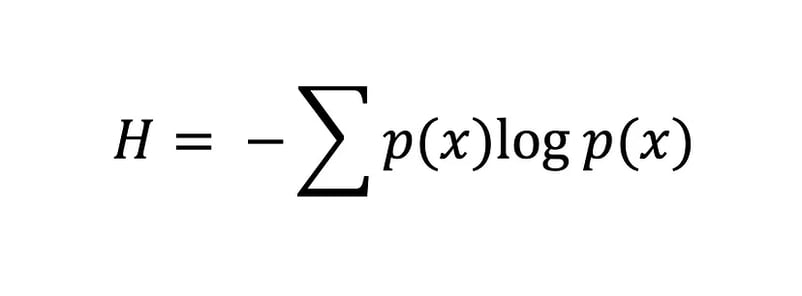
香农熵公式
熵 H(x) 的值越大,概率分布的不确定性越高;值越小,不确定性越低。
什么是交叉熵?
交叉熵(也称对数损失或 log loss)是机器学习中常用来衡量分类模型性能的损失函数。
它衡量在使用另一个概率分布 q 的最优编码来识别来自概率分布 p 的事件时,所需的平均比特数。换言之,交叉熵衡量分类模型学到的概率分布与真实值之间的差异。
交叉熵损失函数通过在训练过程中调整机器学习模型的权重来寻求最优解。目标是最小化真实结果与预测结果之间的误差。交叉熵值越低,性能越好。该优化通过梯度下降实现,损失函数的梯度用于指导参数更新。
如果您熟悉Kullback-Leibler(KL)散度,可能会问:“交叉熵和 KL 散度有何区别?”这个问题很合理。这两个概念都广泛用于衡量概率分布之间的差异或相似性。尽管它们有相似之处,但用途不同。
如上所述,交叉熵衡量在使用概率分布 Q 的最优编码来识别来自概率分布 P 的事件时的平均比特数,通常用于机器学习中评估模型性能,其目标是最小化预测概率分布与真实分布之间的误差。
相比之下,KL 散度衡量两个概率分布 P 和 Q 之间的差异。具体而言,KL 散度量化当用 Q 近似 P 时的信息损失量。在无监督学习任务中,这非常有用,目标是通过最小化真实数据分布与学习到的数据分布之间的散度来发现数据结构。
交叉熵作为损失函数
在机器学习中,损失函数帮助模型判断“错在何处”,并据此改进。它们是量化模型中预测值与真实值之间差异的数学函数,但作用不止于此。
损失函数给出的误差度量也在优化过程中为模型提供反馈,说明其对数据的拟合程度。因此,大多数机器学习模型会在优化阶段引入损失函数,通过选择合适的模型参数来帮助最小化误差并得到最优解——误差越小,模型越好。
我们可以使用交叉熵损失函数来衡量两个概率分布之间的误差。比如,假设我们在进行一个二元分类任务(两类:0 和 1)。
在这种情况下,我们需要使用二元交叉熵,即对所有数据样本的平均交叉熵:
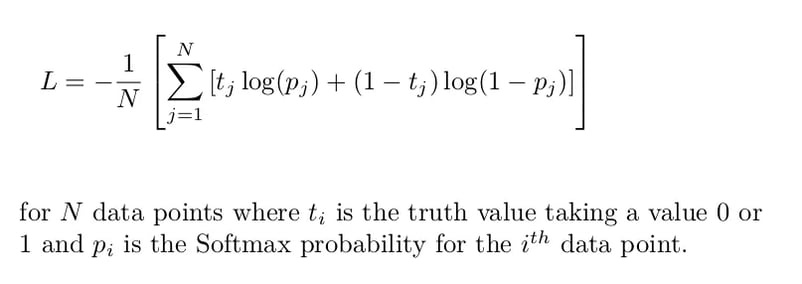
二元交叉熵公式【来源:Cross-Entropy Loss Function】
如果我们要计算一个真实值为 y=1 的单个数据点的损失,公式如下:
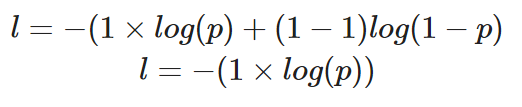
计算真实值为 1 的单个样本的二元交叉熵
预测概率 p 决定损失 l 的大小。如果 p 值较高,模型做出了正确预测,将得到“奖励”——表现为较低的损失 l。
相反,如果预测概率 p 较低,说明模型预测错误,二元交叉熵损失函数会通过较高的 l 值来反映这一点。
对于多类分类任务,交叉熵(通常称为类别交叉熵)可以扩展如下。在这种情况下,输出层通常使用softmax 激活函数在所有类别上产生概率分布:
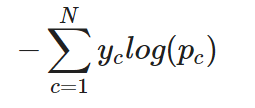
单个样本的类别交叉熵
也就是说,在多类分类任务中应用交叉熵时,会分别计算每个类别的损失并求和,得到总损失。
何时使用交叉熵损失
交叉熵损失是分类任务的标准选择,但了解各变体的适用场景有助于您构建更优模型:
| 损失函数 | 使用场景 | 输出激活 | 示例 |
|---|---|---|---|
| 二元交叉熵 | 两类(0 或 1) | Sigmoid | 垃圾邮件检测、医疗诊断 |
| 类别交叉熵 | 互斥的多个类别 | Softmax | 图像分类、情感分析 |
| 二元交叉熵(多标签) | 每个样本包含多个标签 | Sigmoid(按输出) | 图片打标、文档归类 |
在 PyTorch 和 TensorFlow 中实现交叉熵损失
在本教程部分,我们将学习如何在TensorFlow和PyTorch中使用交叉熵损失函数。
先来创建数据集。我们将使用 Scikit-learn 的 make_classification 函数:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
# Create training data
X, y = make_classification(
n_samples=10000,
n_informative=10,
random_state=2022
)
# split into train and test
X_new, X_test = X[:9000, :], X[9000:, ]
y_new, y_test = y[:9000], y[9000:]
X_train, X_val, y_train, y_val = train_test_split(
X_new, y_new,
test_size=0.3
)
print(f"Train data: {X_train.shape}\n\
Train labels: {y_train.shape}\n\
Test data: {X_test.shape}\n\
Test labels: {y_test.shape}")
"""
Train data: (6300, 20)
Train labels: (6300,)
Test data: (1000, 20)
Test labels: (1000,)
"""TensorFlow 中的交叉熵
我们将构建一个包含输入层、隐藏层和输出层的模型。
由于这是一个二元分类任务,我们将使用二元交叉熵作为损失函数。输出层使用sigmoid 激活函数来生成 0 到 1 之间的概率。
import tensorflow as tf
# Build and train model
model = tf.keras.Sequential([
tf.keras.layers.Dense(10,
input_shape=(X_train.shape[1],),
activation="relu"),
tf.keras.layers.Dense(10,
activation="relu"),
tf.keras.layers.Dense(1, activation="sigmoid")
])
model.compile(
loss="binary_crossentropy", # loss function here
optimizer="adam",
metrics=["accuracy"])
history = model.fit(X_train, y_train, epochs=20, validation_data=[X_val, y_val], verbose=0)接下来我们绘制损失曲线,查看模型是否在改进——也就是误差随每个 epoch 下降,直到无法进一步提升。
# plotting the loss of the models
fig, ax = plt.subplots(figsize=(8,5))
plt.plot(history.history['loss'])
plt.plot(history.history['val_loss'])
plt.title('model loss')
plt.ylabel('loss')
plt.xlabel('epoch')
plt.xticks(np.arange(0,20, step=1))
plt.legend(['train', 'test'], loc='upper right')
plt.show()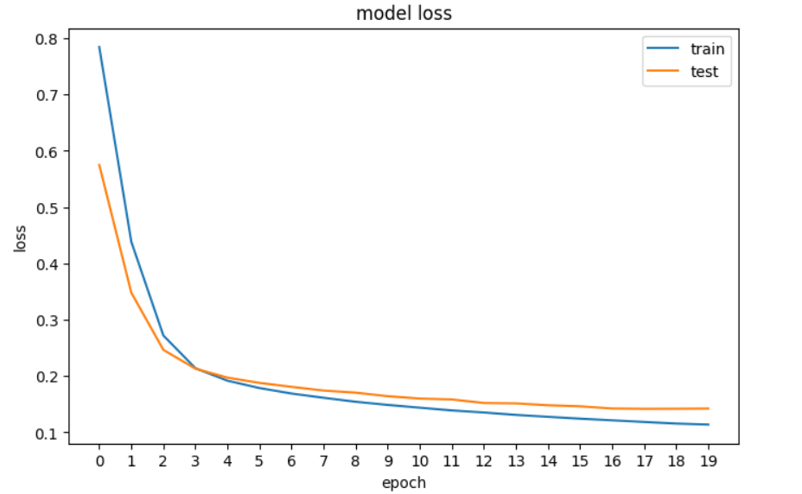
我们在 TensorFlow 中的神经网络损失曲线图。
PyTorch 中的交叉熵
在 PyTorch 中,模型的输入、输出和参数都以张量表示,这意味着我们必须将 Numpy 数组转换为张量。下面的代码首先完成这一转换,然后构建神经网络并打印其结构。
import torch
import torch.nn as nn
import torch.optim as optim
# Convert numpy arrays to tensors
X_train_tensor = torch.tensor(X_train, dtype=torch.float32)
X_val_tensor = torch.tensor(X_val, dtype=torch.float32)
y_train_tensor = torch.tensor(y_train, dtype=torch.float32).reshape(-1, 1)
y_val_tensor = torch.tensor(y_val, dtype=torch.float32).reshape(-1, 1)
# Build the model
input_dim = X_train.shape[1]
hidden_dim = 10
output_dim = 1
model = nn.Sequential(
nn.Linear(input_dim, hidden_dim),
nn.ReLU(),
nn.Linear(hidden_dim, hidden_dim),
nn.ReLU(),
nn.Linear(hidden_dim, output_dim),
nn.Sigmoid()
)
print(model)
"""
Sequential(
(0): Linear(in_features=20, out_features=10, bias=True)
(1): ReLU()
(2): Linear(in_features=10, out_features=10, bias=True)
(3): ReLU()
(4): Linear(in_features=10, out_features=1, bias=True)
(5): Sigmoid()
)
"""接着,定义二元交叉熵损失函数和优化器:
loss_fn = nn.BCELoss() # binary cross entropy
optimizer = optim.Adam(model.parameters(), lr=0.001)现在开始训练模型。以下是训练循环:
# Training loop
n_epochs = 20
train_loss = []
val_loss = []
for epoch in range(n_epochs):
# Training
model.train()
y_pred = model(X_train_tensor)
loss = loss_fn(y_pred, y_train_tensor)
optimizer.zero_grad()
loss.backward()
optimizer.step()
train_loss.append(loss.item())
# Validation
model.eval()
with torch.no_grad():
y_val_pred = model(X_val_tensor)
v_loss = loss_fn(y_val_pred, y_val_tensor)
val_loss.append(v_loss.item())最后绘制损失曲线:
# plotting the loss of the models
fig, ax = plt.subplots(figsize=(8,5))
plt.plot(train_loss)
plt.plot(val_loss)
plt.title('model loss')
plt.ylabel('loss')
plt.xlabel('epoch')
plt.xticks(np.arange(0,20, step=1))
plt.legend(['train', 'test'], loc='upper right')
plt.show()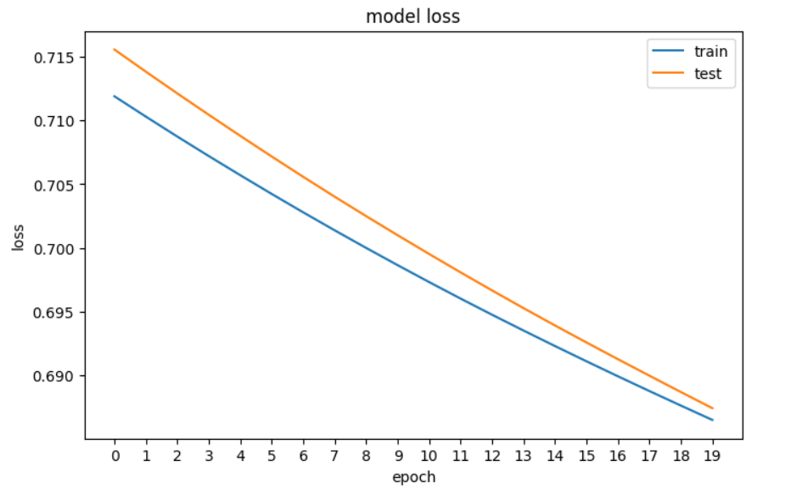
我们在 PyTorch 中的神经网络损失曲线图
关键要点
下面快速回顾一下我们关于交叉熵损失的要点:
- 熵用于度量系统中的随机性或无序程度,以衡量事件的不确定性。若结果确定,熵的度量将很低。
- 交叉熵是机器学习中用于衡量分类模型性能的常用损失函数。具体来说,它衡量分类模型学到的概率分布与预测值之间的差异。在二元分类任务中应用时,也常被称为对数损失(log loss)。
- 二元交叉熵用于二元分类,类别交叉熵用于多类分类。
- 交叉熵与 KL 散度相似,但用途不同:交叉熵通常用于机器学习中评估模型性能,目标是最小化预测概率分布与真实分布之间的误差;而 KL 散度更常用于无监督学习任务,目标是通过最小化真实分布与学习到的分布之间的散度来发掘数据结构。
想要继续学习,请查看以下资源:

交叉熵常见问答
机器学习中的交叉熵是什么?
交叉熵(也称对数损失或 log loss)是机器学习中常用来衡量分类模型性能的损失函数。它衡量预测概率分布与真实分布之间的差异。
熵与交叉熵有什么关系?
熵用于度量系统中的随机性或无序程度,即衡量事件的不确定性。交叉熵在此概念之上,衡量在使用另一个分布的最优编码来识别来自一个概率分布的事件时,所需的平均比特数。
什么是香农熵公式?
香农熵公式用于计算随机变量的熵,衡量可能结果所固有的平均不确定性或信息量。熵值越高,表示不确定性越大。
交叉熵与 KL 散度有何不同?
交叉熵通过最小化预测分布与真实分布之间的误差来评估分类模型的性能。KL 散度量化当一个分布用来近似另一个分布时的信息损失。KL 散度常用于无监督学习任务。
什么是二元交叉熵?
二元交叉熵用于二元分类任务。它计算所有数据样本的平均交叉熵。
类别交叉熵与二元交叉熵有何不同?
类别交叉熵是二元交叉熵在多类分类任务中的扩展。
为什么损失函数在机器学习中很重要?
损失函数量化机器学习模型中预测值与真实值之间的差异。它们通过提供模型对数据拟合程度的反馈来指导优化过程。阅读我们的指南《机器学习中的损失函数详解》了解更多。
机器学习还有哪些其他类型的损失函数?
机器学习中的其他损失函数包括用于回归任务的均方误差(MSE)和平均绝对误差(MAE)、用于支持向量机的 hinge 损失、用于稳健回归的 Huber 损失、用于计数数据回归的泊松损失,以及用于向量相似性任务的余弦相似度相关损失。阅读我们的文章《什么是深度学习?初学者教程》,了解更多损失函数及其在机器学习中的作用。
如何在 PyTorch 中实现交叉熵损失函数?
在 PyTorch 中,针对二元分类任务,交叉熵损失函数可通过 nn.BCELoss 实现。模型使用 nn.Sequential 构建并定义各层,优化器通过 optim.Adam 设置。在训练过程中计算损失以更新模型参数。
我们日常使用的几乎所有应用程序,都以某种形式引入了机器学习来增强或自动化业务流程。
然而,这些模型并不能直接投入到真实环境中——尤其是在高风险场景(例如预测某人是否患癌)下。它们必须在上线前经过优化,以确保高效、有效地运行。这意味着需要对模型参数进行微调,确保它们能真正改善客户体验。
实践中,人们通常使用损失/代价函数来在训练过程中为机器学习模型寻找最优解。交叉熵是用于优化分类模型的最常用损失函数之一。
在本文中,我们将深入探讨:
要点速览
nn.BCELoss,TensorFlow 中为binary_crossentropy)