
{count, plural, one {Program} other {Program}}
Makine Öğrenimi Temelleri Python'da
{hours} sa
Makine öğreniminde, modellerimizin gerçek dünyadaki sonuçları ne kadar doğru tahmin ettiğini ölçmek çok önemlidir. İster bir hava tahmin modeli kuruyor olun ister bir öneri sistemini optimize ediyor olun, tahminlerinizin gerçeğe ne kadar yakın olduğunu nicelleştirmenin bir yoluna ihtiyacınız vardır. Bunu başarmanın güçlü bir yolu da KL Ayrışımıdır.
Bu yazıda, KL Ayrışımının ne olduğunu, neden önemli olduğunu, sezgisel yorumunu, matematiksel temellerini ve uygulamasını gösteren pratik örnekleri inceleyeceğim.
Makine öğrenimi kavramlarını keşfediyorsanız, Python ile Makine Öğrenimi Temelleri beceri yoluna göz atmanızı şiddetle tavsiye ederim.
KL Ayrışımı (Kullback-Leibler Ayrışımı), bir olasılık dağılımının başka bir referans dağılımdan ne kadar saptığını belirlemek için kullanılan bir istatistiksel ölçüdür.
Diyelim ki birlikte yarının hava durumunu tahmin eden bir model geliştiriyoruz. Kaputun altında modelimiz aslında bahis yapıyor—olasılıkları olası sonuçlara atıyor. Ama şu önemli soruyu sormamız gerekiyor:
Bu bahislerin gerçeklikten ne kadar saptığını nasıl ölçersiniz?
Bu farkı nicelleştirebileceğimiz bir yola ihtiyacımız var ve burada KL Ayrışımı devreye girer. Bu, modelimizin neye inandığı ile gerçekte neyin doğru olduğu arasındaki farkı nicelleştiren matematiksel bir araçtır.
Daha önce belirttiğim gibi, KL Ayrışımı (ya da daha resmi adıyla Kullback-Leibler Ayrışımı) modern veri bilimi, makine öğrenimi ve yapay zekânın bel kemiğidir. Bize bit veya nat cinsinden (buna daha sonra değineceğiz), bir olasılık dağılımını (örneğin modelimizin tahminleri, Q) diğerini (gerçek dünya, P) yaklaştırmak için kullandığımızda ne kadar “ekstra şaşkınlık” veya “bilgi kaybı” yaşadığımızı söyler.
Model değerlendirme, sinir ağlarında düzenlileştirme, Bayesyen güncellemeler ve hatta verileri nasıl sıkıştırdığımız veya mesajları verimli biçimde nasıl ilettiğimiz gibi süreçlerin arkasındaki bir yargıç gibi davranır.
KL Ayrışımının ne kadar önemli olduğunu kavramak için şöyle düşünün. Modelimiz her tahmin yaptığında aslında geleceğe dair kumar oynuyordur. KL Ayrışımı, bu bahislerin maliyetini hesaplayan puan kartıdır. Aynı ilke; bir sohbet botu eğitiyor, bir hastalığı teşhis ediyor ya da bir reklam kampanyasını optimize ediyor olalım, makine öğreniminin geniş bir yelpazesinde geçerlidir.
Matematiksel olarak, KL Ayrışımı şu şekilde tanımlanır:
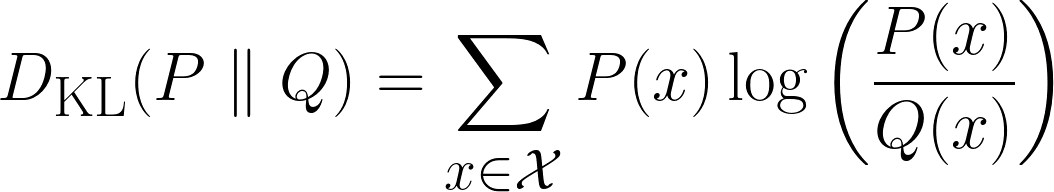
Yukarıdaki formül ayrık durumlar içindir, aşağıdaki formül ise sürekli durumlar içindir.
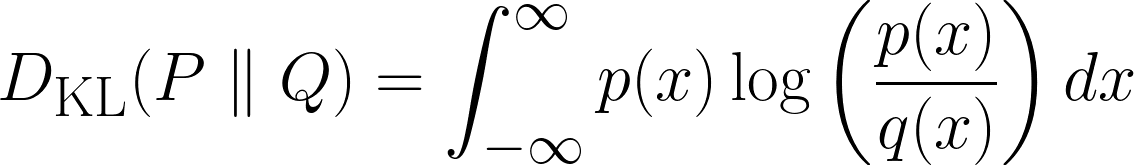
Bu bölümde, KL Ayrışımını sezgisel olarak türeteceğiz. Bir dizi soru sorarak başlayalım.
“Yazı tura atıp sonucu tam bildiğimi düşünün, şaşırır mıydınız?” Sanırım biraz şaşırırdınız ama tamamen şoke olmazdınız. Şimdi ikinci senaryoya geçelim.
“Zar atıp sonucu tam bildiğimi düşünün, önceki senaryoya göre daha çok şaşırır mıydınız?” Sanırım evet dersiniz, çünkü doğru sonucu bilmem daha düşük olasılıklıdır.
Şimdi son bir senaryo:
“Kazanan piyango numaralarını doğru tahmin ettiğimi düşünün, önceki senaryodan daha çok şaşırır mıydınız?” Sanırım evet der ve tamamen şoke olurdunuz. Peki neden?
Çünkü senaryolar ilerledikçe, benim doğru sonucu bilme olasılığım azaldı ve dolayısıyla sizin şaşkınlığınız arttı. Yani bir ilişki gözlemledik:
Bir olayın gerçekleşme olasılığı, şaşkınlıkla ters orantılıdır.
Açıklık için: Olasılık azaldıkça şaşkınlık artar ve tersi.
Burada bir başka ilginç gözlem daha yapabiliriz. Zar atma senaryosuna geri dönelim ve aynı zarı 3 kez attığınızı ve benim her seferinde doğru bildiğimi hayal edin; bir kez doğru bilmiş olmama göre ne kadar daha çok şaşırırdınız?
Şaşkınlığınız sadece biraz artmazdı; dramatik biçimde artardı, ideal olarak üç katına çıkardı. Neden? Çünkü her yeni doğru tahmin, inançsızlığınızı katlar. Sadece sabit bir şaşkınlık eklemiyorsunuz—durumun inanılmazlığını çoğaltıyorsunuz.
Dolayısıyla, Şaşkınlığı matematiksel olarak tanımlamaya çalışırken, şu özellikleri olmasını isteriz:
İlk bakışta pek çok gereklilik olduğundan, matematiksel tanımın oldukça karmaşık olacağını düşünebiliriz. Ancak öyle değil!
Yukarıdaki gerekliliklerin tümü, logaritma fonksiyonunu kullanarak karşılanabilir. Tek başına log fonksiyonu (çoğu zaman log(x) ve ln(x) birbirinin yerine kullanılır) şu şekle sahiptir:
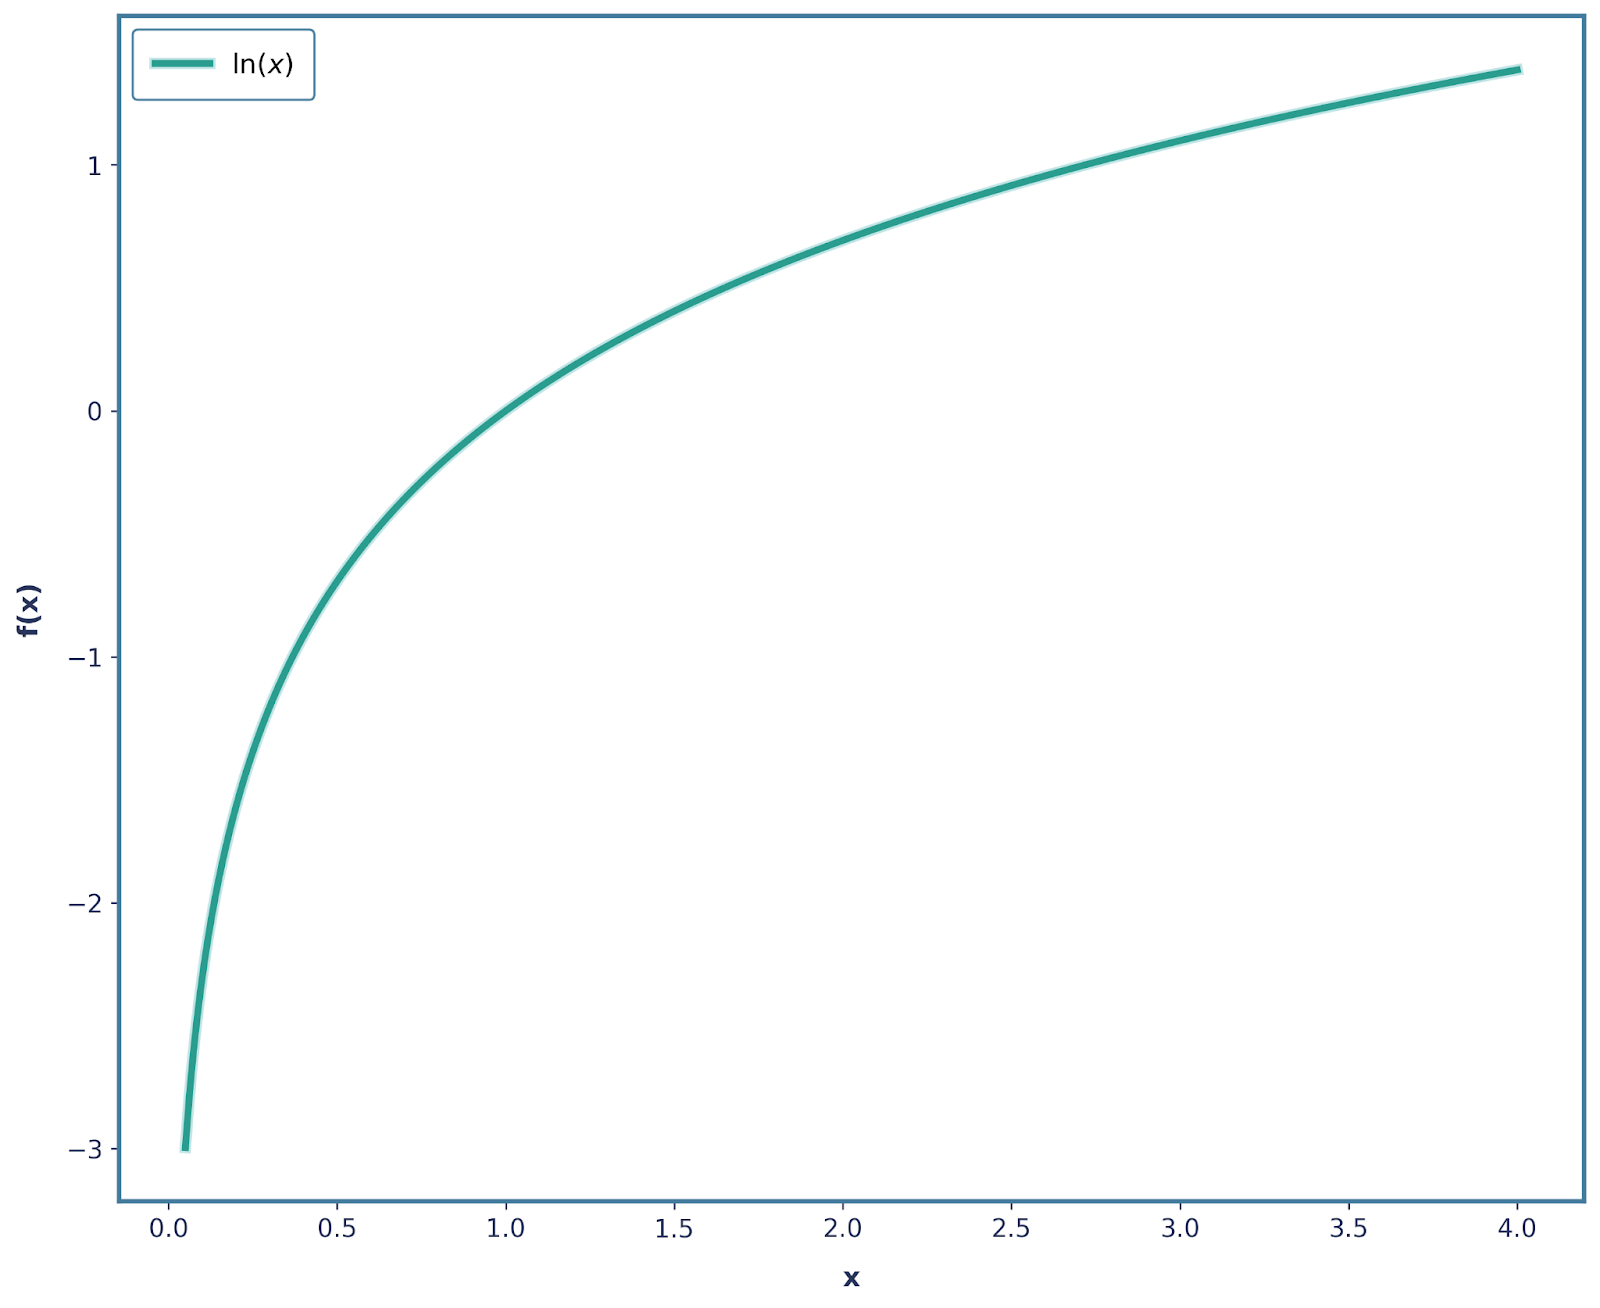
Aslında gerekliliklerin birçoğunu şimdiden karşılıyoruz. Önce Toplanabilirlik Özelliğine odaklanalım. İki bağımsız olay gerçekleştiğinde, toplam şaşkınlığın tekil şaşkınlıkların toplamı olması gerektiğini söylemiştik, hatırlayın. İşte log fonksiyonu tam da bunu yapar!
Nasıl mı:
Adil bir zarda 6 gelme olasılığı ⅙’dır ve olayın şaşkınlığını şöyle tanımlayalım:
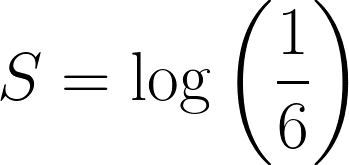
Şimdi, art arda üç kez 6 gelmesi olayını ele alalım; birleşik olasılık: ⅙ * ⅙ * ⅙ = 1/216 olur.
Şaşkınlık açısından, bu şöyle olur:
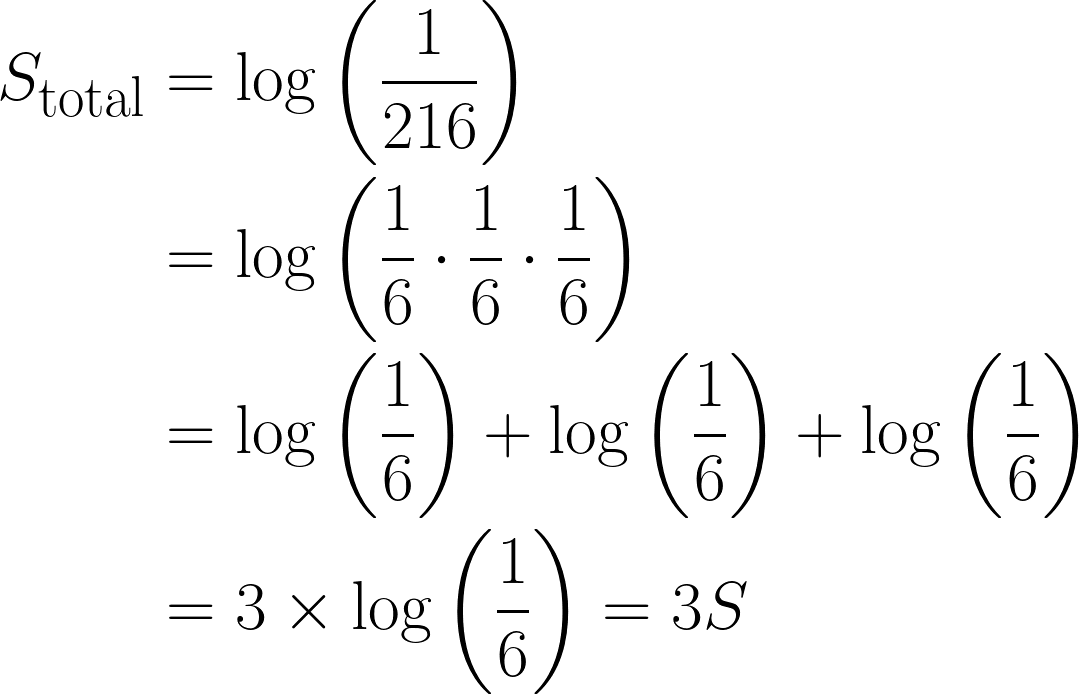
Bu oldukça önemli bir gözlemdir; kullandığımız logaritma sayesinde toplam şaşkınlık 3 kat artmıştır. Ayrıca, log(1) = 0 olduğu için 3. Özelliği de sağlar; çünkü kesin olan bir olayda şaşkınlık unsuru yoktur.
Ek olarak, log(x) sürekli ve monoton bir fonksiyon olduğundan 4. Özellik de sağlanır! Ancak 2. Özellik sağlanmaz; zira olasılık azaldığında şaşkınlığımız azalır (daha negatif hale geldiği için).
Bunu oldukça kolayca, negatif işaret uygulayarak çözebiliriz! Böylece fonksiyonumuz -log(x) olur ve aşağıdaki şekle sahiptir.
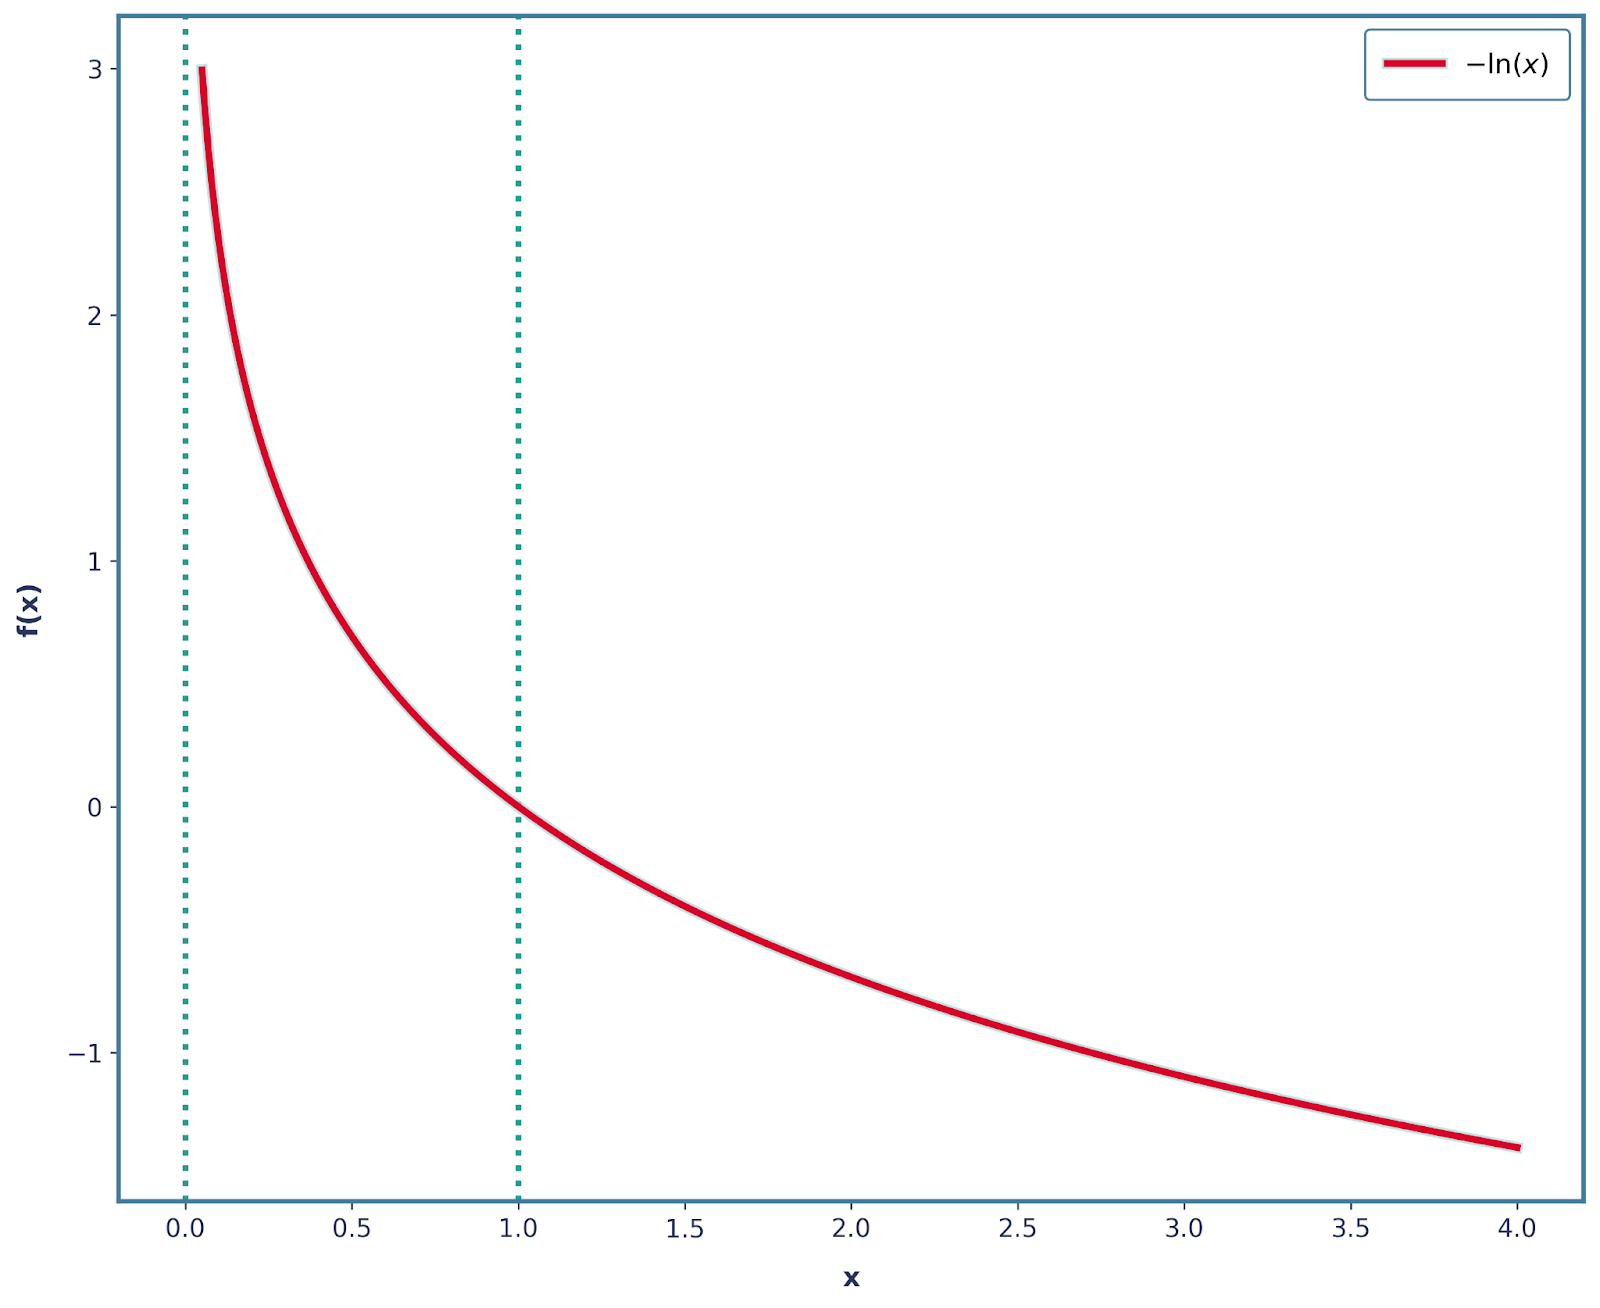
Ayrıca, diğer 3 özelliğin de bu değişiklikle hâlâ sağlandığını not etmek önemlidir. Dolayısıyla, şaşkınlığı matematiksel olarak şöyle tanımlayabiliriz:
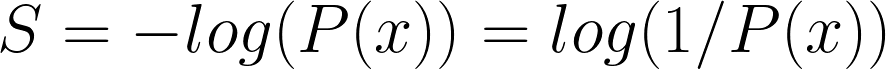
Makine öğreniminde yalnızca tek bir olayın şaşkınlığıyla değil, tüm olası olaylar arasındaki ortalama şaşkınlıkla ilgileniriz. Buna beklenen şaşkınlık denir. Daha özel olarak, dağılımın beklenen şaşkınlığını bulmakla ilgileniriz.
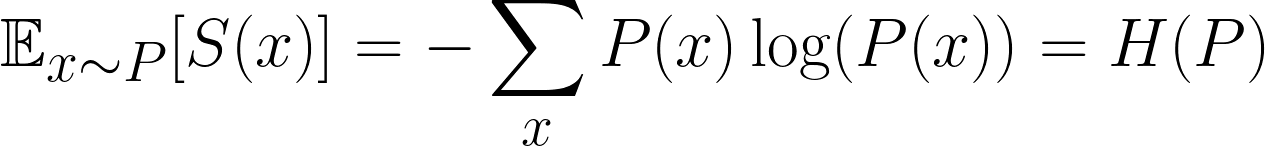
Bu meşhur bir formüldür ve beklenen şaşkınlıktır; daha yaygın adıyla Entropi. Ancak kafa karıştırıcı biçimde, dağılımlarımızı sıklıkla P ve Q ile gösteririz; bu nedenle olasılığı ifade eden p ile karıştırmayın!
Sezgisel olarak yaptığımız şey, her sonucun olasılığını onun şaşkınlığı ile çarpıp tüm olası sonuçlar üzerinden toplamaktır.
Bundan sonra, P(x)’in gerçek altta yatan dağılımımız olduğunu ve Q(x)’in P(x)’i yaklaştırmaya çalıştığımız dağılım (yani Q(X) “yanlış” dağılımdır) olduğunu söyleyeceğiz. Bu, makine öğreniminde çok yaygındır—modellerimiz sürekli olarak gerçek dünyayı tahmin etmeye çalışır.
Şimdi büyük soru geliyor:
Şaşkınlığı yanlış dağılımla hesaplarsak ne olur?
Şaşkınlığı hâlâ hesaplayabiliriz; ancak P(x) yerine, onu Q(x)’e göre ölçeriz. Bu bize yeni bir beklenti verir:
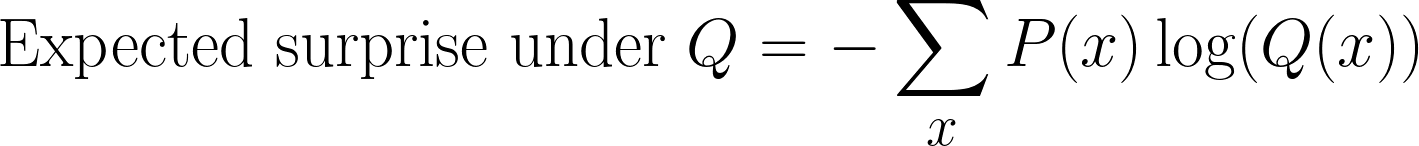
KL Ayrışımını türetirken bu adım çoğu zaman kafa karıştırıcıdır. Hâlâ P(x)’e göre örnekliyoruz (çünkü gerçek dağılım budur), ancak şaşkınlığı Q(x) (modelimizin inancı) ile ölçüyoruz.
Bu niceliğe bazen P(x) ile Q(x) arasındaki çapraz entropi denir.
Bu noktaya kadar iki nicelik tanımladık:
KL Ayrışımı formülünü elde etmek için, bu iki niceliği basitçe çıkarırız ve şunu elde ederiz:
Ve evet, aklınızdaki soru neden?
Şimdi şaşkınlık sezgisine geri dönelim.
Dolayısıyla bu nicelikleri çıkararak KL Ayrışımını hesapladığımızda, ne kadar ekstra şaşkınlık ödediğimizi, yani gerçek dağılım P(x) yerine yanlış dağılımı Q(x) kullandığımız için katlandığımız cezayı soruyoruz.
Şunu da not etmek önemlidir: Eğer Q(x) ile P(x) aynıysa, KL Ayrışımı 0 olur. Bu mantıklıdır—modelimizin tahminleri gerçek dağılımla mükemmel şekilde eşleşiyorsa, ekstra şaşkınlık yoktur ve dolayısıyla ceza da yoktur.
Bu, çapraz entropiden farklıdır; çünkü P(x) ile Q(x) eşit olduğunda sıfıra gitmez; sadece P(x)’in entropisine eşit olur.
Dolayısıyla, KL Ayrışımını sıfıra “demirlenmiş” olarak düşünebiliriz; yani yalnızca, tahmin edilen dağılımımız gerçek olandan sapmaya başladığında artar.
Denklemi türetmekte güzel iş çıkardınız! Kavramı pekiştirmek için bir örnek yapalım.
Bir kullanıcının en sevdiği film türünü tahmin etmekle görevlendirildiğimizi hayal edin. Geçmiş verilerden, dört film türü üzerindeki gerçek dağılım verilmiş (yani bu bizim P(x)’imizdir).
|
Film Türü |
Olasılık |
|
Aksiyon |
0.4 |
|
Komedi |
0.3 |
|
Dram |
0.2 |
|
Korku |
0.1 |
Şimdi birlikte, şu tahminleri yapan bir model kurduk (yani bu bizim Q(x)’imizdir).
|
Film Türü |
Olasılık |
|
Aksiyon |
0.3 |
|
Komedi |
0.4 |
|
Dram |
0.2 |
|
Korku |
0.1 |
Dağılımlar arasında açıkça bir fark var; peki ne kadar? Burada KL Ayrışımını, aşağıdaki denklemi kullanarak devreye sokacağız:
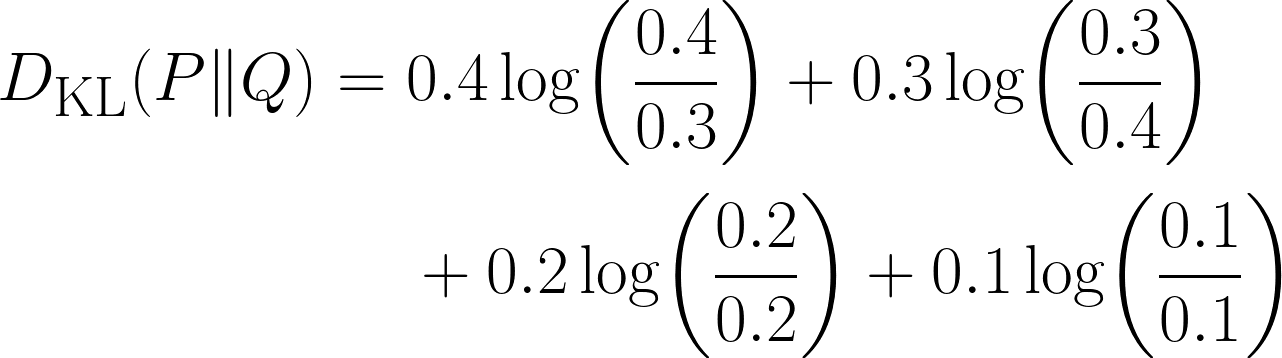
İki dağılımın belirli bir sonuç için aynı olasılığa sahip olduğu durumda terimin nasıl 0 olduğunu fark edin.
Yukarıdaki problemi Python kullanarak da çözebiliriz:
import numpy as np
from scipy.stats import entropy      # Important module from scipy

P = np.array([0.4, 0.3, 0.2, 0.1])   # This is our true distribution
Q = np.array([0.3, 0.4, 0.2, 0.1])   # This is our model’s prediction

kl_nats = entropy(P, Q)              # natural log ⇒ nats
kl_bits = entropy(P, Q, base=2)      # log₂ ⇒ bits

print(f"KL(P‖Q) = {kl_nats} nats")
print(f"KL(P‖Q) = {kl_bits} bits")
Bu kod, terimi hiçbir yerde KL Ayrışımı olarak adlandırmamış olmamız dışında oldukça basit ve sezgiseldir! Bunun yerine entropi ifadesini sıkça kullandım.
Bu bizi önemli bir noktaya getiriyor - KL Ayrışımı sıklıkla Göreli Entropi olarak adlandırılır. Dolayısıyla aslında KL Ayrışımını hesaplıyoruz; çünkü entropi modülü iki dağılım arasındaki göreli entropiyi hesaplıyor.
Bu kafa karıştırıcı görünüyor, bu yüzden kısa bir ara verip her şeyi özetlemek istiyorum:
|
Terim |
Gösterim |
Formül |
|
Entropi veya Shannon Entropisi |
H(P) |
−∑Pi logPi |
|
Çapraz Entropi |
H(P,Q) |
−∑Pi logQi |
|
KL Ayrışımı veya Göreli Entropi |
D_KL (P∥Q) |
−∑Pᵢ · log(Qᵢ/Pᵢ) ya da ∑Pi* log(Pi/Qi) |
KL Ayrışımı formülünü kullanarak ilk örneğimizi hesapladığımıza göre, şimdi de en önemli özelliklerinden bazılarını inceleyelim.
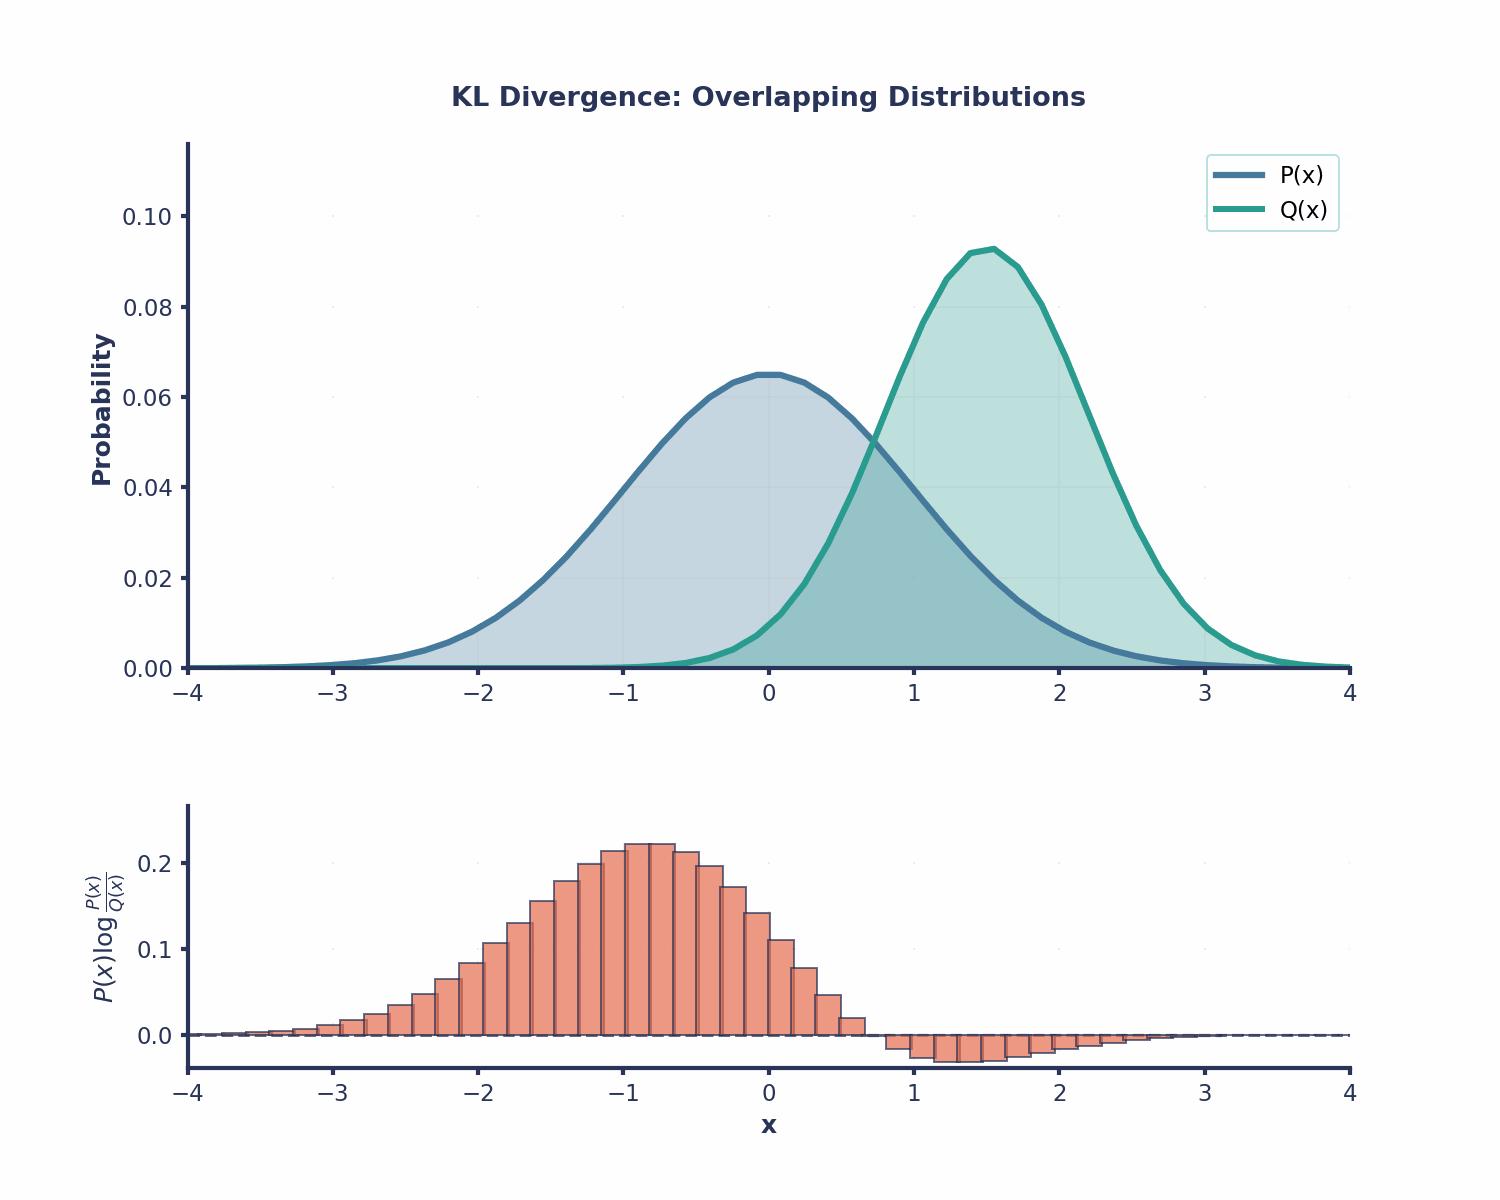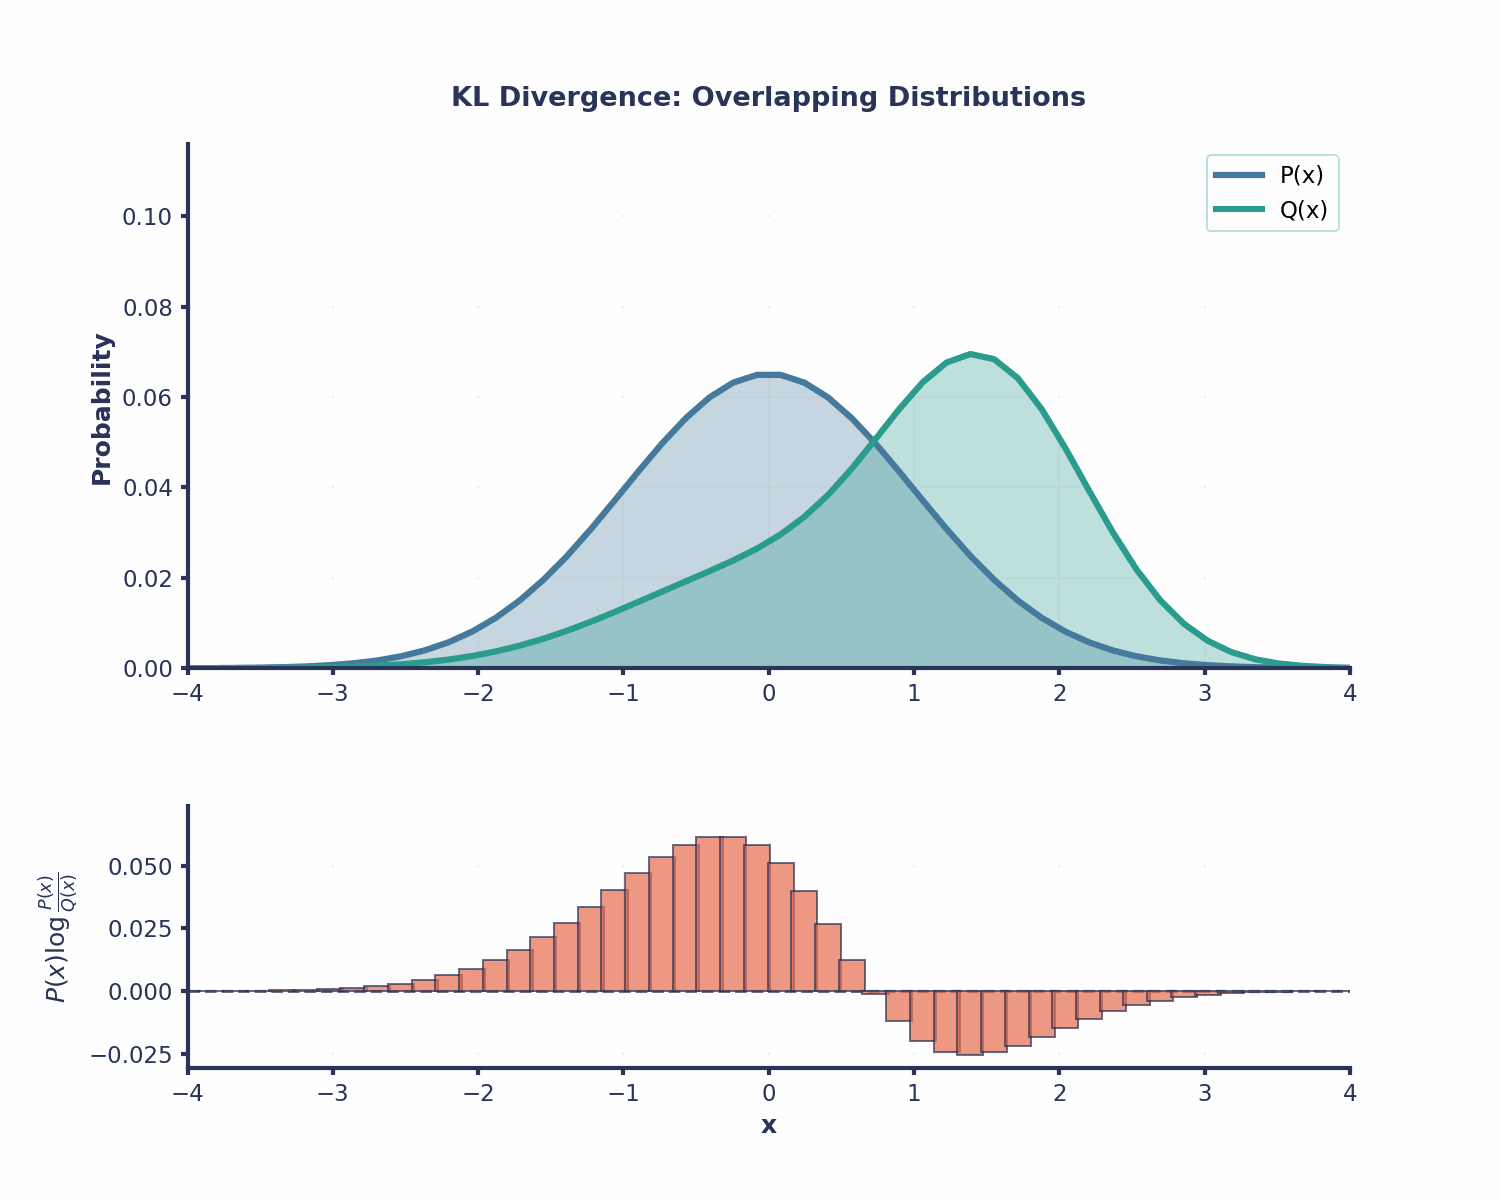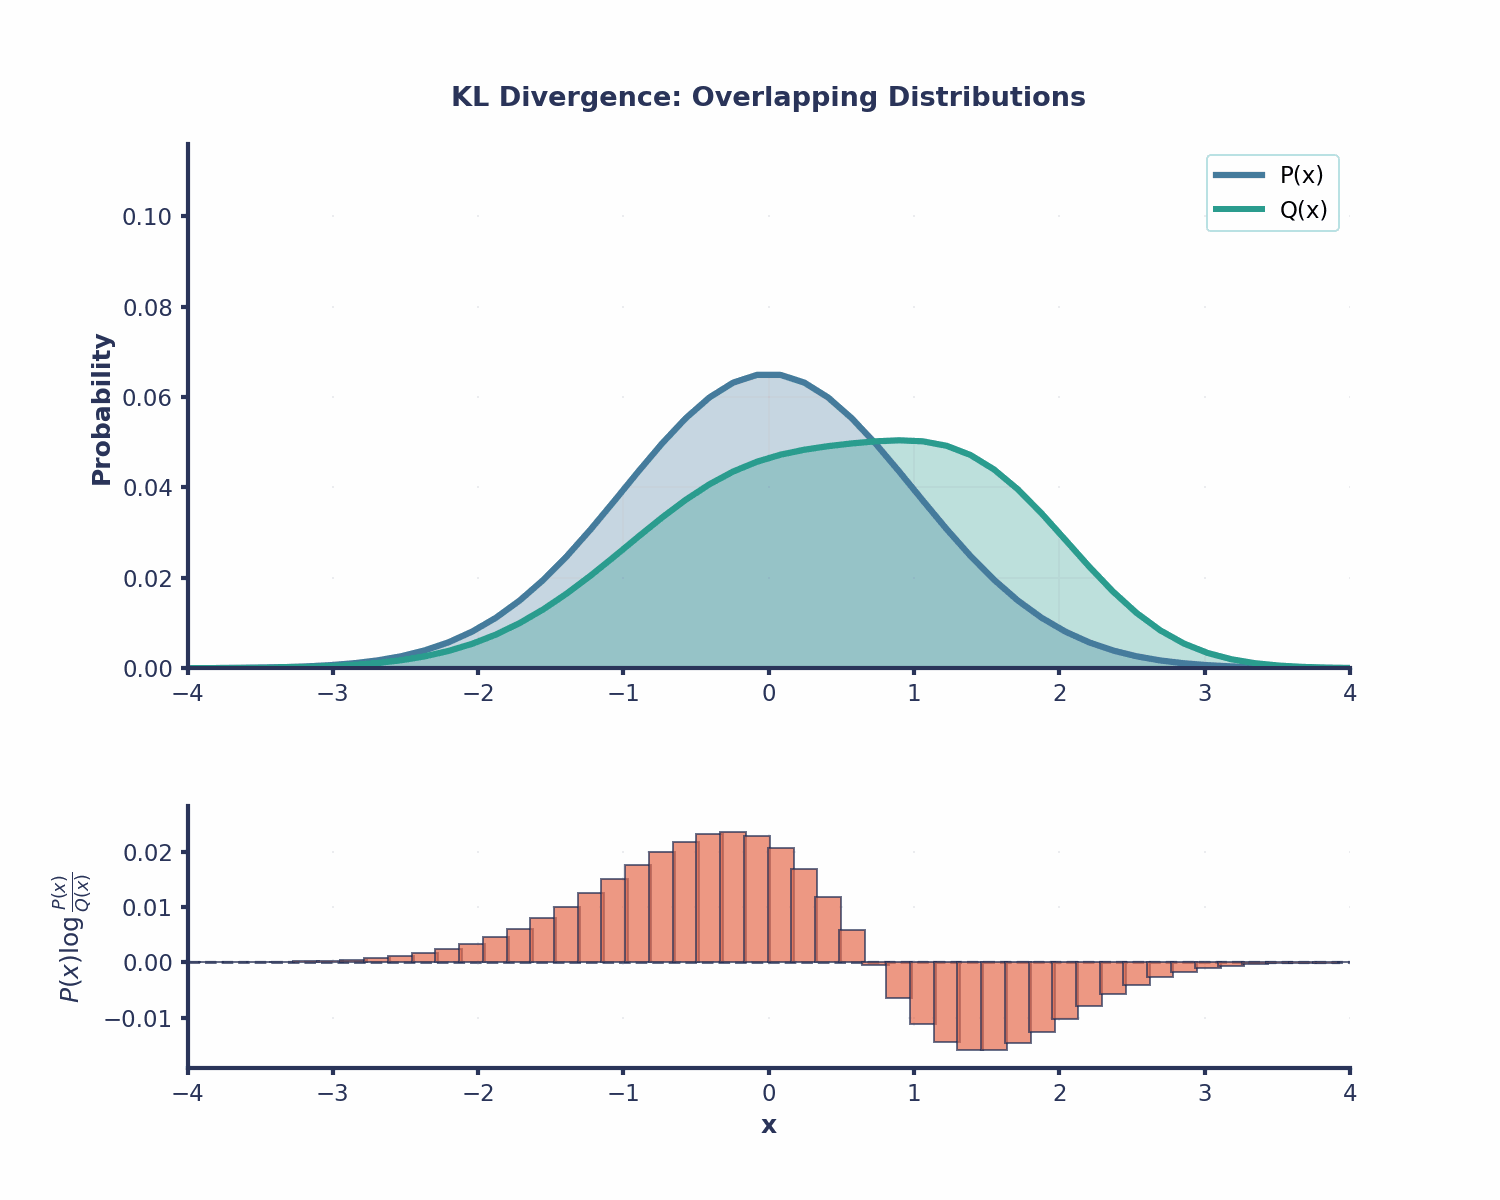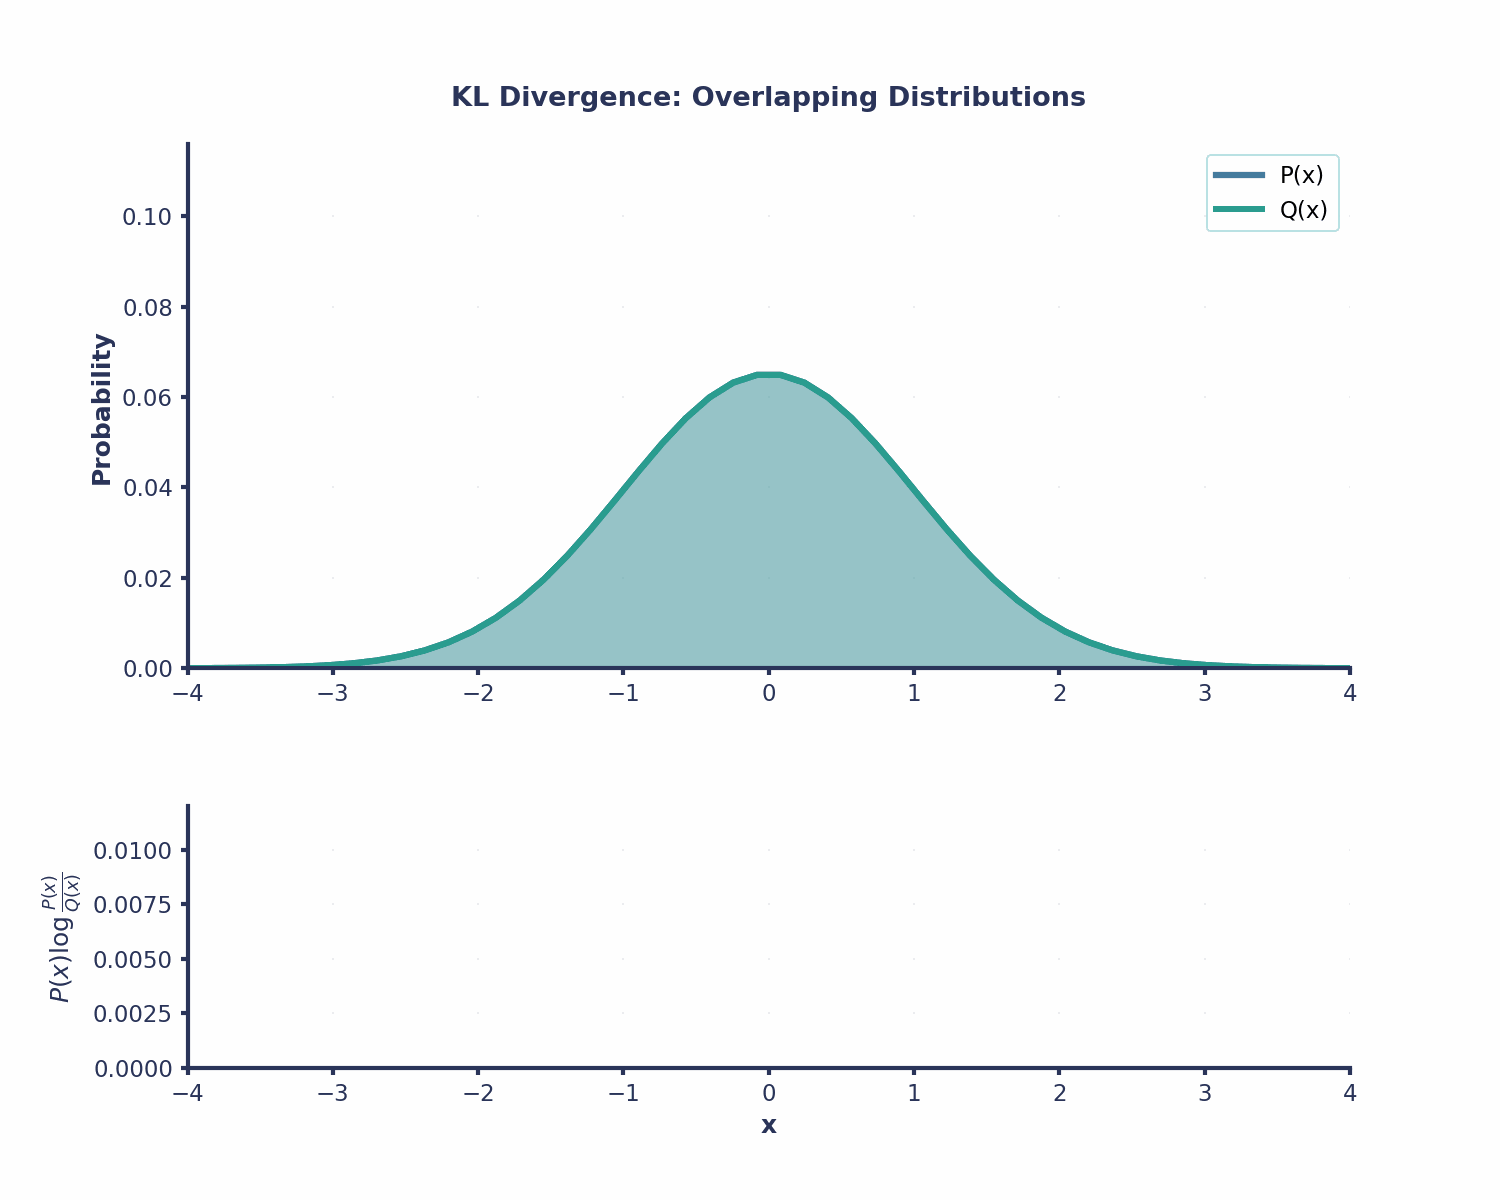
KL Ayrışımı, Makine Öğreniminin pek çok alanında kullanışlıdır:
KL Ayrışımı, model parametrelerini tahmin etmenin temel bir yöntemi olan En Yüksek Olabilirlik Tahmini (MLE) ile yakından ilişkilidir. MLE hakkında ve burada ele aldığımız kavramları nasıl tamamladığı hakkında daha fazla bilgi edinmek için ayrıntılı eğitimime göz atın: En Yüksek Olabilirlik Tahminine (MLE) Giriş.
Her şey gibi, KL Ayrışımının kullanımında da sınırlamalar vardır. Bunları ayrıntılı olarak inceleyelim:
Önceden Jensen–Shannon Ayrışımını andığımı fark etmiş olabilirsiniz; hızlıca üzerinden geçelim.
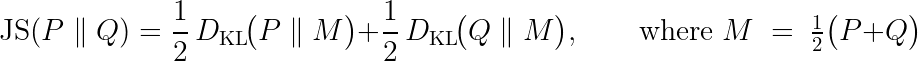
KL Ayrışımından biraz daha karmaşık ve hesaplama açısından daha ağır olmasına rağmen, Jensen–Shannon Ayrışımı simetriktir. Yine de üçgen eşitsizliğini sağlamadığı için gerçek bir uzaklık metriği değildir. Ancak JS Ayrışımının karekökünü alırsak üçgen eşitsizliği sağlanır ve uygun bir metrik haline gelir.
Ayrıca, KL ayrışımının yumuşatılmış bir sürümüdür ve her zaman 0 ile 1 bit arasında kalır (log tabanı 2 kullanırsak). Denkleme tekrar bakarsak, her bir KL terimi ortak orta nokta M’e göre ölçülür; ne P ne de Q asla sıfıra bölmez ve dolayısıyla sonsuzluk oluşmaz.
Kısacası, KL Ayrışımı, modelimizin dağılımı Q’yu gerçek dağılım P’nin yerine koyduğumuzda ortaya çıkan ek bilgi maliyetini ölçmek için kullandığımız önemli bir araçtır. Aynı olduklarında sıfıra iner; farklılaştıkça büyür ve her zaman negatiftir. KL Ayrışımı, entropi ve çapraz entropiyi birbirine bağlar; kayıp fonksiyonlarında, varyasyonel çıkarımda ve politika kısıtlarında karşımıza çıkar.
KL Ayrışımı harikadır, ancak yine de Makine Öğrenimi ve Derin Öğrenme ile ilgili problemlerle uğraşırken kullandığımız bir araçtır. Bunu daha ileri uygulayabilmek için Python ile Makine Öğrenimi Bilimcisi ve Makine Öğrenimi Mühendisi kariyer yollarımıza mutlaka göz atın; her ikisi de gözetimli, gözetimsiz ve derin öğrenmeyi ele alır.
KL Ayrışımını daha ileri Matematik kavramlarıyla ilişkilendirmeye hazırsanız, şu kaynaklara göz atın:
En İyi DataCamp Kursları
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




