随着机器学习技术以空前速度发展,变分自编码器(VAE)正在重塑我们处理与生成数据的方式。通过将强大的数据编码与创新的生成能力相结合,VAE 为该领域的复杂问题提供了具有变革意义的解决方案。
本文将逐步讲解 VAE 的核心概念、应用场景,以及如何使用 PyTorch 高效实现它们。
什么是变分自编码器?
自编码器是一类旨在学习高效数据表示的神经网络,主要用于降维 或特征学习 。
自编码器由两部分组成:
编码器 :将输入数据压缩到低维潜在空间。 解码器 :从该压缩表示中重构原始数据。
自编码器的主要目标是最小化输入与重构输出之间的差异,从而学习到数据的紧凑表示。
变分自编码器(VAE)在此基础上引入概率元素,扩展了传统自编码器 框架的能力。
标准自编码器将输入映射到固定的潜在表示,而 VAE 采用概率式方法:编码器输出潜在空间上的一个分布,通常建模为多元高斯 。这样,VAE 可以在解码过程中从该分布中采样,从而生成新的数据实例。
VAE 的关键创新在于通过学习结构化、连续的潜在空间来生成高质量的新数据。 这对生成式建模尤为重要,其目标不仅是压缩数据,更是创建与原始数据集相似的新样本。
VAE 在图像合成、数据去噪和异常检测等任务中表现出显著效果,使其成为提升机器学习模型与应用能力的有力工具。
变分自编码器的理论背景
本节将介绍 VAE 的理论背景与运行机制,为后续应用部分打下坚实基础。
先从编码器开始。编码器是一个神经网络 ,负责将输入数据映射到潜在空间。与传统自编码器在潜在空间中产生固定点不同,VAE 的编码器输出一个概率分布的参数——通常为高斯分布的均值与方差。这使 VAE 能有效建模数据的不确定性与变异性。
另一个称为解码器的神经网络用于从潜在空间表示中重构原始数据。给定从潜在分布采样的样本,解码器旨在生成与原始输入尽可能接近的输出。通过从已学习的分布中采样,VAE 便能创建新的数据实例。
潜在空间是一个低维、连续的空间,输入数据会被编码到其中。
编码器、解码器与潜在空间作用的可视化。图片来源 。
变分方法是一种用来近似复杂概率分布的技术。在 VAE 的语境中,它用于近似给定数据时潜在变量的真实后验分布,而该分布通常难以处理。
VAE 学习一个近似后验分布,目标是让该近似尽可能接近真实后验。
贝叶斯推断是一种随着更多证据或信息到来而更新假设概率估计的方法。在 VAE 中,贝叶斯推断用于估计潜在变量的分布。
通过将先验知识(先验分布)与观测数据(似然)相结合,VAE 通过学习到的后验分布来调整潜在空间表示。
包含先验分布、后验分布与似然函数的贝叶斯推断。图片来源 。
流程如下所示:
输入数据x q(z∣x) μ σ2
使用重参数化技巧等方法,从分布q(z∣x) z
将采样得到的z x̂ x
变分自编码器 vs 传统自编码器
让我们来看看 VAE 相较于传统自编码器的差异与优势。
架构对比
如前所述,传统自编码器包含一个将输入数据x 映射到固定、低维潜在表示z 的编码器网络。该过程是确定性的,即每个输入都会被编码为潜在空间中的一个特定点。
随后解码器网络从这个固定潜在表示中重构原始数据,目标是最小化输入与其重构之间的差异。
传统自编码器的潜在空间仅是输入数据的压缩表示,缺乏概率建模能力,这限制了其生成新的多样化数据的能力,因为它缺少处理不确定性的机制。
自编码器架构。图片作者自制
VAE 在编码过程中引入概率元素。具体而言,VAE 的编码器将输入数据映射为潜在变量上的一个概率分布,通常建模为具有 均值μ σ2 .
这种方法将每个输入编码为一个分布而非单个点,增加了变异性与不确定性。
从结构上看,传统自编码器是确定性映射,而 VAE 则是概率编码与采样,这一差异可直观呈现。
该结构差异也表明 VAE 通过名为 KL 散度的正则项对潜在空间进行约束,使其连续且结构良好。
这种正则化显著提升了生成样本的质量与一致性,优于传统自编码器。
变分自编码器架构。图片作者自制
应用对比
由于具备概率特性,VAE 的应用范围远超传统自编码器。相比之下,传统自编码器更适用于确定性数据表示足够的场景。
下面通过各自的若干应用来更具体地说明这一点。
VAE 的应用
生成式建模 。VAE 的核心优势在于能够生成与训练数据相似但不与任何特定样本完全相同的新数据。例如,在图像合成中,VAE 可以创建与训练集相似但具备变化的新图像,可用于创作新艺术作品、生成逼真的人脸,或在时尚与建筑中产出新设计。 异常检测。 通过学习正常数据的分布,VAE 能将偏离该分布的样本识别为异常。这在欺诈检测、网络安全、预测性维护等领域尤为有用。 数据插补与去噪。 VAE 擅长重构含缺失或噪声的数据。通过从学习到的潜在分布中采样,它们能够预测并填补缺失值或从受损数据中去除噪声。这在医疗影像中尤为重要,或用于修复受损的音视频数据。 半监督学习。 在半监督场景中,VAE 可利用潜在空间捕捉数据的潜在结构,从而在标注数据有限的情况下提升分类器性能。 潜在空间操控。 VAE 提供结构化、连续的潜在空间,可用于多种应用中的操控。例如,在图像编辑中,可通过在潜在空间中导航来调整特定特征(如光照或表情)。这一特性在创意行业中对图像与视频的修改和增强尤为实用。
传统自编码器的应用
降维 。传统自编码器广泛用于降低数据维度。通过将数据编码到低维潜在空间并再重构,它们能捕捉数据中最重要的特征。这适用于数据可视化(如将高维数据投影到二维或三维),以及作为其他机器学习模型的预处理步骤,以提升性能并降低计算成本。 特征提取。 通过训练编码器捕捉输入数据的关键方面,其潜在表示可作为紧凑的特征向量用于下游任务,如分类、聚类与回归。这在图像识别等应用中尤为有益,潜在空间能揭示重要的视觉模式。 去噪。 传统自编码器可以通过从带噪版本中学习重构干净输入来实现降噪。这在图像处理(提升图像观感)与信号处理(提升音频清晰度)等场景中很有价值。 数据压缩。 紧凑的潜在向量相比原始高维数据更易于存储或传输,且在需要时可通过解码器重构数据。这在图像与视频压缩等应用中尤为实用。 图像重构与修复(inpainting)。 传统自编码器可用于重构图像的缺失部分。在图像修复任务中,自编码器被训练为根据周围像素的上下文填补图像中缺失或受损的区域,这在计算机视觉与数字修复等领域很有用。 序列学习。 自编码器可通过引入循环或卷积层来适配序列数据,进而捕捉时间依赖与模式,适用于文本生成、语音合成与金融预测等应用。
变分自编码器的类型
为解决机器学习中的不同挑战与应用,VAE 已发展出多种专门化形式。本节将介绍其中最突出的类型,并概述其使用场景、优势与局限。
条件变分自编码器
条件变分自编码器(CVAE)是 VAE 的一种专门形式,通过引入条件信息来增强生成过程。
通过在编码器与解码器中同时引入额外信息c ,VAE 即成为条件模型。该条件信息可以是任何相关数据,如类别标签、属性或其他上下文数据。
CVAE 模型结构。图片来源 。
CVAEs 的使用场景包括:
可控数据生成。 例如,在图像生成中,CVAE 可基于给定的标签或描述生成特定目标或场景的图像。 图像到图像的翻译。 CVAE 能在保持特定属性的同时,将图像从一个域转换到另一个域。例如,将黑白图像转换为彩色图像,或将草图转换为逼真的照片。 文本生成。 CVAEs 可基于特定提示或主题生成文本,适用于故事生成、聊天机器人回复以及个性化内容创作等任务。
其优缺点包括:
对生成数据的更精细控制 改进的表示学习 更高的过拟合风险
其他变体
解耦变分自编码器(常称 Beta-VAE)是另一类专门化 VAE。其目标是在潜在表示中让各维度分别捕捉数据中独立、可解释的变化因素。方法是在原始 VAE 目标中引入超参数β ,以平衡重构损失与 KL 散度项。
Beta-VAE 的优缺点:
提升潜在因子的可解释性。 增强对生成数据中单个特征的操控能力。 需要对β 参数进行仔细调节。
若两项间平衡不佳,可能导致重构质量下降。
另一种变体是 对抗自编码器 ( AAE )。AAE 将 VAE 框架与生成对抗网络(GAN)的对抗训练原则相结合。增加一个判别器网络,以确保潜在表示匹配某个先验分布,从而增强模型的生成能力。
AAE 的优缺点:
能生成高质量且逼真的数据样本。 在潜在空间正则化方面效果显著。 由于引入对抗组件,训练复杂度提高。
可能面临与 GAN 类似的训练稳定性问题。
接下来,我们再看看 VAE 的两个扩展。
其一是 变分循环自编码器(VRAE) 。VRAE 通过在编码器与解码器中引入循环神经网络(RNN),将 VAE 框架扩展到序列数据,从而捕捉时间依赖与序列模式。
VRAE 的优缺点:
擅长处理时间序列数据与序列模式。 适用于语音合成、音乐生成与时间序列预测等应用。 由于模型的循环特性,计算需求更高。
最后一种要介绍的变体是 层次变分自编码器(HVAE) 。HVAE 在层次结构中引入多层潜在变量,使模型能够捕捉数据中更复杂的依赖关系与抽象概念。
HVAE 的优缺点:
能够对具有层次结构的复杂数据分布进行建模。 提供更具表达力的潜在表示。 模型复杂度与计算成本上升。
使用 PyTorch 实现变分自编码器
本节我们将使用 PyTorch 实现一个简单的变分自编码器(VAE)。
1. 环境配置
要实现 VAE,我们需要配置包含必要库与工具的 Python 环境。将使用的库包括:
PyTorch torchvision matplotlib numpy
安装这些库的代码如下:
pip install torch torchvision matplotlib numpy技术支持 2. 实现
我们按步骤完成 VAE 的实现。首先,导入相关库:
import torch
import torch. nn as nn
import torch. optim as optim
from torchvision import datasets, transforms
from torch. utils. data import DataLoader
import matplotlib. pyplot as plt
import numpy as np技术支持 接着定义编码器、解码器与 VAE。代码如下:
class Encoder ( nn. Module) :
def __init__ ( self, input_dim, hidden_dim, latent_dim) :
super ( Encoder, self) . __init__( )
self. fc1 = nn. Linear( input_dim, hidden_dim)
self. fc_mu = nn. Linear( hidden_dim, latent_dim)
self. fc_logvar = nn. Linear( hidden_dim, latent_dim)
def forward ( self, x) :
h = torch. relu( self. fc1( x) )
mu = self. fc_mu( h)
logvar = self. fc_logvar( h)
return mu, logvar
class Decoder ( nn. Module) :
def __init__ ( self, latent_dim, hidden_dim, output_dim) :
super ( Decoder, self) . __init__( )
self. fc1 = nn. Linear( latent_dim, hidden_dim)
self. fc2 = nn. Linear( hidden_dim, output_dim)
def forward ( self, z) :
h = torch. relu( self. fc1( z) )
x_hat = torch. sigmoid( self. fc2( h) )
return x_hat
class VAE ( nn. Module) :
def __init__ ( self, input_dim, hidden_dim, latent_dim) :
super ( VAE, self) . __init__( )
self. encoder = Encoder( input_dim, hidden_dim, latent_dim)
self. decoder = Decoder( latent_dim, hidden_dim, input_dim)
def forward ( self, x) :
mu, logvar = self. encoder( x)
std = torch. exp( 0.5 * logvar)
eps = torch. randn_like( std)
z = mu + eps * std
x_hat = self. decoder( z)
return x_hat, mu, logvar技术支持 还需要定义损失函数。VAE 的损失由重构损失与 KL 散度损失构成。在 PyTorch 中可这样实现:
def loss_function ( x, x_hat, mu, logvar) :
BCE = nn. functional. binary_cross_entropy( x_hat, x, reduction= 'sum' )
KLD = - 0.5 * torch. sum ( 1 + logvar - mu. pow ( 2 ) - logvar. exp( ) )
return BCE + KLD技术支持 为训练 VAE,我们将加载MNIST 数据集 、定义优化器并训练模型。
input_dim = 784
hidden_dim = 400
latent_dim = 20
lr = 1e-3
batch_size = 128
epochs = 10
transform = transforms. Compose( [ transforms. ToTensor( ) , transforms. Lambda( lambda x: x. view( - 1 ) ) ] )
train_dataset = datasets. MNIST( root= './data' , train= True , transform= transform, download= True )
train_loader = DataLoader( train_dataset, batch_size= batch_size, shuffle= True )
vae = VAE( input_dim, hidden_dim, latent_dim)
optimizer = optim. Adam( vae. parameters( ) , lr= lr)
vae. train( )
for epoch in range ( epochs) :
train_loss = 0
for x, _ in train_loader:
x = x. view( - 1 , input_dim)
optimizer. zero_grad( )
x_hat, mu, logvar = vae( x)
loss = loss_function( x, x_hat, mu, logvar)
loss. backward( )
train_loss += loss. item( )
optimizer. step( )
print ( f"Epoch { epoch + 1 } , Loss: { train_loss / len ( train_loader. dataset) } " ) 技术支持 3. 测试与评估模型
训练完成后,我们可以通过可视化重构输出与生成样本来评估 VAE。
代码如下:
vae. eval ( )
with torch. no_grad( ) :
x, _ = next ( iter ( train_loader) )
x = x. view( - 1 , input_dim)
x_hat, _, _ = vae( x)
x = x. view( - 1 , 28 , 28 )
x_hat = x_hat. view( - 1 , 28 , 28 )
fig, axs = plt. subplots( 2 , 10 , figsize= ( 15 , 3 ) )
for i in range ( 10 ) :
axs[ 0 , i] . imshow( x[ i] . cpu( ) . numpy( ) , cmap= 'gray' )
axs[ 1 , i] . imshow( x_hat[ i] . cpu( ) . numpy( ) , cmap= 'gray' )
axs[ 0 , i] . axis( 'off' )
axs[ 1 , i] . axis( 'off' )
plt. show( )
with torch. no_grad( ) :
z = torch. randn( 10 , latent_dim)
sample = vae. decoder( z)
sample = sample. view( - 1 , 28 , 28 )
fig, axs = plt. subplots( 1 , 10 , figsize= ( 15 , 3 ) )
for i in range ( 10 ) :
axs[ i] . imshow( sample[ i] . cpu( ) . numpy( ) , cmap= 'gray' )
axs[ i] . axis( 'off' )
plt. show( ) 技术支持
输出可视化。第一行是原始 MNIST 数据,中间一行是重构输出,最后一行是生成样本——图片作者自制。
变分自编码器的挑战与应对
尽管变分自编码器(VAE)是强大的生成式建模工具,但也存在若干挑战与局限,可能影响其性能。下面讨论其中一些问题,并给出缓解策略。
模式崩塌(mode collapse)
即 VAE 未能捕捉数据分布的完整多样性,导致生成样本只代表分布中的少数模式(不同区域),而忽略其他模式,从而使生成输出缺乏多样性。
模式崩塌的成因包括:
潜在空间探索不足: 若训练期间对潜在空间的探索不足,模型可能只学到来自少数区域的样本。 训练数据不足: 受限或缺乏代表性的训练数据会使模型对特定模式过拟合。
缓解模式崩塌的方法包括:
正则化技术: 使用 dropout、批归一化等技术有助于提升泛化能力并减少模式崩塌。 改进训练算法: 重要性加权自编码器(IWAE)可提供更好的梯度估计,改进对潜在空间的探索。
潜在空间信息不足
有时 VAE 学到的潜在空间可能变得信息不足,即模型未能有效利用潜在变量去捕捉输入数据中的有意义特征,导致生成样本与重构质量较差。
常见原因包括:
损失项不平衡: 重构损失与 KL 散度之间的权衡不当,可能导致潜在变量被忽视。 后验坍缩: 编码器学习到的后验分布与先验非常接近,造成潜在空间中的信息丢失。
可通过“热身”策略缓解,即在训练过程中逐步增加 KL 散度的权重,或直接调整损失函数中 KL 散度项的权重。
训练不稳定
VAE 的训练有时不稳定,损失函数可能震荡或发散,导致难以收敛并获得良好训练的模型。
原因包括:
复杂的损失地形: VAE 的损失函数结合了重构与正则两项,优化地形复杂。 对超参数敏感: VAE 对学习率、KL 散度权重、网络结构等超参数较为敏感。
缓解训练不稳定的步骤包括:
仔细调参: 系统性地探索超参数,找到稳定的训练配置。 高级优化器: 使用如 Adam 等自适应学习率优化器,更有效地应对复杂损失地形。
计算成本
在处理大型且复杂的数据集时,训练 VAE 的计算成本可能较高,这是由于需要在随机层中进行采样并通过其反向传播。
高计算成本的原因包括:
大型网络: 编码器与解码器可能变得庞大而深,增加计算负担。 潜在空间采样: 从潜在空间采样并对这些样本计算梯度会增加计算成本。
可采取的缓解措施包括:
模型简化: 降低编码器与解码器的复杂度以减少计算成本。 高效采样技术: 采用更高效的采样方法或近似,降低计算负载。
结语
变分自编码器(VAE)已被证明是机器学习与数据生成领域的突破性进展。
通过在传统自编码器框架中引入概率元素,VAE 不仅能生成高质量的新数据,还能提供更为结构化、连续的潜在空间。这一独特能力开启了广泛的应用场景,从生成式建模、异常检测到数据插补与半监督学习等。
本文介绍了变分自编码器的基础、不同类型、如何在 PyTorch 中实现 VAE,以及在使用 VAE 时面临的挑战与应对之道。
继续学习,您可以参考以下资源:


随着机器学习技术以空前速度发展,变分自编码器(VAE)正在重塑我们处理与生成数据的方式。通过将强大的数据编码与创新的生成能力相结合,VAE 为该领域的复杂问题提供了具有变革意义的解决方案。
本文将逐步讲解 VAE 的核心概念、应用场景,以及如何使用 PyTorch 高效实现它们。
什么是变分自编码器?
自编码器是一类旨在学习高效数据表示的神经网络,主要用于降维或特征学习。
自编码器由两部分组成:
自编码器的主要目标是最小化输入与重构输出之间的差异,从而学习到数据的紧凑表示。
变分自编码器(VAE)在此基础上引入概率元素,扩展了传统自编码器框架的能力。
标准自编码器将输入映射到固定的潜在表示,而 VAE 采用概率式方法:编码器输出潜在空间上的一个分布,通常建模为多元高斯。这样,VAE 可以在解码过程中从该分布中采样,从而生成新的数据实例。
VAE 的关键创新在于通过学习结构化、连续的潜在空间来生成高质量的新数据。这对生成式建模尤为重要,其目标不仅是压缩数据,更是创建与原始数据集相似的新样本。
VAE 在图像合成、数据去噪和异常检测等任务中表现出显著效果,使其成为提升机器学习模型与应用能力的有力工具。
变分自编码器的理论背景
本节将介绍 VAE 的理论背景与运行机制,为后续应用部分打下坚实基础。
先从编码器开始。编码器是一个神经网络,负责将输入数据映射到潜在空间。与传统自编码器在潜在空间中产生固定点不同,VAE 的编码器输出一个概率分布的参数——通常为高斯分布的均值与方差。这使 VAE 能有效建模数据的不确定性与变异性。
另一个称为解码器的神经网络用于从潜在空间表示中重构原始数据。给定从潜在分布采样的样本,解码器旨在生成与原始输入尽可能接近的输出。通过从已学习的分布中采样,VAE 便能创建新的数据实例。
潜在空间是一个低维、连续的空间,输入数据会被编码到其中。
编码器、解码器与潜在空间作用的可视化。图片来源。
变分方法是一种用来近似复杂概率分布的技术。在 VAE 的语境中,它用于近似给定数据时潜在变量的真实后验分布,而该分布通常难以处理。
VAE 学习一个近似后验分布,目标是让该近似尽可能接近真实后验。
贝叶斯推断是一种随着更多证据或信息到来而更新假设概率估计的方法。在 VAE 中,贝叶斯推断用于估计潜在变量的分布。
通过将先验知识(先验分布)与观测数据(似然)相结合,VAE 通过学习到的后验分布来调整潜在空间表示。
包含先验分布、后验分布与似然函数的贝叶斯推断。图片来源。
流程如下所示:
变分自编码器 vs 传统自编码器
让我们来看看 VAE 相较于传统自编码器的差异与优势。
架构对比
如前所述,传统自编码器包含一个将输入数据x映射到固定、低维潜在表示z的编码器网络。该过程是确定性的,即每个输入都会被编码为潜在空间中的一个特定点。
随后解码器网络从这个固定潜在表示中重构原始数据,目标是最小化输入与其重构之间的差异。
传统自编码器的潜在空间仅是输入数据的压缩表示,缺乏概率建模能力,这限制了其生成新的多样化数据的能力,因为它缺少处理不确定性的机制。
自编码器架构。图片作者自制
VAE 在编码过程中引入概率元素。具体而言,VAE 的编码器将输入数据映射为潜在变量上的一个概率分布,通常建模为具有均值μ 与方差σ2.
这种方法将每个输入编码为一个分布而非单个点,增加了变异性与不确定性。
从结构上看,传统自编码器是确定性映射,而 VAE 则是概率编码与采样,这一差异可直观呈现。
该结构差异也表明 VAE 通过名为 KL 散度的正则项对潜在空间进行约束,使其连续且结构良好。
这种正则化显著提升了生成样本的质量与一致性,优于传统自编码器。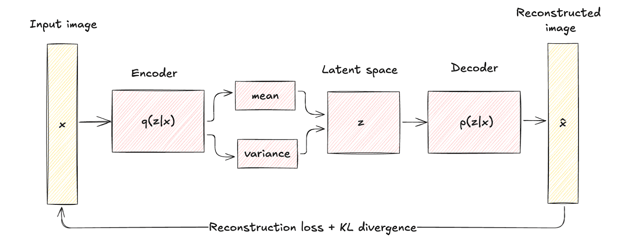
变分自编码器架构。图片作者自制
应用对比
由于具备概率特性,VAE 的应用范围远超传统自编码器。相比之下,传统自编码器更适用于确定性数据表示足够的场景。
下面通过各自的若干应用来更具体地说明这一点。
VAE 的应用
传统自编码器的应用
变分自编码器的类型
为解决机器学习中的不同挑战与应用,VAE 已发展出多种专门化形式。本节将介绍其中最突出的类型,并概述其使用场景、优势与局限。
条件变分自编码器
条件变分自编码器(CVAE)是 VAE 的一种专门形式,通过引入条件信息来增强生成过程。
通过在编码器与解码器中同时引入额外信息c,VAE 即成为条件模型。该条件信息可以是任何相关数据,如类别标签、属性或其他上下文数据。
CVAE 模型结构。图片来源。
CVAEs 的使用场景包括:
其优缺点包括:
其他变体
解耦变分自编码器(常称 Beta-VAE)是另一类专门化 VAE。其目标是在潜在表示中让各维度分别捕捉数据中独立、可解释的变化因素。方法是在原始 VAE 目标中引入超参数β,以平衡重构损失与 KL 散度项。
Beta-VAE 的优缺点:
另一种变体是对抗自编码器(AAE)。AAE 将 VAE 框架与生成对抗网络(GAN)的对抗训练原则相结合。增加一个判别器网络,以确保潜在表示匹配某个先验分布,从而增强模型的生成能力。
AAE 的优缺点:
接下来,我们再看看 VAE 的两个扩展。
其一是变分循环自编码器(VRAE)。VRAE 通过在编码器与解码器中引入循环神经网络(RNN),将 VAE 框架扩展到序列数据,从而捕捉时间依赖与序列模式。
VRAE 的优缺点:
最后一种要介绍的变体是层次变分自编码器(HVAE)。HVAE 在层次结构中引入多层潜在变量,使模型能够捕捉数据中更复杂的依赖关系与抽象概念。
HVAE 的优缺点:
使用 PyTorch 实现变分自编码器
本节我们将使用 PyTorch 实现一个简单的变分自编码器(VAE)。
1. 环境配置
要实现 VAE,我们需要配置包含必要库与工具的 Python 环境。将使用的库包括:
安装这些库的代码如下:
2. 实现
我们按步骤完成 VAE 的实现。首先,导入相关库:
接着定义编码器、解码器与 VAE。代码如下:
还需要定义损失函数。VAE 的损失由重构损失与 KL 散度损失构成。在 PyTorch 中可这样实现:
为训练 VAE,我们将加载MNIST 数据集、定义优化器并训练模型。
3. 测试与评估模型
训练完成后,我们可以通过可视化重构输出与生成样本来评估 VAE。
代码如下:
输出可视化。第一行是原始 MNIST 数据,中间一行是重构输出,最后一行是生成样本——图片作者自制。
变分自编码器的挑战与应对
尽管变分自编码器(VAE)是强大的生成式建模工具,但也存在若干挑战与局限,可能影响其性能。下面讨论其中一些问题,并给出缓解策略。
模式崩塌(mode collapse)
即 VAE 未能捕捉数据分布的完整多样性,导致生成样本只代表分布中的少数模式(不同区域),而忽略其他模式,从而使生成输出缺乏多样性。
模式崩塌的成因包括:
缓解模式崩塌的方法包括:
潜在空间信息不足
有时 VAE 学到的潜在空间可能变得信息不足,即模型未能有效利用潜在变量去捕捉输入数据中的有意义特征,导致生成样本与重构质量较差。
常见原因包括:
可通过“热身”策略缓解,即在训练过程中逐步增加 KL 散度的权重,或直接调整损失函数中 KL 散度项的权重。
训练不稳定
VAE 的训练有时不稳定,损失函数可能震荡或发散,导致难以收敛并获得良好训练的模型。
原因包括:
缓解训练不稳定的步骤包括:
计算成本
在处理大型且复杂的数据集时,训练 VAE 的计算成本可能较高,这是由于需要在随机层中进行采样并通过其反向传播。
高计算成本的原因包括:
可采取的缓解措施包括:
结语
变分自编码器(VAE)已被证明是机器学习与数据生成领域的突破性进展。
通过在传统自编码器框架中引入概率元素,VAE 不仅能生成高质量的新数据,还能提供更为结构化、连续的潜在空间。这一独特能力开启了广泛的应用场景,从生成式建模、异常检测到数据插补与半监督学习等。
本文介绍了变分自编码器的基础、不同类型、如何在 PyTorch 中实现 VAE,以及在使用 VAE 时面临的挑战与应对之道。
继续学习,您可以参考以下资源: