

什么是 Kolmogorov-Arnold 网络(KAN)?
Kolmogorov-Arnold 网络(KAN)基于 Kolmogorov-Arnold 表示定理,这一定理是其数学基础。该定理指出,任何连续的多变量函数都可以分解为若干更简单的一元函数之和。
不过,尽管定理保证了这些一元函数的存在,但并未告诉我们如何找到它们。这正是 KAN 发挥作用的地方。
与多数模型直接近似整个复杂函数不同,KAN 专注于学习这些更简单的一元函数。这种方法不仅灵活,而且在处理数据中的非线性关系时具有高度可解释性。
Kolmogorov-Arnold 网络(KAN)与多层感知机(MLP)的对比
KAN 与传统多层感知机(MLP)的主要区别在于学习发生的方式。
在 MLP 中,神经元通过诸如 ReLU 或 sigmoid 等固定函数激活,然后这些激活通过线性权重矩阵传播。相较之下,KAN 将可学习的激活函数放在神经元之间的边(连接)上,而不是神经元本身。在最初的实现中,这些函数用 B 样条参数化,不过作者也提到,根据具体问题,还可以使用其他类型的函数,例如切比雪夫多项式。
无论是浅层还是深层 KAN,都将复杂函数分解为一系列更简单的一元函数。下图突出显示了这种架构差异:MLP 在神经元内使用固定激活,而 KAN 则在边上实现可学习函数,并在节点上对其求和。这一架构转变使 KAN 能够对数据进行动态适配,相比 MLP 可能以更少的参数实现更高的准确性。此外,训练完成后,如果并非所有边都用于近似,还可以缩小模型规模。
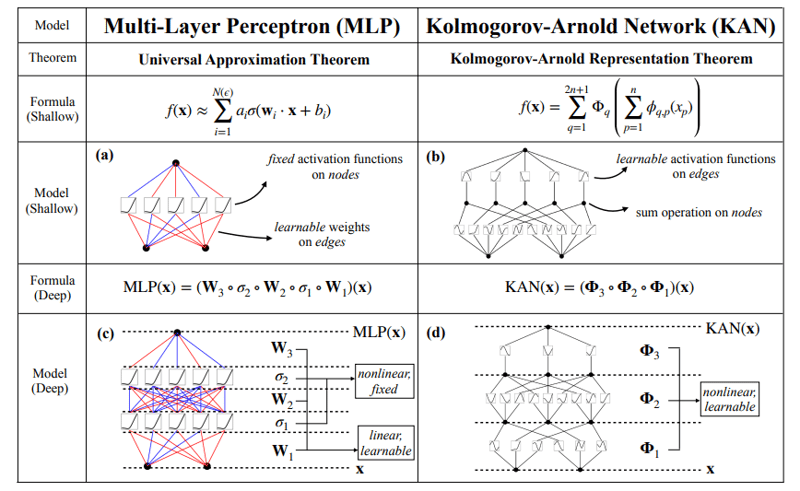
来源:Liu 等,2024
此外,训练完成后,KAN 允许我们提取已学习的一元函数,从而能够重构所得的多变量函数。这一特性在强调可解释性时尤为有用。我们将在后面的示例部分展示这一过程。
pip install git+https://github.com/KindXiaoming/pykan.git用法
安装 pykan 后,我们可以开始导入必要的模块并定义一个简单的 KAN:
from kan import *
model = KAN(width=[2,5,1])这里,我们在 width 参数中指定模型的维度。在此示例中,我们构建了一个具有 2 个输入、1 个输出以及包含 5 个隐藏神经元的层的模型。现在,让我们为实验创建一个数据集。我将使用一个随手构造的随机二元多项式:
from kan.utils import create_dataset
f = lambda x: 3*x[:,[0]]**3+2*x[:,[0]]+4 + 2 * x[:,[0]] * x[:,[1]] ** 2 + 3 * x[:,[1]] ** 3
dataset = create_dataset(f, n_var=2)这里我用一个 lambda 函数来定义多项式。该库似乎在底层使用 numpy——因此语法如此。现在,我们可以将数据集喂入模型并进行可视化:
model(dataset['train_input']);
model.plot()输出如下所示:
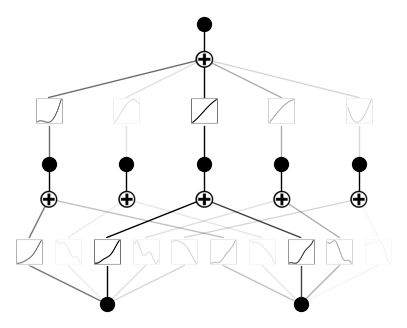
训练
要进行训练,我们需要使用 .fit() 方法:
model.fit(dataset, steps=1000);训练完成后,我们的 KAN 如下所示:
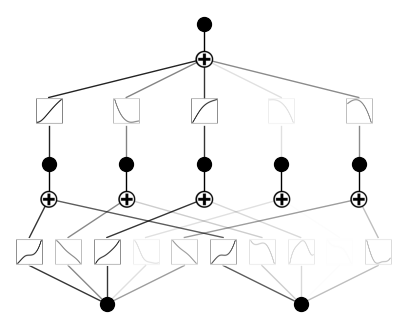
现在,我们来剪枝并再次绘图:
model = model.prune()
model.plot()此时模型如下所示。可以看到,我们剪除了一个激活函数:
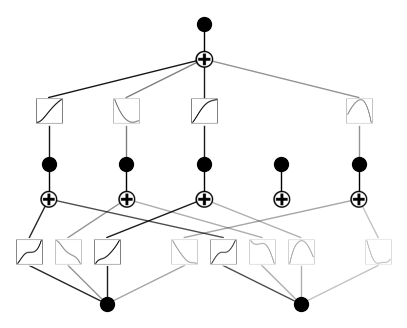
这很合理,因为我们的多项式并未使用输入变量幂的五种不同组合。
KAN 的应用场景
得益于以更少的参数建模复杂非线性关系的能力,Kolmogorov-Arnold 网络(KAN)在多个领域展现出潜力。以下是一些关键用例:
- 科学建模与数据拟合:KAN 尤其适用于需要精确建模复杂函数的科学问题。由于 KAN 通过学习更简单的一元函数来近似多变量函数,它们能够高效捕捉科学数据中的复杂模式。在曲线拟合等任务中,凭借灵活的架构,KAN 往往优于传统 MLP。
- 求解偏微分方程(PDE):KAN 在求解 PDE 方面展现出强大潜力。PDE 常用于物理与工程中对热传导、流体力学等过程建模。其处理高维、非线性问题的能力使其在该领域尤为有用,在准确性与可解释性方面超越 MLP。
- 符号回归:KAN 在符号回归任务中表现出色,目标是找出最能描述数据集的数学表达式。其学习组合结构的能力,使之成为直接从数据中重新发现物理和数学规律的理想工具。
KAN 的优缺点
让我们来看 KAN 如何改进传统神经网络的局限:
- 可解释性:与传统深度学习模型不同,KAN 提供了更可解释的结构。可学习函数可以被可视化和分析,从而洞察模型的决策过程。这一特性在科学领域尤为宝贵,在这些领域中,理解模型的工作机制与获得高准确度同样重要。
- 灵活性:KAN 不局限于单一类型的激活函数。虽然常用 B 样条,但也可根据具体任务采用其他基函数,如切比雪夫多项式。这种灵活性使架构具备广泛适用性与可适配性。
KAN 为深度学习带来了一种有前景的新方法,但与任何技术一样,也存在其弱点:
- 计算复杂度:KAN 的一个挑战是训练阶段的计算强度。由于 KAN 在边上使用可学习激活函数,评估这些函数的复杂性会显著放慢训练过程,相较于传统 MLP 尤其如此。在需要深层 KAN 架构或高细节基函数的任务中,这种复杂性会被进一步放大。
- 专业知识需求:与传统 MLP 相比,KAN 的实现与调优可能更加复杂。为特定任务选择合适的基函数(如 B 样条、切比雪夫多项式)并配置模型,需要更深的数学理解以及更多的人机/模型交互。这可能使缺乏专门知识的从业者更难上手 KAN。
人机-KAN 交互
Kolmogorov-Arnold 网络(KAN)的一个独特之处在于,它能够促进模型与人类直觉之间的有意义互动。原始论文描述了研究人员如何以传统神经网络无法实现的方式参与模型的学习过程。
在将 KAN 训练于特定问题之后,研究人员可以提取模型用于近似复杂多变量函数的已学习一元函数。通过研究这些已学习函数,研究者能够洞察数据中的潜在关系。
此外,从这种互动中获得的见解还能推动迭代式改进。研究人员可以微调 KAN 的架构、修改基函数类型(例如从 B 样条切换为切比雪夫多项式),或根据提取的函数调整训练过程。这种“人类参与环路”的方法使建模过程更具定制化,使 KAN 能够适配不同的科学或数学问题。
通过这种方式,KAN 促进了双向互动:它们从数据中学习形成复杂函数,而人类可以引导并解读这种学习,以优化模型,甚至发现新知识。这种互动正是 KAN 脱颖而出的原因,使机器学习更具协作性与探索性。
结论
总体而言,Kolmogorov-Arnold 网络(KAN)代表了神经网络架构中令人振奋且前景广阔的进展。其独特设计为 MLP 提供了一种灵活且可解释的替代方案,并有潜力在多种任务上优于传统模型。
随着社区通过开源协作与多样化应用不断探索 KAN,这些网络及其扩展有望发展为强大的前沿工具。

研究人员近期提出了一种新型神经网络架构,称为Kolmogorov-Arnold Network(KAN)。KAN 旨在为物理等领域的科学家提供更可解释的模型,用于解决复杂问题。
与传统神经网络不同,KAN 承诺在结果生成过程上提供更高的透明度,回应了当前模型“黑箱”特性的主要批评之一。
KAN 的灵感来源于 Kolmogorov-Arnold 表示定理,作为对广泛使用的多层感知机(MLP)的新替代方案。它们在神经元之间的边(连接)上引入可学习的激活函数,而不是放在神经元内部。
在本文中,我将深入讲解 KAN 的架构,并通过动手编码示例进行演示。