

Apa Itu Jaringan Kolmogorov–Arnold (KAN)?
Jaringan Kolmogorov–Arnold (KAN) didasarkan pada teorema representasi Kolmogorov–Arnold, yang menjadi landasan matematisnya. Teorema tersebut menyatakan bahwa setiap fungsi multivariabel kontinu dapat diuraikan menjadi penjumlahan fungsi-fungsi sederhana satu variabel.
Namun, meskipun teorema menjamin keberadaan fungsi univariat tersebut, teorema tidak memberi tahu kita cara menemukannya. Di sinilah KAN berperan.
Alih-alih langsung mendekati seluruh fungsi kompleks seperti yang dilakukan sebagian besar model lain, KAN berfokus pada pembelajaran fungsi-fungsi univariat yang lebih sederhana ini. Pendekatan ini menghasilkan model yang tidak hanya fleksibel tetapi juga sangat mudah diinterpretasikan, terutama saat menangani hubungan nonlinier dalam data.
Jaringan Kolmogorov–Arnold (KAN) vs. Multi-Layer Perceptron (MLP)
Perbedaan utama antara KAN dan Multi-Layer Perceptron (MLP) tradisional terletak pada cara pembelajarannya terjadi.
Pada MLP, neuron diaktifkan menggunakan fungsi tetap seperti ReLU atau sigmoid, dan aktivasi ini diteruskan melalui matriks bobot linear. Sebaliknya, KAN menempatkan fungsi aktivasi yang dapat dipelajari pada tepi (koneksi) antar-neuron, bukan pada neuronnya sendiri. Dalam implementasi awal, fungsi-fungsi ini diparameterkan sebagai B-spline, meskipun penulis menyebutkan bahwa jenis fungsi lain, seperti polinomial Chebyshev, juga dapat digunakan bergantung pada permasalahannya.
Baik KAN dangkal maupun dalam menguraikan fungsi kompleks menjadi serangkaian fungsi univariat yang lebih sederhana. Gambar di bawah menyoroti perbedaan arsitektur ini: MLP menggunakan aktivasi tetap di dalam neuron, sedangkan KAN menerapkan fungsi yang dapat dipelajari di sepanjang tepi dan menjumlahkannya pada node. Pergeseran arsitektur ini memungkinkan KAN beradaptasi secara dinamis terhadap data, berpotensi mencapai akurasi lebih tinggi dengan jumlah parameter yang lebih sedikit dibanding MLP. Selain itu, setelah pelatihan, model dapat diperkecil ketika tidak semua tepi digunakan untuk pendekatan.
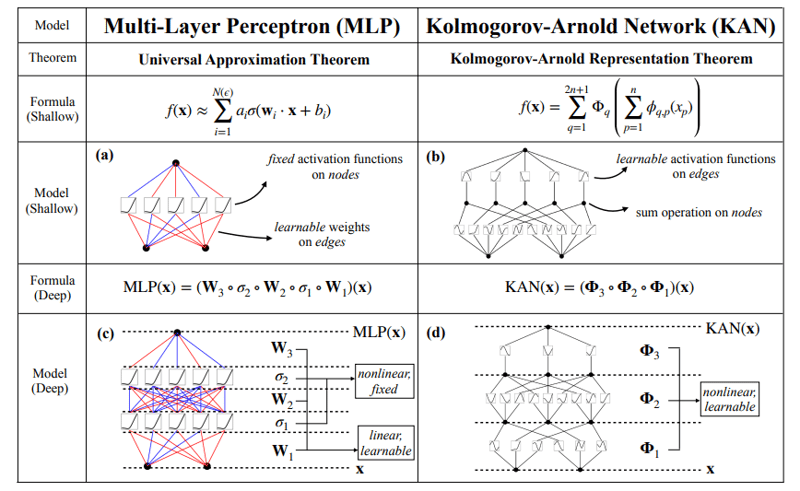
Sumber: Liu dkk., 2024
Selain itu, setelah pelatihan, KAN memungkinkan kita mengekstrak fungsi-fungsi univariat yang telah dipelajari, sehingga memungkinkan rekonstruksi fungsi multivariabel yang dihasilkan. Fitur ini sangat berguna ketika interpretabilitas sangat penting. Kami akan menampilkan proses ini pada bagian contoh nanti.
pip install git+https://github.com/KindXiaoming/pykan.gitPenggunaan
Setelah memasang pykan, kita dapat mulai mengimpor modul yang diperlukan dan mendefinisikan KAN sederhana:
from kan import *
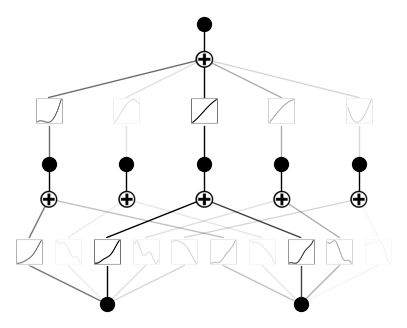
model = KAN(width=[2,5,1])Di sini, kita menetapkan dimensi model pada parameter width. Pada kasus ini, kita membuat model dengan 2 masukan, 1 keluaran, dan satu lapisan berisi 5 neuron tersembunyi.Sekarang, mari kita buat dataset untuk eksperimen kita. Saya akan menggunakan polinomial dua variabel acak yang saya susun cepat:
from kan.utils import create_dataset
f = lambda x: 3*x[:,[0]]**3+2*x[:,[0]]+4 + 2 * x[:,[0]] * x[:,[1]] ** 2 + 3 * x[:,[1]] ** 3
dataset = create_dataset(f, n_var=2)Di sini, saya menggunakan fungsi lambda untuk mendefinisikan polinomial. Pustaka ini tampaknya menggunakan pustaka numpy di balik layar—oleh karena itu sintaksnya. Sekarang, kita dapat memuat dataset ke dalam model dan memvisualisasikannya:
model(dataset['train_input']);
model.plot()Berikut tampilan keluarannya:
Pelatihan
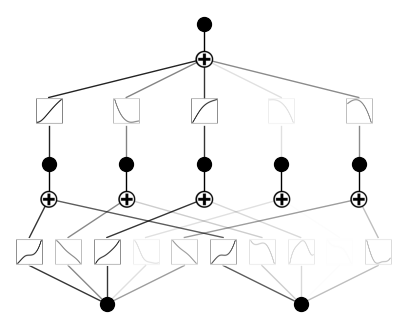
Untuk menjalankan pelatihan, kita perlu menggunakan metode .fit():
model.fit(dataset, steps=1000);Setelah pelatihan, begini tampilan KAN kita:
Sekarang, mari kita pangkas (prune) dan plot ulang modelnya:
model = model.prune()
model.plot()Beginilah tampilan model sekarang. Seperti yang Anda lihat, kita memangkas satu fungsi aktivasi:
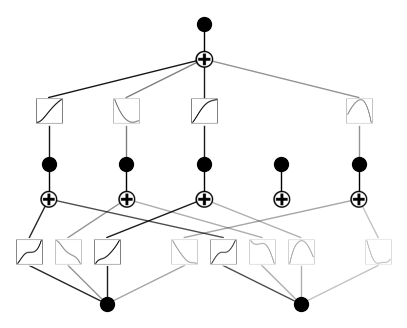
Ini masuk akal, karena polinomial kita tidak menggunakan lima kombinasi berbeda dari pangkat variabel masukan.
Kasus Penggunaan KAN
Jaringan Kolmogorov–Arnold (KAN) menunjukkan potensi di berbagai bidang karena kemampuannya memodelkan hubungan nonlinier yang kompleks dengan lebih sedikit parameter dibanding jaringan saraf tradisional. Berikut beberapa kasus penggunaan utama:
- Pemodelan ilmiah dan pemfittingan data: KAN sangat efektif untuk masalah ilmiah yang memerlukan pemodelan fungsi kompleks yang akurat. Karena KAN mendekati fungsi multivariabel dengan mempelajari fungsi univariat yang lebih sederhana, KAN dapat menangkap pola rumit dalam data ilmiah secara efisien. Untuk tugas seperti curve fitting, KAN sering mengungguli MLP tradisional karena arsitekturnya yang fleksibel.
- Penyelesaian persamaan diferensial parsial (PDE): KAN menunjukkan potensi kuat dalam menyelesaikan PDE, yang umum digunakan dalam fisika dan rekayasa untuk memodelkan proses seperti perpindahan panas dan dinamika fluida. Kapasitasnya menangani masalah berdimensi tinggi dan nonlinier membuat KAN sangat berguna di domain ini, melampaui MLP dalam akurasi dan keterjelasan.
- Regresi simbolik: KAN unggul dalam regresi simbolik, di mana tujuannya adalah menemukan ekspresi matematis yang paling menggambarkan suatu dataset. Kemampuannya mempelajari struktur komposisional menjadikannya alat ideal untuk menemukan kembali hukum fisika dan matematika langsung dari data.
Kelebihan dan Kekurangan KAN
Mari telusuri beberapa cara KAN memperbaiki keterbatasan jaringan saraf konvensional:
- Keterjelasan: Tidak seperti model deep learning tradisional, KAN menyediakan struktur yang lebih mudah diinterpretasikan. Fungsi yang dapat dipelajari dapat divisualisasikan dan dianalisis, memberikan wawasan tentang proses pengambilan keputusan model. Karakteristik ini sangat berharga di bidang ilmiah, di mana memahami cara kerja model sama pentingnya dengan mencapai akurasi tinggi.
- Fleksibilitas: KAN tidak terbatas pada satu jenis fungsi aktivasi. Meskipun sering menggunakan B-spline, fungsi basis lain seperti polinomial Chebyshev dapat digunakan berdasarkan tugas spesifik. Fleksibilitas ini membuat arsitektur KAN serbaguna dan dapat beradaptasi untuk berbagai aplikasi.
KAN menghadirkan pendekatan baru yang menjanjikan untuk deep learning, namun seperti teknologi lainnya, KAN memiliki kelemahan tersendiri:
- Kerumitan komputasi: Salah satu tantangan pada KAN adalah intensitas komputasinya selama fase pelatihan. Karena KAN menggunakan fungsi aktivasi yang dapat dipelajari pada tepi, kompleksitas evaluasi fungsi ini dapat memperlambat proses pelatihan secara signifikan dibanding MLP tradisional. Kompleksitas ini semakin meningkat pada tugas yang memerlukan arsitektur KAN yang dalam atau fungsi basis yang sangat detail.
- Memerlukan keahlian: Menerapkan dan menyetel KAN bisa lebih rumit daripada bekerja dengan MLP tradisional. Memilih fungsi basis yang sesuai (misalnya, B-spline, polinomial Chebyshev) dan mengonfigurasi model untuk tugas tertentu memerlukan pemahaman matematis yang lebih mendalam dan lebih banyak interaksi manusia/model. Hal ini dapat membuat KAN kurang mudah diakses oleh praktisi tanpa pengetahuan khusus.
Interaksi Manusia–KAN
Aspek unik dari Jaringan Kolmogorov–Arnold (KAN) adalah kemampuannya memfasilitasi interaksi yang bermakna antara model dan intuisi manusia. Makalah asli menjelaskan bagaimana peneliti dapat terlibat dengan proses pembelajaran model dengan cara yang tidak mungkin dilakukan pada jaringan saraf tradisional.
Setelah melatih KAN pada masalah tertentu, peneliti dapat mengekstrak fungsi-fungsi univariat yang dipelajari model untuk mendekati fungsi multivariabel yang kompleks. Dengan mempelajari fungsi-fungsi yang dipelajari ini, peneliti memperoleh wawasan tentang hubungan mendasar dalam data.
Lebih jauh lagi, wawasan yang diperoleh dari interaksi ini memungkinkan penyempurnaan iteratif. Peneliti dapat menyetel arsitektur KAN, memodifikasi jenis fungsi basis (misalnya beralih dari B-spline ke polinomial Chebyshev), atau menyesuaikan proses pelatihan berdasarkan fungsi yang diekstrak. Pendekatan human-in-the-loop ini memungkinkan proses pemodelan yang disesuaikan, membuat KAN dapat beradaptasi dengan berbagai masalah ilmiah atau matematis.
Dengan cara ini, KAN memfasilitasi interaksi dua arah: KAN belajar dari data untuk membentuk fungsi kompleks, dan manusia dapat membimbing serta menafsirkan pembelajaran ini untuk menyempurnakan model atau bahkan menemukan pengetahuan baru. Interaksi inilah yang membuat KAN menonjol, mengubah pembelajaran mesin menjadi upaya yang lebih kolaboratif dan eksploratif.
Kesimpulan
Secara keseluruhan, Jaringan Kolmogorov–Arnold (KAN) merepresentasikan kemajuan arsitektur jaringan saraf yang menarik dan menjanjikan. Desainnya yang unik menawarkan alternatif yang fleksibel dan mudah diinterpretasikan terhadap MLP, dengan potensi mengungguli model tradisional dalam berbagai tugas.
Seiring komunitas terus mengeksplorasi KAN melalui kolaborasi open-source dan beragam aplikasi, jaringan ini dan turunannya dapat berkembang menjadi alat yang canggih dan mutakhir.






Para peneliti baru-baru ini memperkenalkan arsitektur jaringan saraf baru bernama Kolmogorov–Arnold Network (KAN). KAN bertujuan membantu ilmuwan di bidang seperti fisika dengan menyediakan model yang lebih mudah diinterpretasikan untuk menyelesaikan masalah kompleks.
Berbeda dengan jaringan saraf tradisional, KAN menjanjikan transparansi yang lebih besar dalam bagaimana mereka mencapai hasil, menanggapi salah satu kritik utama terhadap model saat ini: sifatnya yang "kotak hitam".
KAN terinspirasi dari teorema representasi Kolmogorov–Arnold, menawarkan alternatif baru untuk Multi-Layer Perceptron (MLP) yang banyak digunakan. KAN memperkenalkan fungsi aktivasi yang dapat dipelajari pada tepi antar-neuron alih-alih di dalam neuronnya sendiri.
Dalam artikel ini, saya akan menjelaskan arsitektur KAN secara mendalam dan menggunakan contoh pengkodean praktis.