

Cosa sono le Kolmogorov-Arnold Networks (KAN)?
Le Kolmogorov-Arnold Networks (KAN) si basano sul teorema di rappresentazione di Kolmogorov-Arnold, che ne costituisce il fondamento matematico. Il teorema afferma che qualsiasi funzione continua multivariabile può essere scomposta in una somma di funzioni più semplici a variabile singola.
Tuttavia, sebbene il teorema garantisca l'esistenza di queste funzioni univariate, non ci dice come trovarle. È qui che entrano in gioco le KAN.
Invece di approssimare direttamente un'intera funzione complessa, come fanno la maggior parte degli altri modelli, le KAN si concentrano sull'apprendimento di queste funzioni univariate più semplici. Questo approccio produce un modello non solo flessibile, ma anche altamente interpretabile, soprattutto quando si affrontano relazioni non lineari nei dati.
Kolmogorov-Arnold Networks (KAN) vs. Multi-Layer Perceptron (MLP)
La principale differenza tra KAN e i Multi-Layer Perceptron (MLP) tradizionali riguarda il modo in cui avviene l'apprendimento.
Negli MLP, i neuroni vengono attivati usando funzioni fisse come ReLU o sigmoid, e tali attivazioni vengono propagate tramite matrici di pesi lineari. Al contrario, le KAN collocano funzioni di attivazione apprendibili sui bordi (connessioni) tra i neuroni, invece che nei neuroni stessi. Nell'implementazione originale, queste funzioni sono parametrizzate come B-spline, anche se gli autori menzionano che si possono utilizzare anche altri tipi di funzioni, come i polinomi di Chebyshev, a seconda del problema.
Sia le KAN poco profonde sia quelle profonde scompongono funzioni complesse in una serie di funzioni univariate più semplici. La figura seguente evidenzia questa differenza di architettura: gli MLP usano attivazioni fisse all'interno dei neuroni, mentre le KAN implementano funzioni apprendibili lungo i bordi e le sommano sui nodi. Questo cambiamento architetturale consente alle KAN di adattarsi dinamicamente ai dati, potenzialmente raggiungendo una maggiore accuratezza con meno parametri rispetto agli MLP. Inoltre, dopo l'addestramento, il modello può essere ridotto quando non tutti i bordi sono utilizzati per l'approssimazione.
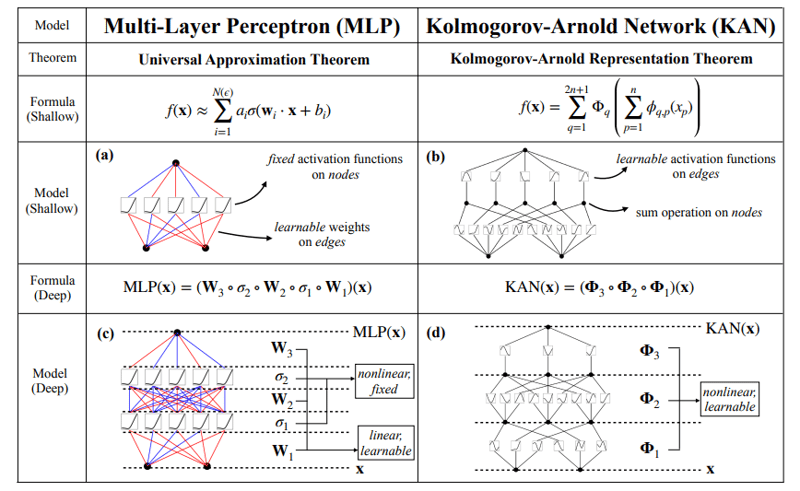
Fonte: Liu et al., 2024
Inoltre, dopo l'addestramento, le KAN permettono di estrarre le funzioni univariate apprese, rendendo possibile ricostruire la funzione multivariabile risultante. Questa caratteristica è particolarmente utile quando l'interpretabilità è cruciale. Mostreremo questo processo nella sezione degli esempi più avanti.
pip install git+https://github.com/KindXiaoming/pykan.gitUso
Dopo aver installato pykan, possiamo iniziare importando i moduli necessari e definendo una semplice KAN:
from kan import *
model = KAN(width=[2,5,1])Qui specifichiamo le dimensioni del modello nel parametro width. In questo caso specifico, stiamo creando un modello con 2 input, 1 output e uno strato di 5 neuroni nascosti.Ora creiamo un dataset per il nostro esperimento. Userò al volo un polinomio a 2 variabili inventato sul momento:
from kan.utils import create_dataset
f = lambda x: 3*x[:,[0]]**3+2*x[:,[0]]+4 + 2 * x[:,[0]] * x[:,[1]] ** 2 + 3 * x[:,[1]] ** 3
dataset = create_dataset(f, n_var=2)Qui uso una funzione lambda per definire un polinomio. La libreria sembra usare numpy sotto il cofano, da cui la sintassi. Ora possiamo caricare il dataset in un modello e visualizzarlo:
model(dataset['train_input']);
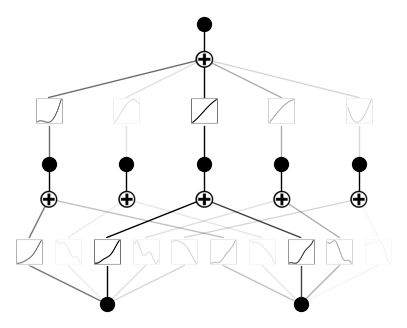
model.plot()Ecco come appare l'output:
Addestramento
Per eseguire l'addestramento, dobbiamo usare il metodo .fit():
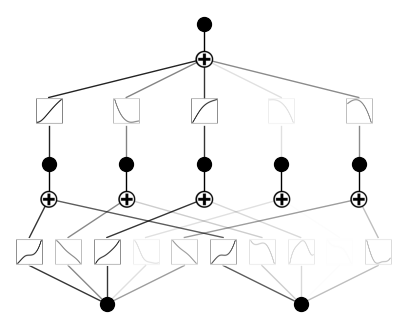
model.fit(dataset, steps=1000);Dopo l'addestramento, ecco come appare la nostra KAN:
Ora, facciamo pruning e tracciamo di nuovo il modello:
model = model.prune()
model.plot()Ecco come appare ora il modello. Come puoi vedere, abbiamo potato un'attivazione:
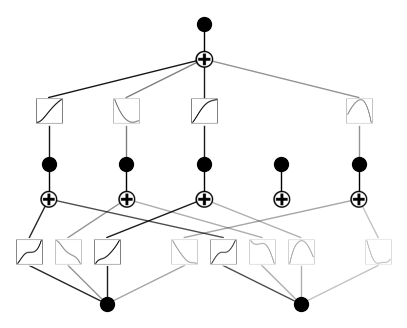
Ha senso, perché il nostro polinomio non usa cinque diverse combinazioni di potenze delle variabili di input.
Casi d'uso delle KAN
Le Kolmogorov-Arnold Networks (KAN) hanno mostrato risultati promettenti in vari ambiti grazie alla loro capacità di modellare relazioni complesse e non lineari con meno parametri rispetto alle reti neurali tradizionali. Ecco alcuni casi d'uso chiave:
- Modellazione scientifica e data fitting: le KAN sono particolarmente efficaci per problemi scientifici che richiedono una modellazione accurata di funzioni complesse. Poiché approssimano funzioni multivariabili imparando funzioni univariate più semplici, riescono a catturare in modo efficiente pattern intricati nei dati scientifici. Per compiti come il curve fitting, spesso superano gli MLP tradizionali grazie alla loro architettura flessibile.
- Risoluzione di equazioni differenziali alle derivate parziali (PDE): le KAN hanno dimostrato un forte potenziale nella risoluzione delle PDE, comunemente usate in fisica e ingegneria per modellare processi come il trasferimento di calore e la dinamica dei fluidi. La loro capacità di gestire problemi ad alta dimensionalità e non lineari le rende particolarmente utili in questo ambito, superando gli MLP in accuratezza e interpretabilità.
- Regressione simbolica: le KAN eccellono nella regressione simbolica, dove l'obiettivo è scoprire espressioni matematiche che descrivano al meglio un dataset. La loro capacità di apprendere strutture compositive le rende uno strumento ideale per riscoprire leggi fisiche e matematiche direttamente dai dati.
Vantaggi e svantaggi delle KAN
Vediamo alcuni modi in cui le KAN migliorano i limiti delle reti neurali convenzionali:
- Interpretabilità: a differenza dei modelli di deep learning tradizionali, le KAN offrono una struttura più interpretabile. Le funzioni apprendibili possono essere visualizzate e analizzate, fornendo informazioni sul processo decisionale del modello. Questa caratteristica è particolarmente preziosa nei campi scientifici, dove comprendere il funzionamento del modello è tanto cruciale quanto ottenere un'elevata accuratezza.
- Flessibilità: le KAN non sono limitate a un singolo tipo di funzione di attivazione. Sebbene spesso utilizzino le B-spline, è possibile impiegare altre funzioni base, come i polinomi di Chebyshev, in base al compito specifico. Questa flessibilità rende l'architettura versatile e adattabile a un'ampia gamma di applicazioni.
Le KAN rappresentano un nuovo approccio promettente al deep learning, ma come ogni tecnologia hanno anche dei punti deboli:
- Complessità computazionale: una delle sfide delle KAN è la loro intensità computazionale durante la fase di addestramento. Poiché le KAN usano funzioni di attivazione apprendibili sui bordi, la complessità nella valutazione di queste funzioni può rallentare sensibilmente il processo di training rispetto agli MLP tradizionali. Questa complessità è ulteriormente amplificata in compiti che richiedono architetture KAN profonde o funzioni base molto dettagliate.
- Necessità di competenze: implementare e ottimizzare le KAN può essere più complesso rispetto a lavorare con gli MLP tradizionali. La scelta delle funzioni base appropriate (ad es. B-spline, polinomi di Chebyshev) e la configurazione del modello per un compito specifico richiedono una comprensione matematica più profonda e una maggiore interazione umano/modello. Questo può rendere le KAN meno accessibili ai professionisti senza conoscenze specialistiche.
Interazione umano-KAN
Un aspetto unico delle Kolmogorov-Arnold Networks (KAN) è la loro capacità di facilitare un'interazione significativa tra il modello e l'intuizione umana. L'articolo originale descrive come i ricercatori possano interagire con l'apprendimento del modello in modi non possibili con le reti neurali tradizionali.
Dopo aver addestrato una KAN su un problema specifico, i ricercatori possono estrarre le funzioni univariate apprese che il modello utilizza per approssimare la funzione multivariabile complessa. Studiando queste funzioni apprese, si ottengono informazioni sulle relazioni sottostanti nei dati.
Inoltre, le intuizioni ricavate da questa interazione consentono un raffinamento iterativo. I ricercatori possono modificare l'architettura della KAN, cambiare il tipo di funzioni base (ad es. passando dalle B-spline ai polinomi di Chebyshev) o regolare il processo di addestramento sulla base delle funzioni estratte. Questo approccio human-in-the-loop permette un processo di modellazione su misura, rendendo le KAN adattabili a diversi problemi scientifici o matematici.
In questo modo, le KAN favoriscono un'interazione bidirezionale: imparano dai dati per formare funzioni complesse e gli esseri umani possono guidare e interpretare questo apprendimento per perfezionare il modello o persino scoprire nuova conoscenza. Questo gioco di rimando è ciò che fa risaltare le KAN, trasformando il machine learning in un'impresa più collaborativa ed esplorativa.
Conclusione
Nel complesso, le Kolmogorov-Arnold Networks (KAN) rappresentano un progresso entusiasmante e promettente nell'architettura delle reti neurali. Il loro design unico offre un'alternativa flessibile e interpretabile agli MLP, con il potenziale di superare i modelli tradizionali in vari compiti.
Man mano che la community continua a esplorare le KAN tramite collaborazioni open-source e applicazioni diverse, queste reti e le loro estensioni potrebbero evolvere in strumenti potenti e allo stato dell'arte.






Recentemente i ricercatori hanno introdotto una nuova architettura di rete neurale chiamata Kolmogorov-Arnold Network (KAN). Le KAN puntano ad aiutare gli scienziati in campi come la fisica offrendo un modello più interpretabile per risolvere problemi complessi.
A differenza delle reti neurali tradizionali, le KAN promettono maggiore trasparenza nel modo in cui arrivano ai risultati, affrontando una delle principali critiche ai modelli attuali: la loro natura da "scatola nera".
Le KAN si ispirano al teorema di rappresentazione di Kolmogorov-Arnold, offrendo una nuova alternativa al diffuso Multi-Layer Perceptron (MLP). Introdurrono funzioni di attivazione apprendibili sui bordi tra i neuroni anziché all'interno dei neuroni stessi.
In questo articolo, spiegherò in profondità l'architettura KAN e userò esempi di codice pratici.