

Mạng Kolmogorov–Arnold (KAN) là gì?
Mạng Kolmogorov–Arnold (KAN) dựa trên định lý biểu diễn Kolmogorov–Arnold, vốn là nền tảng toán học của chúng. Định lý phát biểu rằng mọi hàm nhiều biến liên tục đều có thể được phân rã thành tổng của các hàm đơn biến đơn giản hơn.
Tuy nhiên, dù định lý đảm bảo các hàm đơn biến này tồn tại, nó không cho biết cách tìm ra chúng. Đây chính là lúc KAN phát huy tác dụng.
Thay vì xấp xỉ trực tiếp cả một hàm phức tạp như hầu hết các mô hình khác, KAN tập trung học các hàm đơn biến đơn giản hơn này. Cách tiếp cận này tạo ra một mô hình không chỉ linh hoạt mà còn rất dễ diễn giải, đặc biệt khi xử lý các quan hệ phi tuyến trong dữ liệu.
Mạng Kolmogorov–Arnold (KAN) so với Multi-Layer Perceptron (MLP)
Khác biệt chính giữa KAN và Multi-Layer Perceptron (MLP) truyền thống nằm ở cách học diễn ra.
Trong MLP, các nơ-ron được kích hoạt bằng những hàm cố định như ReLU hoặc sigmoid, và các kích hoạt này được truyền qua các ma trận trọng số tuyến tính. Trái lại, KAN đặt các hàm kích hoạt có thể học được trên các cạnh (kết nối) giữa các nơ-ron thay vì ngay tại nơ-ron. Trong triển khai gốc, các hàm này được tham số hoá dưới dạng B-spline, dù các tác giả có đề cập rằng những loại hàm khác, như đa thức Chebyshev, cũng có thể được dùng tuỳ bài toán.
Cả KAN nông và sâu đều phân rã các hàm phức tạp thành một chuỗi các hàm đơn biến đơn giản hơn. Hình dưới nhấn mạnh khác biệt kiến trúc này: MLP dùng các hàm kích hoạt cố định bên trong nơ-ron, trong khi KAN triển khai các hàm có thể học dọc theo các cạnh và cộng chúng tại các nút. Sự chuyển dịch kiến trúc này cho phép KAN thích ứng linh hoạt với dữ liệu, có khả năng đạt độ chính xác cao hơn với ít tham số hơn MLP. Hơn nữa, sau khi huấn luyện, mô hình có thể được thu gọn khi không phải tất cả các cạnh đều được dùng cho việc xấp xỉ.
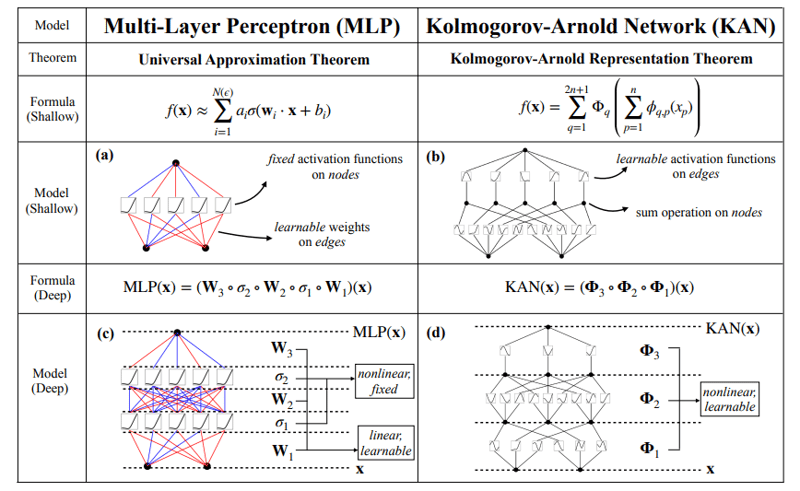
Nguồn: Liu et al., 2024
Ngoài ra, sau khi huấn luyện, KAN cho phép chúng ta trích xuất các hàm đơn biến đã học, từ đó có thể tái dựng hàm nhiều biến kết quả. Tính năng này đặc biệt hữu ích khi khả năng diễn giải là điều cốt yếu. Chúng tôi sẽ trình bày quy trình này trong phần ví dụ bên dưới.
pip install git+https://github.com/KindXiaoming/pykan.gitCách dùng
Sau khi cài đặt pykan, chúng ta có thể bắt đầu nhập các mô-đun cần thiết và định nghĩa một KAN đơn giản:
from kan import *
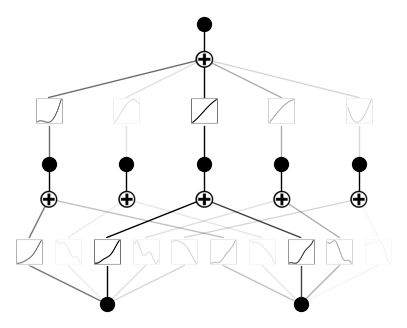
model = KAN(width=[2,5,1])Ở đây, chúng ta chỉ định kích thước của mô hình trong tham số width. Trong trường hợp cụ thể này, chúng ta tạo một mô hình với 2 đầu vào, 1 đầu ra và một tầng gồm 5 nơ-ron ẩn.Giờ hãy tạo một tập dữ liệu cho thử nghiệm. Tôi sẽ dùng một đa thức 2 biến ngẫu nhiên vừa nghĩ ra:
from kan.utils import create_dataset
f = lambda x: 3*x[:,[0]]**3+2*x[:,[0]]+4 + 2 * x[:,[0]] * x[:,[1]] ** 2 + 3 * x[:,[1]] ** 3
dataset = create_dataset(f, n_var=2)Ở đây, tôi dùng một hàm lambda để định nghĩa đa thức. Thư viện có vẻ dùng thư viện numpy bên dưới—vì vậy cú pháp như vậy. Giờ chúng ta có thể nạp tập dữ liệu vào mô hình và trực quan hoá nó:
model(dataset['train_input']);
model.plot()Đây là hình dạng đầu ra:
Huấn luyện
Để chạy huấn luyện, chúng ta cần dùng phương thức .fit():
model.fit(dataset, steps=1000);Sau khi huấn luyện, KAN của chúng ta trông như sau:
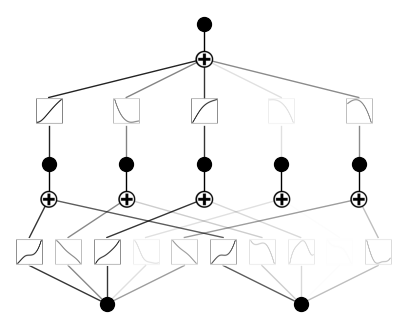
Giờ hãy cắt tỉa (prune) và vẽ lại mô hình:
model = model.prune()
model.plot()Mô hình hiện giờ như sau. Như bạn thấy, chúng ta đã cắt bỏ một hàm kích hoạt:
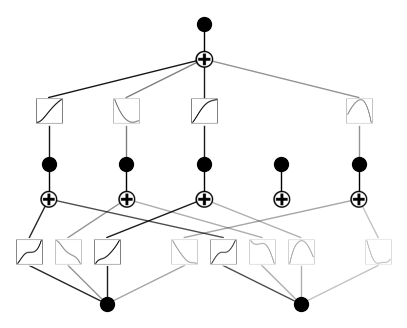
Điều này hợp lý, vì đa thức của chúng ta không dùng năm tổ hợp khác nhau của số mũ trên các biến đầu vào.
Trường hợp sử dụng của KAN
Mạng Kolmogorov–Arnold (KAN) cho thấy nhiều hứa hẹn trong các lĩnh vực khác nhau nhờ khả năng mô hình hoá các quan hệ phi tuyến phức tạp với ít tham số hơn mạng nơ-ron truyền thống. Dưới đây là một số trường hợp tiêu biểu:
- Mô hình hoá khoa học và khớp dữ liệu: KAN đặc biệt hiệu quả cho các bài toán khoa học đòi hỏi mô hình hoá chính xác các hàm phức tạp. Vì KAN xấp xỉ hàm nhiều biến bằng cách học các hàm đơn biến đơn giản hơn, chúng có thể nắm bắt hiệu quả các mẫu tinh vi trong dữ liệu khoa học. Với các tác vụ như khớp đường cong, KAN thường vượt trội so với MLP truyền thống nhờ kiến trúc linh hoạt.
- Giải phương trình đạo hàm riêng (PDE): KAN cho thấy tiềm năng mạnh mẽ trong việc giải PDE, vốn thường dùng trong vật lý và kỹ thuật để mô hình hoá các quá trình như truyền nhiệt và động lực học chất lỏng. Khả năng xử lý các bài toán phi tuyến, nhiều chiều khiến chúng đặc biệt hữu ích trong lĩnh vực này, vượt trội MLP về độ chính xác và khả năng diễn giải.
- Hồi quy ký hiệu (symbolic regression): KAN xuất sắc trong hồi quy ký hiệu, nơi mục tiêu là tìm ra các biểu thức toán học mô tả tốt nhất một tập dữ liệu. Khả năng học các cấu trúc hợp thành giúp chúng trở thành công cụ lý tưởng để tái khám phá các định luật vật lý và toán học trực tiếp từ dữ liệu.
Ưu và nhược điểm của KAN
Hãy cùng tìm hiểu một số cách KAN khắc phục hạn chế của các mạng nơ-ron thông thường:
- Khả năng diễn giải: Không giống các mô hình học sâu truyền thống, KAN cung cấp cấu trúc dễ diễn giải hơn. Các hàm có thể học được có thể được trực quan hoá và phân tích, mang lại hiểu biết về quá trình ra quyết định của mô hình. Đặc điểm này đặc biệt có giá trị trong các lĩnh vực khoa học, nơi việc hiểu cách mô hình hoạt động cũng quan trọng không kém đạt độ chính xác cao.
- Tính linh hoạt: KAN không bị giới hạn ở một loại hàm kích hoạt duy nhất. Dù chúng thường dùng B-spline, các hàm cơ sở khác như đa thức Chebyshev có thể được áp dụng tuỳ nhiệm vụ cụ thể. Sự linh hoạt này khiến kiến trúc trở nên đa dụng và thích nghi với nhiều ứng dụng.
KAN mang đến một hướng tiếp cận mới đầy hứa hẹn cho học sâu, nhưng cũng như mọi công nghệ, chúng có những điểm yếu riêng:
- Độ phức tạp tính toán: Một trong những thách thức với KAN là cường độ tính toán trong giai đoạn huấn luyện. Vì KAN dùng các hàm kích hoạt có thể học được trên các cạnh, độ phức tạp khi đánh giá các hàm này có thể làm chậm đáng kể quá trình huấn luyện so với MLP truyền thống. Độ phức tạp này càng tăng trong các tác vụ đòi hỏi kiến trúc KAN sâu hoặc các hàm cơ sở có độ chi tiết cao.
- Cần chuyên môn: Việc triển khai và tinh chỉnh KAN có thể phức tạp hơn so với làm việc với MLP truyền thống. Việc lựa chọn các hàm cơ sở phù hợp (ví dụ: B-spline, đa thức Chebyshev) và cấu hình mô hình cho một nhiệm vụ cụ thể đòi hỏi hiểu biết toán học sâu hơn và nhiều tương tác người/mô hình hơn. Điều này có thể khiến KAN kém thân thiện hơn với những người thực hành thiếu kiến thức chuyên sâu.
Tương tác giữa con người và KAN
Một khía cạnh độc đáo của Mạng Kolmogorov–Arnold (KAN) là khả năng tạo điều kiện cho sự tương tác có ý nghĩa giữa mô hình và trực giác của con người. Bài báo gốc mô tả cách các nhà nghiên cứu có thể can dự vào quá trình học của mô hình theo những cách mà mạng nơ-ron truyền thống không cho phép.
Sau khi huấn luyện một KAN cho một bài toán cụ thể, các nhà nghiên cứu có thể trích xuất các hàm đơn biến đã học mà mô hình dùng để xấp xỉ hàm nhiều biến phức tạp. Bằng cách nghiên cứu các hàm đã học này, họ có được hiểu biết về các quan hệ nền tảng trong dữ liệu.
Hơn nữa, những hiểu biết thu được từ sự tương tác này cho phép tinh chỉnh lặp. Các nhà nghiên cứu có thể điều chỉnh kiến trúc của KAN, thay đổi loại hàm cơ sở (ví dụ: chuyển từ B-spline sang đa thức Chebyshev), hoặc điều chỉnh quy trình huấn luyện dựa trên các hàm đã trích xuất. Cách tiếp cận có con người trong vòng lặp này cho phép một quy trình mô hình hoá phù hợp theo ngữ cảnh, giúp KAN thích nghi với các bài toán khoa học hoặc toán học khác nhau.
Theo cách đó, KAN tạo điều kiện cho tương tác hai chiều: chúng học từ dữ liệu để hình thành các hàm phức tạp, và con người có thể dẫn dắt, diễn giải việc học này để tinh chỉnh mô hình hoặc thậm chí khám phá tri thức mới. Sự tương tác này làm KAN trở nên nổi bật, biến học máy thành một nỗ lực mang tính hợp tác và khám phá hơn.
Kết luận
Tổng thể, Mạng Kolmogorov–Arnold (KAN) đại diện cho một bước tiến thú vị và đầy hứa hẹn trong kiến trúc mạng nơ-ron. Thiết kế độc đáo của chúng mang lại một lựa chọn linh hoạt và dễ diễn giải thay thế cho MLP, với tiềm năng vượt trội các mô hình truyền thống trong nhiều tác vụ.
Khi cộng đồng tiếp tục khám phá KAN thông qua hợp tác mã nguồn mở và các ứng dụng đa dạng, những mạng này và các phần mở rộng của chúng có thể phát triển thành các công cụ mạnh mẽ, tiên tiến.



Gần đây, các nhà nghiên cứu đã giới thiệu một kiến trúc mạng nơ-ron mới gọi là Mạng Kolmogorov–Arnold (KAN). KAN hướng tới hỗ trợ các nhà khoa học trong những lĩnh vực như vật lý bằng cách cung cấp một mô hình dễ diễn giải hơn để giải quyết các bài toán phức tạp.
Khác với mạng nơ-ron truyền thống, KAN hứa hẹn mang lại tính minh bạch cao hơn trong cách chúng đi đến kết quả, qua đó giải quyết một trong những phê bình lớn nhất với các mô hình hiện nay: bản chất “hộp đen”.
KAN lấy cảm hứng từ định lý biểu diễn Kolmogorov–Arnold, mang đến một lựa chọn mới thay thế cho Multi-Layer Perceptron (MLP) được dùng rộng rãi. Chúng giới thiệu các hàm kích hoạt có thể học được trên các cạnh giữa các nơ-ron thay vì bên trong chính các nơ-ron.
Trong bài viết này, tôi sẽ giải thích chi tiết kiến trúc KAN và sử dụng các ví dụ mã hoá thực hành.