

Wat zijn Kolmogorov-Arnold-netwerken (KAN’s)?
Kolmogorov-Arnold-netwerken (KAN’s) zijn gebaseerd op de representatiestelling van Kolmogorov-Arnold, die de wiskundige basis vormt. Die stelling zegt dat elke continue multivariabele functie kan worden opgesplitst in een som van eenvoudigere, univariabele functies.
Hoewel de stelling garandeert dat deze univariate functies bestaan, vertelt ze ons niet hoe we ze vinden. Dáár komen KAN’s om de hoek kijken.
In plaats van rechtstreeks een volledige complexe functie te benaderen, zoals de meeste andere modellen doen, richten KAN’s zich op het leren van deze eenvoudigere univariate functies. Dat levert een model op dat niet alleen flexibel is, maar ook heel goed uitlegbaar, zeker bij niet-lineaire relaties in data.
Kolmogorov-Arnold-netwerken (KAN’s) vs. Multi-Layer Perceptrons (MLP’s)
Het belangrijkste verschil tussen KAN’s en traditionele Multi-Layer Perceptrons (MLP’s) zit in hoe het leren plaatsvindt.
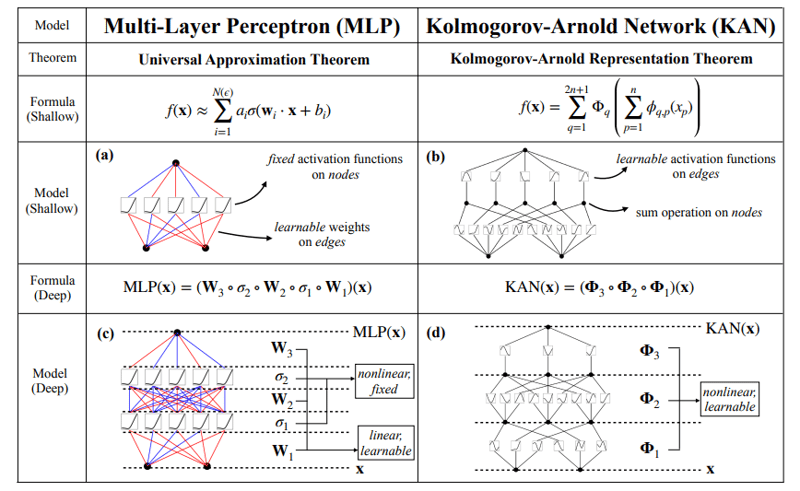
In MLP’s worden neuronen geactiveerd met vaste functies zoals ReLU of sigmoid, en deze activaties worden doorgegeven via lineaire gewichtsmatrices. KAN’s daarentegen plaatsen leerbare activatiefuncties op de randen (verbindingen) tussen neuronen in plaats van op de neuronen zelf. In de oorspronkelijke implementatie worden deze functies geparametriseerd als B-splines, al geven de auteurs aan dat ook andere typen functies, zoals Chebyshev-polynomen, gebruikt kunnen worden afhankelijk van het probleem.
Zowel ondiepe als diepe KAN’s breken complexe functies op in een reeks eenvoudigere, univariate functies. De onderstaande figuur laat dit architectuurverschil zien: MLP’s gebruiken vaste activaties binnen de neuronen, terwijl KAN’s leerbare functies langs de randen implementeren en deze op de knopen sommeren. Door deze architectuurverschuiving kunnen KAN’s zich dynamisch aan de data aanpassen en mogelijk meer nauwkeurigheid behalen met minder parameters dan MLP’s. Bovendien kan het model na de training worden verkleind wanneer niet alle randen worden gebruikt voor de benadering.
Bron: Liu et al., 2024
Na de training kun je bij KAN’s bovendien de geleerde univariate functies extraheren, zodat je de resulterende multivariabele functie kunt reconstrueren. Dat is vooral handig wanneer uitlegbaarheid cruciaal is. We laten dit later zien in de voorbeelden.
pip install git+https://github.com/KindXiaoming/pykan.gitGebruik
Na het installeren van pykan kunnen we de benodigde modules importeren en een eenvoudige KAN definiëren:
from kan import *
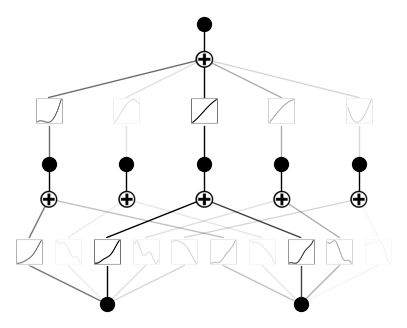
model = KAN(width=[2,5,1])Hier geven we de afmetingen van het model op in de parameter width. In dit geval maken we een model met 2 invoeren, 1 uitvoer en een laag met 5 verborgen neuronen.Laten we nu een dataset maken voor ons experiment. Ik gebruik een willekeurige 2-variabele polynoom die ik ter plekke heb bedacht:
from kan.utils import create_dataset
f = lambda x: 3*x[:,[0]]**3+2*x[:,[0]]+4 + 2 * x[:,[0]] * x[:,[1]] ** 2 + 3 * x[:,[1]] ** 3
dataset = create_dataset(f, n_var=2)Hier gebruik ik een lambda-functie om een polynoom te definiëren. De bibliotheek gebruikt onder water blijkbaar numpy—vandaar de syntax. We kunnen de dataset nu in een model laden en visualiseren:
model(dataset['train_input']);
model.plot()Zo ziet de output eruit:
Training
Om te trainen gebruiken we de methode .fit():
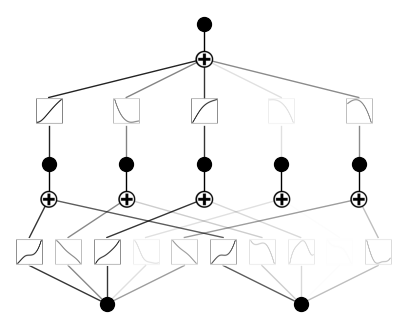
model.fit(dataset, steps=1000);Na de training ziet onze KAN er zo uit:
Laten we nu snoeien en het model opnieuw plotten:
model = model.prune()
model.plot()Zo ziet het model er nu uit. Zoals je ziet, hebben we één activatiefunctie weggesnoeid:
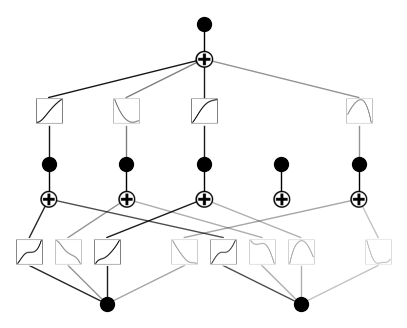
Dat is logisch, want onze polynoom gebruikt geen vijf verschillende combinaties van machten van invoervariabelen.
Toepassingen van KAN’s
Kolmogorov-Arnold-netwerken (KAN’s) laten in uiteenlopende domeinen potentie zien doordat ze complexe, niet-lineaire relaties met minder parameters kunnen modelleren dan traditionele neurale netwerken. Enkele belangrijke use-cases:
- Wetenschappelijke modellering en datafitting: KAN’s zijn bijzonder effectief voor wetenschappelijke problemen die nauwkeurige modellering van complexe functies vereisen. Omdat KAN’s multivariabele functies benaderen door eenvoudigere univariabele functies te leren, kunnen ze complexe patronen in wetenschappelijke data efficiënt vastleggen. Bij taken zoals curvefitting presteren KAN’s vaak beter dan traditionele MLP’s dankzij hun flexibele architectuur.
- Oplossen van partiële differentiaalvergelijkingen (PDE’s): KAN’s tonen sterke potentie bij het oplossen van PDE’s, die in de natuurkunde en engineering veel worden gebruikt om processen als warmtetransport en stromingsleer te modelleren. Door hun vermogen om hoog-dimensionale, niet-lineaire problemen aan te kunnen, zijn ze hier bijzonder nuttig en overtreffen ze MLP’s in nauwkeurigheid en uitlegbaarheid.
- Symbolische regressie: KAN’s blinken uit in symbolische regressie, waar het doel is om wiskundige uitdrukkingen te vinden die een dataset het best beschrijven. Hun vermogen om compositorische structuren te leren maakt ze ideaal om natuurkundige en wiskundige wetten direct uit data (her)ontdekken.
Voordelen en nadelen van KAN’s
Laten we kijken hoe KAN’s de beperkingen van conventionele neurale netwerken verbeteren:
- Uitlegbaarheid: Anders dan traditionele deep-learningmodellen bieden KAN’s een beter uitlegbare structuur. De leerbare functies zijn te visualiseren en te analyseren, wat inzicht geeft in het beslisproces van het model. Dit is vooral waardevol in wetenschappelijke velden, waar begrip van het model net zo belangrijk is als hoge nauwkeurigheid.
- Flexibiliteit: KAN’s zijn niet beperkt tot één type activatiefunctie. Hoewel ze vaak B-splines gebruiken, kunnen ook andere basisfuncties, zoals Chebyshev-polynomen, worden toegepast afhankelijk van de taak. Deze flexibiliteit maakt de architectuur veelzijdig en toepasbaar in allerlei contexten.
KAN’s bieden een veelbelovende nieuwe benadering van deep learning, maar zoals elke technologie hebben ze ook hun zwakke punten:
- Rekenkundige complexiteit: Een van de uitdagingen bij KAN’s is de rekenintensiteit tijdens de trainingsfase. Omdat KAN’s leerbare activatiefuncties op de randen gebruiken, kan de complexiteit van het evalueren daarvan de training aanzienlijk vertragen ten opzichte van traditionele MLP’s. Deze complexiteit wordt nog groter bij taken die diepe KAN-architecturen of zeer gedetailleerde basisfuncties vereisen.
- Benodigde expertise: Het implementeren en afstemmen van KAN’s kan complexer zijn dan werken met traditionele MLP’s. Het kiezen van geschikte basisfuncties (bijv. B-splines, Chebyshev-polynomen) en het configureren van het model voor een specifieke taak vraagt om diepere wiskundige kennis en meer interactie tussen mens en model. Daardoor zijn KAN’s minder toegankelijk voor practitioners zonder gespecialiseerde kennis.
Interactie tussen mens en KAN
Een uniek aspect van Kolmogorov-Arnold-netwerken (KAN’s) is dat ze betekenisvolle interactie tussen model en menselijke intuïtie mogelijk maken. Het oorspronkelijke artikel beschrijft hoe onderzoekers met het leerproces van het model kunnen meedenken op manieren die bij traditionele neurale netwerken niet mogelijk zijn.
Na het trainen van een KAN op een specifiek probleem kunnen onderzoekers de geleerde univariate functies extraheren die het model gebruikt om de complexe multivariabele functie te benaderen. Door deze functies te bestuderen krijgen ze inzicht in de onderliggende relaties in de data.
De inzichten uit deze interactie maken iteratieve verfijning mogelijk. Onderzoekers kunnen de architectuur van de KAN aanpassen, het type basisfuncties wijzigen (bijv. overstappen van B-splines naar Chebyshev-polynomen) of het trainingsproces bijstellen op basis van de geëxtraheerde functies. Deze human-in-the-loop-aanpak maakt een op maat gemaakt modelleerproces mogelijk, waardoor KAN’s zich kunnen aanpassen aan verschillende wetenschappelijke of wiskundige problemen.
Zo ontstaat een wisselwerking: KAN’s leren uit data om complexe functies te vormen, en mensen kunnen dit leerproces sturen en interpreteren om het model te verfijnen of zelfs nieuwe kennis te ontdekken. Die interactie maakt KAN’s bijzonder en verandert machine learning in een meer collaboratieve en verkennende bezigheid.
Conclusie
Al met al vormen Kolmogorov-Arnold-netwerken (KAN’s) een spannende en veelbelovende stap voorwaarts in neurale netwerkarchitectuur. Hun unieke ontwerp biedt een flexibel en uitlegbaar alternatief voor MLP’s, met de potentie om traditionele modellen op diverse taken te overtreffen.
Terwijl de community KAN’s verder onderzoekt via open-source samenwerking en uiteenlopende toepassingen, kunnen deze netwerken en hun uitbreidingen uitgroeien tot krachtige, state-of-the-art tools.

Onderzoekers hebben recent een nieuwe neurale netwerkarchitectuur geïntroduceerd, de Kolmogorov-Arnold Network (KAN). KAN’s zijn bedoeld om wetenschappers in bijvoorbeeld de natuurkunde te helpen met een beter uitlegbaar model voor het oplossen van complexe problemen.
In tegenstelling tot traditionele neurale netwerken beloven KAN’s meer transparantie in hoe ze tot resultaten komen. Daarmee pakken ze een van de grootste kritiekpunten op huidige modellen aan: hun ‘black box’-karakter.
KAN’s zijn geïnspireerd op de representatiestelling van Kolmogorov-Arnold en vormen een nieuw alternatief voor de veelgebruikte Multi-Layer Perceptron (MLP). Ze introduceren leerbare activatiefuncties op de randen tussen neuronen in plaats van binnen de neuronen zelf.
In dit artikel leg ik de KAN-architectuur uitgebreid uit en gebruik ik praktische codevoorbeelden.