

课程
使用 LangGraph 构建多智能体系统
2 小时 45 分钟
9K
实践并学习路径你的进步。
使用 Google 继续从文本文档中提取结构化数据对数据团队来说是一大难题。格式一变正则就会失效,自定义解析代码容易漏掉人类轻松捕捉到的上下文,而且随着数据源变动,这些方案还需要不断修修补补。
LangExtract 通过使用能像人类一样阅读文本并精确追踪信息来源的 AI 模型来解决这一问题。您只需用简单的描述加上少量示例告诉它想要的数据,它就会负责理解与提取的繁重工作。
在本教程中,我将逐步讲解如何为命名实体识别设置 LangExtract、提取实体之间的关系、使用不同的 AI 模型提供商,并将 LangExtract 的方法与传统 NLP 库进行对比。您还将学习如何定义提取任务、提供训练示例,以及如何处理结构化结果以融入您的分析流程。
LangExtract 是一个 Python 库,利用 AI 模型将凌乱的文本转化为有条理的数据。传统文本处理工具容易被上下文迷惑——读到“Apple”时,明明在谈论科技公司,它却可能当成水果;看到“$500”,它可能判定为价格,而实际上是员工 ID。基础的模式匹配能找出电子邮箱地址,但分不清“john.doe@company.com”是现任员工,还是旧邮件里随口提到的人。
为了解决这些上下文与准确性问题,LangExtract 提供:
来源:GitHub
这些工具协同工作,改变了您从文本中提取信息的方式。您无需再编写易碎的复杂规则,而是用简单示例告诉 AI 您的需求。AI 会像人类一样阅读文本,并记录一切信息的来源。这样,您就能提取到传统方法需数百行代码才能发现的复杂信息与关系。
当您需要提取传统 NLP 工具难以处理的定制信息时,LangExtract 最为适合。如果您处理的是特定领域文本,而标准命名实体识别力有未逮,LangExtract 允许您无需编写复杂规则或重训模型,就能精确定义对业务重要的内容。尤其当您不仅要找出单个实体,还需要理解不同信息之间的上下文与关系时,它尤为有用。
在以下场景中,LangExtract 是不错的选择:
如果您从事的是成熟的 NLP 任务(如面向通用类别的基础命名实体识别)、需要对简单模式进行极高速处理,或严格禁止调用外部 API,则应考虑其他工具。传统库如 spaCy 在标准 NLP 任务与海量处理方面表现出色,而当您需要以最小化配置复杂度实现智能、定制化抽取时,LangExtract 更具优势。
在开始抽取数据之前,您需要安装 LangExtract 并配置 AI 模型的访问。该库支持多种安装方式并可对接不同的 AI 提供商。
使用 pip 或 uv 安装 LangExtract。若需 OpenAI 集成,请使用 extras 包:
# Using pip
pip install langextract[openai]

# Using uv
uv add langextract[openai]
[openai] 额外包含 OpenAI 的 Python 客户端。对于其他提供商,您可以安装基础包并按需添加相应的提供商库。
LangExtract 可对接多个 AI 提供商。将 API 密钥设置为环境变量:
# OpenAI (get your key from https://platform.openai.com/api-keys)
export OPENAI_API_KEY="your-openai-key-here"

# Anthropic (get your key from https://console.anthropic.com/settings/keys)
export ANTHROPIC_API_KEY="your-anthropic-key-here"

# Google AI (get your key from https://aistudio.google.com/app/apikey)
export GOOGLE_API_KEY="your-google-key-here"
您只需为计划使用的提供商配置密钥。通过 Ollama 使用本地模型则无需 API 密钥 — 只需在本机安装并运行 Ollama 即可。
通过一个简单测试验证您的环境:
import langextract as lx
import textwrap

# 1. Define the prompt and extraction rules
prompt = textwrap.dedent(
   """\
   Extract characters, emotions, and relationships in order of appearance.
   Use exact text for extractions. Do not paraphrase or overlap entities.
   Provide meaningful attributes for each entity to add context."""
)

# 2. Provide a high-quality example to guide the model
examples = [
   lx.data.ExampleData(
       text="ROMEO. But soft! What light through yonder window breaks? It is the east, and Juliet is the sun.",
       extractions=[
           lx.data.Extraction(
               extraction_class="character",
               extraction_text="ROMEO",
               attributes={"emotional_state": "wonder"},
           ),
       ],
   )
]

# The input text to be processed
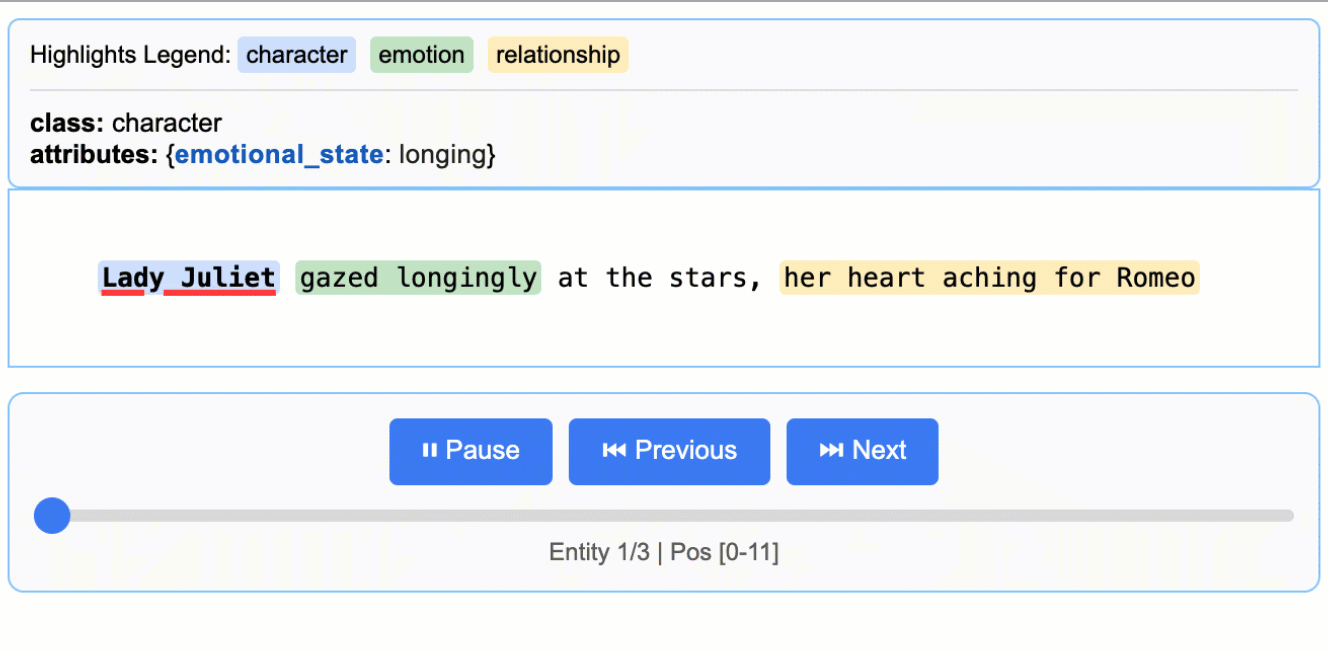
input_text = "Lady Juliet gazed longingly at the stars, her heart aching for Romeo"

# Run the extraction
result = lx.extract(
   text_or_documents=input_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini",
)

print("Extraction successful!")命名实体识别(NER)用于在文本中查找并分类特定信息,例如在商业报告中找出所有公司名、人物与地点。
传统 NER 工具通常使用预定义类别,如“PERSON”或“ORGANIZATION”,但往往会漏掉与您的业务相关的上下文特定实体。LangExtract 允许您定义自定义实体类型,并教会 AI 识别与您领域相关的模式。
下面我们从客户支持邮件中抽取实体。不同于通用类别,我们将识别与支持相关的实体,如投诉类型、产品名称与解决时限,以帮助工单优先级排序。
第一步是用清晰的提示描述您要抽取的内容。这个提示就像是给人工分析师的说明——越具体,效果越好:
import langextract as lx
import textwrap

# Define what we want to extract from support emails
prompt = textwrap.dedent("""
   Extract customer support entities from email text.
   Focus on actionable information that helps prioritize and route tickets.
   Use exact text from the email - don't paraphrase or summarize.
   Include helpful attributes that add context for support agents.
""")
textwrap.dedent() 会移除多行字符串中多余的缩进,使您的提示在代码里更易读,同时发送给 AI 时保持整洁。否则,AI 会看到代码缩进留下的额外空格。
该提示要求 AI 关注与支持相关的信息、使用原文中的精确表述,并通过属性补充上下文。关键在于明确您的领域(客户支持)以及信息的使用价值(帮助排序优先级与分派工单)。
示例能准确教会 AI 您的需求与结果格式。每个示例都向 AI 展示一段文本,以及您希望从中抽取的准确实体:
# Create examples that show the AI what to extract
examples = [
   lx.data.ExampleData(
       text="My laptop screen keeps flickering. I bought it 3 months ago and need this fixed urgently for my presentation tomorrow.",
       extractions=[
           lx.data.Extraction(
               extraction_class="product",
               extraction_text="laptop",
               attributes={"issue": "screen flickering", "urgency": "high"}
           ),
           lx.data.Extraction(
               extraction_class="timeline",
               extraction_text="3 months ago",
               attributes={"context": "purchase_date"}
           ),
           lx.data.Extraction(
               extraction_class="urgency_indicator",
               extraction_text="urgently for my presentation tomorrow",
               attributes={"priority": "high", "deadline": "tomorrow"}
           )
       ]
   )
]
每个 ExampleData 对象包含一个文本样本以及一组 Extraction 对象。Extraction 对象包含三部分信息:
extraction_class:实体类型(如 "product" 或 "timeline")extraction_text:来自原文的精确文本attributes:用于更好理解实体的额外上下文属性正是 LangExtract 区别于传统 NER 的关键。不仅能找到“laptop”,还可捕捉到其“screen flickering”问题并标记为高紧急度。
现在,您可以使用提示与示例在新文本上运行抽取。LangExtract 会利用学到的模式寻找类似的实体:
# Sample support email to analyze
support_email = """
Subject: WiFi adapter not working after Windows update

Hi support team,

My USB WiFi adapter stopped working completely after yesterday's Windows update.
I've tried restarting my computer multiple times but no luck. This is blocking me
from working from home today. I have an important client call at 2 PM and really
need internet access. The adapter worked perfectly before the update.

Thanks,
Mike Chen
"""

# Run the extraction
result = lx.extract(
   text_or_documents=support_email,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini"
)

print("Extraction completed successfully!")
输出:
INFO:absl:Finalizing annotation for document ID doc_435b1cd5.
INFO:absl:Document annotation completed.
✓ Extracted 4 entities (3 unique types)
 • Time: 3.34s
 • Speed: 123 chars/sec
 • Chunks: 1
Extraction completed successfully!
lx.extract() 会接收文本,应用提示指令,并使用示例指导抽取。它会返回一个结果对象,包含所有找到的实体以及它们在原文中的精确位置。
您可以通过更改 model_id 来尝试不同模型。根据文本复杂度与需求,诸如 "claude-3-haiku" 或 "gpt-4o" 的模型可能给出不同结果。
完成抽取后,LangExtract 会返回包含所有实体、其精确位置与属性的结果对象。它的真正价值在于,您可以如何访问、分析与分享这些结构化数据。
所有抽取到的实体都存储在结果对象的 extractions 属性中。每个实体包含文本、类型、在原文中的位置以及相关属性:
# Look at all extracted entities
for extraction in result.extractions:
   print(f"Type: {extraction.extraction_class}")
   print(f"Text: '{extraction.extraction_text}'")
   print(f"Location: chars {extraction.char_interval.start_pos}-{extraction.char_interval.end_pos}")
   print(f"Attributes: {extraction.attributes}")
   print("---")
输出:
Type: product
Text: 'USB WiFi adapter'
Location: chars 78-94
Attributes: {'issue': 'not working after Windows update', 'previous_status': 'worked perfectly before the update'}
---
Type: timeline
Text: 'yesterday'
Location: chars 128-137
Attributes: {'context': 'Windows update'}
---
Type: urgency_indicator
Text: 'blocking me from working from home today'
Location: chars 227-268
Attributes: {'priority': 'high', 'context': 'work from home'}
---
Type: urgency_indicator
Text: 'important client call at 2 PM'
Location: chars 280-309
Attributes: {'priority': 'high', 'deadline': '2 PM today'}
---
每个抽取对象都通过 char_interval 追踪信息来源,展示其在原文中的起止位置。该来源追踪机制便于核验结果并理解上下文。
您可以对实体进行分组与计数,以发现数据模式:
from collections import Counter

# Count different entity types
entity_types = Counter(e.extraction_class for e in result.extractions)
print("Entity breakdown:")
for entity_type, count in entity_types.items():
   percentage = (count / len(result.extractions)) * 100
   print(f"  {entity_type}: {count} entities ({percentage:.1f}%)")

# Find high-priority support tickets
urgent_entities = [
   e for e in result.extractions
   if e.extraction_class == "urgency_indicator"
   and e.attributes.get("priority") == "high"
]
print(f"\nFound {len(urgent_entities)} high-priority indicators")
输出:
Entity breakdown:
 product: 1 entities (25.0%)
 timeline: 1 entities (25.0%)
 urgency_indicator: 2 entities (50.0%)

Found 2 high-priority indicators
此分析有助于您快速识别模式,例如哪些产品类型产生了最多的支持工单,或者当前收到多少紧急请求。
LangExtract 以 JSONL(JSON Lines)格式保存结果,每行包含一个文档的抽取数据。该格式易于与数据处理工具配合,也便于合并多次抽取的结果:
# Save results to a JSONL file
lx.io.save_annotated_documents(
   [result],
   output_name="support_ticket_extractions.jsonl",
   output_dir="."
)
JSONL 将每个文档作为完整的 JSON 对象单独占一行。不同于常规 JSON 文件用一个大数组包裹,JSONL 可以逐行处理,非常适合大数据集。您可以用任意文本编辑器打开,或加载到诸如 pandas 等数据分析工具中。
HTML 可视化是 LangExtract 的亮点之一。它会创建一个交互式报告,在原文中高亮显示抽取的实体,并支持点击浏览结果:
# Generate interactive HTML visualization
html_content = lx.visualize("support_ticket_extractions.jsonl")

# Save the HTML file
with open("support_analysis.html", "w") as f:
   if hasattr(html_content, "data"):
       f.write(html_content.data)  # For Jupyter notebooks
   else:
       f.write(html_content)  # For regular Python scripts

print("HTML visualization saved as 'support_analysis.html'")
输出:
HTML visualization saved as 'support_analysis.html'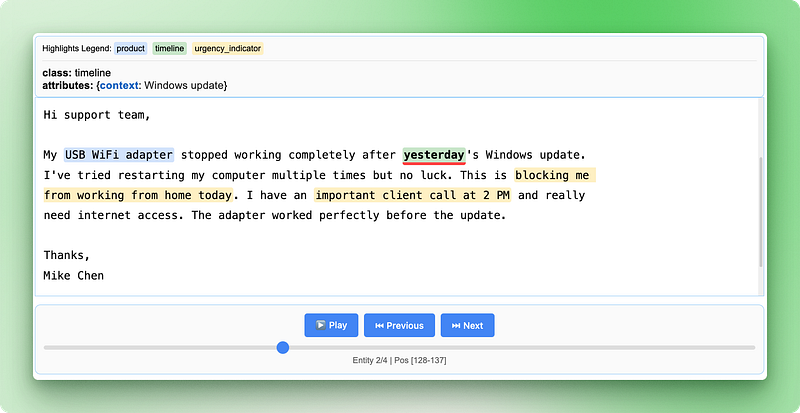
HTML 可视化会在原文中用不同颜色高亮各实体类型。您可以点击高亮文本查看抽取的属性,通过控件在不同实体间导航,并核验 AI 是否正确识别了关键信息。这让抽查结果与建立对抽取流程的信心变得更容易。
该可视化包含实体类型图例、用于在实体间移动的导航控件,以及每个抽取项的详细属性信息。与直接查看原始 JSON 数据相比,这种交互方式能更直观地理解与验证结果。
我们抽取的客户支持实体单独看还不错,但尚不足以讲完整个故事。比如当客户提到“我的 2021 款 MacBook Pro 存在电池问题”时,您需要明白产品、年份与问题是同一个支持案例中的关联信息。若只是分别找到这些片段,意义不大——关键在于它们之间的关系。
传统 NLP 在这方面表现不佳,因为它把每个实体都当作孤立信息。您或许能抽取到“MacBook Pro”、“2021”与“电池问题”,但接下来就需要复杂的规则来判断哪些细节该关联到哪个产品。当同一文本里出现多个产品或多位客户时,这种方法很快就会崩溃。
LangExtract 的做法是,在初始抽取时就将关系带出来,而不是事后再拼接。您可以通过共享属性把相关信息分组,同时仍可精确追踪每条信息在原文中的来源。下面我们以从 HR 文档中抽取员工信息为例,需要将人员与其职位、部门和联系方式关联起来。
在此示例中,我们将从公司公告中抽取员工信息,需要把每个人的多项细节关联起来:
import langextract as lx
import textwrap

# Define relationship extraction prompt
prompt = textwrap.dedent("""
   Extract employee information from company announcements.
   Group related details about each person using employee_group attributes.
   Connect names, titles, departments, and contact info for each employee.
   Use exact text from the announcement - don't paraphrase.
""")

# Create examples showing how to group related information
examples = [
   lx.data.ExampleData(
       text="Sarah Johnson, our new Marketing Director, will lead the digital campaigns team. You can reach Sarah at sarah.j@company.com for any marketing questions.",
       extractions=[
           lx.data.Extraction(
               extraction_class="person",
               extraction_text="Sarah Johnson",
               attributes={"employee_group": "Sarah Johnson"}
           ),
           lx.data.Extraction(
               extraction_class="job_title",
               extraction_text="Marketing Director",
               attributes={"employee_group": "Sarah Johnson"}
           ),
           lx.data.Extraction(
               extraction_class="department",
               extraction_text="digital campaigns team",
               attributes={"employee_group": "Sarah Johnson"}
           ),
           lx.data.Extraction(
               extraction_class="contact",
               extraction_text="sarah.j@company.com",
               attributes={"employee_group": "Sarah Johnson", "type": "email"}
           )
       ]
   )
]
employee_group 属性充当链接机制——拥有相同 employee_group 值的实体属于同一人。这样就能在保持来源追踪的同时,抽取复杂的多部分信息。
现在从包含多位员工的公司公告中进行抽取:
# Sample HR announcement with multiple employees
hr_announcement = """
We're excited to announce two new hires joining our team this month.

Mike Chen joins us as Senior Software Engineer in our Backend Development group. Mike brings 8 years of Python experience and will focus on API architecture. Please welcome Mike - he'll be working from our Seattle office and you can reach him at m.chen@company.com.

Additionally, Lisa Rodriguez starts as Product Manager for our Mobile Apps division. Lisa previously worked at TechStart Inc and has extensive experience with user research. Her office phone is 555-0199 and email is lisa.r@company.com.
"""

# Extract relationships
result = lx.extract(
   text_or_documents=hr_announcement,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini"
)

print(f"Extracted {len(result.extractions)} entities")
输出:
✓ Extraction processing complete

INFO:absl:Finalizing annotation for document ID doc_a349ae1d.
INFO:absl:Document annotation completed.
✓ Extracted 10 entities (4 unique types)
 • Time: 8.57s
 • Speed: 67 chars/sec
 • Chunks: 1
Extracted 10 entities抽取完成后,您可以将相关实体分组,以查看每位员工的完整信息。这需要用少量 Python 代码将分散的实体组织回逻辑分组:
from collections import defaultdict

# Group entities by employee_group
employee_groups = defaultdict(list)
for extraction in result.extractions:
   group_id = extraction.attributes.get("employee_group")
   if group_id:
       employee_groups[group_id].append(extraction)

# Print organized employee information
for employee, details in employee_groups.items():
   print(f"\n=== {employee} ===")
   for detail in details:
       print(f"{detail.extraction_class}: {detail.extraction_text}")
       if detail.attributes.get("type"):
           print(f"  Type: {detail.attributes['type']}")
输出:
=== Mike Chen ===
person: Mike Chen
job_title: Senior Software Engineer
department: Backend Development group
contact: m.chen@company.com
 Type: email
contact: Seattle office
 Type: location

=== Lisa Rodriguez ===
person: Lisa Rodriguez
job_title: Product Manager
department: Mobile Apps division
contact: lisa.r@company.com
 Type: email
contact: 555-0199
 Type: phone
上述代码逐步完成以下工作:
defaultdict(list) 创建一个字典,每个新键会自动初始化为空列表extraction.attributes.get("employee_group") 安全地从每个实体的属性中获取分组 ID,若不存在则返回 None employee_groups[group_id].append(extraction) 将每个实体加入其所属分组的列表defaultdict 是一种会自动创建缺失条目的 Python 容器。当您首次访问 employee_groups["Mike Chen"] 时,它会自动为该员工创建一个空列表,从而省去在字典中检查键是否存在的麻烦。
通过这种分组方法,您可以从原文中分散的信息重建完整的员工画像,同时保留每条数据的精确来源位置。
在包含关系数据时,HTML 可视化的价值更高,因为它能同时展示单个实体与它们的连接:
# Save the relationship extraction results
lx.io.save_annotated_documents(
   [result],
   output_name="employee_relationships.jsonl",
   output_dir="."
)

# Generate HTML visualization showing relationships
html_content = lx.visualize("employee_relationships.jsonl")
with open("employee_relationships.html", "w") as f:
   if hasattr(html_content, "data"):
       f.write(html_content.data)
   else:
       f.write(html_content)

print("Relationship visualization saved as 'employee_relationships.html'")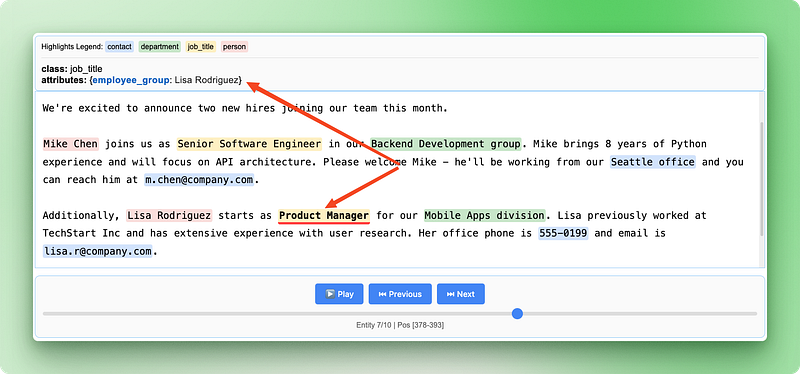
该关系可视化高亮展示不同信息如何连接成完整的员工记录,便于核验 AI 是否从原公告中正确识别并分组了相关细节。
LangExtract 可配合多个 AI 模型提供商使用,每家在成本、速度与准确性之间的权衡各不相同。Google 的 Gemini 模型开箱即用并内置架构约束支持,对大多数抽取任务来说最为省心。 OpenAI 的 GPT 模型往往能提供更高准确性,但需要额外配置且单次抽取成本更高。
# Using Google Gemini (default and recommended)
result_gemini = lx.extract(
   text_or_documents=employee_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gemini-2.5-flash"  # Fast and cost-effective
)

# Using OpenAI GPT models
result_openai = lx.extract(
   text_or_documents=employee_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini",
   fence_output=True,              # Required for OpenAI
   use_schema_constraints=False    # OpenAI doesn't support constraints
)
若需本地处理或避免 API 成本,您可以通过 Ollama 在本地运行模型。本地模型适合较简单的抽取任务,并让您对数据拥有完全控制,但通常速度更慢、准确性也可能不及云端方案。
# Using local models with Ollama (requires Ollama installed)
result_local = lx.extract(
   text_or_documents=employee_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gemma2:2b",                    # Local Gemma model
   model_url="http://localhost:11434",     # Ollama server
   fence_output=False,                     # Local models don't need fencing
   use_schema_constraints=False            # Disable constraints
)真实世界的文本远不如示例那样整洁:50 页的报告格式混乱、客户邮件错别字横飞、PDF 间距怪异。有些文档跨越多个部分、数千字,关键信息可能埋在任意角落。
LangExtract 通过三种主要手段应对这些复杂情况:并发处理多个文档、多轮尝试抽取、以及将大文档拆分为更小的片段。与其一次处理一个文档,不如批量并行,整体会快得多。
# Settings for processing lots of real documents
result = lx.extract(
   text_or_documents=document_batch,
   prompt_description=prompt,
   examples=examples,
   model_id="gemini-2.5-flash",
   max_workers=20,           # Work on many documents at once
   extraction_passes=3,      # Try extraction 3 times
   max_char_buffer=1000      # Break big text into small pieces
)
max_workers 控制并发处理的文档数量。工作线程越多,速度越快,但成本也会上升,并可能触发 API 速率限制。建议从 10–20 开始尝试。
多轮抽取有助于找回首轮遗漏的信息。LangExtract 会运行多次并合并结果,能捕捉更多细节,但耗时和成本也会增加。
将文档分块能更好地处理长文本。max_char_buffer 会把大文档切分为更适合 AI 模型处理的小段。较小分块(1000–2000 字符)更易捕捉细节,而较大分块(3000–5000 字符)保留更多上下文,但可能遗漏部分信息。
# Different settings for different types of documents

# For important documents that need careful review
detailed_result = lx.extract(
   text_or_documents=legal_documents,
   extraction_passes=5,      # Try 5 times for accuracy
   max_char_buffer=800,      # Small chunks for detail
   max_workers=10           # Fewer workers to avoid limits
)

# For quick processing of simple documents
quick_result = lx.extract(
   text_or_documents=email_batch,
   extraction_passes=1,      # Single pass for speed
   max_char_buffer=3000,     # Bigger chunks for speed
   max_workers=30           # More workers for faster results
)
生产环境意味着要处理各种问题。文档可能存在编码错误,网络连接可能中断,API 也可能限制处理速率。请监控抽取任务、为失败文档添加重试逻辑,并跟踪在不同 AI 提供商上的花费。
面对不同文档类型时,请为每一类设置不同的抽取规则。法律合同所需的提示不同于客户邮件;财务报告所需的分块大小不同于社交媒体帖子。构建针对每种文档类型的独立流程,而不是用一个系统包打天下。
与传统 NLP 库相比,LangExtract 采用了不同路径。多数库依赖预训练模型或基于规则的系统,而 LangExtract 借助大型语言模型,能像人类一样理解上下文与语义。下面将其与三款常见 Python NLP 库进行对比,帮助您判断何时应优先选择 LangExtract。
spaCy 注重速度与生产级 NLP 任务,如分词、词性标注与命名实体识别。它内置能识别人名、组织、地点等常见实体的预训练模型,但在领域特定实体或自定义类别上较为吃力。spaCy 擅长快速处理海量文本,但若要抽取自定义信息,往往需要重训模型或编写复杂规则。
LangExtract 则通过简单的示例与提示定义自定义实体,并提供 spaCy 不追踪的精确来源位置,从而免去这类复杂性。
NLTK(Natural Language Toolkit) 面向教学与研究,提供广泛的 NLP 算法与数据集。它提供文本处理的拼装模块,但要构建完整解决方案需要相当的编程功底。NLTK 适合学习 NLP 概念与原型开发,但要搭建生产级抽取系统,往往要组合多个组件并编写大量代码。
LangExtract 则开箱即用——您通过示例定义所需信息,而非编写算法,并且无需额外开发即可获得交互式可视化。
Transformers(Hugging Face) 提供最前沿的 Transformer 模型,覆盖包括命名实体识别、问答在内的多种任务。虽然功能强大,但为特定领域做微调需要机器学习专长,也不提供内置的来源追踪或关系抽取。您需要自己处理模型部署、管理不同模型格式,并开发可视化工具。
LangExtract 屏蔽了与不同 AI 模型打交道的复杂性,自动处理来源追踪,并通过简单的属性分组实现关系抽取,而非依赖复杂的模型架构。
|
功能 |
LangExtract |
spaCy |
NLTK |
Transformers |
|
搭建复杂度 |
简单提示 + 示例 |
模型训练/规则 |
算法编码 |
模型微调 |
|
自定义实体 |
自然语言定义 |
需要重训 |
手写规则 |
模型微调 |
|
来源追踪 |
自动且含精确位置 |
不可用 |
手动实现 |
手动实现 |
|
关系抽取 |
内置分组 |
复杂规则编写 |
手动编码 |
自定义模型开发 |
|
上下文理解 |
LLM 驱动 |
基于模式 |
基于规则 |
依赖模型 |
|
可视化 |
交互式 HTML |
需外部工具 |
需外部工具 |
需外部工具 |
|
学习曲线 |
低(基于示例) |
中(NLP 知识) |
高(算法) |
高(ML 专长) |
|
最佳适用 |
领域特定抽取 |
通用 NLP 流水线 |
研究/学习 |
自定义 AI 应用 |
LangExtract 将文本抽取从“编写复杂规则”变成“与 AI 讨论您的数据”。您已学会如何用简单提示与示例搭建自定义实体抽取、通过关系抽取将相关信息分组,以及创建能精确展示每条数据来源的交互式可视化。该库还能处理并行处理、文档分块等生产难题,适用于真实世界中凌乱且不一致的文本。
无论您是在处理客户支持工单、分析法律文档,还是从论文中提炼洞见,LangExtract 都比传统 NLP 库更直观。与其把时间花在模型训练或规则编写上,不如专注定义对您的用例真正重要的信息。从您手头的文本数据做起,先完成简单抽取,再运用本教程介绍的生产化技巧逐步扩展。
用这些课程学习 AI!
课程
课程
实践并学习路径你的进步。
使用 Google 继续