

为什么要在本地运行 Llama 3?
在本地运行 Llama 3 似乎门槛较高,因为它需要较多的内存、GPU 和算力。但随着框架与模型优化技术的进步,这一切变得前所未有的易用。以下是值得考虑的原因:
- 不间断访问:无需担心速率限制、停机和意外服务中断。
- 更佳性能:响应生成快速,无卡顿或延迟。即便在中端笔记本上,也可达到每秒约 50 个 token 的速度。
- 更强安全性:您可完全掌控用于微调的输入,数据始终保留在本地设备。
- 降低成本:无需为 API 访问或在线聊天机器人订阅支付高额费用,您可以免费使用 Llama 3。
- 可定制与灵活性:可通过超参数自定义模型,添加停止 token,并调整高级设置。
- 离线能力:模型下载完成后,无需联网即可使用。
- 所有权:您对模型、其数据与输出拥有完全的所有权与控制权。
阅读我们的文章《在云端使用大语言模型(LLM)与本地运行 LLM 的优缺点》,进一步了解本地使用 LLM 是否适合您。
将 Llama 3 与 GPT4ALL 搭配使用
GPT4ALL 是一款开源软件,使您即便没有 GPU 也能在本地机器上运行主流大语言模型。它的上手体验友好,非技术背景的个人也能轻松使用。
我们将先在 Windows 上下载并安装 GPT4ALL,前往官方下载页面即可。
安装完成后,启动应用并点击“Downloads”按钮打开模型菜单。向下滚动选择“Llama 3 Instruct”模型,然后点击“Download”按钮。
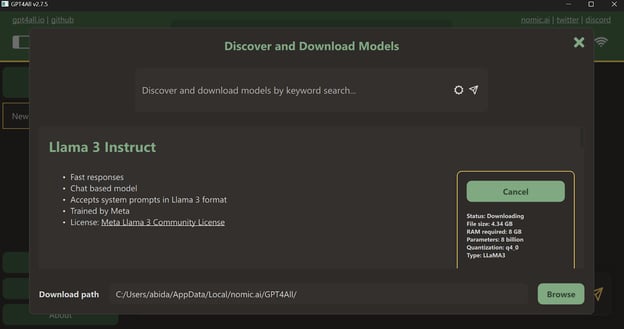
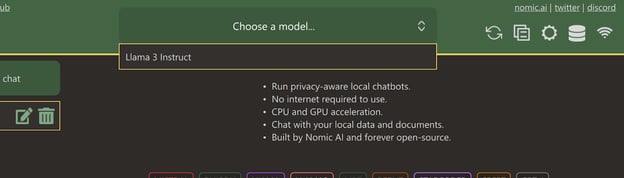
下载完成后,关闭该标签页,并通过“Choose a model”下拉菜单选择 Llama 3 Instruct 模型。
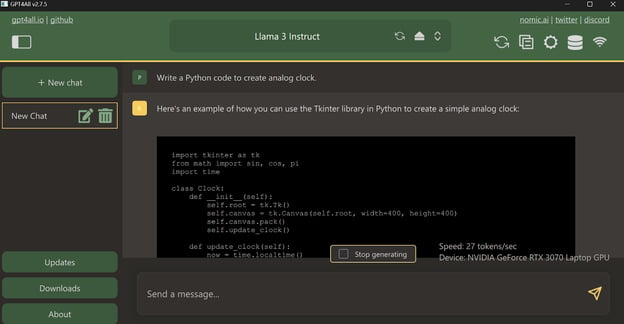
输入提示词,像使用 ChatGPT 一样开始交互。系统已安装 CUDA 工具包,因此会使用 GPU 以更快生成响应。
将 Llama 3 与 Ollama 搭配使用
现在,让我们通过下载并安装 Ollama来尝试在本地使用 Llama 3 的最简方式。
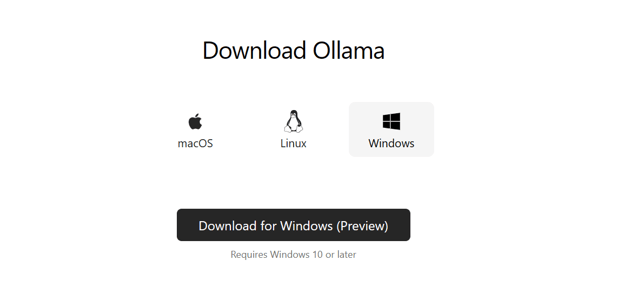
Ollama 是一款强大的本地运行 LLM 工具。它速度快,并且功能丰富。
在系统上安装好 Ollama 后,启动终端/PowerShell 并输入命令。
ollama run llama3注意:下载模型文件并在终端中启动聊天机器人需要几分钟时间。
输入提示词或开始提问,Ollama 会在终端中生成响应。响应速度非常快,您可以不断追问以更深入地探讨话题。
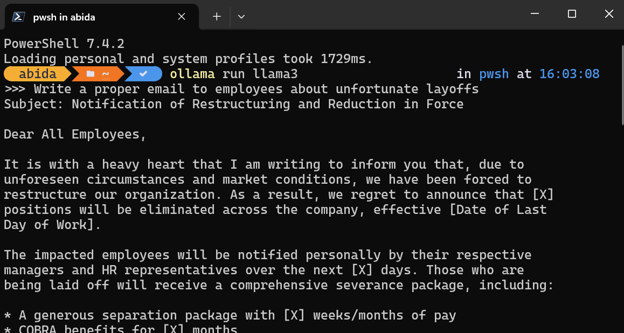
要退出聊天机器人,只需输入 /bye 。
除了这两款软件,您还可以参考指南《本地运行 LLM:7 种简单方法》,探索更多应用与框架。
在本地提供 Llama 3 服务
运行本地服务器可以让您将 Llama 3 集成到其他应用中,并为特定任务构建自己的应用。
在终端中输入以下命令,启动本地模型推理服务器。
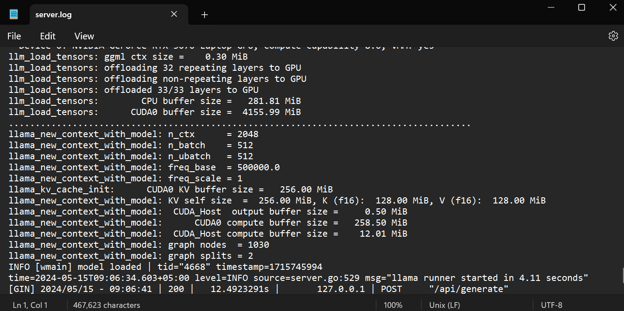
ollama serve要检查服务器是否正常运行,请前往系统托盘,找到 Ollama 图标,右键查看日志。
这会打开 Ollama 文件夹,您可以在其中打开 `server.log` 文件,查看通过 API 发起的服务器请求信息以及带有时间戳的服务器信息。
使用 CURL 访问 API
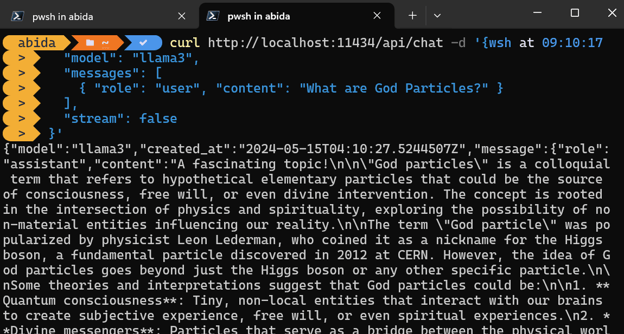
您可以直接通过 CURL 命令访问推理服务器。
只需提供模型名称与提示词,并确保关闭流式传输即可获取完整消息。
curl http://localhost:11434/api/chat -d '{
"model": "llama3",
"messages": [
{ "role": "user", "content": "What are God Particles?" }
],
"stream": false
}'CURL 命令原生支持 Linux,但您也可以在 Windows PowerShell 中使用,如下所示。
使用 Python 包访问 API
您也可以使用 PIP 安装 Ollama 的 Python 包来访问推理服务器。
pip install ollama通过 Python 访问 API,可帮助您构建由 AI 驱动的应用与工具,而且使用非常简单。
只需将模型名称与消息传给 `ollama.chat` 函数,即可生成响应。
注意:在消息参数里,您还可以添加系统提示与助手提示以补充上下文。
import ollama
response = ollama.chat(
model="llama3",
messages=[
{
"role": "user",
"content": "Tell me an interesting fact about elephants",
},
],
)
print(response["message"]["content"])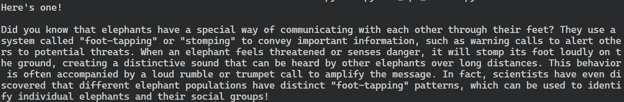
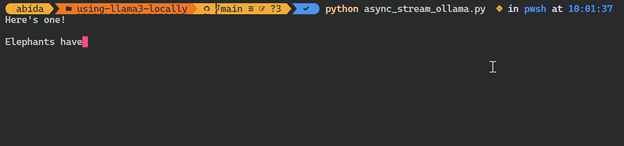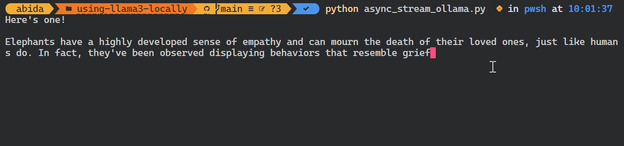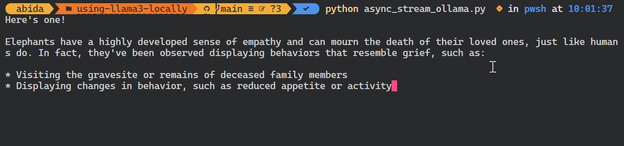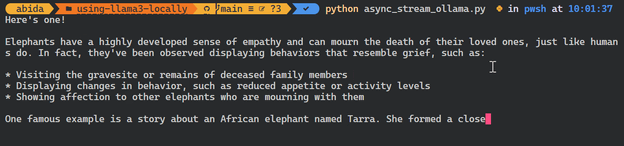
Ollama 的 Python 包还提供异步调用与流式传输等功能,便于高效管理 API 请求并提升模型的感知速度。
与 OpenAI API 类似,您可以创建异步聊天函数,然后使用 async 函数编写流式代码,从而与模型进行高效、快速的交互。
import asyncio
from ollama import AsyncClient
async def chat():
"""
Stream a chat from Llama using the AsyncClient.
"""
message = {
"role": "user",
"content": "Tell me an interesting fact about elephants"
}
async for part in await AsyncClient().chat(
model="llama3", messages=[message], stream=True
):
print(part["message"]["content"], end="", flush=True)
asyncio.run(chat())如您所见,模型会在生成 token 的同时逐步显示。
您还可以使用 Python API 来创建自定义模型、将文本转换为嵌入,并进行错误处理。也支持复制、删除、拉取与推送模型。
在 VSCode 中集成 Llama 3
除了将 Ollama 用作聊天机器人或响应生成工具外,您还可以将其集成到 VSCode 中,利用 Llama 3 实现自动补全、上下文感知的代码建议、代码编写、生成文档字符串、单元测试等功能。
1. 首先,我们需要在终端中输入以下命令以初始化 Ollama 推理服务器。
ollama serve2. 前往 VSCode 扩展,搜索“CodeGPT”工具并安装。CodeGPT 允许您使用 API 密钥连接任意模型提供商。
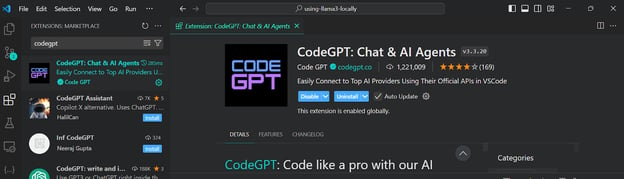
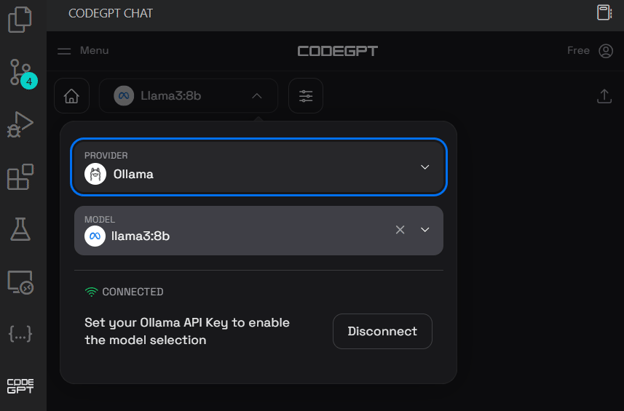
3. 通过单击左侧面板中的 CodeGPT 聊天图标进行设置。将模型提供商改为 Ollama,并选择 llama3:8b 模型。由于在本地运行,您无需提供 API 密钥。
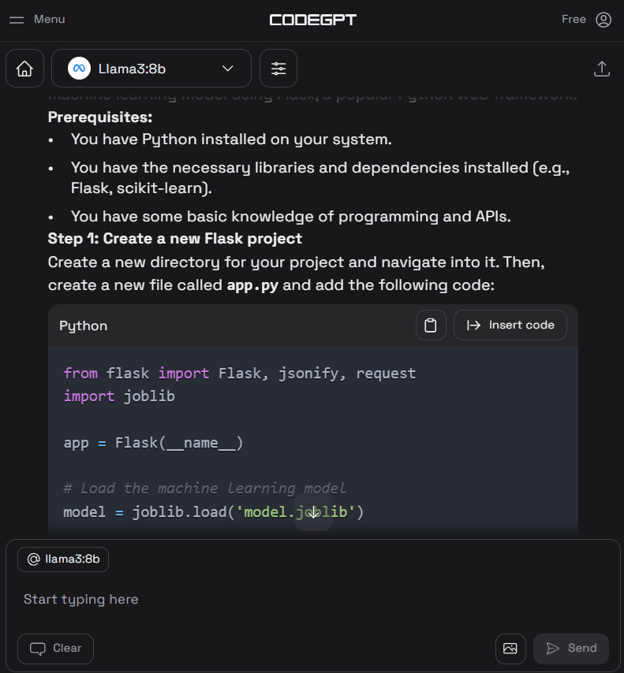
4. 编写提示词以生成 Python 代码,然后点击“Insert the code”按钮将代码插入到您的 Python 文件中。您也可以继续给出后续指令以改进代码。
5. 除了编码助手,您还可以使用 CodeGPT 来理解代码、重构代码、编写文档、生成单元测试并解决问题。
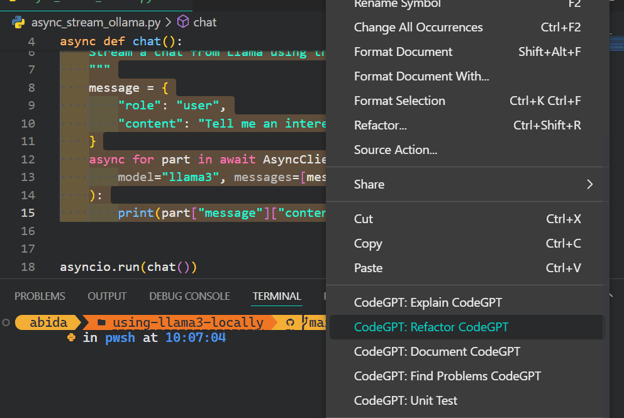
如果您想拥有专业的 Python 开发体验,请查看《为 Python 配置 VSCode》指南,了解 VSCode 核心功能并按需自定义。
在本地开发一款 AI 应用
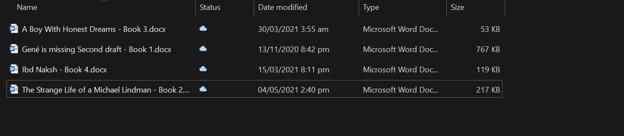
本节中,我们将开发一款由 AI 驱动的应用:它会从指定文件夹读取 docx 文件,将其转换为嵌入,并存储到向量库中。
之后,我们将使用相似度搜索来检索相关语义,并为您的问题提供具有上下文的答案。
这款应用可帮助您快速把握书籍的核心,并更深入地了解人物塑造。
环境设置
首先,我们将安装用于加载文档、向量库与 LLM 框架的所有必要 Python 包。
pip install unstructured[docx] langchain langchainhub langchain_community langchain-chroma然后,启动 Ollama 推理服务器。
ollama serve加载文档
在创建应用前,建议先在 Jupyter Notebook 中开发并测试代码。
我们将使用 DirectoryLoader 从文件夹中加载所有 docx 文件。
from langchain_community.document_loaders import DirectoryLoader
loader = DirectoryLoader("C:/Users/abida/Desktop/Books", glob="**/*.docx")
books = loader.load()
len(books)4您可以参考教程《使用 ChatGPT 与 LangChain 构建具备上下文感知的聊天机器人》来创建您自己的上下文感知型聊天机器人。
拆分文本
将整本书直接输入模型并不可行,因为会超过其上下文窗口。为克服该限制,我们需要将文本划分为更小、便于处理的块,使其能够轻松适配模型的上下文窗口。
在本例中,我们将把四本书的文本都拆分为 500 个字符的块。
from langchain_text_splitters import RecursiveCharacterTextSplitter
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=0)
all_splits = text_splitter.split_documents(books)
Ollama 嵌入与 Chroma 向量库
我们将使用 Langchain 将文本转换为嵌入,并将其存储到 Chroma 数据库中。
我们使用 Ollama 的 Llama 3 模型作为嵌入模型。
from langchain_chroma import Chroma
from langchain_community.embeddings import OllamaEmbeddings
vectorstore = Chroma.from_documents(
documents=all_splits,
embedding=OllamaEmbeddings(model="llama3", show_progress=True),
persist_directory="./chroma_db",
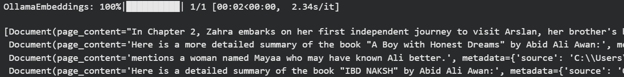
)OllamaEmbeddings: 100%|██████████| 23/23 [01:00<00:00, 2.63s/it]让我们通过执行几次相似度搜索来测试向量数据库。
question = "Who is Zahra?"
docs = vectorstore.similarity_search(question)
docs我们获得了四个与问题相似的结果。
想深入了解向量数据库与 Chroma DB,请阅读教程《Chroma DB 使用指南:一步步教您上手》。
构建用于问答检索系统的 Langchain 链
为了构建一个完善的问答检索系统,我们将使用 Langchain 的链式结构,并开始添加模块。
在我们的问答链中,我们将:
- 将向量库用作检索器并格式化结果。
- 之后提供 RAG 提示词。您可以从 Langchain Hub 轻松获取。
- 然后,提供 Ollama Llama 3 的推理函数。
- 最后,对结果进行解析,仅展示响应。
简单来说,在把问题传给 Llama 3 模型之前,系统会通过相似度搜索和 RAG 提示为其补充上下文。
from langchain import hub
from langchain_community.llms import Ollama
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
llm = Ollama(model="llama3")
retriever = vectorstore.as_retriever()
def format_docs(docs):
return "\n\n".join(doc.page_content for doc in docs)
rag_prompt = hub.pull("rlm/rag-prompt")
qa_chain = (
{"context": retriever | format_docs, "question": RunnablePassthrough()}
| rag_prompt
| llm
| StrOutputParser()
)您也可以使用 LLamaIndex 构建类似应用。请参阅教程《LlamaIndex:面向大语言模型(LLM)应用的数据框架》来实现。
测试问答检索链
围绕书籍提出相关问题,以更好地理解故事。
question = "What is the story of the 'Gené is Missing' book?"
qa_chain.invoke(question)如我们所见,使用书籍内容作为上下文可得到准确的回答。
'Based on the provided context, "Gené is Missing" appears to be a mystery novel that revolves around uncovering the truth about Gené\'s life and potential involvement in murders. The story follows different perspectives, including Simon trying to prove his innocence, flashbacks of Gené\'s past, and detective Jacob investigating the case.'现在我们来问一个关于人物的问题。
question = "Who is Arslan?"
qa_chain.invoke(question)系统给出了精准的答案。
'Arslan is Zahra\'s brother\'s best friend. He is someone that Zahra visits in the book "A Boy with Honest Dreams" by Abid Ali Awan to gather information about Ali.'构建 AI 应用
为了构建一款可在终端中无缝运行的完整 AI 应用,我们将把前面各节中的所有代码整合到一个 Python 文件中。
code AI_app.py此外,我们将增强代码以支持交互式查询,使您可以反复向应用提问,直到输入“exit”明确结束会话。
from langchain_chroma import Chroma
from langchain_community.embeddings import OllamaEmbeddings
from langchain import hub
from langchain_community.llms import Ollama
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
# loading the vectorstore
vectorstore = Chroma(persist_directory="./chroma_db", embedding_function=OllamaEmbeddings(model="llama3"))
# loading the Llama3 model
llm = Ollama(model="llama3")
# using the vectorstore as the retriever
retriever = vectorstore.as_retriever()
# formating the docs
def format_docs(docs):
return "\n\n".join(doc.page_content for doc in docs)
# loading the QA chain from langchain hub
rag_prompt = hub.pull("rlm/rag-prompt")
# creating the QA chain
qa_chain = (
{"context": retriever | format_docs, "question": RunnablePassthrough()}
| rag_prompt
| llm
| StrOutputParser()
)
# running the QA chain in a loop until the user types "exit"
while True:
question = input("Question: ")
if question.lower() == "exit":
break
answer = qa_chain.invoke(question)
print(f"\nAnswer: {answer}\n")
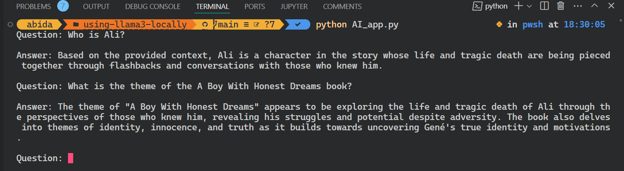
在终端中输入 `Python` 和文件名来运行该应用。
python AI_app.py很酷,我们仅用几行代码就在本地构建了自己的 RAG AI 应用。
本教程的全部源代码已发布在 GitHub 仓库 kingabzpro/using-llama3-locally。欢迎查看,也别忘了为仓库点亮一颗 ⭐。
总结
在本教程中,我们学习了如何在笔记本电脑上本地使用 Llama 3。我们还了解了推理服务器,以及如何利用它将 Llama 3 集成到 VSCode 中。
最后,我们使用 Langchain、Chroma 和 Ollama 构建了问答检索系统。数据始终留在本地系统中,您甚至无需花费一分钱即可完成构建。除了这些较为简单的应用,您还可以用本教程中使用的同样工具构建复杂系统。
若想进一步学习,推荐以下教程:
FAQs
我能在 macOS 或 Linux 上本地运行 Llama 3,还是只能在 Windows 上运行?
可以。您同样可以在 macOS 和 Linux 上本地运行 Llama 3。像 Ollama 和 GPT4ALL 这样的工具提供多平台支持,许多安装步骤在不同操作系统上也相似。
Llama 3 通常需要多少磁盘空间?
取决于模型规模(例如 7B、13B),通常需要约 4 GB 至 20+ GB 的磁盘空间。特别是在使用多个模型或量化版本时,请务必预留充足空间。
部署后我能在本地微调 Llama 3 吗?
可以,但微调比推理更耗费资源。您需要可靠的 GPU 配置,以及如 Hugging Face Transformers 或 PEFT(参数高效微调)等框架来入门。
在本地运行 Llama 3 一定需要 GPU 吗?
不一定需要。像 GPT4ALL 这样的工具可以在 CPU 上运行 Llama 3,但性能会较慢。若期望实时响应或要使用大模型,强烈建议配备 GPU。
我可以在 Ollama 中在多个 LLM 之间切换吗?
可以。Ollama 支持运行不同模型,如 Llama 2、Llama 3 和 Mistral。您可以通过终端或图形界面(取决于您的设置)下载并在它们之间切换。
如何更新我已下载的 Llama 3 模型?
大多数工具(如 Ollama)都支持重新拉取或刷新模型。只需再次运行下载或 pull 命令,它会检查更新并在有新版本时覆盖旧版本。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
在本地运行像 Llama 3 这样的大语言模型(LLM),正成为 AI 领域的变革者。随着 Hugging Face 等平台推动本地部署,用户如今可以享受不间断、且更私密的模型使用体验。
在这篇博客中,我们将了解为何应当在本地运行像 Llama 3 这样的 LLM,以及如何通过 GPT4ALL 和 Ollama 进行访问。此外,我们还将学习模型服务、将 Llama 3 集成到您的工作空间中,并最终利用它来开发 AI 应用。我们不仅把它当作聊天机器人使用,还会用它来提升工作流程,并基于它构建项目。