

कोर्स
LangGraph के साथ Multi-Agent Systems
2 घंटा 45 मिनट
9K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंपाठ दस्तावेज़ों से संरचित डेटा निकालना डेटा टीमों के लिए बड़ी चुनौतियाँ पैदा करता है। फ़ॉर्मेट बदलते ही रेगुलर एक्सप्रेशंस टूट जाते हैं, कस्टम पार्सिंग कोड वह संदर्भ नहीं पकड़ पाता जो इंसान आसानी से समझ लेते हैं, और जैसे-जैसे आपके डेटा स्रोत बदलते हैं, इन समाधानों में लगातार सुधार की ज़रूरत पड़ती है।
LangExtract इसे ऐसे AI मॉडलों से हल करता है जो मनुष्यों की तरह पाठ पढ़ सकते हैं और यह ट्रैक कर सकते हैं कि जानकारी ठीक कहाँ से आई है। आप सरल शब्दों और कुछ उदाहरणों में बताते हैं कि आपको कौन-सा डेटा चाहिए, और यह उस जानकारी को समझने और निकालने का कठिन काम संभाल लेता है।
इस ट्यूटोरियल में, मैं चरण-दर-चरण समझाऊँगा कि नामित इकाई पहचान (NER) के लिए LangExtract कैसे सेट करें, इकाइयों के बीच संबंध कैसे निकालें, विभिन्न AI मॉडल प्रदाताओं के साथ कैसे काम करें, और पारंपरिक NLP लाइब्रेरीज़ के मुकाबले LangExtract के दृष्टिकोण की तुलना कैसे करें। आप यह भी सीखेंगे कि एक्सट्रैक्शन कार्य कैसे परिभाषित करें, प्रशिक्षण उदाहरण कैसे दें, और अपने विश्लेषण वर्कफ़्लो के लिए संरचित परिणामों को कैसे प्रोसेस करें।
LangExtract एक Python लाइब्रेरी है जो AI मॉडलों की मदद से बिखरे हुए पाठ को व्यवस्थित डेटा में बदल देती है। पुराने टेक्स्ट प्रोसेसिंग टूल संदर्भ से भ्रमित हो जाते हैं — वे “Apple” को फल समझ सकते हैं जबकि आप टेक कंपनी के बारे में पढ़ रहे हों, या “$500” देख कर उसे कीमत मान लें जबकि वह वास्तव में कर्मचारी ID हो। बुनियादी पैटर्न मिलान ईमेल पते पहचान सकता है, पर यह नहीं बता सकता कि “john.doe@company.com” कोई मौजूदा कर्मचारी है या किसी पुराने ईमेल में बस उल्लेख किया गया व्यक्ति।
इन संदर्भ और सटीकता से जुड़ी समस्याओं को दूर करने के लिए, LangExtract आपको देता है:
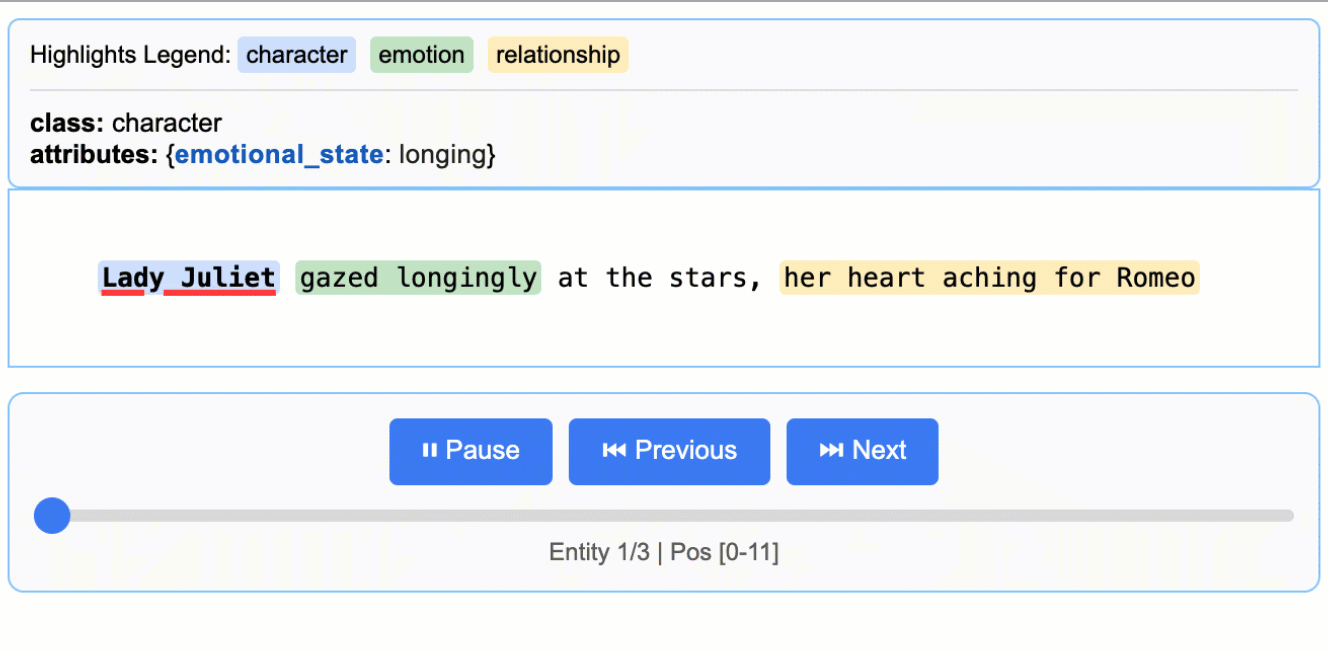
स्रोत: GitHub
ये टूल एक साथ मिलकर आपके पाठ से जानकारी निकालने का तरीका बदल देते हैं। जटिल नियम लिखने के बजाय, जो आसानी से टूट जाते हैं, आप सरल उदाहरणों से AI को बताते हैं कि आपको क्या चाहिए। AI पाठ को इंसान की तरह पढ़ता है और हर चीज़ का स्रोत ट्रैक करता है। इससे आप जटिल जानकारी और संबंध निकाल सकते हैं, जिनके लिए पुराने तरीकों में सैकड़ों लाइन कोड लिखनी पड़ती।
LangExtract तब सबसे अच्छा काम करता है जब आपको ऐसा कस्टम जानकारी निकालनी हो जिसे पारंपरिक NLP टूल अच्छी तरह संभाल नहीं पाते। यदि आप डोमेन-विशिष्ट पाठ पर काम कर रहे हैं जहाँ मानक नामित इकाई पहचान कम पड़ जाती है, तो LangExtract आपको बिना जटिल नियम लिखे या मॉडल फिर से प्रशिक्षित किए, अपने व्यवसाय के लिए महत्वपूर्ण चीज़ें ठीक-ठीक परिभाषित करने देता है। यह विशेष रूप से तब उपयोगी है जब आपको केवल अलग-अलग इकाइयाँ ढूँढनी नहीं, बल्कि संदर्भ और उनके बीच के संबंध भी समझने हों।
LangExtract इन स्थितियों में उपयुक्त विकल्प है:
यदि आप सामान्य श्रेणियों के लिए बुनियादी नामित इकाई पहचान जैसे अच्छी तरह स्थापित NLP कार्यों पर काम कर रहे हैं, सरल पैटर्न के अत्यधिक तेज़ प्रोसेसिंग की ज़रूरत है, या बाहरी API कॉल से सख्ती से बचना आवश्यक है, तो आपको अन्य टूल्स पर विचार करना चाहिए। पारंपरिक लाइब्रेरी जैसे spaCy उच्च-वॉल्यूम प्रोसेसिंग के साथ मानक NLP कार्यों में उत्कृष्ट हैं, जबकि LangExtract तब चमकता है जब आपको न्यूनतम सेटअप जटिलता के साथ बुद्धिमान, कस्टम निष्कर्षण चाहिए।
डेटा निकालना शुरू करने से पहले, आपको LangExtract इंस्टॉल करना और AI मॉडलों की पहुँच सेट करनी होगी। लाइब्रेरी कई इंस्टॉलेशन तरीकों का समर्थन करती है और विभिन्न AI प्रदाताओं के साथ काम करती है।
pip या uv का उपयोग करके LangExtract इंस्टॉल करें। OpenAI इंटेग्रेशन के लिए, extras पैकेज का उपयोग करें:
# Using pip
pip install langextract[openai]

# Using uv
uv add langextract[openai]
The [openai] extra में OpenAI का Python क्लाइंट शामिल है। अन्य प्रदाताओं के लिए, आप बेस पैकेज इंस्टॉल कर सकते हैं और ज़रूरत के अनुसार प्रदाता-विशिष्ट लाइब्रेरी जोड़ सकते हैं।
LangExtract कई AI प्रदाताओं के साथ काम करता है। API कुंजियाँ environment variables के रूप में सेट करें:
# OpenAI (get your key from https://platform.openai.com/api-keys)
export OPENAI_API_KEY="your-openai-key-here"

# Anthropic (get your key from https://console.anthropic.com/settings/keys)
export ANTHROPIC_API_KEY="your-anthropic-key-here"

# Google AI (get your key from https://aistudio.google.com/app/apikey)
export GOOGLE_API_KEY="your-google-key-here"
आपको सिर्फ़ उन्हीं प्रदाताओं की कुंजियाँ चाहिए जिन्हें आप उपयोग करने की योजना बनाते हैं। Ollama के माध्यम से स्थानीय मॉडलों के लिए API कुंजियाँ आवश्यक नहीं हैं — बस अपनी मशीन पर Ollama इंस्टॉल करें और चलाएँ।
अपनी सेटअप को एक सरल परीक्षण से सत्यापित करें:
import langextract as lx
import textwrap

# 1. Define the prompt and extraction rules
prompt = textwrap.dedent(
   """\
   Extract characters, emotions, and relationships in order of appearance.
   Use exact text for extractions. Do not paraphrase or overlap entities.
   Provide meaningful attributes for each entity to add context."""
)

# 2. Provide a high-quality example to guide the model
examples = [
   lx.data.ExampleData(
       text="ROMEO. But soft! What light through yonder window breaks? It is the east, and Juliet is the sun.",
       extractions=[
           lx.data.Extraction(
               extraction_class="character",
               extraction_text="ROMEO",
               attributes={"emotional_state": "wonder"},
           ),
       ],
   )
]

# The input text to be processed
input_text = "Lady Juliet gazed longingly at the stars, her heart aching for Romeo"

# Run the extraction
result = lx.extract(
   text_or_documents=input_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini",
)

print("Extraction successful!")नामित इकाई पहचान (NER) पाठ में विशिष्ट जानकारी के टुकड़ों को ढूँढती और वर्गीकृत करती है — जैसे किसी व्यावसायिक रिपोर्ट में बताए गए सभी कंपनी नाम, व्यक्ति और स्थान।
पारंपरिक NER टूल “PERSON” या “ORGANIZATION” जैसी पूर्व-निर्धारित श्रेणियों के साथ काम करते हैं, पर अक्सर आपके व्यवसाय के लिए महत्वपूर्ण संदर्भ-विशिष्ट इकाइयाँ छूट जाती हैं। LangExtract आपको कस्टम इकाई प्रकार परिभाषित करने और अपने डोमेन के लिए विशिष्ट पैटर्न पहचानने के लिए AI को सिखाने देता है।
आइए ग्राहक सहायता ईमेल से इकाइयाँ निकालकर देखते हैं। सामान्य श्रेणियों की बजाय, हम सपोर्ट-विशिष्ट इकाइयाँ पहचानेंगे जैसे शिकायत के प्रकार, उत्पाद के नाम, और समाधान की समय-सीमाएँ जो टिकटों को प्राथमिकता देने में मदद करें।
पहला कदम एक स्पष्ट प्रॉम्प्ट के साथ यह बताना है कि आप क्या निकालना चाहते हैं। यह प्रॉम्प्ट एक मानव विश्लेषक के निर्देशों जैसा काम करता है — जितने विशिष्ट होंगे, उतने बेहतर परिणाम मिलेंगे:
import langextract as lx
import textwrap

# Define what we want to extract from support emails
prompt = textwrap.dedent("""
   Extract customer support entities from email text.
   Focus on actionable information that helps prioritize and route tickets.
   Use exact text from the email - don't paraphrase or summarize.
   Include helpful attributes that add context for support agents.
""")
फ़ंक्शन textwrap.dedent() मल्टीलाइन स्ट्रिंग्स से अतिरिक्त इंडेंटेशन हटाता है, जिससे आपका प्रॉम्प्ट कोड में पढ़ने में आसान रहता है और AI को भेजे जाने पर साफ़ दिखता है। इसके बिना AI आपके कोड के इंडेंटेशन से आए अतिरिक्त स्पेस भी देखता।
यह प्रॉम्प्ट AI को सपोर्ट-विशिष्ट जानकारी ढूँढने, पाठ से सटीक उद्धरण इस्तेमाल करने, और गुणों के माध्यम से संदर्भ जोड़ने का निर्देश देता है। प्रमुख बात है आपके डोमेन (कस्टमर सपोर्ट) के बारे में स्पष्ट होना और यह बताना कि क्या चीज़ उपयोगी है (जो टिकटों को प्राथमिकता देने और रूट करने में मदद करे)।
उदाहरण AI को ठीक-ठीक सिखाते हैं कि आपको क्या चाहिए और परिणाम कैसे फ़ॉर्मैट करने हैं। हर उदाहरण AI को पाठ का एक हिस्सा और उससे निकाली जाने वाली सटीक इकाइयाँ दिखाता है:
# Create examples that show the AI what to extract
examples = [
   lx.data.ExampleData(
       text="My laptop screen keeps flickering. I bought it 3 months ago and need this fixed urgently for my presentation tomorrow.",
       extractions=[
           lx.data.Extraction(
               extraction_class="product",
               extraction_text="laptop",
               attributes={"issue": "screen flickering", "urgency": "high"}
           ),
           lx.data.Extraction(
               extraction_class="timeline",
               extraction_text="3 months ago",
               attributes={"context": "purchase_date"}
           ),
           lx.data.Extraction(
               extraction_class="urgency_indicator",
               extraction_text="urgently for my presentation tomorrow",
               attributes={"priority": "high", "deadline": "tomorrow"}
           )
       ]
   )
]
हर ExampleData ऑब्जेक्ट में एक टेक्स्ट सैंपल और Extraction ऑब्जेक्ट्स की सूची होती है। Extraction ऑब्जेक्ट्स तीन बातें निर्दिष्ट करते हैं:
extraction_class: इकाई का प्रकार (जैसे "product" या "timeline")extraction_text: मूल पाठ के सटीक शब्दattributes: अतिरिक्त संदर्भ जो इकाई को बेहतर समझने में मदद करेयही गुण (attributes) LangExtract को पारंपरिक NER से अलग बनाते हैं। सिर्फ़ “laptop” ढूँढने के बजाय, हम पकड़ सकते हैं कि उसमें “screen flickering” की समस्या है और उसे उच्च तात्कालिकता के रूप में चिह्नित कर सकते हैं।
अब आप अपने प्रॉम्प्ट और उदाहरणों का उपयोग करके नए पाठ पर निष्कर्षण चला सकते हैं। LangExtract सीखे हुए पैटर्न लागू करके समान इकाइयाँ ढूँढेगा:
# Sample support email to analyze
support_email = """
Subject: WiFi adapter not working after Windows update

Hi support team,

My USB WiFi adapter stopped working completely after yesterday's Windows update.
I've tried restarting my computer multiple times but no luck. This is blocking me
from working from home today. I have an important client call at 2 PM and really
need internet access. The adapter worked perfectly before the update.

Thanks,
Mike Chen
"""

# Run the extraction
result = lx.extract(
   text_or_documents=support_email,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini"
)

print("Extraction completed successfully!")
आउटपुट:
INFO:absl:Finalizing annotation for document ID doc_435b1cd5.
INFO:absl:Document annotation completed.
✓ Extracted 4 entities (3 unique types)
 • Time: 3.34s
 • Speed: 123 chars/sec
 • Chunks: 1
Extraction completed successfully!
फ़ंक्शन lx.extract() आपका पाठ लेता है, प्रॉम्प्ट निर्देश लागू करता है, और उदाहरणों का उपयोग करके निष्कर्षण का मार्गदर्शन करता है। यह एक परिणाम ऑब्जेक्ट लौटाता है जिसमें मिली सभी इकाइयाँ और उनके मूल पाठ में सटीक स्थान शामिल होते हैं।
आप model_id पैरामीटर बदलकर अलग-अलग मॉडलों के साथ प्रयोग कर सकते हैं। "claude-3-haiku" या "gpt-4o" जैसे मॉडल आपके पाठ की जटिलता और आवश्यकताओं के अनुसार अलग परिणाम दे सकते हैं।
निष्कर्षण पूरा होने पर, LangExtract एक परिणाम ऑब्जेक्ट लौटाता है जिसमें मिली सभी इकाइयाँ उनके सटीक स्थानों और गुणों के साथ होती हैं। असली ताकत इस बात में है कि आप इस संरचित डेटा तक कैसे पहुँचते हैं, उसका विश्लेषण कैसे करते हैं, और उसे कैसे साझा करते हैं।
परिणाम ऑब्जेक्ट सभी मिली इकाइयाँ extractions प्रॉपर्टी में संग्रहीत करता है। हर एक्सट्रैक्शन में इकाई का पाठ, उसका प्रकार, मूल दस्तावेज़ में उसका स्थान, और कोई भी गुण शामिल होते हैं:
# Look at all extracted entities
for extraction in result.extractions:
   print(f"Type: {extraction.extraction_class}")
   print(f"Text: '{extraction.extraction_text}'")
   print(f"Location: chars {extraction.char_interval.start_pos}-{extraction.char_interval.end_pos}")
   print(f"Attributes: {extraction.attributes}")
   print("---")
आउटपुट:
Type: product
Text: 'USB WiFi adapter'
Location: chars 78-94
Attributes: {'issue': 'not working after Windows update', 'previous_status': 'worked perfectly before the update'}
---
Type: timeline
Text: 'yesterday'
Location: chars 128-137
Attributes: {'context': 'Windows update'}
---
Type: urgency_indicator
Text: 'blocking me from working from home today'
Location: chars 227-268
Attributes: {'priority': 'high', 'context': 'work from home'}
---
Type: urgency_indicator
Text: 'important client call at 2 PM'
Location: chars 280-309
Attributes: {'priority': 'high', 'deadline': '2 PM today'}
---
हर एक्सट्रैक्शन ऑब्जेक्ट char_interval का उपयोग करके जानकारी का स्रोत ठीक-ठीक ट्रैक करता है, जो मूल पाठ में आरंभ और अंत की पोजीशन दिखाता है। यह स्रोत ट्रैकिंग आपको परिणाम सत्यापित करने और संदर्भ समझने देती है।
आप इकाइयों को समूहित और गिनकर अपने डेटा में पैटर्न समझ सकते हैं:
from collections import Counter

# Count different entity types
entity_types = Counter(e.extraction_class for e in result.extractions)
print("Entity breakdown:")
for entity_type, count in entity_types.items():
   percentage = (count / len(result.extractions)) * 100
   print(f"  {entity_type}: {count} entities ({percentage:.1f}%)")

# Find high-priority support tickets
urgent_entities = [
   e for e in result.extractions
   if e.extraction_class == "urgency_indicator"
   and e.attributes.get("priority") == "high"
]
print(f"\nFound {len(urgent_entities)} high-priority indicators")
आउटपुट:
Entity breakdown:
 product: 1 entities (25.0%)
 timeline: 1 entities (25.0%)
 urgency_indicator: 2 entities (50.0%)

Found 2 high-priority indicators
यह विश्लेषण आपको जल्दी से ऐसे पैटर्न दिखाता है, जैसे कौन-से उत्पाद प्रकार सबसे अधिक सपोर्ट टिकट बनाते हैं या आपको कितनी तात्कालिक अनुरोध मिल रहे हैं।
LangExtract परिणामों को JSONL (JSON Lines) फ़ॉर्मेट में सहेजता है, जहाँ हर पंक्ति में एक दस्तावेज़ का निष्कर्षण डेटा होता है। यह फ़ॉर्मेट डेटा प्रोसेसिंग टूल्स के साथ अच्छा काम करता है और कई निष्कर्षणों के परिणामों को जोड़ना आसान बनाता है:
# Save results to a JSONL file
lx.io.save_annotated_documents(
   [result],
   output_name="support_ticket_extractions.jsonl",
   output_dir="."
)
JSONL हर दस्तावेज़ को अलग पंक्ति में एक पूर्ण JSON ऑब्जेक्ट के रूप में संग्रहीत करता है। सामान्य JSON फ़ाइलों के विपरीत, जिनमें एक बड़ा ऐरे होता है, JSONL फ़ाइलों को लाइन-दर-लाइन प्रोसेस किया जा सकता है, जिससे वे बड़े डेटासेट के लिए उपयुक्त बनती हैं। आप इन फ़ाइलों को किसी भी टेक्स्ट एडिटर में खोल सकते हैं या pandas जैसे डेटा विश्लेषण टूल में लोड कर सकते हैं।
HTML दृश्यावली वह जगह है जहाँ LangExtract वास्तव में अलग दिखता है। यह एक इंटरैक्टिव रिपोर्ट बनाता है जो मूल पाठ में निकाली गई इकाइयों को हाईलाइट करता है और आपको परिणामों पर क्लिक करके देखने देता है:
# Generate interactive HTML visualization
html_content = lx.visualize("support_ticket_extractions.jsonl")

# Save the HTML file
with open("support_analysis.html", "w") as f:
   if hasattr(html_content, "data"):
       f.write(html_content.data)  # For Jupyter notebooks
   else:
       f.write(html_content)  # For regular Python scripts

print("HTML visualization saved as 'support_analysis.html'")
आउटपुट:
HTML visualization saved as 'support_analysis.html'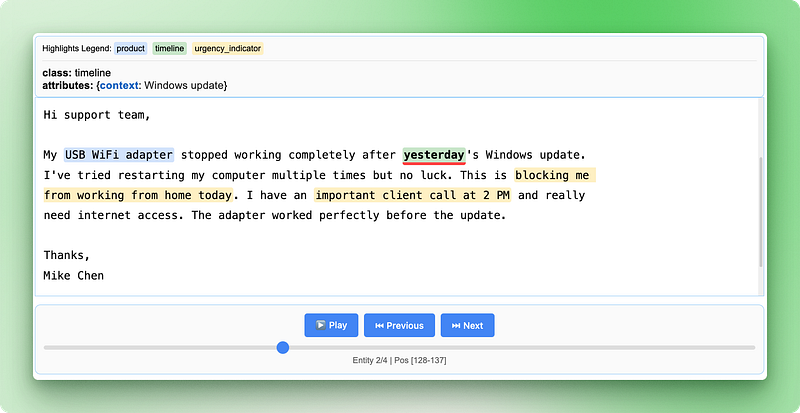
HTML दृश्यावली आपके मूल पाठ को हर इकाई प्रकार के लिए रंग-कोडेड हाईलाइट्स के साथ दिखाती है। आप हाईलाइटेड टेक्स्ट पर क्लिक करके निकाले गए गुण देख सकते हैं, कंट्रोल्स की मदद से अलग-अलग इकाइयों के बीच नेविगेट कर सकते हैं, और सत्यापित कर सकते हैं कि AI ने महत्वपूर्ण जानकारी सही पहचानी है। इससे परिणामों की स्पॉट-चेकिंग आसान हो जाती है और आपके एक्सट्रैक्शन पाइपलाइन पर भरोसा बढ़ता है।
विज़ुअलाइज़ेशन में प्रत्येक इकाई प्रकार दिखाने वाला एक लीजेंड, इकाइयों के बीच जाने के लिए नेविगेशन कंट्रोल्स, और हर एक्सट्रैक्शन के लिए विस्तृत गुण जानकारी शामिल होती है। यह इंटरैक्टिव तरीका कच्चे JSON डेटा देखने की तुलना में आपके परिणामों को समझना और मान्य करना काफ़ी आसान बना देता है।
हमने जो ग्राहक सहायता इकाइयाँ निकालीं, वे अलग-अलग तो ठीक काम करती हैं, लेकिन पूरी कहानी नहीं बतातीं। जब कोई ग्राहक कहता है “मेरे 2021 के MacBook Pro में बैटरी की समस्या है,” तो आपको समझना होता है कि उत्पाद, मॉडल वर्ष, और समस्या — ये सब एक ही सपोर्ट केस से जुड़े हैं। इन्हें अलग-अलग ढूँढ लेना पर्याप्त नहीं — आपको उनके बीच के संबंध चाहिए।
पारंपरिक NLP इसे ठीक से नहीं संभालता क्योंकि वह हर इकाई को अलग-थलग सूचना की तरह देखता है। आप “MacBook Pro”, “2021”, और “battery issues” को अलग इकाइयों के रूप में निकाल सकते हैं, पर फिर यह समझने के लिए जटिल नियम चाहिए कि कौन-सी जानकारी किस उत्पाद से संबंधित है। एक ही पाठ में कई उत्पादों या ग्राहकों के साथ यह तरीका जल्दी टूट जाता है।
LangExtract इसे बाद में इकाइयाँ जोड़ने की कोशिश करने की बजाय, शुरुआती चरण में ही संबंध निकालकर हल करता है। आप साझा गुणों के माध्यम से संबंधित जानकारी को समूहित कर सकते हैं और फिर भी मूल पाठ में हर टुकड़े का सटीक स्रोत ट्रैक कर सकते हैं। आइए HR दस्तावेज़ों से कर्मचारी जानकारी निकालें, जहाँ हमें लोगों को उनकी भूमिकाओं, विभागों, और संपर्क विवरण से जोड़ना है।
इस उदाहरण के लिए, हम कंपनी घोषणाओं से कर्मचारी जानकारी निकालेंगे जहाँ प्रत्येक व्यक्ति के बारे में कई विवरणों को जोड़ना होगा:
import langextract as lx
import textwrap

# Define relationship extraction prompt
prompt = textwrap.dedent("""
   Extract employee information from company announcements.
   Group related details about each person using employee_group attributes.
   Connect names, titles, departments, and contact info for each employee.
   Use exact text from the announcement - don't paraphrase.
""")

# Create examples showing how to group related information
examples = [
   lx.data.ExampleData(
       text="Sarah Johnson, our new Marketing Director, will lead the digital campaigns team. You can reach Sarah at sarah.j@company.com for any marketing questions.",
       extractions=[
           lx.data.Extraction(
               extraction_class="person",
               extraction_text="Sarah Johnson",
               attributes={"employee_group": "Sarah Johnson"}
           ),
           lx.data.Extraction(
               extraction_class="job_title",
               extraction_text="Marketing Director",
               attributes={"employee_group": "Sarah Johnson"}
           ),
           lx.data.Extraction(
               extraction_class="department",
               extraction_text="digital campaigns team",
               attributes={"employee_group": "Sarah Johnson"}
           ),
           lx.data.Extraction(
               extraction_class="contact",
               extraction_text="sarah.j@company.com",
               attributes={"employee_group": "Sarah Johnson", "type": "email"}
           )
       ]
   )
]
employee_group गुण एक लिंकिंग सिस्टम की तरह काम करता है — जिन सभी इकाइयों में एक जैसा employee_group मान है, वे एक ही व्यक्ति से संबंधित हैं। इससे आप जटिल, बहु-भाग जानकारी निकाल सकते हैं और यह भी बनाए रख सकते हैं कि कौन-सा विवरण किससे जुड़ा है।
अब आइए कई कर्मचारियों वाली कंपनी घोषणा से निष्कर्षण करें:
# Sample HR announcement with multiple employees
hr_announcement = """
We're excited to announce two new hires joining our team this month.

Mike Chen joins us as Senior Software Engineer in our Backend Development group. Mike brings 8 years of Python experience and will focus on API architecture. Please welcome Mike - he'll be working from our Seattle office and you can reach him at m.chen@company.com.

Additionally, Lisa Rodriguez starts as Product Manager for our Mobile Apps division. Lisa previously worked at TechStart Inc and has extensive experience with user research. Her office phone is 555-0199 and email is lisa.r@company.com.
"""

# Extract relationships
result = lx.extract(
   text_or_documents=hr_announcement,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini"
)

print(f"Extracted {len(result.extractions)} entities")
आउटपुट:
✓ Extraction processing complete

INFO:absl:Finalizing annotation for document ID doc_a349ae1d.
INFO:absl:Document annotation completed.
✓ Extracted 10 entities (4 unique types)
 • Time: 8.57s
 • Speed: 67 chars/sec
 • Chunks: 1
Extracted 10 entitiesनिष्कर्षण के बाद, आप संबंधित इकाइयों को समूहित कर सकते हैं ताकि प्रत्येक कर्मचारी की पूरी जानकारी देखी जा सके। इसके लिए बिखरी हुई इकाइयों को तर्कसंगत समूहों में व्यवस्थित करने हेतु कुछ Python कोड चाहिए:
from collections import defaultdict

# Group entities by employee_group
employee_groups = defaultdict(list)
for extraction in result.extractions:
   group_id = extraction.attributes.get("employee_group")
   if group_id:
       employee_groups[group_id].append(extraction)

# Print organized employee information
for employee, details in employee_groups.items():
   print(f"\n=== {employee} ===")
   for detail in details:
       print(f"{detail.extraction_class}: {detail.extraction_text}")
       if detail.attributes.get("type"):
           print(f"  Type: {detail.attributes['type']}")
आउटपुट:
=== Mike Chen ===
person: Mike Chen
job_title: Senior Software Engineer
department: Backend Development group
contact: m.chen@company.com
 Type: email
contact: Seattle office
 Type: location

=== Lisa Rodriguez ===
person: Lisa Rodriguez
job_title: Product Manager
department: Mobile Apps division
contact: lisa.r@company.com
 Type: email
contact: 555-0199
 Type: phone
यह कोड चरण-दर-चरण यह करता है:
defaultdict(list) ऐसा डिक्शनरी बनाता है जहाँ हर नई एंट्री अपने-आप खाली सूची से शुरू होती हैextraction.attributes.get("employee_group") हर इकाई के गुणों से सुरक्षित रूप से समूह ID लाता है, और न होने पर None लौटाता हैemployee_groups[group_id].append(extraction) हर इकाई को उसके समूह की सूची में जोड़ता हैdefaultdict एक Python संग्रह है जो गुम प्रविष्टियाँ अपने-आप बना देता है। जब आप पहली बार employee_groups["Mike Chen"] एक्सेस करते हैं, तो यह उस कर्मचारी के लिए अपने-आप एक खाली सूची बना देता है। इससे आपको हर कर्मचारी के लिए डिक्शनरी में पहले से एंट्री जाँचने की ज़रूरत नहीं रहती।
यह समूह बनाने का तरीका मूल पाठ में बिखरी जानकारी से पूर्ण कर्मचारी प्रोफ़ाइल फिर से बनाने देता है, और साथ ही हर डेटा अंश के सटीक स्रोत स्थानों को बनाए रखता है।
रिलेशनशिप डेटा के साथ HTML दृश्यावली और भी मूल्यवान हो जाती है, क्योंकि यह व्यक्तिगत इकाइयों और उनके कनेक्शनों—दोनों को दिखाती है:
# Save the relationship extraction results
lx.io.save_annotated_documents(
   [result],
   output_name="employee_relationships.jsonl",
   output_dir="."
)

# Generate HTML visualization showing relationships
html_content = lx.visualize("employee_relationships.jsonl")
with open("employee_relationships.html", "w") as f:
   if hasattr(html_content, "data"):
       f.write(html_content.data)
   else:
       f.write(html_content)

print("Relationship visualization saved as 'employee_relationships.html'")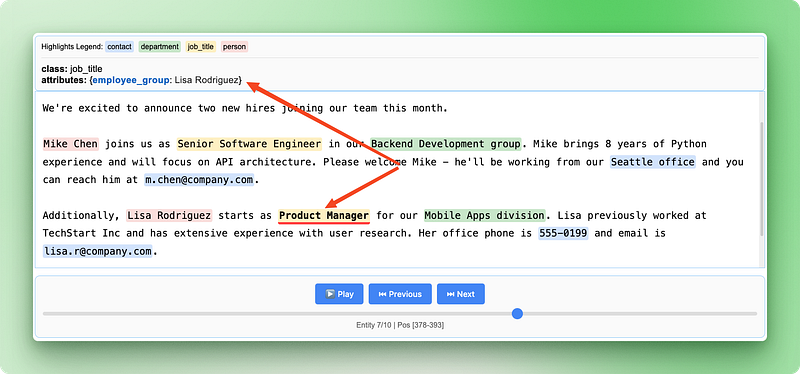
यह रिलेशनशिप दृश्यावली दिखाती है कि कैसे अलग-अलग जानकारी मिलकर पूर्ण कर्मचारी रिकॉर्ड बनाती है, जिससे यह सत्यापित करना आसान होता है कि AI ने मूल घोषणा से संबंधित विवरणों को सही पहचाना और समूहित किया।
LangExtract कई AI मॉडल प्रदाताओं के साथ काम करता है, जिनमें लागत, गति, और सटीकता के बीच अलग-अलग संतुलन होते हैं। Google के Gemini मॉडल बिल्ट-इन स्कीमा सपोर्ट के साथ सीधे काम करते हैं, जिससे वे अधिकतर निष्कर्षण कार्यों के लिए सबसे आसान विकल्प बनते हैं। OpenAI के GPT मॉडल प्रायः अधिक सटीकता देते हैं लेकिन अतिरिक्त कॉन्फ़िगरेशन की आवश्यकता होती है और प्रति निष्कर्षण अधिक लागत लगती है।
# Using Google Gemini (default and recommended)
result_gemini = lx.extract(
   text_or_documents=employee_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gemini-2.5-flash"  # Fast and cost-effective
)

# Using OpenAI GPT models
result_openai = lx.extract(
   text_or_documents=employee_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gpt-4o-mini",
   fence_output=True,              # Required for OpenAI
   use_schema_constraints=False    # OpenAI doesn't support constraints
)
स्थानीय प्रोसेसिंग के लिए या जब आप API लागतों से बचना चाहें, आप Ollama का उपयोग करके मॉडल्स को लोकली चला सकते हैं। स्थानीय मॉडल सरल निष्कर्षण कार्यों के लिए अच्छे रहते हैं और आपके डेटा पर पूरा नियंत्रण देते हैं, हालाँकि वे आम तौर पर धीमे चलते हैं और क्लाउड-आधारित विकल्पों की तुलना में कम सटीक हो सकते हैं।
# Using local models with Ollama (requires Ollama installed)
result_local = lx.extract(
   text_or_documents=employee_text,
   prompt_description=prompt,
   examples=examples,
   model_id="gemma2:2b",                    # Local Gemma model
   model_url="http://localhost:11434",     # Ollama server
   fence_output=False,                     # Local models don't need fencing
   use_schema_constraints=False            # Disable constraints
)वास्तविक दुनिया का पाठ हमारे साफ़-सुथरे उदाहरणों जैसा नहीं होता। आपको 50-पृष्ठ की रिपोर्ट मिलती हैं जिनका फ़ॉर्मेटिंग बिखरा होता है, ग्राहकों के ईमेल टाइपो से भरे होते हैं, और PDF में अजीब स्पेसिंग होती है। कुछ दस्तावेज़ों में अलग-अलग सेक्शनों में हज़ारों शब्द होते हैं, और महत्वपूर्ण जानकारी कहीं भी दबी हो सकती है।
LangExtract इन उलझनों को तीन मुख्य तरीकों से संभालता है: एक साथ कई दस्तावेज़ चलाना, निष्कर्षण को कई बार आज़माना, और बड़े दस्तावेज़ों को छोटे टुकड़ों में बाँटना। एक-एक दस्तावेज़ प्रोसेस करने के बजाय, आप कई दस्तावेज़ एक साथ प्रोसेस कर सकते हैं, जिससे सब कुछ बहुत तेज़ हो जाता है।
# Settings for processing lots of real documents
result = lx.extract(
   text_or_documents=document_batch,
   prompt_description=prompt,
   examples=examples,
   model_id="gemini-2.5-flash",
   max_workers=20,           # Work on many documents at once
   extraction_passes=3,      # Try extraction 3 times
   max_char_buffer=1000      # Break big text into small pieces
)
max_workers सेटिंग नियंत्रित करती है कि एक समय में कितने दस्तावेज़ प्रोसेस हों। ज़्यादा वर्कर्स तेज़ परिणाम देते हैं, पर इससे लागत बढ़ती है और API सीमाएँ भी आ सकती हैं। 10–20 वर्कर्स से शुरू करें और आवश्यकतानुसार समायोजित करें।
कई निष्कर्षण पास वे जानकारी ढूँढने में मदद करते हैं जो पहली बार छूट सकती है। LangExtract निष्कर्षण कई बार चलाकर परिणाम जोड़ता है। इससे विवरण ज़्यादा पकड़े जाते हैं, लेकिन समय और लागत दोनों बढ़ती हैं।
दस्तावेज़ों को टुकड़ों में बाँटना लंबे पाठ के साथ मदद करता है। max_char_buffer सेटिंग बड़े दस्तावेज़ों को छोटे हिस्सों में काटती है जो AI मॉडलों के साथ बेहतर काम करते हैं। छोटे टुकड़े (1000–2000 अक्षर) ज़्यादा विवरण पकड़ते हैं, जबकि बड़े टुकड़े (3000–5000 अक्षर) ज़्यादा संदर्भ रखते हैं पर कुछ चीज़ें छूट सकती हैं।
# Different settings for different types of documents

# For important documents that need careful review
detailed_result = lx.extract(
   text_or_documents=legal_documents,
   extraction_passes=5,      # Try 5 times for accuracy
   max_char_buffer=800,      # Small chunks for detail
   max_workers=10           # Fewer workers to avoid limits
)

# For quick processing of simple documents
quick_result = lx.extract(
   text_or_documents=email_batch,
   extraction_passes=1,      # Single pass for speed
   max_char_buffer=3000,     # Bigger chunks for speed
   max_workers=30           # More workers for faster results
)
प्रोडक्शन कार्य का मतलब है समस्याओं से निपटना। दस्तावेज़ों में एन्कोडिंग त्रुटियाँ हो सकती हैं, नेटवर्क कनेक्शन असफल हो सकते हैं, और API यह सीमित कर सकती हैं कि आप कितनी तेज़ी से प्रोसेस कर सकते हैं। अपने निष्कर्षण जॉब्स पर नज़र रखें, असफल दस्तावेज़ों के लिए रीट्राई लॉजिक जोड़ें, और अलग-अलग AI प्रदाताओं पर होने वाले खर्च को ट्रैक करें।
अलग-अलग दस्तावेज़ प्रकारों के साथ काम करते समय, प्रत्येक प्रकार के लिए अलग निष्कर्षण नियम सेट करें। कानूनी अनुबंधों को ग्राहक ईमेल से अलग प्रॉम्प्ट चाहिए। वित्तीय रिपोर्टों को सोशल मीडिया पोस्ट से अलग चंक आकार चाहिए। एक ही सिस्टम से सब संभालने की कोशिश करने के बजाय हर दस्तावेज़ प्रकार के लिए अलग पाइपलाइन बनाएँ।
LangExtract पारंपरिक NLP लाइब्रेरीज़ की तुलना में अलग दृष्टिकोण अपनाता है। जहाँ अधिकांश लाइब्रेरीज़ प्री-ट्रेंड मॉडलों या नियम-आधारित प्रणालियों पर निर्भर करती हैं, LangExtract बड़े भाषा मॉडलों (LLMs) का उपयोग करता है जो मनुष्यों की तरह संदर्भ और अर्थ समझ सकते हैं। आइए इसे तीन लोकप्रिय Python NLP लाइब्रेरीज़ से तुलना करके देखें कि आप कब LangExtract को अन्य विकल्पों पर चुनेंगे।
spaCy गति और प्रोडक्शन-तैयार NLP कार्यों जैसे टोकनाइज़ेशन, पार्ट-ऑफ़-स्पीच टैगिंग, और नामित इकाई पहचान पर केंद्रित है। इसमें लोगों, संगठनों, और स्थानों जैसी सामान्य इकाइयों को पहचानने वाले प्री-ट्रेंड मॉडल आते हैं, लेकिन डोमेन-विशिष्ट इकाइयों या कस्टम श्रेणियों पर यह संघर्ष करता है। spaCy बड़े पैमाने पर पाठ को जल्दी प्रोसेस करने में उत्कृष्ट है, पर कस्टम जानकारी निकालने के लिए आपको मॉडल फिर से प्रशिक्षित करने या जटिल नियम लिखने पड़ते हैं।
LangExtract इस जटिलता को सरल उदाहरणों और प्रॉम्प्ट्स के माध्यम से कस्टम इकाइयाँ परिभाषित करने देकर दूर कर देता है, और साथ ही वे सटीक स्रोत लोकेशन देता है जो spaCy ट्रैक नहीं करता।
NLTK (Natural Language Toolkit) शिक्षा और शोध के लिए डिज़ाइन किया गया है, और यह NLP एल्गोरिद्म और डेटासेट्स की एक विस्तृत श्रृंखला उपलब्ध कराता है। यह पाठ प्रोसेसिंग के लिए बिल्डिंग ब्लॉक्स देता है, लेकिन पूर्ण समाधान बनाने के लिए पर्याप्त प्रोग्रामिंग ज्ञान चाहिए। NLTK से सीखने और प्रोटोटाइपिंग में मदद मिलती है, पर प्रोडक्शन-तैयार निष्कर्षण प्रणालियाँ बनाने के लिए कई घटकों को जोड़ना और काफी कोड लिखना पड़ता है।
LangExtract बॉक्स से बाहर एक संपूर्ण समाधान देता है — आप एल्गोरिद्म कोड करने के बजाय उदाहरणों के माध्यम से बताते हैं कि आपको क्या चाहिए, और बिना अतिरिक्त विकास कार्य के इंटरैक्टिव दृश्यावलियाँ प्राप्त करते हैं।
Transformers (Hugging Face) अत्याधुनिक ट्रांसफ़ॉर्मर मॉडलों तक पहुँच देता है, जिनसे NER और प्रश्नोत्तर सहित विभिन्न NLP कार्य किए जा सकते हैं। यह शक्तिशाली है, लेकिन विशिष्ट डोमेनों के लिए मॉडल फाइन-ट्यून करने हेतु मशीन लर्निंग विशेषज्ञता चाहिए, और यह बिल्ट-इन स्रोत ट्रैकिंग या रिलेशनशिप एक्सट्रैक्शन प्रदान नहीं करता। आपको मॉडल परिनियोजन संभालना, अलग-अलग मॉडल फ़ॉर्मैट्स मैनेज करना, और अपनी विज़ुअलाइज़ेशन टूल्स बनानी पड़ती हैं।
LangExtract विभिन्न AI मॉडलों के साथ काम करने की जटिलता को एब्स्ट्रैक्ट कर देता है, स्रोत ट्रैकिंग अपने-आप संभालता है, और जटिल मॉडल आर्किटेक्चर के बजाय सरल एट्रिब्यूट ग्रुपिंग के माध्यम से रिलेशनशिप एक्सट्रैक्शन देता है।
|
विशेषता |
LangExtract |
spaCy |
NLTK |
Transformers |
|
सेटअप जटिलता |
सरल प्रॉम्प्ट + उदाहरण |
मॉडल प्रशिक्षण/नियम |
एल्गोरिद्म कोडिंग |
मॉडल फाइन-ट्यूनिंग |
|
कस्टम इकाइयाँ |
प्राकृतिक भाषा में परिभाषा |
रिट्रेनिंग आवश्यक |
मैन्युअल नियम लेखन |
मॉडल फाइन-ट्यूनिंग |
|
स्रोत ट्रैकिंग |
सटीक पोज़ीशन सहित स्वचालित |
उपलब्ध नहीं |
मैन्युअल कार्यान्वयन |
मैन्युअल कार्यान्वयन |
|
रिलेशनशिप एक्सट्रैक्शन |
बिल्ट-इन ग्रुपिंग |
जटिल नियम लेखन |
मैन्युअल कोडिंग |
कस्टम मॉडल विकास |
|
संदर्भ समझ |
LLM-संचालित |
पैटर्न-आधारित |
नियम-आधारित |
मॉडल-निर्भर |
|
विज़ुअलाइज़ेशन |
इंटरैक्टिव HTML |
बाहरी टूल्स आवश्यक |
बाहरी टूल्स आवश्यक |
बाहरी टूल्स आवश्यक |
|
लर्निंग कर्व |
कम (उदाहरण-आधारित) |
मध्यम (NLP ज्ञान) |
उच्च (एल्गोरिद्म) |
उच्च (ML विशेषज्ञता) |
|
उत्तम उपयोग |
डोमेन-विशिष्ट निष्कर्षण |
सामान्य NLP पाइपलाइंस |
शोध/सीखना |
कस्टम AI अनुप्रयोग |
LangExtract पाठ निष्कर्षण को जटिल नियम लिखने से बदलकर आपके डेटा पर AI से “बात” करने जैसा बना देता है। आपने सीखा कि सरल प्रॉम्प्ट और उदाहरणों से कस्टम इकाई निष्कर्षण कैसे सेट करें, संबंध निष्कर्षण के जरिए संबंधित जानकारी कैसे समूहित करें, और इंटरैक्टिव दृश्यावलियाँ कैसे बनाएँ जो दिखाती हैं कि हर डेटा अंश कहाँ से आया। लाइब्रेरी पैरेलल प्रोसेसिंग और डॉक्यूमेंट चंकिंग जैसी प्रोडक्शन चुनौतियों को संभालती है, जिससे यह उलझे, असंगत पाठ वाले वास्तविक अनुप्रयोगों के लिए व्यावहारिक बनती है।
चाहे आप ग्राहक सहायता टिकट प्रोसेस कर रहे हों, कानूनी दस्तावेज़ों का विश्लेषण कर रहे हों, या शोध पत्रों से अंतर्दृष्टि निकाल रहे हों — LangExtract पारंपरिक NLP लाइब्रेरीज़ की तुलना में अधिक सहज तरीका प्रदान करता है। मॉडल प्रशिक्षण या नियम लेखन में समय देने के बजाय, आप अपने उपयोग के मामले के लिए महत्वपूर्ण जानकारी परिभाषित करने पर ध्यान दे सकते हैं। अपने स्वयं के पाठ डेटा पर सरल निष्कर्षण से शुरू करें, फिर इस ट्यूटोरियल में कवर की गई प्रोडक्शन तकनीकों का उपयोग करके स्केल करें।
इन पाठ्यक्रमों के साथ AI सीखें!
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें