

为何在 RAG 中选择 Llama 3.1?
Llama 3.1 是 RAG 的理想选择。RAG 将检索系统与语言模型的文本生成能力相结合,以确保输出更准确、更相关。
在 RAG 中,检索系统会先在大型数据集中查找最相关的信息,语言模型再据此生成最终回答。这对于问答、构建聊天机器人以及处理信息密集型任务尤为有用,因为传统语言模型可能会给出过时或不相关的答案。
凭借最多支持 128K tokens 和多语言能力,Llama 3.1 能显著提升 RAG 系统中 AI 生成内容的质量与可靠性。
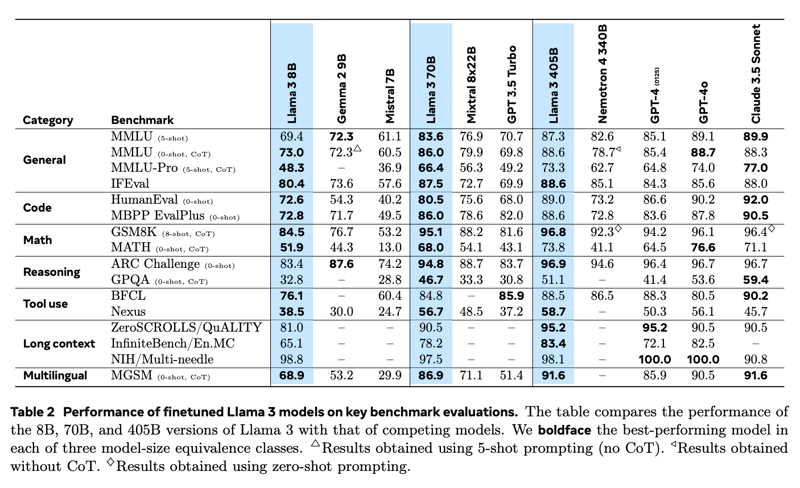
此外,与 GPT-4o 和 Claude 3.5 Sonnet 等闭源模型相比,Llama 3.1 在 RAG 应用中同样表现突出。其强大的推理能力和对更长文本的处理能力,使其更擅长应对复杂问题并产出更相关的答案。
在 Needle-in-a-Haystack(NIH,“大海捞针”)基准测试中,该测试考察模型在海量文本(“干草堆”)中定位特定信息(“针”)的能力,Llama 3.1 在各模型规模上都展现出近乎完美的检索率。这证明了其处理复杂搜索任务的能力,非常适合需要从大型数据集中提取精确信息的 RAG 系统。
该模型在 Multi-needle 基准中也有出色表现,该测试要求准确检索多条信息。其近乎完美的结果进一步证明了其胜任复杂检索任务的能力。
如何使用 Ollama 和 Langchain 基于 Llama 3.1 实现 RAG
要用 Llama 3.1 搭建 RAG 应用,需要完成若干步骤。这包括将 Llama 3.1 模型下载到本地、设置环境、加载必要的库,并创建一个检索机制。最后,我们将其与语言模型结合,构建完整应用。
以下是一个清晰的分步指南,帮助您基于 Llama 3.1 实现 RAG 应用。
步骤 1:安装 Ollama
首先安装 Ollama 应用,它可以在本地运行 Llama 3.1 及其他开源语言模型。您可以从其官方网站下载 Ollama。
安装并打开 Ollama 后,下一步是在本地下载 Llama 3.1 模型。本文示例使用 8B 参数版本。请打开终端运行以下命令:
ollama run llama3.1模型下载完成后,我们就可以通过 Langchain 进行连接,具体方法将在后续章节展示。
步骤 2:设置环境
在开始之前,请确保安装了合适的 Python 库。我们需要 langchain、langchain_community、langchain-ollama、langchain_openai 等库。如果尚未安装,可使用 pip 运行以下命令:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollama步骤 3:加载并准备文档
创建 RAG 系统的第一步是加载将作为知识库的文档。此示例中,我们使用网页作为数据源。
操作方法如下:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
"<https://lilianweng.github.io/posts/2023-06-23-agent/>",
"<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
"<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]这里,WebBaseLoader 用于抓取每个给定 URL 的内容。得到的文档嵌套列表随后被合并为一个名为 docs_list 的扁平列表,作为我们的文档集合。
步骤 4:将文档切分为片段
为提升检索效率,我们使用 RecursiveCharacterTextSplitter 将文档切分为更小的片段,这有助于系统更高效地处理与搜索文本。
我们可以通过设置片段大小与重叠来配置分割器。如下所示,片段大小为 250 个字符,且无重叠。
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)步骤 5:创建向量存储
接下来,我们需要将文本片段转换为向量嵌入,并存入向量库,以便基于相似度进行快速高效的检索。
为此,我们使用 OpenAIEmbeddings 为每个文本片段生成嵌入,并将其存储在 SKLearnVectorStore 中。通过配置 as_retriever(k=4),向量库会针对任一查询返回最相关的前 4 个文档。
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
documents=doc_splits,
embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)步骤 6:设置 LLM 与提示模板
本步骤将设置 LLM,并创建提示模板,以便基于检索到的文档生成回答。
首先,我们需要定义提示模板来指导 LLM 格式化答案。该模板要求模型使用所提供的文档,在最多三句话内简明回答问题;若无法找到答案,应直接说明不知道。
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
template="""You are an assistant for question-answering tasks.
Use the following documents to answer the question.
If you don't know the answer, just say that you don't know.
Use three sentences maximum and keep the answer concise:
Question: {question}
Documents: {documents}
Answer:
""",
input_variables=["question", "documents"],
)接着,我们通过 Langchain 的 ChatOllama 连接 Llama 3.1 模型,并将温度设置为 0,以获得更一致的回答。
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
model="llama3.1",
temperature=0,
)最后,我们创建一个链,将提示模板与 LLM 组合,并使用 StrOutputParser 确保输出为干净、便于展示的纯文本字符串。
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()步骤 7:将检索器与 LLM 集成到 RAG 应用中
本步骤我们将组合检索器与 RAG 链,创建一个完整的 RAG 应用。我们会创建一个名为 RAGApplication 的类,用于同时处理文档检索与答案生成。
RAGApplication 类包含 run 方法:接收用户问题,使用检索器查找相关文档并提取文本,然后将问题与文档文本传入 RAG 链,生成简明答案。
# Define the RAG application class
class RAGApplication:
def __init__(self, retriever, rag_chain):
self.retriever = retriever
self.rag_chain = rag_chain
def run(self, question):
# Retrieve relevant documents
documents = self.retriever.invoke(question)
# Extract content from retrieved documents
doc_texts = "\\n".join([doc.page_content for doc in documents])
# Get the answer from the language model
answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answer步骤 8:测试应用
最后,我们可以用一些示例问题测试 RAG 应用是否正常工作。您可以调整提示模板或检索设置,以改进性能或针对特定需求进行优化。
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.Llama 3.1 与 RAG:真实世界的应用
Llama 3.1 的先进特性与对 RAG 的支持,使其非常适合多个具有影响力的场景。
对于聊天机器人开发,将 Llama 3.1 与 RAG 集成,能够让机器人通过访问外部数据库或知识库,提供更准确、具备上下文意识的回答。这能确保提供给用户的信息既及时又相关,尤其在客户服务等领域,及时且准确的回答能显著提升用户满意度与效率。Llama 3.1 对多语言的支持也使其能够更好地服务多元用户群体。
在问答系统中,Llama 3.1 能弥补仅依赖内部数据集的传统语言模型的不足。借助 RAG 访问来自外部来源的最新信息,Llama 3.1 可提升答案的准确性与可靠性。这在医疗与教育等需要精确且最新信息的领域尤其重要。
例如,一个由 Llama 3.1 驱动的医疗 AI 助手可以实时查询医学数据库,为医护人员提供最新研究或治疗指南,从而辅助更优的临床决策。
Llama 3.1 也非常适合知识密集型任务,如撰写详尽报告或进行深入研究。借助 RAG 融合多元来源,Llama 3.1 模型能提供更全面、细致的分析,对科研、金融和战略规划等领域的专业人士尤为有价值。
总结
使用 Ollama 和 Langchain 基于 Llama 3.1 实现 RAG,为构建先进、具备上下文感知能力的语言模型提供了一种优选方案。
按照上述步骤——设置环境、加载与处理文档、创建嵌入、并将检索器与 LLM 集成——您即可构建出能够检索相关信息并提供准确回答的 RAG 系统。
Llama 3.1 与 RAG 的结合,尤其适用于聊天机器人、问答系统与研究工具等真实场景,在这些场景中,获取最新的外部信息至关重要。

Ryan 是一名首席数据科学家,专注于使用大型语言模型构建 AI 应用。他是伦敦帝国理工学院自然语言处理与知识图谱方向的博士候选人,并在该校获得了计算机科学硕士学位。除数据科学之外,他还撰写每周的 Substack 时事通讯 The Limitless Playbook,分享来自全球顶尖思想家的一个可操作理念,并不时撰写关于核心 AI 概念的文章。
Meta 发布的 Llama 3.1 标志着开源权重大语言模型的一次重要进步。
Llama 3.1 的参数规模最高可达 4050 亿,在能力上可与顶级闭源模型 OpenAI 的 GPT-4o、Anthropic 的 Claude 3 和 Google Gemini 相媲美。
在本教程中,我们将学习如何使用 Llama 3.1 8B 模型实现检索增强生成(RAG)应用。我们将了解 Llama 3.1 适合做 RAG 的原因,如何使用 Ollama 在本地下载并访问 Llama 3.1,以及如何使用 Langchain 连接构建整体 RAG 应用。我们还将了解 Llama 3.1 的不同用例与实际应用。