

Llama.cpp क्या है?
Llama.cpp का विकास Georgi Gerganov द्वारा किया गया है। यह Meta के LLaMa आर्किटेक्चर को कुशल C/C++ में इम्प्लीमेंट करता है, और LLM इन्फरेंस के इर्द-गिर्द सबसे गतिशील ओपन-सोर्स समुदायों में से एक है, जिसमें 900 से अधिक योगदानकर्ता, आधिकारिक GitHub रिपॉजिटरी पर 69000+ स्टार्स और 2600+ रिलीज़ हैं।
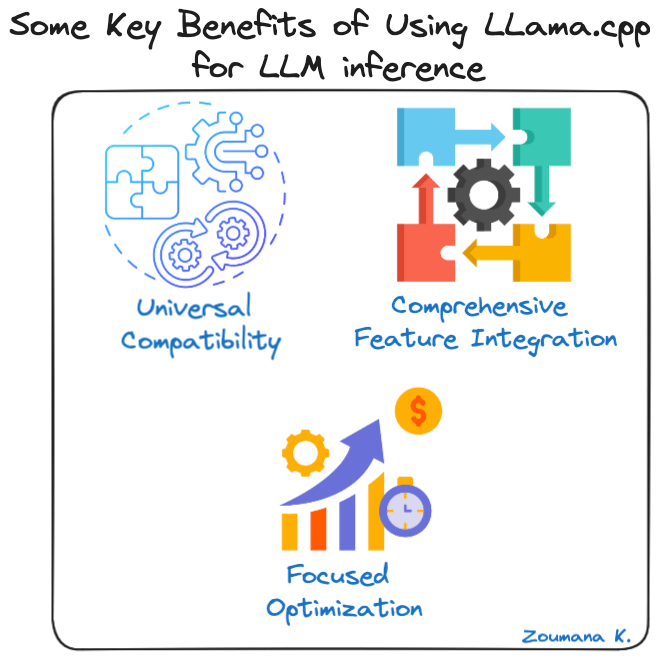
LLM इन्फरेंस के लिए LLama.cpp उपयोग करने के कुछ प्रमुख लाभ
- सार्वभौमिक अनुकूलता: Llama.cpp का CPU-प्रथम C++ लाइब्रेरी के रूप में डिज़ाइन कम जटिलता और अन्य प्रोग्रामिंग परिवेशों में आसान इंटीग्रेशन का अर्थ देता है। यह व्यापक अनुकूलता विभिन्न प्लेटफॉर्म्स पर इसके अपनाने में तेजी लाती है।
- व्यापक फीचर इंटीग्रेशन: आवश्यक लो-लेवल फीचर्स के लिए रिपॉजिटरी के रूप में काम करते हुए, Llama.cpp हाई-लेवल क्षमताओं के लिए LangChain के दृष्टिकोण को प्रतिबिंबित करता है, जो विकास प्रक्रिया को सुव्यवस्थित करता है, भले ही भविष्य में स्केलेबिलिटी चुनौतियाँ हो सकती हैं।
- केंद्रित ऑप्टिमाइज़ेशन: Llama.cpp एक ही मॉडल आर्किटेक्चर पर फोकस करता है, जिससे सटीक और प्रभावी सुधार संभव होते हैं। GGML और GGUF जैसे फ़ॉर्मैट्स के माध्यम से Llama मॉडलों के प्रति इसकी प्रतिबद्धता ने पर्याप्त दक्षता लाभ दिलाए हैं।
Llama.cpp की इस समझ के साथ, इस ट्यूटोरियल के अगले भागों में टेक्स्ट जनरेशन उपयोग मामले के इम्प्लीमेंटेशन की प्रक्रिया से गुजरा जाएगा। हम LLama.cpp की बुनियादी बातें समझने, हाथ में लिए गए प्रोजेक्ट के एंड-टू-एंड वर्कफ़्लो को देखने और इसके विभिन्न उद्योगों में अनुप्रयोगों का विश्लेषण करने से शुरुआत करेंगे।
Llama.cpp आर्किटेक्चर
Llama.cpp की रीढ़ मूल Llama मॉडल हैं, जो ट्रांसफॉर्मर आर्किटेक्चर पर आधारित हैं। Llama के लेखकों ने बाद में प्रस्तावित और विभिन्न मॉडलों जैसे PaLM में उपयोग किए गए कई सुधारों का लाभ उठाया है।
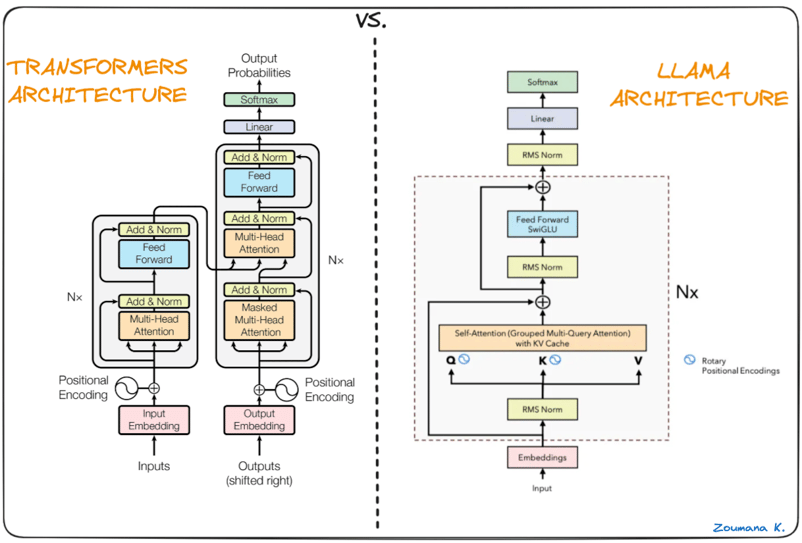
ट्रांसफॉर्मर्स और Llama आर्किटेक्चर के बीच अंतर (Llama आर्किटेक्चर: उमर जमील)
LLaMa आर्किटेक्चर और ट्रांसफॉर्मर्स के बीच मुख्य अंतर:
- प्री-नॉर्मलाइज़ेशन (GPT3): प्रशिक्षण स्थिरता में सुधार के लिए, आउटपुट को नॉर्मलाइज़ करने के बजाय, प्रत्येक ट्रांसफॉर्मर सब-लेयर के इनपुट को RMSNorm पद्धति से नॉर्मलाइज़ किया जाता है।
- SwiGGLU सक्रियण फ़ंक्शन (PaLM): मूल गैर-रेखीय ReLU सक्रियण फ़ंक्शन को SwiGLU सक्रियण फ़ंक्शन से बदला गया है, जिससे प्रदर्शन में सुधार होता है।
- रोटरी एम्बेडिंग्स (GPTNeao): एबसोल्यूट पोज़िशनल एम्बेडिंग्स हटाने के बाद, नेटवर्क की प्रत्येक लेयर पर रोटरी पोज़िशनल एम्बेडिंग्स (RoPE) जोड़ी गई हैं।
पर्यावरण सेटअप
LLama.cpp के साथ काम शुरू करने के लिए आवश्यक पूर्वापेक्षाएँ:
Python: ताकि आप pip चला सकें, जो Python पैकेज मैनेजर हैLlama-cpp-python: llama.cpp के लिए Python बाइंडिंग
वर्चुअल एनवायरनमेंट बनाएँ
इंस्टॉलेशन प्रक्रिया से संबंधित किसी भी परेशानी से बचने के लिए वर्चुअल एनवायरनमेंट बनाना अनुशंसित है, और conda एनवायरनमेंट बनाने के लिए एक अच्छा विकल्प हो सकता है।
इस भाग के सभी कमांड टर्मिनल से चलाए जाते हैं। conda create स्टेटमेंट का उपयोग करके, हम llama-cpp-env नाम का वर्चुअल एनवायरनमेंट बनाते हैं।
conda create --name llama-cpp-envवर्चुअल एनवायरनमेंट सफलतापूर्वक बनने के बाद, हम नीचे दिए अनुसार conda activate स्टेटमेंट का उपयोग करके इसे सक्रिय करते हैं:
conda activate llama-cpp-envउपरोक्त स्टेटमेंट टर्मिनल की शुरुआत में ब्रैकेट्स के बीच एनवायरनमेंट वेरिएबल का नाम इस प्रकार दिखाएगा:
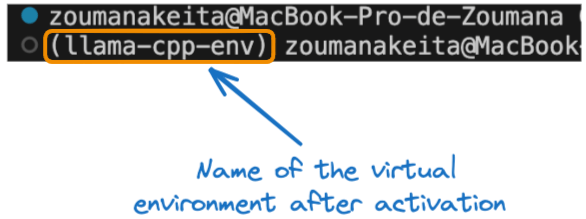
सक्रियण के बाद वर्चुअल एनवायरनमेंट का नाम
अब, हम llama-cpp-python पैकेज इस प्रकार इंस्टॉल कर सकते हैं:
pip install llama-cpp-python
or
pip install llama-cpp-python==0.1.48llama_cpp_script.py का सफल निष्पादन दर्शाता है कि लाइब्रेरी सही तरीके से इंस्टॉल हो गई है।
इंस्टॉलेशन के सफल होने की पुष्टि करने के लिए, आइए import स्टेटमेंट जोड़ें, फिर स्क्रिप्ट चलाएँ।
- पहले,
from llama_cpp import Llamaकोllama_cpp_script.pyफ़ाइल में जोड़ें, फिर - Python
llama_cpp_script.pyचलाएँ। यदि लाइब्रेरी इम्पोर्ट होने में विफल रहती है, तो एक त्रुटि फेंकी जाएगी; ऐसे में इंस्टॉलेशन प्रक्रिया के लिए और जाँच की आवश्यकता होगी।
Llama.cpp की बुनियादी बातें समझें
इस चरण पर, इंस्टॉलेशन प्रक्रिया सफल होनी चाहिए। अब LLama.cpp की बुनियादी बातों को समझते हैं।
ऊपर इम्पोर्ट की गई Llama क्लास Llama.cpp का उपयोग करते समय मुख्य कंस्ट्रक्टर है, और यह कई पैरामीटर्स लेती है, जो नीचे दिए गए तक सीमित नहीं हैं। पैरामीटर्स की पूरी सूची आधिकारिक दस्तावेज़ में दी गई है:
model_path: इस्तेमाल किए जा रहे Llama मॉडल फ़ाइल का पथprompt: मॉडल के लिए इनपुट प्रॉम्प्ट। यह टेक्स्ट टोकनाइज़ होकर मॉडल को पास किया जाता है।device: Llama मॉडल चलाने के लिए डिवाइस; यह CPU या GPU हो सकता है।max_tokens: मॉडल की प्रतिक्रिया में जेनरेट होने वाले टोकन्स की अधिकतम संख्याstop: स्ट्रिंग्स की सूची जो मॉडल की जेनरेशन प्रक्रिया को रोक देगीtemperature: यह मान 0 और 1 के बीच होता है। मान जितना कम होगा, परिणाम उतना ही निर्धारक होगा। दूसरी ओर, उच्च मान अधिक रैंडमनेस लाता है, जिससे आउटपुट अधिक विविध और रचनात्मक हो सकता है।top_p: भविष्यवाणियों की विविधता को नियंत्रित करने के लिए उपयोग होता है, यानी यह उन सबसे संभावित टोकन्स का चयन करता है जिनकी संचयी प्रायिकता दिए गए थ्रेशहोल्ड से अधिक हो। शून्य से शुरू होकर, उच्च मान बेहतर आउटपुट खोजने की संभावना बढ़ाता है लेकिन अतिरिक्त गणनाएँ मांगता है।echo: एक बूलियन जो निर्धारित करता है कि मॉडल मूल प्रॉम्प्ट को शुरुआत में शामिल करे (True) या न करे (False)
उदाहरण के लिए, मान लीजिए कि हम वर्तमान कार्यशील निर्देशिका में संग्रहीत <MY_AWESOME_MODEL> नामक एक लार्ज लैंग्वेज मॉडल का उपयोग करना चाहते हैं। इंस्टैंशिएशन प्रक्रिया इस प्रकार दिखेगी:
# Instanciate the model
my_aweseome_llama_model = Llama(model_path="./MY_AWESOME_MODEL")
prompt = "This is a prompt"
max_tokens = 100
temperature = 0.3
top_p = 0.1
echo = True
stop = ["Q", "\n"]
# Define the parameters
model_output = my_aweseome_llama_model(
prompt,
max_tokens=max_tokens,
temperature=temperature,
top_p=top_p,
echo=echo,
stop=stop,
)
final_result = model_output["choices"][0]["text"].strip()कोड स्वयं व्याख्यात्मक है और प्रत्येक पैरामीटर के अर्थ को बताने वाले आरंभिक बिंदुओं से आसानी से समझा जा सकता है।
मॉडल का परिणाम एक डिक्शनरी होता है जिसमें जनरेटेड प्रतिक्रिया और कुछ अतिरिक्त मेटाडेटा शामिल होते हैं। आउटपुट के फ़ॉर्मैट का अध्ययन लेख के अगले भागों में किया गया है।
आपका पहला Llama.cpp प्रोजेक्ट
अब टेक्स्ट जनरेशन प्रोजेक्ट के इम्प्लीमेंटेशन की शुरुआत करने का समय है। नया Llama.cpp प्रोजेक्ट शुरू करना ऊपर दिए Python कोड टेम्पलेट का अनुसरण करने भर का काम है, जो रुचि के लार्ज लैंग्वेज मॉडल को लोड करने से लेकर अंतिम प्रतिक्रिया जेनरेट करने तक के सभी चरण समझाता है।
प्रोजेक्ट Hugging Face के Zephyr-7B-Beta के GGUF संस्करण का उपयोग करता है। यह mistralai/Mistral-7B-v0.1 का फाइन-ट्यून किया गया संस्करण है, जिसे Direct Preference Optimization (DPO) का उपयोग करके सार्वजनिक रूप से उपलब्ध, सिंथेटिक डेटासेट्स के मिश्रण पर प्रशिक्षित किया गया है।
हमारा Transformers और Hugging Face का परिचय ट्रांसफॉर्मर्स को बेहतर तरीके से समझने और वास्तविक समस्याएँ हल करने में उनकी शक्ति का उपयोग करना सिखाता है। हमारे पास Mistral 7B ट्यूटोरियल भी है।
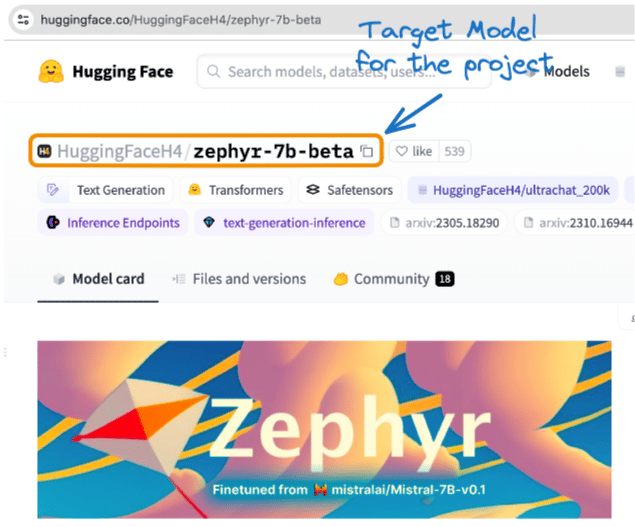
Hugging Face पर Zephyr मॉडल (स्रोत)
एक बार मॉडल लोकली डाउनलोड हो जाने पर, हम इसे प्रोजेक्ट लोकेशन के model फ़ोल्डर में ले जा सकते हैं। इम्प्लीमेंटेशन में उतरने से पहले, प्रोजेक्ट संरचना समझते हैं:
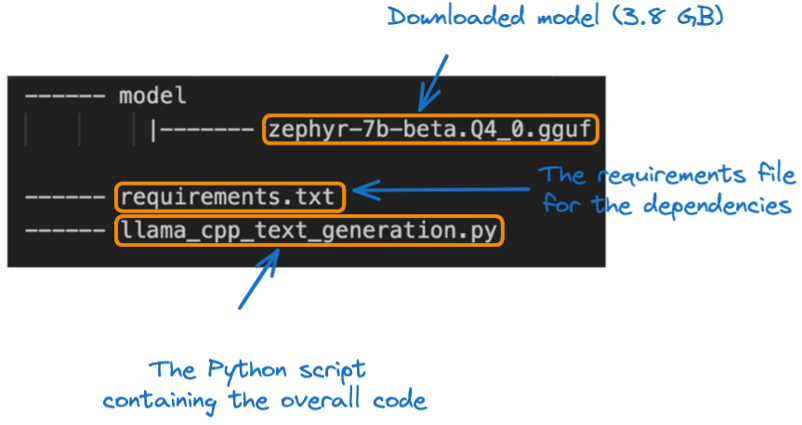
प्रोजेक्ट की संरचना
पहला कदम Llama कंस्ट्रक्टर का उपयोग करके मॉडल लोड करना है। चूँकि यह एक बड़ा मॉडल है, यह बताना महत्वपूर्ण है कि लोड किए जाने वाले मॉडल का अधिकतम कॉन्टेक्स्ट आकार क्या होगा। इस विशेष प्रोजेक्ट में, हम 512 टोकन्स का उपयोग करते हैं।
from llama_cpp import Llama
# GLOBAL VARIABLES
my_model_path = "./model/zephyr-7b-beta.Q4_0.gguf"
CONTEXT_SIZE = 512
# LOAD THE MODEL
zephyr_model = Llama(model_path=my_model_path,
n_ctx=CONTEXT_SIZE)मॉडल लोड हो जाने के बाद, अगला चरण टेक्स्ट जनरेशन का है। मूल कोड टेम्पलेट का उपयोग करते हुए, हम एक सहायक फ़ंक्शन generate_text_from_prompt का उपयोग करेंगे।
def generate_text_from_prompt(user_prompt,
max_tokens = 100,
temperature = 0.3,
top_p = 0.1,
echo = True,
stop = ["Q", "\n"]):
# Define the parameters
model_output = zephyr_model(
user_prompt,
max_tokens=max_tokens,
temperature=temperature,
top_p=top_p,
echo=echo,
stop=stop,
)
return model_output__main__ क्लॉज़ के भीतर, दिए गए प्रॉम्प्ट के साथ इस फ़ंक्शन को चलाया जा सकता है।
if __name__ == "__main__":
my_prompt = "What do you think about the inclusion policies in Tech companies?"
zephyr_model_response = generate_text_from_prompt(my_prompt)
print(zephyr_model_response)मॉडल की प्रतिक्रिया नीचे दी गई है:
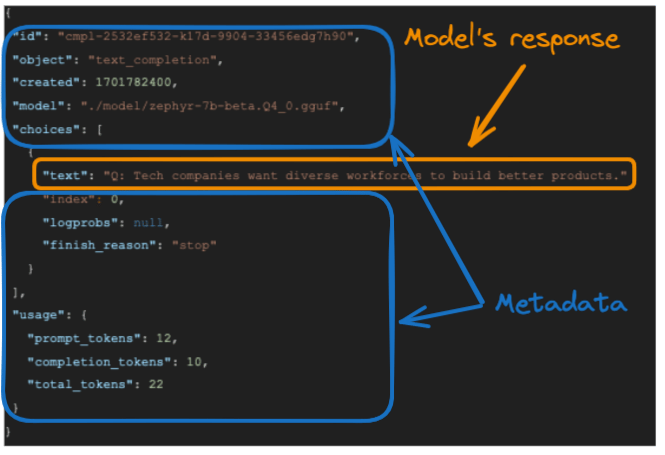
मॉडल की प्रतिक्रिया
मॉडल द्वारा जनरेटेड प्रतिक्रिया <What do you think about the inclusion policies in Tech companies?> है और मॉडल की सटीक प्रतिक्रिया नारंगी बॉक्स में हाइलाइट की गई है।
- मूल प्रॉम्प्ट में 12 टोकन्स हैं
- प्रतिक्रिया या कम्प्लीशन में 10 टोकन्स हैं, और
- कुल टोकन्स उपरोक्त दो का योग है, जो 22 है
हालाँकि यह पूर्ण आउटपुट आगे के उपयोग के लिए उपयोगी हो सकता है, हमें केवल मॉडल की टेक्स्टुअल प्रतिक्रिया में रुचि हो सकती है। हम choices एलिमेंट के “text” फ़ील्ड को चुनकर प्रतिक्रिया को इस प्रकार फ़ॉर्मैट कर सकते हैं:
final_result = model_output["choices"][0]["text"].strip()
strip() फ़ंक्शन का उपयोग किसी स्ट्रिंग से अग्रणी और अनुगामी व्हाइटस्पेस हटाने के लिए किया जाता है और परिणाम है:
Tech companies want diverse workforces to build better products.Llama.CPP के वास्तविक-world अनुप्रयोग
यह खंड LLama.cpp के एक वास्तविक-world अनुप्रयोग से गुजरता है और अंतर्निहित समस्या, संभावित समाधान, और Llama.cpp के उपयोग के लाभ प्रस्तुत करता है।
समस्या
ETP4Africa की कल्पना करें, एक टेक स्टार्टअप जिसे अपने शैक्षणिक ऐप के लिए ऐसा भाषा मॉडल चाहिए जो विभिन्न डिवाइसों पर कुशलता से काम कर सके और देरी न करे।
Llama.cpp के साथ समाधान
वे Llama.cpp इम्प्लीमेंट करते हैं, इसके CPU-ऑप्टिमाइज़्ड परफॉर्मेंस और अपने Go-आधारित बैकएंड के साथ इंटरफेस करने की क्षमता का लाभ उठाते हुए।
लाभ
- पोर्टेबिलिटी और गति: Llama.cpp का हल्का डिज़ाइन तेज़ प्रतिक्रियाएं और कई डिवाइसों के साथ अनुकूलता सुनिश्चित करता है।
- कस्टमाइज़ेशन: अनुकूलित लो-लेवल फीचर्स ऐप को प्रभावी रियल-टाइम कोडिंग सहायता प्रदान करने देते हैं।
Llama.cpp के इंटीग्रेशन से ETP4Africa ऐप त्वरित, इंटरैक्टिव प्रोग्रामिंग मार्गदर्शन प्रदान कर पाता है, जिससे उपयोगकर्ता अनुभव और सहभागिता में सुधार होता है।
डेटा इंजीनियरिंग किसी भी डेटा साइंस और AI प्रोजेक्ट का एक प्रमुख घटक है, और हमारा ट्यूटोरियल डेटा इंजीनियरिंग और डेटा एप्लिकेशंस के लिए LangChain का परिचय डेटा पाइपलाइन्स और एप्लिकेशंस में लार्ज लैंग्वेज मॉडल्स से AI को शामिल करने के लिए एक संपूर्ण मार्गदर्शिका प्रदान करता है।
निष्कर्ष
संक्षेप में, इस लेख ने LLama.cpp के साथ लार्ज लैंग्वेज मॉडल्स को सेटअप और उपयोग करने का व्यापक अवलोकन प्रस्तुत किया है।
Llama.cpp की बुनियादी बातें समझने, कार्यशील वातावरण सेट करने, आवश्यक लाइब्रेरी इंस्टॉल करने, और टेक्स्ट जनरेशन (प्रश्न-उत्तर) उपयोग मामले को इम्प्लीमेंट करने में आपकी सहायता के लिए विस्तृत निर्देश दिए गए।
अंत में, वास्तविक-world अनुप्रयोग के लिए व्यावहारिक अंतर्दृष्टियाँ दी गईं और यह दर्शाया गया कि Llama.cpp का उपयोग अंतर्निहित समस्या को कुशलतापूर्वक निपटाने के लिए कैसे किया जा सकता है।
लार्ज लैंग्वेज मॉडल्स की दुनिया में और गहराई तक जाने के लिए तैयार हैं? AI पेशेवरों द्वारा उपयोग किए जाने वाले शक्तिशाली डीप लर्निंग फ्रेमवर्क्स LangChain और Pytorch के साथ अपनी क्षमताएँ बढ़ाएँ, हमारे How to Build LLM Applications with LangChain ट्यूटोरियल और How to Train a LLM with PyTorch के साथ।
FAQs
Llama.cpp अन्य हल्के LLM फ्रेमवर्क्स से कैसे अलग है?
Llama.cpp विशेष रूप से CPU उपयोग के लिए ऑप्टिमाइज़्ड है, जो इसे अन्य फ्रेमवर्क्स से अलग करता है जो GPU एक्सेलेरेशन पर अधिक निर्भर हो सकते हैं। यह इसे सीमित हार्डवेयर संसाधनों वाले परिवेशों के लिए उपयुक्त बनाता है।
Llama.cpp को कुशलतापूर्वक चलाने के लिए सिस्टम आवश्यकताएँ क्या हैं?
हालाँकि Llama.cpp हल्का होने के लिए डिज़ाइन किया गया है, फिर भी बड़े मॉडलों को संभालने के लिए आधुनिक मल्टी-कोर CPU और पर्याप्त RAM होने से लाभ होता है। सटीक आवश्यकताएँ आपके द्वारा उपयोग किए जा रहे मॉडल के आकार पर निर्भर करती हैं।
क्या Python के अलावा अन्य प्रोग्रामिंग भाषाओं के साथ Llama.cpp को इंटीग्रेट किया जा सकता है?
हाँ, Llama.cpp का C++ लाइब्रेरी के रूप में डिज़ाइन Python से परे विभिन्न प्रोग्रामिंग परिवेशों में इंटीग्रेशन की अनुमति देता है, हालाँकि प्रत्येक भाषा के लिए विशिष्ट बाइंडिंग्स इम्प्लीमेंट करनी होंगी।
Llama मॉडलों के संदर्भ में GGML और GGUF फ़ॉर्मैट क्या हैं?
GGML (Georgi Gerganov Model Language) और GGUF ऐसे फ़ॉर्मैट हैं जो Llama मॉडलों को कुशलता से स्टोर करने के लिए उपयोग होते हैं, जिनका फोकस स्टोरेज आकार घटाने और लोडिंग स्पीड बढ़ाने पर है।
LLaMa मॉडलों में अपडेट्स और सुधारों को Llama.cpp कैसे संभालता है?
ओपन-सोर्स समुदाय Llama.cpp का सक्रिय रूप से रखरखाव करता है, यह सुनिश्चित करते हुए कि यह LLaMa मॉडलों में नवीनतम प्रगति और ऑप्टिमाइज़ेशन्स को शामिल करे, जिससे इसकी दक्षता और प्रदर्शन में बढ़ोतरी होती है।
Llama.cpp का उपयोग करने में कोई सीमाएँ या ज्ञात मुद्दे हैं?
अन्य किसी सॉफ़्टवेयर की तरह, Llama.cpp में भी सीमाएँ हो सकती हैं, खासकर बहुत बड़े मॉडलों या जटिल वर्कफ़्लोज़ के साथ स्केलेबिलिटी में। साथ ही, CPU-ऑप्टिमाइज़्ड होने के कारण कुछ कार्यों में यह GPU-आधारित समाधानों के प्रदर्शन से मेल नहीं खा सकता।
Llama.cpp के आउटपुट पर temperature पैरामीटर का क्या प्रभाव पड़ता है?
यह temperature पैरामीटर मॉडल प्रतिक्रियाओं में रैंडमनेस को प्रभावित करता है। कम मान आउटपुट को अधिक निर्धारक बनाते हैं, जबकि उच्च मान वैरिएबिलिटी लाते हैं, जो रचनात्मक अनुप्रयोगों में उपयोगी हो सकता है।

बहु-प्रतिभाशाली डेटा साइंटिस्ट जो अपना ज्ञान साझा करने और समुदाय को वापस देने में आनंद लेते हैं, ज़ूमाना YouTube पर कंटेंट क्रिएटर हैं और Medium पर शीर्ष तकनीकी लेखक हैं। उन्हें बोलने, कोडिंग करने और पढ़ाने में खुशी मिलती है। ज़ूमाना के पास दो मास्टर डिग्री हैं—पहली पेरिस, फ्रांस से कंप्यूटर साइंस में, मशीन लर्निंग पर केंद्रित, और दूसरी अमेरिका के टेक्सास टेक यूनिवर्सिटी से डेटा साइंस में। उनका करियर फ्रांस में Groupe OPEN में सॉफ्टवेयर डेवलपर के रूप में शुरू हुआ, जिसके बाद वे IBM में मशीन लर्निंग कंसल्टेंट बने, जहाँ उन्होंने बीमा कंपनियों के लिए एंड-टू-एंड एआई समाधान विकसित किए। ज़ूमाना ने Axionable, पेरिस और मॉन्ट्रियल स्थित पहली Sustainable AI स्टार्टअप, से जुड़कर डेटा साइंटिस्ट के रूप में काम किया और फ्रांस, मॉन्ट्रियल, सिंगापुर और स्विट्ज़रलैंड के क्लाइंट्स के लिए मुख्यतः NLP उपयोग मामलों पर आधारित एआई प्रोडक्ट्स लागू किए। इसके अतिरिक्त, अपने समय का 5% उन्होंने अनुसंधान और विकास को समर्पित किया। वर्तमान में, वे IFC - The World Bank Group में सीनियर डेटा साइंटिस्ट के रूप में कार्यरत हैं।
लार्ज लैंग्वेज मॉडल्स (LLMs) विभिन्न उद्योगों में क्रांति ला रहे हैं। कस्टमर सर्विस चैटबॉट्स से लेकर उन्नत डेटा विश्लेषण टूल्स तक, इस शक्तिशाली तकनीक की क्षमताएं डिजिटल इंटरैक्शन और ऑटोमेशन के परिदृश्य को नया रूप दे रही हैं।
हालाँकि, LLMs के व्यावहारिक अनुप्रयोग हाई-पावर्ड कंप्यूटिंग की जरूरत या त्वरित प्रतिक्रिया समय की अनिवार्यता के कारण सीमित हो सकते हैं। ये मॉडल आमतौर पर परिष्कृत हार्डवेयर और व्यापक डिपेंडेंसीज़ की अपेक्षा करते हैं, जो अधिक सीमित परिवेशों में इनके अपनाने को कठिन बना सकते हैं।
यहीं LLaMa.cpp (या LLaMa C++) काम आता है, जो हेवीवेट फ्रेमवर्क्स के मुकाबले हल्का और अधिक पोर्टेबल विकल्प प्रदान करता है।
Llama.cpp लोगो (स्रोत)