LlamaIndex é um framework de dados para aplicações baseadas em Large Language Models (LLMs). LLMs como o GPT-4 já vêm treinados em enormes conjuntos de dados públicos, oferecendo capacidades incríveis de processamento de linguagem natural logo de cara. Porém, sem acesso aos seus próprios dados privados, a utilidade deles fica limitada.
O LlamaIndex permite ingerir dados de APIs, bancos de dados, PDFs e muito mais por meio de conectores flexíveis. Esses dados são indexados em representações intermediárias otimizadas para LLMs. Em seguida, o LlamaIndex habilita consultas em linguagem natural e conversas com seus dados via mecanismos de consulta, interfaces de chat e agentes de dados impulsionados por LLMs. Assim, seus LLMs passam a acessar e interpretar dados privados em larga escala sem precisar retreinar o modelo com dados mais recentes.
Seja você iniciante buscando uma forma simples de consultar seus dados em linguagem natural ou um usuário avançado que precisa de personalização profunda, o LlamaIndex oferece as ferramentas certas. A API de alto nível permite começar com apenas cinco linhas de código, enquanto as APIs de baixo nível dão controle total sobre ingestão, indexação, recuperação e muito mais.
Como o LlamaIndex funciona?
O LlamaIndex utiliza sistemas de Geração Aumentada por Recuperação (RAG), que combinam grandes modelos de linguagem com uma base de conhecimento privada. Em geral, há duas etapas: a etapa de indexação e a etapa de consulta.
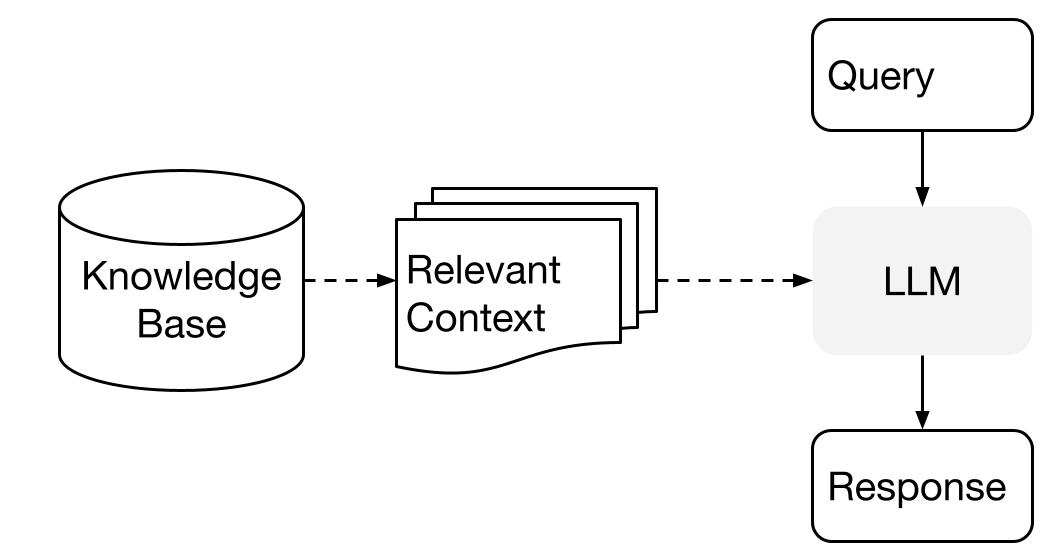
Imagem de High-Level Concepts
Etapa de indexação
Na etapa de indexação, o LlamaIndex indexa de forma eficiente dados privados em um índice vetorial. Esse passo cria uma base de conhecimento pesquisável específica do seu domínio. Você pode inserir documentos de texto, registros de banco de dados, grafos de conhecimento e outros tipos de dados.
Em essência, a indexação converte os dados em vetores numéricos, ou embeddings, que capturam seu significado semântico. Isso viabiliza buscas rápidas por similaridade em todo o conteúdo.
Etapa de consulta
Na etapa de consulta, o pipeline de RAG busca as informações mais relevantes com base na pergunta do usuário. Essas informações são então passadas ao LLM, junto com a pergunta, para gerar uma resposta precisa.
Esse processo dá ao LLM acesso a informações atuais e atualizadas que podem não ter sido incluídas no treinamento inicial.
O principal desafio nessa etapa é recuperar, organizar e raciocinar sobre múltiplas bases de conhecimento, potencialmente.
Aprofunde-se em RAG no nosso code-along sobre Retrieval Augmented Generation com PineCone.
Configurando o LlamaIndex
Antes de mergulhar no nosso tutorial e projeto com LlamaIndex, precisamos instalar o pacote Python e configurar a API.
Podemos instalar o LlamaIndex com o pip.
pip install llama-indexPor padrão, o LlamaIndex usa o modelo OpenAI GPT-3 text-davinci-003. Para usar esse modelo, você precisa ter a variável OPENAI_API_KEY configurada. É possível criar uma conta gratuita e obter uma chave de API acessando o novo token de API da OpenAI.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Além disso, verifique se o pacote openai está instalado.
pip install openaiAdicionando dados pessoais aos LLMs com LlamaIndex
Nesta seção, vamos usar o LlamaIndex para criar um leitor de currículo. Você pode baixar seu currículo indo até a página do seu perfil no Linkedin, clicando em Mais e depois em Salvar como PDF.
Observação: estamos usando o DataLab para executar o código em Python. Você pode acessar todo o código e saídas no workbook LlamaIndex: Adding Personal Data to LLMs; crie sua própria cópia para rodar tudo sem instalar nada no seu computador!
Antes de executar qualquer coisa, precisamos instalar llama-index, openai e pypdf. Estamos instalando pypdf para ler e converter arquivos PDF.
%pip install llama-index openai pypdfCarregando dados e criando o índice
Temos um diretório chamado "Private-Data" contendo apenas um arquivo PDF. Vamos usar o SimpleDirectoryReader para ler o arquivo e depois convertê-lo em um índice usando o TreeIndex.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)
Executando uma consulta
Depois de indexar os dados, você já pode começar a fazer perguntas com as_query_engine(). Essa função permite perguntar sobre informações específicas dentro do documento e receber a resposta correspondente com a ajuda do modelo GPT-3 text-davinci-003 da OpenAI.
Observação: você pode configurar a API da OpenAI no DataLab seguindo o tutorial Using GPT-3.5 and GPT-4 via the OpenAI API in Python.
Como dá para ver, o modelo respondeu corretamente à consulta. Ele pesquisou no índice e encontrou as informações relevantes.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.Podemos perguntar mais sobre certificações. Parece que o LlamaIndex tem um entendimento completo do candidato, o que pode ser vantajoso para empresas buscando perfis específicos.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalSalvando e carregando o contexto
Criar um índice pode levar tempo. Para evitar recriar índices, podemos salvar o contexto. Por padrão, o comando a seguir salva o armazenamento do índice no diretório ./storage.
new_index.storage_context.persist()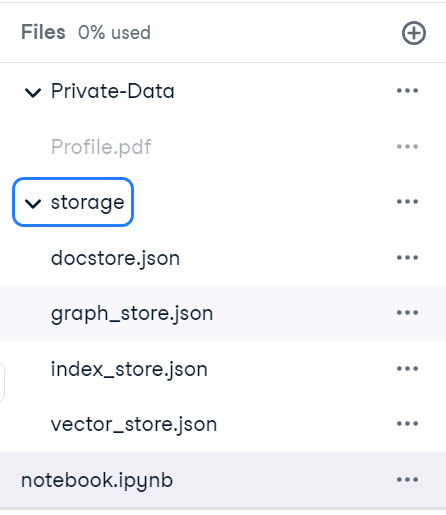
Depois disso, podemos carregar rapidamente o contexto de armazenamento e recriar um índice.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Para verificar se está tudo certo, vamos perguntar ao mecanismo de consulta algo presente no currículo. Parece que carregamos o contexto com sucesso.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.Chatbot
Em vez de perguntas e respostas, também podemos usar o LlamaIndex para criar um chatbot pessoal. Basta inicializar o índice com a função as_chat_engine().
Vamos começar com uma pergunta simples.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.E, sem fornecer contexto adicional, vamos fazer perguntas de acompanhamento.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.Fica claro que o mecanismo de chat está funcionando muito bem.
Depois de criar sua aplicação de linguagem, o próximo passo é ler sobre os prós e contras de usar LLMs na nuvem versus rodá-los localmente. Isso ajuda a definir qual abordagem faz mais sentido para você.
Construindo texto para fala da Wiki com LlamaIndex
Nosso próximo projeto é desenvolver uma aplicação que responda a perguntas com base em conteúdo da Wikipedia e converta as respostas em áudio.
O código-fonte e mais detalhes estão disponíveis neste workbook do DataLab.
Fazendo web scraping da página da Wikipedia
Primeiro, vamos coletar os dados da página Italy - Wikipedia e salvar como o arquivo italy_text.txt na pasta data.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)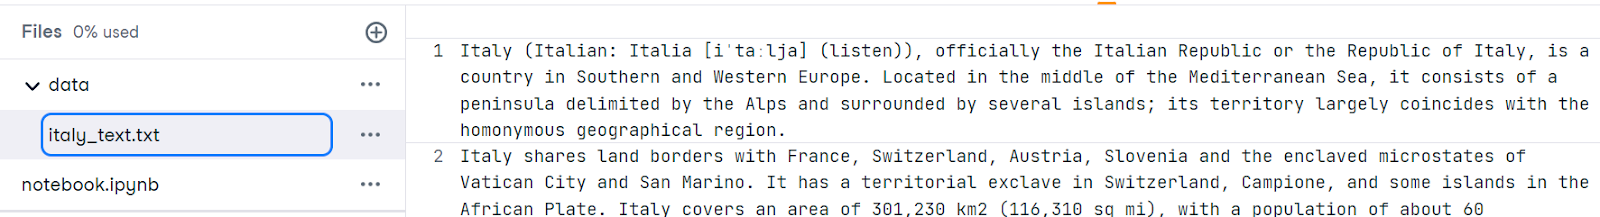
Carregando os dados e construindo o índice
Em seguida, precisamos instalar os pacotes necessários. O pacote elevenlabs permite converter texto em fala facilmente via API.
%pip install llama-index openai elevenlabsUsando o SimpleDirectoryReader, vamos carregar os dados e converter o arquivo TXT em um repositório vetorial com o VectorStoreIndex.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
Consulta
A ideia é fazer uma pergunta geral sobre o país e receber uma resposta do query_engine do LLM.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))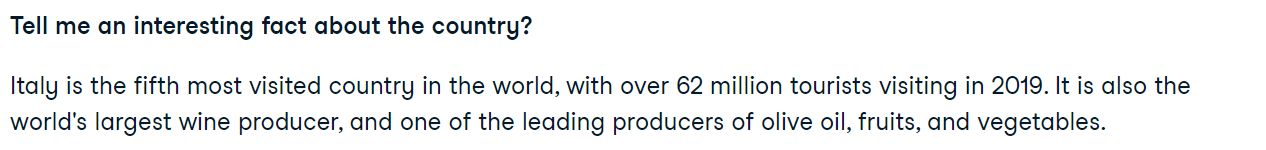
Texto para fala
Depois, vamos usar o módulo llama_index.tts para acessar a API do ElevenLabsTTS. Você precisa informar a chave de API da ElevenLabs para iniciar a geração de áudio. É possível obter uma chave gratuita no site da ElevenLabs.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
Vamos passar a resposta para a função generate_audio para gerar voz natural. Para ouvir o áudio, usaremos a função Audio do IPython.display.
audio = tts.generate_audio(str(response))
Audio(audio)
Este é um exemplo simples. Você pode combinar vários módulos para criar um assistente, como a Siri, que responda às suas perguntas interpretando seus dados privados. Para mais informações, consulte a documentação do LlamaIndex.
Além do LlamaIndex, a LangChain também permite construir aplicações baseadas em LLMs. Você também pode ler Introdução ao LangChain para engenharia de dados e aplicações de dados para ter uma visão geral do que é possível fazer com LangChain, incluindo os problemas que ela resolve e exemplos de casos de uso.
Casos de uso do LlamaIndex
O LlamaIndex oferece um kit completo para construir aplicações baseadas em linguagem. Além disso, você pode usar diversos carregadores de dados e ferramentas de agentes do Llama Hub para desenvolver aplicações complexas com múltiplas funcionalidades.
Você pode conectar fontes de dados personalizadas ao seu LLM com um ou mais plugins Data Loaders.
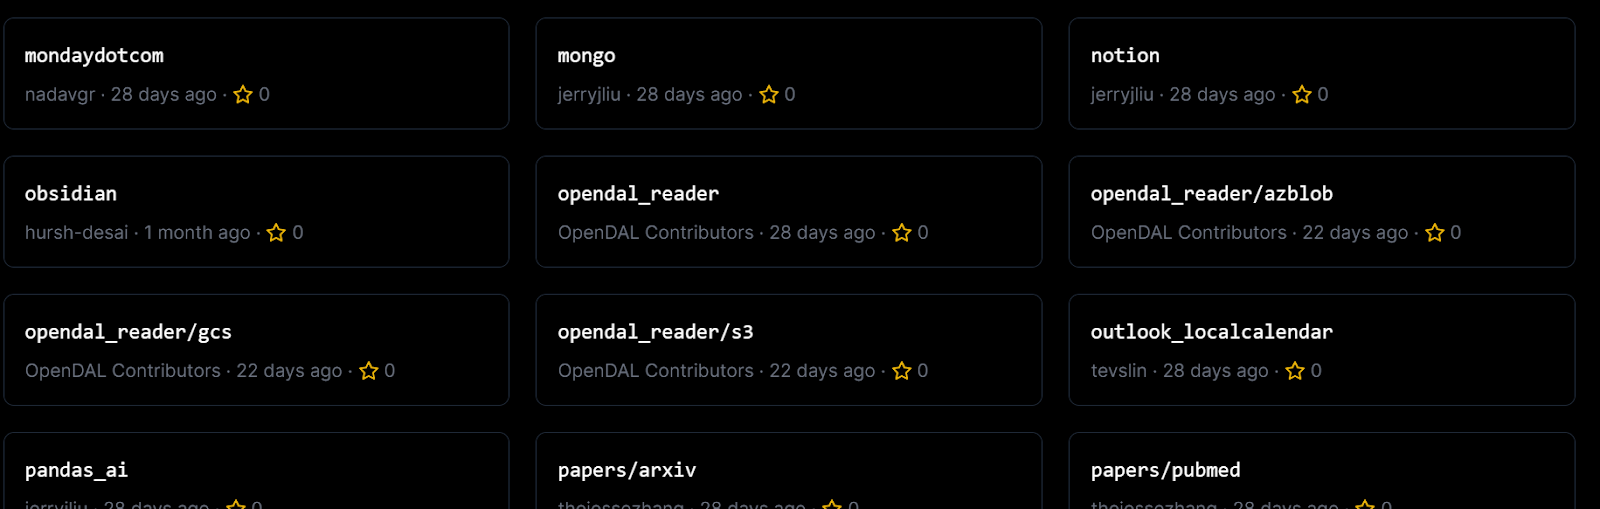
Data Loaders do Llama Hub
Você também pode usar Agent Tools para integrar ferramentas e APIs de terceiros.
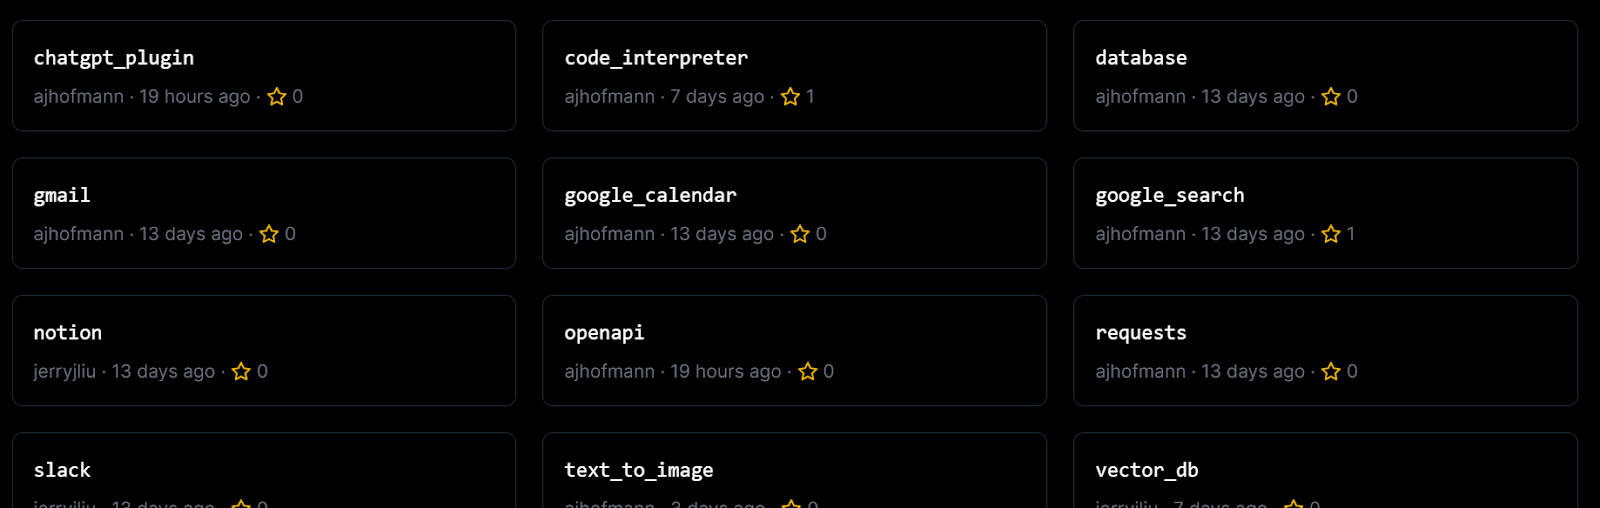
Agent Tools do Llama Hub
Em resumo, você pode usar o LlamaIndex para construir:
- Perguntas e respostas sobre documentos
- Chatbots
- Agentes
- Dados estruturados
- Aplicações web full-stack
- Ambientes privados
Para saber mais sobre esses casos de uso, acesse a documentação do LlamaIndex.
Conclusão
O LlamaIndex oferece um kit poderoso para construir sistemas de geração aumentada por recuperação, combinando a força dos grandes modelos de linguagem com bases de conhecimento personalizadas. Ele permite criar um repositório indexado de dados específicos do seu domínio e aproveitá-lo durante a inferência para fornecer contexto relevante ao LLM e gerar respostas de alta qualidade.
Neste tutorial, entendemos o que é o LlamaIndex e como ele funciona. Além disso, construímos um leitor de currículo e um projeto de texto para fala com poucas linhas de Python. Criar uma aplicação com LLM usando LlamaIndex é simples, e você ainda conta com uma vasta biblioteca de plugins, data loaders e agentes.
Para se tornar um desenvolvedor de LLM de ponta, o próximo passo natural é se inscrever no curso Master Large Language Models Concepts. Esse curso oferece uma compreensão completa sobre LLMs, incluindo aplicações, métodos de treinamento, considerações éticas e as pesquisas mais recentes.