LlamaIndex là một khung dữ liệu cho các ứng dụng dựa trên Mô hình Ngôn ngữ Lớn (LLM). Các LLM như GPT-4 được huấn luyện sẵn trên các bộ dữ liệu công khai khổng lồ, cho phép khả năng xử lý ngôn ngữ tự nhiên ấn tượng ngay từ đầu. Tuy nhiên, tính hữu dụng của chúng bị hạn chế nếu không thể truy cập dữ liệu riêng của bạn.
LlamaIndex cho phép bạn nạp dữ liệu từ API, cơ sở dữ liệu, PDF và nhiều nguồn khác thông qua các bộ nối dữ liệu linh hoạt. Dữ liệu này được lập chỉ mục thành các biểu diễn trung gian được tối ưu hóa cho LLM. Sau đó LlamaIndex cho phép truy vấn và đối thoại bằng ngôn ngữ tự nhiên với dữ liệu của bạn thông qua các công cụ truy vấn, giao diện chat và các tác nhân dữ liệu vận hành bởi LLM. Nó giúp LLM của bạn truy cập và diễn giải dữ liệu riêng tư ở quy mô lớn mà không cần huấn luyện lại mô hình trên dữ liệu mới.
Dù bạn là người mới bắt đầu muốn có cách đơn giản để truy vấn dữ liệu bằng ngôn ngữ tự nhiên hay người dùng nâng cao cần tùy biến sâu, LlamaIndex đều cung cấp công cụ. API cấp cao cho phép bắt đầu chỉ với năm dòng mã, trong khi các API cấp thấp hơn cho phép kiểm soát toàn diện việc nạp dữ liệu, lập chỉ mục, truy xuất và hơn thế nữa.
LlamaIndex hoạt động như thế nào?
LlamaIndex sử dụng các hệ thống Tạo sinh Tăng cường Truy xuất (RAG) kết hợp các mô hình ngôn ngữ lớn với một cơ sở tri thức riêng. Thông thường gồm hai giai đoạn: giai đoạn lập chỉ mục và giai đoạn truy vấn.
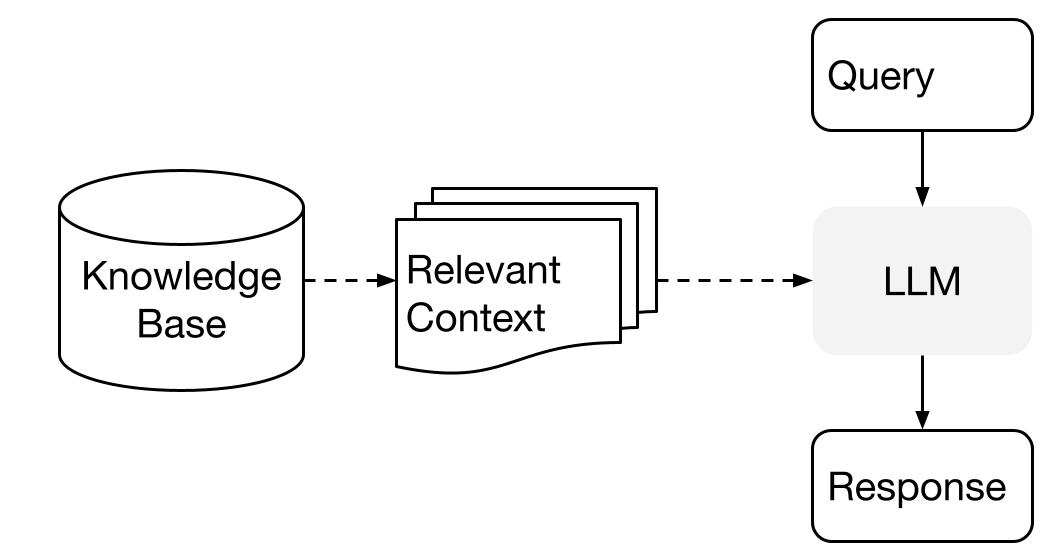
Hình ảnh từ Khái niệm Cấp cao
Giai đoạn lập chỉ mục
Trong giai đoạn lập chỉ mục, LlamaIndex sẽ lập chỉ mục dữ liệu riêng tư vào một chỉ mục vector một cách hiệu quả. Bước này giúp tạo một cơ sở tri thức có thể tìm kiếm, đặc thù cho miền của bạn. Bạn có thể nhập tài liệu văn bản, bản ghi cơ sở dữ liệu, đồ thị tri thức và các loại dữ liệu khác.
Về bản chất, việc lập chỉ mục chuyển dữ liệu thành các vector số hoặc embedding nắm bắt ý nghĩa ngữ nghĩa của dữ liệu. Nó cho phép tìm kiếm tương đồng nhanh trên toàn bộ nội dung.
Giai đoạn truy vấn
Trong giai đoạn truy vấn, pipeline RAG tìm kiếm thông tin liên quan nhất dựa trên truy vấn của người dùng. Thông tin này sau đó được cung cấp cho LLM cùng với truy vấn để tạo ra câu trả lời chính xác.
Quy trình này cho phép LLM truy cập thông tin hiện tại và đã cập nhật có thể không được bao gồm trong lần huấn luyện ban đầu.
Thách thức chính trong giai đoạn này là truy xuất, tổ chức và suy luận trên nhiều cơ sở tri thức tiềm năng.
Tìm hiểu thêm về RAG trong phần code-along của chúng tôi về Retrieval Augmented Generation với PineCone.
Thiết lập LlamaIndex
Trước khi đi vào hướng dẫn và dự án LlamaIndex, chúng ta cần cài đặt gói Python và thiết lập API.
Chúng ta có thể cài đặt LlamaIndex bằng pip một cách đơn giản.
pip install llama-indexTheo mặc định, LlamaIndex sử dụng mô hình OpenAI GPT-3 text-davinci-003. Để dùng mô hình này, bạn phải thiết lập OPENAI_API_KEY. Bạn có thể tạo tài khoản miễn phí và lấy khóa API bằng cách đăng nhập vào API token mới của OpenAI.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Ngoài ra, hãy đảm bảo bạn đã cài đặt gói openai.
pip install openaiThêm dữ liệu cá nhân vào LLM bằng LlamaIndex
Trong phần này, chúng ta sẽ học cách dùng LlamaIndex để tạo một trình đọc sơ yếu lý lịch. Bạn có thể tải sơ yếu lý lịch của mình bằng cách vào trang hồ sơ Linkedin, nhấp vào More, rồi Save to PDF.
Lưu ý rằng chúng tôi đang dùng DataLab để chạy mã Python. Bạn có thể truy cập toàn bộ mã và đầu ra liên quan trong sổ tay LlamaIndex: Thêm dữ liệu cá nhân vào LLM; bạn có thể dễ dàng tạo bản sao của riêng mình để chạy toàn bộ mã mà không cần cài đặt gì trên máy tính!
Trước khi chạy bất cứ thứ gì, chúng ta phải cài đặt llama-index, openai và pypdf. Chúng ta cài pypdf để có thể đọc và chuyển đổi tệp PDF.
%pip install llama-index openai pypdfNạp dữ liệu và tạo chỉ mục
Chúng ta có một thư mục tên "Private-Data" chỉ chứa một tệp PDF. Chúng ta sẽ dùng SimpleDirectoryReader để đọc nó rồi chuyển thành một chỉ mục bằng TreeIndex.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)
Chạy truy vấn
Khi dữ liệu đã được lập chỉ mục, bạn có thể bắt đầu đặt câu hỏi bằng cách dùng as_query_engine(). Hàm này cho phép bạn hỏi về thông tin cụ thể trong tài liệu và nhận câu trả lời tương ứng với sự trợ giúp của mô hình OpenAI GPT-3 text-davinci-003.
Lưu ý: bạn có thể thiết lập OpenAI API trong DataLab bằng cách làm theo hướng dẫn Sử dụng GPT-3.5 và GPT-4 qua OpenAI API trong Python.
Như chúng ta thấy, mô hình LLM đã trả lời chính xác truy vấn. Nó đã tìm kiếm trong chỉ mục và tìm ra thông tin liên quan.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.Chúng ta có thể hỏi thêm về chứng chỉ. Có vẻ LlamaIndex đã nắm bắt đầy đủ thông tin về ứng viên, điều này có thể hữu ích cho các công ty đang tìm kiếm những cá nhân cụ thể.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalLưu và tải ngữ cảnh
Tạo một chỉ mục là quá trình tốn thời gian. Chúng ta có thể tránh tạo lại chỉ mục bằng cách lưu ngữ cảnh. Mặc định, lệnh sau sẽ lưu kho chỉ mục trong thư mục ./storage.
new_index.storage_context.persist()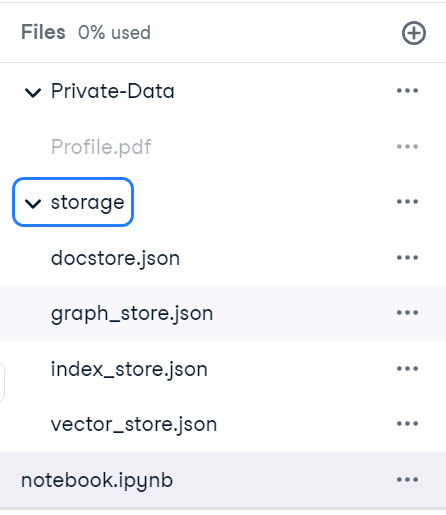
Sau khi xong, chúng ta có thể nhanh chóng tải ngữ cảnh lưu trữ và tạo chỉ mục.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Để kiểm tra hoạt động đúng, chúng ta sẽ hỏi công cụ truy vấn câu hỏi từ sơ yếu lý lịch. Có vẻ chúng ta đã tải ngữ cảnh thành công.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.Chatbot
Thay vì H&Đ, chúng ta cũng có thể dùng LlamaIndex để tạo Chatbot cá nhân. Chỉ cần khởi tạo chỉ mục với hàm as_chat_engine().
Chúng ta sẽ hỏi một câu đơn giản.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.Và không đưa thêm ngữ cảnh, chúng ta sẽ hỏi các câu tiếp theo.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.Rõ ràng động cơ chat đang hoạt động trơn tru.
Sau khi xây dựng ứng dụng ngôn ngữ, bước tiếp theo trong lộ trình của bạn là đọc về ưu và nhược điểm của việc dùng Mô hình Ngôn ngữ Lớn (LLM) trên đám mây so với chạy cục bộ. Điều này sẽ giúp bạn xác định cách tiếp cận phù hợp nhất với nhu cầu của mình.
Xây dựng chuyển văn bản Wikipedia thành giọng nói với LlamaIndex
Dự án tiếp theo của chúng ta là phát triển một ứng dụng có thể trả lời các câu hỏi lấy từ Wikipedia và chuyển chúng thành giọng nói.
Mã nguồn và thông tin bổ sung có trong sổ tay DataLab này.
Thu thập dữ liệu trang Wikipedia
Đầu tiên, chúng ta sẽ thu thập dữ liệu từ trang Italy - Wikipedia và lưu thành tệp italy_text.txt trong thư mục data.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)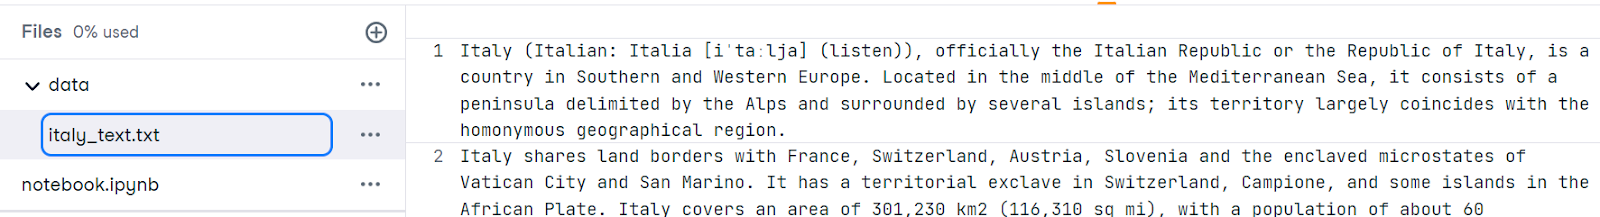
Nạp dữ liệu và xây dựng chỉ mục
Tiếp theo, chúng ta cần cài đặt các gói cần thiết. Gói elevenlabs cho phép chúng ta dễ dàng chuyển văn bản thành giọng nói bằng API.
%pip install llama-index openai elevenlabsBằng cách dùng SimpleDirectoryReader chúng ta sẽ nạp dữ liệu và chuyển tệp TXT thành kho vector bằng VectorStoreIndex.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
Truy vấn
Kế hoạch của chúng ta là hỏi một câu chung về đất nước và nhận phản hồi từ query_engine của LLM.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))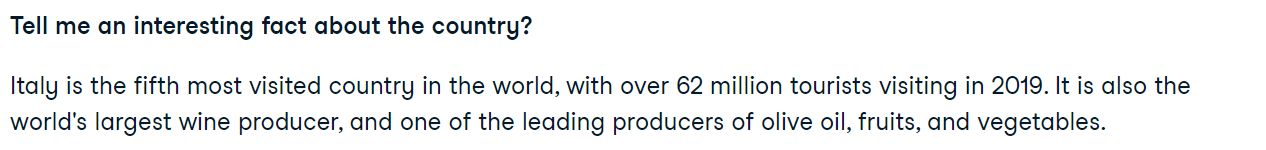
Chuyển văn bản thành giọng nói
Sau đó, chúng ta sẽ dùng mô-đun llama_index.tts để truy cập API ElevenLabsTTS. Bạn cần cung cấp khóa API ElevenLabs để khởi tạo hàm tạo âm thanh. Bạn có thể lấy khóa API miễn phí tại trang web ElevenLabs.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
Chúng ta sẽ đưa phản hồi vào hàm generate_audio để tạo giọng nói tự nhiên. Để nghe âm thanh, chúng ta sẽ dùng hàm Audio của IPython.display.
audio = tts.generate_audio(str(response))
Audio(audio)
Đây là một ví dụ đơn giản. Bạn có thể dùng nhiều mô-đun để tạo trợ lý của riêng mình, như Siri, phản hồi các câu hỏi bằng cách diễn giải dữ liệu riêng tư của bạn. Để biết thêm thông tin, vui lòng tham khảo tài liệu LlamaIndex.
Bên cạnh LlamaIndex, LangChain cũng cho phép bạn xây dựng các ứng dụng dựa trên LLM. Ngoài ra, bạn có thể đọc Giới thiệu về LangChain cho Kỹ thuật Dữ liệu & Ứng dụng Dữ liệu để hiểu tổng quan về những gì bạn có thể làm với LangChain, bao gồm các vấn đề mà LangChain giải quyết và ví dụ về các bài toán dữ liệu.
Các trường hợp sử dụng LlamaIndex
LlamaIndex cung cấp bộ công cụ hoàn chỉnh để xây dựng các ứng dụng dựa trên ngôn ngữ. Bên cạnh đó, bạn có thể dùng nhiều bộ nạp dữ liệu và công cụ tác nhân từ Llama Hub để phát triển các ứng dụng phức tạp với nhiều chức năng.
Bạn có thể kết nối các nguồn dữ liệu tùy chỉnh với LLM của mình bằng một hoặc nhiều plugin Data Loaders.
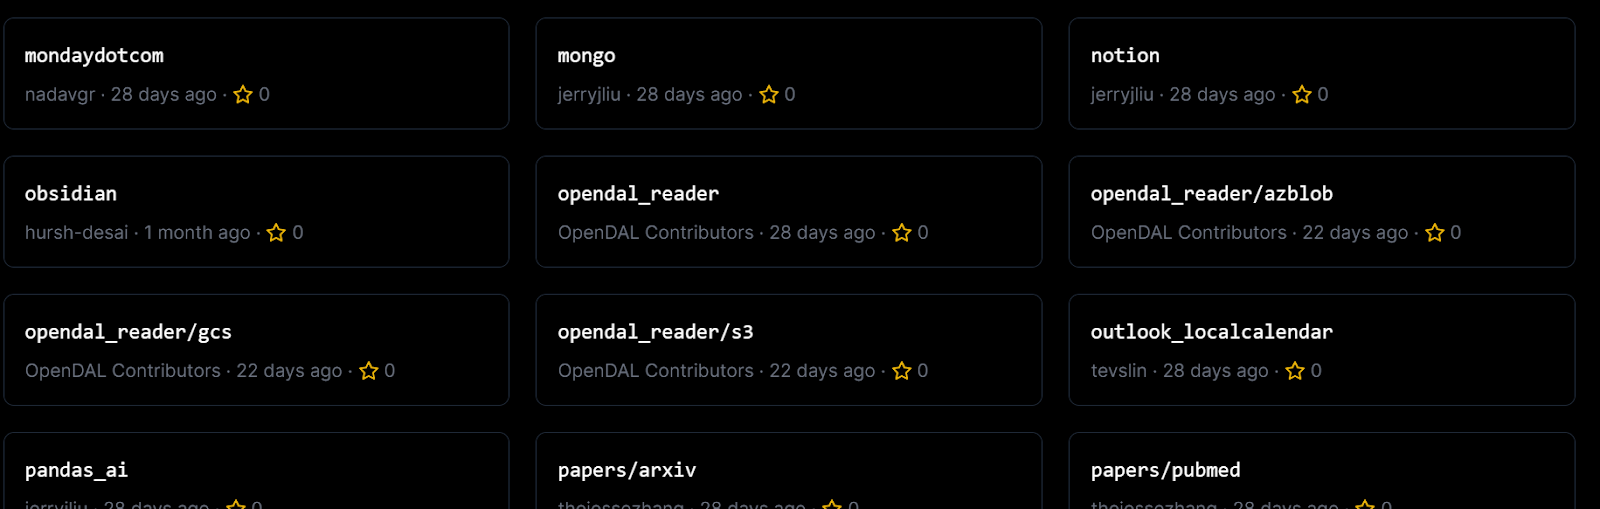
Data Loaders từ Llama Hub
Bạn cũng có thể dùng công cụ Agent để tích hợp công cụ và API bên thứ ba.
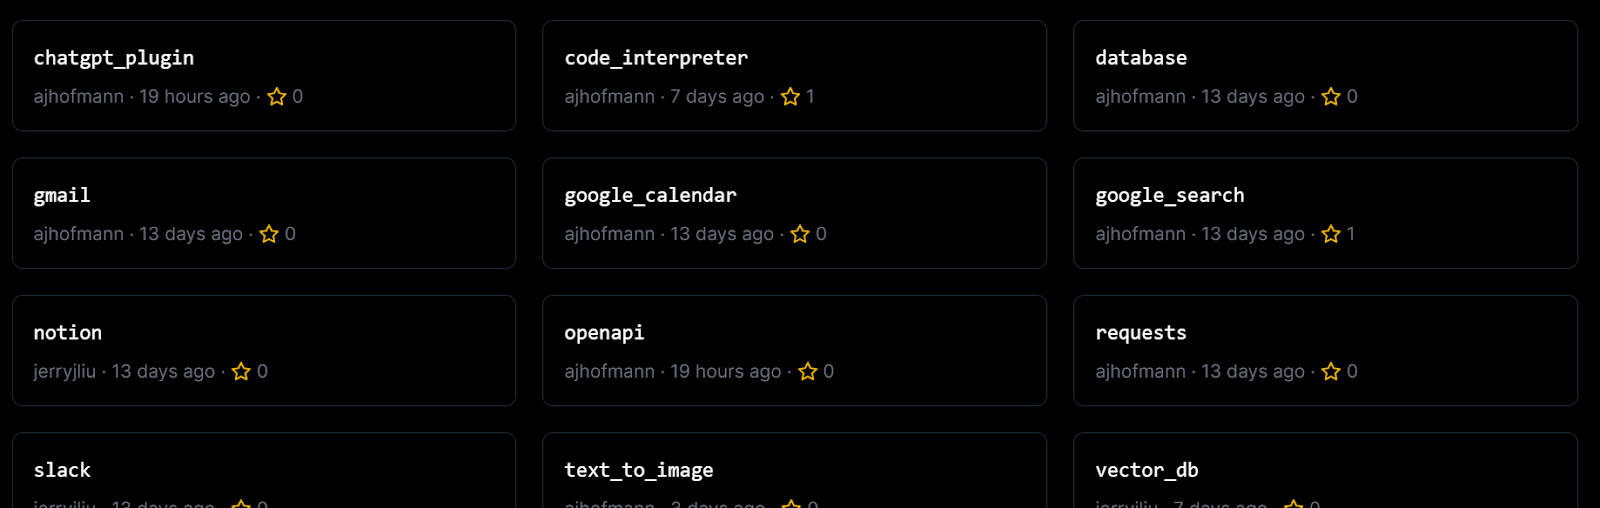
Agent Tools từ Llama Hub
Tóm lại, bạn có thể dùng LlamaIndex để xây dựng:
- Hỏi đáp trên tài liệu
- Chatbot
- Tác nhân (Agents)
- Dữ liệu có cấu trúc
- Ứng dụng web full-stack
- Thiết lập riêng tư
Để tìm hiểu chi tiết về các trường hợp sử dụng này, hãy truy cập tài liệu của LlamaIndex.
Kết luận
LlamaIndex cung cấp bộ công cụ mạnh mẽ để xây dựng các hệ thống tạo sinh tăng cường truy xuất, kết hợp thế mạnh của các mô hình ngôn ngữ lớn với các cơ sở tri thức tùy chỉnh. Nó cho phép tạo một kho dữ liệu được lập chỉ mục theo miền và tận dụng nó trong quá trình suy luận để cung cấp ngữ cảnh phù hợp cho LLM nhằm tạo ra phản hồi chất lượng cao.
Trong hướng dẫn này, chúng ta đã tìm hiểu về LlamaIndex và cách thức hoạt động. Ngoài ra, chúng ta đã xây dựng một trình đọc sơ yếu lý lịch và dự án chuyển văn bản thành giọng nói chỉ với vài dòng mã Python. Việc tạo ứng dụng LLM với LlamaIndex rất đơn giản, và nó cung cấp thư viện phong phú các plugin, bộ nạp dữ liệu và tác nhân.
Để trở thành nhà phát triển LLM chuyên nghiệp, bước tự nhiên tiếp theo là đăng ký khóa học Nắm vững các Khái niệm về Mô hình Ngôn ngữ Lớn. Khóa học này sẽ giúp bạn hiểu toàn diện về LLM, bao gồm ứng dụng, phương pháp huấn luyện, các cân nhắc đạo đức và nghiên cứu mới nhất.
