
Last chance! 50% off DataCamp Premium
Sale ends in
LlamaIndex adalah kerangka data untuk aplikasi berbasis Large Language Models (LLM). LLM seperti GPT-4 telah dilatih sebelumnya pada himpunan data publik yang masif, sehingga langsung memiliki kemampuan pemrosesan bahasa natural yang luar biasa. Namun, kegunaannya terbatas tanpa akses ke data privat Anda sendiri.
LlamaIndex memungkinkan Anda menyerap data dari API, basis data, PDF, dan lainnya melalui konektor data yang fleksibel. Data ini diindeks ke dalam representasi perantara yang dioptimalkan untuk LLM. LlamaIndex kemudian memungkinkan pengajuan kueri dan percakapan dalam bahasa natural dengan data Anda melalui mesin kueri, antarmuka chat, dan agen data bertenaga LLM. Ini memungkinkan LLM Anda mengakses dan menafsirkan data privat dalam skala besar tanpa melatih ulang model pada data yang lebih baru.
Baik Anda pemula yang mencari cara sederhana untuk mengajukan kueri terhadap data Anda dalam bahasa natural maupun pengguna mahir yang memerlukan kustomisasi mendalam, LlamaIndex menyediakan alatnya. API tingkat tinggi memungkinkan Anda mulai hanya dengan lima baris kode, sementara API tingkat rendah memberi kendali penuh atas proses ingestion, pengindeksan, pengambilan, dan lainnya.
LlamaIndex menggunakan sistem Retrieval Augmented Generation (RAG) yang menggabungkan model bahasa besar dengan basis pengetahuan privat. Umumnya terdiri dari dua tahap: tahap pengindeksan dan tahap pengajuan kueri.
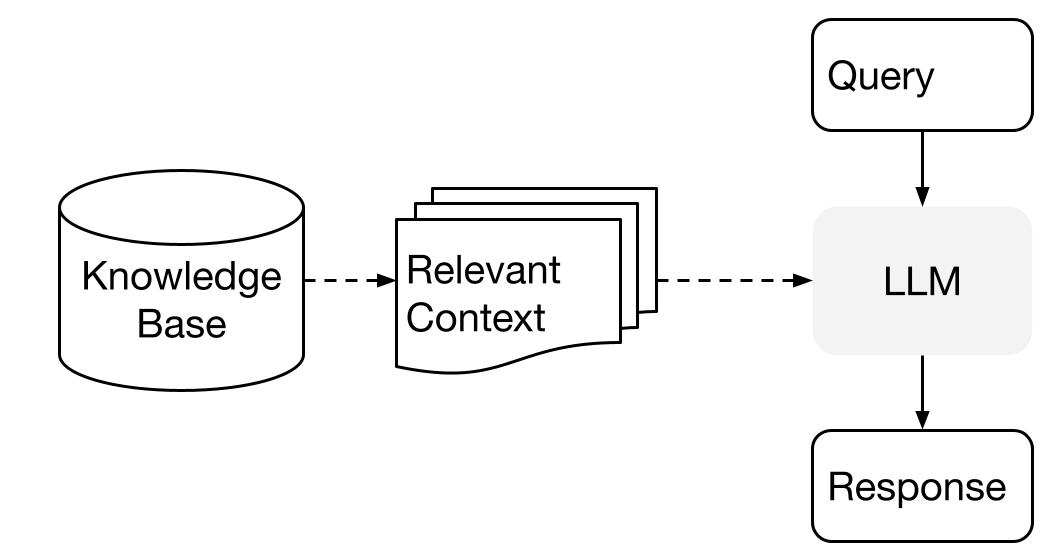
Gambar dari Konsep Tingkat Tinggi
Pada tahap pengindeksan, LlamaIndex akan secara efisien mengindeks data privat ke dalam index vektor. Langkah ini membantu membuat basis pengetahuan yang dapat dicari, spesifik untuk domain Anda. Anda dapat memasukkan dokumen teks, rekaman basis data, knowledge graph, dan tipe data lainnya.
Intinya, pengindeksan mengubah data menjadi vektor numerik atau embedding yang menangkap makna semantiknya. Ini memungkinkan pencarian kemiripan secara cepat di seluruh konten.
Selama tahap pengajuan kueri, pipeline RAG mencari informasi yang paling relevan berdasarkan kueri pengguna. Informasi ini kemudian diberikan kepada LLM, bersama dengan kueri, untuk membuat respons yang akurat.
Proses ini memungkinkan LLM mengakses informasi yang terkini dan terbarui yang mungkin tidak termasuk dalam pelatihan awalnya.
Tantangan utama pada tahap ini adalah mengambil, mengatur, dan melakukan penalaran atas kemungkinan beberapa basis pengetahuan sekaligus.
Pelajari lebih lanjut tentang RAG dalam sesi code-along kami tentang Retrieval Augmented Generation dengan PineCone.
Sebelum kita menyelami tutorial dan proyek LlamaIndex, kita harus memasang paket Python dan menyiapkan API.
Kita dapat memasang LlamaIndex dengan mudah menggunakan pip.
pip install llama-indexSecara bawaan, LlamaIndex menggunakan model OpenAI GPT-3 text-davinci-003. Untuk menggunakan model ini, Anda harus menyiapkan OPENAI_API_KEY. Anda dapat membuat akun gratis dan mendapatkan kunci API dengan masuk ke OpenAI’s new API token.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Selain itu, pastikan Anda telah memasang paket openai.
pip install openaiPada bagian ini, kita akan belajar menggunakan LlamaIndex untuk membuat pembaca resume. Anda dapat mengunduh resume Anda dengan membuka halaman profil Linkedin, klik More, lalu Save to PDF.
Harap dicatat bahwa kita menggunakan DataLab untuk menjalankan kode Python. Anda dapat mengakses semua kode dan output yang relevan dalam buku kerja LlamaIndex: Adding Personal Data to LLMs; Anda dapat dengan mudah membuat salinan sendiri untuk menjalankan semua kode tanpa harus memasang apa pun di komputer Anda!
Sebelum menjalankan apa pun, kita harus memasang llama-index, openai, dan pypdf. Kita memasang pypdf agar dapat membaca dan mengonversi file PDF.
%pip install llama-index openai pypdfKita memiliki direktori bernama "Private-Data" yang hanya berisi satu file PDF. Kita akan menggunakan SimpleDirectoryReader untuk membacanya dan kemudian mengonversinya menjadi indeks menggunakan TreeIndex.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)Setelah data diindeks, Anda dapat mulai mengajukan pertanyaan dengan menggunakan as_query_engine(). Fungsi ini memungkinkan Anda menanyakan informasi spesifik dalam dokumen dan menerima respons yang sesuai dengan bantuan model OpenAI GPT-3 text-davinci-003.
Catatan: Anda dapat menyiapkan OpenAI API di DataLab dengan mengikuti tutorial Menggunakan GPT-3.5 dan GPT-4 via OpenAI API di Python.
Seperti yang dapat kita lihat, model LLM telah merespons kueri dengan akurat. Model menelusuri indeks dan menemukan informasi yang relevan.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.Kita dapat menanyakan lebih lanjut tentang sertifikasi. Tampaknya LlamaIndex telah memperoleh pemahaman yang lengkap tentang kandidat, yang dapat menguntungkan perusahaan yang mencari individu tertentu.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalMembuat indeks adalah proses yang memakan waktu. Kita dapat menghindari pembuatan ulang indeks dengan menyimpan konteks. Secara bawaan, perintah berikut akan menyimpan index store di direktori ./storage.
new_index.storage_context.persist()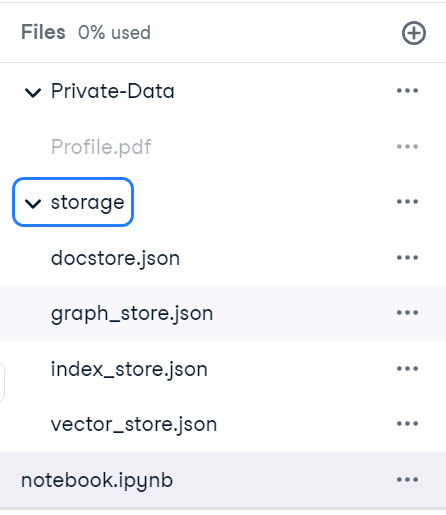
Setelah itu selesai, kita dapat dengan cepat memuat konteks penyimpanan dan membuat indeks.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Untuk memverifikasi bahwa ini berfungsi dengan benar, kita akan menanyakan pertanyaan dari resume ke mesin kueri. Tampaknya kita telah berhasil memuat konteks.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.Alih-alih tanya jawab, kita juga dapat menggunakan LlamaIndex untuk membuat Chatbot pribadi. Kita hanya perlu menginisialisasi indeks dengan fungsi as_chat_engine().
Kita akan mengajukan pertanyaan sederhana.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.Dan tanpa memberikan konteks tambahan, kita akan mengajukan pertanyaan lanjutan.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.Terlihat jelas bahwa mesin chat berfungsi dengan baik.
Setelah membangun aplikasi bahasa Anda, langkah berikutnya adalah membaca tentang kelebihan dan kekurangan menggunakan Large Language Models (LLM) di cloud dibanding menjalankannya secara lokal. Ini akan membantu Anda menentukan pendekatan mana yang paling sesuai dengan kebutuhan Anda.
Proyek berikutnya melibatkan pengembangan aplikasi yang dapat menjawab pertanyaan yang bersumber dari Wikipedia dan mengonversinya menjadi suara.
Sumber kode dan informasi tambahan tersedia di buku kerja DataLab ini.
Pertama, kita akan mengambil data dari halaman web Italy - Wikipedia dan menyimpannya sebagai file italy_text.txt di folder data.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)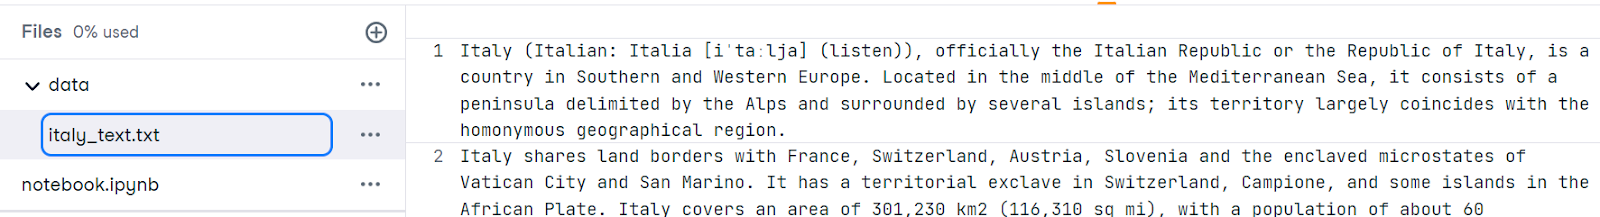
Selanjutnya, kita perlu memasang paket yang diperlukan. Paket elevenlabs memungkinkan kita dengan mudah mengonversi teks menjadi suara menggunakan API.
%pip install llama-index openai elevenlabsDengan menggunakan SimpleDirectoryReader kita akan memuat data dan mengonversi file TXT menjadi vector store menggunakan VectorStoreIndex.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)Rencana kita adalah mengajukan pertanyaan umum tentang negara tersebut dan menerima respons dari LLM query_engine.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))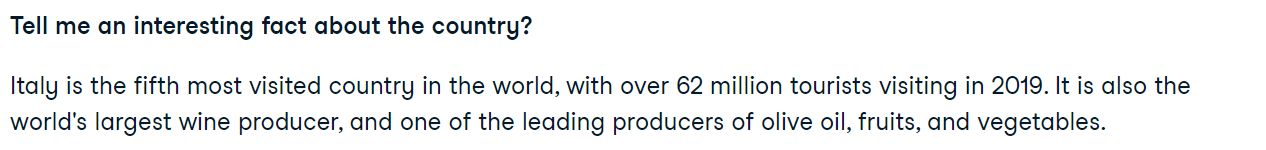
Setelah itu, kita akan menggunakan modul llama_index.tts untuk mengakses API ElevenLabsTTS. Anda perlu memberikan kunci API ElevenLabs untuk memulai fungsi pembuatan audio. Anda dapat memperoleh kunci API secara gratis di situs web ElevenLabs.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
Kita akan menambahkan respons ke fungsi generate_audio untuk menghasilkan suara yang natural. Untuk mendengarkan audio, kita akan menggunakan fungsi Audio dari IPython.display.
audio = tts.generate_audio(str(response))
Audio(audio)
Ini adalah contoh sederhana. Anda dapat menggunakan banyak modul untuk membuat asisten Anda, seperti Siri, yang merespons pertanyaan Anda dengan menafsirkan data privat Anda. Untuk informasi lebih lanjut, silakan merujuk ke dokumentasi LlamaIndex.
Selain LlamaIndex, LangChain juga memungkinkan Anda membangun aplikasi berbasis LLM. Selain itu, Anda dapat membaca Pengantar LangChain untuk Data Engineering & Aplikasi Data untuk memahami gambaran umum tentang apa yang dapat Anda lakukan dengan LangChain, termasuk masalah yang diselesaikan LangChain dan contoh kasus penggunaan data.
LlamaIndex menyediakan seperangkat alat lengkap untuk membangun aplikasi berbasis bahasa. Di atas itu, Anda dapat menggunakan berbagai data loader dan alat agen dari Llama Hub untuk mengembangkan aplikasi kompleks dengan banyak fungsi.
Anda dapat menghubungkan sumber data kustom ke LLM Anda dengan satu atau lebih plugin Data Loaders.
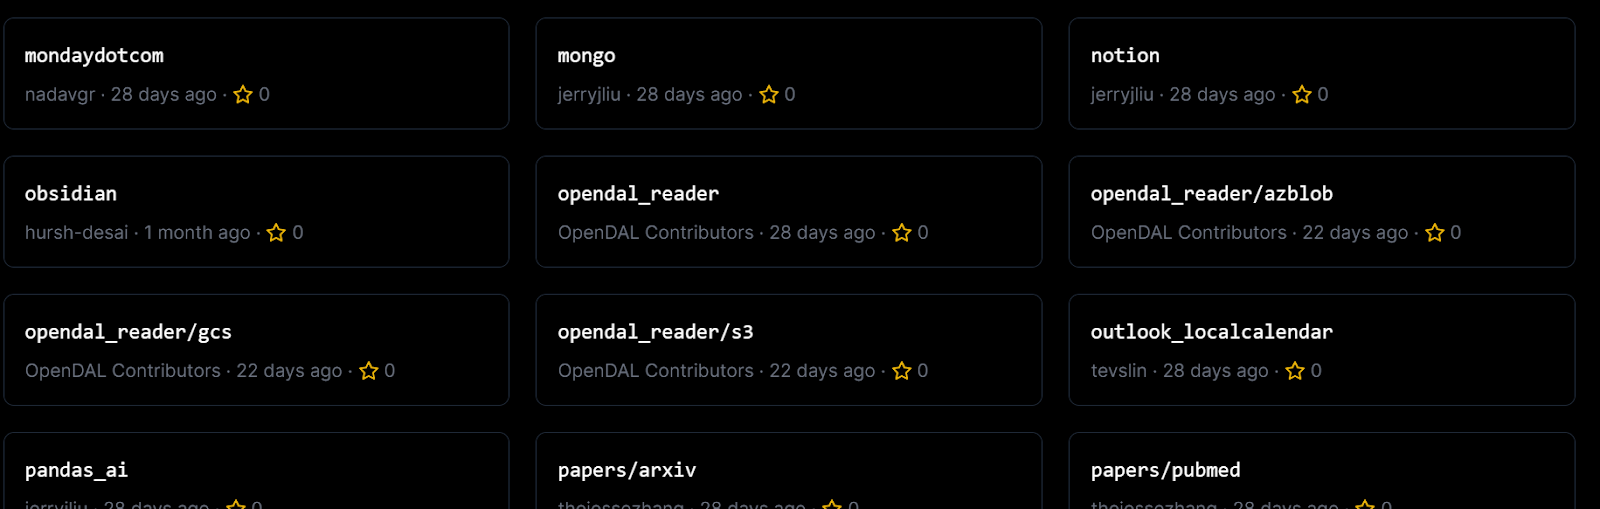
Data Loader dari Llama Hub
Anda juga dapat menggunakan alat Agent untuk mengintegrasikan alat dan API pihak ketiga.
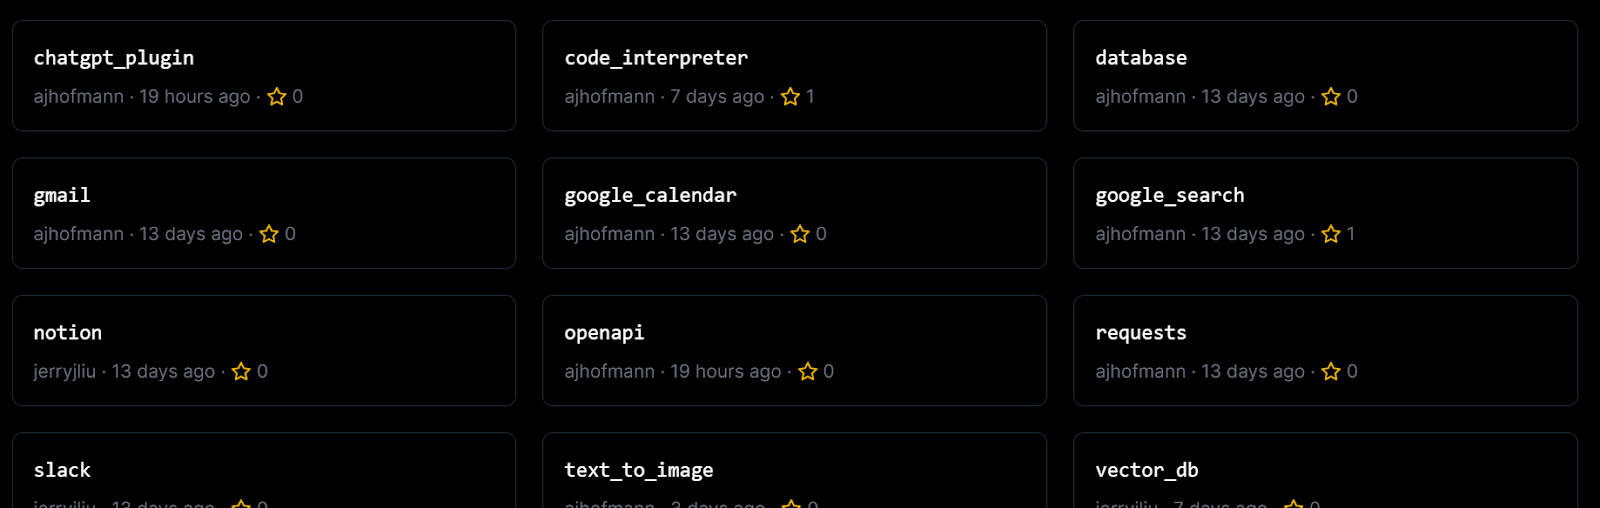
Alat Agent dari Llama Hub
Singkatnya, Anda dapat menggunakan LlamaIndex untuk membangun:
Untuk mempelajari use case ini secara rinci, kunjungi dokumentasi LlamaIndex.
LlamaIndex menyediakan seperangkat alat yang kuat untuk membangun sistem retrieval-augmented generation yang menggabungkan kekuatan model bahasa besar dengan basis pengetahuan kustom. Ini memungkinkan pembuatan simpanan terindeks dari data spesifik domain dan memanfaatkannya saat inferensi untuk menyediakan konteks relevan kepada LLM guna menghasilkan respons berkualitas tinggi.
Dalam tutorial ini, kita mempelajari LlamaIndex dan cara kerjanya. Selain itu, kita membangun proyek pembaca resume dan teks-ke-suara hanya dengan beberapa baris kode Python. Membuat aplikasi LLM dengan LlamaIndex itu sederhana, dan ia menawarkan pustaka plugin, data loader, dan agen yang sangat kaya.
Untuk menjadi pengembang LLM ahli, langkah alami berikutnya adalah mendaftar di kursus Master Large Language Models Concepts. Kursus ini akan memberi Anda pemahaman menyeluruh tentang LLM, termasuk aplikasinya, metode pelatihan, pertimbangan etis, dan riset terbaru.
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt




