LlamaIndex बड़े भाषा मॉडलों (LLMs) पर आधारित अनुप्रयोगों के लिए एक डेटा फ्रेमवर्क है। GPT-4 जैसे LLMs विशाल सार्वजनिक डेटासेट्स पर प्री-ट्रेंड आते हैं, जिससे वे बॉक्स से बाहर ही अद्भुत प्राकृतिक भाषा संसाधन क्षमताएँ प्रदान करते हैं। लेकिन आपकी अपनी निजी डेटा तक पहुंच न होने पर उनकी उपयोगिता सीमित हो जाती है।
LlamaIndex लचीले डेटा कनेक्टर्स के माध्यम से APIs, डेटाबेस, PDFs, और अन्य स्रोतों से डेटा इन्गेस्ट करने देता है। इस डेटा को LLMs के लिए अनुकूलित मध्यवर्ती अभ्यावेदन में इंडेक्स किया जाता है। फिर LlamaIndex क्वेरी इंजनों, चैट इंटरफेस, और LLM-संचालित डेटा एजेंट्स के माध्यम से आपकी डेटा के साथ प्राकृतिक भाषा में क्वेरी और संवाद की सुविधा देता है। यह आपके LLMs को बिना मॉडल को नए डेटा पर पुनः प्रशिक्षित किए, बड़े पैमाने पर निजी डेटा तक पहुंचने और उसकी व्याख्या करने में सक्षम बनाता है।
चाहे आप अपनी डेटा से प्राकृतिक भाषा में सरल तरीक़े से प्रश्न पूछना चाहते हों या उन्नत उपयोगकर्ता के रूप में गहरी कस्टमाइज़ेशन की ज़रूरत हो—LlamaIndex उपयुक्त टूल्स प्रदान करता है। हाई-लेवल API से आप सिर्फ पाँच पंक्तियों के कोड में शुरुआत कर सकते हैं, जबकि लोअर-लेवल APIs डेटा इन्गेस्टion, इंडेक्सिंग, रिट्रीवल, और अन्य पर पूर्ण नियंत्रण देते हैं।
LlamaIndex कैसे काम करता है?
LlamaIndex Retrieval Augmented Generation (RAG) सिस्टम का उपयोग करता है, जो बड़े भाषा मॉडलों को निजी नॉलेज बेस के साथ जोड़ते हैं। यह सामान्यतः दो चरणों में होता है: इंडेक्सिंग चरण और क्वेरींग चरण।
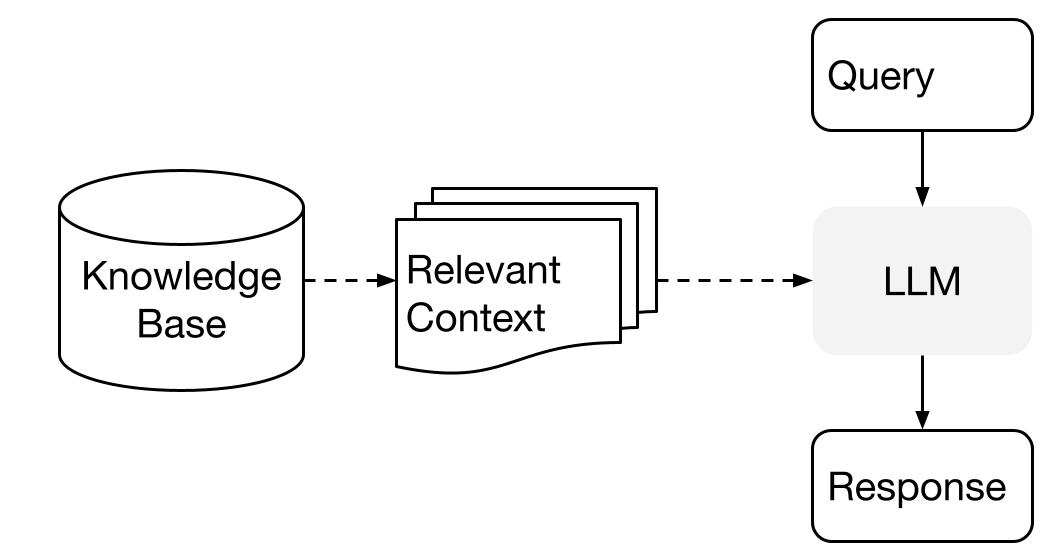
High-Level Concepts से छवि
इंडेक्सिंग चरण
इंडेक्सिंग चरण में LlamaIndex निजी डेटा को कुशलता से एक वेक्टर इंडेक्स में इंडेक्स करता है। यह चरण आपके डोमेन-विशिष्ट, खोजयोग्य नॉलेज बेस बनाने में मदद करता है। आप टेक्स्ट दस्तावेज़, डेटाबेस रिकॉर्ड्स, नॉलेज ग्राफ़, और अन्य डेटा प्रकार इनपुट कर सकते हैं।
मूल रूप से, इंडेक्सिंग डेटा को संख्यात्मक वेक्टरों या एम्बेडिंग्स में बदल देती है जो उसके सेमान्टिक अर्थ को समेटते हैं। इससे कंटेंट पर तेज़ समानता खोजें संभव होती हैं।
क्वेरींग चरण
क्वेरींग चरण के दौरान, RAG पाइपलाइन उपयोगकर्ता की क्वेरी के आधार पर सबसे प्रासंगिक जानकारी खोजती है। फिर यह जानकारी, क्वेरी के साथ, LLM को दी जाती है ताकि सटीक उत्तर बनाया जा सके।
यह प्रक्रिया LLM को वर्तमान और अद्यतन जानकारी तक पहुंच देती है, जो शायद उसके प्रारंभिक प्रशिक्षण में शामिल न रही हो।
इस चरण में मुख्य चुनौती संभावित रूप से कई नॉलेज बेस से जानकारी को प्राप्त करना, व्यवस्थित करना और उस पर तर्क करना होती है।
PineCone के साथ Retrieval Augmented Generation पर हमारे कोड-अलॉन्ग में RAG के बारे में और जानें।
LlamaIndex सेट करना
ट्यूटोरियल और प्रोजेक्ट में जाने से पहले, हमें Python पैकेज इंस्टॉल करना और API सेटअप करना होगा।
हम pip का उपयोग करके आसानी से LlamaIndex इंस्टॉल कर सकते हैं।
pip install llama-indexडिफ़ॉल्ट रूप से, LlamaIndex OpenAI GPT-3 text-davinci-003 मॉडल का उपयोग करता है। इस मॉडल का उपयोग करने के लिए, आपके पास OPENAI_API_KEY सेटअप होना चाहिए। आप OpenAI’s new API token में लॉग इन करके निःशुल्क अकाउंट बनाकर API कुंजी प्राप्त कर सकते हैं।
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
साथ ही, यह सुनिश्चित करें कि आपने openai पैकेज इंस्टॉल किया हुआ है।
pip install openaiLlamaIndex के माध्यम से LLMs में व्यक्तिगत डेटा जोड़ना
इस खंड में, हम LlamaIndex का उपयोग करके एक रेज़्यूमे रीडर बनाना सीखेंगे। आप अपना रेज़्यूमे Linkedin प्रोफ़ाइल पेज पर जाकर, More पर क्लिक करके, और फिर Save to PDF चुनकर डाउनलोड कर सकते हैं।
कृपया ध्यान दें कि हम Python कोड चलाने के लिए DataLab का उपयोग कर रहे हैं। आप संबंधित सारा कोड और आउटपुट LlamaIndex: Adding Personal Data to LLMs वर्कबुक में एक्सेस कर सकते हैं; आप आसानी से इसकी अपनी कॉपी बना सकते हैं और बिना अपने कंप्यूटर पर कुछ इंस्टॉल किए पूरा कोड चला सकते हैं!
कुछ भी चलाने से पहले, हमें llama-index, openai, और pypdf इंस्टॉल करने होंगे। हम pypdf इसलिए इंस्टॉल कर रहे हैं ताकि PDF फ़ाइलें पढ़ और कन्वर्ट कर सकें।
%pip install llama-index openai pypdfडेटा लोड करना और इंडेक्स बनाना
हमारे पास "Private-Data" नामक एक डायरेक्टरी है जिसमें केवल एक PDF फ़ाइल है। हम इसे पढ़ने के लिए SimpleDirectoryReader का उपयोग करेंगे और फिर TreeIndex का उपयोग करके इसे एक इंडेक्स में बदलेंगे।
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)
क्वेरी चलाना
डेटा इंडेक्स हो जाने के बाद, आप as_query_engine() का उपयोग करके प्रश्न पूछना शुरू कर सकते हैं। यह फंक्शन आपको दस्तावेज़ के भीतर विशिष्ट जानकारी पर प्रश्न करने और OpenAI के GPT-3 text-davinci-003 मॉडल की मदद से संबंधित उत्तर प्राप्त करने में सक्षम बनाता है।
नोट: आप DataLab में OpenAI API को Using GPT-3.5 and GPT-4 via the OpenAI API in Python ट्यूटोरियल का अनुसरण करके सेट कर सकते हैं।
जैसा कि हम देख सकते हैं, LLM मॉडल ने क्वेरी का सटीक उत्तर दिया है। इसने इंडेक्स में खोजकर प्रासंगिक जानकारी पाई।
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.हम प्रमाणपत्र के बारे में और पूछताछ कर सकते हैं। ऐसा प्रतीत होता है कि LlamaIndex ने उम्मीदवार की संपूर्ण समझ बना ली है, जो विशेष व्यक्तियों की तलाश कर रही कंपनियों के लिए लाभदायक हो सकती है।
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist Professionalकॉन्टेक्स्ट को सेव और लोड करना
इंडेक्स बनाना समय-लेवा प्रक्रिया है। हम कॉन्टेक्स्ट सेव करके इंडेक्सेज़ को फिर से बनाने से बच सकते हैं। डिफ़ॉल्ट रूप से, निम्नलिखित कमांड ./storage डायरेक्टरी में इंडेक्स स्टोर सेव कर देगा।
new_index.storage_context.persist()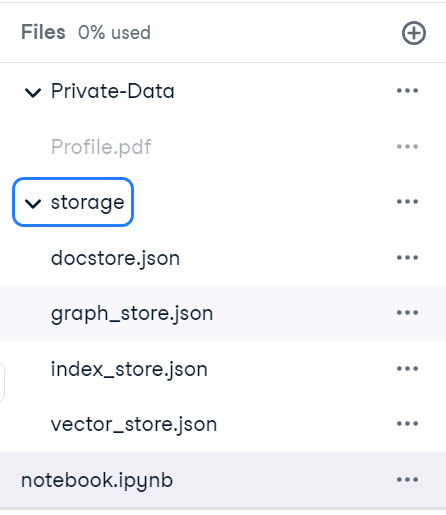
यह हो जाने के बाद, हम स्टोरेज कॉन्टेक्स्ट को जल्दी से लोड करके इंडेक्स बना सकते हैं।
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
यह सत्यापित करने के लिए कि यह ठीक से काम कर रहा है, हम क्वेरी इंजन से रेज़्यूमे से जुड़ा प्रश्न पूछेंगे। लगता है कि हमने सफलतापूर्वक कॉन्टेक्स्ट लोड कर लिया है।
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.चैटबोट
Q&A के बजाय, हम LlamaIndex का उपयोग करके एक व्यक्तिगत चैटबोट भी बना सकते हैं। हमें केवल as_chat_engine() फंक्शन के साथ इंडेक्स इनिशियलाइज़ करना है।
हम एक सरल प्रश्न पूछेंगे।
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.और बिना अतिरिक्त संदर्भ दिए, हम आगे के प्रश्न पूछेंगे।
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.यह स्पष्ट है कि चैट इंजन बिना किसी रुकावट के काम कर रहा है।
अपना भाषा अनुप्रयोग बनाने के बाद, आपकी अगली प्राथमिकता होनी चाहिए क्लाउड में बड़े भाषा मॉडलों (LLMs) का उपयोग करने बनाम उन्हें लोकल चलाने के फायदे और नुकसान पढ़ना। इससे आपको अपनी ज़रूरतों के अनुसार सबसे उपयुक्त तरीका चुनने में मदद मिलेगी।
LlamaIndex के साथ विकि टेक्स्ट टू स्पीच बनाना
हमारा अगला प्रोजेक्ट एक ऐसा अनुप्रयोग विकसित करना है जो Wikipedia से ली गई जानकारी पर प्रश्नों के उत्तर दे और उन्हें स्पीच में बदल दे।
कोड स्रोत और अतिरिक्त जानकारी इस DataLab वर्कबुक में उपलब्ध है।
Wikipedia पेज का वेब स्क्रैपिंग
सबसे पहले, हम Italy - Wikipedia वेबपेज से डेटा स्क्रैप करेंगे और उसे data फ़ोल्डर में italy_text.txt फ़ाइल के रूप में सेव करेंगे।
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)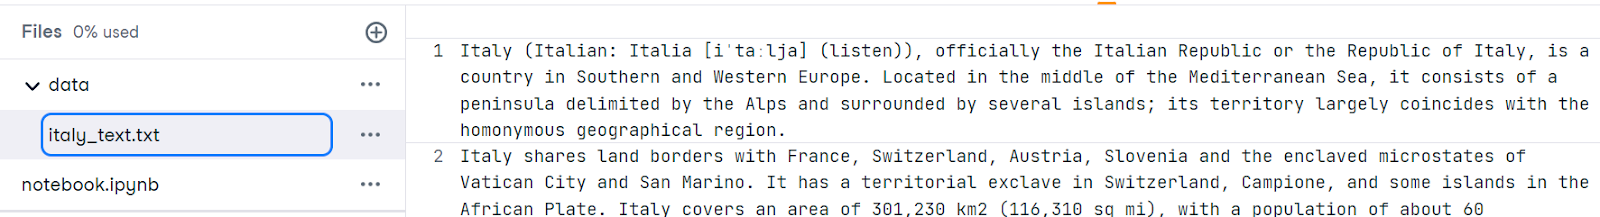
डेटा लोड करना और इंडेक्स बनाना
अगला, हमें आवश्यक पैकेज इंस्टॉल करने होंगे। elevenlabs पैकेज हमें API के जरिए टेक्स्ट को स्पीच में आसानी से बदलने देता है।
%pip install llama-index openai elevenlabsSimpleDirectoryReader का उपयोग करके हम डेटा लोड करेंगे और VectorStoreIndex के माध्यम से TXT फ़ाइल को एक वेक्टर स्टोर में बदलेंगे।
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
क्वेरी
हमारी योजना देश के बारे में एक सामान्य प्रश्न पूछने और LLM query_engine से उत्तर प्राप्त करने की है।
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))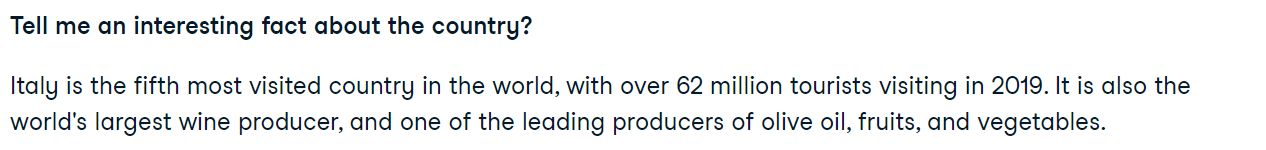
टेक्स्ट टू स्पीच
इसके बाद, हम llama_index.tts मॉड्यूल का उपयोग करके ElevenLabsTTS API तक पहुंचेंगे। आपको ऑडियो जनरेशन फंक्शन शुरू करने के लिए ElevenLabs API कुंजी प्रदान करनी होगी। आप ElevenLabs वेबसाइट से निःशुल्क API कुंजी प्राप्त कर सकते हैं।
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
हम प्राकृतिक वॉइस जनरेट करने के लिए प्रतिक्रिया को generate_audio फंक्शन में देंगे। ऑडियो सुनने के लिए, हम IPython.display के Audio फंक्शन का उपयोग करेंगे।
audio = tts.generate_audio(str(response))
Audio(audio)
यह एक सरल उदाहरण है। आप कई मॉड्यूल्स का उपयोग करके अपनी असिस्टेंट—जैसे Siri—बना सकते हैं, जो आपकी निजी डेटा की व्याख्या करके आपके प्रश्नों का उत्तर देती है। अधिक जानकारी के लिए LlamaIndex प्रलेखन देखें।
LlamaIndex के अलावा, LangChain भी आपको LLM-आधारित अनुप्रयोग बनाने देता है। इसके अतिरिक्त, आप Introduction to LangChain for Data Engineering & Data Applications पढ़ सकते हैं ताकि LangChain से क्या किया जा सकता है, वह किन समस्याओं को हल करता है, और डेटा उपयोग मामलों के उदाहरणों का अवलोकन मिल सके।
LlamaIndex के उपयोग के मामले
LlamaIndex भाषा-आधारित अनुप्रयोग बनाने के लिए एक संपूर्ण टूलकिट प्रदान करता है। इसके अलावा, आप Llama Hub से विभिन्न डेटा लोडर्स और एजेंट टूल्स का उपयोग करके बहु-कार्यात्मक जटिल अनुप्रयोग विकसित कर सकते हैं।
आप एक या अधिक प्लगइन्स डेटा लोडर्स के साथ अपने LLM को कस्टम डेटा स्रोतों से कनेक्ट कर सकते हैं।
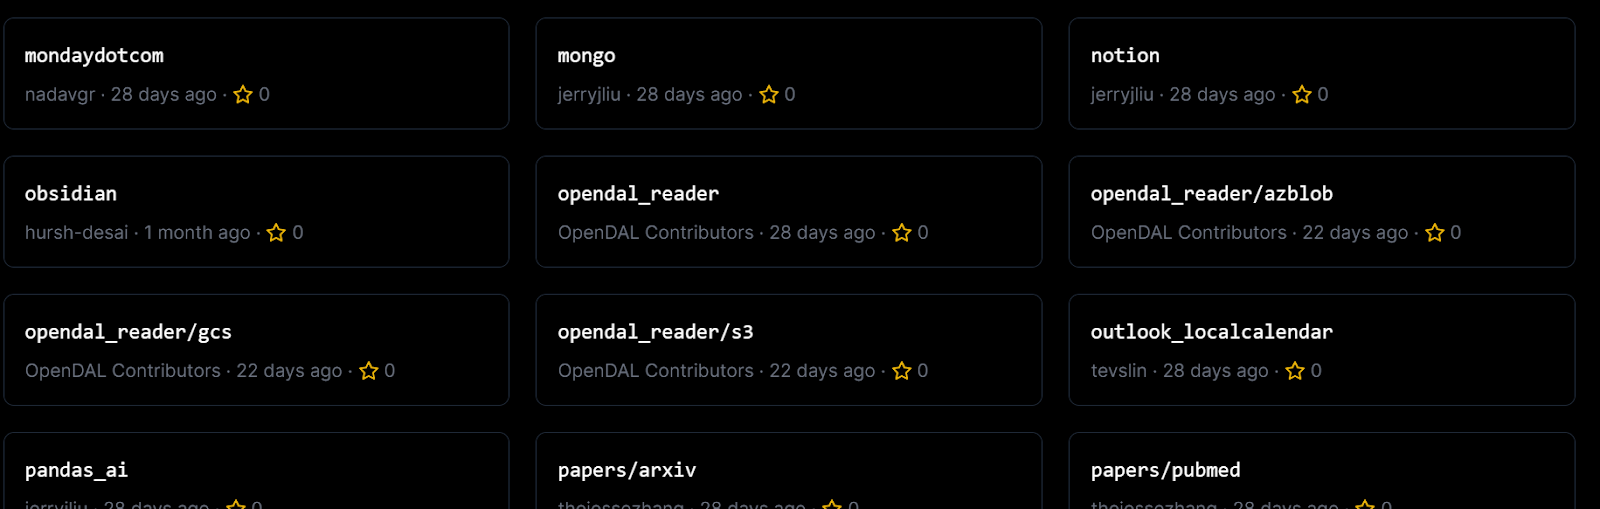
Llama Hub से डेटा लोडर्स
आप एजेंट टूल्स का उपयोग करके तृतीय-पक्ष टूल्स और APIs को भी एकीकृत कर सकते हैं।
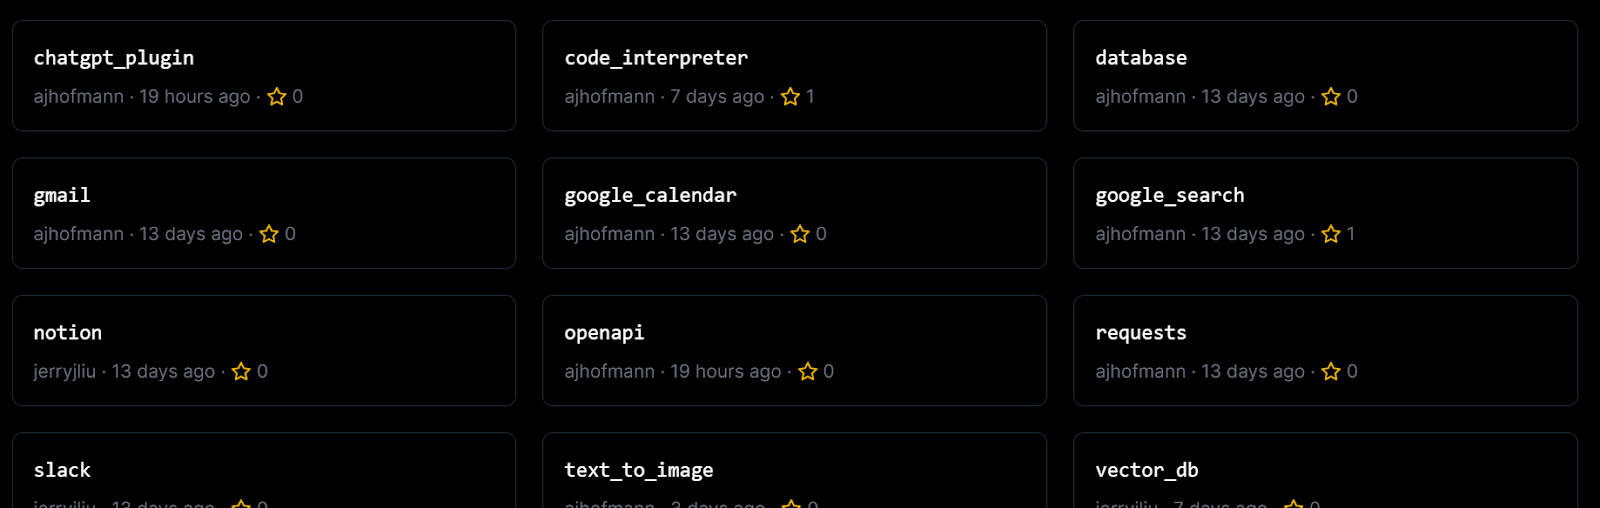
Llama Hub से एजेंट टूल्स
संक्षेप में, आप LlamaIndex का उपयोग करके निम्न बना सकते हैं:
- दस्तावेज़ों पर प्रश्नोत्तर
- चैटबोट्स
- एजेंट्स
- स्ट्रक्चर्ड डेटा
- फुल-स्टैक वेब एप्लिकेशन
- प्राइवेट सेटअप
इन उपयोग मामलों के बारे में विस्तार से जानने के लिए, LlamaIndex के प्रलेखन पर जाएँ।
निष्कर्ष
LlamaIndex एक शक्तिशाली टूलकिट प्रदान करता है जो रिट्रीवल-ऑगमेंटेड जनरेशन सिस्टम बनाने में मदद करता है—जो बड़े भाषा मॉडलों की ताकत को कस्टम नॉलेज बेस के साथ जोड़ते हैं। यह डोमेन-विशिष्ट डेटा का इंडेक्स्ड स्टोर बनाने और इन्फ़रेंस के दौरान उसे उपयोग में लाकर LLM को प्रासंगिक संदर्भ देने, तथा उच्च-गुणवत्ता के उत्तर जनरेट करने में सक्षम बनाता है।
इस ट्यूटोरियल में, हमने LlamaIndex और उसके कार्य-तरीके के बारे में सीखा। साथ ही, हमने कुछ ही पंक्तियों के Python कोड से एक रेज़्यूमे रीडर और टेक्स्ट-टू-स्पीच प्रोजेक्ट बनाया। LlamaIndex के साथ LLM एप्लिकेशन बनाना सरल है, और यह प्लगइन्स, डेटा लोडर्स, और एजेंट्स का विस्तृत पुस्तकालय प्रदान करता है।
एक विशेषज्ञ LLM डेवलपर बनने के लिए अगला स्वाभाविक कदम Master Large Language Models Concepts कोर्स में नामांकन करना है। यह कोर्स LLMs की अनुप्रयोगों, प्रशिक्षण विधियों, नैतिक पहलुओं, और नवीनतम शोध सहित व्यापक समझ प्रदान करेगा।
