
Last chance! 50% off DataCamp Premium
Sale ends in
LlamaIndex è un framework dati per applicazioni basate su Large Language Models (LLM). Gli LLM come GPT-4 sono pre-addestrati su enormi dataset pubblici, offrendo fin da subito incredibili capacità di elaborazione del linguaggio naturale. Tuttavia, la loro utilità è limitata senza accesso ai tuoi dati privati.
LlamaIndex ti consente di acquisire dati da API, database, PDF e altro tramite connettori dati flessibili. Questi dati vengono indicizzati in rappresentazioni intermedie ottimizzate per gli LLM. LlamaIndex permette poi di fare query e conversazioni in linguaggio naturale sui tuoi dati tramite motori di interrogazione, interfacce chat e agenti dati alimentati da LLM. Consente ai tuoi LLM di accedere e interpretare dati privati su larga scala senza riaddestrare il modello su dati più recenti.
Che tu sia un principiante in cerca di un modo semplice per interrogare i tuoi dati in linguaggio naturale o un utente avanzato che richiede una profonda personalizzazione, LlamaIndex fornisce gli strumenti. Le API di alto livello permettono di iniziare in sole cinque righe di codice, mentre le API di basso livello offrono il pieno controllo su ingestion, indicizzazione, recupero e altro ancora.
LlamaIndex utilizza sistemi di Retrieval Augmented Generation (RAG) che combinano large language model con una base di conoscenza privata. In genere si compone di due fasi: la fase di indicizzazione e la fase di interrogazione.
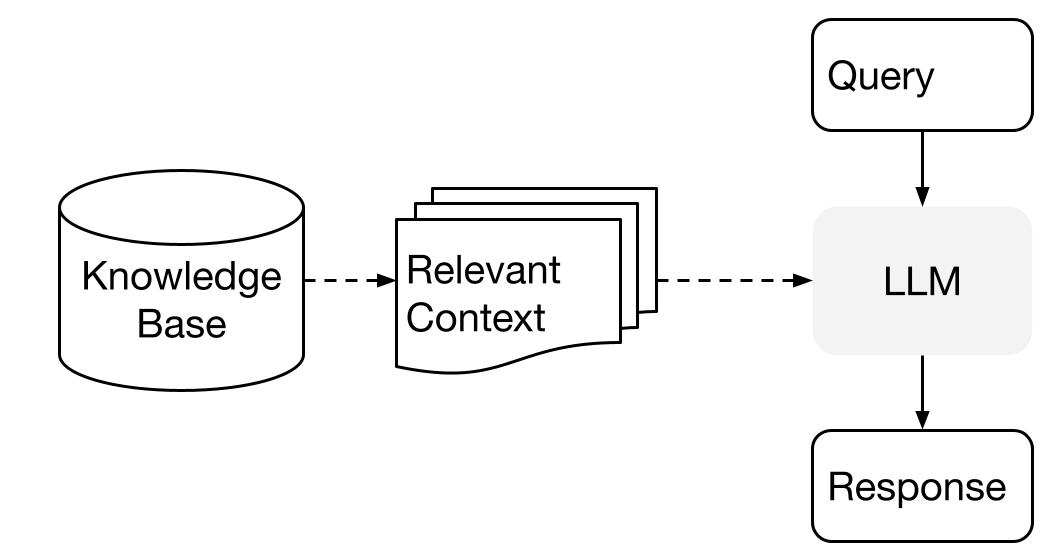
Immagine da High-Level Concepts
Durante la fase di indicizzazione, LlamaIndex indicizzerà in modo efficiente i dati privati in un indice vettoriale. Questo passaggio aiuta a creare una base di conoscenza ricercabile specifica per il tuo dominio. Puoi fornire documenti di testo, record di database, knowledge graph e altri tipi di dati.
In sostanza, l’indicizzazione converte i dati in vettori numerici o embedding che ne catturano il significato semantico. Ciò consente ricerche per similarità rapide sul contenuto.
Durante la fase di interrogazione, la pipeline RAG cerca le informazioni più pertinenti in base alla query dell’utente. Queste informazioni vengono quindi fornite all’LLM, insieme alla query, per creare una risposta accurata.
Questo processo consente all’LLM di accedere a informazioni attuali e aggiornate che potrebbero non essere state incluse nel suo addestramento iniziale.
La principale sfida in questa fase è recuperare, organizzare e ragionare su basi di conoscenza potenzialmente multiple.
Scopri di più su RAG nel nostro code-along su Retrieval Augmented Generation con PineCone.
Prima di entrare nel nostro tutorial e progetto con LlamaIndex, dobbiamo installare il pacchetto Python e configurare l’API.
Possiamo installare LlamaIndex semplicemente con pip.
pip install llama-indexPer impostazione predefinita, LlamaIndex usa il modello OpenAI GPT-3 text-davinci-003. Per usare questo modello, devi avere impostata una OPENAI_API_KEY. Puoi creare un account gratuito e ottenere una chiave API accedendo a OpenAI’s new API token.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Inoltre, assicurati di aver installato il pacchetto openai.
pip install openaiIn questa sezione impareremo a usare LlamaIndex per creare un lettore di CV. Puoi scaricare il tuo CV andando sulla pagina profilo di Linkedin, cliccando su Altro e poi su Salva in PDF.
Nota che stiamo usando DataLab per eseguire il codice Python. Puoi accedere a tutto il codice e all’output pertinenti nel workbook LlamaIndex: Adding Personal Data to LLMs; puoi creare facilmente una tua copia per eseguire tutto il codice senza dover installare nulla sul tuo computer!
Prima di eseguire qualsiasi cosa, dobbiamo installare llama-index, openai e pypdf. Installiamo pypdf per poter leggere e convertire file PDF.
%pip install llama-index openai pypdfAbbiamo una directory chiamata "Private-Data" che contiene un solo file PDF. Useremo SimpleDirectoryReader per leggerlo e poi lo convertiremo in un indice usando TreeIndex.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)Una volta indicizzati i dati, puoi iniziare a fare domande usando as_query_engine(). Questa funzione ti consente di porre domande su informazioni specifiche all’interno del documento e ricevere una risposta corrispondente con l’aiuto del modello OpenAI GPT-3 text-davinci-003.
Nota: puoi configurare l’API di OpenAI in DataLab seguendo il tutorial Usare GPT-3.5 e GPT-4 tramite l’API di OpenAI in Python.
Come possiamo vedere, il modello LLM ha risposto accuratamente alla query. Ha cercato nell’indice e trovato le informazioni pertinenti.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.Possiamo approfondire chiedendo delle certificazioni. Sembra che LlamaIndex abbia acquisito una comprensione completa del candidato, il che può essere vantaggioso per le aziende che cercano profili specifici.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalLa creazione di un indice richiede tempo. Possiamo evitare di ricreare gli indici salvando il contesto. Per impostazione predefinita, il seguente comando salverà l’archivio dell’indice nella directory ./storage.
new_index.storage_context.persist()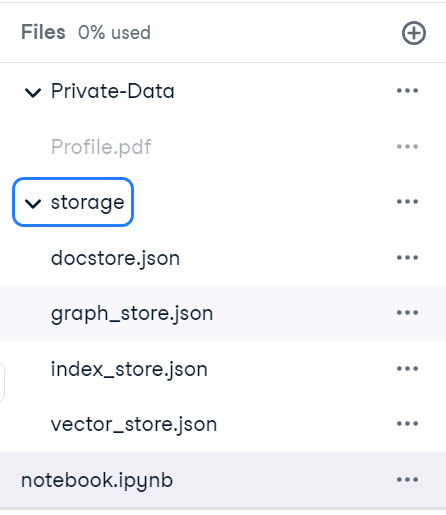
Una volta fatto, possiamo caricare rapidamente il contesto di archiviazione e creare un indice.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Per verificare che funzioni correttamente, chiederemo al motore di query una domanda dal CV. Sembra che abbiamo caricato il contesto con successo.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.Invece del classico Q&A, possiamo anche usare LlamaIndex per creare un chatbot personale. Dobbiamo solo inizializzare l’indice con la funzione as_chat_engine().
Faremo una domanda semplice.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.E senza fornire ulteriore contesto, faremo domande di follow-up.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.È evidente che il motore di chat funziona alla perfezione.
Dopo aver costruito la tua applicazione linguistica, il passo successivo nella tua roadmap è leggere pro e contro dell’uso dei Large Language Models (LLM) nel cloud rispetto all’esecuzione locale. Questo ti aiuterà a capire quale approccio si adatta meglio alle tue esigenze.
Il nostro prossimo progetto prevede lo sviluppo di un’applicazione che possa rispondere a domande provenienti da Wikipedia e convertirle in parlato.
Il codice sorgente e informazioni aggiuntive sono disponibili in questo workbook DataLab.
Per prima cosa effettueremo lo scraping dei dati dalla pagina Italy - Wikipedia e li salveremo come file italy_text.txt nella cartella data.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)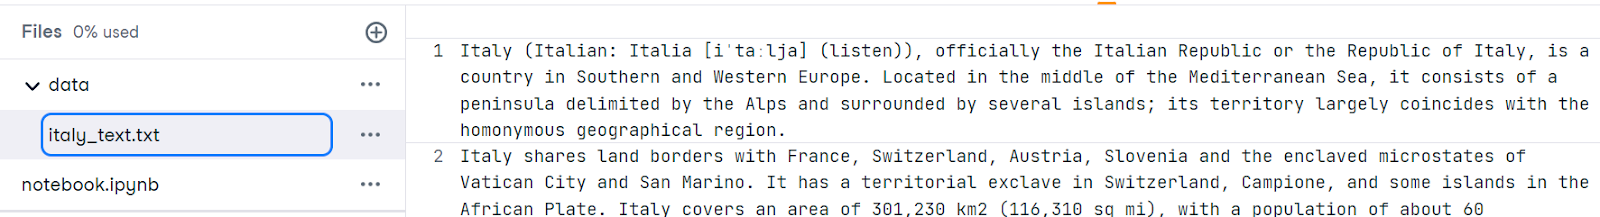
Successivamente, dobbiamo installare i pacchetti necessari. Il pacchetto elevenlabs ci consente di convertire facilmente il testo in parlato tramite un’API.
%pip install llama-index openai elevenlabsUsando SimpleDirectoryReader caricheremo i dati e convertiremo il file TXT in un archivio vettoriale usando VectorStoreIndex.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)Il nostro piano è porre una domanda generale sul paese e ricevere una risposta dall’LLM tramite il query_engine.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))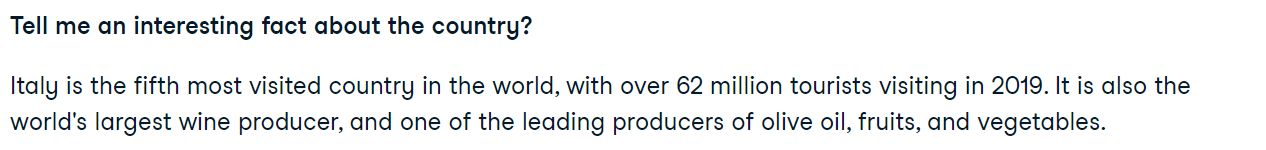
Dopodiché useremo il modulo llama_index.tts per accedere all’API di ElevenLabsTTS. Devi fornire la chiave API di ElevenLabs per avviare la funzione di generazione audio. Puoi ottenere una chiave API gratuitamente dal sito di ElevenLabs.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
Aggiungeremo la risposta alla funzione generate_audio per generare una voce naturale. Per ascoltare l’audio, useremo la funzione Audio di IPython.display.
audio = tts.generate_audio(str(response))
Audio(audio)
Questo è un esempio semplice. Puoi usare più moduli per creare il tuo assistente, come Siri, che risponde alle tue domande interpretando i tuoi dati privati. Per maggiori informazioni, consulta la documentazione di LlamaIndex.
Oltre a LlamaIndex, anche LangChain ti permette di creare applicazioni basate su LLM. Inoltre, puoi leggere Introduzione a LangChain per Data Engineering e Data Applications per avere una panoramica di ciò che puoi fare con LangChain, inclusi i problemi che risolve ed esempi di casi d’uso sui dati.
LlamaIndex fornisce un toolkit completo per costruire applicazioni basate sul linguaggio. In più, puoi usare vari data loader e strumenti per agenti da Llama Hub per sviluppare applicazioni complesse con funzionalità multiple.
Puoi collegare fonti dati personalizzate al tuo LLM con uno o più plugin Data Loader.
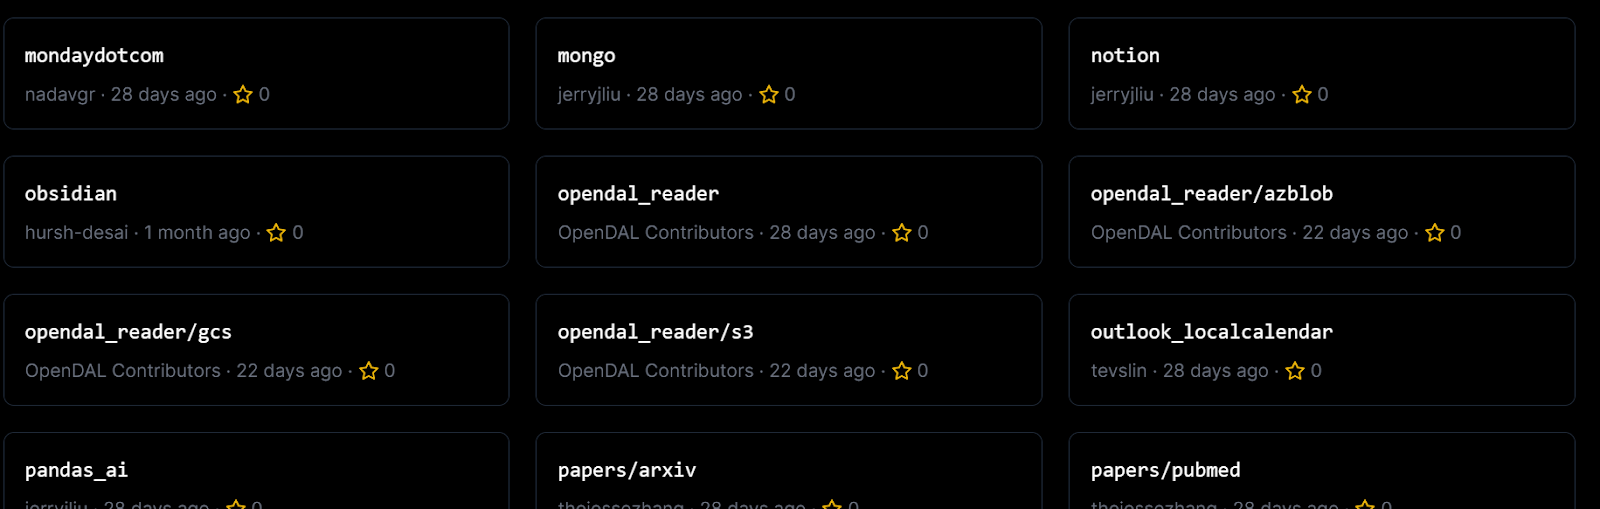
Data Loader da Llama Hub
Puoi anche usare strumenti per Agent per integrare tool e API di terze parti.
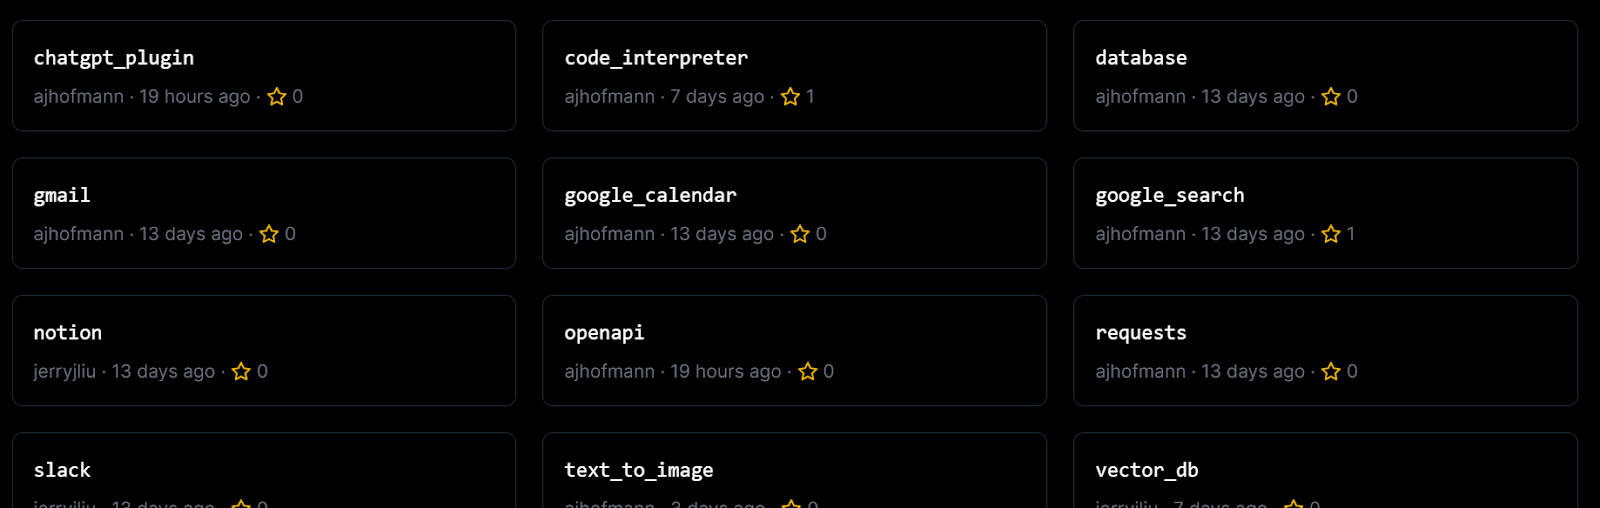
Strumenti per Agent da Llama Hub
In breve, puoi usare LlamaIndex per costruire:
Per approfondire questi casi d’uso, vai alla documentazione di LlamaIndex.
LlamaIndex offre un potente toolkit per costruire sistemi di retrieval-augmented generation che combinano i punti di forza dei large language model con basi di conoscenza personalizzate. Consente di creare un archivio indicizzato di dati specifici del dominio e di sfruttarlo in fase di inferenza per fornire all’LLM il contesto rilevante e generare risposte di alta qualità.
In questo tutorial abbiamo conosciuto LlamaIndex e come funziona. Inoltre, abbiamo costruito un lettore di CV e un progetto di text-to-speech con poche righe di codice Python. Creare un’applicazione LLM con LlamaIndex è semplice e offre un’ampia libreria di plugin, data loader e agenti.
Per diventare un esperto sviluppatore di LLM, il prossimo passo naturale è iscriverti al corso Master Large Language Models Concepts. Questo corso ti offrirà una comprensione completa degli LLM, incluse applicazioni, metodi di addestramento, considerazioni etiche e le ricerche più recenti.
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min




