LlamaIndex, Büyük Dil Modellerine (LLM) dayalı uygulamalar için bir veri çerçevesidir. GPT-4 gibi LLM'ler, kutudan çıkar çıkmaz olağanüstü doğal dil işleme yetenekleri sağlayan devasa kamu veri kümeleri üzerinde önceden eğitilmiştir. Ancak, kendi özel verilerinize erişim olmadan kullanımları sınırlıdır.
LlamaIndex, esnek veri bağlayıcıları aracılığıyla API'lerden, veritabanlarından, PDF'lerden ve daha fazlasından veri almanıza olanak tanır. Bu veriler, LLM'ler için optimize edilmiş ara temsillere indekslenir. LlamaIndex daha sonra sorgu motorları, sohbet arayüzleri ve LLM destekli veri ajanları aracılığıyla verilerinizle doğal dilde sorgulama ve sohbet imkanı sunar. Modeli yeni veriler üzerinde yeniden eğitmeden LLM'lerinizin geniş ölçekte özel verilere erişmesini ve bunları yorumlamasını sağlar.
İster verilerinizi doğal dille sorgulamak için basit bir yol arayan bir başlangıç seviyesinde olun, ister derin özelleştirme gerektiren ileri düzey bir kullanıcı olun, LlamaIndex gerekli araçları sunar. Yüksek seviyeli API yalnızca beş satır kodla başlamanıza olanak tanırken, daha alt seviyeli API'ler veri alma, indeksleme, geri getirme ve daha fazlası üzerinde tam kontrol sağlar.
LlamaIndex Nasıl Çalışır?
LlamaIndex, büyük dil modellerini özel bir bilgi tabanıyla birleştiren Geri Getirme Artırmalı Üretim (RAG) sistemlerini kullanır. Genellikle iki aşamadan oluşur: indeksleme aşaması ve sorgulama aşaması.
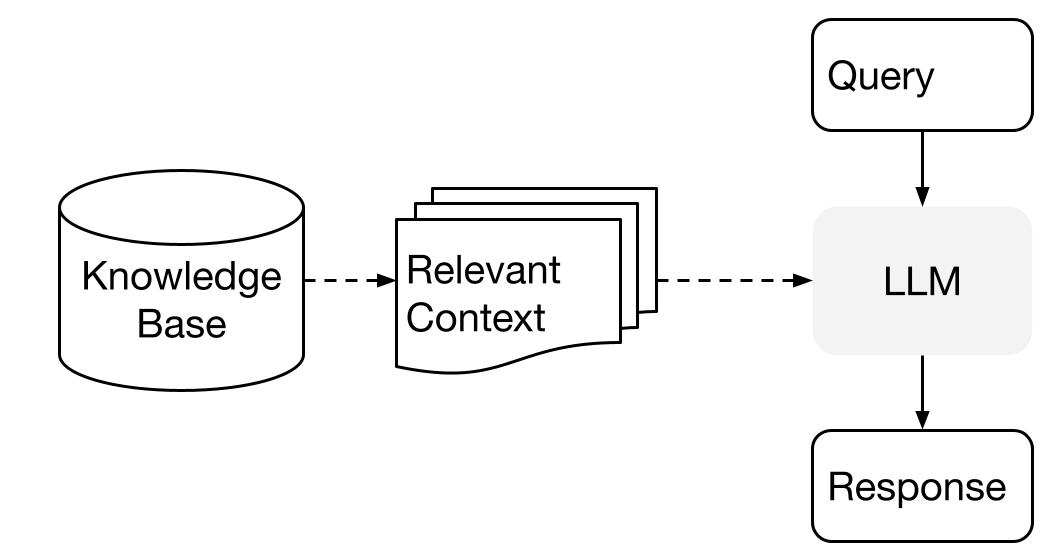
Üst Düzey Kavramlar kaynağından görsel
İndeksleme aşaması
LlamaIndex, indeksleme aşamasında özel verileri verimli bir şekilde bir vektör indeksine işler. Bu adım, alanınıza özgü aranabilir bir bilgi tabanı oluşturmanıza yardımcı olur. Metin belgeleri, veritabanı kayıtları, bilgi grafikleri ve diğer veri türlerini girebilirsiniz.
Özünde indeksleme, verileri anlamsal anlamını yakalayan sayısal vektörlere veya gömlemelere dönüştürür. Bu da içerik genelinde hızlı benzerlik aramaları yapılmasını sağlar.
Sorgulama aşaması
Sorgulama aşamasında, RAG hattı kullanıcının sorgusuna göre en ilgili bilgileri arar. Bu bilgiler, doğru bir yanıt üretmek üzere sorguyla birlikte LLM'e verilir.
Bu süreç, LLM'in ilk eğitimine dahil edilmemiş olabilecek güncel ve güncellenmiş bilgilere erişmesini sağlar.
Bu aşamadaki temel zorluk, potansiyel olarak birden fazla bilgi tabanından bilgi getirmek, bunları düzenlemek ve bunlar üzerinde akıl yürütmektir.
PineCone ile Geri Getirme Artırmalı Üretim kod eşli dersiyle RAG hakkında daha fazla bilgi edinin.
LlamaIndex'in kurulumu
LlamaIndex eğitimimize ve projemize dalmadan önce, Python paketini kurmamız ve API'yi yapılandırmamız gerekiyor.
LlamaIndex'i pip kullanarak kolayca kurabiliriz.
pip install llama-indexVarsayılan olarak, LlamaIndex OpenAI GPT-3 text-davinci-003 modelini kullanır. Bu modeli kullanmak için bir OPENAI_API_KEY ayarlamış olmanız gerekir. OpenAI’nin yeni API belirteci sayfasına giriş yaparak ücretsiz bir hesap oluşturabilir ve bir API anahtarı alabilirsiniz.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Ayrıca, openai paketini kurduğunuzdan emin olun.
pip install openaiLlamaIndex ile Kişisel Verileri LLM'lere Ekleme
Bu bölümde, bir özgeçmiş okuyucu oluşturmak için LlamaIndex kullanmayı öğreneceğiz. Özgeçmişinizi Linkedin profil sayfasına gidip Daha Fazla'ya tıklayarak ve ardından PDF olarak kaydederek indirebilirsiniz.
Python kodunu çalıştırmak için DataLab kullandığımızı lütfen unutmayın. İlgili tüm kodlara ve çıktılara LlamaIndex: Kişisel Verileri LLM'lere Ekleme çalışma kitabından erişebilirsiniz; kendi kopyanızı kolayca oluşturabilir ve bilgisayarınıza hiçbir şey kurmadan tüm kodu çalıştırabilirsiniz!
Herhangi bir şeyi çalıştırmadan önce, llama-index, openai ve pypdf kurmalıyız. PDF dosyalarını okuyup dönüştürebilmek için pypdf kuruyoruz.
%pip install llama-index openai pypdfVerileri yükleme ve indeks oluşturma
Yalnızca bir PDF dosyası içeren "Private-Data" adlı bir dizinimiz var. Bunu okumak için SimpleDirectoryReader'ı kullanacağız ve ardından TreeIndex kullanarak bir indekse dönüştüreceğiz.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)
Bir sorgu çalıştırma
Veriler indekslendikten sonra, as_query_engine() kullanarak soru sormaya başlayabilirsiniz. Bu işlev, belgedeki belirli bilgiler hakkında sorular sormanıza ve OpenAI GPT-3 text-davinci-003 modelinin yardımıyla karşılık gelen bir yanıt almanıza olanak tanır.
Not: OpenAI API'sini DataLab'de Python'da OpenAI API üzerinden GPT-3.5 ve GPT-4 kullanma öğreticisini izleyerek ayarlayabilirsiniz.
Görüldüğü gibi, LLM modelinin sorguya doğru şekilde yanıt verdiğini görüyoruz. İndeksi taradı ve ilgili bilgiyi buldu.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.Sertifikalar hakkında daha fazla sorabiliriz. Görünüşe göre LlamaIndex aday hakkında kapsamlı bir anlayışa sahip olmuş; bu da belirli profilleri arayan şirketler için avantaj sağlayabilir.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalBağlamı kaydetme ve yükleme
Bir indeks oluşturmak zaman alan bir süreçtir. Bağlamı kaydederek indeksleri yeniden oluşturmaktan kaçınabiliriz. Varsayılan olarak, aşağıdaki komut indeks deposunu ./storage dizinine kaydeder.
new_index.storage_context.persist()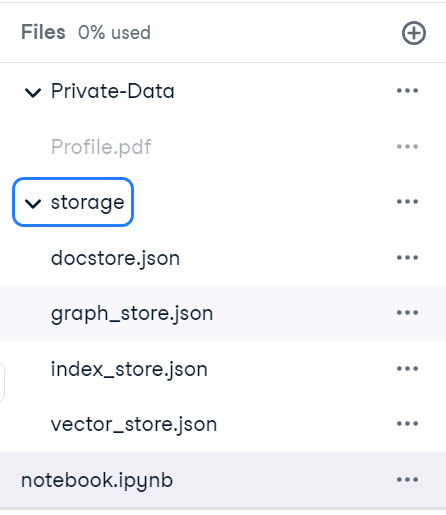
Bu işlem tamamlandıktan sonra, depolama bağlamını hızlıca yükleyip bir indeks oluşturabiliriz.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Doğru çalıştığını doğrulamak için sorgu motoruna özgeçmişten bir soru soracağız. Görünüşe göre bağlamı başarıyla yükledik.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.Sohbet botu
Soru-Cevap yerine, LlamaIndex'i kişisel bir sohbet botu oluşturmak için de kullanabiliriz. as_chat_engine() işleviyle indeksi başlatmamız yeterli.
Basit bir soru soracağız.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.Ve ek bağlam vermeden takip soruları soracağız.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.Sohbet motorunun kusursuz çalıştığı açık.
Dil uygulamanızı oluşturduktan sonra, zaman çizelgenizdeki bir sonraki adım, Büyük Dil Modellerini (LLM) bulutta kullanmanın artı ve eksileri ile yerelde çalıştırmanın karşılaştırmasını okumaktır. Bu, ihtiyaçlarınıza en uygun yaklaşımı belirlemenize yardımcı olacaktır.
LlamaIndex ile Viki Metinden Sese uygulaması oluşturma
Bir sonraki projemiz, Wikipedia'dan alınan sorulara yanıt verebilen ve bunları sese dönüştürebilen bir uygulama geliştirmeyi içeriyor.
Kod kaynağı ve ek bilgiler bu DataLab çalışma kitabında mevcuttur.
Wikipedia sayfasını web kazıma
Önce Italy - Wikipedia web sayfasından verileri kazıyıp data klasöründe italy_text.txt dosyası olarak kaydedeceğiz.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)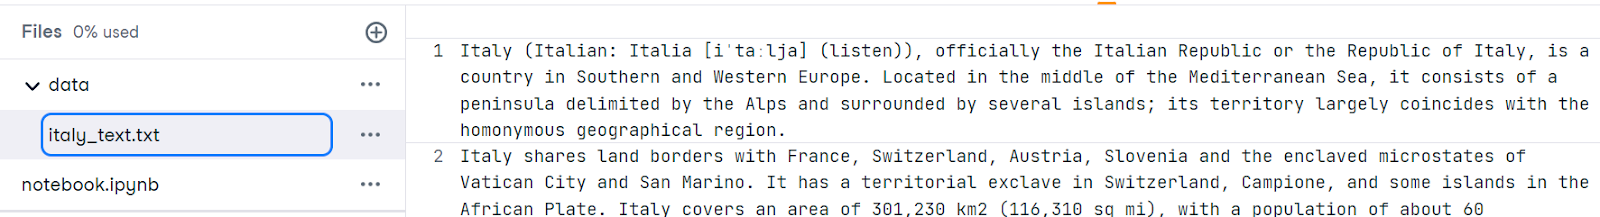
Verileri yükleme ve indeks oluşturma
Sonraki adımda gerekli paketleri kurmamız gerekiyor. elevenlabs paketi, bir API kullanarak metni kolayca sese dönüştürmemize olanak tanır.
%pip install llama-index openai elevenlabsSimpleDirectoryReader kullanarak verileri yükleyecek ve VectorStoreIndex ile TXT dosyasını bir vektör deposuna dönüştüreceğiz.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
Sorgu
Planımız, ülke hakkında genel bir soru sormak ve LLM query_engine'den bir yanıt almaktır.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))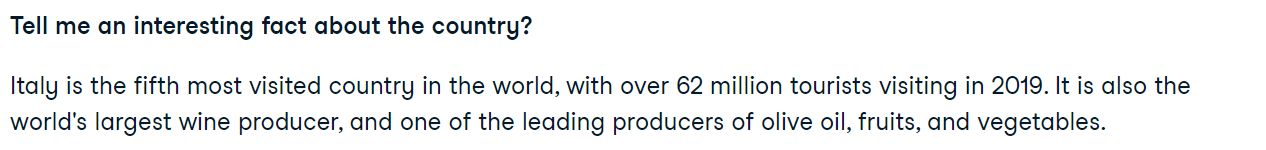
Metinden sese
Ardından, ElevenLabsTTS API'sine erişmek için llama_index.tts modülünü kullanacağız. Ses üretim işlevini başlatmak için ElevenLabs API anahtarını sağlamanız gerekir. Ücretsiz bir API anahtarını ElevenLabs web sitesinden alabilirsiniz.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
Doğal bir ses üretmek için yanıtı generate_audio işlevine ekleyeceğiz. Sesi dinlemek için IPython.display'in Audio işlevini kullanacağız.
audio = tts.generate_audio(str(response))
Audio(audio)
Bu basit bir örnek. Siri gibi, sorularınıza özel verilerinizi yorumlayarak yanıt veren bir asistan oluşturmak için birden fazla modül kullanabilirsiniz. Daha fazla bilgi için LlamaIndex belgelerine bakın.
LlamaIndex'e ek olarak, LangChain de LLM tabanlı uygulamalar geliştirmenize olanak tanır. Ayrıca, LangChain ile neler yapabileceğinize genel bir bakış için Veri Mühendisliği ve Veri Uygulamaları için LangChain'e Giriş yazısını okuyabilir; LangChain'in çözdüğü problemler ve veri kullanım örnekleri hakkında bilgi edinebilirsiniz.
LlamaIndex Kullanım Alanları
LlamaIndex, dil tabanlı uygulamalar oluşturmak için eksiksiz bir araç seti sunar. Buna ek olarak, Llama Hub üzerinden çeşitli veri yükleyicileri ve ajan araçlarını kullanarak çok işlevli karmaşık uygulamalar geliştirebilirsiniz.
Özel veri kaynaklarını bir veya daha fazla Eklenti Veri Yükleyici ile LLM'inize bağlayabilirsiniz.
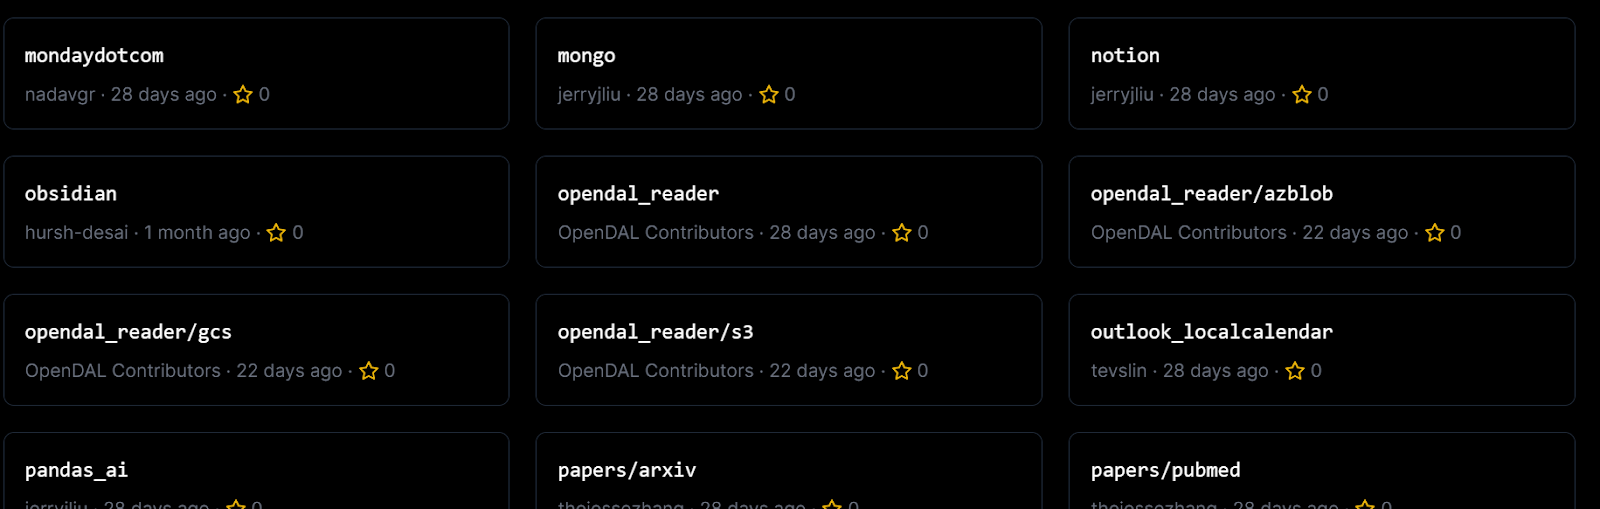
Llama Hub'dan Veri Yükleyiciler
Ayrıca, üçüncü taraf araçları ve API'leri entegre etmek için Ajan araçlarını da kullanabilirsiniz.
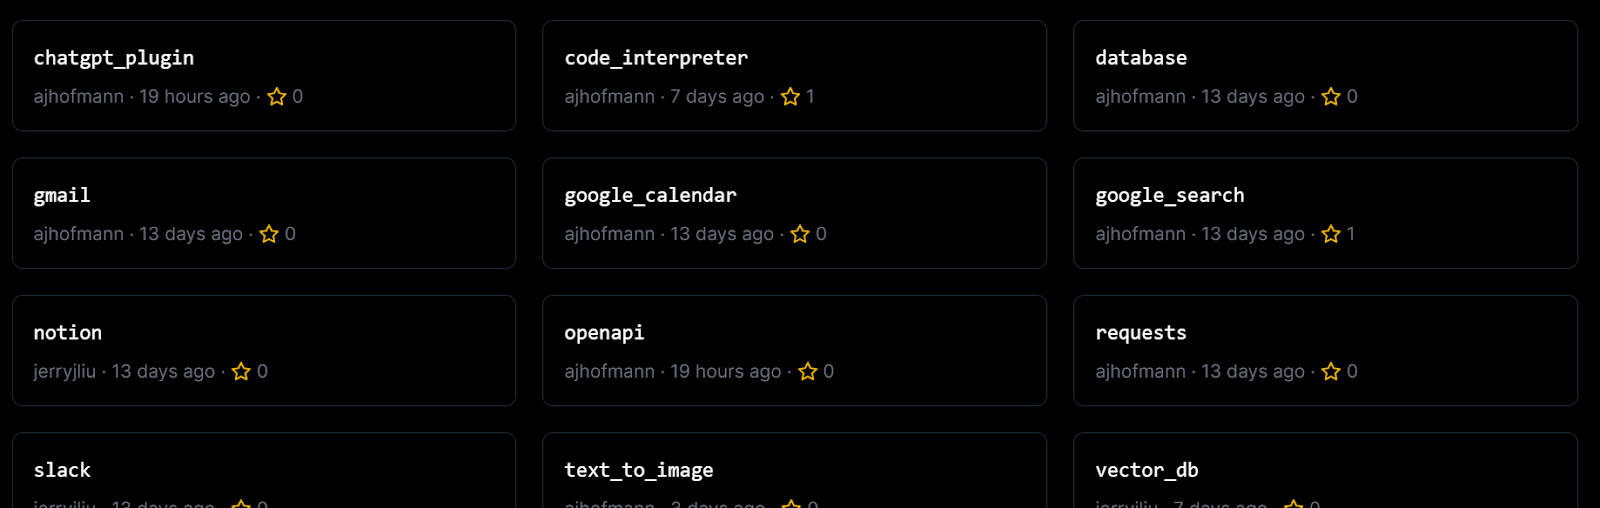
Llama Hub'dan Ajan Araçları
Kısacası, LlamaIndex ile şunları oluşturabilirsiniz:
- Belgeler Üzerinde Soru-Cevap
- Sohbet botları
- Ajanlar
- Yapılandırılmış Veri
- Uçtan Uca Web Uygulaması
- Özel Kurulum
Bu kullanım alanlarını ayrıntılı öğrenmek için LlamaIndex belgelerine göz atın.
Sonuç
LlamaIndex, büyük dil modellerinin gücünü özel bilgi tabanlarıyla birleştiren geri getirme artırmalı üretim sistemleri inşa etmek için güçlü bir araç seti sunar. Alanınıza özgü verilerden oluşturulmuş bir indeks deposu yaratmayı ve çıkarım sırasında bunu kullanarak LLM'e ilgili bağlam sağlamayı, böylece yüksek kaliteli yanıtlar üretmeyi mümkün kılar.
Bu eğitimde, LlamaIndex'i ve nasıl çalıştığını öğrendik. Ayrıca, yalnızca birkaç satır Python koduyla bir özgeçmiş okuyucu ve metinden sese projesi oluşturduk. LlamaIndex ile bir LLM uygulaması oluşturmak basittir ve geniş bir eklenti, veri yükleyici ve ajan kütüphanesi sunar.
Uzman bir LLM geliştiricisi olmak için bir sonraki doğal adım, Büyük Dil Modelleri Kavramlarında Ustalaşın kursuna kaydolmaktır. Bu kurs, uygulamaları, eğitim yöntemleri, etik hususlar ve en güncel araştırmalar dahil olmak üzere LLM'ler hakkında kapsamlı bir anlayış sağlayacaktır.





