
Last chance! 50% off DataCamp Premium
Sale ends in
LlamaIndex is een dataframework voor applicaties op basis van Large Language Models (LLM’s). LLM’s zoals GPT-4 zijn vooraf getraind op enorme openbare datasets en bieden daardoor direct indrukwekkende mogelijkheden voor natuurlijke taalverwerking. Maar zonder toegang tot je eigen privédata is hun nut beperkt.
Met LlamaIndex kun je data opnemen uit API’s, databases, pdf’s en meer via flexibele dataconnectoren. Deze data worden geïndexeerd in intermediaire representaties die geoptimaliseerd zijn voor LLM’s. LlamaIndex maakt vervolgens natuurlijke-taalvragen en -gesprekken met je data mogelijk via query-engines, chatinterfaces en LLM-aangestuurde data-agents. Zo krijgen je LLM’s toegang tot en inzicht in privédata op grote schaal, zonder het model opnieuw te trainen op nieuwere data.
Of je nu beginner bent en eenvoudig je data in natuurlijke taal wilt bevragen, of een gevorderde gebruiker die diepe maatwerkopties nodig heeft: LlamaIndex levert de tools. Met de high-level API kun je starten in slechts vijf regels code, terwijl low-level API’s volledige controle geven over data-ingestie, indexering, retrieval en meer.
LlamaIndex gebruikt Retrieval Augmented Generation (RAG)-systemen die grote taalmodellen combineren met een privé-kennisbank. Dit bestaat doorgaans uit twee fasen: de indexeringsfase en de queryfase.
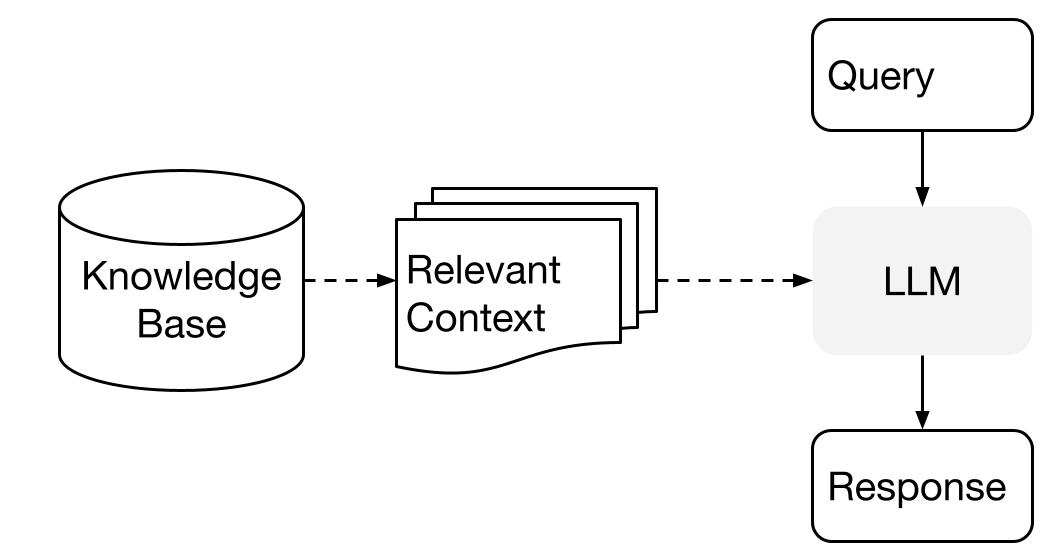
Afbeelding uit High-Level Concepts
Tijdens de indexeringsfase indexeert LlamaIndex privédata efficiënt in een vectorindex. Deze stap helpt bij het creëren van een doorzoekbare kennisbank die specifiek is voor jouw domein. Je kunt tekstdocumenten, databaserecords, kennisgrafen en andere datatypen invoeren.
Kort gezegd zet indexeren de data om in numerieke vectoren of embeddings die de semantische betekenis vastleggen. Dit maakt snelle similariteitszoekacties door de content mogelijk.
Tijdens de queryfase zoekt de RAG-pijplijn naar de meest relevante informatie op basis van de vraag van de gebruiker. Deze informatie wordt vervolgens samen met de query aan de LLM gegeven om een nauwkeurig antwoord te genereren.
Daardoor heeft de LLM toegang tot actuele en bijgewerkte informatie die mogelijk niet in de initiële training was opgenomen.
De grootste uitdaging in deze fase is het ophalen, organiseren en redeneren over mogelijk meerdere kennisbanken.
Leer meer over RAG in onze code-along over Retrieval Augmented Generation met PineCone.
Voordat we in onze LlamaIndex-tutorial en -project duiken, installeren we het Python-pakket en stellen we de API in.
We kunnen LlamaIndex eenvoudig installeren met pip.
pip install llama-indexStandaard gebruikt LlamaIndex het OpenAI GPT-3 text-davinci-003-model. Om dit model te gebruiken, moet je een OPENAI_API_KEY instellen. Je kunt een gratis account aanmaken en een API-sleutel krijgen door in te loggen op OpenAI’s nieuwe API-token.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Zorg er ook voor dat je het pakket openai hebt geïnstalleerd.
pip install openaiIn deze sectie leren we LlamaIndex te gebruiken om een cv-lezer te maken. Je kunt je cv downloaden via je LinkedIn-profielpagina, klik op Meer en vervolgens op Opslaan als pdf.
Let op: we gebruiken DataLab om de Python-code uit te voeren. Je hebt toegang tot alle relevante code en output in het LlamaIndex: Adding Personal Data to LLMs-werkboek; je kunt eenvoudig je eigen kopie maken om alle code te draaien zonder iets op je computer te hoeven installeren!
Voor we iets uitvoeren, moeten we llama-index, openai en pypdf installeren. We installeren pypdf zodat we pdf-bestanden kunnen lezen en converteren.
%pip install llama-index openai pypdfWe hebben een map met de naam "Private-Data" met slechts één pdf-bestand. We gebruiken de SimpleDirectoryReader om het te lezen en converteren het vervolgens naar een index met TreeIndex.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)Zodra de data is geïndexeerd, kun je vragen gaan stellen met as_query_engine(). Met deze functie kun je vragen stellen over specifieke informatie in het document en een bijbehorend antwoord ontvangen met behulp van het OpenAI GPT-3 text-davinci-003-model.
Tip: je kunt de OpenAI API instellen in DataLab via de tutorial Using GPT-3.5 and GPT-4 via the OpenAI API in Python.
Zoals we zien, heeft het LLM-model accuraat op de vraag gereageerd. Het doorzocht de index en vond de relevante informatie.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.We kunnen verder informeren naar certificeringen. Het lijkt erop dat LlamaIndex een volledig beeld van de kandidaat heeft gekregen, wat voordelig kan zijn voor bedrijven die naar specifieke profielen zoeken.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalEen index maken kost tijd. We kunnen voorkomen dat we indexen opnieuw moeten maken door de context op te slaan. Standaard slaat het volgende commando de index store op in de map ./storage.
new_index.storage_context.persist()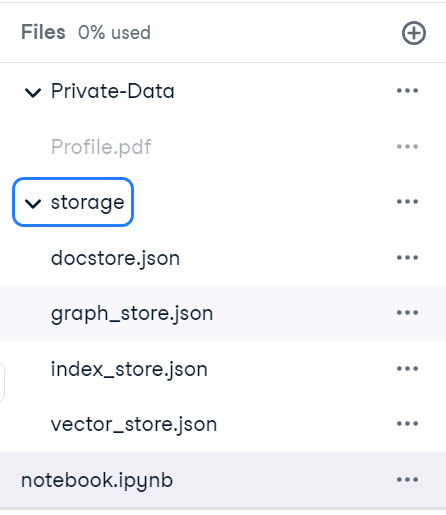
Daarna kunnen we de storage-context snel laden en een index maken.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Om te controleren of alles correct werkt, stellen we de query-engine een vraag uit het cv. Het lijkt erop dat we de context succesvol hebben geladen.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.In plaats van Q&A kunnen we met LlamaIndex ook een persoonlijke chatbot maken. We hoeven de index alleen te initialiseren met de functie as_chat_engine().
We stellen een eenvoudige vraag.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.Zonder extra context te geven, stellen we vervolgvraagjes.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.Het is duidelijk dat de chat-engine uitstekend functioneert.
Na het bouwen van je taalapplicatie is de volgende stap in je planning om te lezen over de voor- en nadelen van het gebruik van Large Language Models (LLM’s) in de cloud versus ze lokaal draaien. Dit helpt je bepalen welke aanpak het beste bij je past.
Ons volgende project is een applicatie die vragen beantwoordt op basis van Wikipedia en deze omzet in spraak.
De broncode en extra informatie vind je in dit DataLab-werkboek.
Eerst scrapen we de data van de webpagina Italy - Wikipedia en slaan die op als het bestand italy_text.txt in de map data.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)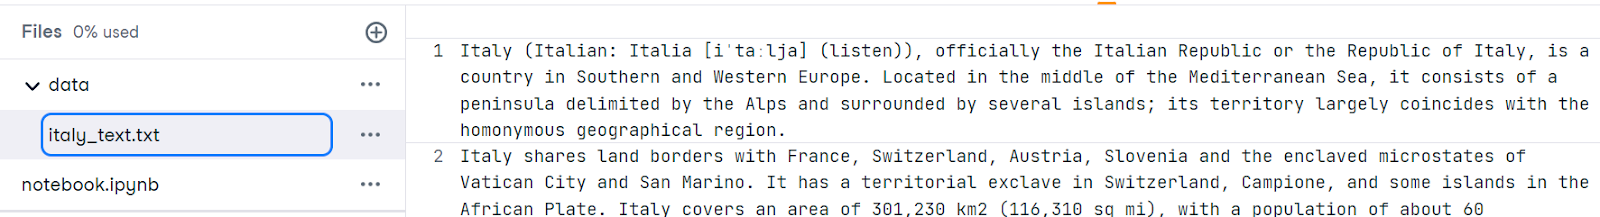
Vervolgens installeren we de benodigde pakketten. Met het pakket elevenlabs kunnen we eenvoudig tekst naar spraak omzetten via een API.
%pip install llama-index openai elevenlabsMet SimpleDirectoryReader laden we de data en zetten we het TXT-bestand om naar een vectorstore met VectorStoreIndex.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)Ons plan is om een algemene vraag over het land te stellen en een antwoord te krijgen van de LLM-query_engine.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))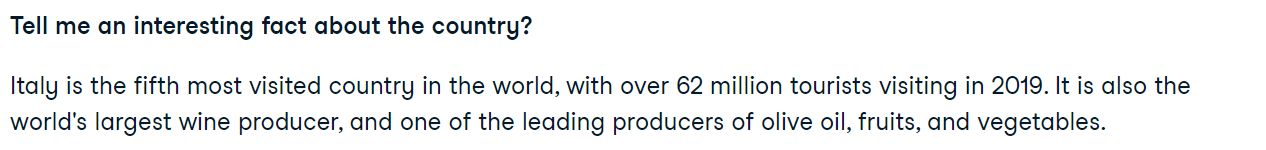
Daarna gebruiken we de module llama_index.tts om toegang te krijgen tot de ElevenLabsTTS-API. Je moet een ElevenLabs API-sleutel opgeven om de audiogeneratiefunctie te starten. Je kunt gratis een API-sleutel krijgen op de website van ElevenLabs.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
We geven de response mee aan de functie generate_audio om een natuurlijke stem te genereren. Om het audiofragment af te spelen gebruiken we de functie Audio van IPython.display.
audio = tts.generate_audio(str(response))
Audio(audio)
Dit is een eenvoudig voorbeeld. Je kunt meerdere modules gebruiken om je assistent te creëren, zoals Siri, die je vragen beantwoordt door je privédata te interpreteren. Raadpleeg voor meer informatie de documentatie van LlamaIndex.
Naast LlamaIndex kun je met LangChain ook applicaties op basis van LLM’s bouwen. Daarnaast kun je Introduction to LangChain for Data Engineering & Data Applications lezen voor een overzicht van wat je met LangChain kunt doen, inclusief de problemen die LangChain oplost en voorbeelden van datagebruiksscenario’s.
LlamaIndex biedt een complete toolkit om taalgebaseerde applicaties te bouwen. Daarbovenop kun je diverse dataloaders en agenttools uit Llama Hub gebruiken om complexe applicaties met meerdere functionaliteiten te ontwikkelen.
Je kunt aangepaste databronnen aan je LLM koppelen met een of meer plugin-dataloaders.
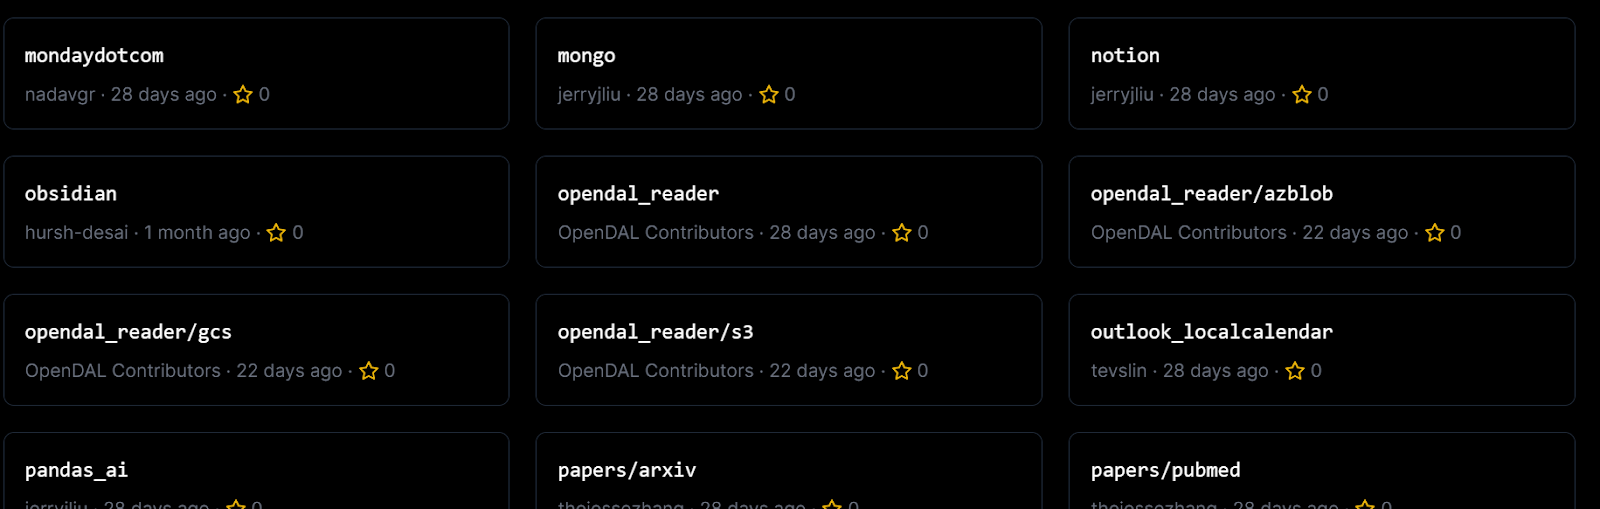
Dataloaders van Llama Hub
Je kunt ook Agent-tools gebruiken om tools en API’s van derden te integreren.
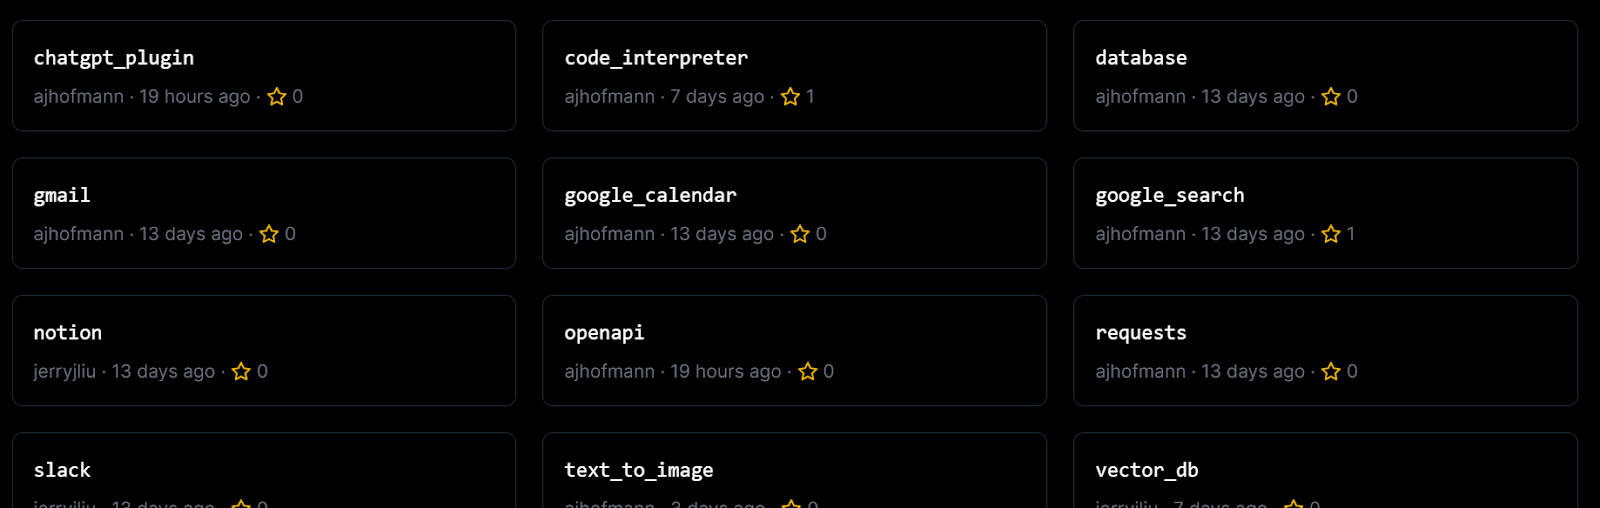
Agent-tools van Llama Hub
Kortom, met LlamaIndex kun je bouwen:
Voor gedetailleerde informatie over deze use-cases ga je naar de documentatie van LlamaIndex.
LlamaIndex biedt een krachtige toolkit voor het bouwen van retrieval-augmented generation-systemen die de kracht van grote taalmodellen combineren met aangepaste kennisbanken. Je kunt een geïndexeerde opslag van domeinspecifieke data creëren en die tijdens inferentie benutten om relevante context aan de LLM te geven voor hoogwaardige reacties.
In deze tutorial hebben we LlamaIndex en de werking ervan besproken. Daarnaast hebben we met slechts een paar regels Python-code een cv-lezer en een text-to-speech-project gebouwd. Een LLM-applicatie maken met LlamaIndex is eenvoudig en het platform biedt een uitgebreide bibliotheek met plugins, dataloaders en agents.
Om een expert-ontwikkelaar in LLM’s te worden, is de volgende logische stap je in te schrijven voor de cursus Master Large Language Models Concepts. Deze cursus geeft je een grondig begrip van LLM’s, inclusief hun toepassingen, trainingsmethoden, ethische overwegingen en het nieuwste onderzoek.
blog
Adel Nehme
15 min


