LlamaIndex ist ein Daten-Framework für Anwendungen, die auf Large Language Models (LLMs) basieren. LLMs wie GPT-4 sind vorab auf riesigen öffentlichen Datensätzen trainiert und liefern dadurch starke Fähigkeiten in der Sprachverarbeitung direkt ab Werk. Ohne Zugriff auf deine eigenen privaten Daten bleibt ihr Nutzen jedoch begrenzt.
LlamaIndex ermöglicht es dir, Daten aus APIs, Datenbanken, PDFs und mehr über flexible Datenkonnektoren einzulesen. Diese Daten werden in Zwischenrepräsentationen indexiert, die für LLMs optimiert sind. Anschließend kannst du deine Daten per natürlicher Sprache abfragen und darüber chatten – über Query-Engines, Chat-Oberflächen und LLM-gestützte Data Agents. So können LLMs auf private Daten im großen Stil zugreifen und sie interpretieren, ohne dass das Modell auf neueren Daten neu trainiert werden muss.
Egal, ob du als Einsteiger eine einfache Möglichkeit suchst, deine Daten in natürlicher Sprache zu befragen, oder als fortgeschrittener Nutzer tiefgreifende Anpassungen brauchst: LlamaIndex liefert die passenden Werkzeuge. Die High-Level-API erlaubt den Start in nur fünf Zeilen Code, während Low-Level-APIs volle Kontrolle über Dateneinzug, Indexierung, Retrieval und mehr bieten.
Wie funktioniert LlamaIndex?
LlamaIndex setzt auf Retrieval Augmented Generation (RAG), das große Sprachmodelle mit einer privaten Wissensbasis kombiniert. Im Kern gibt es zwei Phasen: die Indexierungsphase und die Abfragephase.
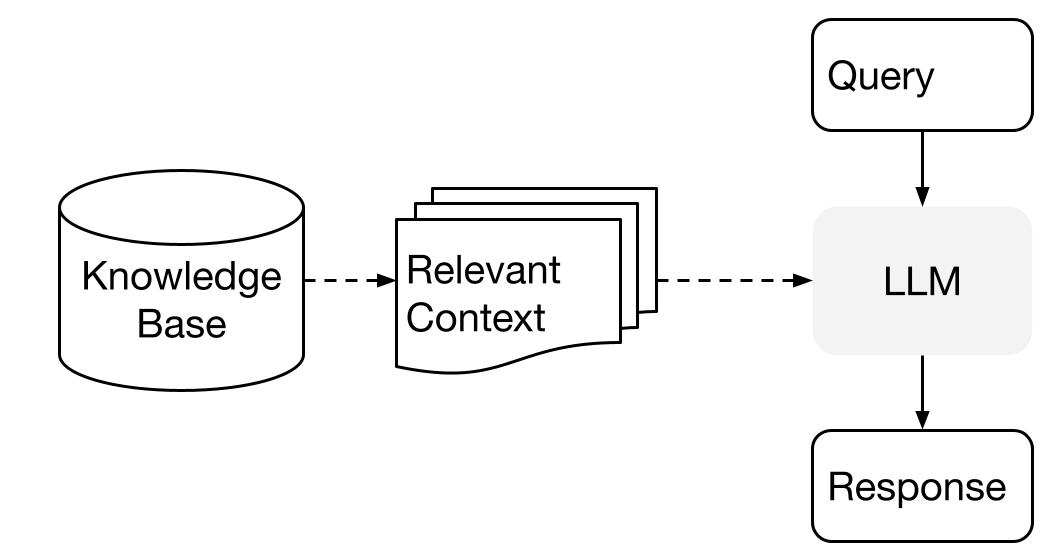
Grafik aus High-Level Concepts
Indexierungsphase
In der Indexierungsphase bringt LlamaIndex private Daten effizient in einen Vektorindex. So entsteht eine durchsuchbare Wissensbasis, die speziell auf deine Domäne zugeschnitten ist. Du kannst Textdokumente, Datenbanksätze, Knowledge Graphs und weitere Datentypen einbinden.
Im Grunde wandelt die Indexierung Daten in numerische Vektoren bzw. Embeddings um, die ihre semantische Bedeutung abbilden. Dadurch werden schnelle Ähnlichkeitssuchen über den gesamten Inhalt möglich.
Abfragephase
In der Abfragephase sucht die RAG-Pipeline auf Basis der Nutzerfrage nach den relevantesten Informationen. Diese Informationen werden zusammen mit der Frage an das LLM übergeben, um eine präzise Antwort zu erzeugen.
So erhält das LLM Zugriff auf aktuelle und neue Informationen, die beim ursprünglichen Training nicht enthalten waren.
Die zentrale Herausforderung in dieser Phase ist das effiziente Auffinden, Strukturieren und Verknüpfen potenziell mehrerer Wissensbasen.
Erfahre mehr über RAG in unserem Code-along zu Retrieval Augmented Generation mit PineCone.
LlamaIndex einrichten
Bevor wir ins Tutorial und Projekt einsteigen, installieren wir das Python-Paket und richten die API ein.
LlamaIndex lässt sich mit pip ganz einfach installieren.
pip install llama-indexStandardmäßig nutzt LlamaIndex das OpenAI-Modell GPT-3 text-davinci-003. Um dieses Modell zu verwenden, brauchst du einen eingerichteten OPENAI_API_KEY. Du kannst ein kostenloses Konto anlegen und einen API-Schlüssel erhalten, indem du dich bei OpenAI’s new API token einloggst.
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
Stelle außerdem sicher, dass das Paket openai installiert ist.
pip install openaiPrivate Daten mit LlamaIndex zu LLMs hinzufügen
In diesem Abschnitt erstellen wir mit LlamaIndex einen Lebenslauf-Reader. Du kannst deinen Lebenslauf auf deiner LinkedIn-Profilseite herunterladen, über „Mehr“ und dann „Als PDF speichern“.
Hinweis: Wir verwenden DataLab, um den Python-Code auszuführen. Du findest sämtlichen Code und die Ausgaben im Workbook LlamaIndex: Adding Personal Data to LLMs. Du kannst dir ganz einfach eine eigene Kopie erstellen und alles ausführen, ohne etwas lokal installieren zu müssen.
Bevor wir starten, müssen wir llama-index, openai und pypdf installieren. pypdf benötigen wir, um PDF-Dateien zu lesen und zu konvertieren.
%pip install llama-index openai pypdfDaten laden und Index erstellen
Wir haben ein Verzeichnis namens "Private-Data" mit genau einer PDF-Datei. Diese lesen wir mit dem SimpleDirectoryReader ein und wandeln sie mit dem TreeIndex in einen Index um.
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)
Eine Abfrage ausführen
Sobald die Daten indexiert sind, kannst du mit as_query_engine() Fragen stellen. Diese Funktion ermöglicht es dir, gezielt Informationen im Dokument abzufragen und mithilfe des OpenAI-Modells GPT-3 text-davinci-003 passende Antworten zu erhalten.
Hinweis: Du kannst die OpenAI API in DataLab gemäß dem Tutorial Using GPT-3.5 and GPT-4 via the OpenAI API in Python einrichten.
Wie zu sehen ist, hat das LLM die Anfrage korrekt beantwortet. Es hat den Index durchsucht und die relevanten Informationen gefunden.
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.Wir können weiter zu Zertifizierungen nachfragen. Offenbar hat LlamaIndex ein vollständiges Bild des Kandidaten gewonnen – ein Vorteil für Unternehmen, die gezielt nach bestimmten Profilen suchen.
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist ProfessionalKontext speichern und laden
Das Erstellen eines Index ist zeitaufwendig. Um das erneute Erstellen zu vermeiden, können wir den Kontext speichern. Standardmäßig legt der folgende Befehl den Index-Store im Verzeichnis ./storage ab.
new_index.storage_context.persist()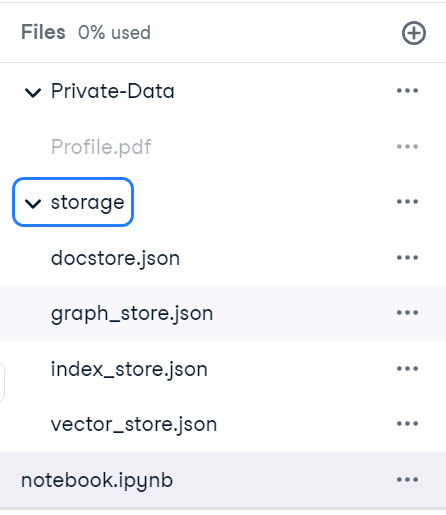
Anschließend können wir den Storage-Kontext schnell laden und daraus einen Index erstellen.
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
Zur Kontrolle stellen wir dem Query-Engine die Frage aus dem Lebenslauf. Es sieht so aus, als hätten wir den Kontext erfolgreich geladen.
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.Chatbot
Statt klassischem Q&A können wir mit LlamaIndex auch einen persönlichen Chatbot erstellen. Dafür initialisieren wir den Index mit der Funktion as_chat_engine().
Wir starten mit einer einfachen Frage.
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.Ohne zusätzlichen Kontext stellen wir Anschlussfragen.
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.Es ist klar erkennbar, dass die Chat-Engine einwandfrei funktioniert.
Nachdem du deine Sprach-Anwendung gebaut hast, solltest du dich als Nächstes mit Vor- und Nachteilen von LLMs in der Cloud gegenüber lokalem Betrieb beschäftigen. So findest du heraus, welcher Ansatz für dich am besten passt.
Wiki-Text-zu-Sprache mit LlamaIndex bauen
Im nächsten Projekt entwickeln wir eine Anwendung, die Fragen mit Inhalten aus Wikipedia beantwortet und die Antworten anschließend vertont.
Quellcode und weitere Informationen findest du in diesem DataLab-Workbook.
Wikipedia-Seite scrapen
Zuerst scrapen wir die Daten von der Seite Italy - Wikipedia und speichern sie als Datei italy_text.txt im Ordner data.
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)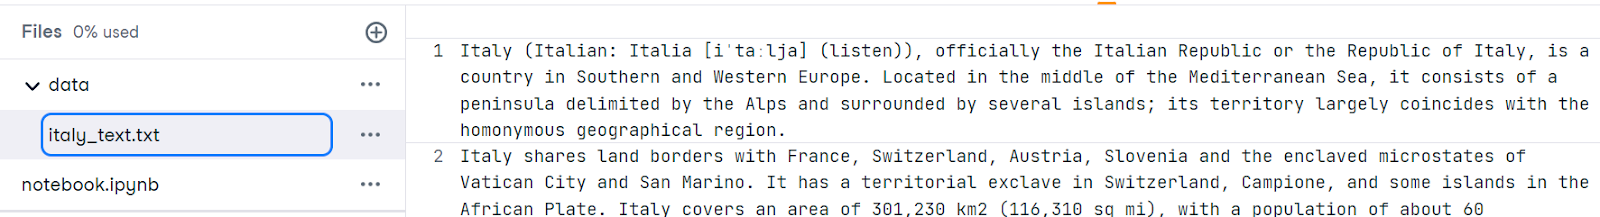
Daten laden und Index aufbauen
Als Nächstes installieren wir die benötigten Pakete. Mit dem Paket elevenlabs können wir Text bequem per API in Sprache umwandeln.
%pip install llama-index openai elevenlabsMit dem SimpleDirectoryReader laden wir die Daten und überführen die TXT-Datei mit VectorStoreIndex in einen Vektorspeicher.
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
Abfrage
Unser Plan: Wir stellen eine allgemeine Frage zum Land und erhalten eine Antwort vom LLM-query_engine.
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))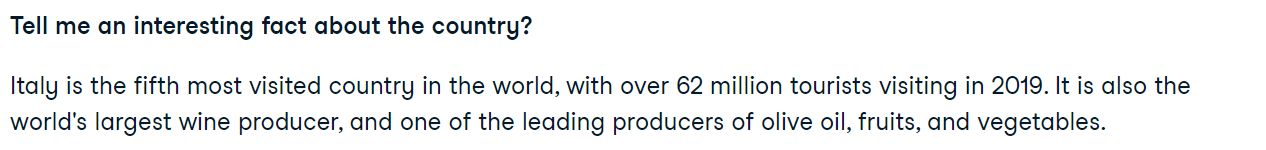
Text zu Sprache
Danach nutzen wir das Modul llama_index.tts, um auf die ElevenLabsTTS-API zuzugreifen. Für die Audiogenerierung brauchst du einen ElevenLabs-API-Schlüssel. Einen kostenlosen Schlüssel erhältst du auf der Website von ElevenLabs.
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
Wir übergeben die Antwort an die Funktion generate_audio, um eine natürliche Stimme zu erzeugen. Zum Anhören verwenden wir die Audio-Funktion aus IPython.display.
audio = tts.generate_audio(str(response))
Audio(audio)
Dies ist ein einfaches Beispiel. Du kannst mehrere Module kombinieren und deinen Assistenten – ähnlich wie Siri – bauen, der Fragen beantwortet, indem er deine privaten Daten interpretiert. Weitere Informationen findest du in der LlamaIndex-Dokumentation.
Neben LlamaIndex kannst du mit LangChain ebenfalls LLM-basierte Anwendungen entwickeln. Lies außerdem die Introduction to LangChain for Data Engineering & Data Applications, um einen Überblick darüber zu bekommen, was mit LangChain möglich ist – inklusive der Probleme, die LangChain löst, und praxisnaher Daten-Use-Cases.
LlamaIndex: Einsatzszenarien
LlamaIndex stellt einen vollständigen Werkzeugkasten für sprachbasierte Anwendungen bereit. Zusätzlich kannst du über den Llama Hub verschiedene Data Loader und Agent-Tools nutzen, um komplexe Anwendungen mit mehreren Funktionen zu entwickeln.
Du kannst eigene Datenquellen über einen oder mehrere Plugin-Data-Loader an dein LLM anbinden.
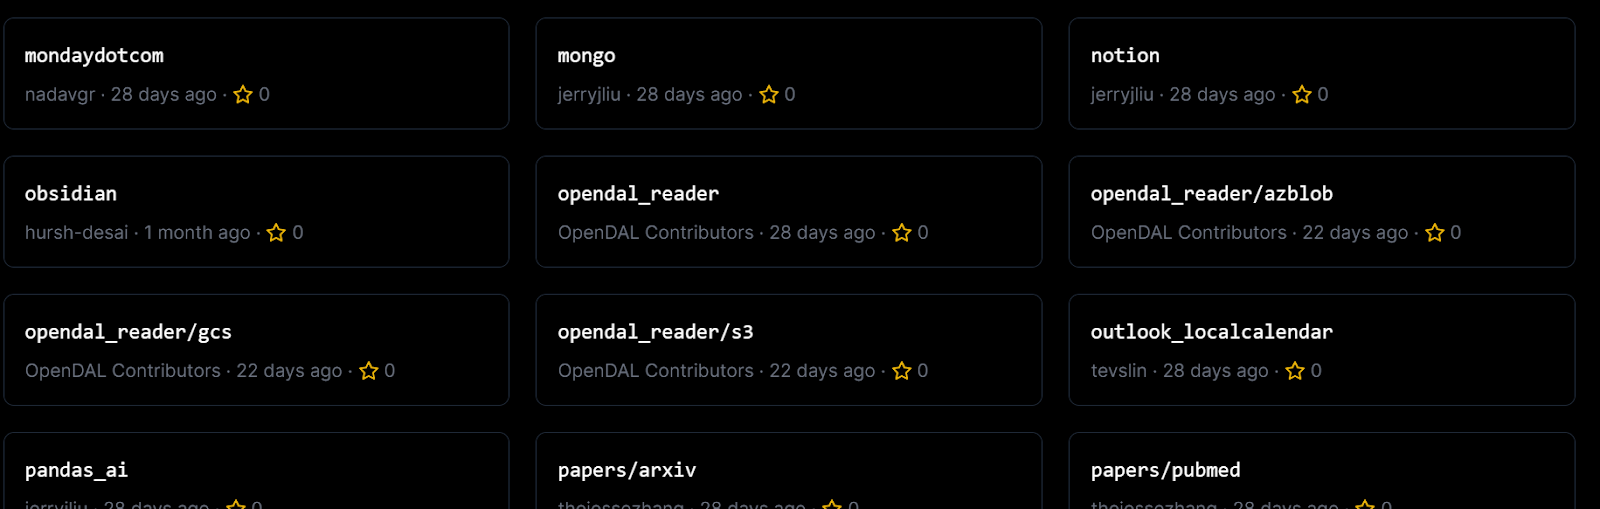
Data Loader aus dem Llama Hub
Außerdem stehen Agent-Tools zur Verfügung, um Drittanbieter-Tools und -APIs zu integrieren.
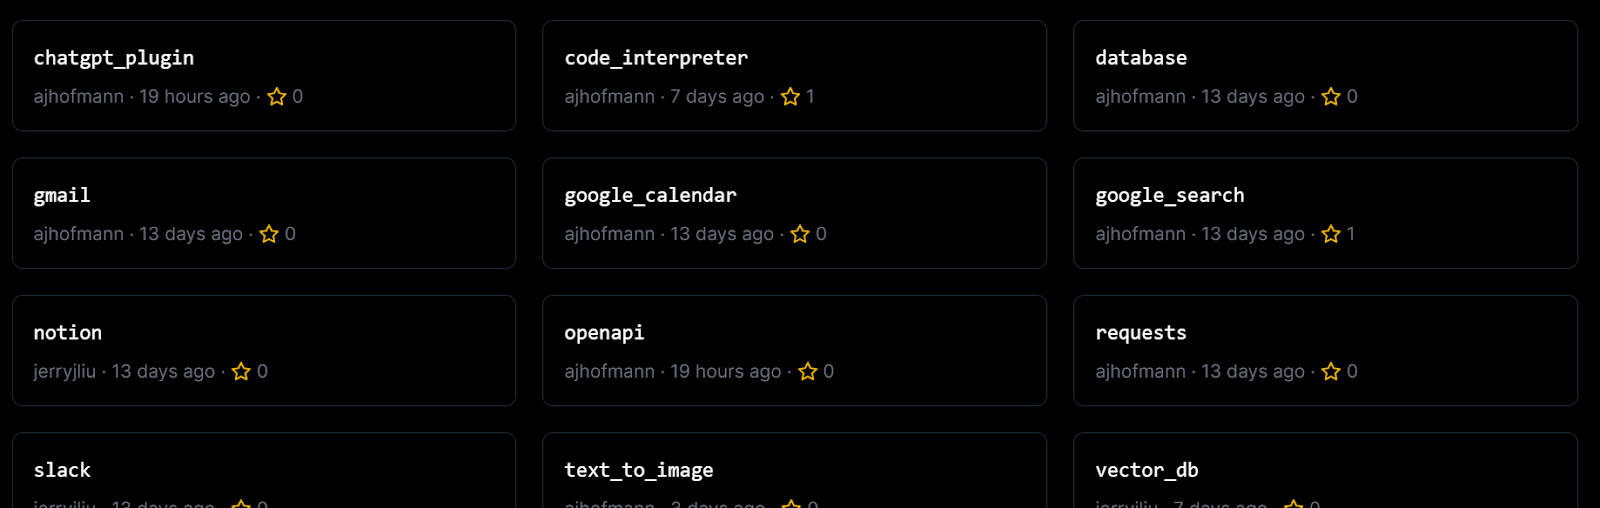
Agent Tools aus dem Llama Hub
Kurz gesagt, mit LlamaIndex kannst du Folgendes bauen:
- Q&A über Dokumente
- Chatbots
- Agents
- Strukturierte Daten
- Vollständige Webanwendungen
- Private Setups
Details zu diesen Use Cases findest du in der LlamaIndex-Dokumentation.
Fazit
LlamaIndex bietet einen leistungsstarken Werkzeugkasten für Retrieval-Augmented-Generation-Systeme, die die Stärken großer Sprachmodelle mit individuellen Wissensbasen verbinden. Du kannst domänenspezifische Daten indexieren und sie bei der Inferenz als kontextgebende Grundlage für das LLM nutzen, um hochwertige Antworten zu erzeugen.
In diesem Tutorial haben wir LlamaIndex und seine Funktionsweise kennengelernt. Außerdem haben wir einen Lebenslauf-Reader sowie ein Text-zu-Sprache-Projekt mit nur wenigen Zeilen Python-Code umgesetzt. Das Bauen von LLM-Anwendungen mit LlamaIndex ist unkompliziert und bietet eine große Bibliothek an Plugins, Data Loadern und Agents.
Wenn du ein echter LLM-Profi werden willst, ist der nächste Schritt der Kurs Master Large Language Models Concepts. Er vermittelt dir ein umfassendes Verständnis von LLMs – von Einsatzszenarien über Trainingsmethoden und ethische Fragen bis hin zu aktuellen Forschungsergebnissen.