

开始使用 o1-preview 和 o1-mini
有许多便捷可用的 o1 模型,但官方途径要么通过 OpenAI API,要么使用 ChatGPT Plus 或 Team 订阅。
本节我们将学习如何用它们来解决复杂问题。
访问 o1 模型
如果您熟悉用于聊天补全的 OpenAI API,只需将模型名设为 "o1-preview" 并提供一个详细的提示即可。就是这么简单。
from openai import OpenAI
client = OpenAI()
response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Create an SQL database from scratch, including guides on usage and code everything in Python."
}
]
)
print(response.choices[0].message.content)在 ChatGPT 中访问它时,点击模型选择下拉菜单并选择“o1-preview”模型,如下所示。
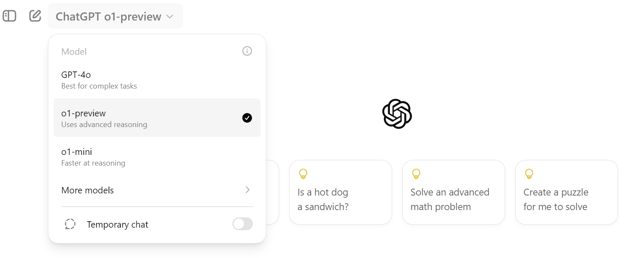
在 ChatGPT 中使用 o1-preview 模型
o1 模型的提示有所不同。您需要提供多条指令或详细问题,才能充分发挥其能力。它可以处理冗长复杂的指令并生成最优答案。
在欧洲为自由职业业务计算税款可能很复杂。我们将使用 o1 模型来确定我们对西班牙政府的纳税义务。
提示: “我是在西班牙为一家美国公司工作的自由职业者。过去一年我赚了 120,000 美元,需要计算我应缴纳的税额。请考虑到我是在 8 个月前搬到西班牙的。”
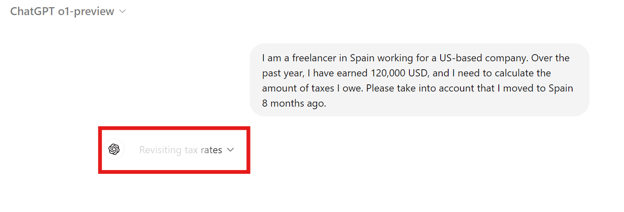
它用了将近 30 秒才回复,但内容非常详细。包括数学计算、税务信息,以及确定我们欠西班牙政府多少税所需的全部细节。
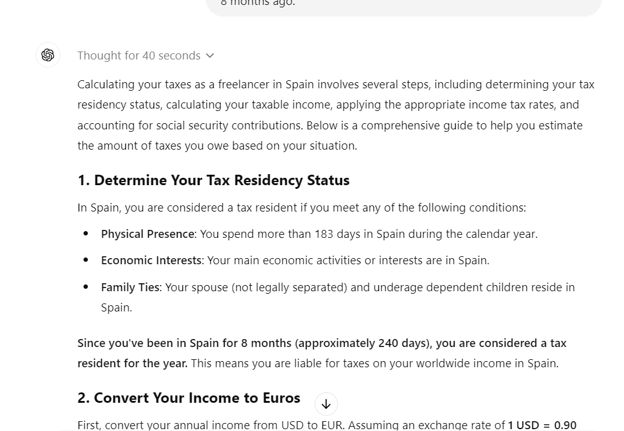
回复分为以下部分:
- 确定您的税务居民身份
- 将收入折算为欧元
- 计算应纳税所得额
- 计算社会保险缴费
- 预计应缴税款总额
- 重要说明
- 后续步骤
查看摘要部分可以得出我们大致应缴税额,这非常有帮助。
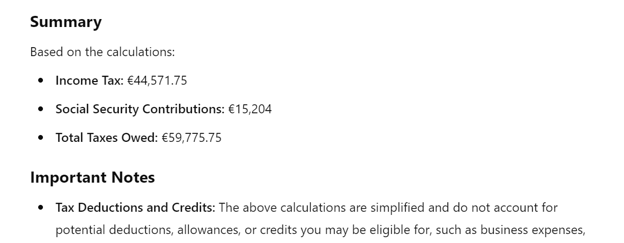
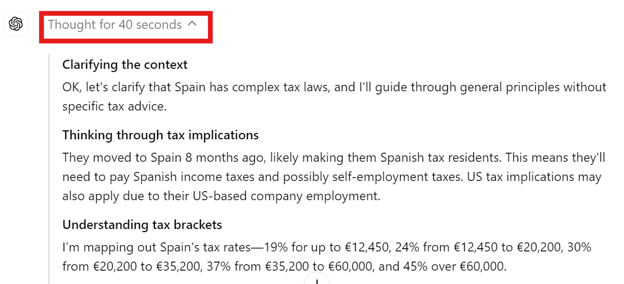
您可以点击聊天回复中的下拉菜单来查看其思维链和决策过程。
我们可以看到,模型在作答前理解了上下文、税务影响和税率区间。
在 ChatGPT 中使用 o1-mini 模型
o1-mini 模型的准确性略逊于 o1-preview,但速度更快。在我们的示例中,我们将使用该模型为数据科学简历创建一个静态网站。
提示: “请使用一个 Python 框架为我的数据科学简历创建一个静态网站。”
它不仅创建了一个规范的简历网站,还提供了如何免费发布到 GitHub Pages 的指导。
回复分为以下部分:
- Pelican 简介
- 先决条件
- 设置 Pelican
- 选择主题
- 创建您的简历内容
- 构建站点
- 使用 Makefile 实现自动化
- 部署您的简历网站
- 增强您的简历网站
- 更多资源
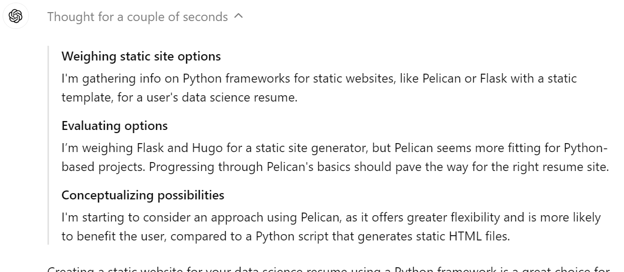
在回复中显示思维链是一个很棒的功能。我们可以清楚地看到模型在权衡使用 Pelican、Flask 或 Hugo 作为 Web 框架,最终选出了最佳方案。
OpenAI o1-preview 教程:构建水质分类应用
在本项目中,我们将使用 o1-preview 模型来构建并部署一个水质分类应用。这个项目相当复杂,因为我们会向其提供详细的需求描述。
如果您对使用 ChatGPT 构建数据科学项目感兴趣,请查看使用 ChatGPT 进行数据科学项目指南。您将学习如何用 ChatGPT 进行项目规划、数据分析、数据预处理、模型选择、超参数调优、Web 应用开发与部署。
1. 提示工程
我们会在提示工程上投入更多时间,以确保将所有项目指令完整提供给模型。
提示分为三部分:
- 项目描述: 详细解释项目要做什么、要构建什么。
- 目标与限制: 提供目标信息,例如力争达到 90% 的准确率。
- 执行步骤: 提供您希望其执行的全部必要步骤。例如,使用 Kaggle API 进行数据摄取、将指标保存到文件夹、进行数据分析、训练与评估模型等。尽可能写得详尽。
阅读ChatGPT 提示工程新手指南,了解如何在 ChatGPT 中编写合适的提示以生成所需结果。提示工程是一门艺术,随着 o1 模型的推出,更值得学习。
提示: “我的项目经理要求我们使用 Kaggle 上的数据集 https://www.kaggle.com/datasets/adityakadiwal/water-potability 开发一个水质应用。请提供所有必要的文件、Python 包和代码信息,以便我们构建一个高精度模型。
目标是达到 90% 的总体准确率。
请按照以下步骤构建项目:
1. 使用 Kaggle API 加载数据集,并在 data 文件夹中解压。
2. 进行数据预处理和数据分析。将分析图表和文件保存在 metrics 文件夹中。
3. 使用 scikit-learn 框架训练模型。确保跟踪实验并保存模型文件和元数据。使用 skops 库保存模型。
4. 执行详细的模型评估并保存结果。
5. 创建一个 FastAPI 应用,从用户处接收图像并预测水质。
6. 使用 Jinja2 模板添加用户界面。
7. 使用 Docker 选项将应用部署到 Hugging Face Hub。”
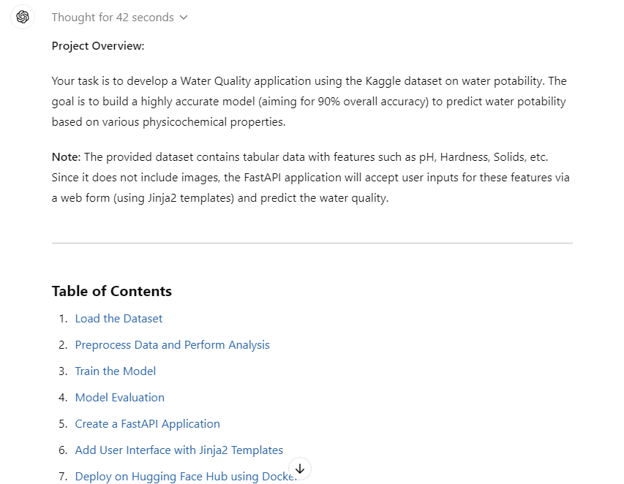
生成的回复为我们提供了加载数据、预处理、训练与评估模型、创建 FastAPI 应用、搭建用户界面和部署的全部信息。
问题在于内容较为碎片化,我们希望它为我们创建 Python 和 HTML 文件,方便直接复制粘贴代码。
接下来我们将把所有代码转换为 Python 和 HTML 文件,让工作更为轻松。
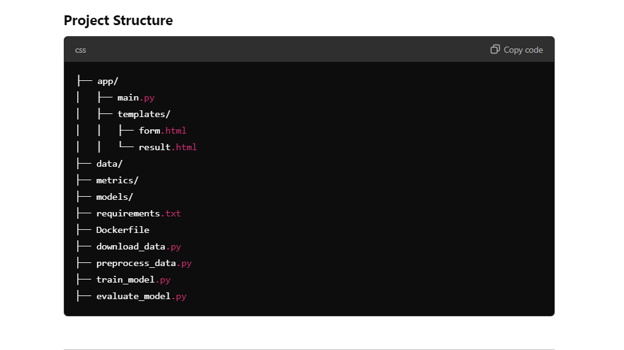
追问提示: “请将代码转换为 Python 文件。”
如我们所见,已生成包含所有文件和代码的项目结构。我们只需创建相应的文件夹和文件,然后复制粘贴代码即可。
2. 环境搭建
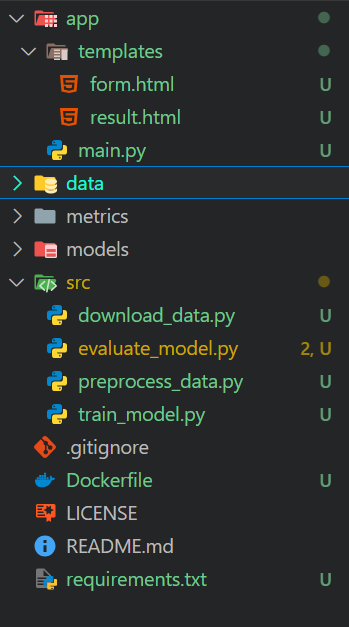
o1 模型提供了搭建项目目录所需的全部信息。我们只需在项目目录中用代码编辑器创建文件夹和文件。
我们将创建以下文件夹:
- app:包含 FastAPI 的应用文件和 HTML 模板。
- data:包含原始数据和预处理数据。
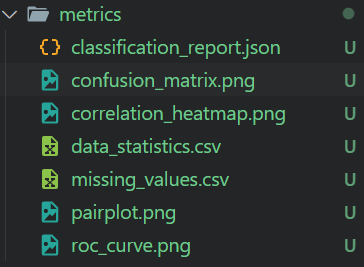
- metrics:包含模型评估数据和数据分析结果。
- models:包含已保存的模型和缩放器对象。
- src:包含用于加载、处理、训练和评估的所有 Python 文件。
此外,主目录还将包含 Dockerfile、README 和 requirements.txt 文件。
3. 加载数据集
我们将使用 Kaggle API 加载Water Quality Kaggle 数据集,并将其解压到 data 文件夹。
data\download_data.py:
import os
# Ensure the data directory exists
os.makedirs("data", exist_ok=True)
# Download the dataset
os.system("kaggle datasets download -d adityakadiwal/water-potability -p data --unzip")运行该 Python 文件将下载数据集、解压并移除压缩文件。
$ python .\src\download_data.py
Dataset URL: https://www.kaggle.com/datasets/adityakadiwal/water-potability
License(s): CC0-1.0
Downloading water-potability.zip to data
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 304kB/s]
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 303kB/s]4. 预处理与数据分析
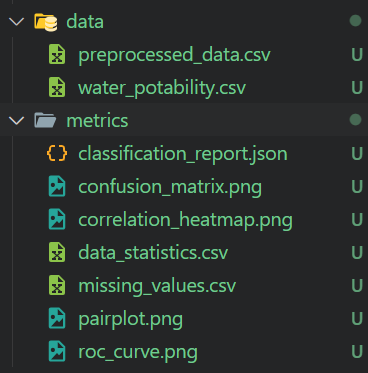
预处理脚本将加载数据、清洗、处理缺失值、进行特征缩放,并保存缩放器与预处理后的数据集。同时还会进行数据分析,并保存指标与可视化图表。
data\preprocess_data.py:
import os
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
import joblib
# Create directories if they don't exist
os.makedirs("metrics", exist_ok=True)
os.makedirs("models", exist_ok=True)
# Load the dataset
data = pd.read_csv("data/water_potability.csv")
# Check for missing values and save the summary
missing_values = data.isnull().sum()
missing_values.to_csv("metrics/missing_values.csv")
# Statistical summary
stats = data.describe()
stats.to_csv("metrics/data_statistics.csv")
# Pair plot
sns.pairplot(data, hue="Potability")
plt.savefig("metrics/pairplot.png")
# Correlation heatmap
plt.figure(figsize=(10, 8))
sns.heatmap(data.corr(), annot=True)
plt.savefig("metrics/correlation_heatmap.png")
# Handle missing values
imputer = SimpleImputer(strategy="mean")
data_imputed = pd.DataFrame(imputer.fit_transform(data), columns=data.columns)
# Feature scaling
scaler = StandardScaler()
features = data_imputed.drop("Potability", axis=1)
target = data_imputed["Potability"]
features_scaled = scaler.fit_transform(features)
# Save the scaler
joblib.dump(scaler, "models/scaler.joblib")
# Save preprocessed data
preprocessed_data = pd.DataFrame(features_scaled, columns=features.columns)
preprocessed_data["Potability"] = target
preprocessed_data.to_csv("metrics/preprocessed_data.csv", index=False)$ python .\src\preprocess_data.py 我们得到了预处理数据以及所有带图的分析报告。
5. 模型构建与训练
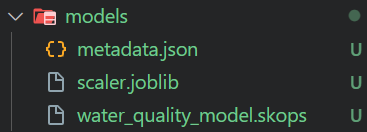
训练脚本会加载预处理数据,使用其训练一个随机森林分类器。随后使用 Skope 保存模型,手动跟踪实验,并以 JSON 文件形式保存模型元数据。
src\train_model.py:
import os
import json
import skops.io as sio
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]
# Split the data
X_train, X_test, y_train, y_test = train_test_split(
features, target, test_size=0.2, random_state=42, stratify=target
)
# Train the model
model = RandomForestClassifier(n_estimators=200, random_state=42)
model.fit(X_train, y_train)
# Save the model using skops
os.makedirs("models", exist_ok=True)
sio.dump(model, "models/water_quality_model.skops")
# Track experiments and save metadata
metadata = {
"model_name": "RandomForestClassifier",
"parameters": model.get_params(),
"training_score": model.score(X_train, y_train),
}
with open("models/metadata.json", "w") as f:
json.dump(metadata, f, indent=4)$ python .\src\train_model.py 训练脚本将生成一个模型文件和元数据,如下所示。
6. 模型评估
模型评估脚本会加载处理后的数据和已保存的模型,生成分类报告、混淆矩阵、ROC 曲线、AUC 和总体准确率。所有指标与图表均保存在 metrics 文件夹中。
src\evaluate_model.py :
import os
import json
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.metrics import (
classification_report,
confusion_matrix,
roc_auc_score,
roc_curve,
)
import skops.io as sio
from sklearn.model_selection import train_test_split
# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]
# Split the data
X_train, X_test, y_train, y_test = train_test_split(
features, target, test_size=0.2, random_state=42, stratify=target
)
# Load the model
model = sio.load("models/water_quality_model.skops")
# Predictions
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test)[:, 1]
# Classification report
report = classification_report(y_test, y_pred, output_dict=True)
with open("metrics/classification_report.json", "w") as f:
json.dump(report, f, indent=4)
# Confusion matrix
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d")
plt.title("Confusion Matrix")
plt.ylabel("Actual Label")
plt.xlabel("Predicted Label")
plt.savefig("metrics/confusion_matrix.png")
# ROC curve and AUC
fpr, tpr, _ = roc_curve(y_test, y_pred_proba)
roc_auc = roc_auc_score(y_test, y_pred_proba)
plt.figure()
plt.plot(fpr, tpr, label="AUC = %0.2f" % roc_auc)
plt.plot([0, 1], [0, 1], "k--")
plt.legend(loc="lower right")
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("Receiver Operating Characteristic")
plt.savefig("metrics/roc_curve.png")
# Overall accuracy
accuracy = model.score(X_test, y_test)
print(f"Overall Accuracy: {accuracy * 100:.2f}%")$ python .\src\evaluate_model.py 总体准确率不算理想。不过,我们随时可以让 o1 模型来提升准确率。
Overall Accuracy: 65.55%metrics 文件夹包含所有已保存的模型评估图表和指标。我们可以手动查看,以更细致地理解模型表现。
7. 创建 FastAPI 应用
要为 FastAPI 应用创建用户界面,我们需要创建首页和结果页。在 app 目录内创建 template 文件夹,并添加两个 HTML 文件:一个用于主页面,一个用于结果页面。
查看FastAPI 教程:FastAPI 入门,详细了解 FastAPI 框架以及如何在项目中使用它。
如果您不熟悉 HTML,不必担心。只需复制粘贴代码,并相信 o1 模型即可。
app\templates\form.html:
<!DOCTYPE html>
<html>
<head>
<title>Water Quality Prediction</title>
</head>
<body>
<h2>Enter Water Parameters</h2>
<form action="/predict" method="post">
{% for feature in ['ph', 'Hardness', 'Solids', 'Chloramines', 'Sulfate', 'Conductivity', 'Organic_carbon', 'Trihalomethanes', 'Turbidity'] %}
<label for="{{ feature }}">{{ feature.replace('_', ' ').title() }}:</label><br>
<input type="number" step="any" id="{{ feature }}" name="{{ feature }}" required><br><br>
{% endfor %}
<input type="submit" value="Predict">
</form>
</body>
</html>app\templates\result.html:
<!DOCTYPE html>
<html>
<head>
<title>Prediction Result</title>
</head>
<body>
<h2>Prediction Result</h2>
<p>The water is predicted to be: <strong>{{ result }}</strong></p>
<a href="/">Try Again</a>
</body>
</html>主应用的 Python 文件包含两个函数:home 和 predict。“home”函数显示包含输入框和按钮的欢迎页;“predict”函数对用户输入做转换、送入模型,并显示水是否可饮用的结果。
app\templates\main.py:
from fastapi import FastAPI, Request, Form
from fastapi.responses import HTMLResponse
from fastapi.templating import Jinja2Templates
import numpy as np
import skops.io as sio
import joblib
app = FastAPI()
templates = Jinja2Templates(directory="app/templates")
# Load the saved model and preprocessing pipeline
model = sio.load("models/water_quality_model.skops", trusted=True)
preprocessing_pipeline = joblib.load("models/preprocessing_pipeline.joblib")
@app.get("/", response_class=HTMLResponse)
async def home(request: Request):
return templates.TemplateResponse("form.html", {"request": request})
@app.post("/predict", response_class=HTMLResponse)
async def predict(
request: Request,
ph: float = Form(...),
Hardness: float = Form(...),
Solids: float = Form(...),
Chloramines: float = Form(...),
Sulfate: float = Form(...),
Conductivity: float = Form(...),
Organic_carbon: float = Form(...),
Trihalomethanes: float = Form(...),
Turbidity: float = Form(...),
):
input_data = np.array(
[
[
ph,
Hardness,
Solids,
Chloramines,
Sulfate,
Conductivity,
Organic_carbon,
Trihalomethanes,
Turbidity,
]
]
)
# Preprocess input data
input_preprocessed = preprocessing_pipeline.transform(input_data)
prediction = model.predict(input_preprocessed)
result = "Potable" if prediction[0] == 1 else "Not Potable"
return templates.TemplateResponse(
"result.html", {"request": request, "result": result}
)我们将先在本地测试应用,以验证其是否运行正常。
$ uvicorn app.main:app --reload 通过使用 uvicorn 运行 Python 文件,我们可以获得本地地址并复制到浏览器中访问。
注意: 关于如何运行这些文件的信息也由 o1 模型提供。
INFO: Will watch for changes in these directories: ['C:\\Repository\\GitHub\\Water-Quality-App']
INFO: Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
INFO: Started reloader process [34792] using StatReload如我们所见,应用运行良好。
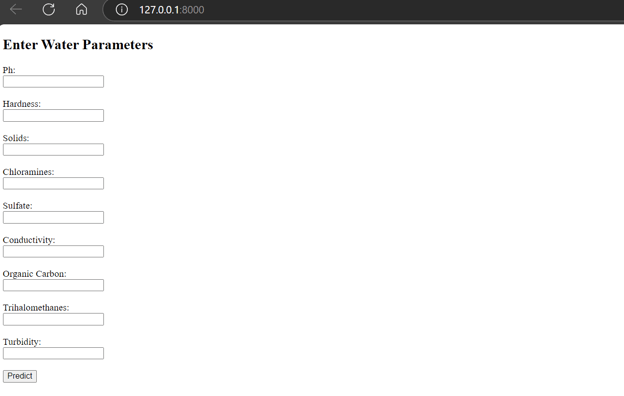
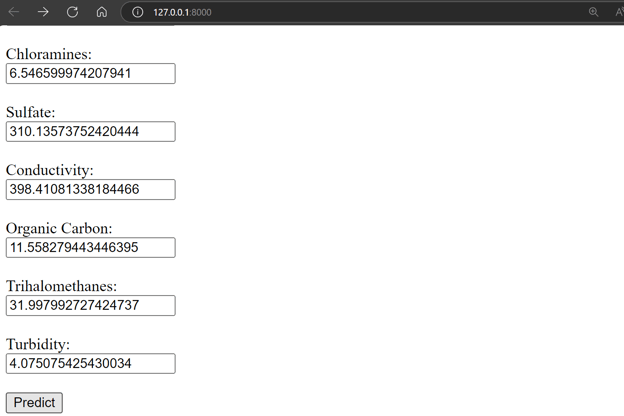
接着我们输入随机值来检查水质,并点击预测按钮。
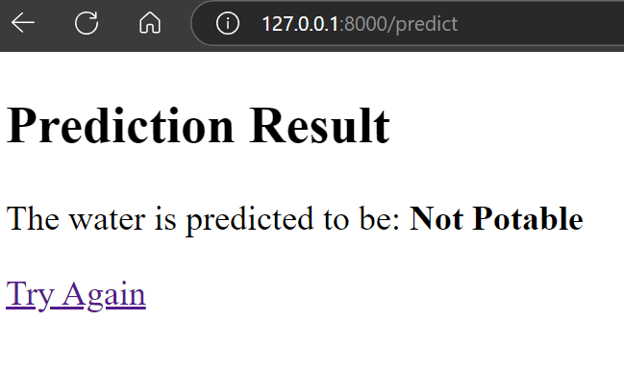
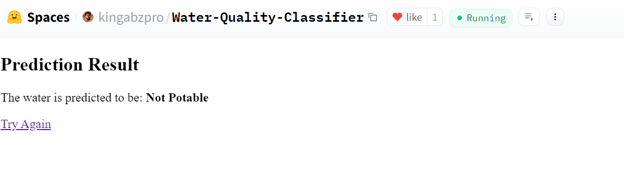
结果非常直观:提示该水不可饮用。
您还可以在 URL 后输入“/docs”访问 FastAPI Swagger UI,测试 API 并生成结果。
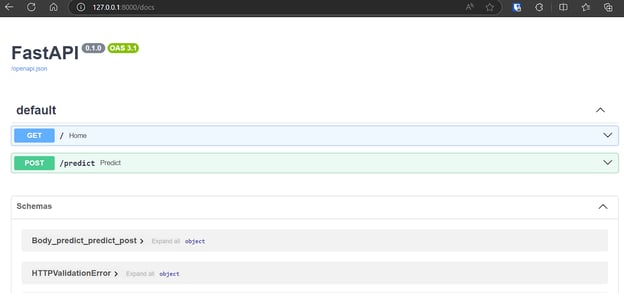
8. 使用 Docker 在 Hugging Face Hub 部署应用
OpenAI o1 模型已为我们生成了 Docker 代码、指南和参考链接,助我们顺利学习如何在 Hugging Face 上部署应用。
阅读面向数据科学的 Docker:入门教程,了解 Docker 的工作原理。您将学习如何安装 Docker、使用 Docker 命令、将机器学习应用容器化,以及遵循行业最佳实践。
首先,在 Hugging Face 网站点击个人头像,再点击“New Space”按钮。输入应用名称,选择 SDK 类型(Docker),选择许可证类型并点击“Create Space”。
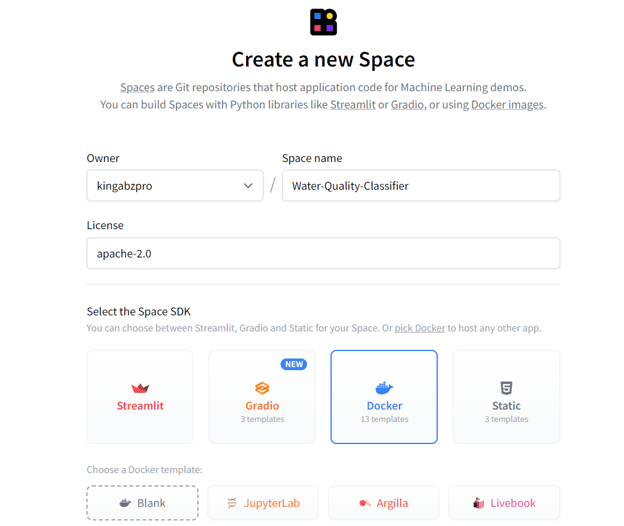
来源:Hugging Face
主页面上提供了使用 Docker 部署应用的全部说明。
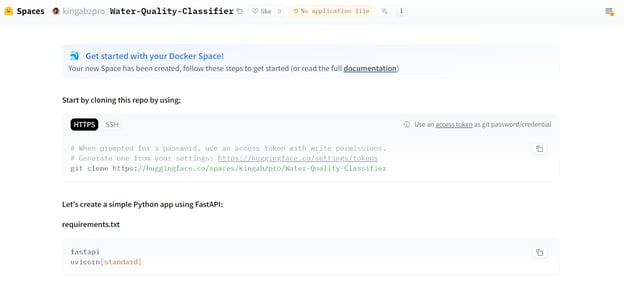
接下来,我们需要克隆该仓库。
git clone https://huggingface.co/spaces/kingabzpro/Water-Quality-Classifier在仓库中移动 app 和 model 文件夹。创建 Dockerfile 并输入以下命令。o1 模型已为我们提供代码,我们只需将端口号改为 7860。
Dockerfile:
# Use an official Python runtime as a parent image
FROM python:3.9-slim
# Set the working directory
WORKDIR /app
# Copy the current directory contents into the container at /app
COPY . /app
# Install any needed packages specified in requirements.txt
RUN pip install --no-cache-dir -r requirements.txt
# Expose port 7860
EXPOSE 7860
# Run the application
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "7860"]创建 requirements.txt 文件,包含所需 Python 包的信息。我们将用它在云服务器上下载并安装所有必需的 Python 包。
requirements.txt:
fastapi
uvicorn
jinja2
pydantic
skops
joblib
numpy
pandas
scikit-learn==1.5.1
matplotlib
seaborn
kaggle
imbalanced-learn
python-multipart我们的应用仓库应如下所示:
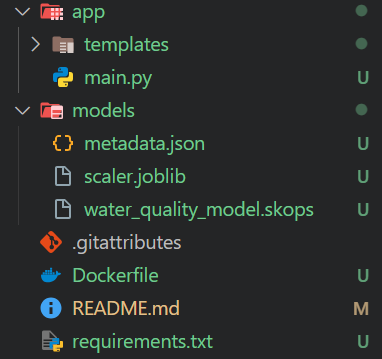
我们的模型文件较大(> 10MB),因此需要使用 Git LFS 跟踪它。安装 Git LFS,并跟踪所有以“.skops”结尾的文件。
git lfs install
git lfs track "*.skops" 将所有更改暂存、提交,并推送到远程服务器。
git add .
git commit -m "pushing all the files"
git push前往您在 Hugging Face 上的应用页面,您会看到它正在构建容器并安装所有必要的包。
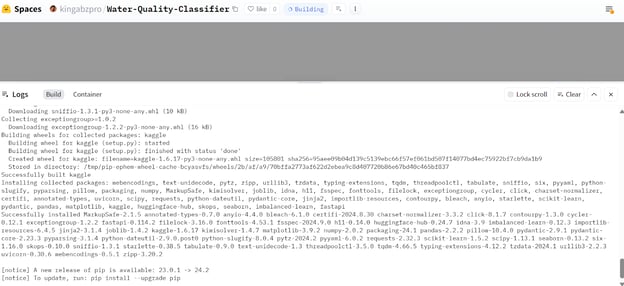
几分钟后,应用即可使用。其界面与本地应用相同。让我们试着输入示例值并生成结果。
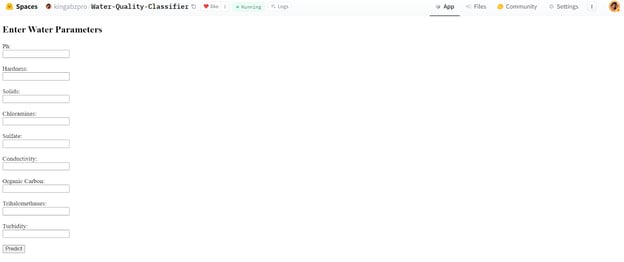
我们的应用运行正常,并给出了预期结果。
该 Hugging Face Space 应用对所有人开放,这意味着我们可以在终端中使用 curl 命令进行访问。
curl -X 'POST' \
'https://kingabzpro-water-quality-classifier.hf.space/predict' \
-H 'accept: text/html' \
-H 'Content-Type: application/x-www-form-urlencoded' \
-d 'Organic_carbon=10&Hardness=200&Turbidity=4&Solids=10000&Chloramines=7&Trihalomethanes=80&Sulfate=300&ph=7&Conductivity=400' \
| grep -oP '(?<=<strong>).*(?=</strong>)'输出:
Not Potable所有项目文件、数据、模型和元数据均可在kingabzpro/Water-Quality-App GitHub 仓库中获取。
作者观点
o1-preview 模型远胜于 GPT-4o。它能完美遵循指令且几乎无 Bug,生成的代码可直接使用。在构建该机器学习应用时,我只做了大约 5% 的小改动。最棒的是,我还能从 AI 模型的决策中学习,理解它为何做出某些选择。
结语
在本教程中,我们看到了 OpenAI 的 o1 推理模型有多强大。我们只对代码做了少量修改,就构建出了一个完整的机器学习项目,并能立即运行。模型对每条指令的处理都很到位,无需额外追问便产出了很好的结果。
目前我们能够使用 o1 的小型版本,如 o1-preview 和 o1-mini。未来我们将能使用完整的 o1 模型,它在构建复杂项目时会更胜一筹。关键在于学会提出恰当的问题,以充分释放模型的能力。
用 AI 模型构建机器学习项目并不难,但如果您想把它做成职业,必须理解这些模型的工作机制。否则,在排查问题或将模型用于特定业务需求时会很吃力。为建立这种理解,我们建议初学者学习Machine Learning Scientist with Python 职业路径。它包含 21 门课程和 3 个项目,教您如何构建并改进不同类型的机器学习模型。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
在本教程中,我们将从零开始创建一个水质分类应用,并使用 Docker 将其部署到云端。
我们将先探索 OpenAI o1 模型并了解其功能。随后将通过 API 和 ChatGPT 访问模型,分别尝试 o1-preview 和 o1-mini 版本,然后基于此开发有效的提示来构建水质分类应用。
拿到输出后,我们会把 o1 模型提供的代码和文件加入项目文件夹,然后在本地执行 Python 代码进行数据加载、预处理、训练和评估。最后,我们将构建一个 FastAPI 应用并使用 Docker 在 Hugging Face 上部署。
如果您刚接触 AI,AI Fundamentals 技能路径是很好的起点。它将帮助您了解 ChatGPT 和大语言模型等热门 AI 主题。
图片来自作者
什么是 OpenAI 的 o1 推理模型?
OpenAI 已发布 o1 模型,这是一种旨在执行类人推理任务的新型 AI,包括解决多步问题、复杂数学方程和编程问题。
在回答困难问题之前,o1 会采用思维链方式来尝试解决问题。通过强化学习,o1 会打磨其思维链并优化策略,学会识别并纠正错误。
o1 模型提供两个变体:o1-preview 和 o1-mini。
o1-preview 适用于需要深度推理的问题,而 o1-mini 更快,适合编程和数学问题。两种模型均向 ChatGPT Plus 和 Team 用户开放。若您是第 5 层级组织,也可通过 OpenAI API 访问。
当前版本尚不具备网页浏览、文件上传和 Python REPL 等功能,OpenAI 计划在后续更新中加入。
来源:Learning to Reason with LLMs | OpenAI
如图所示,o1-preview 和 o1 模型正在树立新标杆。它们在数学和编程竞赛中表现出色,甚至能够应对博士生级别的科学问题。
阅读OpenAI o1 指南:工作原理、用例、API 等,深入了解其工作方式及基准测试。