
Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
In diesem Tutorial bauen wir eine Anwendung zur Klassifizierung der Wasserqualität von Grund auf und deployen sie mit Docker in der Cloud.
Wir starten mit einer Erkundung des OpenAI o1-Modells und seines Funktionsumfangs. Anschließend greifen wir per API und ChatGPT auf das Modell zu, testen sowohl o1-preview als auch o1-mini und entwickeln danach wirksame Prompts, um eine Anwendung zur Wasserqualitätsklassifizierung zu erstellen.
Sobald wir die Ausgabe haben, fügen wir den vom o1-Modell bereitgestellten Code und die Dateien in den Projektordner ein und laden, verarbeiten, trainieren und evaluieren die Daten, indem wir Python-Code lokal ausführen. Zum Schluss bauen wir eine FastAPI-Anwendung und deployen sie mit Docker auf Hugging Face.
Wenn du neu in der KI bist, ist der AI Fundamentals Lernpfad ein idealer Einstieg. Du lernst populäre KI-Themen wie ChatGPT und große Sprachmodelle kennen.
Bild: Autor
OpenAI hat das o1-Modell vorgestellt – eine neue KI für menschenähnliches Schlussfolgern, etwa bei mehrstufigen Aufgaben, komplexen Matheaufgaben und Coding-Fragen.
Bevor o1 auf eine schwierige Frage antwortet, nutzt es eine Chain of Thought, um ein Problem zu lösen. Durch Bestärkendes Lernen verfeinert o1 seine Gedankenkette und die angewandten Strategien. Es lernt, Fehler zu erkennen und zu korrigieren.
Das o1-Modell gibt es in zwei Varianten: o1-preview und o1-mini.
o1-preview ist für tiefes Reasoning gedacht, o1-mini ist schneller und ideal für Coding- und Matheaufgaben. Beide Modelle sind für ChatGPT Plus- und Team-Nutzer verfügbar. Organisationen in Tier 5 können zudem über die OpenAI API darauf zugreifen.
Die aktuelle Version unterstützt noch kein Web-Browsing, keinen Datei-Upload und keine Python-REPL. OpenAI plant, diese Funktionen in künftigen Updates nachzureichen.
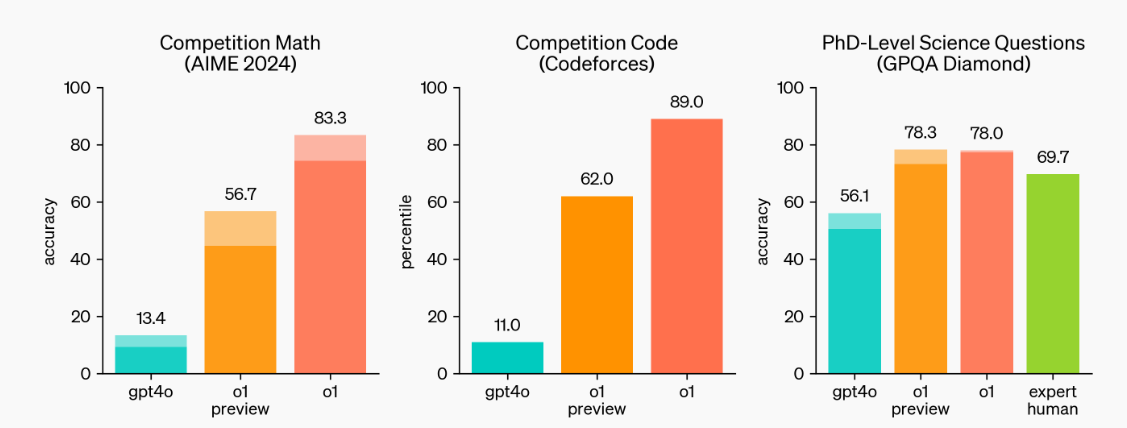
Quelle: Learning to Reason with LLMs | OpenAI
Wie wir sehen, setzen o1-preview und o1 neue Maßstäbe. Sie glänzen in Mathe- und Programmierwettbewerben und meistern wissenschaftliche Fragen auf PhD-Niveau.
Lies den OpenAI o1 Guide: How It Works, Use Cases, API & More für eine tiefgehende Analyse, um Funktionsweise und Benchmarks im Detail zu verstehen.
Es gibt viele leicht zugängliche o1-Modelle, die offiziellen Wege führen jedoch über die OpenAI API oder ein ChatGPT Plus- bzw. Team-Abo.
In diesem Abschnitt lernst du, wie du damit komplexe Aufgaben löst.
Wenn du die OpenAI API für Chat Completions kennst, musst du lediglich den Modellnamen auf "o1-preview" setzen und einen detaillierten Prompt bereitstellen. So einfach ist das.
from openai import OpenAI
client = OpenAI()

response = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Create an SQL database from scratch, including guides on usage and code everything in Python."
        }
    ]
)

print(response.choices[0].message.content)
In ChatGPT klickst du im Dropdown zur Modellauswahl und wählst das Modell “o1-preview” aus, wie unten gezeigt.
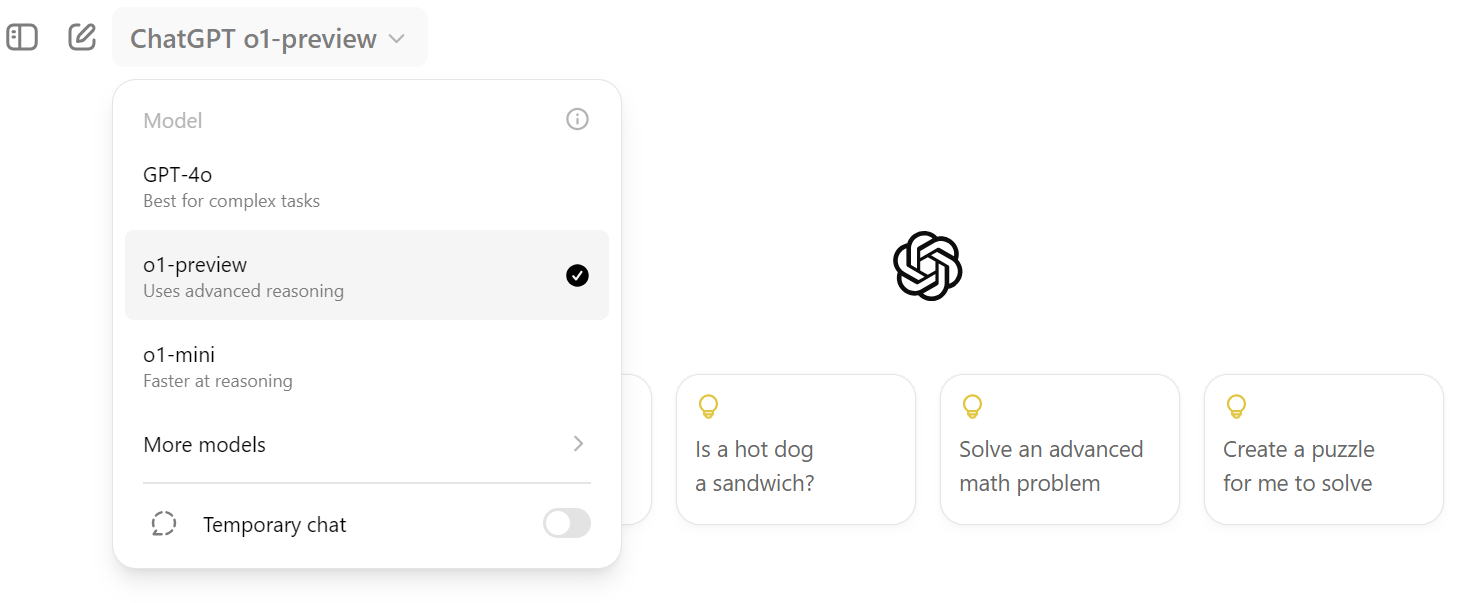
Prompts für das o1-Modell funktionieren etwas anders. Du solltest mehrere Anweisungen oder sehr detaillierte Fragen geben, um das volle Potenzial zu nutzen. Auch lange und komplexe Anweisungen werden verarbeitet, um eine optimale Antwort zu erzeugen.
Die Steuerberechnung für ein Freelance-Business in Europa ist komplex. Wir verwenden das o1-Modell, um unsere Steuerlast in Spanien zu bestimmen.
Prompt: “Ich bin Freelancer in Spanien und arbeite für ein US-Unternehmen. Im letzten Jahr habe ich 120.000 USD verdient und muss berechnen, wie viele Steuern ich schulde. Bitte berücksichtige, dass ich vor 8 Monaten nach Spanien gezogen bin.”
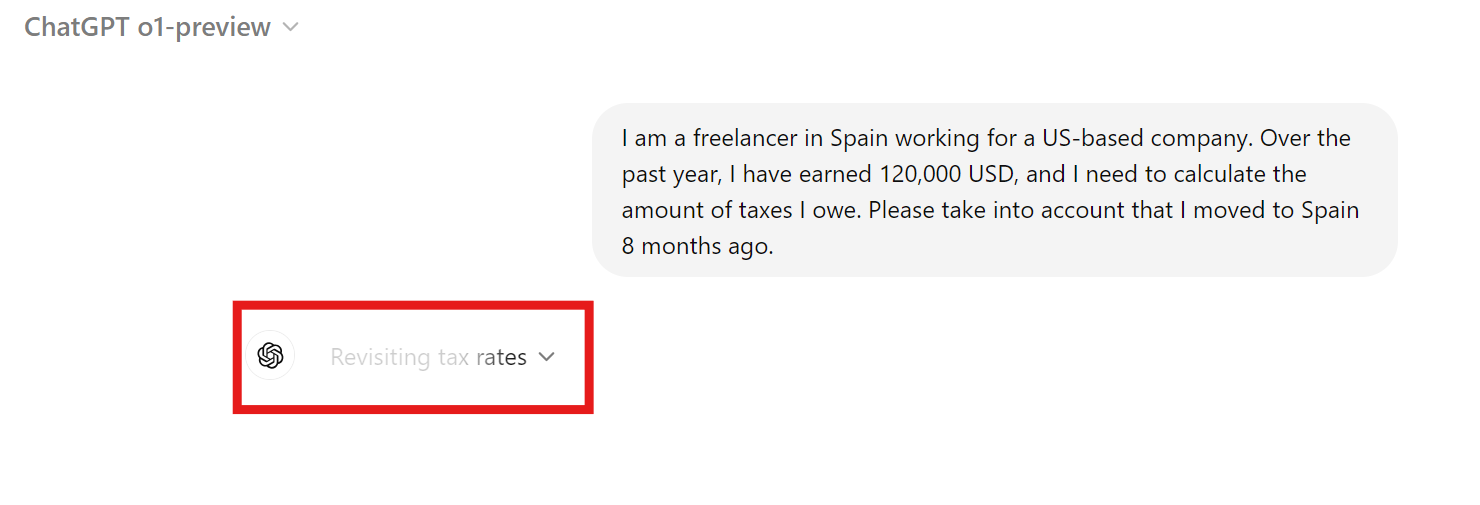
Die Antwort dauerte fast 30 Sekunden, war dafür aber sehr ausführlich. Sie enthielt Rechenschritte, Steuerinfos und alle Details, um die Abgaben an den spanischen Staat zu ermitteln.
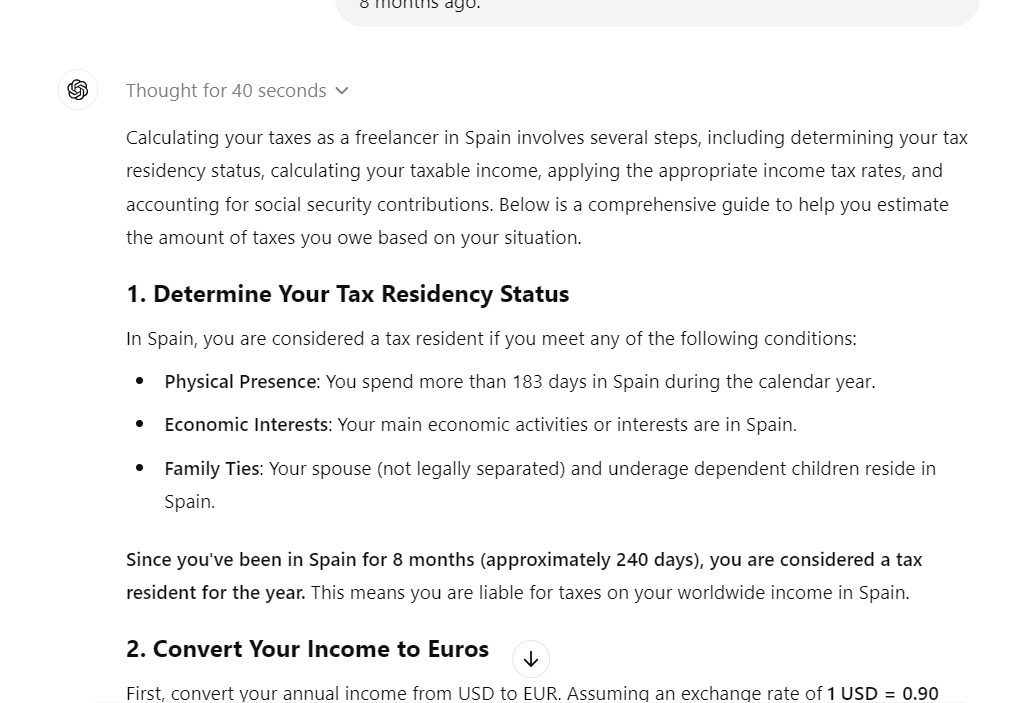
Die Antwort war in folgende Teile gegliedert:
Die Zusammenfassung liefert einen guten Näherungswert für die fälligen Steuern – äußerst hilfreich.
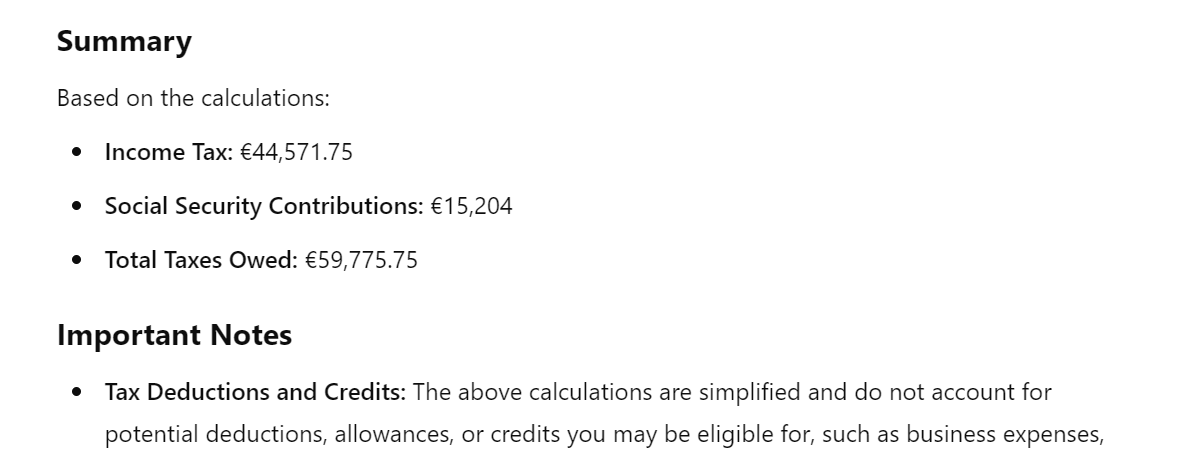
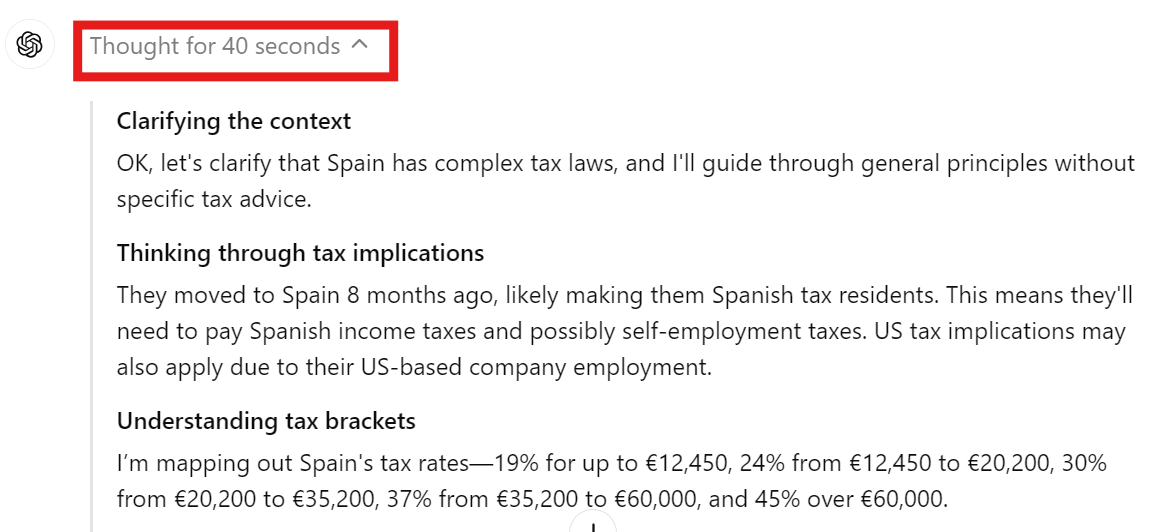
Über das Aufklappmenü in der Chat-Antwort kannst du die Chain of Thought und die Entscheidungsfindung einsehen.
Wir sehen, dass das Modell vor der Antwort Kontext, steuerliche Auswirkungen und Steuersätze versteht.
Das o1-mini-Modell ist weniger präzise, aber schneller als o1-preview. In unserem Fall nutzen wir es, um eine statische Website für Data-Science-Lebensläufe zu erstellen.
Prompt: “Bitte erstelle eine statische Website für meinen Data-Science-Lebenslauf mithilfe eines Python-Frameworks.”
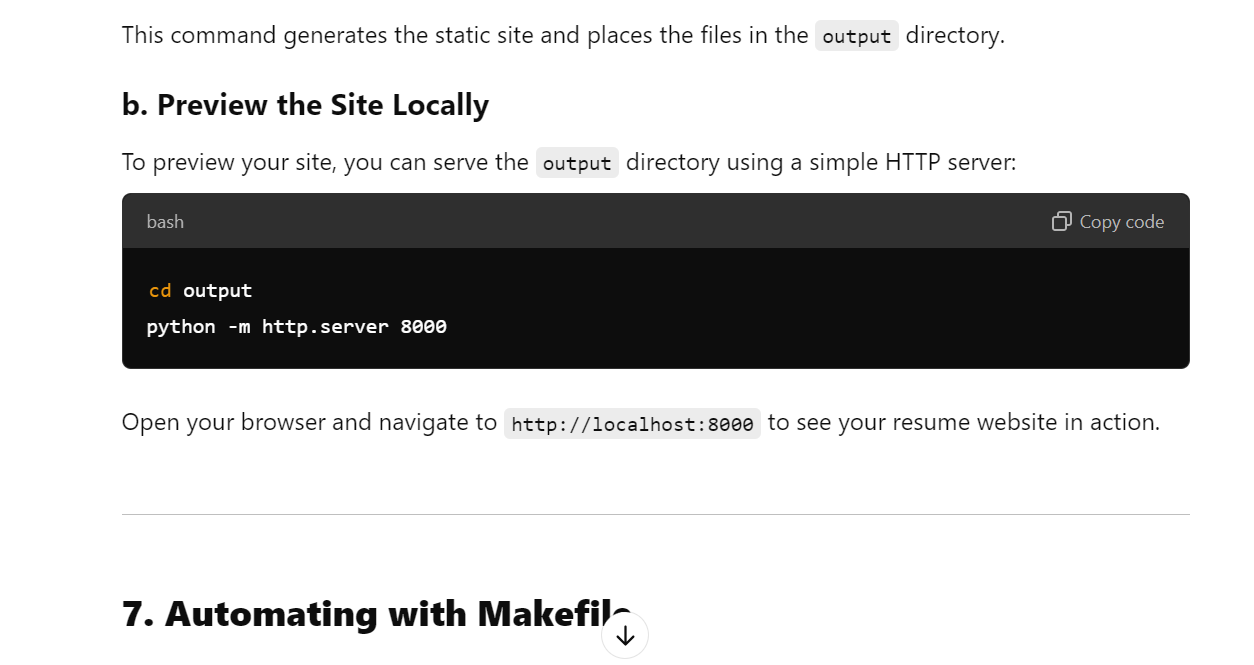
Es hat nicht nur eine saubere Lebenslauf-Website erzeugt, sondern auch erklärt, wie man sie kostenlos auf GitHub Pages veröffentlicht.
Die Antwort war in folgende Teile gegliedert:
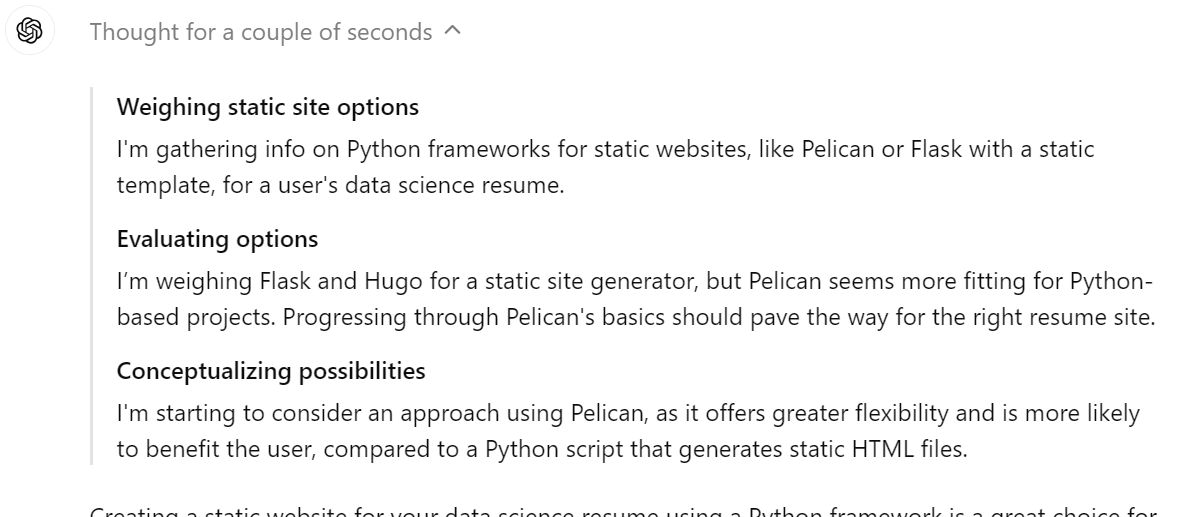
Die Anzeige der Chain of Thought ist großartig. Man sieht klar, dass das Modell Pelican, Flask oder Hugo als Webframework erwägt und am Ende die beste Lösung auswählt.
In diesem Projekt verwenden wir o1-preview, um eine Anwendung zur Wasserqualitätsklassifizierung zu entwickeln und zu deployen. Das Projekt ist recht komplex, da wir eine sehr detaillierte Beschreibung unserer Anforderungen vorgeben.
Wenn du ein Data-Science-Projekt mit ChatGPT bauen willst, sieh dir A Guide to Using ChatGPT for Data Science Projects an. Du lernst, ChatGPT für Projektplanung, Datenanalyse, Datenvorverarbeitung, Modellwahl, Hyperparameter-Tuning, Web-App-Entwicklung und Deployment zu nutzen.
Wir investieren mehr Zeit in Prompt Engineering, damit das Modell alle Projektrichtlinien erhält.
Der Prompt besteht aus drei Teilen:
Lies A Beginner's Guide to ChatGPT Prompt Engineering, um in ChatGPT gute Prompts zu schreiben und die gewünschten Ergebnisse zu erzielen. Prompt Engineering ist eine Kunst – und mit o1 noch wichtiger geworden.
Prompt: “Mein Projektmanager hat uns beauftragt, eine Water Quality-Anwendung mit dem Kaggle-Datensatz unter https://www.kaggle.com/datasets/adityakadiwal/water-potability zu entwickeln. Bitte liefere alle nötigen Informationen zu Dateien, Python-Packages und Code, damit wir ein hochpräzises Modell bauen können.
Ziel ist eine Gesamtgenauigkeit von 90%.
Bitte befolge diese Schritte zum Aufbau des Projekts:
1. Lade den Datensatz per Kaggle API und entpacke ihn in den Datenordner.
2. Preprocess die Daten und führe eine Datenanalyse durch. Speichere Analyse-Grafiken und -Dateien im Ordner metrics.
3. Trainiere das Modell mit scikit-learn. Achte auf Experiment-Tracking und speichere Modelldateien sowie Metadaten. Speichere das Modell mit der skops-Bibliothek.
4. Führe eine detaillierte Modellevaluation durch und speichere die Ergebnisse.
5. Erstelle eine FastAPI-App, die ein Bild vom Nutzenden entgegennimmt und die Wasserqualität vorhersagt.
6. Ergänze ein User Interface mit Jinja2-Templates.
7. Deploye die App auf dem Hugging Face Hub mit der Docker-Option.”
Die generierte Antwort liefert alle Informationen, die wir zum Laden, Vorverarbeiten, Trainieren und Evaluieren, zum Erstellen der FastAPI-App samt UI und zum Deployment benötigen.
Das Problem: Alles ist fragmentiert. Wir wollen, dass direkt Python- und HTML-Dateien entstehen, damit wir nur noch kopieren und einfügen müssen.
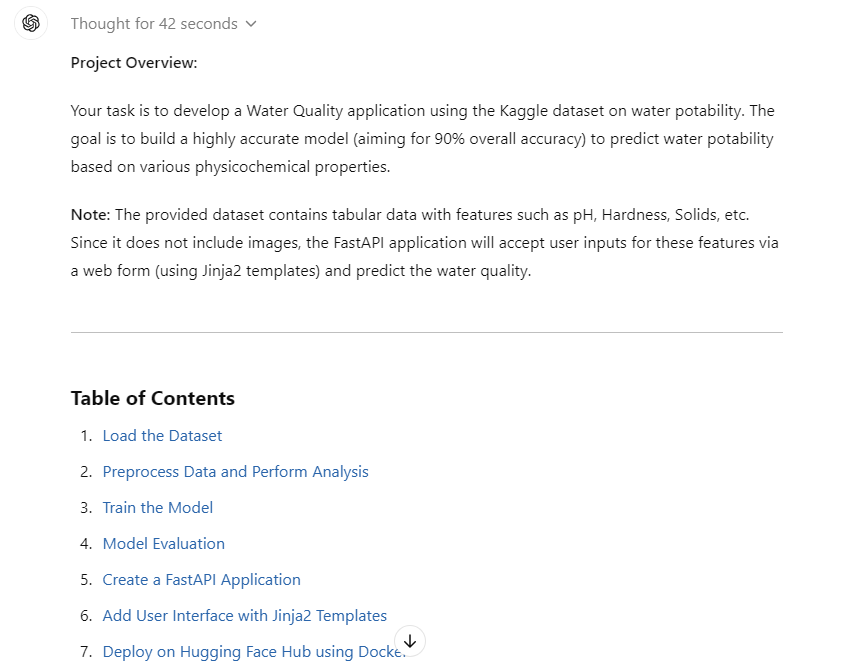
Jetzt wandeln wir den gesamten Code in Python- und HTML-Dateien um – noch einfacher für uns.
Follow-up-Prompt: “Bitte wandle den Code in Python-Dateien um.”
Wie zu sehen, erhalten wir eine Projektstruktur mit allen Dateien und Codes. Wir müssen nur Ordner und Dateien anlegen und den Code einfügen.
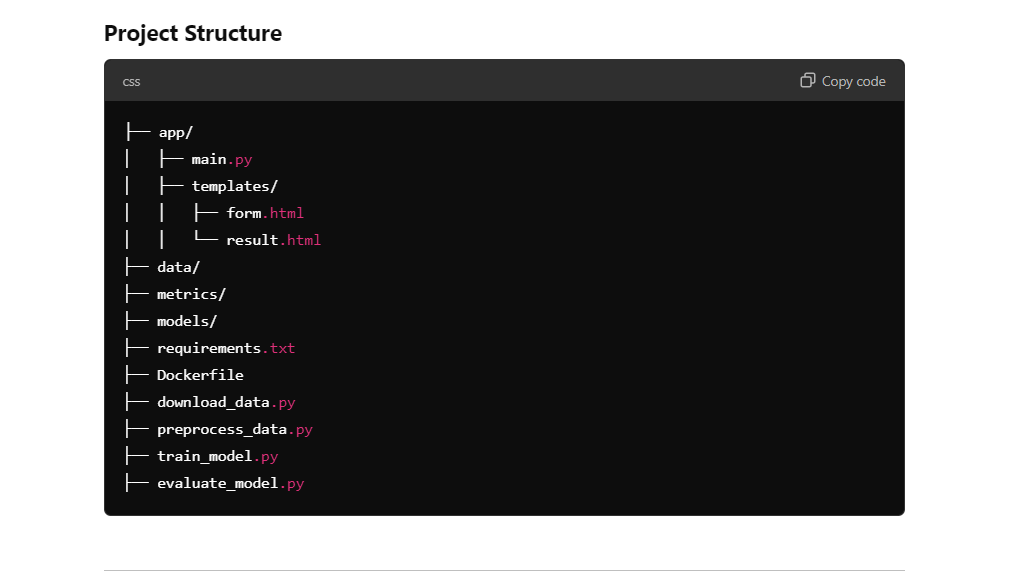
Das o1-Modell liefert alle Infos zum Einrichten des Projektverzeichnisses. Wir erstellen mit dem Code-Editor einfach die Ordner und Dateien im Projektverzeichnis.
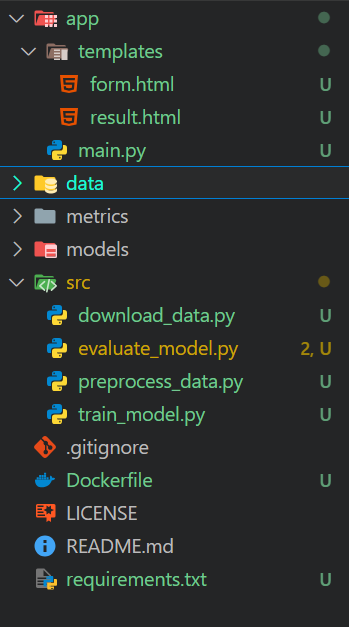
Wir erstellen folgende Ordner:
Im Hauptverzeichnis liegen zusätzlich Dockerfile, README und requirements.txt.
Wir laden den Water Quality-Datensatz von Kaggle über die Kaggle API und entpacken ihn in den Ordner data.
data\download_data.py:
import os

# Ensure the data directory exists
os.makedirs("data", exist_ok=True)

# Download the dataset
os.system("kaggle datasets download -d adityakadiwal/water-potability -p data --unzip")
Beim Ausführen der Python-Datei wird der Datensatz heruntergeladen, entpackt und die ZIP-Datei entfernt.
$ python .\src\download_data.py
Dataset URL: https://www.kaggle.com/datasets/adityakadiwal/water-potability
License(s): CC0-1.0
Downloading water-potability.zip to data
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 304kB/s]
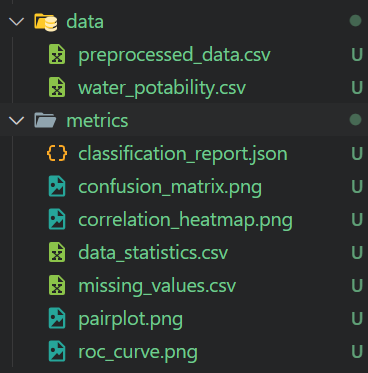
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 303kB/s]Das Preprocessing-Skript lädt die Daten, bereinigt sie, behandelt fehlende Werte, skaliert Features und speichert anschließend den Scaler sowie den vorverarbeiteten Datensatz. Außerdem führt es die Datenanalyse durch und speichert Metriken und Visualisierungen.
data\preprocess_data.py:
import os
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
import joblib

# Create directories if they don't exist
os.makedirs("metrics", exist_ok=True)
os.makedirs("models", exist_ok=True)

# Load the dataset
data = pd.read_csv("data/water_potability.csv")

# Check for missing values and save the summary
missing_values = data.isnull().sum()
missing_values.to_csv("metrics/missing_values.csv")

# Statistical summary
stats = data.describe()
stats.to_csv("metrics/data_statistics.csv")

# Pair plot
sns.pairplot(data, hue="Potability")
plt.savefig("metrics/pairplot.png")

# Correlation heatmap
plt.figure(figsize=(10, 8))
sns.heatmap(data.corr(), annot=True)
plt.savefig("metrics/correlation_heatmap.png")

# Handle missing values
imputer = SimpleImputer(strategy="mean")
data_imputed = pd.DataFrame(imputer.fit_transform(data), columns=data.columns)

# Feature scaling
scaler = StandardScaler()
features = data_imputed.drop("Potability", axis=1)
target = data_imputed["Potability"]
features_scaled = scaler.fit_transform(features)

# Save the scaler
joblib.dump(scaler, "models/scaler.joblib")

# Save preprocessed data
preprocessed_data = pd.DataFrame(features_scaled, columns=features.columns)
preprocessed_data["Potability"] = target
preprocessed_data.to_csv("metrics/preprocessed_data.csv", index=False)
$ python .\src\preprocess_data.py Wir erhalten die vorverarbeiteten Daten sowie alle Analyseberichte mit Grafiken.
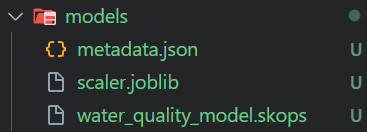
Das Trainingsskript lädt die vorverarbeiteten Daten und trainiert damit einen Random Forest Classifier. Anschließend wird das Modell mit Skops gespeichert, Experimente werden manuell getrackt und Metadaten als JSON gesichert.
src\train_model.py:
import os
import json
import skops.io as sio
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]

# Split the data
X_train, X_test, y_train, y_test = train_test_split(
    features, target, test_size=0.2, random_state=42, stratify=target
)

# Train the model
model = RandomForestClassifier(n_estimators=200, random_state=42)
model.fit(X_train, y_train)

# Save the model using skops
os.makedirs("models", exist_ok=True)
sio.dump(model, "models/water_quality_model.skops")

# Track experiments and save metadata
metadata = {
    "model_name": "RandomForestClassifier",
    "parameters": model.get_params(),
    "training_score": model.score(X_train, y_train),
}

with open("models/metadata.json", "w") as f:
    json.dump(metadata, f, indent=4)
$ python .\src\train_model.py Das Skript erzeugt die Modelldatei und Metadaten, wie unten gezeigt.
Das Evaluationsskript lädt die verarbeiteten Daten und das gespeicherte Modell und erstellt Classification Report, Konfusionsmatrix, ROC-Kurve, AUC sowie die Gesamtgenauigkeit. Alle Metriken und Grafiken werden im Ordner metrics gespeichert.
src\evaluate_model.py :
import os
import json
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    roc_auc_score,
    roc_curve,
)
import skops.io as sio
from sklearn.model_selection import train_test_split

# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]

# Split the data
X_train, X_test, y_train, y_test = train_test_split(
    features, target, test_size=0.2, random_state=42, stratify=target
)

# Load the model
model = sio.load("models/water_quality_model.skops")

# Predictions
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test)[:, 1]

# Classification report
report = classification_report(y_test, y_pred, output_dict=True)
with open("metrics/classification_report.json", "w") as f:
    json.dump(report, f, indent=4)

# Confusion matrix
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d")
plt.title("Confusion Matrix")
plt.ylabel("Actual Label")
plt.xlabel("Predicted Label")
plt.savefig("metrics/confusion_matrix.png")

# ROC curve and AUC
fpr, tpr, _ = roc_curve(y_test, y_pred_proba)
roc_auc = roc_auc_score(y_test, y_pred_proba)

plt.figure()
plt.plot(fpr, tpr, label="AUC = %0.2f" % roc_auc)
plt.plot([0, 1], [0, 1], "k--")
plt.legend(loc="lower right")
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("Receiver Operating Characteristic")
plt.savefig("metrics/roc_curve.png")

# Overall accuracy
accuracy = model.score(X_test, y_test)
print(f"Overall Accuracy: {accuracy * 100:.2f}%")
$ python .\src\evaluate_model.py Die Gesamtgenauigkeit ist nicht besonders hoch. Wir können das o1-Modell jedoch jederzeit bitten, die Genauigkeit zu verbessern.
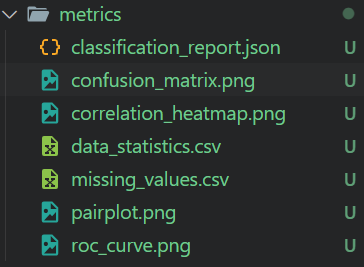
Overall Accuracy: 65.55%Im Ordner metrics findest du alle gespeicherten Evaluationsgrafiken und -metriken. So lässt sich die Modellleistung im Detail nachvollziehen.
Für das User Interface der FastAPI-App benötigen wir eine Start- und eine Ergebnisseite. Erstelle dazu im Verzeichnis app einen Ordner templates und füge zwei HTML-Dateien hinzu: eine für die Hauptseite und eine für die Ergebnisseite.
Sieh dir das FastAPI Tutorial: An Introduction to Using FastAPI an, um den FastAPI-Stack im Detail zu verstehen und in deinem Projekt einzusetzen.
Falls du HTML nicht kennst: Kein Problem. Kopiere den Code einfach und vertrau auf das o1-Modell.
app\templates\form.html:
<!DOCTYPE html>
<html>
<head>
    <title>Water Quality Prediction</title>
</head>
<body>
    <h2>Enter Water Parameters</h2>
    <form action="/predict" method="post">
        {% for feature in ['ph', 'Hardness', 'Solids', 'Chloramines', 'Sulfate', 'Conductivity', 'Organic_carbon', 'Trihalomethanes', 'Turbidity'] %}
        <label for="{{ feature }}">{{ feature.replace('_', ' ').title() }}:</label><br>
        <input type="number" step="any" id="{{ feature }}" name="{{ feature }}" required><br><br>
        {% endfor %}
        <input type="submit" value="Predict">
    </form>
</body>
</html>
app\templates\result.html:
<!DOCTYPE html>
<html>
<head>
    <title>Prediction Result</title>
</head>
<body>
    <h2>Prediction Result</h2>
    <p>The water is predicted to be: <strong>{{ result }}</strong></p>
    <a href="/">Try Again</a>
</body>
</html>
Die Hauptdatei der Anwendung enthält zwei Funktionen: home und predict. "home" zeigt die Startseite mit Eingabefeldern und Button. "predict" transformiert die Eingaben, führt das Modell aus und gibt zurück, ob das Wasser trinkbar ist oder nicht.
app\templates\main.py:
from fastapi import FastAPI, Request, Form
from fastapi.responses import HTMLResponse
from fastapi.templating import Jinja2Templates
import numpy as np
import skops.io as sio
import joblib

app = FastAPI()
templates = Jinja2Templates(directory="app/templates")

# Load the saved model and preprocessing pipeline
model = sio.load("models/water_quality_model.skops", trusted=True)
preprocessing_pipeline = joblib.load("models/preprocessing_pipeline.joblib")


@app.get("/", response_class=HTMLResponse)
async def home(request: Request):
    return templates.TemplateResponse("form.html", {"request": request})


@app.post("/predict", response_class=HTMLResponse)
async def predict(
    request: Request,
    ph: float = Form(...),
    Hardness: float = Form(...),
    Solids: float = Form(...),
    Chloramines: float = Form(...),
    Sulfate: float = Form(...),
    Conductivity: float = Form(...),
    Organic_carbon: float = Form(...),
    Trihalomethanes: float = Form(...),
    Turbidity: float = Form(...),
):
    input_data = np.array(
        [
            [
                ph,
                Hardness,
                Solids,
                Chloramines,
                Sulfate,
                Conductivity,
                Organic_carbon,
                Trihalomethanes,
                Turbidity,
            ]
        ]
    )
    # Preprocess input data
    input_preprocessed = preprocessing_pipeline.transform(input_data)
    prediction = model.predict(input_preprocessed)
    result = "Potable" if prediction[0] == 1 else "Not Potable"
    return templates.TemplateResponse(
        "result.html", {"request": request, "result": result}
    )
Wir testen die App zunächst lokal, um zu prüfen, ob sie läuft.
$ uvicorn app.main:app --reload Beim Start mit uvicorn erhalten wir die lokale Adresse, die wir im Browser öffnen können.
Hinweis: Auch die Hinweise zum Ausführen der Dateien kommen vom o1-Modell.
INFO:     Will watch for changes in these directories: ['C:\\Repository\\GitHub\\Water-Quality-App']
INFO:     Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
INFO:     Started reloader process [34792] using StatReload
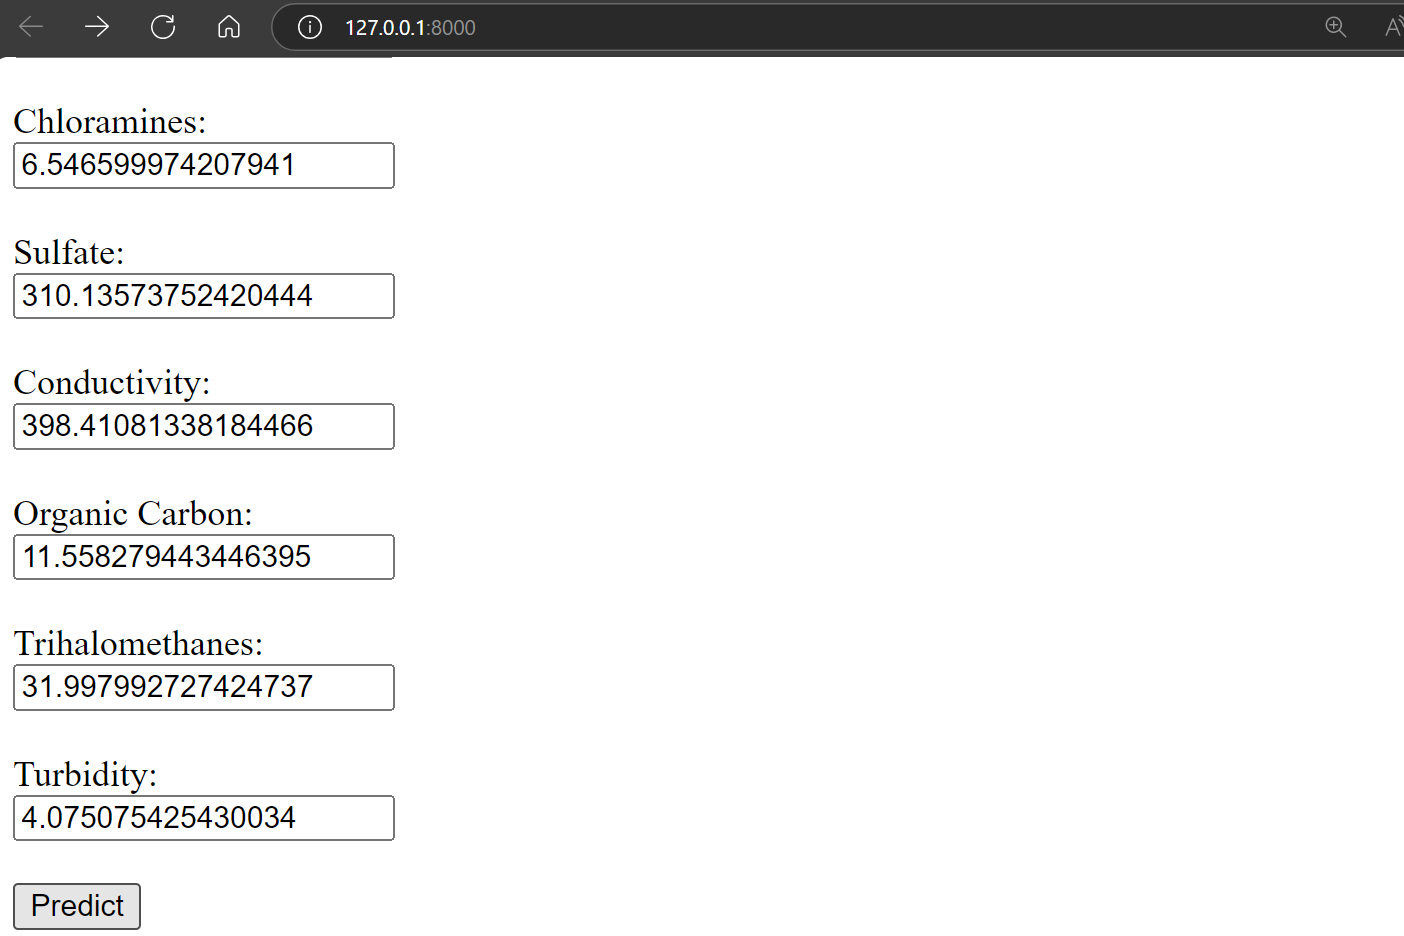
Wie zu sehen, funktioniert die App einwandfrei.
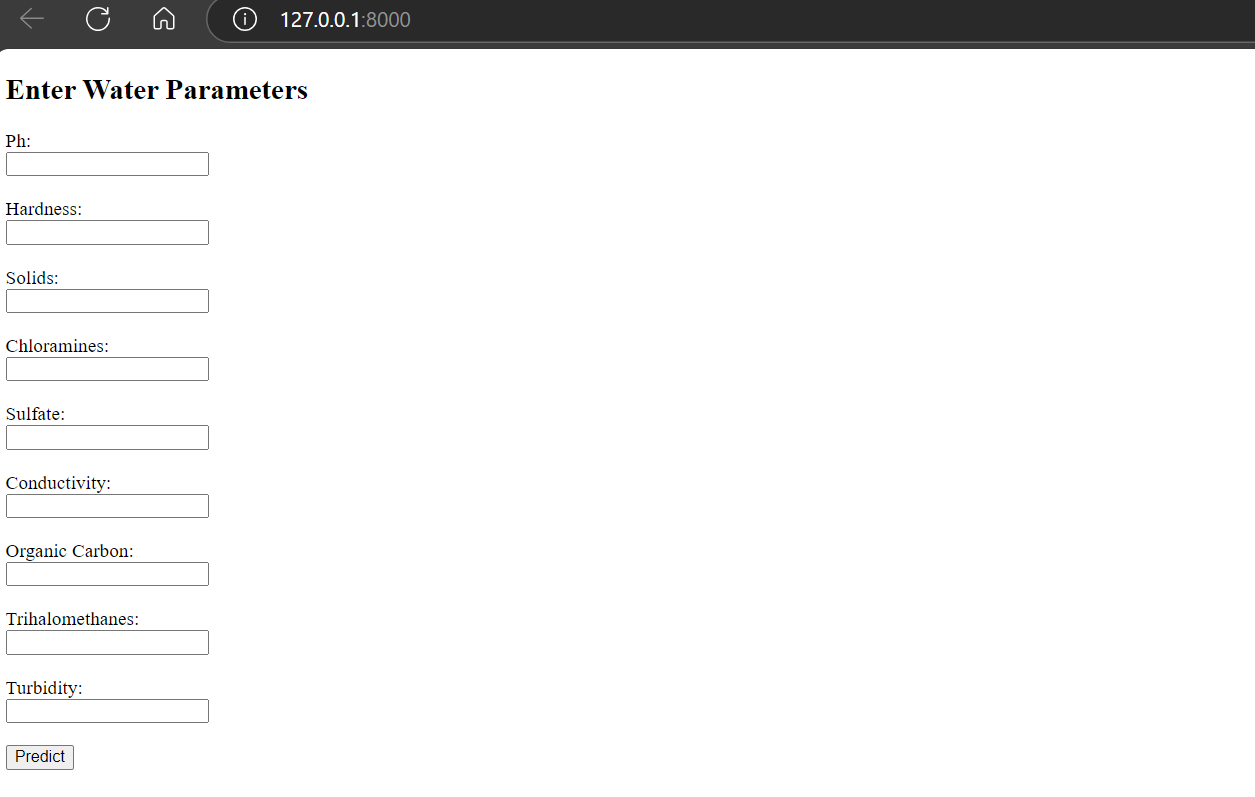
Gib nun Zufallswerte ein, um die Wasserqualität zu prüfen, und klicke auf Predict.
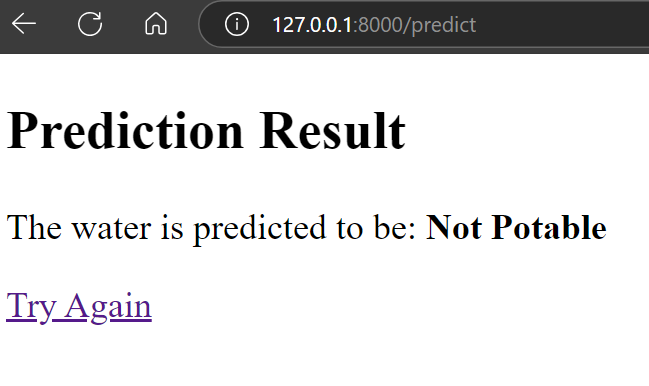
Das Ergebnis ist eindeutig: Das Wasser ist nicht trinkbar.
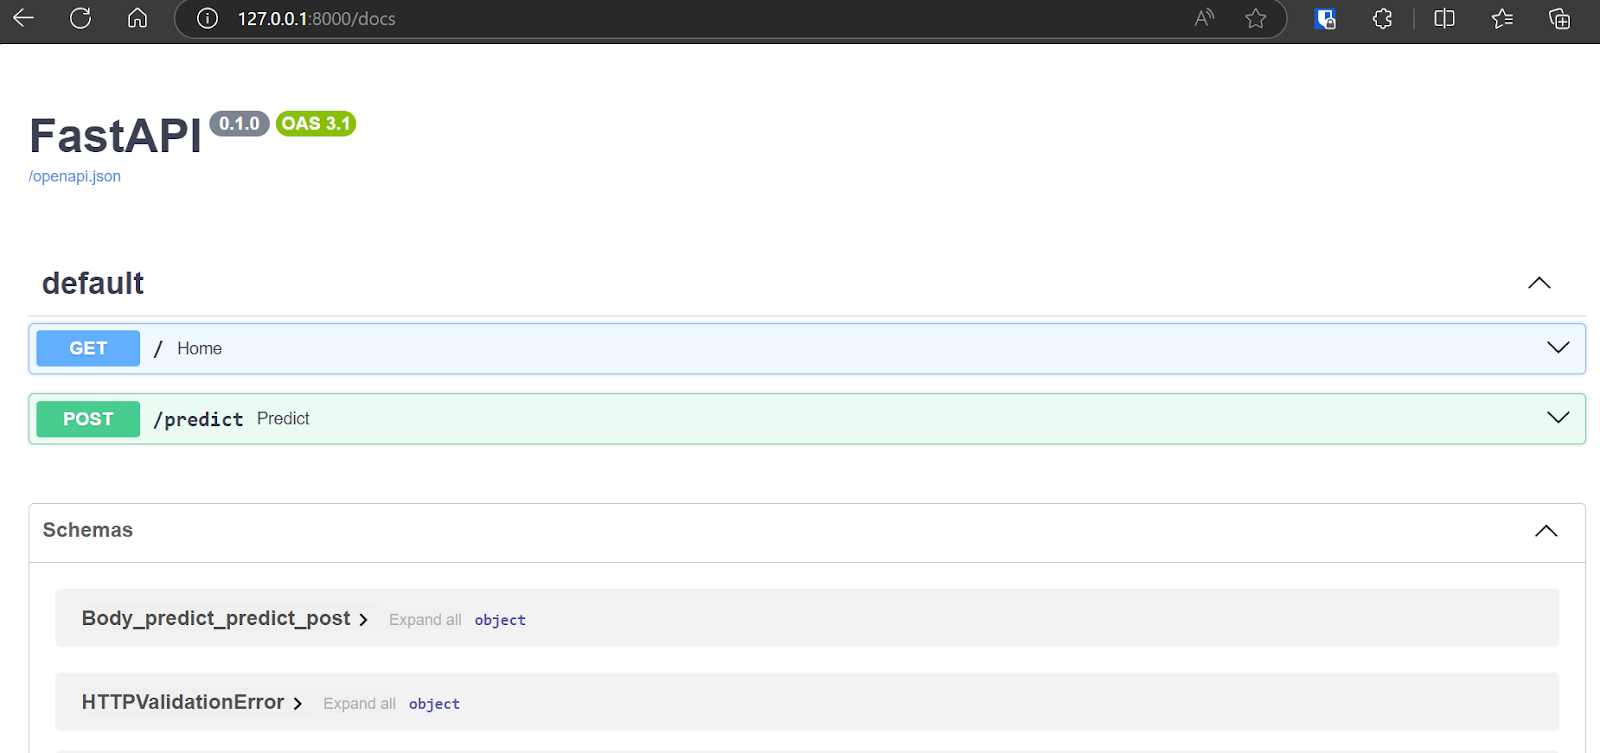
Über “/docs” nach der URL erreichst du das FastAPI Swagger UI, testest die API und erzeugst Ergebnisse.
Das OpenAI o1-Modell hat Docker-Code, Anleitung und Referenzen generiert, damit wir die App erfolgreich auf Hugging Face deployen können.
Lies das Tutorial Docker for Data Science: An Introduction, um zu verstehen, wie Docker funktioniert: Setup, Kommandos, ML-Apps dockerisieren und Best Practices.
Erstelle zuerst eine neue Space: Klicke auf dein Profilbild auf Hugging Face und dann auf "New Space". Vergib einen App-Namen, wähle als SDK "Docker", lege den Lizenztyp fest und klicke auf “Create Space”.
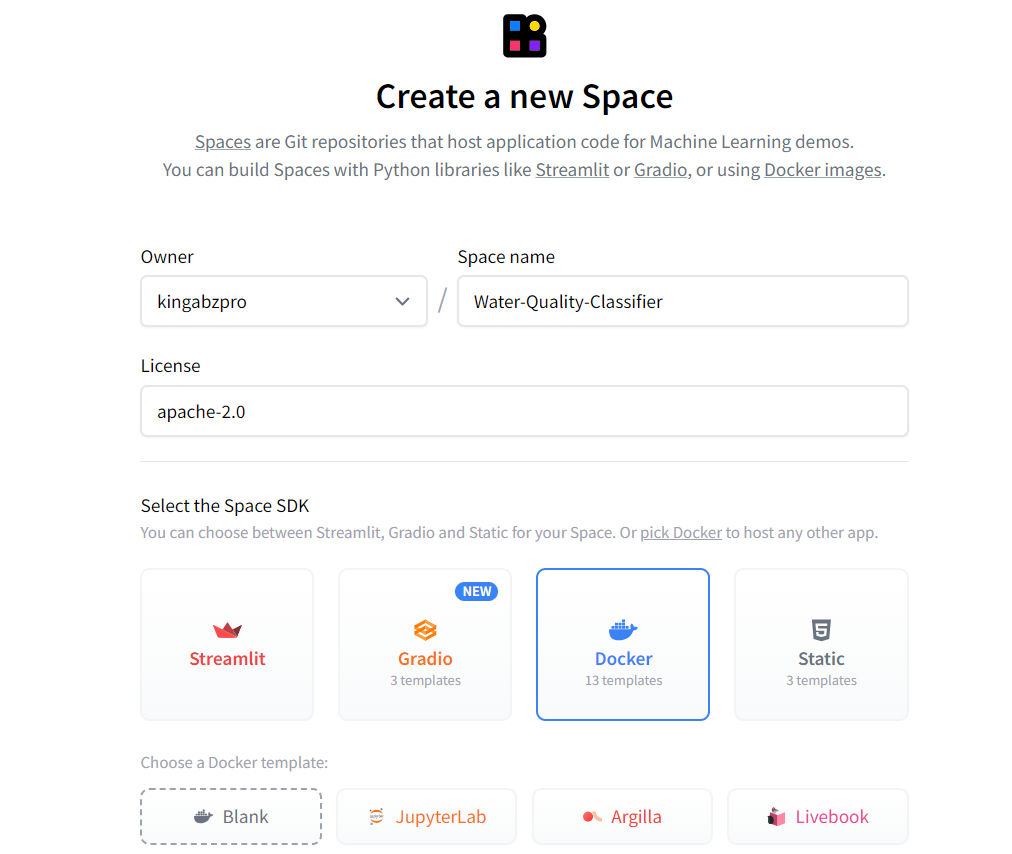
Quelle: Hugging Face
Auf der Hauptseite findest du alle Anweisungen für das Deployment per Docker.
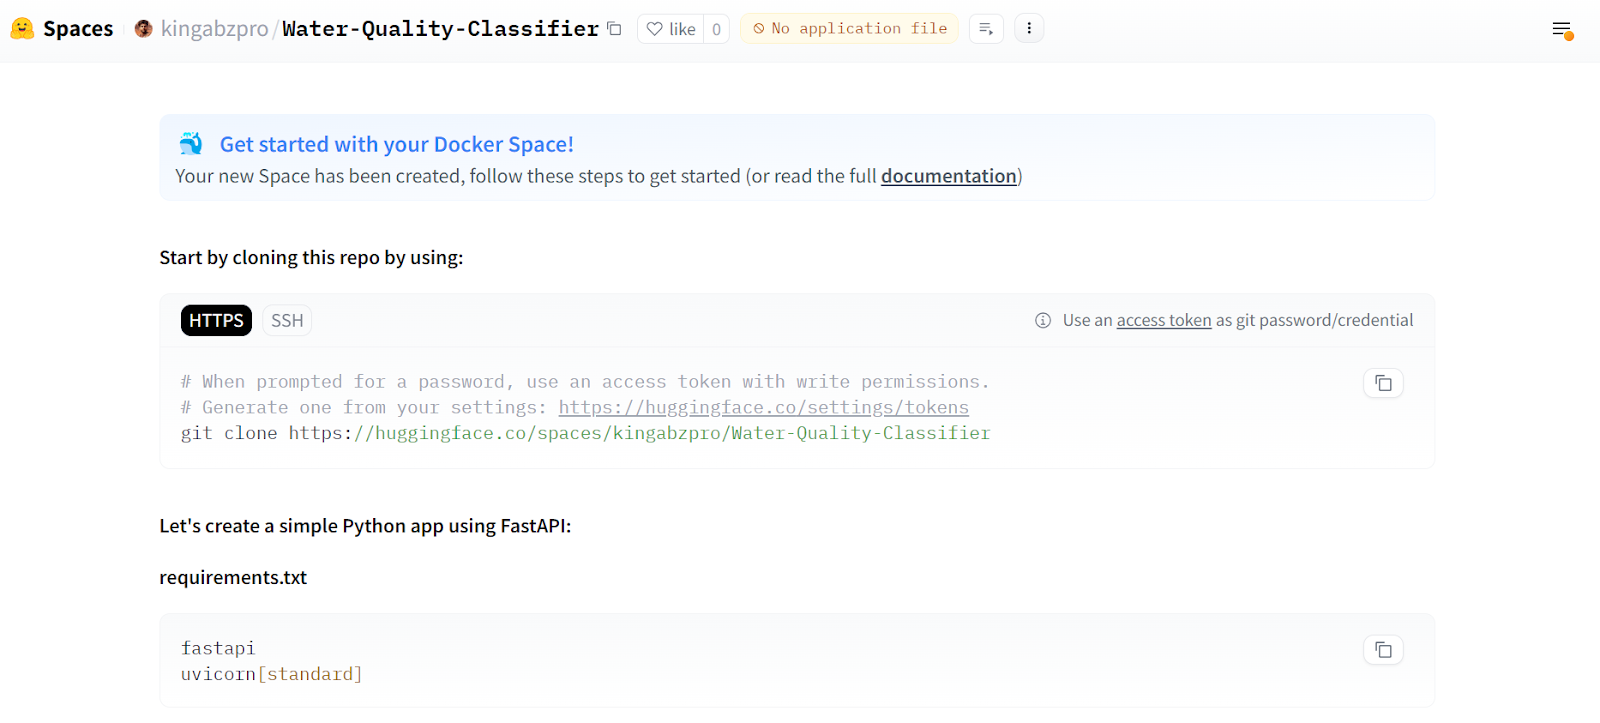
Quelle: Water Quality Classifier
Als Nächstes klonen wir das Repository.
git clone https://huggingface.co/spaces/kingabzpro/Water-Quality-ClassifierVerschiebe innerhalb des Repos die Ordner app und models. Erstelle ein Dockerfile und nutze den folgenden Befehl. Den Code liefert das o1-Modell – wir müssen nur den Port auf 7860 ändern.
Dockerfile:
# Use an official Python runtime as a parent image
FROM python:3.9-slim

# Set the working directory
WORKDIR /app

# Copy the current directory contents into the container at /app
COPY . /app

# Install any needed packages specified in requirements.txt
RUN pip install --no-cache-dir -r requirements.txt

# Expose port 7860
EXPOSE 7860

# Run the application
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "7860"]
Erstelle die Datei requirements.txt mit den benötigten Python-Packages. Diese Datei nutzt der Cloud-Server, um alle Abhängigkeiten zu installieren.
requirements.txt:
fastapi
uvicorn
jinja2
pydantic
skops
joblib
numpy
pandas
scikit-learn==1.5.1
matplotlib
seaborn
kaggle
imbalanced-learn
python-multipart
So sollte unser App-Repository aussehen:
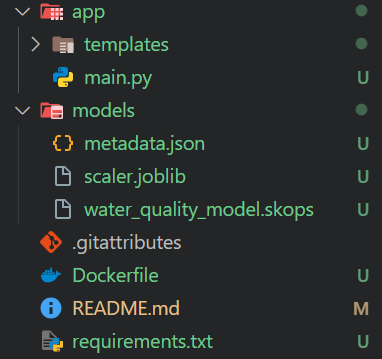
Unser Modell ist groß (> 10 MB), daher müssen wir es mit Git LFS tracken. Installiere Git LFS und tracke alle Dateien mit der Endung “.skops”.
git lfs install
git lfs track "*.skops"
Stage alle Änderungen, committe mit Nachricht und pushe zum Remote-Server.
git add .
git commit -m "pushing all the files"
git push
Wechsle zur App-Seite auf Hugging Face. Du siehst, wie der Container gebaut und alle Pakete installiert werden.
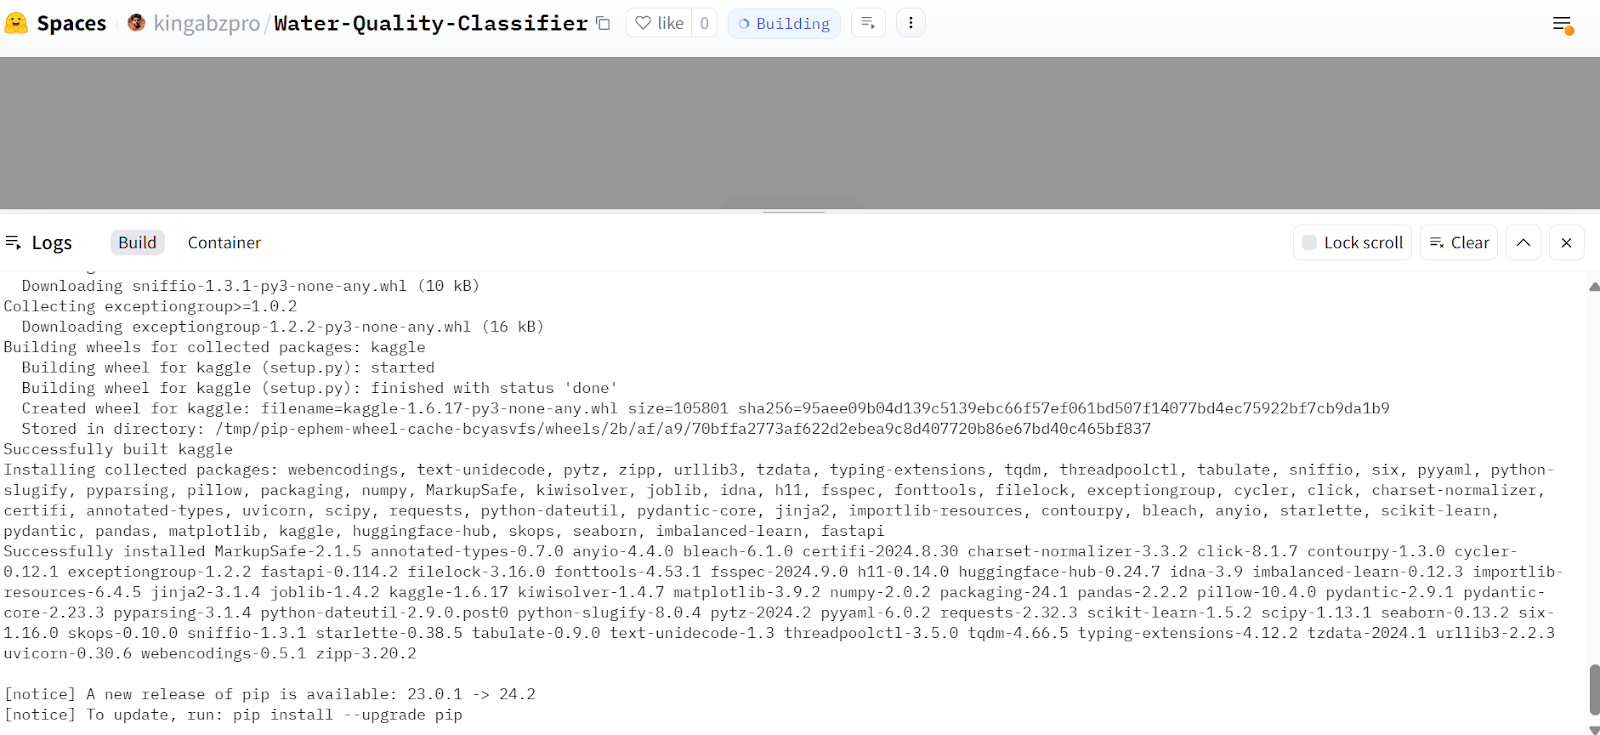
Quelle: Water Quality Classifier
Nach wenigen Minuten ist die App einsatzbereit. Sie entspricht der lokalen App. Gib Beispielwerte ein und lass dir die Ergebnisse anzeigen.
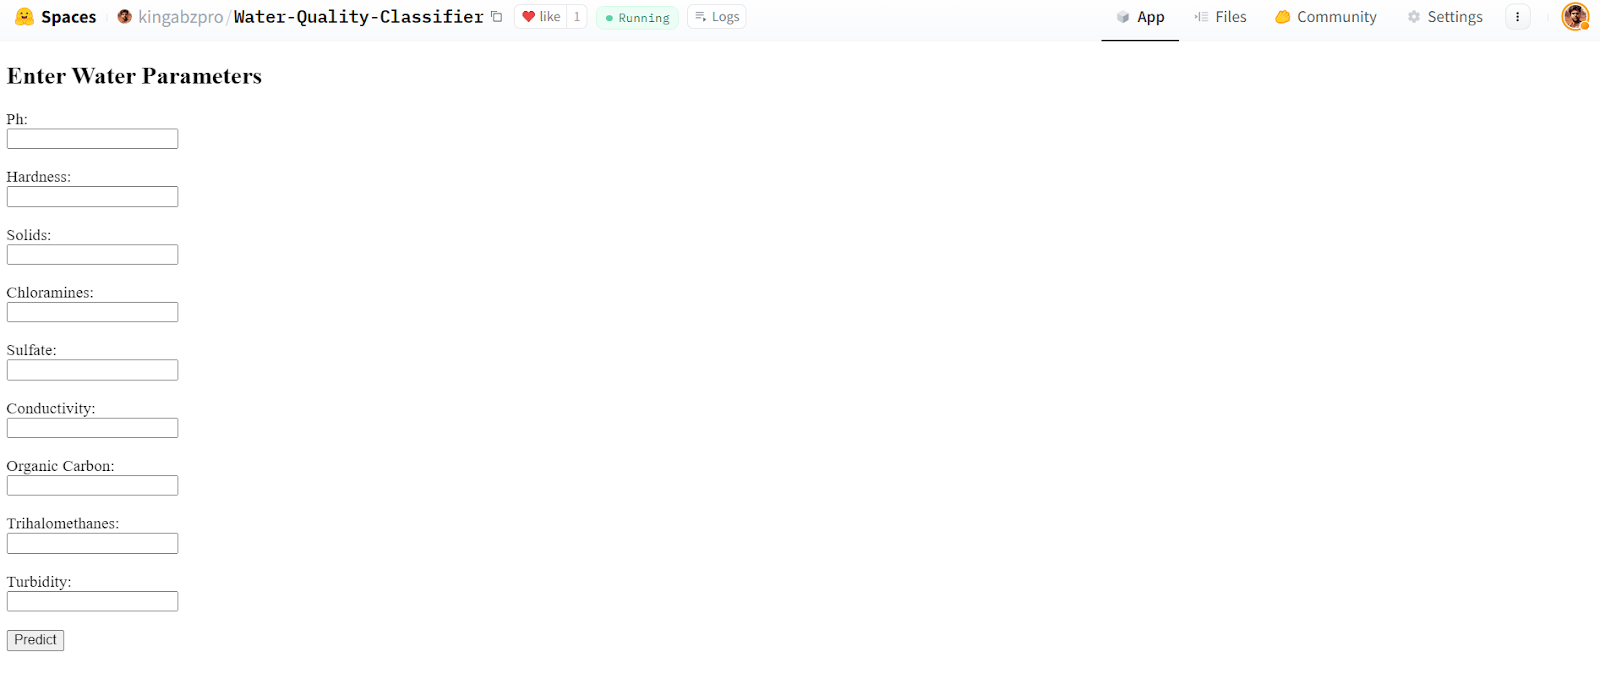
Quelle: Water Quality Classifier
Unsere App läuft stabil und liefert die erwarteten Ergebnisse.
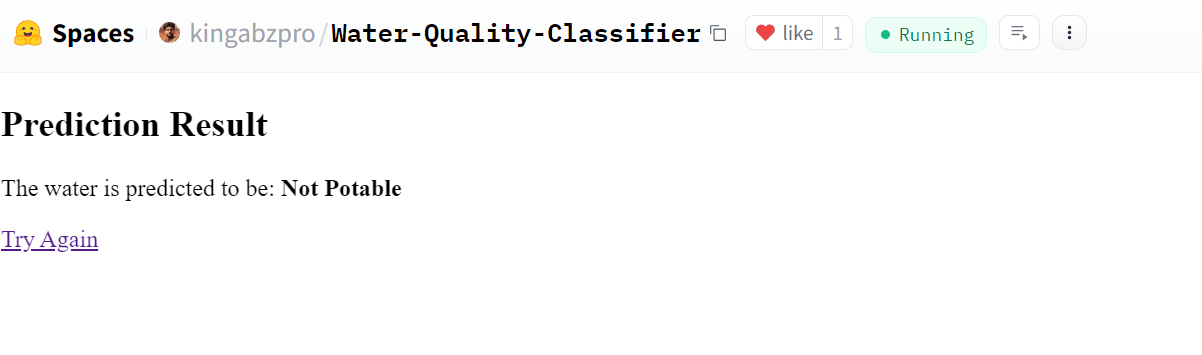
Quelle: Water Quality Classifier
Diese Hugging Face Space-App ist öffentlich nutzbar. Du kannst sie also auch im Terminal per curl aufrufen.
curl -X 'POST' \
  'https://kingabzpro-water-quality-classifier.hf.space/predict' \
  -H 'accept: text/html' \
  -H 'Content-Type: application/x-www-form-urlencoded' \
  -d 'Organic_carbon=10&Hardness=200&Turbidity=4&Solids=10000&Chloramines=7&Trihalomethanes=80&Sulfate=300&ph=7&Conductivity=400' \
  | grep -oP '(?<=<strong>).*(?=</strong>)'
Ausgabe:
Not PotableAlle Projektdateien, Daten, Modelle und Metadaten findest du im GitHub-Repository kingabzpro/Water-Quality-App.
Das o1-preview-Modell ist GPT-4o deutlich überlegen. Es befolgt Anweisungen präzise und ist praktisch bugfrei – der generierte Code ist sofort einsatzbereit. Beim Bau der ML-App musste ich nur etwa 5% minimal anpassen. Am besten gefiel mir, dass ich aus der Entscheidungsfindung der KI gelernt habe und nachvollziehen konnte, warum sie bestimmte Wege gewählt hat.
Abid Ali Awan
Top-OpenAI-Kurse
Kurs
Kurs
Kurs