

o1-preview ve o1-mini ile Başlarken
Kolay erişilebilen pek çok o1 modeli var, ancak resmî olanlara OpenAI API üzerinden veya ChatGPT Plus ya da Team aboneliği ile ulaşılabilir.
Bu bölümde, bu modelleri karmaşık problemleri çözmek için nasıl kullanabileceğimizi öğreneceğiz.
o1 modeline erişim
OpenAI sohbet tamamlaması API’sine aşinaysanız, model adını "o1-preview" olarak ayarlayıp ayrıntılı bir komut vermeniz yeterlidir. Bu kadar basit.
from openai import OpenAI
client = OpenAI()
response = client.chat.completions.create(
model="o1-preview",
messages=[
{
"role": "user",
"content": "Create an SQL database from scratch, including guides on usage and code everything in Python."
}
]
)
print(response.choices[0].message.content)ChatGPT üzerinde erişmek için model seçim açılır menüsüne tıklayıp aşağıda gösterildiği gibi “o1-preview” modelini seçmeniz gerekir.
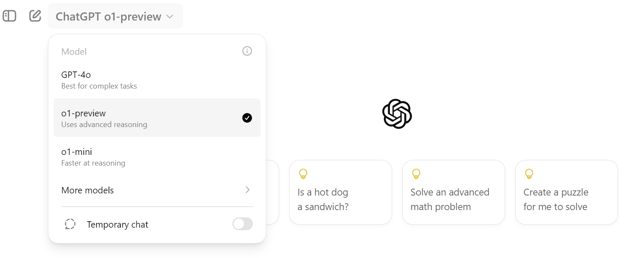
ChatGPT’de o1-preview modelini kullanma
o1 modelinin komutları farklıdır. Gücünden tam olarak yararlanmak için birden fazla talimat veya ayrıntılı sorular vermeniz gerekir. Uzun ve karmaşık yönergeleri alıp en iyi cevabı üretebilir.
Avrupa’da serbest çalışanlar için vergi hesaplamak karmaşık olabilir. İspanya hükümetine olan vergi yükümlülüğümüzü belirlemek için o1 modelini kullanacağız.
Komut: “ABD merkezli bir şirket için çalışan, İspanya’da yaşayan serbest çalışanım. Geçtiğimiz yıl 120.000 USD kazandım ve ödemem gereken vergiyi hesaplamam gerekiyor. 8 ay önce İspanya’ya taşındığımı dikkate alın.”
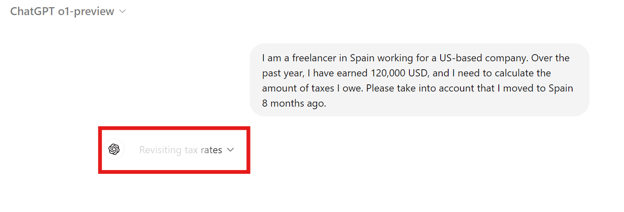
Yanıtın gelmesi yaklaşık 30 saniye sürdü ancak oldukça ayrıntılıydı. Matematiksel denklemler, vergi bilgileri ve İspanya hükümetine ne kadar borçlu olduğumuzu belirlemek için gereken tüm ayrıntıları içeriyordu.
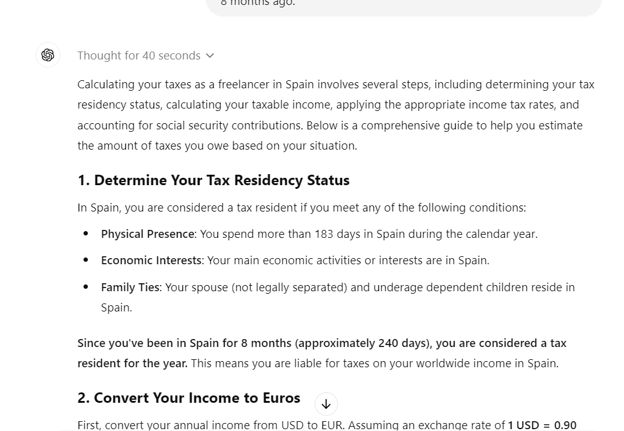
Yanıt şu bölümlere ayrılmıştı:
- Vergi Mükellefiyet Durumunuzu Belirleyin
- Gelirinizi Euro’ya Çevirin
- Vergiye Tabi Gelirinizi Hesaplayın
- Sosyal Güvenlik Katkılarını Hesaplayın
- Toplam Tahmini Vergi Borcu
- Önemli Notlar
- Sonraki Adımlar
Özet bölümünü incelemek, devlete yaklaşık ne kadar vergi borçlu olduğumuzu görmemizi sağlıyor; bu oldukça faydalı.
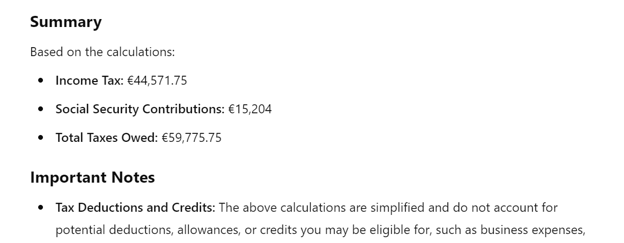
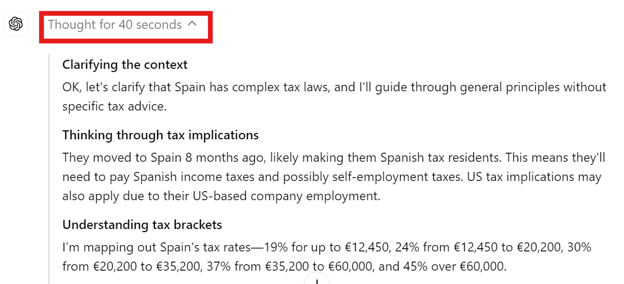
Zincirleme düşünce ve karar verme sürecini görmek için sohbet yanıtındaki açılır menüye tıklayabilirsiniz.
Modelin, yanıt vermeden önce bağlamı, vergi etkilerini ve vergi dilimini anladığını görebiliyoruz.
ChatGPT’de o1-mini modelini kullanma
o1-mini modeli, o1-preview’dan daha hızlı ancak daha az isabetlidir. Bizim örneğimizde, veri bilimi özgeçmişleri için statik bir web sitesi oluşturmak üzere bu modeli kullanacağız.
Komut: “Lütfen Python tabanlı bir çatı kullanarak veri bilimi özgeçmişim için statik bir web sitesi oluşturun.”
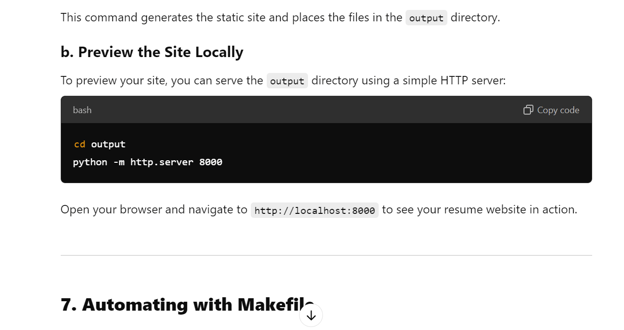
Sadece düzgün bir özgeçmiş sitesi oluşturmakla kalmadı, aynı zamanda bunu GitHub Pages üzerinde ücretsiz nasıl yayımlayacağımıza dair rehber de sağladı.
Yanıt şu bölümlere ayrılmıştı:
- Pelican’a Giriş
- Önkoşullar
- Pelican’ı Kurma
- Tema Seçimi
- Özgeçmiş İçeriğinizi Oluşturma
- Siteyi Derleme
- Makefile ile Otomasyon
- Özgeçmiş Sitenizi Dağıtma
- Sitenizi Zenginleştirme
- Ek Kaynaklar
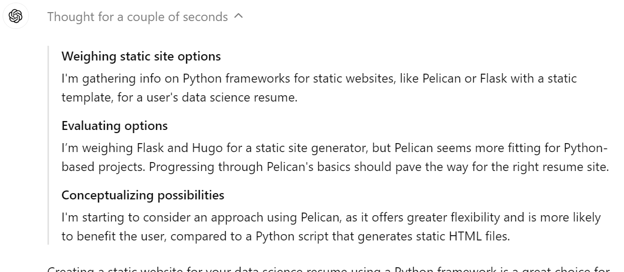
Yanıtta düşünce zincirinin gösterilmesi harika bir özellik. Modelin bir web çatısı olarak Pelican, Flask veya Hugo’yu değerlendirdiğini açıkça görebiliyoruz. Sonunda en iyi çözümü seçti.
OpenAI o1-preview Eğitimi: Su Kalitesi Sınıflandırıcı Uygulaması Oluşturma
Bu projede, o1-preview modelini kullanarak bir su kalitesi sınıflandırma uygulaması geliştirecek ve dağıtacağız. Oldukça kapsamlı bir proje; aradığımız şeye dair ayrıntılı bir açıklama sağlayacağız.
ChatGPT kullanarak bir veri bilimi projesi geliştirmekle ilgileniyorsanız, Veri Bilimi Projeleri için ChatGPT Kullanım Rehberi yazısına göz atın. Proje planlama, veri analizi, veri ön işleme, model seçimi, hiperparametre ayarı, bir web uygulaması geliştirme ve dağıtım konularını öğreneceksiniz.
1. Komut (prompt) tasarımı
Proje yönergelerinin tamamını modele verdiğimizden emin olmak istediğimiz için komut tasarımına daha fazla zaman ayıracağız.
Komut üç bölüme ayrılmıştır:
- Proje açıklaması: Projenin ve ne inşa etmek istediğimizin ayrıntılı açıklaması.
- Hedefler ve kısıtlar: %90 doğruluk elde etmeyi amaçlamak gibi hedef bilgilerini sağlayın.
- İzlenecek adımlar: Atmasını istediğiniz tüm gerekli adımları verin. Örneğin, Kaggle API ile veri alımı, metriklerin klasöre kaydedilmesi, veri analizi yapılması, modelin eğitilmesi ve değerlendirilmesi vb. Mümkün olduğunca çok adım yazın.
ChatGPT’de doğru çıktıları üretecek komutlar yazmayı öğrenmek için Acemi Kullanıcılar için ChatGPT Komut Tasarımı Rehberi yazısını okuyun. Komut tasarımı bir sanattır ve o1 modelinin gelişiyle öğrenilmesi daha da gerekli hale geldi.
Komut: “Proje yöneticim, https://www.kaggle.com/datasets/adityakadiwal/water-potability adresindeki Kaggle veri kümesini kullanarak bir Su Kalitesi uygulaması geliştirmemizi istedi. Yüksek doğrulukta bir model kurabilmemiz için dosyalar, Python paketleri ve kodla ilgili gerekli tüm bilgileri sağlayın.
Hedef, genel doğruluğu %90’a ulaştırmaktır.
Lütfen projeyi oluşturmak için şu adımları izleyin:
1. Veri kümesini Kaggle API ile yükleyin ve data klasöründe açın.
2. Veriyi ön işleyin ve bazı veri analizi çalışmaları yapın. Analiz görsellerini ve dosyalarını metrics klasörüne kaydedin.
3. Modeli scikit-learn çerçevesini kullanarak eğitin. Deneyleri takip ettiğinizden ve model dosyalarını ile meta verilerini kaydettiğinizden emin olun. Modeli skops kütüphanesi ile kaydedin.
4. Ayrıntılı model değerlendirmesi yapın ve sonuçları kaydedin.
5. Kullanıcıdan bir görsel alan ve suyun kalitesini tahmin eden bir FastAPI uygulaması oluşturun.
6. Jinja2 şablonlarını kullanarak kullanıcı arayüzü eklediğinizden emin olun.
7. Uygulamayı Docker seçeneğini kullanarak Hugging Face hub üzerinde dağıtın.”
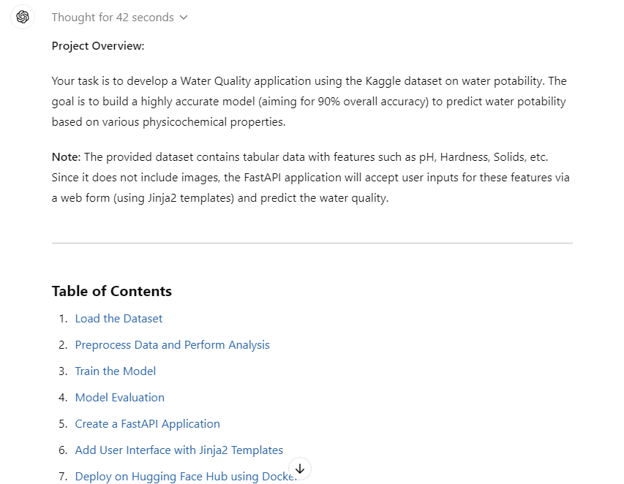
Oluşturulan yanıt, veriyi yüklemek, ön işlemek, modeli eğitmek ve değerlendirmek, FastAPI uygulaması ile kullanıcı arayüzünü oluşturmak ve dağıtmak için gereken tüm bilgileri sağladı.
Sorun şu ki yanıt parçalı; sadece kopyalayıp yapıştırabileceğimiz Python ve HTML dosyaları üretmesini istiyoruz.
Şimdi tüm kodu Python ve HTML dosyalarına dönüştürerek işi daha da kolaylaştıracağız.
Takip komutu: “Lütfen kodu Python dosyalarına dönüştürün.”
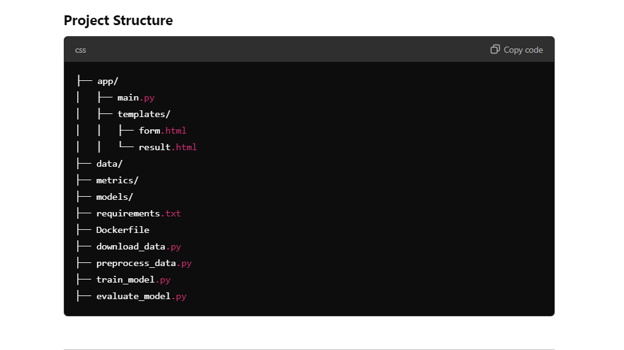
Gördüğümüz gibi, tüm dosyaların ve kodların bulunduğu bir proje yapısı elde ettik. Yapmamız gereken sadece klasör ve dosyaları oluşturup kodu kopyalayıp yapıştırmak.
2. Kurulum
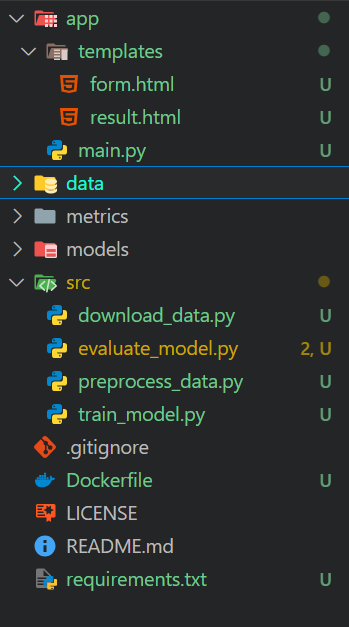
o1 modeli, bir proje dizini kurmak için gereken tüm bilgileri sağlar. Kod düzenleyiciyi kullanarak proje dizini içinde klasör ve dosyaları oluşturmamız yeterli.
Şu klasörleri oluşturacağız:
- app: Bu klasör FastAPI uygulama dosyasını ve HTML şablonlarını içerecek.
- data: Bu klasör orijinal ve ön işlenmiş veriyi içerecek.
- metrics: Bu klasör model değerlendirme verilerini ve veri analizini içerecek.
- models: Bu klasör kayıtlı modelleri ve ölçekleyici nesneleri içerecek.
- src: Bu klasör yükleme, işleme, eğitim ve değerlendirmede yardımcı olacak tüm Python dosyalarını içerecek.
Ayrıca, ana dizin Dockerfile, README ve requirements.txt dosyasını içerecek.
3. Veri kümesini yükleme
Kaggle API kullanarak Su Kalitesi veri kümesini indirecek ve data klasöründe açacağız.
data\download_data.py:
import os
# Ensure the data directory exists
os.makedirs("data", exist_ok=True)
# Download the dataset
os.system("kaggle datasets download -d adityakadiwal/water-potability -p data --unzip")Python dosyasını çalıştırmak veri kümesini indirecek, açacak ve zip dosyasını kaldıracaktır.
$ python .\src\download_data.py
Dataset URL: https://www.kaggle.com/datasets/adityakadiwal/water-potability
License(s): CC0-1.0
Downloading water-potability.zip to data
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 304kB/s]
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 303kB/s]4. Veriyi ön işleme ve veri analizi
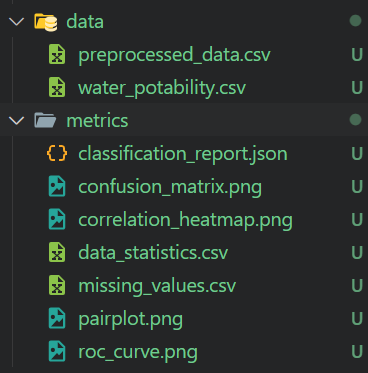
Ön işleme Python dosyası veriyi yükler, temizler, eksik verileri ele alır, ölçeklendirir ve ardından ölçekleyiciyi ile ön işlenmiş veri kümesini kaydeder. Ayrıca veri analizi yapar ve metrikler ile veri görselleştirmelerini kaydeder.
data\preprocess_data.py:
import os
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
import joblib
# Create directories if they don't exist
os.makedirs("metrics", exist_ok=True)
os.makedirs("models", exist_ok=True)
# Load the dataset
data = pd.read_csv("data/water_potability.csv")
# Check for missing values and save the summary
missing_values = data.isnull().sum()
missing_values.to_csv("metrics/missing_values.csv")
# Statistical summary
stats = data.describe()
stats.to_csv("metrics/data_statistics.csv")
# Pair plot
sns.pairplot(data, hue="Potability")
plt.savefig("metrics/pairplot.png")
# Correlation heatmap
plt.figure(figsize=(10, 8))
sns.heatmap(data.corr(), annot=True)
plt.savefig("metrics/correlation_heatmap.png")
# Handle missing values
imputer = SimpleImputer(strategy="mean")
data_imputed = pd.DataFrame(imputer.fit_transform(data), columns=data.columns)
# Feature scaling
scaler = StandardScaler()
features = data_imputed.drop("Potability", axis=1)
target = data_imputed["Potability"]
features_scaled = scaler.fit_transform(features)
# Save the scaler
joblib.dump(scaler, "models/scaler.joblib")
# Save preprocessed data
preprocessed_data = pd.DataFrame(features_scaled, columns=features.columns)
preprocessed_data["Potability"] = target
preprocessed_data.to_csv("metrics/preprocessed_data.csv", index=False)$ python .\src\preprocess_data.py Ön işlenmiş veriyi ve tüm veri analizi raporlarını görsellerle birlikte elde ettik.
5. Model oluşturma ve eğitim
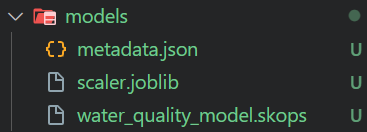
Eğitim betiği, ön işlenmiş veriyi yükleyip bir Rastgele Orman Sınıflandırıcısı eğitir. Ardından modeli kaydetmek, deneyi elle takip etmek ve model meta verilerini bir JSON dosyası olarak kaydetmek için Skope kullanılır.
src\train_model.py:
import os
import json
import skops.io as sio
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]
# Split the data
X_train, X_test, y_train, y_test = train_test_split(
features, target, test_size=0.2, random_state=42, stratify=target
)
# Train the model
model = RandomForestClassifier(n_estimators=200, random_state=42)
model.fit(X_train, y_train)
# Save the model using skops
os.makedirs("models", exist_ok=True)
sio.dump(model, "models/water_quality_model.skops")
# Track experiments and save metadata
metadata = {
"model_name": "RandomForestClassifier",
"parameters": model.get_params(),
"training_score": model.score(X_train, y_train),
}
with open("models/metadata.json", "w") as f:
json.dump(metadata, f, indent=4)$ python .\src\train_model.py Eğitim betiği aşağıda gösterildiği gibi bir model dosyası ve meta veriler üretecektir.
6. Model değerlendirme
Model değerlendirme betiği, işlenmiş veriyi ve kaydedilmiş modeli yükleyerek sınıflandırma raporu, karışıklık matrisi, ROC eğrisi, AUC ve genel doğruluğu üretir. Tüm metrikler ve görseller metrics klasörüne kaydedilir.
src\evaluate_model.py :
import os
import json
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.metrics import (
classification_report,
confusion_matrix,
roc_auc_score,
roc_curve,
)
import skops.io as sio
from sklearn.model_selection import train_test_split
# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]
# Split the data
X_train, X_test, y_train, y_test = train_test_split(
features, target, test_size=0.2, random_state=42, stratify=target
)
# Load the model
model = sio.load("models/water_quality_model.skops")
# Predictions
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test)[:, 1]
# Classification report
report = classification_report(y_test, y_pred, output_dict=True)
with open("metrics/classification_report.json", "w") as f:
json.dump(report, f, indent=4)
# Confusion matrix
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d")
plt.title("Confusion Matrix")
plt.ylabel("Actual Label")
plt.xlabel("Predicted Label")
plt.savefig("metrics/confusion_matrix.png")
# ROC curve and AUC
fpr, tpr, _ = roc_curve(y_test, y_pred_proba)
roc_auc = roc_auc_score(y_test, y_pred_proba)
plt.figure()
plt.plot(fpr, tpr, label="AUC = %0.2f" % roc_auc)
plt.plot([0, 1], [0, 1], "k--")
plt.legend(loc="lower right")
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("Receiver Operating Characteristic")
plt.savefig("metrics/roc_curve.png")
# Overall accuracy
accuracy = model.score(X_test, y_test)
print(f"Overall Accuracy: {accuracy * 100:.2f}%")$ python .\src\evaluate_model.py Genel doğruluk o kadar iyi değil. Ancak o1 modelinden doğruluğu artırmasını her zaman isteyebiliriz.
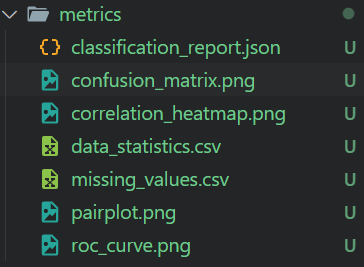
Overall Accuracy: 65.55%metrics klasörü, kaydedilen tüm model değerlendirme görsellerini ve metrikleri içerir. Model performansını ayrıntılı anlamak için bunları elle inceleyebiliriz.
7. Bir FastAPI uygulaması oluşturma
FastAPI uygulaması için bir kullanıcı arayüzü oluşturmak üzere dizin içinde bir templates klasörü oluşturup iki HTML dosyası eklememiz gerekir: biri ana sayfa, diğeri sonuç sayfası için.
FastAPI çerçevesini ayrıntılı öğrenmek ve projeye nasıl uygulayabileceğinizi görmek için FastAPI Eğitimi: FastAPI’ye Giriş yazısına göz atın.
HTML’e aşina değilseniz endişelenmeyin. Kodu kopyalayıp yapıştırmanız ve o1 modeline güvenmeniz yeterli.
app\templates\form.html:
<!DOCTYPE html>
<html>
<head>
<title>Water Quality Prediction</title>
</head>
<body>
<h2>Enter Water Parameters</h2>
<form action="/predict" method="post">
{% for feature in ['ph', 'Hardness', 'Solids', 'Chloramines', 'Sulfate', 'Conductivity', 'Organic_carbon', 'Trihalomethanes', 'Turbidity'] %}
<label for="{{ feature }}">{{ feature.replace('_', ' ').title() }}:</label><br>
<input type="number" step="any" id="{{ feature }}" name="{{ feature }}" required><br><br>
{% endfor %}
<input type="submit" value="Predict">
</form>
</body>
</html>app\templates\result.html:
<!DOCTYPE html>
<html>
<head>
<title>Prediction Result</title>
</head>
<body>
<h2>Prediction Result</h2>
<p>The water is predicted to be: <strong>{{ result }}</strong></p>
<a href="/">Try Again</a>
</body>
</html>Ana uygulama Python dosyasında iki Python işlevi vardır: home ve predict. "home" işlevi, giriş kutuları ve bir düğme içeren karşılama sayfasını gösterir. "predict" işlevi kullanıcı girdisini dönüştürür, modeli çalıştırır ve suyun içilebilir olup olmadığını belirten sonucu gösterir.
app\templates\main.py:
from fastapi import FastAPI, Request, Form
from fastapi.responses import HTMLResponse
from fastapi.templating import Jinja2Templates
import numpy as np
import skops.io as sio
import joblib
app = FastAPI()
templates = Jinja2Templates(directory="app/templates")
# Load the saved model and preprocessing pipeline
model = sio.load("models/water_quality_model.skops", trusted=True)
preprocessing_pipeline = joblib.load("models/preprocessing_pipeline.joblib")
@app.get("/", response_class=HTMLResponse)
async def home(request: Request):
return templates.TemplateResponse("form.html", {"request": request})
@app.post("/predict", response_class=HTMLResponse)
async def predict(
request: Request,
ph: float = Form(...),
Hardness: float = Form(...),
Solids: float = Form(...),
Chloramines: float = Form(...),
Sulfate: float = Form(...),
Conductivity: float = Form(...),
Organic_carbon: float = Form(...),
Trihalomethanes: float = Form(...),
Turbidity: float = Form(...),
):
input_data = np.array(
[
[
ph,
Hardness,
Solids,
Chloramines,
Sulfate,
Conductivity,
Organic_carbon,
Trihalomethanes,
Turbidity,
]
]
)
# Preprocess input data
input_preprocessed = preprocessing_pipeline.transform(input_data)
prediction = model.predict(input_preprocessed)
result = "Potable" if prediction[0] == 1 else "Not Potable"
return templates.TemplateResponse(
"result.html", {"request": request, "result": result}
)Önce uygulamayı yerelde çalıştırıp düzgün çalıştığını doğrulayacağız.
$ uvicorn app.main:app --reload uvicorn ile Python dosyasını çalıştırarak tarayıcıya kopyalayıp yapıştırabileceğimiz yerel adresi elde ederiz.
Not: Dosyaların nasıl çalıştırılacağına dair tüm bilgiler de o1 modeli tarafından sağlanmaktadır.
INFO: Will watch for changes in these directories: ['C:\\Repository\\GitHub\\Water-Quality-App']
INFO: Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
INFO: Started reloader process [34792] using StatReloadGördüğümüz gibi uygulama gayet iyi çalışıyor.
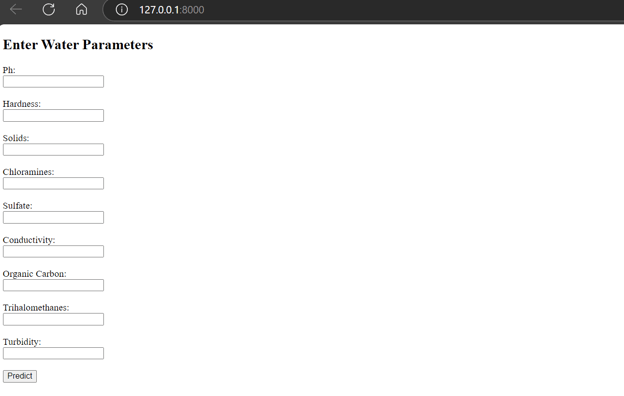
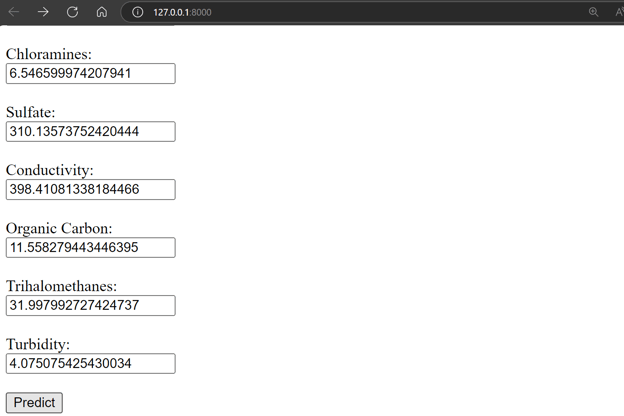
Rastgele değerler verip su kalitesini kontrol edelim ve tahmin düğmesine basalım.
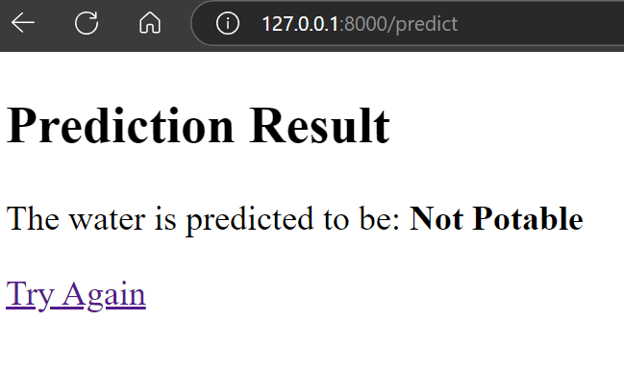
Sonuç etkileyici. Suyun içilebilir olmadığını gösteriyor.
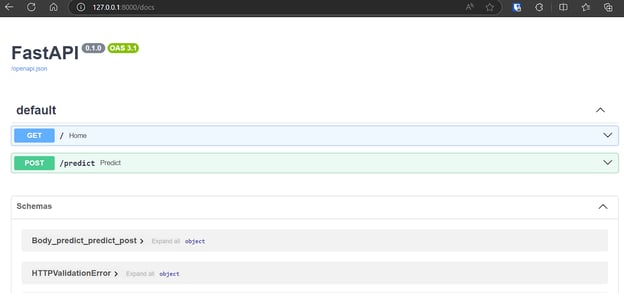
API’yi test etmek ve sonuçlar üretmek için URL’den sonra “/docs” yazarak FastAPI Swagger UI’a da erişebilirsiniz.
8. Uygulamayı Docker kullanarak Hugging Face Hub üzerinde dağıtma
OpenAI o1 modeli, uygulamayı Hugging Face üzerinde başarıyla dağıtmayı öğrenmemiz için Docker kodu, bir kılavuz ve referans bağlantıları oluşturdu.
Docker’ın nasıl çalıştığını öğrenmek için Veri Bilimi için Docker: Bir Giriş eğitimini okuyun. Docker’ı kurmayı, Docker komutlarını kullanmayı, makine öğrenimi uygulamalarını konteynerleştirmeyi ve sektör genelinde en iyi uygulamaları öğreneceksiniz.
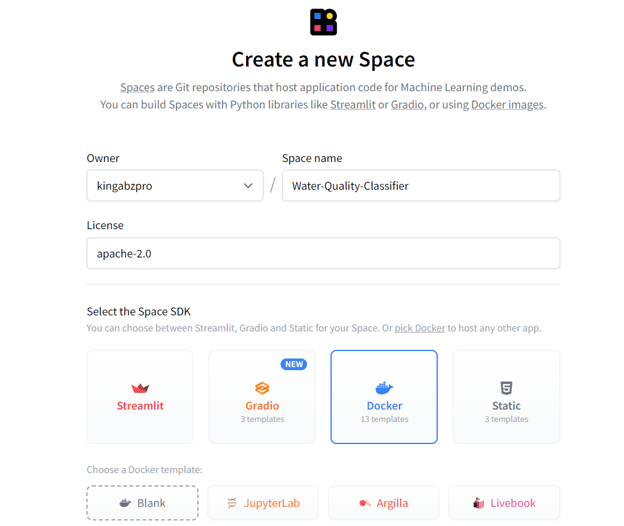
Önce Hugging Face sitesinde profil resmine tıklayıp "New Space" düğmesine basarak yeni bir Space oluşturun. Uygulama adını yazın, SDK türünü (Docker) seçin, lisans türünü belirleyin ve “Create Space” düğmesine basın.
Kaynak: Hugging Face
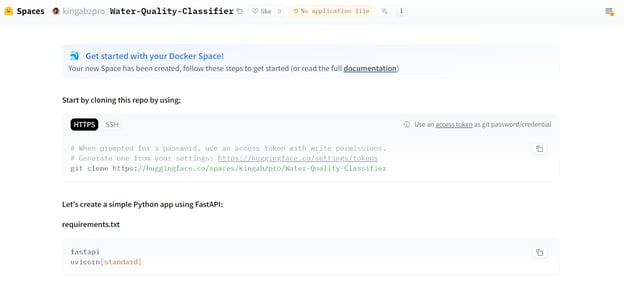
Docker kullanarak uygulamayı dağıtma yönergelerinin tamamı ana sayfada yer alır.
Kaynak: Water Quality Classifier
Sonrasında depoyu klonlamamız gerekiyor.
git clone https://huggingface.co/spaces/kingabzpro/Water-Quality-ClassifierDepo içinde app ve model klasörlerini taşıyın. Bir Dockerfile oluşturun ve aşağıdaki komutu yazın. o1 modeli bize kodu sağladı; yalnızca bağlantı noktasını 7860 olarak değiştirmemiz gerekiyor.
Dockerfile:
# Use an official Python runtime as a parent image
FROM python:3.9-slim
# Set the working directory
WORKDIR /app
# Copy the current directory contents into the container at /app
COPY . /app
# Install any needed packages specified in requirements.txt
RUN pip install --no-cache-dir -r requirements.txt
# Expose port 7860
EXPOSE 7860
# Run the application
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "7860"]requirements.txt dosyasını oluşturup Python paketleriyle ilgili bilgileri ekleyin. Bu dosyayı, gerekli tüm Python paketlerini bulut sunucusuna indirip kurmak için kullanacağız.
requirements.txt:
fastapi
uvicorn
jinja2
pydantic
skops
joblib
numpy
pandas
scikit-learn==1.5.1
matplotlib
seaborn
kaggle
imbalanced-learn
python-multipartDepomuzun şöyle görünmesi gerekir:
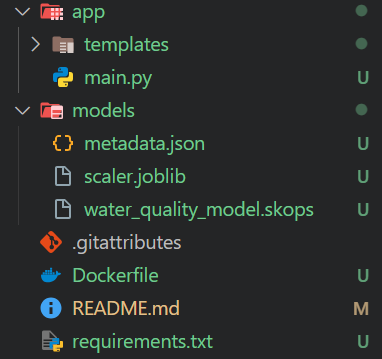
Modelimiz büyük bir dosya (> 10MB), bu nedenle onu izlemek için Git LFS kullanmalıyız. Git LFS kurun ve “.skops” uzantılı tüm dosyaları takip edin.
git lfs install
git lfs track "*.skops" Tüm değişiklikleri aşamaya alın, bir iletiyle commit edin ve uzak sunucuya gönderin.
git add .
git commit -m "pushing all the files"
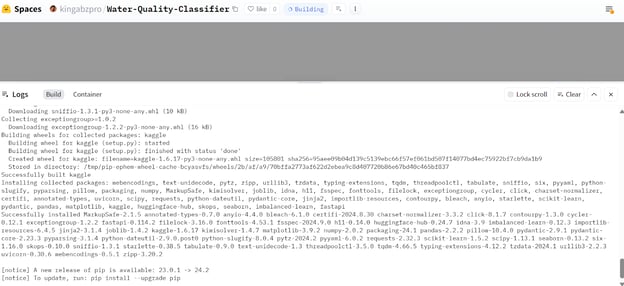
git pushHugging Face’teki uygulama sayfanıza gidin; konteynerin oluşturulduğunu ve gerekli tüm paketlerin yüklendiğini göreceksiniz.
Kaynak: Water Quality Classifier
Birkaç dakika sonra uygulama kullanıma hazır olur. Yerel uygulamayla benzer görünüyor. Örnek değerler verip sonuç üretmeyi deneyelim.
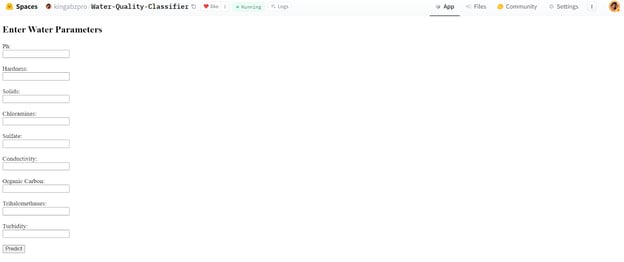
Kaynak: Water Quality Classifier
Uygulamamız kusursuz çalışıyor ve beklenen sonuçları veriyor.
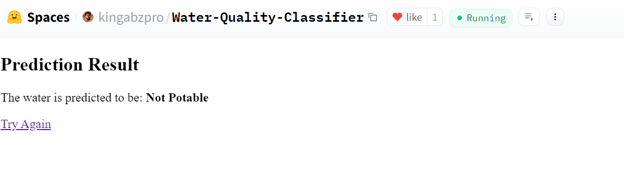
Kaynak: Water Quality Classifier
Bu Hugging Face Space uygulaması herkesin kullanımına açıktır; yani terminalde curl komutunu kullanarak da erişebiliriz.
curl -X 'POST' \
'https://kingabzpro-water-quality-classifier.hf.space/predict' \
-H 'accept: text/html' \
-H 'Content-Type: application/x-www-form-urlencoded' \
-d 'Organic_carbon=10&Hardness=200&Turbidity=4&Solids=10000&Chloramines=7&Trihalomethanes=80&Sulfate=300&ph=7&Conductivity=400' \
| grep -oP '(?<=<strong>).*(?=</strong>)'Çıktı:
Not PotableTüm proje dosyaları, veriler, modeller ve meta veriler kingabzpro/Water-Quality-App GitHub deposunda mevcuttur.
Yazarın Görüşü
o1-preview modeli GPT-4o’dan çok daha üstün. Talimatları kusursuz takip ediyor ve hatasız; bu nedenle ürettiği kod kullanıma hazır. Makine öğrenimi uygulamasını oluştururken yalnızca küçük değişiklikler yapmam gerekti, yaklaşık %5. En iyi yanı ise, modelin karar verme sürecinden de öğrenmiş olmam; bazı seçimleri neden yaptığını anladım.
Sonuç
Bu eğitimde, OpenAI’nin o1 akıl yürütme modelinin ne kadar güçlü olabileceğini gördük. Koda yalnızca birkaç küçük değişiklik yaparak eksiksiz bir makine öğrenimi projesi inşa ettik ve anında çalıştı. Model her komutu kusursuz şekilde ele aldı ve ek talimatlara gerek duymadan harika sonuçlar üretti.
Şu anda o1-preview ve o1-mini gibi o1 modelinin daha küçük sürümlerine erişimimiz var. Gelecekte, daha karmaşık projeler inşa etmek için çok daha iyi olacak tam o1 modeline de erişebileceğiz. Anahtar nokta, modelden en iyi verimi almak için doğru soruları sormaya odaklanmaktır.
Yapay zekâ modelleriyle bir makine öğrenimi projesi kurmak basit olabilir; ancak bunu bir kariyere dönüştürmek istiyorsanız, bu modellerin nasıl çalıştığını anlamanız gerekir. Aksi takdirde sorunları çözmek veya modelleri belirli iş ihtiyaçlarına uygulamak zor olabilir. Bu anlayışı kazanmak için yeni başlayanlara Machine Learning Scientist with Python kariyer yolunu öneriyoruz. 21 kurs ve 3 projeyle farklı türde makine öğrenimi modellerini nasıl kuracağınızı ve geliştireceğinizi öğretir.

Sertifikalı bir veri bilimcisi olarak, yenilikçi makine öğrenimi uygulamaları oluşturmak için en son teknolojileri kullanmaya büyük ilgi duyuyorum. Konuşma tanıma, veri analizi ve raporlama, MLOps, konuşma yapay zekası ve NLP alanlarında güçlü bir geçmişe sahip olarak, gerçek bir etki yaratabilecek akıllı sistemler geliştirme becerilerimi geliştirdim. Teknik uzmanlığımın yanı sıra, karmaşık kavramları açık ve özlü bir dille ifade etme yeteneğine sahip, becerikli bir iletişimciyim. Sonuç olarak, veri bilimi konusunda aranan bir blog yazarı oldum ve giderek büyüyen veri profesyonelleri topluluğuyla görüşlerimi ve deneyimlerimi paylaşıyorum. Şu anda, içerik oluşturma ve düzenlemeye odaklanıyorum. Büyük dil modelleriyle çalışarak, hem işletmelerin hem de bireylerin verilerinden en iyi şekilde yararlanmalarına yardımcı olabilecek güçlü ve ilgi çekici içerikler geliştiriyorum.



Bu eğitimde, sıfırdan bir su kalitesi sınıflandırıcı uygulaması oluşturacak ve Docker kullanarak buluta dağıtacağız.
OpenAI o1 modelini inceleyerek ve işlevselliğini anlayarak başlayacağız. Ardından modele API ve ChatGPT üzerinden erişecek, o1-preview ve o1-mini sürümlerini deneyip su kalitesi sınıflandırıcı uygulaması için etkili komutlar geliştireceğiz.
Çıktıları aldıktan sonra, o1 modelinin sağladığı kod ve dosyaları proje klasörüne ekleyip Python kodunu yerelde çalıştırarak veri yükleme, ön işleme, eğitim ve değerlendirme adımlarını yürüteceğiz. Son olarak bir FastAPI uygulaması geliştirip Docker kullanarak Hugging Face üzerinde dağıtacağız.
Yapay zekâya yeni başlıyorsanız, AI Fundamentals beceri yolu harika bir başlangıç noktasıdır. ChatGPT ve büyük dil modelleri gibi popüler yapay zekâ konularını öğrenmenize yardımcı olur.
Görsel: Yazar
OpenAI’nin o1 Akıl Yürütme Modeli Nedir?
OpenAI, çok adımlı problemleri, karmaşık matematik denklemlerini ve kodlama sorularını çözmek gibi insan benzeri muhakeme görevlerini yerine getirmek üzere tasarlanmış yeni bir yapay zekâ olan o1 modelini tanıttı.
Zor bir soruya yanıt vermeden önce, o1 bir problemi çözerken düşünce zinciri kullanır. Pekiştirmeli öğrenme yoluyla, o1 düşünce zincirini keskinleştirir ve kullandığı stratejileri rafine eder. Hatalarını tanımayı ve düzeltmeyi öğrenir.
o1 modeli iki varyantta sunulmaktadır: o1-preview ve o1-mini.
o1-preview derin muhakeme gerektiren sorular için, o1-mini ise kodlama ve matematik problemleri için ideal, daha hızlı bir modeldir. Her iki model de ChatGPT Plus ve Team kullanıcılarına açıktır. Seviye 5 bir kuruluş iseniz, OpenAI API üzerinden de erişebilirsiniz.
Modelin mevcut sürümünde, OpenAI’nin ileride eklemeyi planladığı web tarama, dosya yükleme ve Python REPL gibi özellikler bulunmuyor.
Kaynak: Learning to Reason with LLMs | OpenAI
Gördüğümüz gibi, o1-preview ve o1 modelleri yeni ölçütler belirliyor. Matematik ve kodlama yarışmalarında üstün performans sergilediler ve doktora öğrencilerinin bilim sorularını da çözebiliyorlar.
Ayrıntılı analiz ve nasıl çalıştığını ile ölçütlerini derinlemesine öğrenmek için OpenAI o1 Rehberi: Nasıl Çalışır, Kullanım Alanları, API ve Daha Fazlası yazısını okuyun.