
Kursus
Bekerja dengan OpenAI API
3 jam
184.5K
Dalam tutorial ini, kita akan membuat aplikasi pengklasifikasi kualitas air dari nol dan men-deploy-nya ke cloud menggunakan Docker.
Kita akan mulai dengan mengeksplorasi model OpenAI o1 dan memahami fungsionalitasnya. Lalu, kita akan mengakses model melalui API dan ChatGPT, bereksperimen dengan versi o1-preview dan o1-mini, sebelum mengembangkan prompt yang efektif untuk membangun aplikasi pengklasifikasi kualitas air.
Setelah mendapatkan output, kita akan menambahkan kode dan file yang diberikan oleh model o1 ke dalam folder proyek lalu memuat, praproses, melatih, dan mengevaluasi dengan mengeksekusi kode Python secara lokal. Terakhir, kita akan membangun aplikasi FastAPI dan men-deploy-nya di Hugging Face menggunakan Docker.
Jika Anda baru dalam AI, jalur keterampilan AI Fundamentals adalah tempat yang tepat untuk memulai. Ini akan membantu Anda mempelajari topik AI populer seperti ChatGPT dan model bahasa besar.
Gambar oleh Penulis
OpenAI telah memperkenalkan model o1, sebuah AI baru yang dirancang untuk melakukan tugas-tugas penalaran mirip manusia, termasuk menyelesaikan masalah multi-langkah, persamaan matematika yang rumit, dan pertanyaan pemrograman.
Sebelum merespons pertanyaan sulit, o1 menggunakan rantai pemikiran saat mencoba memecahkan masalah. Melalui pembelajaran penguatan, o1 mengasah rantai pemikirannya dan menyempurnakan strategi yang digunakan. Ia belajar mengenali dan mengoreksi kesalahannya.
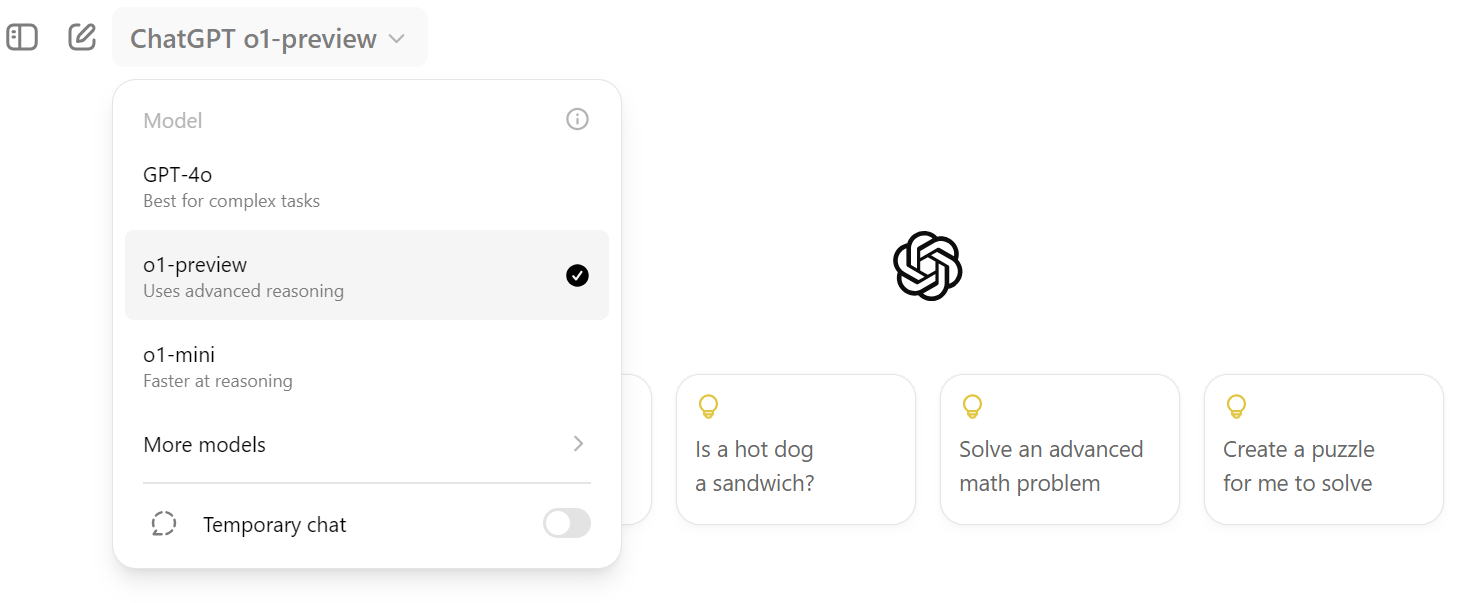
Model o1 tersedia dalam dua varian: o1-preview dan o1-mini.
o1-preview digunakan untuk pertanyaan penalaran mendalam, sementara o1-mini adalah model yang lebih cepat dan ideal untuk masalah pemrograman dan matematika. Kedua model tersedia bagi pengguna ChatGPT Plus dan Team. Jika Anda organisasi tier 5, Anda juga dapat mengaksesnya melalui OpenAI API.
Versi model saat ini belum memiliki fitur seperti penjelajahan web, pengunggahan file, dan Python REPL, yang direncanakan OpenAI untuk ditambahkan pada pembaruan mendatang.
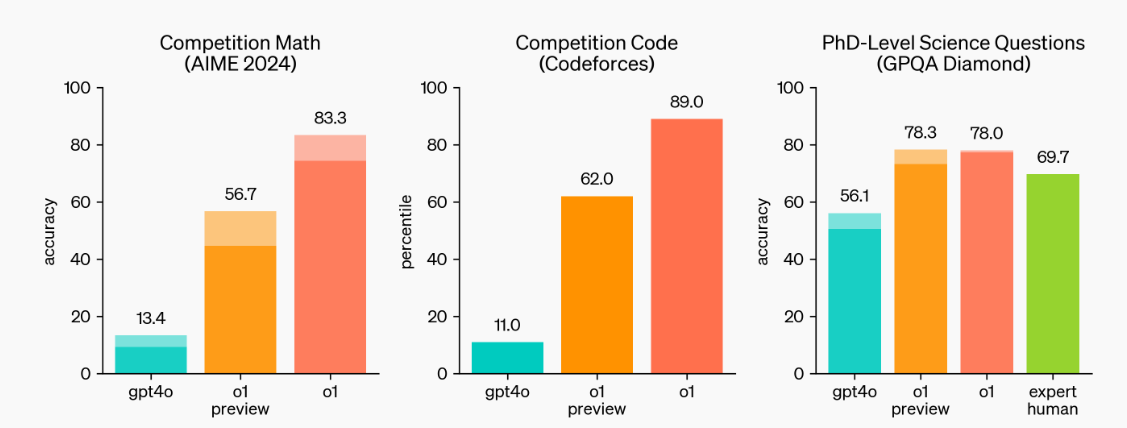
Sumber: Learning to Reason with LLMs | OpenAI
Seperti yang kita lihat, o1-preview dan o1 menetapkan tolok ukur baru. Mereka unggul dalam kompetisi matematika dan pemrograman serta dapat menangani pertanyaan sains tingkat Ph.D.
Baca Panduan OpenAI o1: Cara Kerja, Use Case, API & Lainnya untuk analisis mendalam dan mempelajari cara kerjanya serta tolok ukurnya secara rinci.
Ada banyak model o1 yang mudah diakses, tetapi yang resmi adalah melalui OpenAI API atau menggunakan langganan ChatGPT Plus atau Team.
Pada bagian ini, kita akan mempelajari cara menggunakannya untuk menyelesaikan masalah kompleks.
Jika Anda sudah familiar dengan OpenAI API untuk penyelesaian percakapan, Anda harus mengatur nama model menjadi "o1-preview" dan memberikan prompt yang terperinci. Semudah itu.
from openai import OpenAI
client = OpenAI()

response = client.chat.completions.create(
    model="o1-preview",
    messages=[
        {
            "role": "user",
            "content": "Create an SQL database from scratch, including guides on usage and code everything in Python."
        }
    ]
)

print(response.choices[0].message.content)
Untuk mengaksesnya di ChatGPT, Anda harus mengeklik opsi dropdown pemilihan model dan memilih model “o1-preview”, seperti yang ditunjukkan di bawah.
Prompt untuk model o1 berbeda. Anda harus memberikannya beberapa instruksi atau pertanyaan terperinci untuk sepenuhnya memaksimalkan kemampuannya. Ia dapat memproses instruksi yang panjang dan kompleks untuk menghasilkan jawaban optimal.
Menghitung pajak untuk bisnis freelance di Eropa dapat menjadi kompleks. Kita akan menggunakan model o1 untuk menentukan kewajiban pajak kita kepada pemerintah Spanyol.
Prompt: “Saya seorang freelancer di Spanyol yang bekerja untuk perusahaan berbasis di AS. Selama setahun terakhir, saya memperoleh 120.000 USD, dan saya perlu menghitung jumlah pajak yang harus saya bayar. Harap pertimbangkan bahwa saya pindah ke Spanyol 8 bulan yang lalu.”
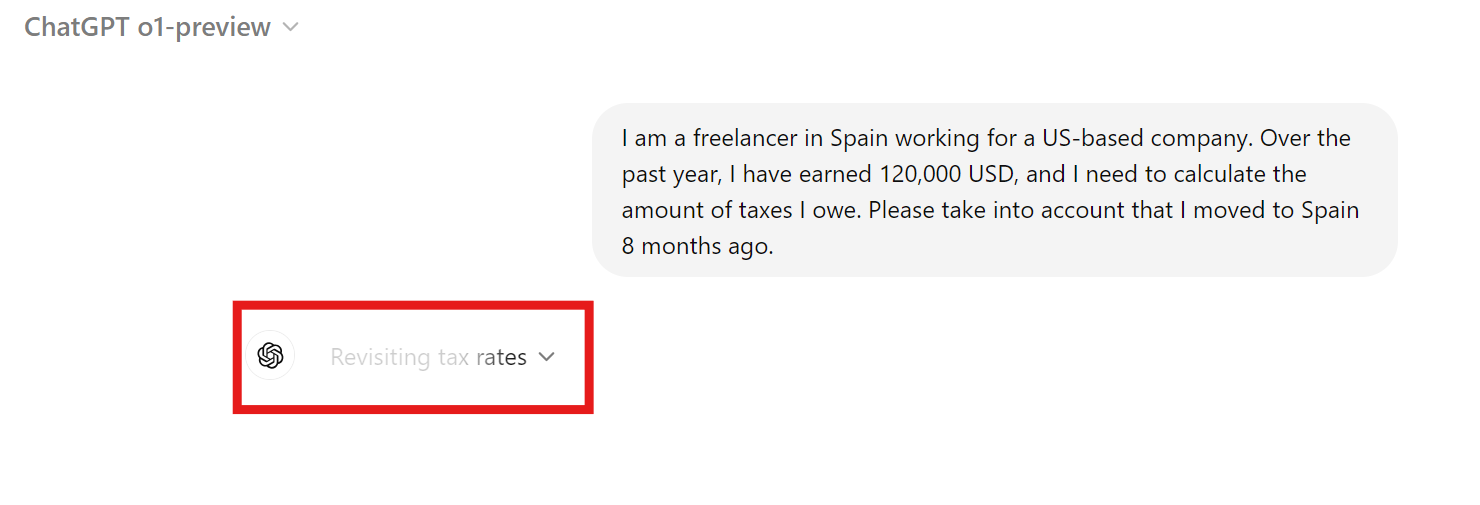
Butuh hampir 30 detik untuk merespons, tetapi jawabannya terperinci. Tercakup persamaan matematika, informasi pajak, dan semua detail yang diperlukan untuk menentukan berapa banyak yang harus kita bayarkan kepada pemerintah Spanyol.
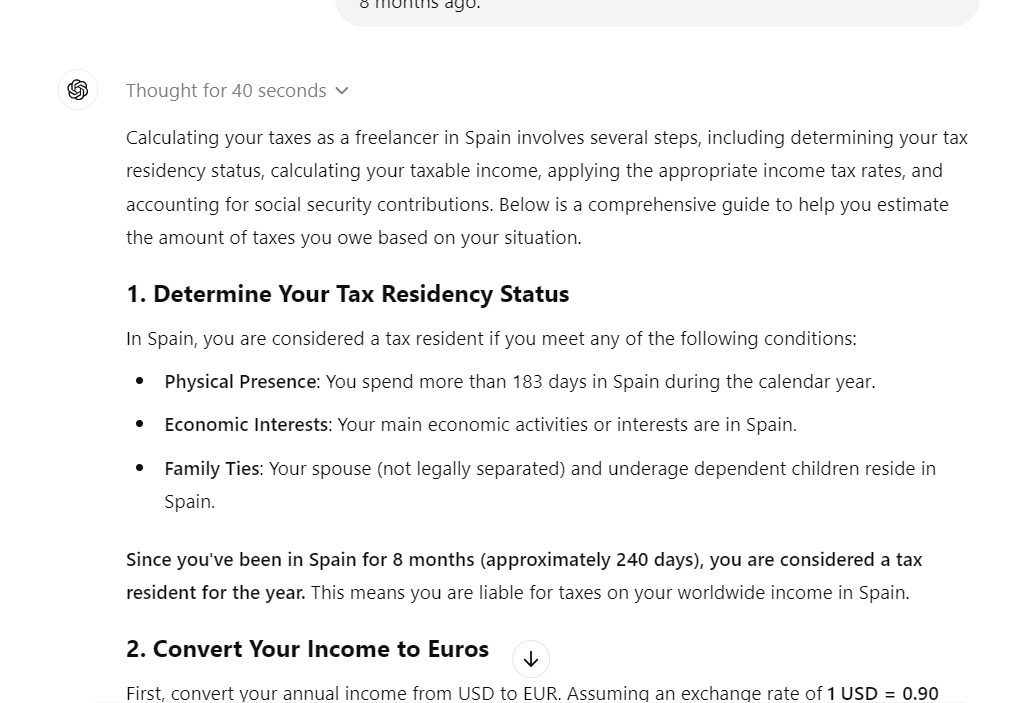
Respons dibagi menjadi bagian-bagian berikut:
Meninjau bagian ringkasan memberi kita perkiraan jumlah pajak yang terutang ke pemerintah, yang cukup membantu.
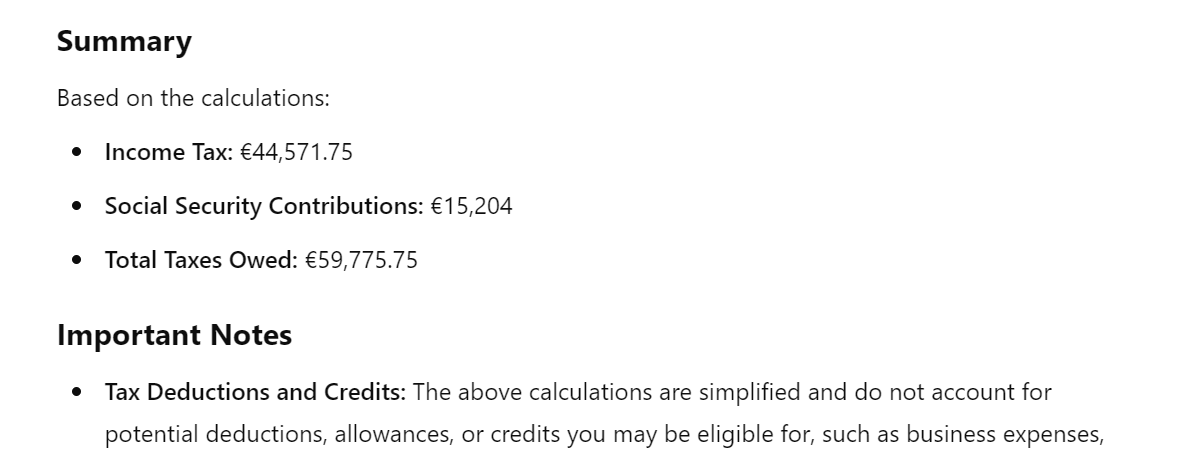
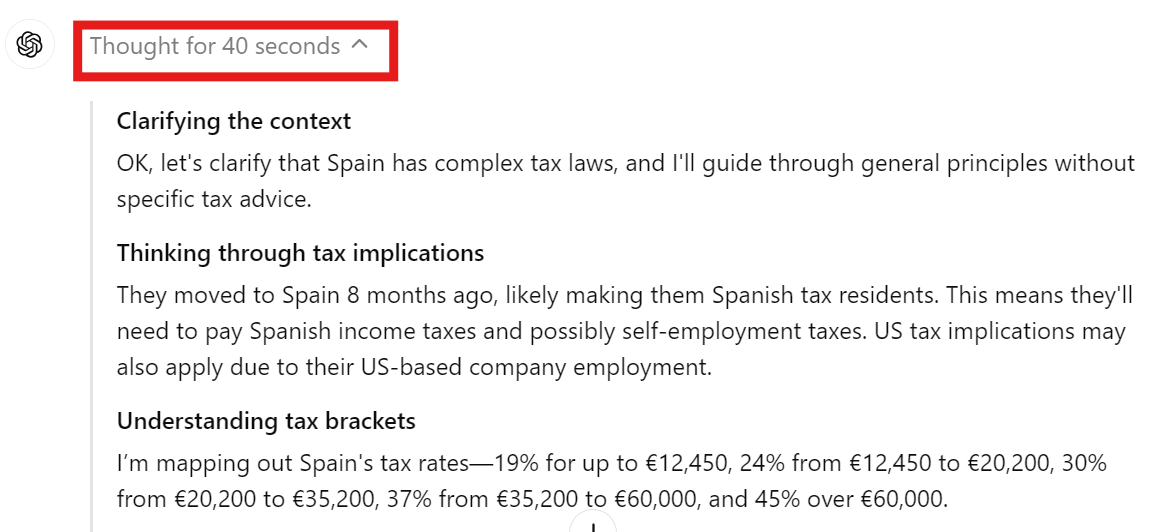
Anda dapat mengeklik menu drop-down pada respons chat untuk melihat rantai pemikiran dan pengambilan keputusan.
Kita dapat melihat bahwa model memahami konteks, implikasi pajak, dan golongan pajak sebelum menjawab pertanyaan Anda.
Model o1-mini kurang akurat tetapi lebih cepat daripada model o1-preview. Dalam kasus kita, kita akan menggunakan model ini untuk membuat situs web statis untuk resume data science.
Prompt: “Tolong buatkan situs web statis untuk resume data science saya menggunakan kerangka kerja Python.”
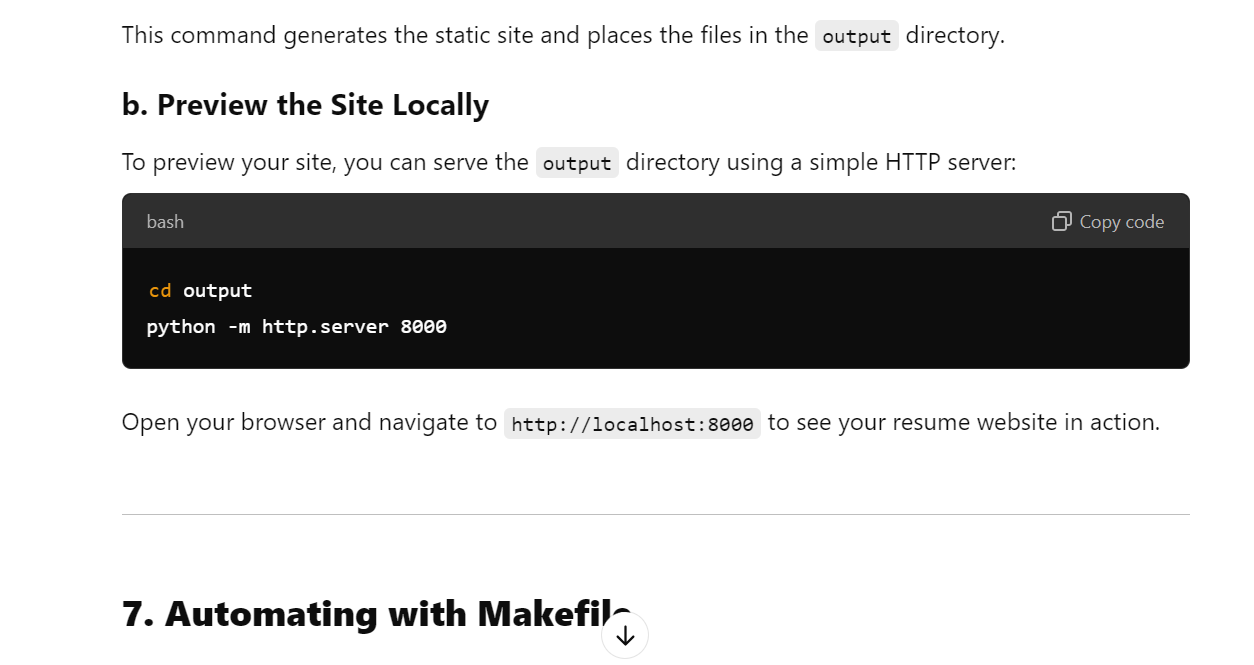
Tidak hanya membuat situs resume yang sesuai, model ini juga memberi kita panduan tentang cara memublikasikannya di GitHub Pages secara gratis.
Respons dibagi menjadi bagian-bagian berikut:
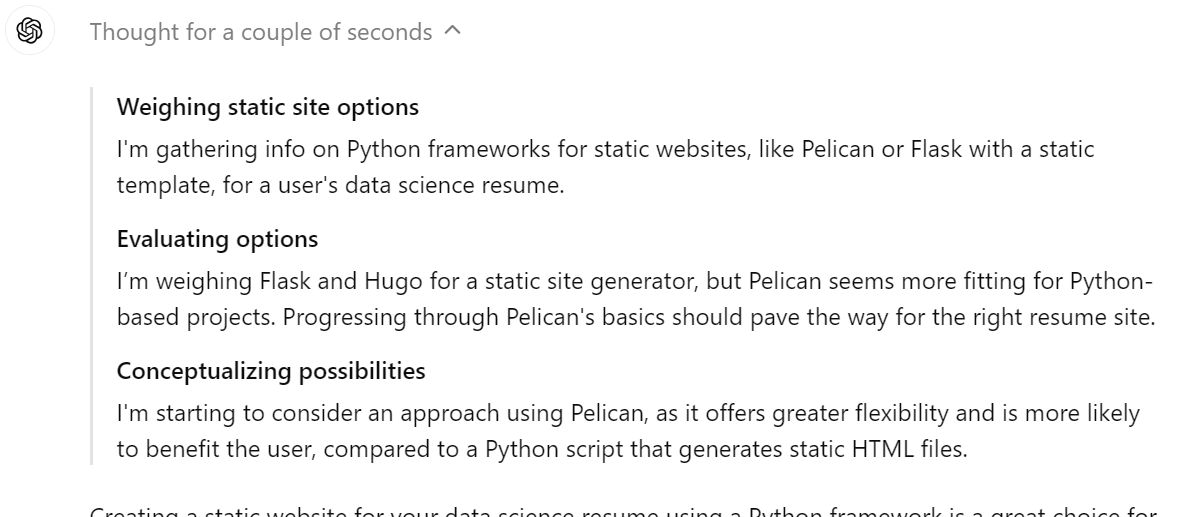
Fitur untuk menampilkan rantai pemikiran pada respons sangat bagus. Kita dapat melihat dengan jelas bahwa model mempertimbangkan penggunaan Pelican, Flask, atau Hugo sebagai kerangka web. Pada akhirnya, ia memilih solusi terbaik.
Dalam proyek ini, kita akan menggunakan model o1-preview untuk membangun dan men-deploy aplikasi klasifikasi kualitas air. Ini adalah proyek yang cukup kompleks, karena kita akan memberikan deskripsi mendetail tentang apa yang kita cari.
Jika Anda tertarik membangun proyek data science menggunakan ChatGPT, lihat Panduan Menggunakan ChatGPT untuk Proyek Data Science. Anda akan mempelajari cara menggunakan ChatGPT untuk perencanaan proyek, analisis data, prapemrosesan data, pemilihan model, penyetelan hiperparameter, pengembangan aplikasi web, dan deployment.
Kita akan menghabiskan lebih banyak waktu pada prompt engineering, karena kita ingin memastikan semua arahan proyek diberikan kepada model.
Prompt dibagi menjadi tiga bagian:
Baca A Beginner's Guide to ChatGPT Prompt Engineering untuk mempelajari cara menulis prompt yang tepat di ChatGPT dan menghasilkan hasil yang diperlukan. Prompt engineering adalah sebuah seni, dan dengan hadirnya model o1, menjadi semakin penting untuk dipelajari.
Prompt: “Manajer proyek saya menugaskan kami untuk mengembangkan aplikasi Kualitas Air menggunakan dataset Kaggle yang tersedia di https://www.kaggle.com/datasets/adityakadiwal/water-potability. Harap berikan semua informasi yang diperlukan tentang file, paket Python, dan kode agar kami dapat membangun model yang sangat akurat.
Tujuannya adalah mencapai akurasi keseluruhan 90%.
Harap ikuti langkah-langkah untuk membangun proyek:
1. Muat dataset dari Kaggle menggunakan API dan ekstrak ke folder data.
2. Praproses data dan lakukan beberapa analisis data. Simpan gambar dan file analisis di folder metrics.
3. Latih model menggunakan kerangka kerja scikit-learn. Pastikan Anda melacak eksperimen dan menyimpan file model serta metadata. Simpan model menggunakan pustaka skops.
4. Lakukan evaluasi model secara rinci dan simpan hasilnya.
5. Buat aplikasi FastAPI yang mengambil gambar dari pengguna dan memprediksi kualitas air.
6. Pastikan menambahkan antarmuka pengguna menggunakan template Jinja2.
7. Deploy aplikasi di Hugging Face hub menggunakan opsi Docker.”
Respons yang dihasilkan telah memberikan kita semua informasi yang dibutuhkan untuk memuat data, mempraprosesnya, melatih dan mengevaluasi model, membuat aplikasi FastAPI, membuat antarmuka pengguna, dan men-deploy-nya.
Masalahnya adalah informasinya terfragmentasi dan kita ingin model membuatkan file Python dan HTML agar kita hanya perlu menyalin dan menempelkan kode.
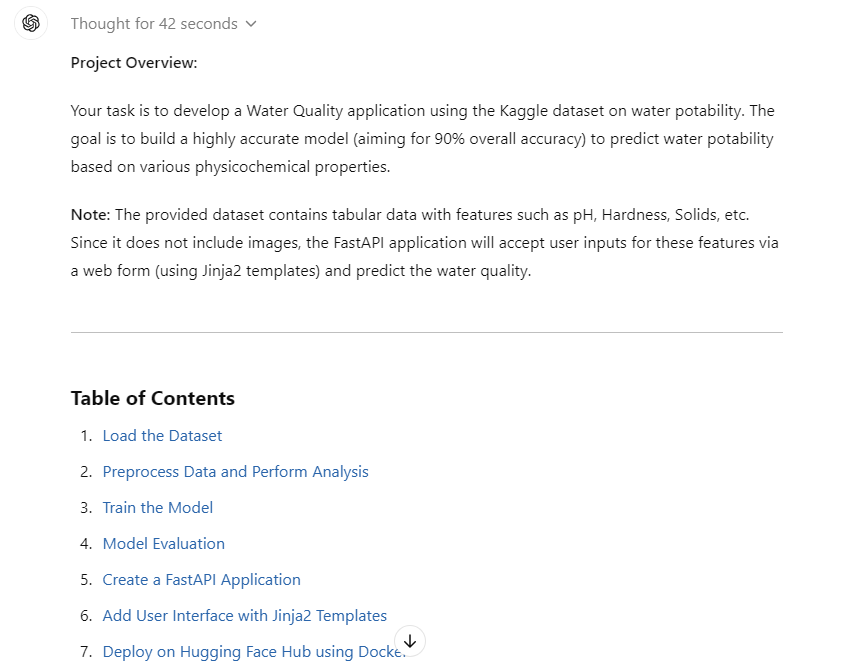
Sekarang kita akan mengonversi semua kode menjadi file Python dan HTML, sehingga membuat pekerjaan kita makin mudah.
Prompt lanjutan: “Tolong konversi kodenya menjadi file-file Python.”
Seperti yang kita lihat, kita memiliki struktur proyek dengan semua file dan kode di dalamnya. Yang harus kita lakukan hanyalah membuat folder dan file lalu menyalin dan menempelkan kode.
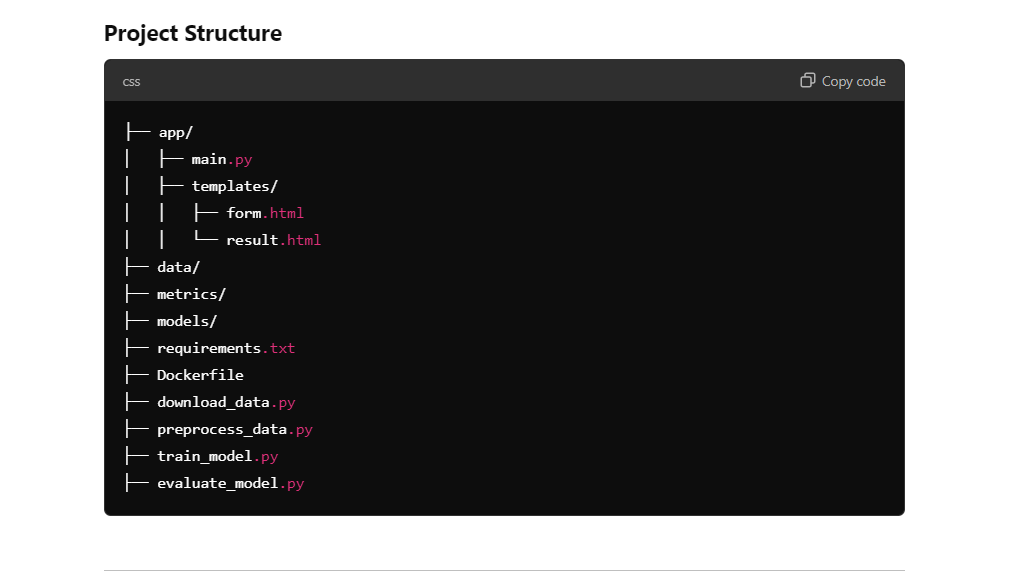
Model o1 menyediakan semua informasi yang diperlukan untuk menyiapkan direktori proyek. Kita hanya perlu membuat folder dan file di dalam direktori proyek menggunakan editor kode.
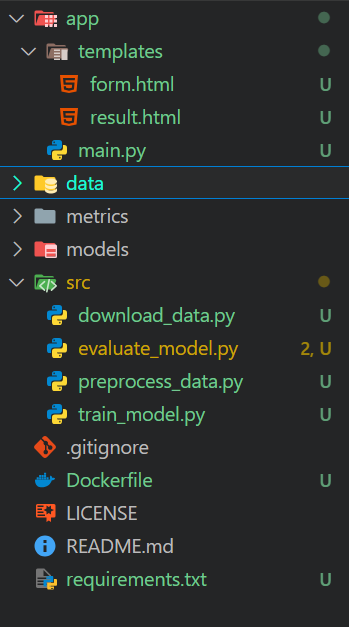
Kita akan membuat folder berikut:
Selain itu, direktori utama akan berisi Dockerfile, README, dan file requirements.txt.
Kita akan memuat dataset Kaggle Water Quality menggunakan Kaggle API dan mengekstraknya ke folder data.
data\download_data.py:
import os

# Ensure the data directory exists
os.makedirs("data", exist_ok=True)

# Download the dataset
os.system("kaggle datasets download -d adityakadiwal/water-potability -p data --unzip")
Menjalankan file Python akan mengunduh dataset, mengekstraknya, dan menghapus file zip-nya.
$ python .\src\download_data.py
Dataset URL: https://www.kaggle.com/datasets/adityakadiwal/water-potability
License(s): CC0-1.0
Downloading water-potability.zip to data
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 304kB/s]
100%|████████████████████████████████████████████████████████████████████████████████| 251k/251k [00:00<00:00, 303kB/s]File Python prapemrosesan akan memuat data, membersihkannya, menangani data hilang, melakukan penskalaan, lalu menyimpan scaler dan dataset yang telah dipraproses. Ia juga akan melakukan analisis data serta menyimpan metrik dan visualisasi data.
data\preprocess_data.py:
import os
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler
import joblib

# Create directories if they don't exist
os.makedirs("metrics", exist_ok=True)
os.makedirs("models", exist_ok=True)

# Load the dataset
data = pd.read_csv("data/water_potability.csv")

# Check for missing values and save the summary
missing_values = data.isnull().sum()
missing_values.to_csv("metrics/missing_values.csv")

# Statistical summary
stats = data.describe()
stats.to_csv("metrics/data_statistics.csv")

# Pair plot
sns.pairplot(data, hue="Potability")
plt.savefig("metrics/pairplot.png")

# Correlation heatmap
plt.figure(figsize=(10, 8))
sns.heatmap(data.corr(), annot=True)
plt.savefig("metrics/correlation_heatmap.png")

# Handle missing values
imputer = SimpleImputer(strategy="mean")
data_imputed = pd.DataFrame(imputer.fit_transform(data), columns=data.columns)

# Feature scaling
scaler = StandardScaler()
features = data_imputed.drop("Potability", axis=1)
target = data_imputed["Potability"]
features_scaled = scaler.fit_transform(features)

# Save the scaler
joblib.dump(scaler, "models/scaler.joblib")

# Save preprocessed data
preprocessed_data = pd.DataFrame(features_scaled, columns=features.columns)
preprocessed_data["Potability"] = target
preprocessed_data.to_csv("metrics/preprocessed_data.csv", index=False)
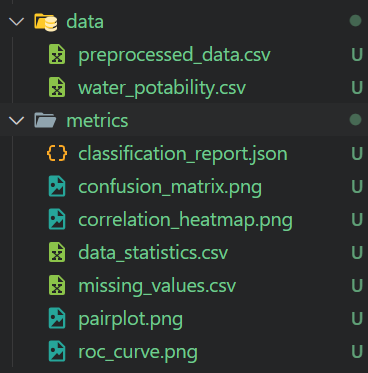
$ python .\src\preprocess_data.py Kita mendapatkan data yang telah dipraproses dan semua laporan analisis data beserta gambar-gambarnya.
Skrip pelatihan memuat data yang sudah dipraproses dan menggunakannya untuk melatih Random Forest Classifier. Skope kemudian digunakan untuk menyimpan model, melacak eksperimen secara manual, dan menyimpan metadata model sebagai file JSON.
src\train_model.py:
import os
import json
import skops.io as sio
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]

# Split the data
X_train, X_test, y_train, y_test = train_test_split(
    features, target, test_size=0.2, random_state=42, stratify=target
)

# Train the model
model = RandomForestClassifier(n_estimators=200, random_state=42)
model.fit(X_train, y_train)

# Save the model using skops
os.makedirs("models", exist_ok=True)
sio.dump(model, "models/water_quality_model.skops")

# Track experiments and save metadata
metadata = {
    "model_name": "RandomForestClassifier",
    "parameters": model.get_params(),
    "training_score": model.score(X_train, y_train),
}

with open("models/metadata.json", "w") as f:
    json.dump(metadata, f, indent=4)
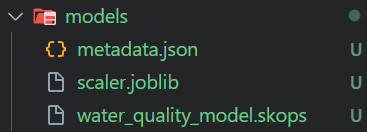
$ python .\src\train_model.py Skrip pelatihan akan menghasilkan file model dan metadata, seperti ditunjukkan di bawah.
Skrip evaluasi model memuat data yang telah diproses dan model tersimpan untuk menghasilkan classification report, confusion matrix, kurva ROC, AUC, dan akurasi keseluruhan. Semua metrik dan gambar disimpan di folder metrics.
src\evaluate_model.py :
import os
import json
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.metrics import (
    classification_report,
    confusion_matrix,
    roc_auc_score,
    roc_curve,
)
import skops.io as sio
from sklearn.model_selection import train_test_split

# Load preprocessed data
data = pd.read_csv("metrics/preprocessed_data.csv")
features = data.drop("Potability", axis=1)
target = data["Potability"]

# Split the data
X_train, X_test, y_train, y_test = train_test_split(
    features, target, test_size=0.2, random_state=42, stratify=target
)

# Load the model
model = sio.load("models/water_quality_model.skops")

# Predictions
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test)[:, 1]

# Classification report
report = classification_report(y_test, y_pred, output_dict=True)
with open("metrics/classification_report.json", "w") as f:
    json.dump(report, f, indent=4)

# Confusion matrix
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d")
plt.title("Confusion Matrix")
plt.ylabel("Actual Label")
plt.xlabel("Predicted Label")
plt.savefig("metrics/confusion_matrix.png")

# ROC curve and AUC
fpr, tpr, _ = roc_curve(y_test, y_pred_proba)
roc_auc = roc_auc_score(y_test, y_pred_proba)

plt.figure()
plt.plot(fpr, tpr, label="AUC = %0.2f" % roc_auc)
plt.plot([0, 1], [0, 1], "k--")
plt.legend(loc="lower right")
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("Receiver Operating Characteristic")
plt.savefig("metrics/roc_curve.png")

# Overall accuracy
accuracy = model.score(X_test, y_test)
print(f"Overall Accuracy: {accuracy * 100:.2f}%")
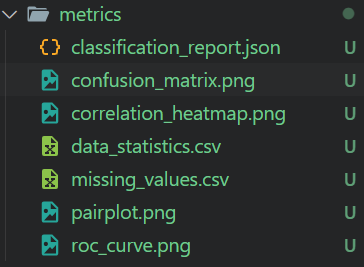
$ python .\src\evaluate_model.py Akurasi keseluruhan belum terlalu bagus. Namun, kita selalu dapat meminta model o1 untuk meningkatkan akurasi.
Overall Accuracy: 65.55%Folder metrics berisi semua gambar dan metrik evaluasi model yang disimpan. Kita dapat meninjaunya secara manual untuk memahami kinerja model secara detail.
Untuk membuat antarmuka pengguna bagi aplikasi FastAPI, kita perlu membuat halaman indeks dan hasil. Ini dapat dilakukan dengan membuat folder template di dalam direktori app dan menambahkan dua file HTML: satu untuk halaman utama dan satu untuk halaman hasil.
Simak Tutorial FastAPI: Pengantar Menggunakan FastAPI untuk mempelajari kerangka kerja FastAPI secara rinci dan cara mengimplementasikannya dalam proyek Anda.
Jika Anda tidak familiar dengan HTML, jangan khawatir. Anda hanya perlu menyalin dan menempelkan kode dan percaya pada model o1.
app\templates\form.html:
<!DOCTYPE html>
<html>
<head>
    <title>Water Quality Prediction</title>
</head>
<body>
    <h2>Enter Water Parameters</h2>
    <form action="/predict" method="post">
        {% for feature in ['ph', 'Hardness', 'Solids', 'Chloramines', 'Sulfate', 'Conductivity', 'Organic_carbon', 'Trihalomethanes', 'Turbidity'] %}
        <label for="{{ feature }}">{{ feature.replace('_', ' ').title() }}:</label><br>
        <input type="number" step="any" id="{{ feature }}" name="{{ feature }}" required><br><br>
        {% endfor %}
        <input type="submit" value="Predict">
    </form>
</body>
</html>
app\templates\result.html:
<!DOCTYPE html>
<html>
<head>
    <title>Prediction Result</title>
</head>
<body>
    <h2>Prediction Result</h2>
    <p>The water is predicted to be: <strong>{{ result }}</strong></p>
    <a href="/">Try Again</a>
</body>
</html>
File Python aplikasi utama memiliki dua fungsi Python: home dan predict. Fungsi "home" menampilkan halaman sambutan yang berisi kotak input dan tombol. Fungsi "predict" mentransformasi input pengguna, menjalankannya melalui model, dan menampilkan hasil yang menunjukkan apakah air layak minum atau tidak.
app\templates\main.py:
from fastapi import FastAPI, Request, Form
from fastapi.responses import HTMLResponse
from fastapi.templating import Jinja2Templates
import numpy as np
import skops.io as sio
import joblib

app = FastAPI()
templates = Jinja2Templates(directory="app/templates")

# Load the saved model and preprocessing pipeline
model = sio.load("models/water_quality_model.skops", trusted=True)
preprocessing_pipeline = joblib.load("models/preprocessing_pipeline.joblib")


@app.get("/", response_class=HTMLResponse)
async def home(request: Request):
    return templates.TemplateResponse("form.html", {"request": request})


@app.post("/predict", response_class=HTMLResponse)
async def predict(
    request: Request,
    ph: float = Form(...),
    Hardness: float = Form(...),
    Solids: float = Form(...),
    Chloramines: float = Form(...),
    Sulfate: float = Form(...),
    Conductivity: float = Form(...),
    Organic_carbon: float = Form(...),
    Trihalomethanes: float = Form(...),
    Turbidity: float = Form(...),
):
    input_data = np.array(
        [
            [
                ph,
                Hardness,
                Solids,
                Chloramines,
                Sulfate,
                Conductivity,
                Organic_carbon,
                Trihalomethanes,
                Turbidity,
            ]
        ]
    )
    # Preprocess input data
    input_preprocessed = preprocessing_pipeline.transform(input_data)
    prediction = model.predict(input_preprocessed)
    result = "Potable" if prediction[0] == 1 else "Not Potable"
    return templates.TemplateResponse(
        "result.html", {"request": request, "result": result}
    )
Kita akan menguji aplikasi secara lokal terlebih dahulu untuk memverifikasi bahwa aplikasi berjalan.
$ uvicorn app.main:app --reload Dengan menjalankan file Python menggunakan uvicorn, kita memperoleh alamat lokal yang dapat disalin dan ditempelkan ke peramban.
Catatan: Semua informasi tentang cara menjalankan file juga disediakan oleh model o1.
INFO:     Will watch for changes in these directories: ['C:\\Repository\\GitHub\\Water-Quality-App']
INFO:     Uvicorn running on http://127.0.0.1:8000 (Press CTRL+C to quit)
INFO:     Started reloader process [34792] using StatReload
Seperti yang kita lihat, aplikasinya berjalan dengan baik.
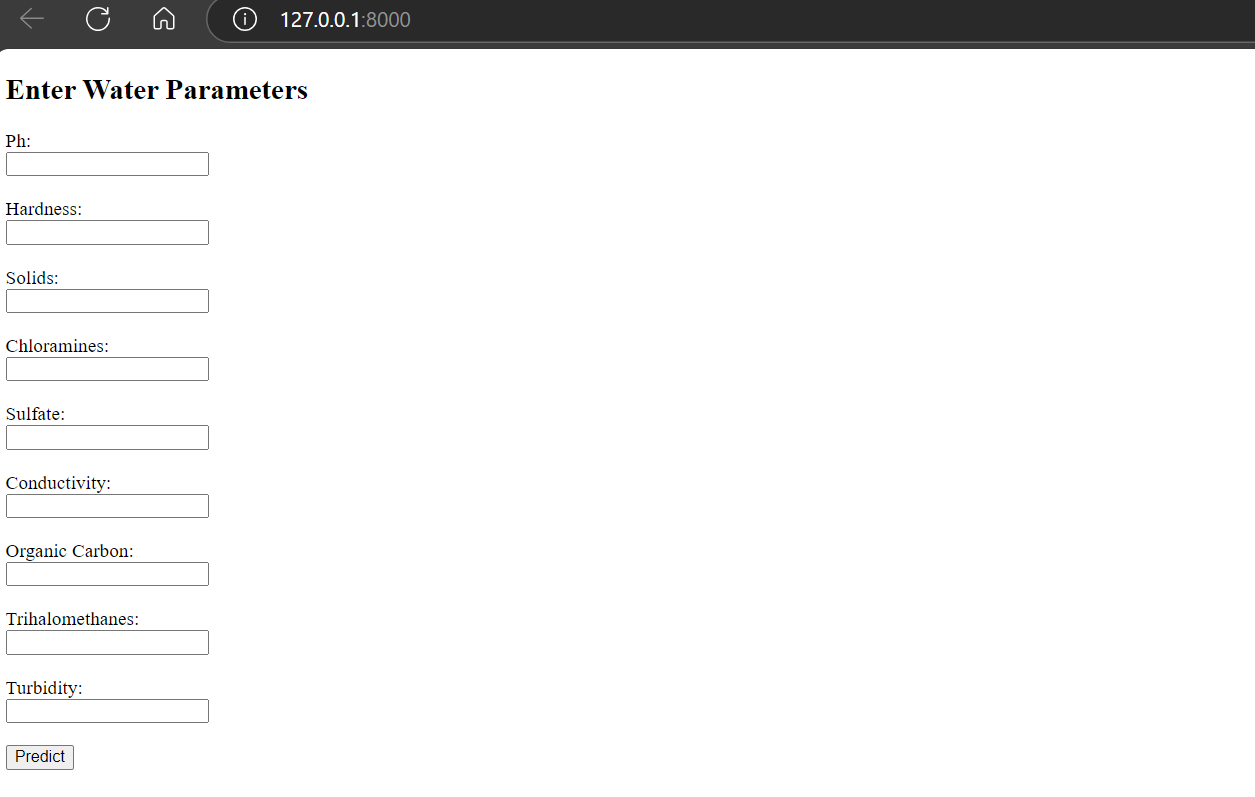
Mari beri nilai acak untuk memeriksa kualitas air dan tekan tombol prediksi.
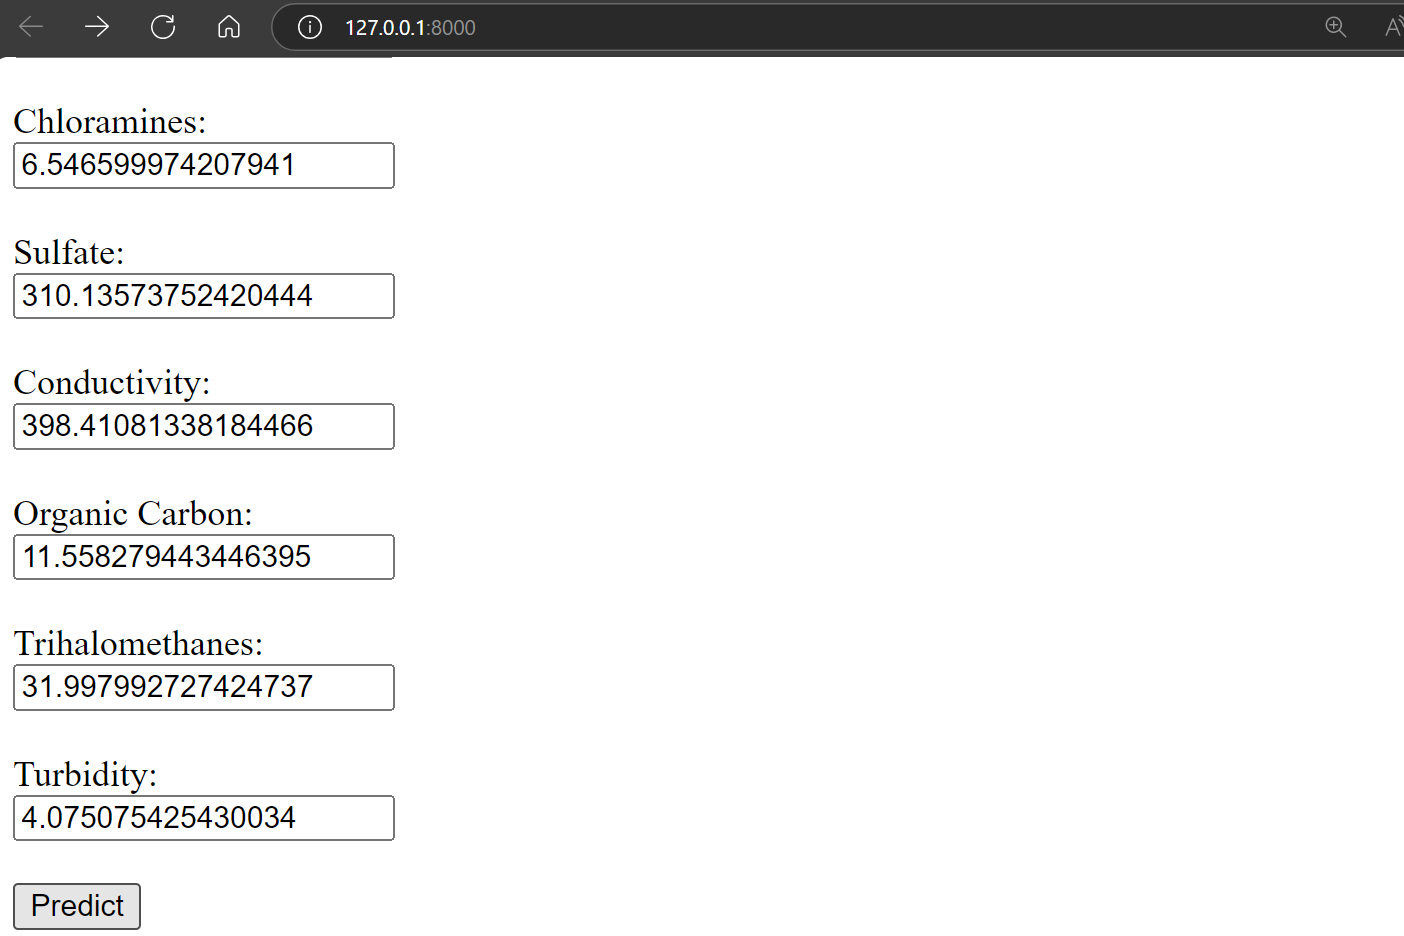
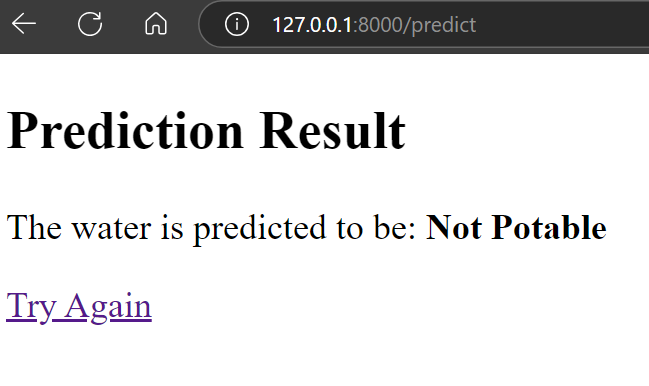
Hasilnya luar biasa. Ditunjukkan bahwa air tidak layak minum.
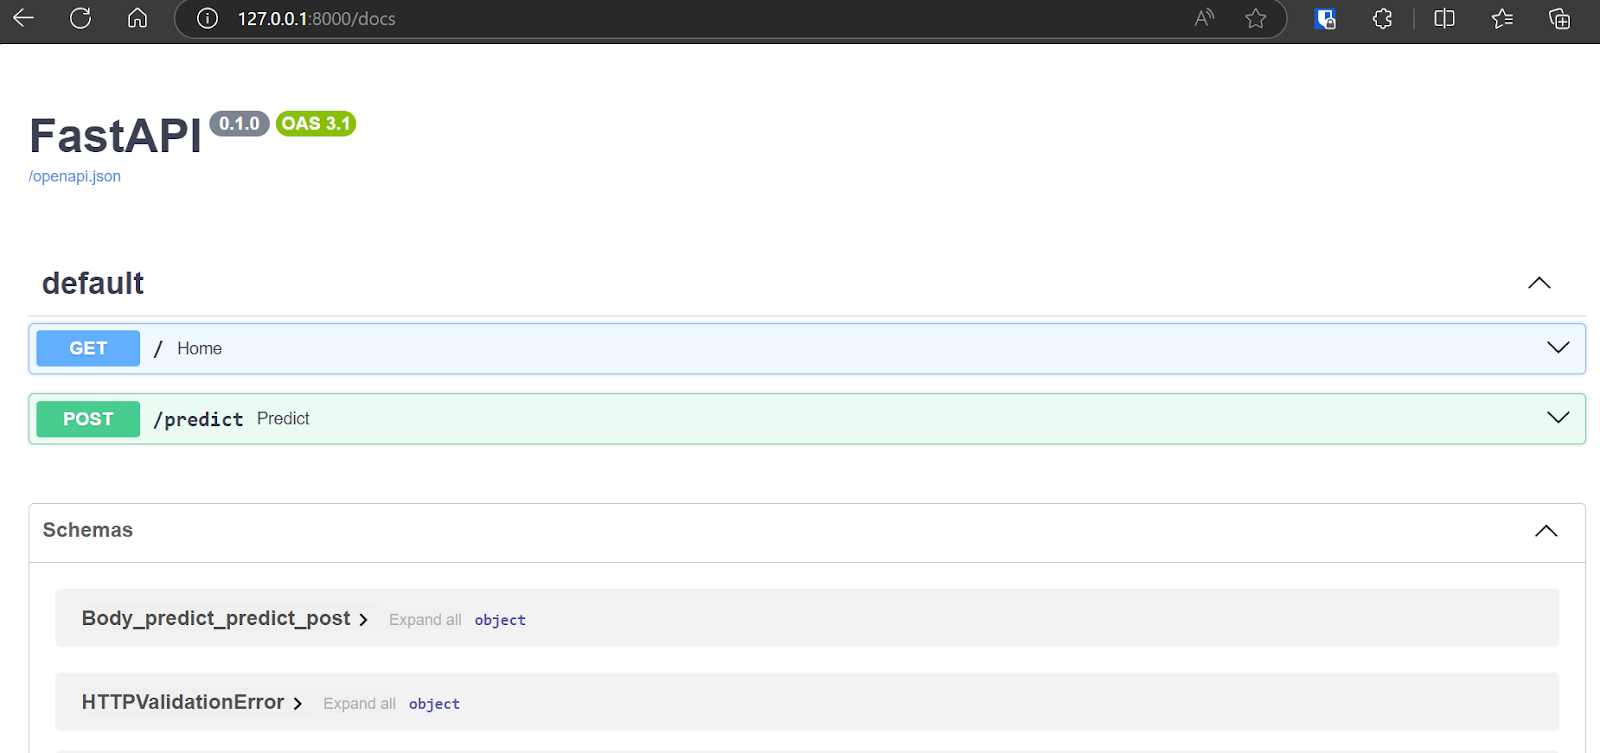
Anda bahkan dapat mengakses FastAPI Swagger UI dengan mengetik “/docs” setelah URL untuk menguji API dan menghasilkan hasil.
Model OpenAI o1 telah menghasilkan kode Docker, panduan, dan tautan referensi agar kita berhasil mempelajari cara men-deploy aplikasi di Hugging Face.
Baca tutorial Docker untuk Data Science: Sebuah Pengantar untuk mempelajari cara kerja Docker. Anda akan mempelajari cara menyiapkan Docker, menggunakan perintah Docker, mendockerisasi aplikasi machine learning, dan mengikuti praktik terbaik di industri.
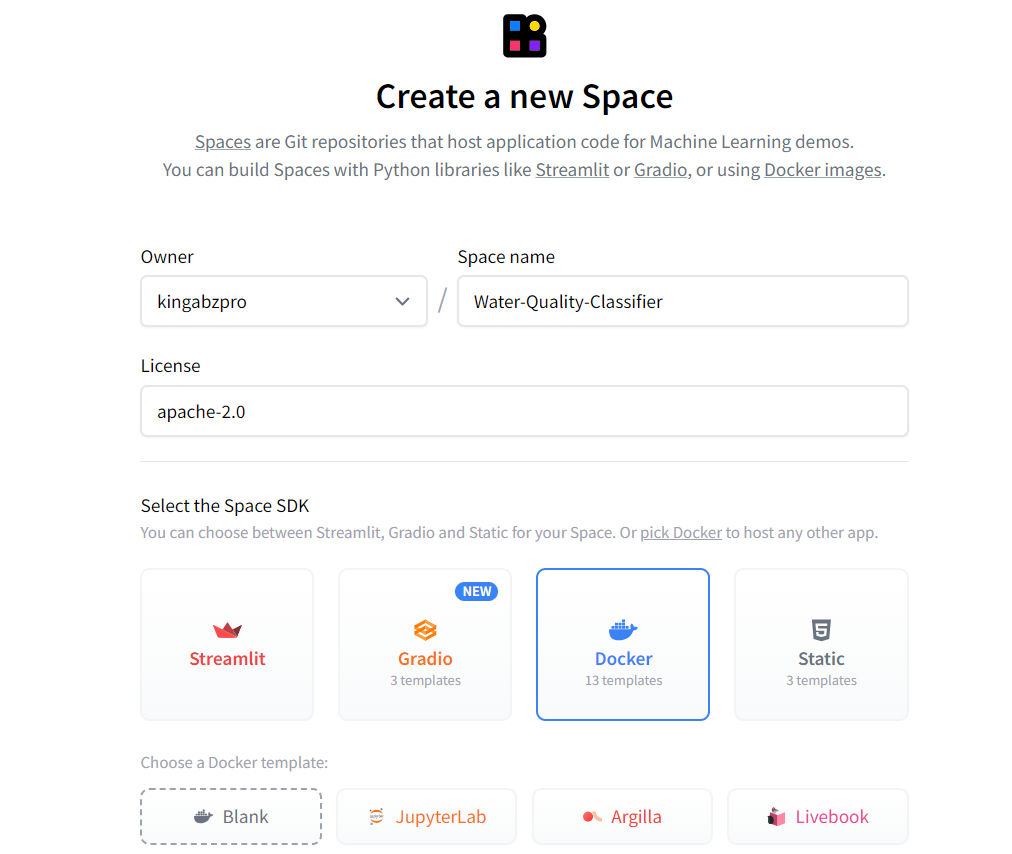
Pertama, buat Space baru dengan mengeklik foto profil di situs Hugging Face lalu mengeklik tombol "New Space". Ketik nama aplikasi, pilih jenis SDK (Docker), pilih jenis lisensi dan tekan “Create Space”.
Sumber: Hugging Face
Semua instruksi untuk men-deploy aplikasi menggunakan Docker disediakan di halaman utama.
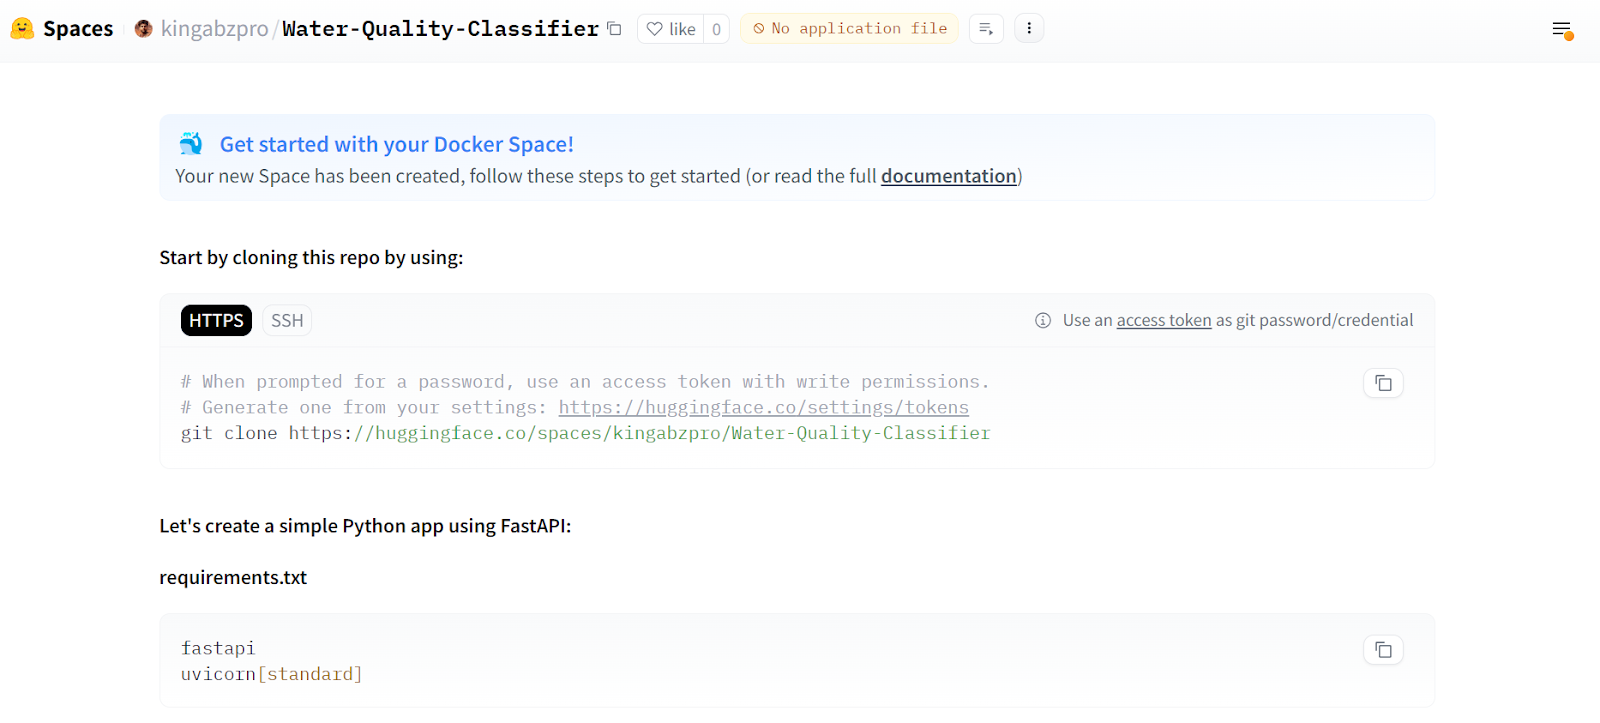
Sumber: Water Quality Classifier
Selanjutnya, kita harus mengkloning repositori.
git clone https://huggingface.co/spaces/kingabzpro/Water-Quality-ClassifierDi dalam repositori, pindahkan folder app dan model. Buat Dockerfile dan ketik perintah berikut. Model o1 telah menyediakan kodenya; kita hanya perlu mengubah nomor port menjadi 7860.
Dockerfile:
# Use an official Python runtime as a parent image
FROM python:3.9-slim

# Set the working directory
WORKDIR /app

# Copy the current directory contents into the container at /app
COPY . /app

# Install any needed packages specified in requirements.txt
RUN pip install --no-cache-dir -r requirements.txt

# Expose port 7860
EXPOSE 7860

# Run the application
CMD ["uvicorn", "app.main:app", "--host", "0.0.0.0", "--port", "7860"]
Buat file requirements.txt yang berisi informasi paket Python. Kita akan menggunakan file ini untuk mengunduh dan memasang semua paket Python yang diperlukan pada server cloud.
requirements.txt:
fastapi
uvicorn
jinja2
pydantic
skops
joblib
numpy
pandas
scikit-learn==1.5.1
matplotlib
seaborn
kaggle
imbalanced-learn
python-multipart
Beginilah tampilan repositori aplikasi kita:
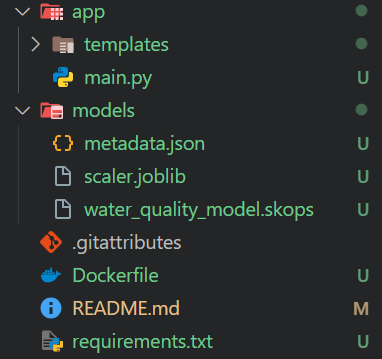
Model kita adalah file besar (> 10MB), jadi kita perlu menggunakan Git LFS untuk melacaknya. Pasang Git LFS dan lacak semua file dengan ekstensi “.skops”.
git lfs install
git lfs track "*.skops"
Stage semua perubahan, lakukan commit dengan pesan, lalu push ke server jarak jauh.
git add .
git commit -m "pushing all the files"
git push
Buka halaman aplikasi Anda di Hugging Face, dan Anda akan melihat bahwa kontainer sedang dibangun dan semua paket yang diperlukan sedang dipasang.
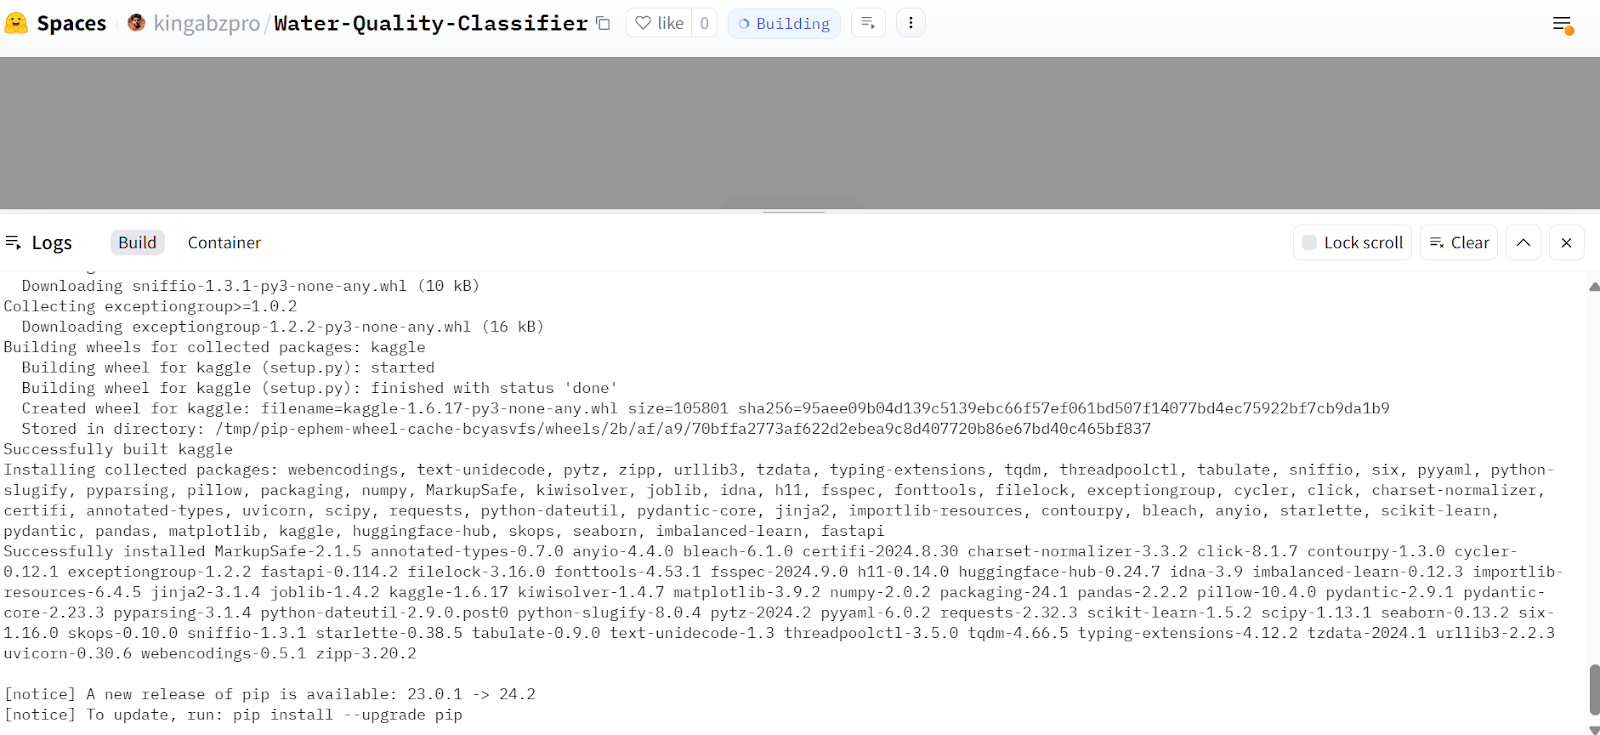
Sumber: Water Quality Classifier
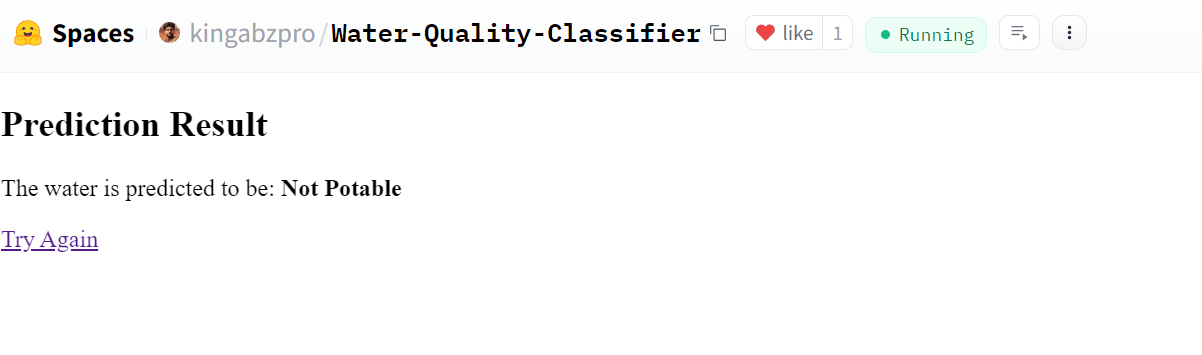
Setelah beberapa menit, aplikasi siap digunakan. Tampilannya mirip dengan aplikasi lokal. Mari coba memberikan nilai contoh dan menghasilkan hasilnya.
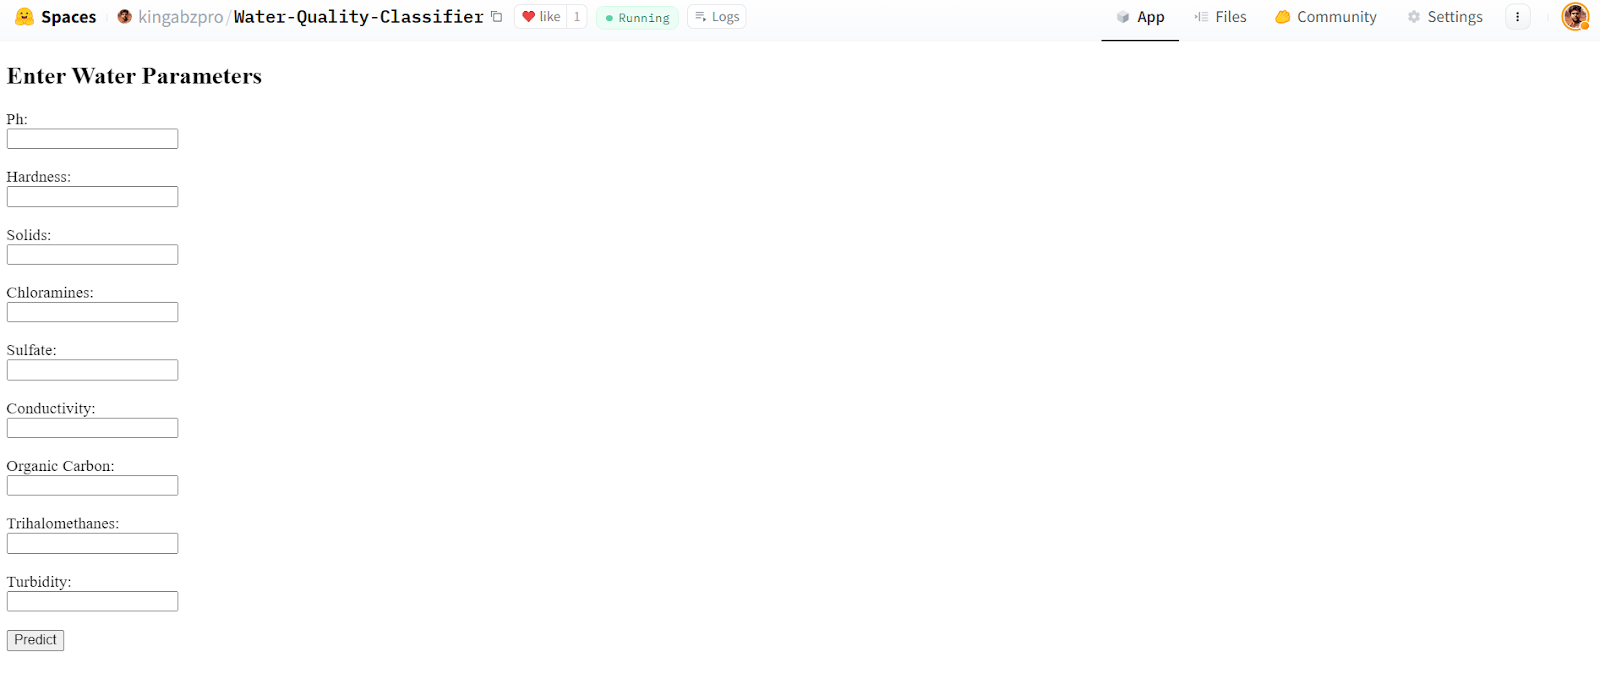
Sumber: Water Quality Classifier
Aplikasi kita bekerja dengan sempurna dan menghasilkan hasil yang diharapkan.
Sumber: Water Quality Classifier
Aplikasi Hugging Face Space ini tersedia untuk siapa pun, yang berarti kita dapat mengaksesnya menggunakan perintah curl di terminal.
curl -X 'POST' \
  'https://kingabzpro-water-quality-classifier.hf.space/predict' \
  -H 'accept: text/html' \
  -H 'Content-Type: application/x-www-form-urlencoded' \
  -d 'Organic_carbon=10&Hardness=200&Turbidity=4&Solids=10000&Chloramines=7&Trihalomethanes=80&Sulfate=300&ph=7&Conductivity=400' \
  | grep -oP '(?<=<strong>).*(?=</strong>)'
Keluaran:
Not PotableSemua file proyek, data, model, dan metadata tersedia di repositori GitHub kingabzpro/Water-Quality-App.
Model o1-preview jauh lebih unggul daripada GPT-4o. Model ini mengikuti instruksi dengan sempurna dan bebas bug, sehingga kode yang dihasilkannya siap digunakan. Saat membangun aplikasi machine learning, saya hanya perlu melakukan perubahan kecil, sekitar 5%. Bagian terbaiknya adalah saya juga belajar dari pengambilan keputusan model AI, memahami mengapa ia membuat pilihan tertentu.
Abid Ali Awan
Kursus Teratas OpenAI
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



