课程
Python 线性建模入门
4 小时
27K
有一类定积分用纸笔推导就是算不出来。这不是您的错。某些函数,如 e^(−x²) 或 sin(x)/x,根本不存在封闭形式的原函数。遇到这种情况,就需要换种思路:在若干精心挑选的点上计算函数值,再将这些值加权组合来估算曲线下的面积。这就是求积。
本文将介绍什么是求积、其通用框架如何运作,以及从直观的中点法到令人惊艳的高斯方法等主要技术。我们还会讨论复合方法、误差来源、自适应策略,以及如何为手头问题挑选合适的方法。
“求积”一词历史悠久,源自经典几何中“作一与给定图形面积相等的正方形”的问题,也就是“求面积”的另一种说法。如今,该术语专指定积分的数值近似。
其核心思想是一种替代:与其寻找精确的原函数,不如在一组称为节点的点 xᵢ 处对函数 f(x) 采样,为每个值乘以相应的权重 wᵢ,然后求和:
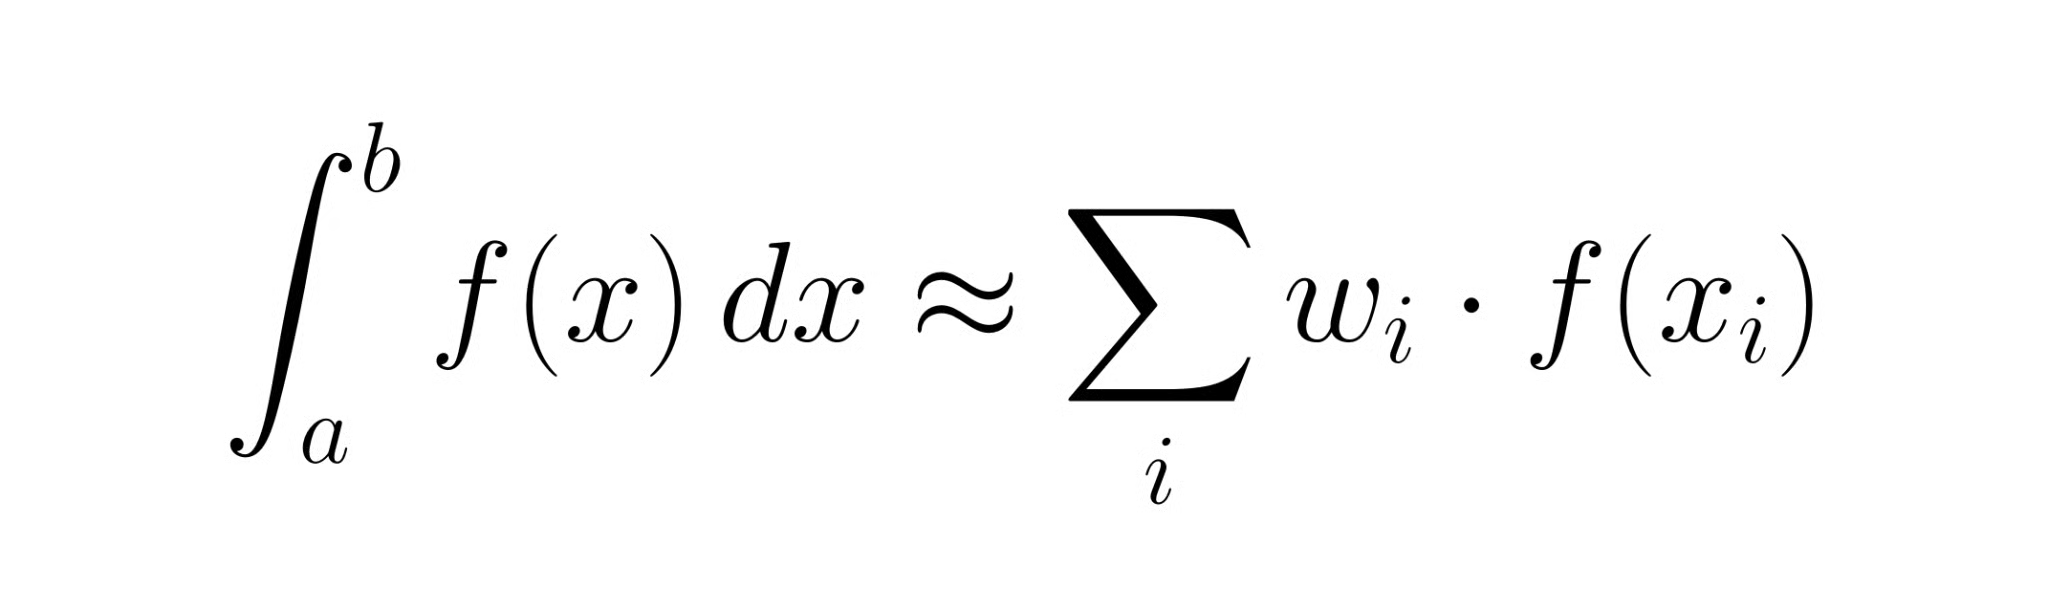
术语“求积”与“数值积分”基本同义。前者更常见于数学语境中;后者是科学计算中的日常用语。
每条求积公式都作用于区间 [a, b]。在该区间内,它选取一组节点 xᵢ,并为每个节点分配一个权重 wᵢ。近似值即是上述加权和。不同方法的区别在于节点如何选取、权重如何分配。就是这样。梯形法、辛普森法和高斯求积都遵循这一同一模板的不同变体。
近似误差是加权和与真实积分之间的差距。每种方法都会引入误差,而随着您增加节点(或缩小子区间)误差收敛的速度,决定了一种方法是“好”还是“更好”。请牢记这一视角:选择求积方法,本质上是在决定如何花费您的函数计算预算。
下列方法从最直观到最精巧依次排列。
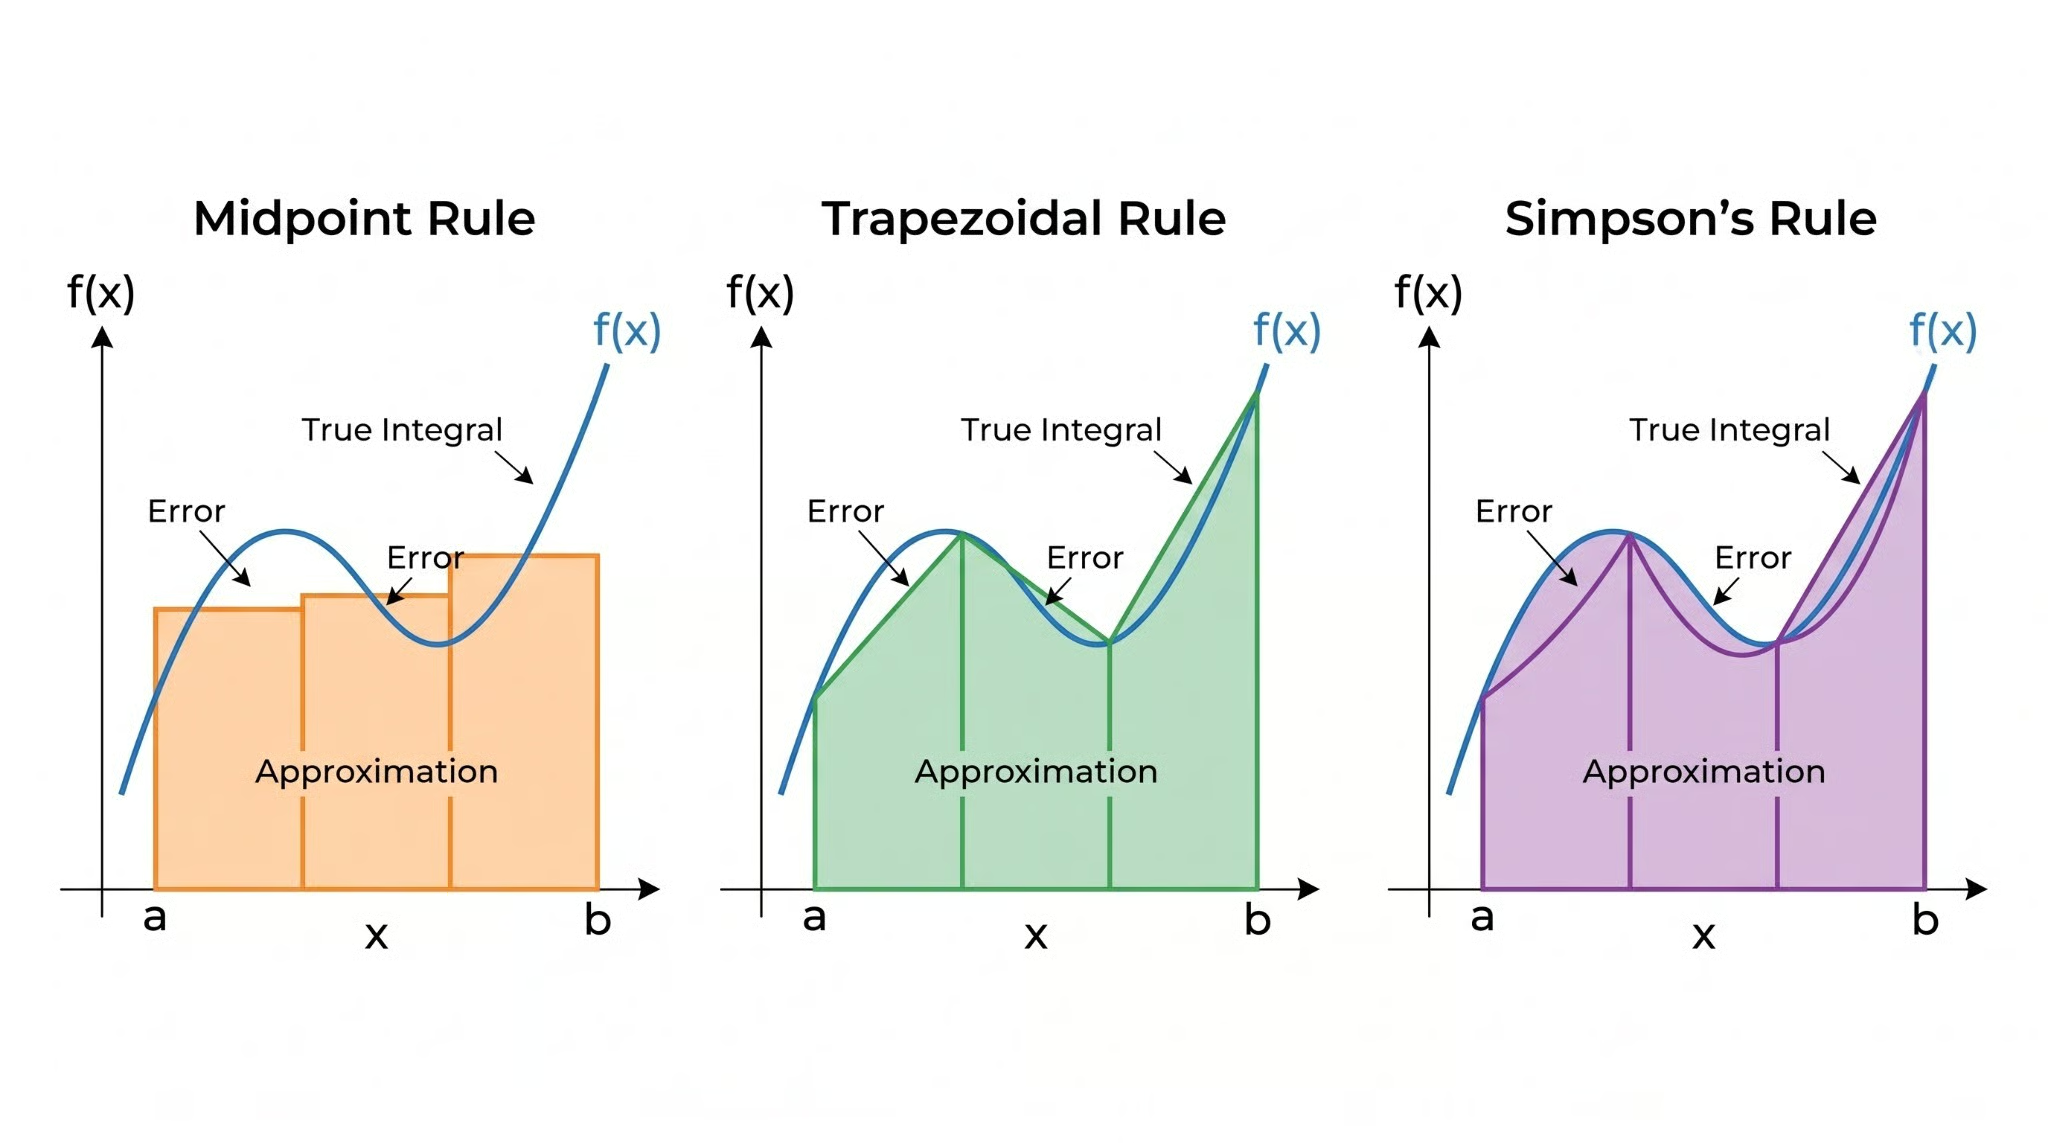 中点法、梯形法与辛普森法的可视化对比。图片来源:作者。
取区间 [a, b] 的中点,在此处计算 f 的值,并乘以区间宽度 (b − a)。其假设是中心处的函数值能代表整个区间的平均水平。
这听起来几乎过于简单,对单个区间来说确实如此。但第一个惊喜是:中点法对常数与线性函数是精确的,其每区间误差尺度为 O(h³),其中 h = b − a。对于光滑函数,这实际上比梯形法更好,这一点常常出乎意料。
使用两个端点而非仅用中心点。用直线连接端点并计算所得梯形的面积:(b − a) · [f(a) + f(b)] / 2。对线性函数精确,每区间误差为 O(h³),与中点法同阶,但常数更大。
梯形法可能是教学最广泛的求积方法,因此名气很大。对性质良好的函数它表现尚可。但在相同计算次数下,复合辛普森法几乎总能做得更好。
通过三点——两个端点与中点——拟合一条二次多项式,并对该多项式进行精确积分:
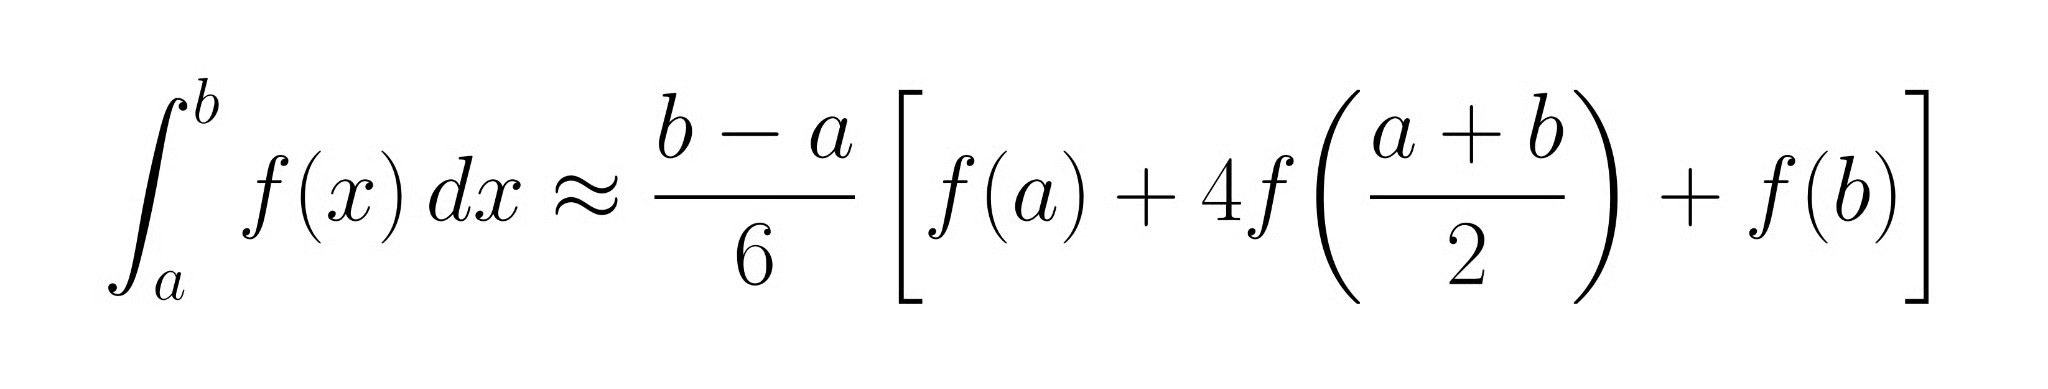
在中心多做一次函数评估会多一次函数调用,但回报很可观:辛普森法对三次及以下多项式精确,每区间误差尺度为 O(h⁵),比梯形法高两个量级。对光滑函数而言,这通常是首选的方法。
精彩之处在这里。中点法、梯形法和辛普森法都使用等间距节点。高斯求积提出不同的问题:如果我们同时选择节点位置与权重,以最大化精度,会怎样?
使用 n 个节点时,高斯求积(具体为高斯-勒让德变体)可对任意次数不超过 2n − 1 的多项式实现精确积分。两个节点即可精确三次式;五个节点可处理九次多项式。节点是勒让德多项式的根,且相较于等距分布,它们更靠近区间两端聚集。 额外精度来自让节点“可移动”,而不是它们“恰好落在哪里”。它们在端点附近的聚集是数学推导的副产物,下面我们会看到原因。
下面比较这四种方法的表现:
|
方法 |
思路 |
每区间误差 |
计算代价 |
最适合 |
|
中点法 |
在中心点评估 |
O(h³) |
每区间 1 次评估 |
简单、光滑的函数 |
|
梯形法 |
线性拟合 |
O(h³) |
每区间 2 次评估 |
周期函数 |
|
辛普森法 |
二次拟合 |
O(h⁵) |
每区间 3 次评估 |
光滑函数 |
|
高斯求积 |
最优节点 + 权重 |
O(h^(2n+1)) |
每区间 n 次评估 |
高精度、光滑函数 |
在整个区间 [a, b] 上只应用一次规则通常不够。标准做法是:将区间分成 n 个等长子区间,宽度为 h = (b − a)/n,并对每个子区间应用基本规则。
对复合梯形法,在 n+1 个等距点上评估 f,并求和得到 n 个梯形的面积。总误差降为 O(h²)。步长减半,误差缩小至四分之一。复合中点法逻辑相同,整体误差阶也相同。
复合版本要求子区间数为偶数。在 n+1 个点上评估 f,可获得 O(h⁴) 的整体误差。步长减半,误差缩小为原来的十六分之一。这也是为何当您需要在光滑函数上取得中等精度时,复合辛普森法常作默认选择。
下方 Python 代码展示了当子区间数增加时,对 ∫[0 到 π] sin(x) dx(精确值:2.0)的近似如何收紧:
import numpy as np

def composite_simpson(func, lower, upper, num_intervals):
    """Approximate integral using composite Simpson's rule."""
    if num_intervals % 2 != 0:
        raise ValueError("num_intervals must be even")
    nodes = np.linspace(lower, upper, num_intervals + 1)
    values = func(nodes)
    h = (upper - lower) / num_intervals
    weights = np.ones(num_intervals + 1)
    weights[1:-1:2] = 4   # odd-indexed interior points
    weights[2:-2:2] = 2   # even-indexed interior points
    return (h / 3) * np.dot(weights, values)

exact = 2.0
for n in [4, 8, 16, 32]:
    approx = composite_simpson(np.sin, 0, np.pi, n)
    print(f"n={n:3d}: approx={approx:.10f}, error={abs(approx - exact):.2e}")
仅用 32 个子区间,误差就降至 10⁻⁶ 以下。这就是 O(h⁴) 收敛。
高斯求积背后的思想值得超过表格的一席之地。
当节点等距分布时,您在花费评估预算的方式未必匹配被积函数的难度分布。有些区域需要更高分辨率;而在平坦区间则浪费了评估。高斯求积通过为可精确积分的多项式次数选择可证明最优的节点来规避这一问题。
对 n 个节点,高斯-勒让德规则选择第 n 个勒让德多项式 Pₙ(x) 的 n 个零点作为节点,再计算权重,使得任意次数 ≤ 2n − 1 的多项式都能被无误差地积分。实践中,numpy.polynomial.legendre.leggauss(n) 可直接返回二者。节点在 [−1, 1](标准参考区间)的端点附近更为密集——这是多项式插值误差往往最大的地方,额外的采样密度在这里最有价值。
当您的函数光滑、解析且需要用很少的评估获得高精度时,高斯求积表现最佳。对性质良好的被积函数,五个高斯-勒让德点就能胜过使用几十个子区间的复合辛普森法。但对于存在折点、不连续,或只能在固定等距点获得数据的函数,它却并不合适。在这些情况下,精心选择的节点反而会“对着干”。
没有任何数值方法能免疫误差。每个求积结果都受到两类不同误差的影响,理解它们对判断结果可靠性至关重要。
误差来源包括:
函数的光滑性、区间宽度与方法选择都会影响离散化误差。具有尖锐特征的“粗糙”函数需要更多子区间或自适应方法。
当被积函数在大多数地方很平滑、但在少数区域较复杂时,均匀网格会浪费评估次数。
先对一个区间应用某条求积规则,再应用更高阶的规则(或在两半区间上应用同一规则)并做对比。两者之差估计局部误差。若低于容差,则接受该区间;否则将其二分,并在每一半上递归。重复此过程,直到所有子区间都满足容差。
当被积函数具有孤立特征时(狭窄峰值、折点、被平滑区域包围的快速震荡),相较于均匀细化,自适应方法能带来巨大的效率提升。它们将评估精准投向函数真正需要的地方。
在 Python 中,scipy.integrate.quad() 实现了自适应高斯求积(具体为 QUADPACK 的 DQAGSE 算法)。传入函数与积分上下限;返回估计值及误差上界。对大多数一维积分而言,这是无需手工调参的正确工具。
from scipy import integrate
import numpy as np

# Integrate a function with a peak near x=0.5
def peaked_func(x):
    return np.exp(-100 * (x - 0.5)**2)

result, error_bound = integrate.quad(peaked_func, 0, 1)
print(f"Estimate: {result:.10f}")
print(f"Error bound: {error_bound:.2e}")
quad() 能很好地处理这个窄峰。若用均匀的辛普森法,要匹敌它需要数百个子区间。
在 Python 中,除非有特殊原因,否则对一维积分首选 scipy.integrate.quad()。它自适应、精确且经过充分测试。下述内容在您需要自行实现、缺乏良好自适应库的语言环境,或要针对特定情形优化时尤为相关。
求积并非孤立存在。理解它相对于您可能考虑的其他工具所处的位置会有所帮助。
解析积分寻找精确原函数;求积近似一个数值。若存在且能找到精确原函数,就应使用它。当精确积分不可能或不现实时,求积就派上用场。
二者都近似定积分,但方式不同。求积是确定性的:在预先选定的固定节点处评估 f,收敛速度取决于函数光滑性与节点数量。蒙特卡罗通过随机采样并取平均,误差按 O(1/√N) 缩减,且与维度无关。在低维中它收敛较慢,但因其与维度无关的特性,使其在约五维以上成为更可行的选择。
某些求积规则(包括辛普森法)通过在评估点上拟合多项式并对其精确积分来工作。但其目标不同于插值。插值旨在重建函数;求积只追求一个数值。多项式是工具,而非输出本身。
求积之所以令人满意,在于其背后一条组织性思想能发挥巨大作用。本文涉及的每种方法——中点法、梯形法、辛普森法与高斯求积——其实都是对同一问题的不同回答:在有限的函数评估预算下,应该把评估点放在哪里,并如何加权?
通过在评估点上拟合更好的多项式,可以快速降低误差;将节点选择为最优位置,又能在同样预算下进一步榨取精度;随后自适应方法将这些思路融合,把评估投入到函数真正需要的地方。
在 Python 中,scipy.integrate.quad() 是一维问题的正确默认选项。本文其余内容旨在帮助您理解其底层原理,或在需要自行实现时提供指导。若您想继续用 SciPy 提升数值技能,欢迎学习我们的 Introduction to Optimization in Python 课程。
与 DataCamp 一起学习
课程
课程
学习路径