คอร์ส
Introduction to Linear Modeling in Python
4 ชม.
27K
มีอินทิกรัลจำกัดบางประเภทที่คำนวณด้วยแคลคูลัสบนกระดาษอย่างไรก็ไม่ยอมออกผล ไม่ใช่เพราะทำผิดอะไร เพียงแต่ฟังก์ชันบางตัว เช่น e^(−x²) หรือ sin(x)/x ไม่มีปริพันธ์ปริยายในรูปปิดเลย เมื่อเป็นเช่นนั้น ต้องเปลี่ยนวิธีคิด: ประเมินค่าฟังก์ชันที่จุดไม่กี่จุดที่เลือกอย่างระมัดระวัง แล้วรวมค่าเหล่านั้นเพื่อประมาณพื้นที่ใต้กราฟ นั่นคือควอดราเจอร์
บทความนี้อธิบายว่าควอดราเจอร์คืออะไร กรอบวิธีทั่วไปทำงานอย่างไร และวิธีหลักๆ ตั้งแต่กฎจุดกึ่งกลางที่เข้าใจง่ายไปจนถึงวิธีเกาส์ที่แม่นยำอย่างน่าประหลาดใจ นอกจากนี้ยังครอบคลุมวิธีเชิงประกอบ แหล่งที่มาของความคลาดเคลื่อน กลยุทธ์แบบปรับตัว และแนวทางเลือกวิธีให้เหมาะกับปัญหาที่อยู่ตรงหน้า
คำว่า "ควอดราเจอร์" มีที่มาช้านาน มาจากปัญหาเรขาคณิตคลาสสิกของการสร้างสี่เหลี่ยมจัตุรัสที่มีพื้นที่เท่ากับรูปทรงที่กำหนด ซึ่งก็เท่ากับการ "หาพื้นที่" ในปัจจุบัน คำนี้หมายถึงการประมาณค่าอินทิกรัลจำกัดด้วยวิธีเชิงตัวเลข
แก่นไอเดียคือการแทนที่: แทนที่จะหาปริพันธ์ปริยายแบบ exact ให้ทำการสุ่มตัวอย่างฟังก์ชัน f(x) ที่ชุดจุดซึ่งเรียกว่าโหนด แล้วคูณแต่ละค่าด้วยน้ำหนักที่กำหนด จากนั้นรวมผลลัพธ์เข้าด้วยกัน:
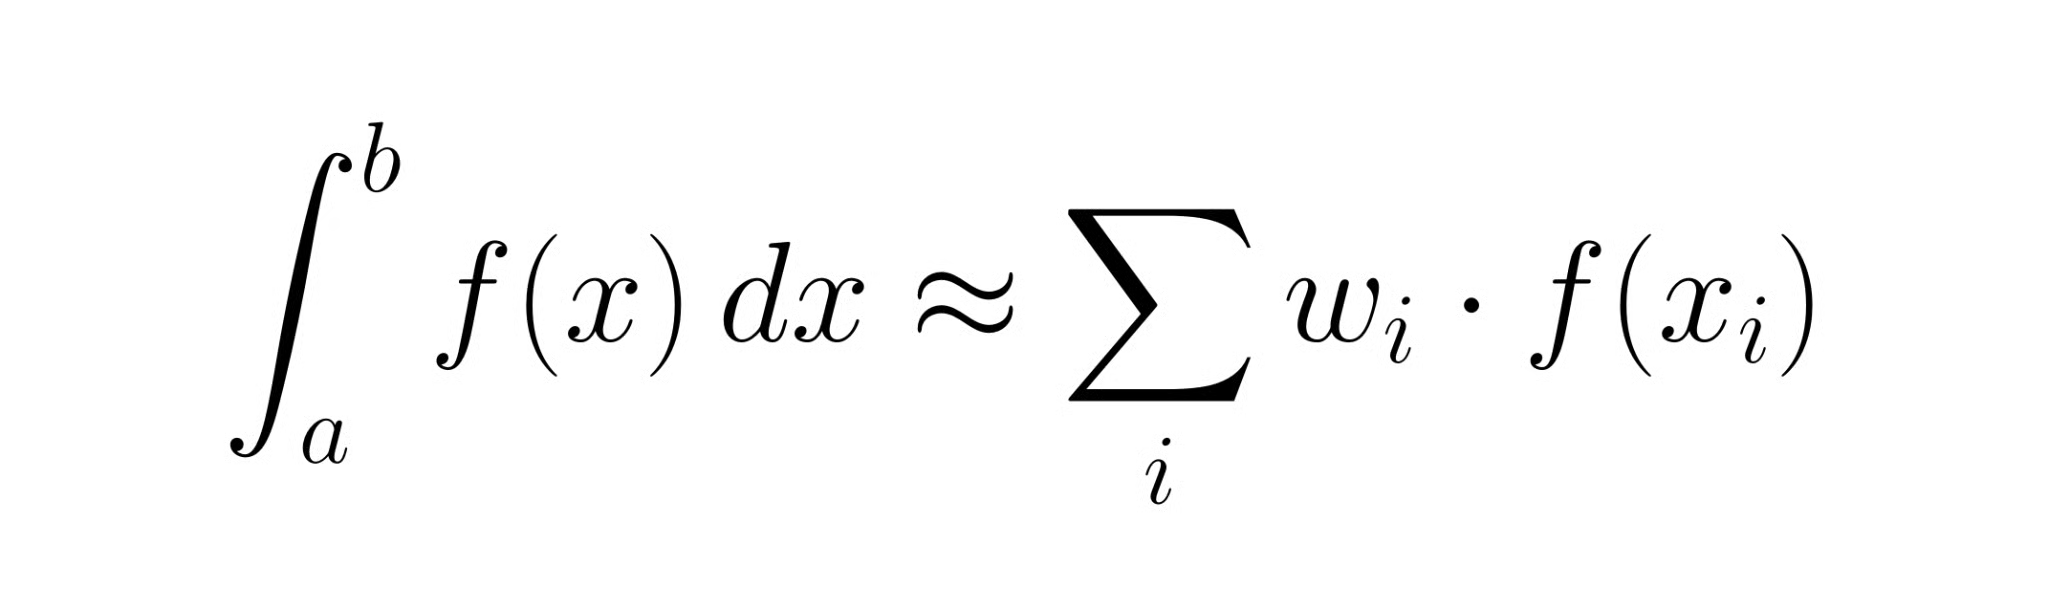
คำว่า ควอดราเจอร์ กับ การอินทิเกรตเชิงตัวเลข มีความหมายแทบไม่ต่างกัน คำว่าควอดราเจอร์มักใช้ในบริบททางคณิตศาสตร์มากกว่า ส่วนการอินทิเกรตเชิงตัวเลขเป็นคำที่ใช้ทั่วไปในงานคอมพิวติ้งเชิงวิทยาศาสตร์
ทุกกฎควอดราเจอร์ทำงานบนช่วง [a, b] ภายในช่วงนี้จะเลือกชุดโหนด xᵢ และกำหนดน้ำหนัก wᵢ ให้แต่ละโหนด การประมาณคือผลรวมถ่วงน้ำหนักดังกล่าว ความแตกต่างของแต่ละวิธีอยู่ที่ตำแหน่งโหนดและการกำหนดน้ำหนัก แค่นั้นเอง กฎคางหมู กฎของซิมป์สัน และควอดราเจอร์แบบเกาส์ ล้วนเป็นรูปแบบตามแม่แบบเดียวกันนี้
ความคลาดเคลื่อนจากการประมาณคือช่องว่างระหว่างผลรวมถ่วงน้ำหนักกับค่าอินทิกรัลจริง ทุกวิธีต่างก่อให้เกิดความคลาดเคลื่อน และอัตราที่ความคลาดเคลื่อนยุบตัวเมื่อเพิ่มจำนวนโหนด (หรือทำให้ช่วงย่อยแคบลง) คือสิ่งที่แยกวิธีที่ดีออกจากวิธีที่ยอดเยี่ยม ควรมองกรอบนี้ไว้: การเลือกวิธีควอดราเจอร์แท้จริงแล้วคือการเลือกว่าจะใช้สิทธิ์ประเมินค่าฟังก์ชันอย่างไรให้คุ้มที่สุด
ลำดับวิธีด้านล่างเรียงจากที่เข้าใจได้ง่ายที่สุดไปจนถึงซับซ้อนที่สุด
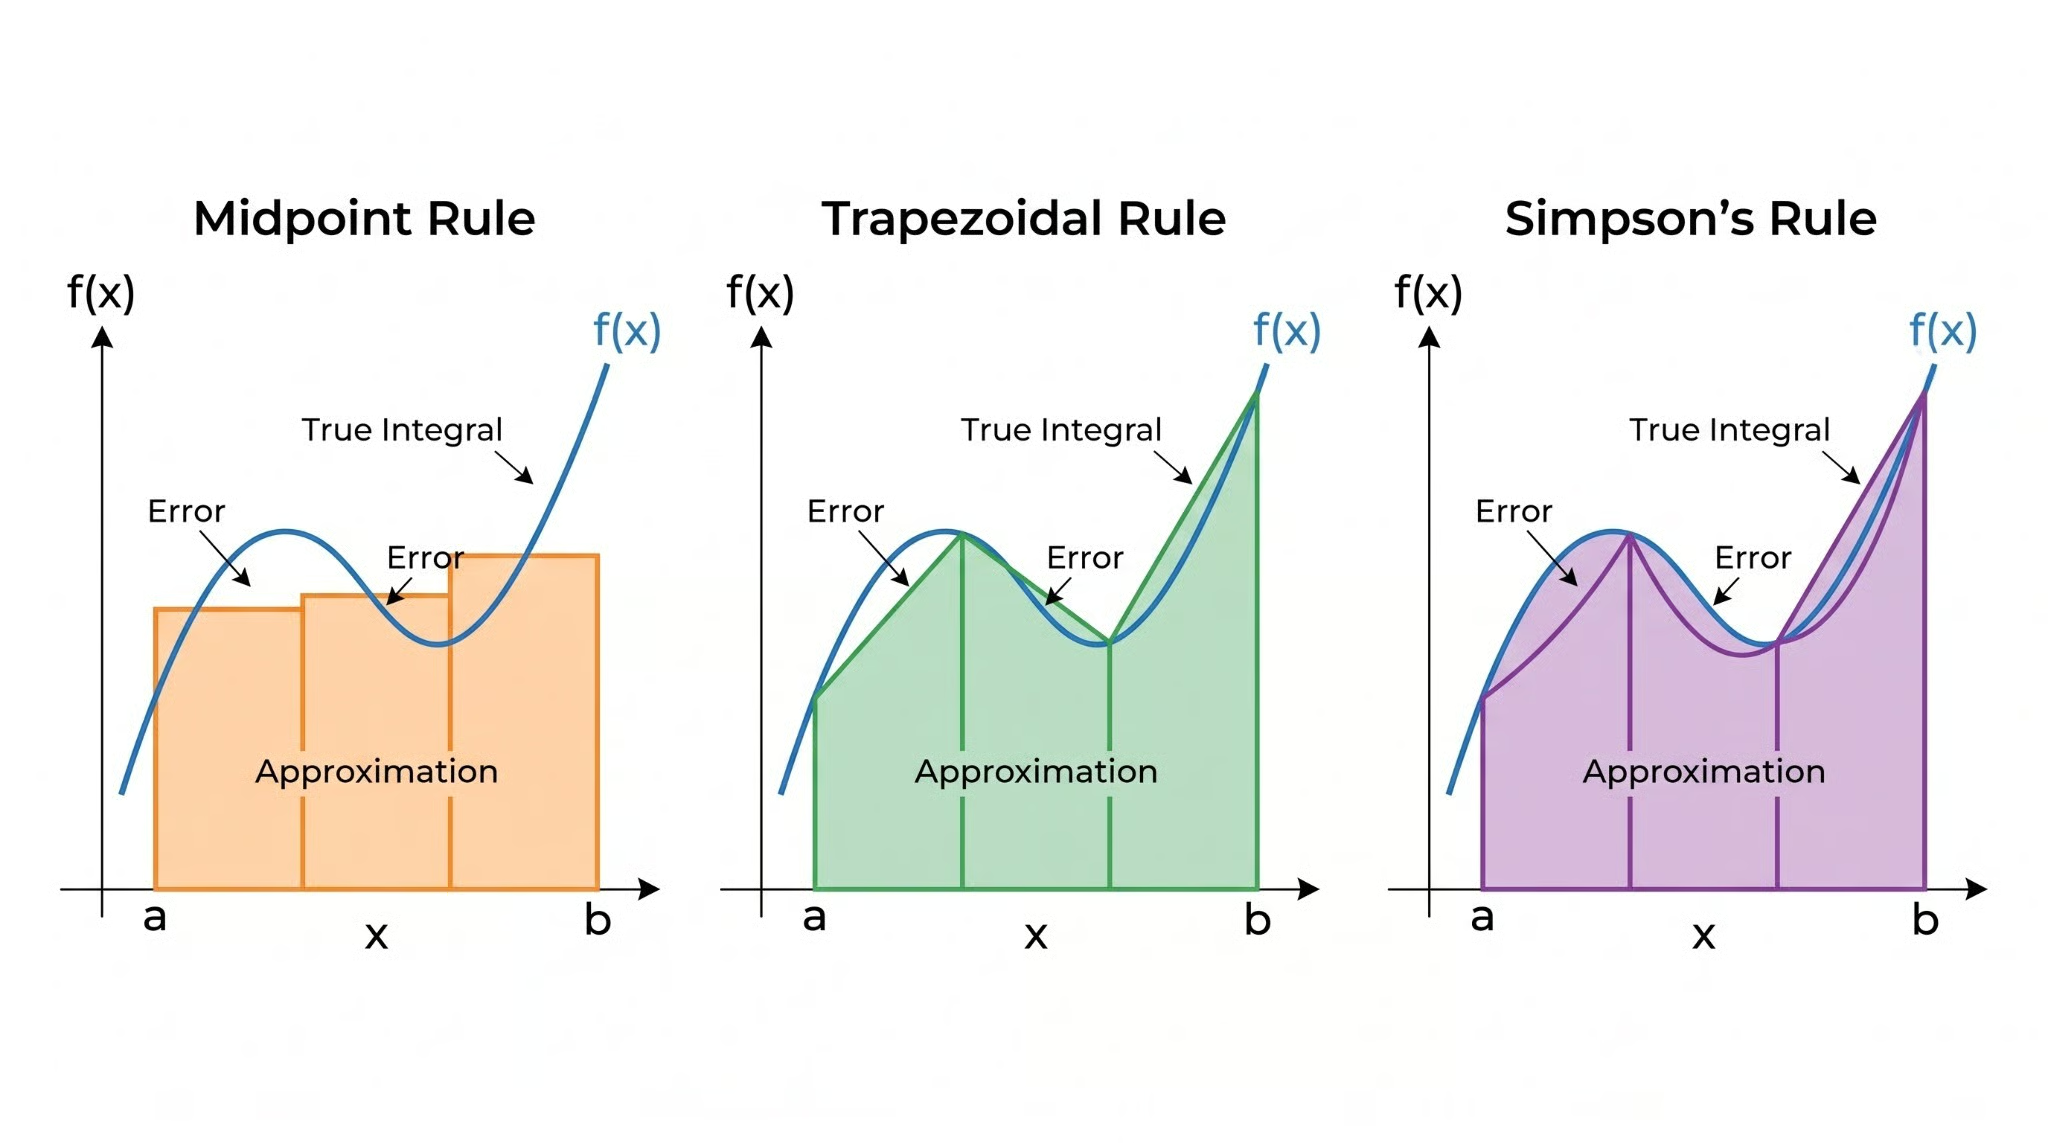 ภาพเปรียบเทียบกฎจุดกึ่งกลาง คางหมู และซิมป์สัน ภาพโดยผู้เขียน
นำจุดกึ่งกลางของ [a, b] มาประเมินค่า f แล้วคูณด้วยความกว้าง (b − a) สมมติฐานคือค่าฟังก์ชันที่จุดกึ่งกลางแทนค่าเฉลี่ยทั่วทั้งช่วงได้
ฟังดูง่ายเกินไป และสำหรับช่วงเดียวก็จริง แต่เรื่องน่าประหลาดใจอย่างแรกคือ กฎจุดกึ่งกลางให้ผลเที่ยงตรงสำหรับฟังก์ชันค่าคงที่และเชิงเส้น และความคลาดเคลื่อนต่อช่วงมีสเกลเป็น O(h³) โดย h = b − a ซึ่งจริงๆ แล้วดีกว่ากฎคางหมูสำหรับฟังก์ชันที่เรียบ ซึ่งมักทำให้หลายคนแปลกใจ
ใช้จุดปลายทั้งสองแทนการใช้แต่จุดกึ่งกลาง เชื่อมสองจุดด้วยเส้นตรงและคำนวณพื้นที่ของรูปคางหมูที่ได้: (b − a) · [f(a) + f(b)] / 2 ให้ผลเที่ยงตรงสำหรับฟังก์ชันเชิงเส้น โดยมีความคลาดเคลื่อนต่อช่วงเป็น O(h³) เช่นเดียวกับกฎจุดกึ่งกลาง แต่ค่าคงที่หน้าพจน์ใหญ่กว่า
กฎคางหมูน่าจะเป็นวิธีควอดราเจอร์ที่ถูกสอนอย่างแพร่หลายที่สุด จนมีชื่อเสียงเกินจริง สำหรับฟังก์ชันที่นิ่งดีถือว่าใช้ได้ แต่กฎของซิมป์สันแบบเชิงประกอบมักทำได้ดีกว่าสำหรับจำนวนการประเมินค่าเท่าเดิม
ปรับพหุนามดีกรีสองผ่านสามจุด: สองจุดปลายและจุดกึ่งกลาง แล้วอินทิเกรตพหุนามนั้นอย่างเที่ยงตรง:
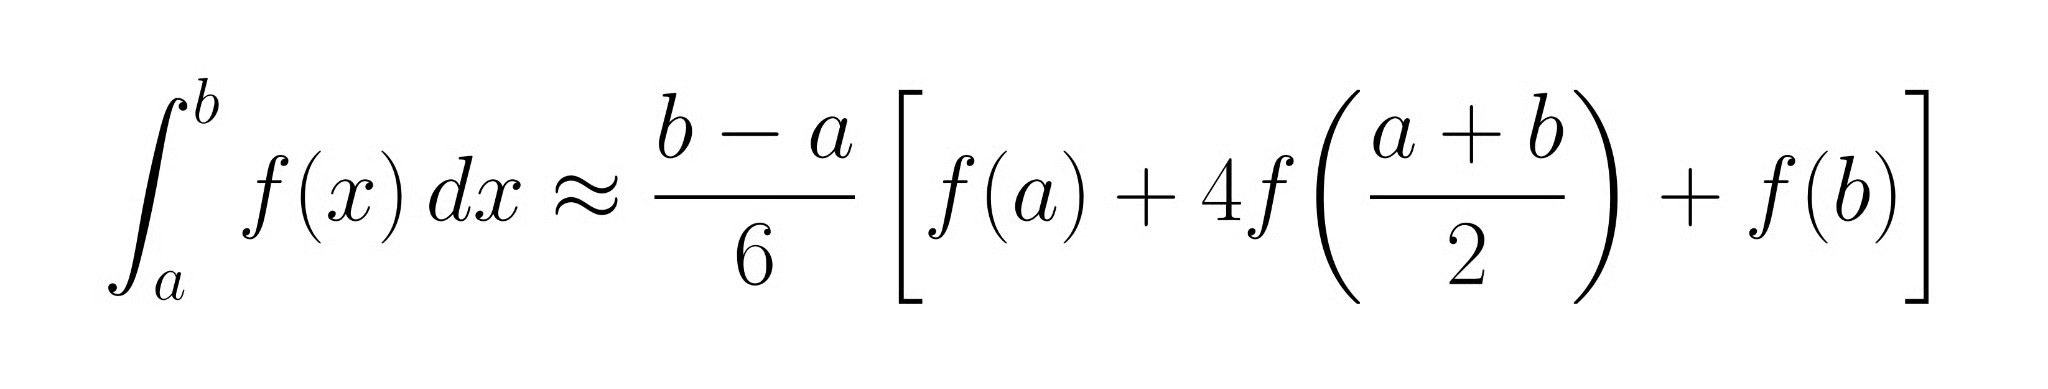
การประเมินค่าเพิ่มที่จุดกึ่งกลางทำให้มีค่าใช้จ่ายเพิ่มหนึ่งครั้ง แต่ผลที่ได้คุ้มค่า: กฎของซิมป์สันให้ผลเที่ยงตรงสำหรับพหุนามถึงดีกรีสาม และความคลาดเคลื่อนต่อช่วงมีสเกลเป็น O(h⁵) ซึ่งดีกว่ากฎคางหมูสองลำดับ สำหรับฟังก์ชันที่เรียบ นี่มักเป็นวิธีแรกที่ควรหยิบใช้
ตรงนี้เริ่มน่าสนใจจริงจังแล้ว กฎจุดกึ่งกลาง คางหมู และซิมป์สันใช้โหนดที่เว้นระยะเท่าๆ กัน ควอดราเจอร์แบบเกาส์ตั้งคำถามต่างออกไป: ถ้าเลือกทั้งตำแหน่งโหนดและน้ำหนักให้แม่นยำที่สุดจะเป็นอย่างไร?
ด้วยโหนด n จุด ควอดราเจอร์แบบเกาส์ (โดยเฉพาะแบบเกาส์-เลอฌ็องดร์) สามารถอินทิเกรตพหุนามดีกรีไม่เกิน 2n − 1 ได้อย่างเที่ยงตรง โหนด 2 จุดให้ความเที่ยงตรงสำหรับพหุนามดีกรีสาม; โหนด 5 จุดจัดการพหุนามดีกรี 9 ได้ โหนดคือรากของพหุนามเลอฌ็องดร์ และจะกระจุกตัวใกล้ปลายช่วงมากกว่าวางห่างเท่าๆ กัน ความแม่นยำที่มากขึ้นมาจากการปล่อยให้โหนดขยับ ไม่ใช่เพราะบังเอิญไปอยู่ตำแหน่งดีๆ การกระจุกตัวใกล้ปลายช่วงเป็นผลพวงทางคณิตศาสตร์ และจะเห็นเหตุผลด้านล่าง
ต่อไปนี้คือการเปรียบเทียบทั้งสี่วิธี:
|
Method |
Approach |
Error per interval |
Computational cost |
Best for |
|
Midpoint rule |
Evaluate at center |
O(h³) |
1 eval/interval |
Simple, smooth functions |
|
Trapezoidal rule |
Linear fit |
O(h³) |
2 evals/interval |
Periodic functions |
|
Simpson's rule |
Quadratic fit |
O(h⁵) |
3 evals/interval |
Smooth functions |
|
Gaussian quadrature |
Optimal nodes + weights |
O(h^(2n+1)) |
n evals/interval |
High accuracy, smooth functions |
การใช้กฎกับช่วงเต็ม [a, b] เพียงครั้งเดียวมักไม่เพียงพอ วิธีมาตรฐานคือ แบ่งช่วงออกเป็นช่วงย่อย n ช่วงที่เท่ากัน โดยมีความกว้าง h = (b − a)/n และใช้กฎพื้นฐานกับแต่ละช่วงย่อย
สำหรับกฎคางหมูแบบเชิงประกอบ ให้ประเมินค่า f ที่จุด n+1 จุดที่เว้นระยะเท่าๆ กัน แล้วรวมพื้นที่คางหมู n รูป ความคลาดเคลื่อนรวมลดลงเป็น O(h²) ลด h ลงครึ่งหนึ่ง ความคลาดเคลื่อนจะลดลงสี่เท่า กฎจุดกึ่งกลางแบบเชิงประกอบใช้ตรรกะเดียวกันและมีลำดับความคลาดเคลื่อนรวมเท่ากัน
เวอร์ชันเชิงประกอบต้องใช้จำนวนช่วงย่อยเป็นจำนวนคู่ ประเมินค่า f ที่จุด n+1 จุด และได้ความคลาดเคลื่อนรวมเป็น O(h⁴) ลด h ลงครึ่งหนึ่ง ความคลาดเคลื่อนจะลดลงสิบหกเท่า นี่คือเหตุผลที่กฎของซิมป์สันแบบเชิงประกอบมักเป็นค่าตั้งต้นเมื่อต้องการความแม่นยำปานกลางบนฟังก์ชันที่เรียบ
โค้ด Python ด้านล่างแสดงให้เห็นว่าการประมาณแน่นขึ้นอย่างไรเมื่อเพิ่มจำนวนช่วงย่อยสำหรับ ∫[0 ถึง π] sin(x) dx (ค่าจริง: 2.0):
import numpy as np

def composite_simpson(func, lower, upper, num_intervals):
    """Approximate integral using composite Simpson's rule."""
    if num_intervals % 2 != 0:
        raise ValueError("num_intervals must be even")
    nodes = np.linspace(lower, upper, num_intervals + 1)
    values = func(nodes)
    h = (upper - lower) / num_intervals
    weights = np.ones(num_intervals + 1)
    weights[1:-1:2] = 4   # odd-indexed interior points
    weights[2:-2:2] = 2   # even-indexed interior points
    return (h / 3) * np.dot(weights, values)

exact = 2.0
for n in [4, 8, 16, 32]:
    approx = composite_simpson(np.sin, 0, np.pi, n)
    print(f"n={n:3d}: approx={approx:.10f}, error={abs(approx - exact):.2e}")
เพียง 32 ช่วง ความคลาดเคลื่อนก็ต่ำกว่า 10⁻⁶ แล้ว นี่คือการลู่เข้าแบบ O(h⁴)
แนวคิดเบื้องหลังควอดราเจอร์แบบเกาส์สมควรได้มากกว่าช่องในตาราง
เมื่อโหนดอยู่ที่จุดซึ่งเว้นระยะเท่าๆ กัน แปลว่ากำลังใช้ทรัพยากรการประเมินค่าในลักษณะที่อาจไม่สอดคล้องกับความยากของอินทิแกรนด์ บางบริเวณต้องการความละเอียดมากกว่า ส่วนบางบริเวณเสียทรัพยากรไปกับช่วงที่แบน ควอดราเจอร์แบบเกาส์เลี่ยงปัญหานี้ด้วยการเลือกโหนดที่พิสูจน์ได้ว่าเหมาะที่สุดสำหรับดีกรีของพหุนามที่สามารถอินทิเกรตได้อย่างเที่ยงตรง
สำหรับโหนด n จุด กฎเกาส์-เลอฌ็องดร์จะเลือก n รากของพหุนามเลอฌ็องดร์ลำดับที่ n คือ Pₙ(x) เป็นโหนด แล้วคำนวณน้ำหนักเพื่อให้พหุนามดีกรี ≤ 2n − 1 ถูกอินทิเกรตได้โดยไร้ความคลาดเคลื่อน ในทางปฏิบัติ numpy.polynomial.legendre.leggauss(n) ให้ทั้งโหนดและน้ำหนัก โหนดจะกระจุกตัวใกล้ปลายช่วง [−1, 1] ซึ่งเป็นช่วงอ้างอิงมาตรฐาน ตรงบริเวณที่ความคลาดเคลื่อนของการอินเตอร์โพเลตด้วยพหุนามมักสูง และความหนาแน่นการสุ่มตัวอย่างที่มากขึ้นให้ผลคุ้มค่าที่สุด
ควอดราเจอร์แบบเกาส์เหมาะที่สุดเมื่อฟังก์ชันเรียบและเป็นอนาลิติก และต้องการความแม่นยำสูงด้วยจำนวนการประเมินค่าน้อย โหนดเกาส์-เลอฌ็องดร์เพียงห้าจุดสามารถทำได้ดีกว่ากฎของซิมป์สันแบบเชิงประกอบที่ใช้หลายสิบช่วงบนอินทิแกรนด์ที่ประพฤติดี แต่ไม่เหมาะกับฟังก์ชันที่มีคม หยุดชะงัก หรือมีข้อมูลเฉพาะที่จุดซึ่งเว้นระยะเท่าๆ กัน ในกรณีเหล่านั้น การจัดวางโหนดอย่างพิถีพิถันกลับกลายเป็นข้อเสีย
ไม่มีวิธีเชิงตัวเลขใดรอดพ้นจากความคลาดเคลื่อน มีสองแหล่งหลักที่กระทบผลลัพธ์ของควอดราเจอร์ทุกครั้ง การเข้าใจทั้งคู่จำเป็นอย่างยิ่งเพื่อรู้ว่าจะเชื่อค่าที่ได้เมื่อใด
แหล่งที่มาของความคลาดเคลื่อนประกอบด้วย:
ความเรียบของฟังก์ชัน ความกว้างของช่วง และการเลือกวิธี ล้วนส่งผลต่อความคลาดเคลื่อนจากการแยกย่อย ฟังก์ชันที่หยาบและมีลักษณะแหลมคมต้องการช่วงย่อยมากขึ้นหรือวิธีแบบปรับตัว
กริดที่สม่ำเสมอทำให้สิ้นเปลืองการประเมินค่าเมื่ออินทิแกรนด์เรียบเกือบทั้งหมดแต่ซับซ้อนในไม่กี่บริเวณ
ใช้กฎควอดราเจอร์กับช่วงหนึ่ง แล้วใช้กฎที่ลำดับสูงกว่า (หรือกฎเดียวกันกับครึ่งช่วงทั้งสอง) และเปรียบเทียบ ผลต่างเป็นการประมาณความคลาดเคลื่อนเฉพาะที่ หากต่ำกว่าเกณฑ์ ก็ยอมรับช่วงนั้น หากไม่ ให้แบ่งย่อยแล้วทำซ้ำกับแต่ละครึ่ง ดำเนินการไปจนกว่าทุกช่วงย่อยจะผ่านเกณฑ์
ประสิทธิภาพที่ดีกว่าการทำให้ละเอียดแบบสม่ำเสมอจะสูงมากเมื่ออินทิแกรนด์มีลักษณะเฉพาะที่โดดเดี่ยว: ยอดแหลมแคบๆ รอยคม การแกว่งเร็วที่ล้อมรอบด้วยบริเวณที่เรียบ วิธีแบบปรับตัวจะทุ่มการประเมินค่าไปยังตำแหน่งที่ฟังก์ชันต้องการจริงๆ
ใน Python scipy.integrate.quad() ใช้วิธีควอดราเจอร์แบบเกาส์เชิงปรับตัว (อัลกอริทึม DQAGSE ของ QUADPACK) ส่งผ่านฟังก์ชันและขีดจำกัด จะได้ค่าประมาณและขอบเขตความคลาดเคลื่อน คืนมา สำหรับอินทิกรัลหนึ่งมิติส่วนใหญ่ นี่คือเครื่องมือที่เหมาะสม ไม่ต้องจูนเอง
from scipy import integrate
import numpy as np

# Integrate a function with a peak near x=0.5
def peaked_func(x):
    return np.exp(-100 * (x - 0.5)**2)

result, error_bound = integrate.quad(peaked_func, 0, 1)
print(f"Estimate: {result:.10f}")
print(f"Error bound: {error_bound:.2e}")
quad() จัดการยอดแคบนี้ได้อย่างราบรื่น กฎของซิมป์สันแบบกริดสม่ำเสมอต้องใช้ช่วงย่อยนับร้อยจึงจะทัดเทียม
เริ่มจาก scipy.integrate.quad() สำหรับอินทิกรัลหนึ่งมิติใน Python เว้นแต่มีเหตุผลอื่น มันเป็นแบบปรับตัว แม่นยำ และผ่านการทดสอบอย่างดี เนื้อหาด้านล่างเหมาะเมื่อจำเป็นต้องทำเอง ใช้ภาษาไร้ไลบรารีแบบปรับตัวที่ดี หรือปรับให้เหมาะกับกรณีเฉพาะ
ควอดราเจอร์ไม่ได้อยู่โดดเดี่ยว การเห็นภาพว่ามันอยู่ตรงไหนเมื่อเทียบกับเครื่องมืออื่นๆ ที่อาจกำลังพิจารณาจะช่วยได้
การอินทิเกรตเชิงวิเคราะห์หาปริพันธ์ปริยายที่แน่นอน ส่วนควอดราเจอร์ประมาณเป็นตัวเลข หากมีปริพันธ์ปริยายที่แน่นอนและหาได้ ก็ควรใช้มัน ควอดราเจอร์มีที่ยืนเมื่อการอินทิเกรตแบบ exact เป็นไปไม่ได้หรือไม่เหมาะสม
ทั้งคู่ประมาณค่าอินทิกรัลจำกัด แต่ต่างวิธี ควอดราเจอร์เป็นเชิงกำหนด: ประเมิน f ที่โหนดตายตัวที่เลือกไว้ล่วงหน้า โดยอัตราการลู่เข้าผูกกับความเรียบของฟังก์ชันและจำนวนโหนด มอนติคาร์โลสุ่มตัวอย่างแล้วเฉลี่ย โดยความคลาดเคลื่อนสเกลเป็น O(1/√N) ไม่ขึ้นกับมิติ นั่นทำให้มันลู่เข้าช้ากว่าในมิติต่ำ แต่ไม่ขึ้นกับมิติ จึงเป็นตัวเลือกที่ใช้งานจริงเมื่อเกินราวห้ามิติ
กฎควอดราเจอร์บางอย่าง รวมถึงกฎของซิมป์สัน ทำงานโดยปรับพหุนามผ่านจุดที่ประเมินค่าแล้วอินทิเกรตอย่างเที่ยงตรง แต่เป้าหมายต่างจากการอินเตอร์โพเลชัน การอินเตอร์โพเลชันต้องการสร้างฟังก์ชันกลับคืน ส่วนควอดราเจอร์ต้องการเพียงตัวเลข พหุนามเป็นเพียงเครื่องมือ ไม่ใช่ผลลัพธ์
สิ่งที่น่าพอใจเกี่ยวกับควอดราเจอร์คือได้ประโยชน์มากมายจากแนวคิดจัดระเบียบเพียงแนวคิดเดียว ทุกวิธีที่กล่าวมา ไม่ว่าจะกฎจุดกึ่งกลาง คางหมู ซิมป์สัน หรือเกาส์ ล้วนเป็นคำตอบต่างรูปต่อคำถามเดียวกัน: เมื่อมีงบประมาณการประเมินค่าฟังก์ชันจำกัด ควรวางมันไว้ที่ไหน และให้น้ำหนักอย่างไร
การปรับพหุนามที่ดีกว่าผ่านจุดประเมินค่าช่วยลดความคลาดเคลื่อนลงอย่างรวดเร็ว การขยับโหนดไปยังตำแหน่งที่เหมาะที่สุดยิ่งคั้นเอาความแม่นยำจากงบประมาณเท่าเดิมได้มากขึ้น วิธีแบบปรับตัวช่วยดึงทุกอย่างมารวมกัน ส่งการประเมินค่าไปยังที่ที่ฟังก์ชันต้องการจริงๆ
ใน Python scipy.integrate.quad() คือค่าตั้งต้นที่เหมาะสมสำหรับปัญหา 1 มิติ เนื้อหาอื่นๆ ในบทความนี้เหมาะเมื่ออยากเข้าใจว่าเบื้องหลังเกิดอะไรขึ้น หรือเมื่อต้องทำเอง หากต้องการต่อยอดทักษะเชิงตัวเลขด้วย SciPy ลองดูคอร์ส Introduction to Optimization in Python
เรียนกับ DataCamp
คอร์ส
คอร์ส
แทร็ก