कोर्स
Python में Linear Modeling परिचय
4 घंटा
27K
कुछ निश्चित समाकल ऐसे होते हैं जो कागज़-कलम वाले कैलकुलस से हाथ नहीं आते—आपकी गलती नहीं है। e^(−x²) या sin(x)/x जैसे कुछ फलनों के तो बंद-रूप प्रतिसमाकल होते ही नहीं। ऐसे में अलग तरीके की जरूरत पड़ती है: फलन को चुनिंदा बिंदुओं पर मान करिए और उन मानों को जोड़कर नीचे के क्षेत्रफल का अनुमान लगाइए। यही क्वाड्रेचर है।
यह लेख बताता है कि क्वाड्रेचर क्या है, इसका सामान्य ढांचा कैसे काम करता है, और प्रमुख विधियाँ—सरल मध्यबिंदु नियम से लेकर आश्चर्यजनक रूप से सटीक गॉसियन तरीके तक। हम संयोजित (कॉम्पोज़िट) विधियाँ, त्रुटि के स्रोत, अनुकूली (एडैप्टिव) रणनीतियाँ, और आपके सामने मौजूद समस्या के लिए सही विधि चुनना भी कवर करेंगे।
"क्वाड्रेचर" शब्द पुराना है। यह किसी दी गई आकृति के बराबर क्षेत्रफल वाला वर्ग बनाने की शास्त्रीय ज्यामितीय समस्या से आता है—अर्थात "क्षेत्रफल निकालना"। आज यह शब्द किसी निश्चित समाकल के संख्यात्मक सन्निकटन के लिए प्रयुक्त होता है।
मुख्य विचार एक प्रतिस्थापन का है: सटीक प्रतिसमाकल खोजने के बजाय, आप फलन f(x) को चुने गए बिंदुओं (नोड्स) पर मानते हैं, हर मान को एक संबंधित भार से गुणा करते हैं, और उन सबका योग लेते हैं:
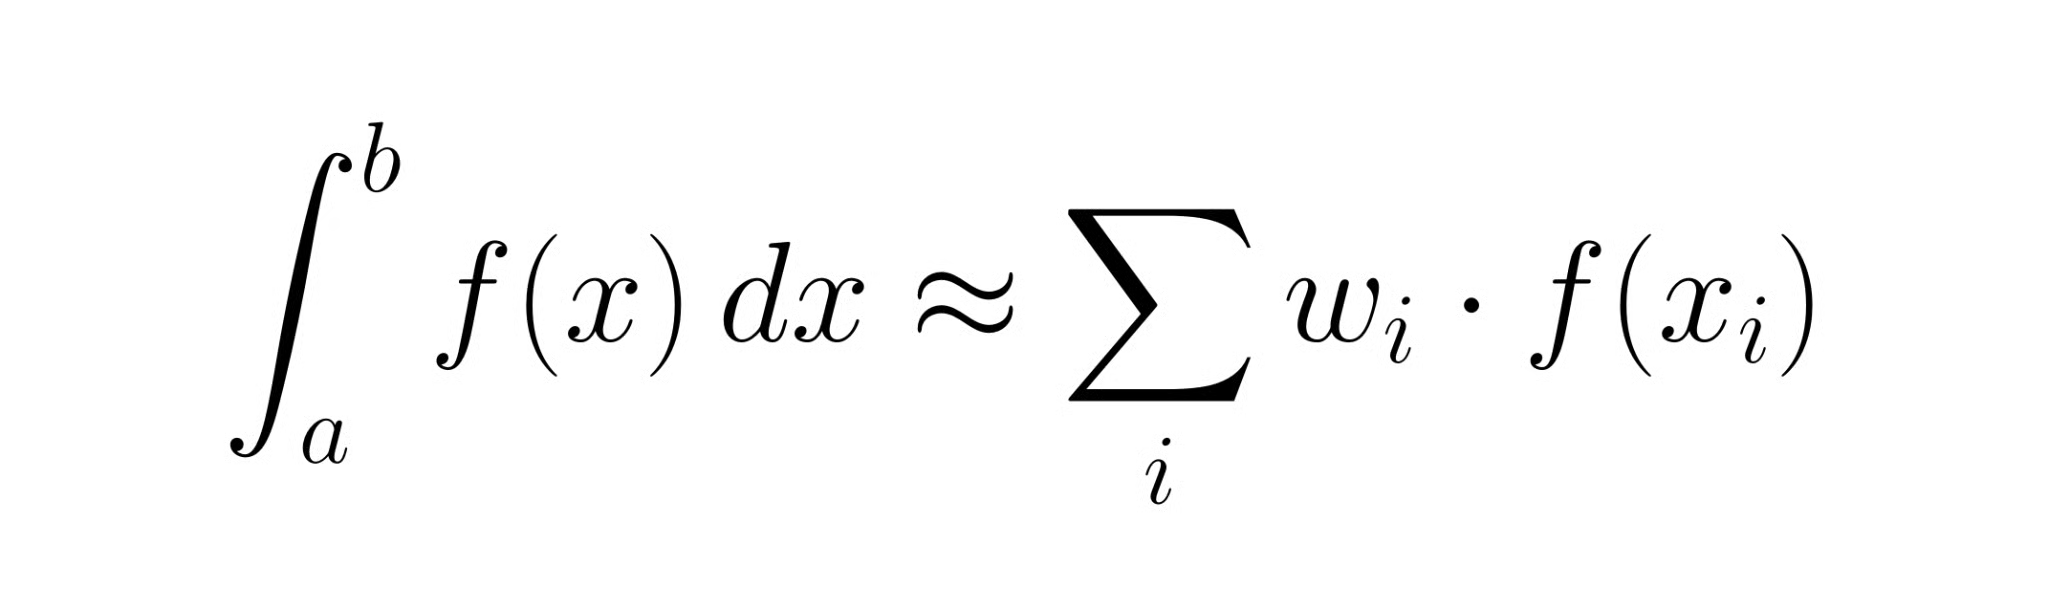
शब्द क्वाड्रेचर और संख्यात्मक समाकलन मूलतः एक ही बात कहते हैं। क्वाड्रेचर आम तौर पर अधिक गणितीय संदर्भों में दिखता है; वैज्ञानिक कंप्यूटिंग में रोज़मर्रा का शब्द संख्यात्मक समाकलन है।
हर क्वाड्रेचर नियम [a, b] अंतराल पर काम करता है। इस अंतराल के भीतर यह नोड्स xᵢ चुनता है और प्रत्येक को एक भार wᵢ देता है। सन्निकटन ऊपर दिया गया भारित योग है। विधियों में फर्क बस इतना है कि नोड्स कहाँ रखे जाते हैं और भार कैसे दिए जाते हैं। बस। ट्रैपेज़ॉइडल नियम, सिम्पसन का नियम, और गॉसियन क्वाड्रेचर इसी साँचे के अलग-अलग रूप हैं।
सन्निकटन त्रुटि वह अंतर है जो भारित योग और वास्तविक समाकल के बीच होता है। हर विधि कुछ त्रुटि लाती है, और जैसे-जैसे आप अधिक नोड्स जोड़ते हैं (या अंतराल छोटे करते हैं) वह त्रुटि कितनी तेज़ी से घटती है—यही एक अच्छी और बेहतरीन विधि में फर्क करता है। इस नज़रिये को याद रखें: क्वाड्रेचर विधि चुनना दरअसल अपने फलन-मूल्यांकन बजट को कैसे खर्च करना है, यह तय करना है।
नीचे दी गई विधियाँ सबसे सहज से लेकर सबसे परिष्कृत तक क्रमबद्ध हैं।
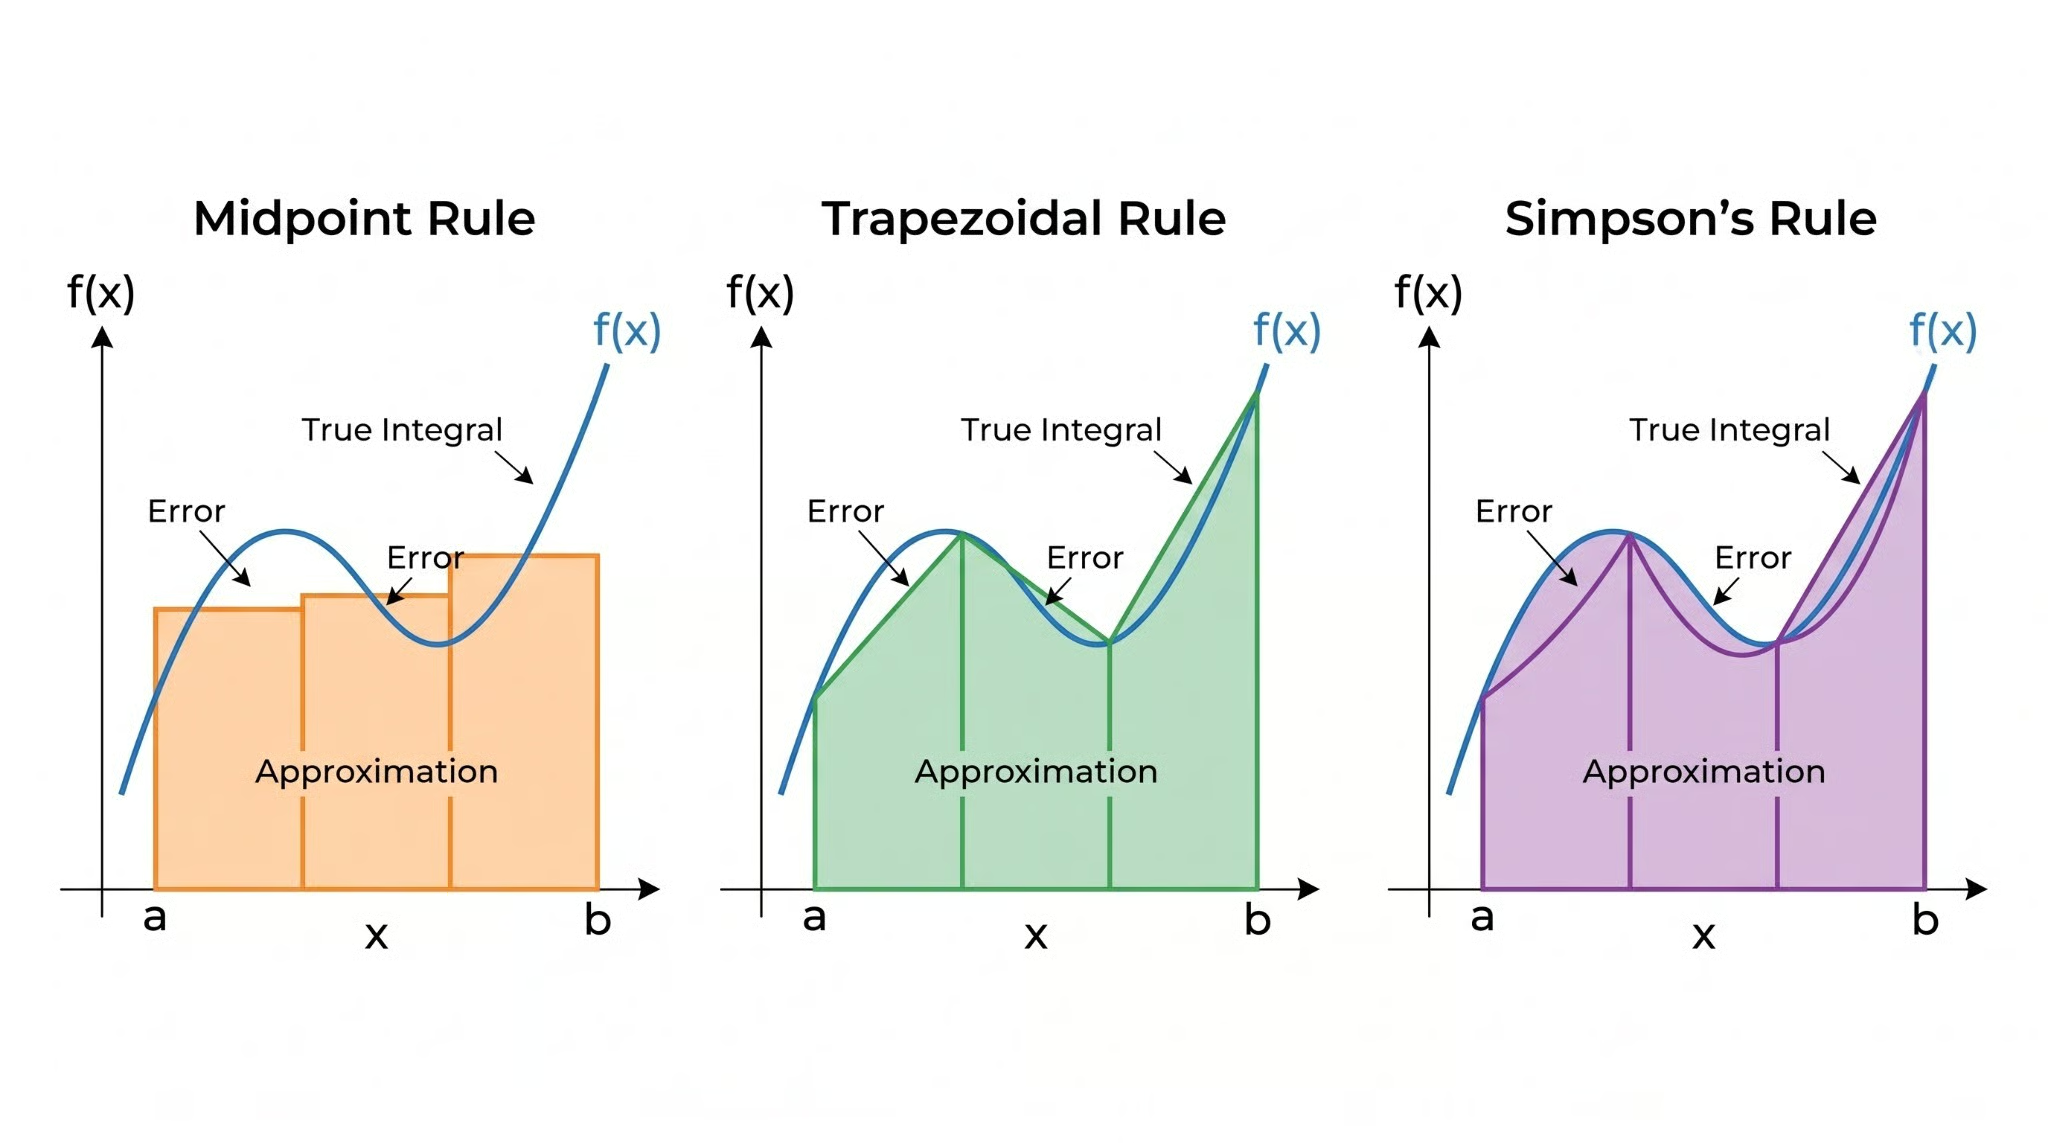 मध्यबिंदु, ट्रैपेज़ॉइडल और सिम्पसन समाकलन नियमों की दृश्य तुलना। चित्र लेखक द्वारा।
[a, b] का मध्यबिंदु लें, वहीं f का मान निकालें, और चौड़ाई (b − a) से गुणा करें। मान्यता यह है कि केंद्र पर फलन का मान पूरे अंतराल के औसत का प्रतिनिधित्व करता है।
यह सुनने में बहुत सरल लगता है, और एक ही अंतराल के लिए है भी। पर पहला चौंकाव यह है: मध्यबिंदु नियम स्थिर और रैखिक फलनों के लिए बिल्कुल सटीक है, और इसकी त्रुटि प्रति अंतराल O(h³) (जहाँ h = b − a) के रूप में बढ़ती-घटती है। चिकने फलनों पर यह वास्तव में ट्रैपेज़ॉइडल नियम से बेहतर है—यह बात अक्सर लोगों को हैरत में डालती है।
सिर्फ केंद्र के बजाय दोनों सिरों का उपयोग करें। सिरों को एक सीधी रेखा से जोड़ें और बने हुए समलंब का क्षेत्रफल निकालें: (b − a) · [f(a) + f(b)] / 2। रैखिक फलनों के लिए सटीक, और प्रति अंतराल O(h³) त्रुटि—मध्यबिंदु नियम के समान क्रम, हालाँकि स्थिरांक बड़ा होता है।
ट्रैपेज़ॉइडल नियम शायद सबसे ज़्यादा पढ़ाया जाता है, इसलिए इसकी छवि अपेक्षा से बड़ी है। अच्छे-स्वभाव वाले (well-behaved) फलनों के लिए यह ठीक-ठाक है। पर उतने ही मूल्याकंनों पर संयोजित सिम्पसन का नियम लगभग हमेशा बेहतर रहता है।
तीन बिंदुओं—दोनों सिरे और मध्यबिंदु—से होकर एक द्विघात बहुपद फिट कीजिए। उस बहुपद का समाकलन सटीक कीजिए:
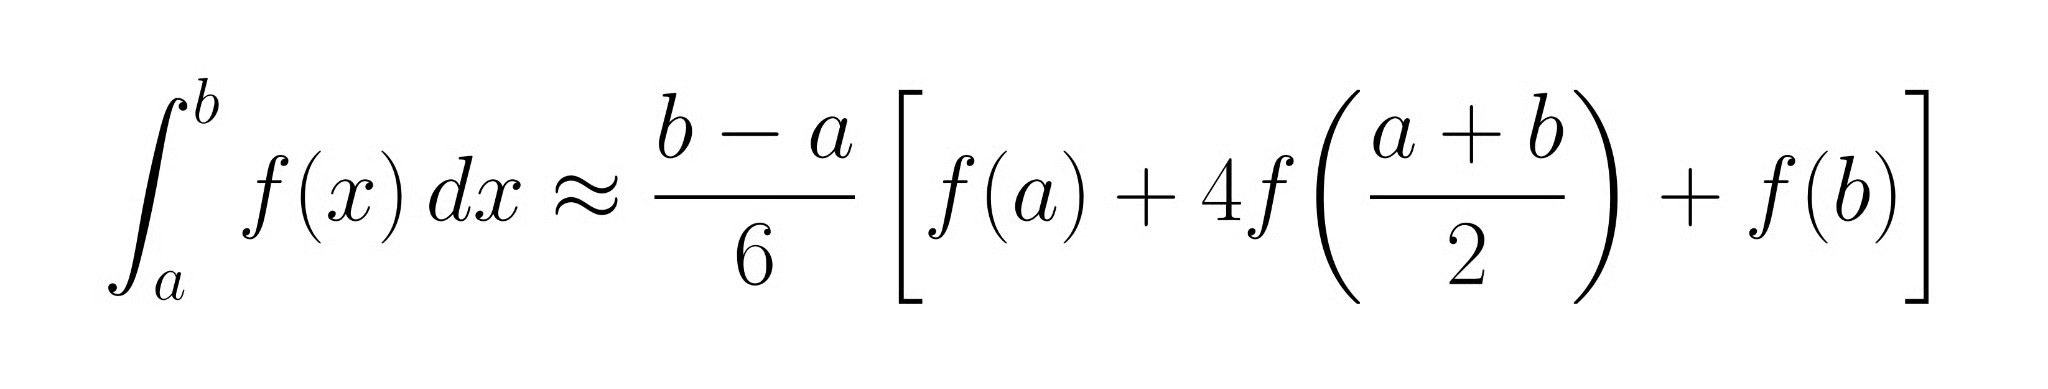
बीच में एक अतिरिक्त मूल्यांकन एक और फलन कॉल का खर्च जोड़ता है, पर लाभ पक्का है: सिम्पसन का नियम डिग्री तीन तक के बहुपदों के लिए सटीक है, और प्रति अंतराल त्रुटि O(h⁵) के रूप में घटती-बढ़ती है—ट्रैपेज़ॉइडल नियम से दो क्रम बेहतर। चिकने फलनों के लिए यह आम तौर पर पहली पसंद होनी चाहिए।
यहीं चीज़ें वाकई दिलचस्प होती हैं। मध्यबिंदु, ट्रैपेज़ॉइडल और सिम्पसन नियम समान दूरी पर नोड्स का उपयोग करते हैं। गॉसियन क्वाड्रेचर अलग सवाल पूछता है: क्यों न नोड्स की जगहें और भार—दोनों—ऐसे चुने जाएँ कि सटीकता अधिकतम हो?
n नोड्स के साथ, गॉसियन क्वाड्रेचर (विशेषतः गॉस-लेजांद्र रूप) 2n − 1 डिग्री तक के किसी भी बहुपद का समाकलन बिल्कुल सटीक कर सकता है। दो नोड्स घन बहुपदों तक को सटीक बनाते हैं; पाँच नोड्स डिग्री-9 बहुपद सँभाल लेते हैं। नोड्स लेजांद्र बहुपदों के शून्य होते हैं और वे अंतराल के सिरों की ओर अधिक सघन होते हैं, समान दूरी पर नहीं बैठते। अतिरिक्त सटीकता नोड्स के खिसक सकने से आती है, न कि वे कहाँ गिरते हैं उससे। सिरों के पास उनका सघन होना गणित का सह-उत्पाद है, और नीचे हम देखेंगे ऐसा क्यों होता है।
यहाँ चारों विधियों की तुलना इस प्रकार है:
|
Method |
Approach |
Error per interval |
Computational cost |
Best for |
|
Midpoint rule |
Evaluate at center |
O(h³) |
1 eval/interval |
Simple, smooth functions |
|
Trapezoidal rule |
Linear fit |
O(h³) |
2 evals/interval |
Periodic functions |
|
Simpson's rule |
Quadratic fit |
O(h⁵) |
3 evals/interval |
Smooth functions |
|
Gaussian quadrature |
Optimal nodes + weights |
O(h^(2n+1)) |
n evals/interval |
High accuracy, smooth functions |
आमतौर पर पूरे [a, b] अंतराल पर किसी नियम को एक बार लगाना पर्याप्त नहीं होता। मानक उपाय यह है: अंतराल को n समान उप-अंतरालों में बाँटें जिनकी चौड़ाई h = (b − a)/n हो, और हर एक पर वही मूल नियम लागू करें।
संयोजित ट्रैपेज़ॉइडल नियम में, f का मान n+1 समान दूरी के बिंदुओं पर निकालें और n समलंबों का योग लें। कुल त्रुटि O(h²) तक गिर जाती है। h आधा करने पर त्रुटि चार गुना घटती है। संयोजित मध्यबिंदु नियम भी इसी तर्क का अनुसरण करता है और वैश्विक त्रुटि-क्रम वही रहता है।
इसका संयोजित रूप समांतर (even) संख्या के उप-अंतराल चाहता है। f का मान n+1 बिंदुओं पर निकालें और O(h⁴) वैश्विक त्रुटि पाएँ। h आधा करने पर त्रुटि सोलह गुना घटती है। इसलिए चिकने फलनों पर मध्यम सटीकता चाहिए तो संयोजित सिम्पसन का नियम अक्सर डिफ़ॉल्ट होता है।
नीचे दिया Python कोड यह दिखाता है कि ∫[0 से π] sin(x) dx (सटीक मान: 2.0) के लिए उप-अंतराल बढ़ाने पर सन्निकटन कैसे कसता जाता है:
import numpy as np

def composite_simpson(func, lower, upper, num_intervals):
    """Approximate integral using composite Simpson's rule."""
    if num_intervals % 2 != 0:
        raise ValueError("num_intervals must be even")
    nodes = np.linspace(lower, upper, num_intervals + 1)
    values = func(nodes)
    h = (upper - lower) / num_intervals
    weights = np.ones(num_intervals + 1)
    weights[1:-1:2] = 4   # odd-indexed interior points
    weights[2:-2:2] = 2   # even-indexed interior points
    return (h / 3) * np.dot(weights, values)

exact = 2.0
for n in [4, 8, 16, 32]:
    approx = composite_simpson(np.sin, 0, np.pi, n)
    print(f"n={n:3d}: approx={approx:.10f}, error={abs(approx - exact):.2e}")
सिर्फ 32 अंतराल पर ही त्रुटि 10⁻⁶ से नीचे चली जाती है। यही O(h⁴) अभिसरण है।
गॉसियन क्वाड्रेचर के पीछे का विचार तालिका-प्रविष्टि से अधिक का हकदार है।
जब नोड्स समान दूरी पर बैठते हैं, तो आप मूल्यांकन बजट को ऐसे खर्च करते हैं जो अनिवार्य नहीं कि समाकलनीय (इंटीग्रैंड) की कठिनाई से मेल खाए। कुछ हिस्सों को अधिक रेज़ोल्यूशन चाहिए; कुछ समतल हिस्सों पर मूल्यांकन व्यर्थ जाते हैं। गॉसियन क्वाड्रेचर इससे बचता है—वह ऐसे नोड्स चुनता है जो उस बहुपद-डिग्री के लिए सिद्धतः इष्ट (ऑप्टिमल) हों जिन्हें आप बिना त्रुटि समाकलित कर सकते हैं।
n नोड्स के लिए, गॉस-लेजांद्र नियम nवें लेजांद्र बहुपद Pₙ(x) के n मूलों को नोड्स के रूप में चुनता है, फिर ऐसे भार निकालता है कि डिग्री ≤ 2n − 1 का कोई भी बहुपद बिना त्रुटि समाकलित हो। व्यवहार में, numpy.polynomial.legendre.leggauss(n) दोनों लौटा देता है। नोड्स मानक संदर्भ अंतराल [−1, 1] के सिरों की ओर सघन होते हैं—वही जगह जहाँ बहुपद इंटरपोलेशन-त्रुटि बड़ी होती है और जहाँ अतिरिक्त सैंपल घनत्व का सबसे अधिक लाभ मिलता है।
जब आपके पास चिकना, विश्लेषणात्मक (analytic) फलन हो और कम मूल्याकंनों में उच्च सटीकता चाहिए, तब गॉसियन क्वाड्रेचर सर्वोत्तम रहता है। पाँच गॉस-लेजांद्र बिंदु कई अच्छे-स्वभाव वाले इंटीग्रैंड्स पर दर्जनों अंतरालों वाले संयोजित सिम्पसन से भी बेहतर कर सकते हैं। पर जिन फलनों में मोड़ (kinks), असातत्य (discontinuities) हों, या जिनका डाटा सिर्फ समान दूरी के बिंदुओं पर उपलब्ध हो—वहाँ यह उपयुक्त नहीं। ऐसे मामलों में, सावधानी से चुनी गई नोड-स्थिति आपके विरुद्ध जाती है।
कोई भी संख्यात्मक विधि त्रुटि से मुक्त नहीं। हर क्वाड्रेचर परिणाम को दो अलग-अलग स्रोत प्रभावित करते हैं, और दोनों को समझना इस बात की कुंजी है कि कब अपने उत्तर पर भरोसा करें।
त्रुटि के स्रोतों में शामिल हैं:
फलन की चिकनाई, अंतराल-चौड़ाई, और विधि का चुनाव—ये सब विघटन-त्रुटि को प्रभावित करते हैं। तीखे गुणों वाले उबड़-खाबड़ फलन को अधिक अंतराल या अनुकूली तरीका चाहिए।
जब इंटीग्रैंड ज़्यादातर जगह चिकना हो लेकिन कुछ जगह जटिल, तब एकसमान ग्रिड मूल्यांकन व्यर्थ करता है।
किसी अंतराल पर एक क्वाड्रेचर नियम लगाएँ, फिर उच्च-क्रम के नियम (या उसी नियम को दो आधों पर) लगाकर तुलना करें। अंतर स्थानीय त्रुटि का अनुमान देता है। यदि यह सहनशीलता से कम है, तो अंतराल को स्वीकार करें। अन्यथा, इसे बाँटें और दोनों आधों पर पुनरावृत्ति करें। तब तक दोहराएँ जब तक हर उप-अंतराल सहनशीलता पूरी न कर ले।
जब इंटीग्रैंड में अलग-थलग विशेषताएँ हों—संकरी चोटी, कोई मोड़, या चिकने क्षेत्र से घिरी तीव्र दोलन—तो समान परिशोधन की तुलना में कुशलता बहुत बढ़ सकती है। अनुकूली विधियाँ मूल्यांकन ठीक वहीं केंद्रित करती हैं जहाँ फलन को उनकी ज़रूरत होती है।
Python में scipy.integrate.quad() अनुकूली गॉसियन क्वाड्रेचर (विशेषतः QUADPACK का DQAGSE एल्गोरिदम) लागू करता है। अपना फलन और सीमाएँ पास करें; सन्निकटन और एक त्रुटि-सीमा वापस मिलती है। अधिकतर एक-आयामी समाकलों के लिए यही सही औज़ार है—कोई मैनुअल ट्यूनिंग नहीं चाहिए।
from scipy import integrate
import numpy as np

# Integrate a function with a peak near x=0.5
def peaked_func(x):
    return np.exp(-100 * (x - 0.5)**2)

result, error_bound = integrate.quad(peaked_func, 0, 1)
print(f"Estimate: {result:.10f}")
print(f"Error bound: {error_bound:.2e}")
quad() इस संकरी चोटी को आसानी से सँभाल लेता है। समान-स्पेस्ड सिम्पसन नियम को इससे मेल खाने के लिए सैकड़ों उप-अंतराल चाहिए होंगे।
Python में एक-आयामी समाकलों के लिए तब तक scipy.integrate.quad() से शुरू करें, जब तक कोई खास वजह न हो। यह अनुकूली, सटीक और अच्छी तरह परखा हुआ है। नीचे की बातें तब प्रासंगिक हैं जब आप खुद कुछ लागू कर रहे हों, किसी ऐसी भाषा में काम कर रहे हों जहाँ अच्छा अनुकूली पुस्तकालय न हो, या किसी विशिष्ट मामले के लिए अनुकूलन कर रहे हों।
क्वाड्रेचर अलग-थलग नहीं होता। इसे उन अन्य औज़ारों के संदर्भ में देखना उपयोगी है जिन पर आप विचार कर रहे होंगे।
विश्लेषणात्मक समाकलन सटीक प्रतिसमाकल ढूँढता है; क्वाड्रेचर एक संख्या का सन्निकटन करता है। यदि सटीक प्रतिसमाकल मौजूद हो और आप उसे पा सकें, तो वही उपयोग करें। जब सटीक समाकल असंभव या nepractical हो, तब क्वाड्रेचर की ज़रूरत पड़ती है।
दोनों निश्चित समाकलों का सन्निकटन करते हैं, पर अलग ढंग से। क्वाड्रेचर निश्चित (डिटरमिनिस्टिक) है: यह f का मान पूर्व-चुने नोड्स पर लेता है, और अभिसरण फलन की चिकनाई व नोड्स की संख्या से जुड़ा होता है। Monte Carlo यादृच्छिक नमूने लेकर औसत बनाता है, और इसकी त्रुटि O(1/√N) के रूप में घटती-बढ़ती है—आयाम से स्वतंत्र। कम आयामों में यह धीमा है, पर आयाम-स्वतंत्र होने के कारण लगभग पाँच से ऊपर के आयामों में यह व्यावहारिक विकल्प बन जाता है।
कुछ क्वाड्रेचर नियम—सिम्पसन समेत—मूल्यांकन बिंदुओं से होकर बहुपद फिट करके और उसका सटीक समाकलन करके काम करते हैं। पर लक्ष्य इंटरपोलेशन से अलग है। इंटरपोलेशन फलन का पुनर्निर्माण करता है; क्वाड्रेचर को सिर्फ एक संख्या चाहिए। बहुपद एक औज़ार है, आउटपुट नहीं।
क्वाड्रेचर में जो संतोष मिलता है, वह एक ही संगठित विचार से मिलने वाली अपार उपयोगिता है। यहाँ की हर विधि—मध्यबिंदु, ट्रैपेज़ॉइडल, सिम्पसन, गॉसियन—दरअसल उसी सवाल के अलग जवाब हैं: फलन-मूल्यांकन के सीमित बजट में आप बिंदु कहाँ रखें और उन्हें कितने भार दें?
मूल्यांकन बिंदुओं से होकर बेहतर बहुपद फिट करने से त्रुटि तेज़ी से घटती है। इष्ट रूप से चुने नोड्स पर शिफ्ट होने से उसी बजट से और भी सटीकता निचोड़ी जा सकती है। फिर अनुकूली विधियाँ सबको साथ लाती हैं, मूल्यांकन वहीं भेजती हैं जहाँ फलन को सच में उनकी ज़रूरत है।
Python में scipy.integrate.quad() 1D समस्याओं के लिए सही डिफ़ॉल्ट है। इस लेख की बाकी बातें तब काम आती हैं जब आप अंदर-ही-अंदर क्या हो रहा है, यह समझना चाहते हैं, या खुद कुछ लागू कर रहे हैं। यदि आप SciPy के साथ अपनी संख्यात्मक क्षमताएँ और बढ़ाना चाहते हैं, तो हमारा Introduction to Optimization in Python कोर्स करें।
DataCamp के साथ सीखें
कोर्स
कोर्स
लर्निंग पाथ