कोर्स
LangChain के साथ Agentic Systems डिज़ाइन करना
3 घंटा
14.7K
Qwen3.5 अलीबाबा की नवीनतम Qwen मॉडल शृंखला है और यह तर्क, कोडिंग और मल्टीमोडल टास्क में पहले के Qwen मॉडलों के मजबूत प्रदर्शन पर आधारित है।
स्वतंत्र बेंचमार्क मूल्यांकन दिखाते हैं कि Qwen3.5-397B-A17B मॉडल LiveCodeBench और AIME26 जैसे व्यापक रूप से उपयोग किए जाने वाले परीक्षणों पर उच्च स्कोर देता है, अक्सर मूल्यांकित श्रेणियों के बहुमत में GPT-5.2 और Claude Opus 4.5 जैसे अग्रणी मॉडलों से बेहतर प्रदर्शन करते हुए, और पिछली Qwen पीढ़ियों की तुलना में उल्लेखनीय रूप से अधिक थ्रूपुट प्रदान करता है।
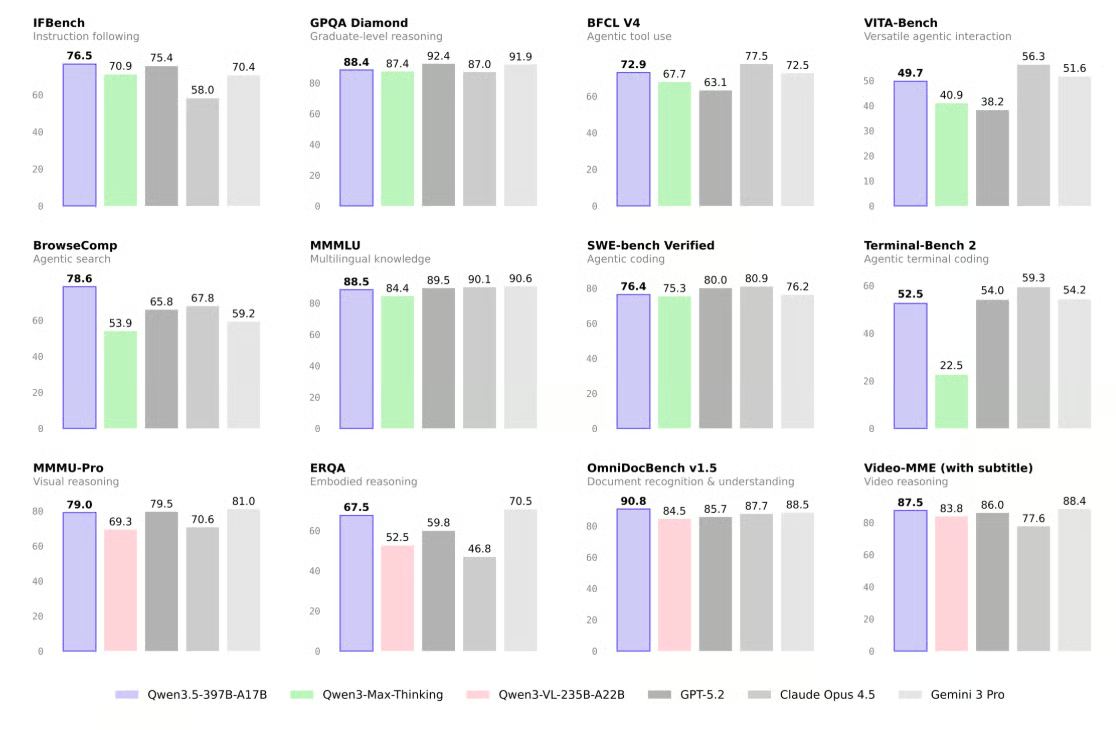
स्रोत: Qwen/Qwen3.5-397B-A17B · Hugging Face
इस ट्यूटोरियल में, हम:
इस गाइड के लिखे जाने के बाद से Qwen आगे बढ़ चुका है। यदि आप Blackwell कार्ड पर हैं, तो RTX 5090 पर Qwen3.8-27B तेज़ सेटअप है, जो NVFP4 और मॉडल के बिल्ट-इन MTP ड्राफ्ट हेड का उपयोग करता है।
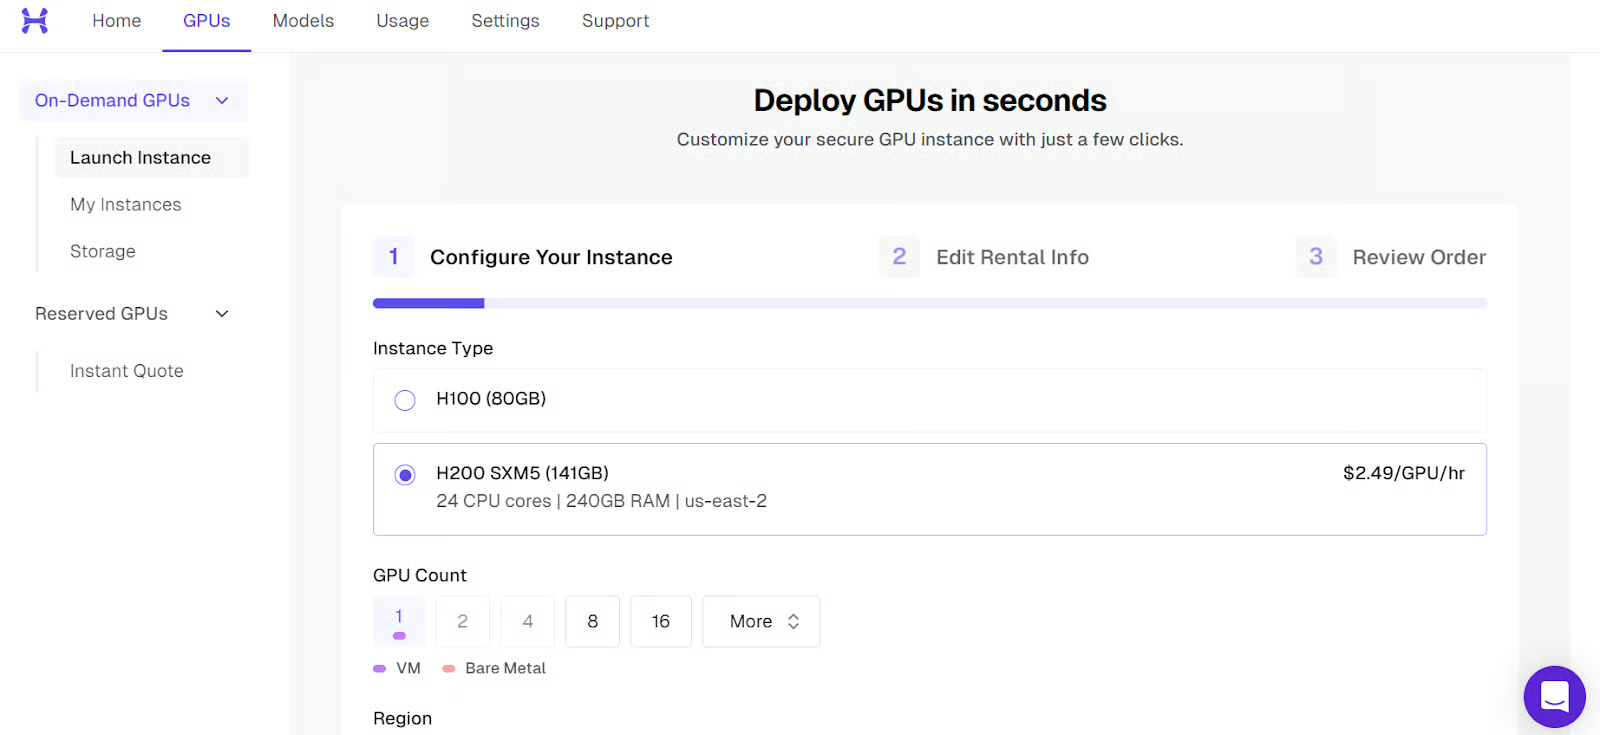
Qwen3.5 को लोकली चलाने से पहले, सुनिश्चित करें कि आपका सेटअप सुचारु इन्फरेंस के लिए हार्डवेयर और सॉफ्टवेयर—दोनों आवश्यकताओं को पूरा करता है। इस ट्यूटोरियल में, हम 141GB VRAM वाले NVIDIA H200 GPU का उपयोग कर रहे हैं, जिसे 240GB सिस्टम RAM के साथ जोड़ा गया है, जो हमें MXFP4_MOE संस्करण को MoE ऑफलोडिंग के साथ कुशलता से चलाने के लिए पर्याप्त मेमोरी देता है।
संदर्भ के तौर पर, Unsloth 4-बिट डायनेमिक क्वांट UD-Q4_K_XL लगभग 214GB डिस्क स्पेस उपयोग करता है। यह सीधे 256GB M3 Ultra पर फिट हो सकता है, और यह 256GB RAM के साथ एकल 24GB GPU पर भी अच्छी तरह चलता है, MoE ऑफलोडिंग के साथ 25+ टोकन प्रति सेकंड हासिल करते हुए। छोटे 3-बिट क्वांट 192GB RAM में फिट हो सकते हैं, जबकि उच्च परिशुद्धता वाले 8-बिट संस्करणों को कुल 512GB RAM और VRAM तक की आवश्यकता हो सकती है।
सामान्यतः, सर्वोत्तम प्रदर्शन के लिए, आपके VRAM + RAM का योग डाउनलोड किए गए क्वांटाइज़्ड मॉडल के आकार के लगभग बराबर होना चाहिए। यदि नहीं, तो llama.cpp SSD स्टोरेज पर ऑफलोड कर सकता है, लेकिन इन्फरेंस धीमा होगा।
सॉफ्टवेयर पक्ष पर, आपके पास नवीनतम NVIDIA GPU ड्राइवर इंस्टॉल होने चाहिए, साथ ही हालिया CUDA Toolkit भी, ताकि llama.cpp और CUDA-त्वरित इन्फरेंस के साथ पूर्ण संगतता सुनिश्चित हो।
अब जब पूर्वापेक्षाएँ पूरी हो गई हैं, तो आइए चरण-दर-चरण देखें कि Qwen 3.5 को लोकली कैसे उपयोग करें:
Qwen3.5 को लोकली चलाने के लिए, आपको एक शक्तिशाली GPU मशीन की आवश्यकता होगी। चूँकि अधिकांश लैपटॉप और डेस्कटॉप पीसी में इस आकार के मॉडलों को संभालने के लिए पर्याप्त VRAM या मेमोरी नहीं होती, हम इसके बजाय क्लाउड GPU वर्चुअल मशीन का उपयोग करेंगे।
इस ट्यूटोरियल में, हम मॉडल को प्राइवेट रूप से चलाने के लिए Hyperbolic का उपयोग कर रहे हैं। आप RunPod, Vast.ai, या कोई भी GPU VM प्लेटफ़ॉर्म उपयोग कर सकते हैं जो आपको पसंद हो। हमने Hyperbolic चुना क्योंकि यह वर्तमान में सबसे किफायती GPU इंस्टेंस में से कुछ ऑफर करता है।
एक सिंगल H200 GPU के साथ नया इंस्टेंस लॉन्च करके शुरू करें।
मशीन बूट होने के बाद, आप सार्वजनिक IP पता और SSH कमांड देखेंगे, जो आपके लोकल टर्मिनल से कनेक्ट होने के लिए आवश्यक है।
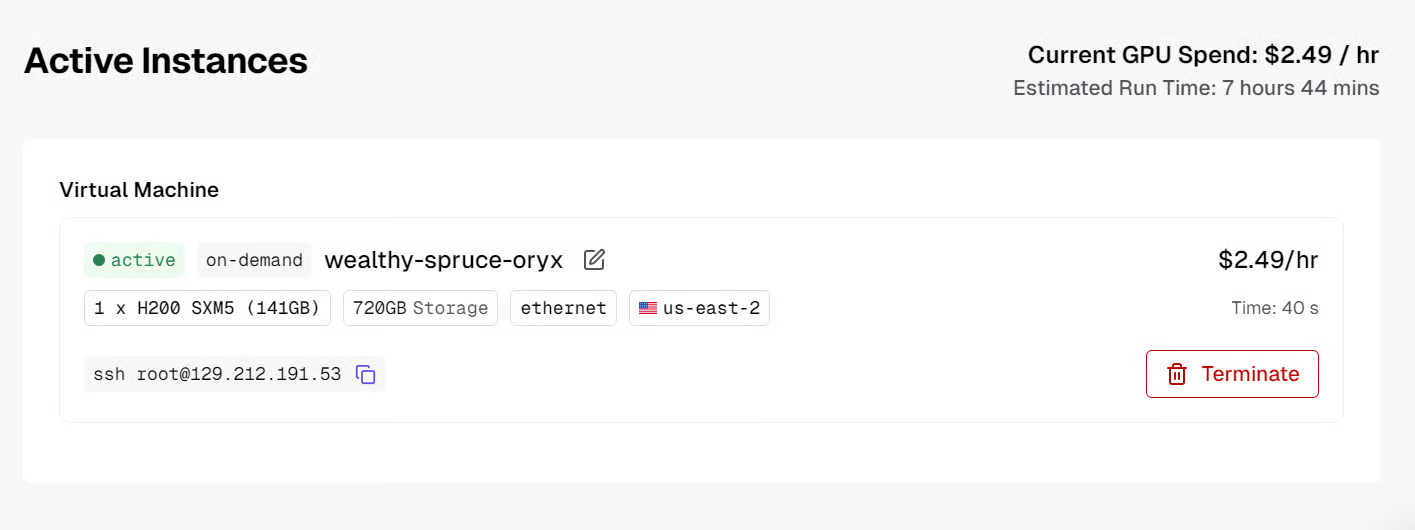
कनेक्ट करने से पहले, सुनिश्चित करें कि आपने लोकली SSH सेट किया है और आपने वर्चुअल मशीन बनाते समय अपना पब्लिक SSH की जोड़ा है।
इंस्टेंस तैयार होने पर, पोर्ट फ़ॉरवर्डिंग के साथ SSH का उपयोग करके कनेक्ट करें। यह महत्वपूर्ण है क्योंकि हम पोर्ट 8080 के माध्यम से लोकली llama.cpp इन्फरेंस सर्वर तक पहुँच चाहते हैं:
ssh -L 8080:localhost:8080 root@129.212.191.53पहली बार कनेक्ट होने पर, पुष्टि के लिए yes टाइप करें, और फिर अपने SSH की से प्रमाणीकरण करें।
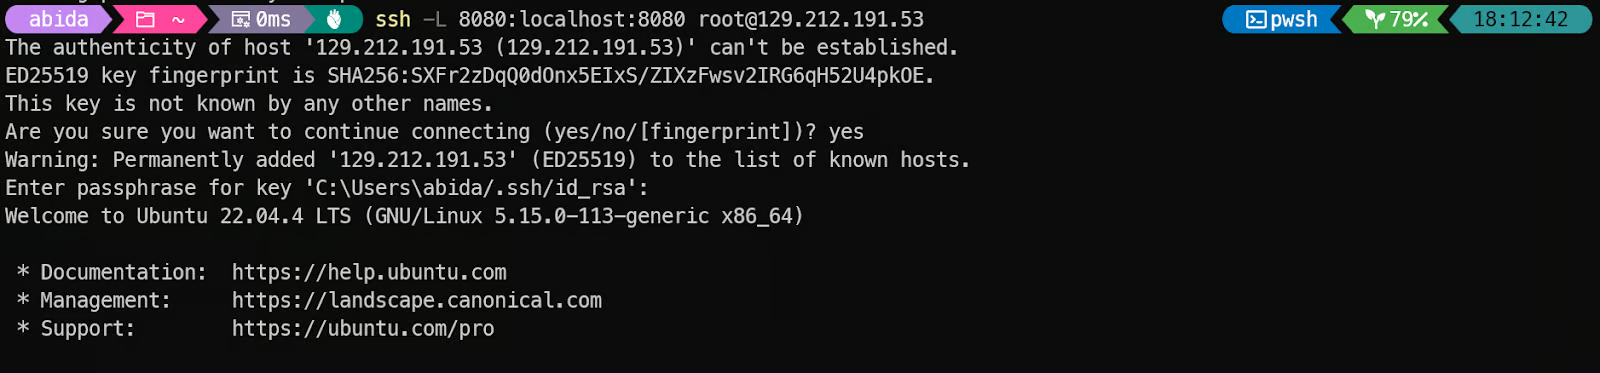
लॉगिन के बाद, जाँचें कि GPU सही तरीके से डिटेक्ट हो रहा है:
nvidia-smi आपको आउटपुट में NVIDIA H200 सूचीबद्ध दिखना चाहिए।
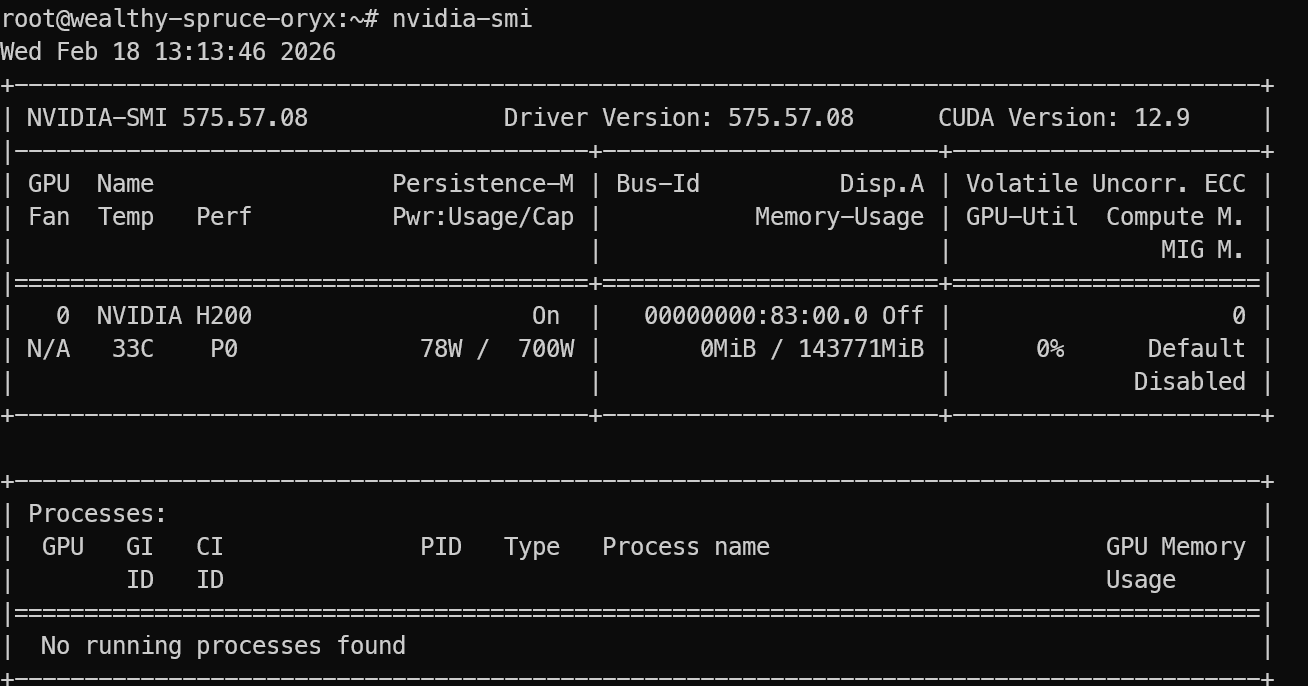
अंत में, वे आवश्यक Linux पैकेज इंस्टॉल करें जो llama.cpp को डाउनलोड, बिल्ड और चलाने के लिए चाहिए:
sudo apt update
sudo apt install pciutils build-essential cmake curl libcurl4-openssl-dev -y
यह पूरा हो जाने पर, आपका वातावरण llama.cpp इंस्टॉल करने और Qwen3.5 को लोकली चलाने के लिए तैयार है।
llama.cpp एक ओपन-सोर्स C और C++ इन्फरेंस इंजन है जो आपको बड़े भाषा मॉडल लोकली न्यूनतम सेटअप के साथ चलाने देता है, और यह CPU तथा GPU—दोनों एक्सेलेरेशन सपोर्ट करता है।
सबसे पहले, llama.cpp रिपॉज़िटरी क्लोन करें:
git clone https://github.com/ggml-org/llama.cppइसके बाद, CMake के साथ CUDA-सक्षम बिल्ड कॉन्फ़िगर करें। हम -DGGML_CUDA=ON से CUDA सक्षम करते हैं, और हम CUDA आर्किटेक्चर 90a सेट करते हैं क्योंकि हम NVIDIA H200 (Hopper क्लास) का उपयोग कर रहे हैं। यह बिल्ड को Hopper फीचर्स के लिए अनुकूलित GPU कोड जनरेट करने में मदद करता है।
cmake llama.cpp -B llama.cpp/build \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES="90a"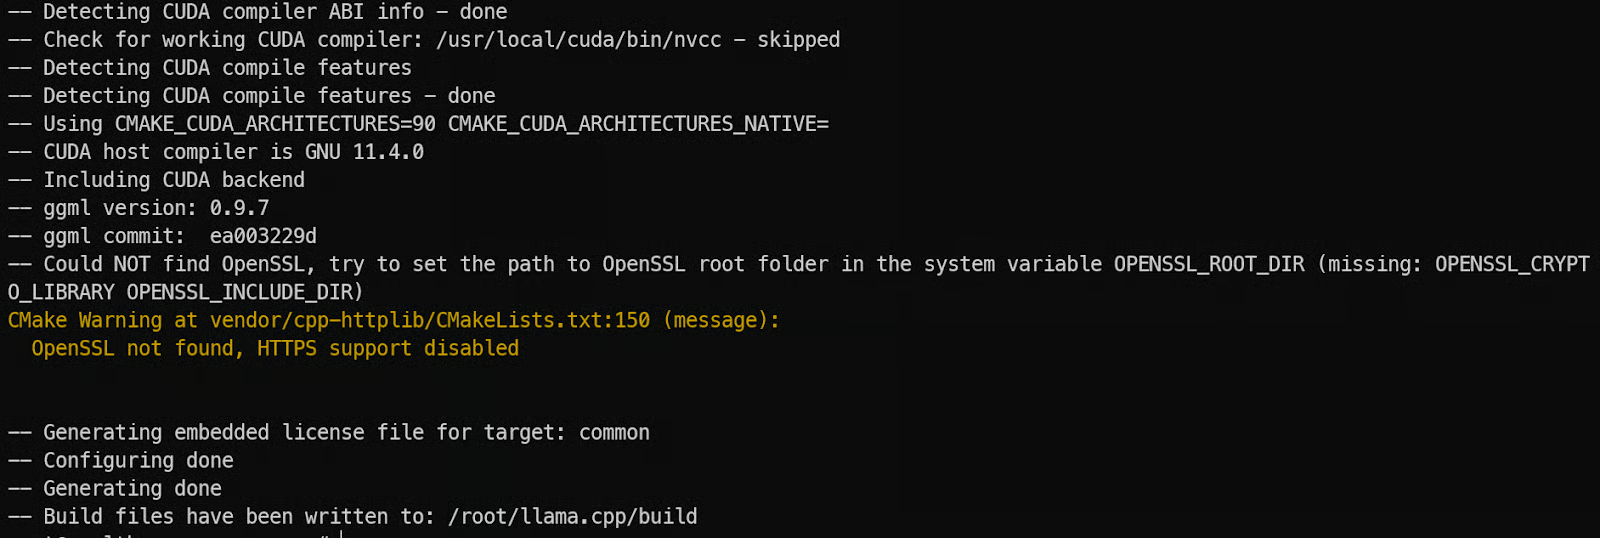
अब सर्वर बाइनरी कम्पाइल करें। llama-server बिल्ट-इन REST सर्वर है जो आपको llama.cpp को API एंडपॉइंट के रूप में एक्सपोज़ करने देता है:
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-server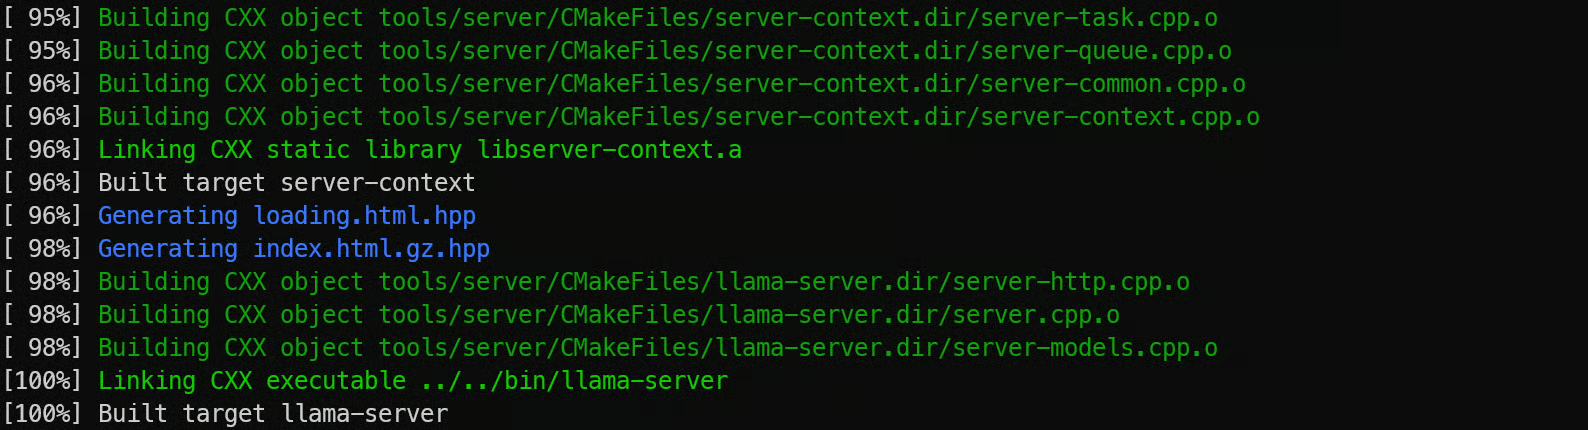
अंत में, कम्पाइल की गई बाइनरीज़ को मुख्य फ़ोल्डर में कॉपी करें ताकि उन्हें चलाना आसान हो:
cp llama.cpp/build/bin/llama-* llama.cppअब जब llama.cpp इंस्टॉल हो गया है, अगला चरण GGUF फ़ॉर्मेट में वास्तविक Qwen3.5 मॉडल वेट्स डाउनलोड करना है। ये फाइलें बड़ी हैं, इसलिए Hugging Face CLI का उपयोग सीधे आपके GPU मशीन पर उन्हें फेच करने का सबसे भरोसेमंद तरीका है।
हम पहले Python इंस्टॉल करते हैं क्योंकि Hugging Face डाउनलोड टूल और ऑथेंटिकेशन यूटिलिटी Python पैकेज के रूप में वितरित की जाती हैं। भले ही llama.cpp स्वयं C++ में लिखा गया है, Python मॉडल डाउनलोड और ट्रांसफर को मैनेज करना कहीं आसान बनाता है।
pip इंस्टॉल करके शुरू करें:
sudo apt install python3-pipअब Hugging Face Hub क्लाइंट को परफॉर्मेंस हेल्पर्स के साथ इंस्टॉल करें। hf_transfer और hf-xet डाउनलोड को काफ़ी तेज़ कर देते हैं, जो सैकड़ों गीगाबाइट के मॉडल फाइलें खींचते समय महत्वपूर्ण होता है:
pip -q install -U huggingface_hub hf-xet
pip -q install -U hf_transfer
अब Hugging Face से Qwen3.5 मॉडल डाउनलोड करें। इस ट्यूटोरियल में, हम केवल MXFP4_MOE वेरिएंट फेच करते हैं, जो कुशल MoE इन्फरेंस के लिए ऑप्टिमाइज़्ड है:
hf download unsloth/Qwen3.5-397B-A17B-GGUF \
   --local-dir models/Qwen3.5 \
   --include "*MXFP4_MOE*"
डाउनलोड पूरा होने पर, मॉडल फाइलें models/Qwen3.5 के अंदर स्टोर हो जाएँगी, और लोकल इन्फरेंस के लिए llama.cpp में लोड करने के लिए तैयार रहेंगी।
अब हम llama-server का उपयोग करके Qwen3.5 शुरू कर सकते हैं। इससे हमें एक OpenAI-कंपैटिबल API एंडपॉइंट मिलता है जिसे हम लोकल टूल्स और ऐप्स से कॉल कर सकते हैं।
हमने सर्वर को सिंगल GPU सेटअप के लिए तीन प्रमुख तरीकों से ऑप्टिमाइज़ किया है। पहला, हम --fit on सक्षम करते हैं ताकि llama.cpp GPU VRAM और सिस्टम RAM के बीच मॉडल को स्वतः संतुलित करे, बजाय इसके कि मॉडल पूरी तरह VRAM में फिट न होने पर विफल हो जाए।
दूसरा, हम --ctx-size 16384 के साथ बड़ा कॉन्टेक्स्ट विंडो इस्तेमाल करते हैं ताकि सर्वर लंबे प्रॉम्प्ट संभाल सके। तीसरा, हम --jinja सक्षम करते हैं और --chat-template-kwargs पास करते हैं ताकि चैट फ़ॉर्मैटिंग नियंत्रित की जा सके और तेज़, अधिक सीधे उत्तरों के लिए थिंकिंग मोड निष्क्रिय किया जा सके।
सर्वर को इस तरह चलाएँ:
./llama.cpp/llama-server \
    --model models/Qwen3.5/MXFP4_MOE/Qwen3.5-397B-A17B-MXFP4_MOE-00001-of-00006.gguf \
    --alias "Qwen3.5" \
  --host 0.0.0.0 \
  --port 8080 \
  --fit on \
  --jinja \
   --ctx-size 16384 \
   --temp 0.7 \
   --top-p 0.8 \
   --top-k 20 \
   --min-p 0.00 \
   --chat-template-kwargs "{\"enable_thinking\": false}"
मॉडल लोड होते समय, आप देखेंगे कि यह GPU VRAM और सिस्टम मेमोरी—दोनों का उपयोग करता है, जो एक बड़े MoE मॉडल के लिए अपेक्षित है।
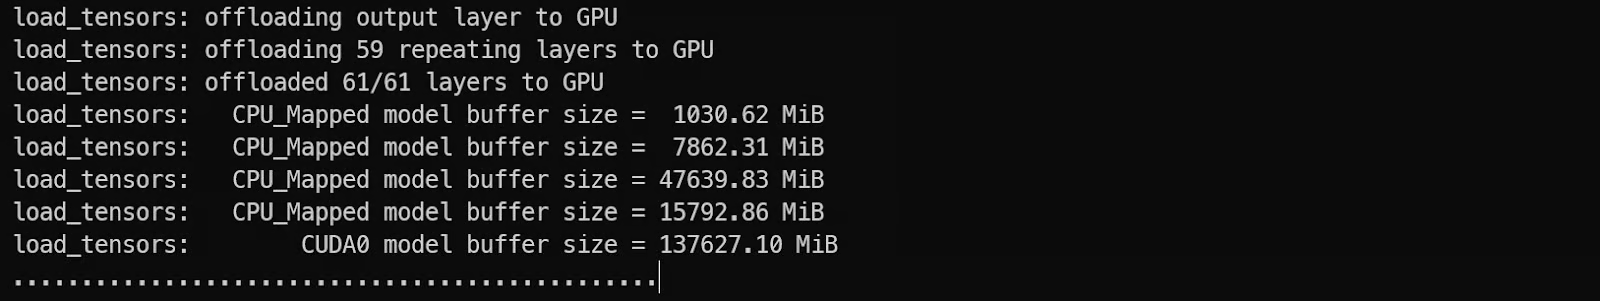
लोडिंग पूरी होने पर, सर्वर यहाँ पहुँचा जा सकेगा:
0.0.0.0:8080 VM परhttp://127.0.0.1:8080 आपके लोकल मशीन पर SSH पोर्ट फ़ॉरवर्डिंग के बाद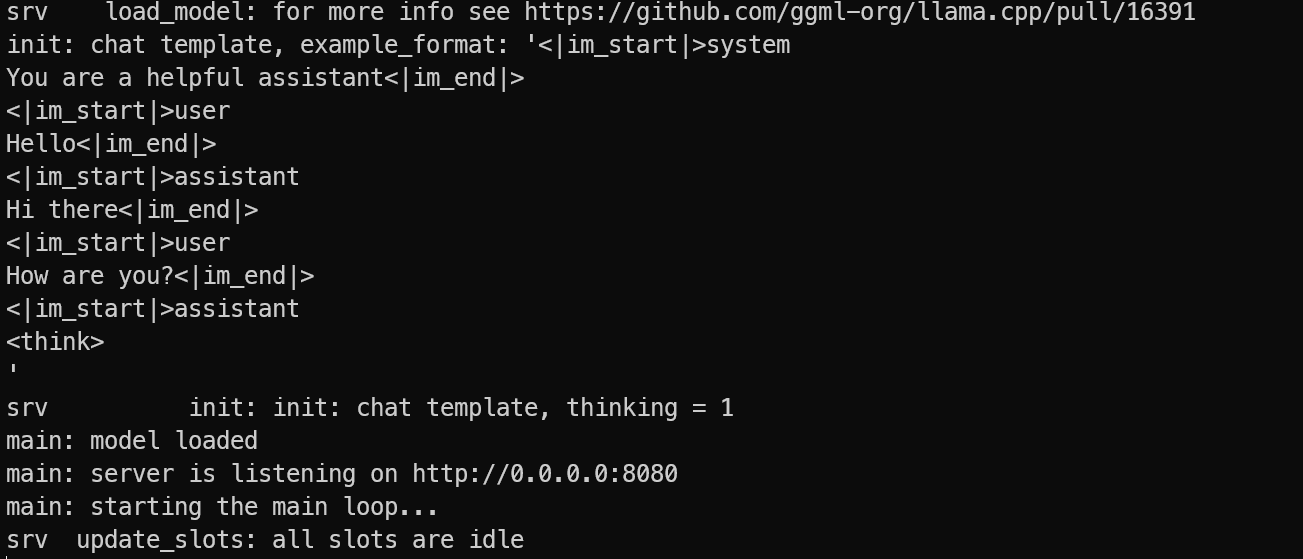
सर्वर को चलता रहने दें। अपने लोकल पीसी पर, एक नया टर्मिनल खोलें और SSH पोर्ट फ़ॉरवर्डिंग के साथ फिर से कनेक्ट करें:
ssh -L 8080:localhost:8080 root@129.212.191.53फिर उपलब्ध मॉडलों की सूची बनाकर सर्वर का परीक्षण करें:
curl -s http://127.0.0.1:8080/v1/modelsयदि आपको प्रतिक्रिया में Qwen3.5 दिखे, तो आपका सर्वर सही ढंग से चल रहा है, और आप OpenAI SDK और अपनी लोकल ऐप्स से इसे कॉल करने के लिए तैयार हैं।

अब जब Qwen3.5 इन्फरेंस सर्वर चल रहा है, अगला कदम यह सत्यापित करना है कि यह वास्तविक क्लाइंट एप्लिकेशन के साथ सही ढंग से काम करता है। llama.cpp के सबसे बड़े फायदों में से एक यह है कि llama-server एक OpenAI-कंपैटिबल API एक्सपोज़ करता है, जिसका अर्थ है कि आप अपने कोड स्ट्रक्चर को बदले बिना आधिकारिक OpenAI SDK का उपयोग कर सकते हैं।
सबसे पहले, अपने लोकल मशीन (या चाहें तो VM के अंदर) पर OpenAI Python पैकेज इंस्टॉल करें:
pip install openai अब एक साधारण टेस्ट स्क्रिप्ट चलाएँ। यह OpenAI के क्लाउड सर्वरों के बजाय http://127.0.0.1:8080/v1 पर आपके लोकली फ़ॉरवर्ड किए गए एंडपॉइंट से कनेक्ट होता है।
python3 - <<'PY'
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required"
)

response = client.chat.completions.create(
    model="Qwen3.5",
    messages=[
        {"role": "user", "content": "Write one sentence about AI agents."}
    ]
)

print(response.choices[0].message.content)
PY
यहाँ कुछ महत्वपूर्ण बातें समझने योग्य हैं:
base_url आपके लोकल Qwen3.5 सर्वर की ओर इंगित करता है, न कि OpenAI के API की ओर।api_key SDK द्वारा अभी भी आवश्यक है, लेकिन llama.cpp प्रमाणीकरण लागू नहीं करता, इसलिए कोई भी placeholder मान काम कर जाता है।model="Qwen3.5" वही नाम है जो हमने सर्वर शुरू करते समय उपनाम के रूप में सेट किया था।यदि सब कुछ सही से कॉन्फ़िगर है, तो आपको मॉडल से तेज़, साफ़ प्रतिक्रिया मिलेगी।
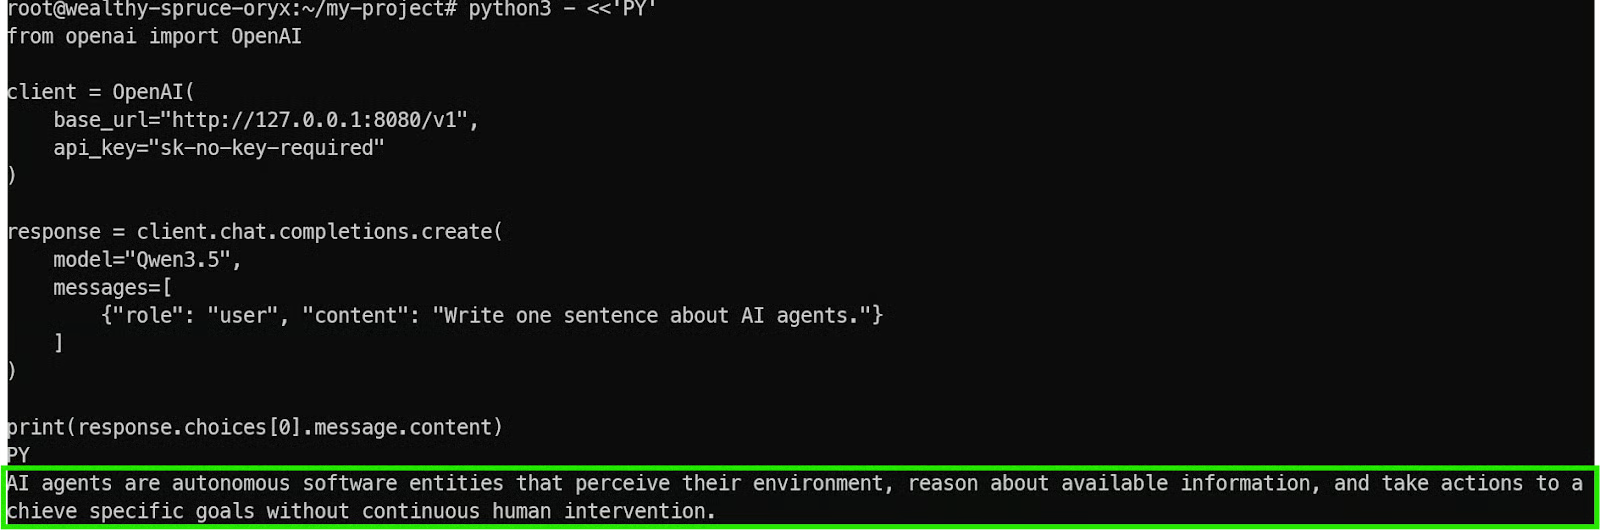
यह पुष्टि करता है कि:
इस बिंदु पर, आप Qwen3.5 को किसी भी लोकल टूल, एजेंट वर्कफ़्लो, या एप्लिकेशन में इंटीग्रेट कर सकते हैं जो पहले से OpenAI API फ़ॉर्मैट को सपोर्ट करता है।
llama.cpp में एक बिल्ट-इन, ChatGPT-स्टाइल WebUI शामिल है जिसका उपयोग आप अपने ब्राउज़र में सीधे मॉडल से चैट करने के लिए कर सकते हैं। यह त्वरित परीक्षण, प्रॉम्प्ट इटरेशन, और बिना कोई क्लाइंट स्क्रिप्ट लिखे कोड जनरेट करने के लिए उपयोगी है।
चूँकि हमने पहले ही SSH पोर्ट फ़ॉरवर्डिंग सेट कर ली है, आप अपने लोकल मशीन पर WebUI खोल सकते हैं, और यह ऐसे व्यवहार करेगा मानो सर्वर आपके लैपटॉप पर चल रहा हो।
डिफ़ॉल्ट रूप से, WebUI यहाँ उपलब्ध है:
http://127.0.0.1:8080यदि यह पेज लोड होता है, तो यह दो बातें पुष्ट करता है। आपका SSH टनल सही ढंग से काम कर रहा है, और Qwen3.5 सर्वर GPU VM पर प्राइवेट रूप से चलते हुए भी लोकली पहुँचा जा सकता है।
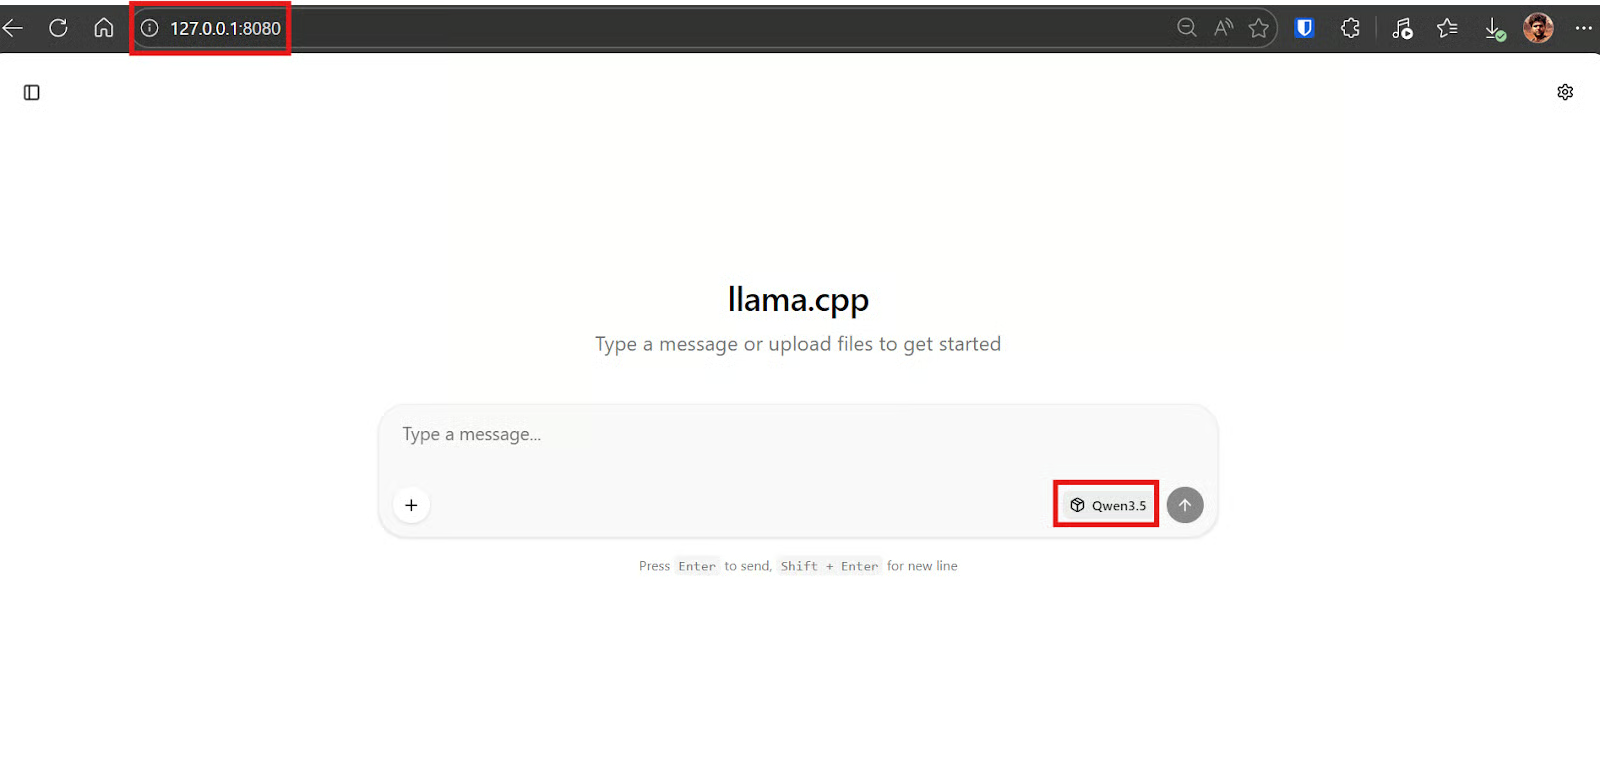
WebUI में पहुँचने के बाद, यह प्रॉम्प्ट पेस्ट करें। उद्देश्य है कि मॉडल Python कोड और एक छोटा उपयोग गाइड—दोनों जनरेट करे।
कुछ ही सेकंड में, Qwen3.5 को एक app.py फ़ाइल और आमतौर पर इसे कैसे चलाना है, इस पर एक त्वरित व्याख्या जनरेट करनी चाहिए।
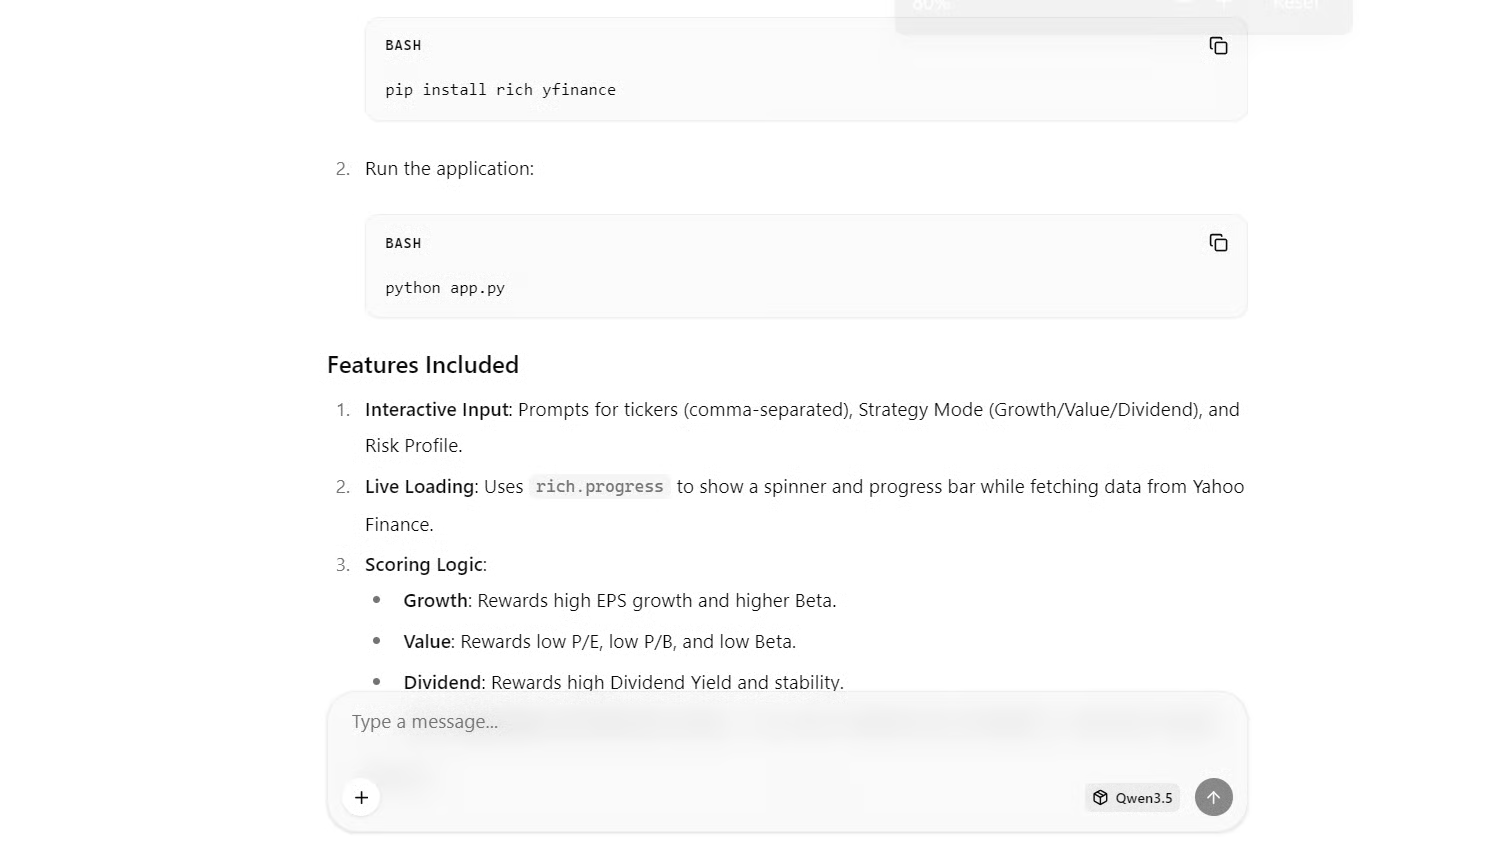
अब अपने लोकल टर्मिनल (लैपटॉप) पर स्विच करें। जनरेटेड ऐप के लिए आवश्यक निर्भरताएँ इंस्टॉल करें:
pip install rich yfinanceयह इंस्टॉल करता है:
rich TUI लेआउट, टेबल, प्रॉम्प्ट और प्रोग्रेस इंडिकेटर के लिएyfinance फ्री, सार्वजनिक स्टॉक मेट्रिक्स खींचने के लिएएक app.py नामक फ़ाइल बनाएँ, मॉडल द्वारा जनरेट किया गया कोड पेस्ट करें, और चलाएँ:
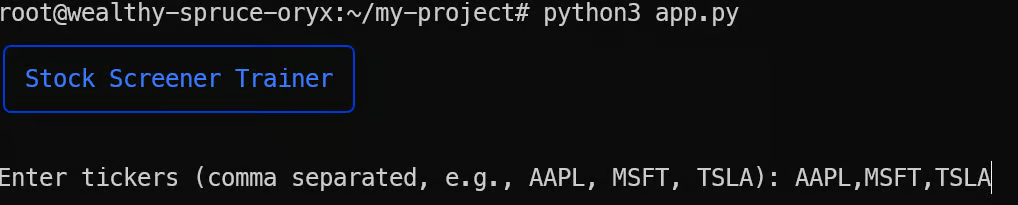
python3 app.pyस्क्रिप्ट चलाने के बाद, आपको अपने टर्मिनल में TUI सही ढंग से लॉन्च होता दिखना चाहिए। ऐप आपसे वे स्टॉक टिकर्स दर्ज करने के लिए कहेगा जिनका आप विश्लेषण करना चाहते हैं, साथ ही आपका पसंदीदा स्क्रीनिंग मोड और रिस्क स्तर भी।
उदाहरण के लिए, हमने इसे तीन लोकप्रिय स्टॉक्स के साथ टेस्ट किया।
थोड़े से लोडिंग फेज़ के बाद, टूल स्टॉक मेट्रिक्स की पूरी टेबल लौटाता है, स्कोरिंग नियमों के आधार पर परिणामों को हाइलाइट करता है, और सब कुछ एक results.csv फ़ाइल में सेव कर देता है।
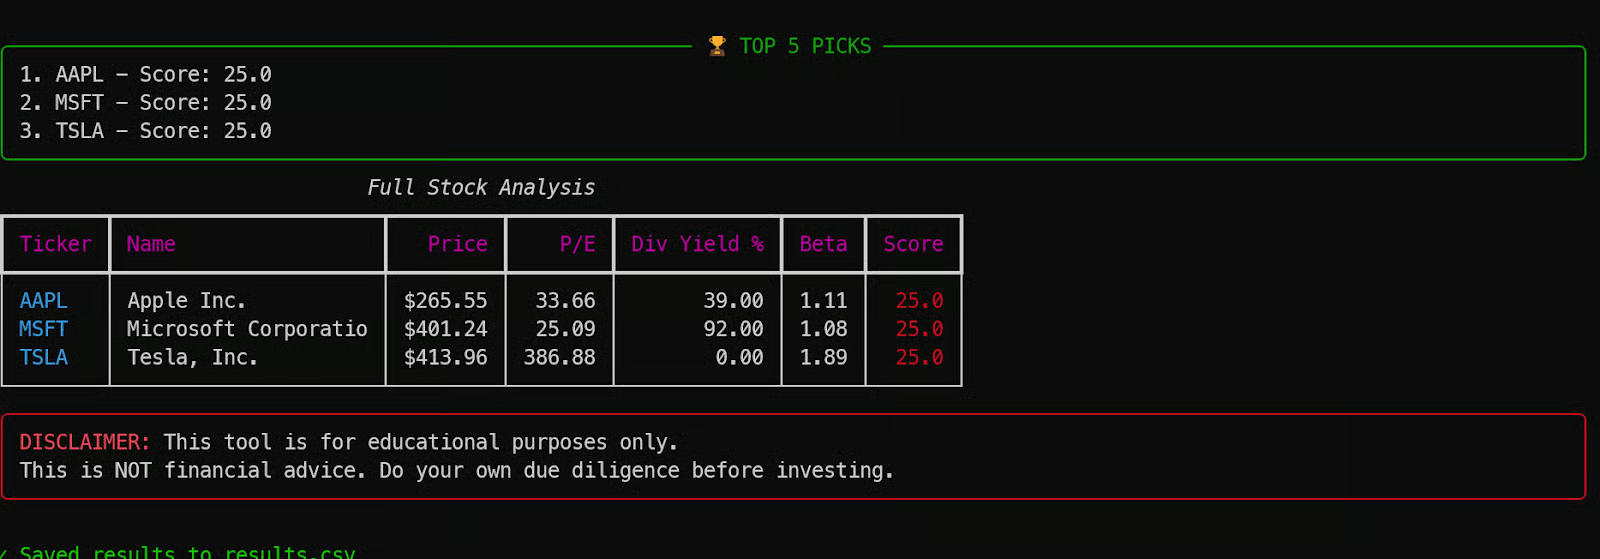
यह इस बात का बढ़िया उदाहरण है कि Qwen3.5 केवल एक 4-बिट क्वांटाइज़्ड मॉडल एंडपॉइंट और एक साधारण प्रॉम्प्ट के साथ एक बार में पूरा काम करने वाला एप्लिकेशन कैसे जनरेट कर सकता है।
Qwen3.5 को लोकली चलाना एक फ्रंटियर-स्केल मॉडल तक पहुँचने का शक्तिशाली तरीका है, जबकि सब कुछ निजी और आपके पूर्ण नियंत्रण में रहता है। इस ट्यूटोरियल में, मॉडल एक सिंगल H200 GPU VM पर होस्ट किया गया, जिसे SSH पोर्ट फ़ॉरवर्डिंग का उपयोग करके लोकल मशीन से सुरक्षित रूप से एक्सेस किया गया, और एक ऑप्टिमाइज़्ड llama.cpp OpenAI-कंपैटिबल एंडपॉइंट के माध्यम से सर्व किया गया।
फिर भी, कुछ व्यावहारिक सीमाएँ ध्यान में रखने योग्य हैं। चूँकि सब कुछ एक सक्रिय SSH टनल पर निर्भर करता है, कनेक्शन स्थिर रहना चाहिए। यदि आपका इंटरनेट ड्रॉप हो जाता है या सत्र डिस्कनेक्ट हो जाता है, तो आप लोकल पोर्ट तक पहुँच खो देते हैं और अक्सर वर्कफ़्लो के कुछ हिस्सों को फिर से कनेक्ट और रीस्टार्ट करना पड़ता है।
एक और आम समस्या है llama.cpp को सही ढंग से बिल्ड करना। यदि आप अपने GPU के लिए सही CUDA आर्किटेक्चर फ़्लैग निर्दिष्ट नहीं करते, तो कम्पाइलेशन में बहुत अधिक समय लग सकता है और हार्डवेयर के लिए पूर्ण रूप से ऑप्टिमाइज़ नहीं हो पाता। शुरुआत में ही सही आर्किटेक्चर सेट करना बिल्ड समय और प्रदर्शन में स्पष्ट अंतर लाता है।
अंततः, जबकि 4-बिट MXFP4_MOE क्वांट बड़े मॉडलों को कुशलता से चलाने के लिए उत्कृष्ट है, यह हमेशा एजेंटिक कोडिंग वर्कफ़्लोज़ के लिए आदर्श नहीं होता। Qwen Code CLI, Kilo Code CLI, और OpenCode जैसे टूल्स के साथ परीक्षण में, मॉडल गहन तर्क में संघर्ष करता दिखा और अक्सर लंबे जेनरेशन लूप्स के दौरान विफल हो गया, कभी-कभी GPU अस्थिरता भी ट्रिगर कर देता था।
उच्च परिशुद्धता क्वांट या छोटे, तर्क-केंद्रित मॉडल विश्वसनीय एजेंट-आधारित कोडिंग के लिए बेहतर काम कर सकते हैं।
एजेंटिक कोडिंग के बारे में अधिक जानने के लिए, हमारा AI-Assisted Coding for Developers कोर्स देखें। मैं हमारे r पर गाइड की भी सिफारिश करता हूँलोकली GLM-5 चलाने के लिए एजेंटिक कोडिंग।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स