热力图是一种常见的数据可视化技术,使用颜色来表示数据幅度的不同水平,帮助您快速识别数据集中的模式和异常。
Seaborn 库可让您轻松创建高度自定义的数据可视化,如折线图、直方图和热力图。您也可以查看我们的教程:数据图表的不同类型及其在 Python 中的创建方法。
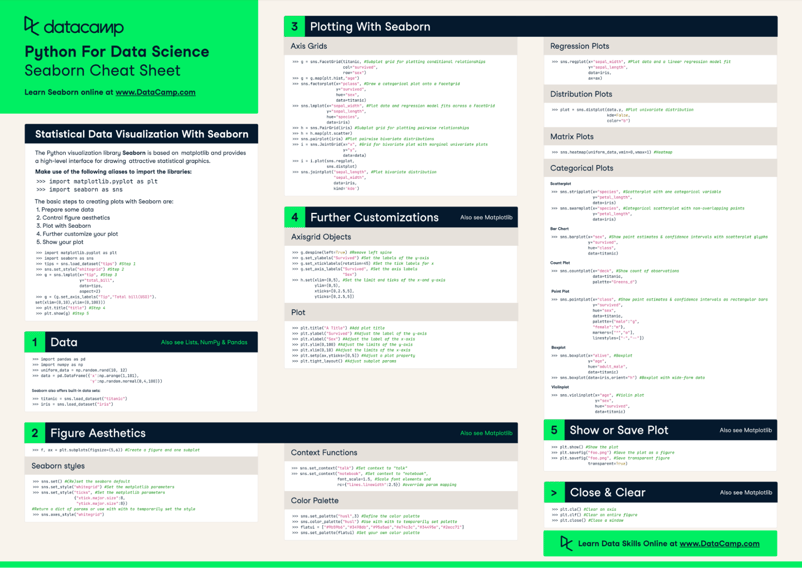
绘图与自定义 Seaborn 可视化时,请随身参考我们的 Seaborn 速查表以便快速查询。
在本教程中,我们将探讨什么是 Seaborn 热力图、何时使用它们,以及如何创建和自定义它们以满足您的需求。
理解热力图
什么是热力图?
热力图以网格形式组织数据,用不同的颜色或色阶来表示数据幅度的不同水平。
热力图的可视化特性使您能够立即识别模式,例如聚类、趋势和异常。这使得热力图成为探索性数据分析的有效工具。
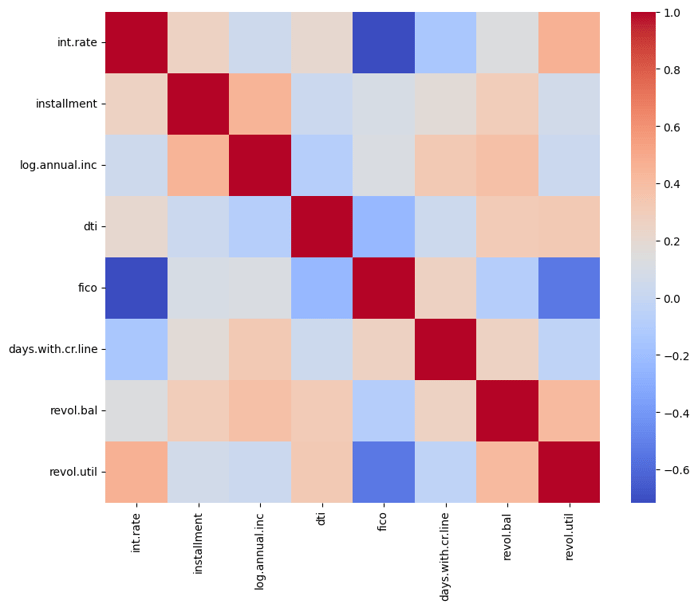
下面是一个 Seaborn 热力图示例:
何时应使用热力图?
是否选择使用热力图取决于您的需求和数据集的性质。总体而言,热力图最适用于可用颜色表示取值的 数据集,通常是连续或离散的数值型数据。不过,对于已量化或汇总的分类型数据(例如计数、均值),也可以使用热力图。
如果数据集中存在极端离群值或非常稀疏,不经过预处理或归一化,热力图的效果可能不佳。文本、图像等非结构化数据也不适合直接用于热力图,除非先将其转换为结构化的数值格式。
热力图在可视化多个变量之间的相关矩阵方面表现出色,可让您一眼识别高度正相关或负相关的变量。
热力图还适用于在两个维度上进行数据的可视化比较,例如不同时间段或类别。对于地理数据分析,热力图可以表示空间布局中事件的密度或强度,例如城市人口密度或犯罪热点。
开始使用 Seaborn 热力图
设置您的环境
在本教程中,我们将使用 DataCamp 的 AI 加持数据笔记本 DataLab 上提供的关于贷款的数据集。本教程的代码也可在相应的 DataLab 工作簿中获取。
在 DataLab 中,各大主流库都已方便地预装并可直接导入。若想了解更多,请参阅我们关于数据科学顶级 Python 库的文章。
本教程将使用以下库:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns技术支持
如果您不熟悉 Python、需要快速上手本教程,请查看我们的 Python 入门课程。
或者,如果您想进一步了解本教程中将使用的库,可以查看以下课程:
准备您的数据
请确保您的数据为矩阵格式,行与列表示不同的维度(例如时间段、变量、类别)。矩阵中的每个单元格应包含您希望可视化的数值。
数据清洗
在使用热力图之前,您应执行两项主要的数据清洗任务:处理缺失值和移除离群值。
处理缺失值时,您可以使用统计量(均值、中位数)填充、插值,或在不重要时直接删除。对于离群值,根据您的分析目的,您可以将其移除或调整其取值。
在我们的贷款数据集中,没有缺失值,但我们识别出了一些离群值并决定移除。请查看 DataLab 上的笔记本,了解我们如何实现的完整代码。
数据归一化或缩放
如果您的数据集跨越较大的取值范围,请考虑进行缩放或归一化。这能使热力图的颜色更准确地表示相对差异。常见方法包括最小-最大缩放和 Z 分数归一化。
对于需要分箱的连续数据,考虑将其离散化为若干区间或类别,以获得更有意义的热力图可视化。
语法与参数
要使用 seaborn.heatmap(),通常需要传入一个数据矩阵。然后,您可根据需求调整参数来自定义热力图。
-
data:要可视化的数据集,必须为矩阵形式。
-
cmap:指定热力图的颜色映射。Seaborn 支持多种配色方案,包括顺序型、发散型和定性方案。
-
annot:若设为 True,将在热力图的每个单元格中标注取值。
-
fmt:当 annot 为 True 时,fmt 决定标注数据的字符串格式代码。例如,'d' 表示整数,'.2f' 表示保留两位小数的浮点数。
-
linewidths:设置分隔每个单元格的线宽。值越大,单元格之间的分隔越明显。
-
linecolor:当 linewidths 大于 0 时,指定分隔线的颜色。
-
cbar:布尔值,指示是否绘制颜色条。颜色条用于将数据值映射到颜色。
-
vmin 和 vmax:定义颜色映射所覆盖的数据范围。
-
center:在使用发散型配色方案时,设置颜色映射的中心值。
-
square:若设为 True,确保热力图单元格为正方形。
-
xticklabels 和 yticklabels:控制 x 轴与 y 轴上显示的标签。
创建您的第一个 Seaborn 热力图
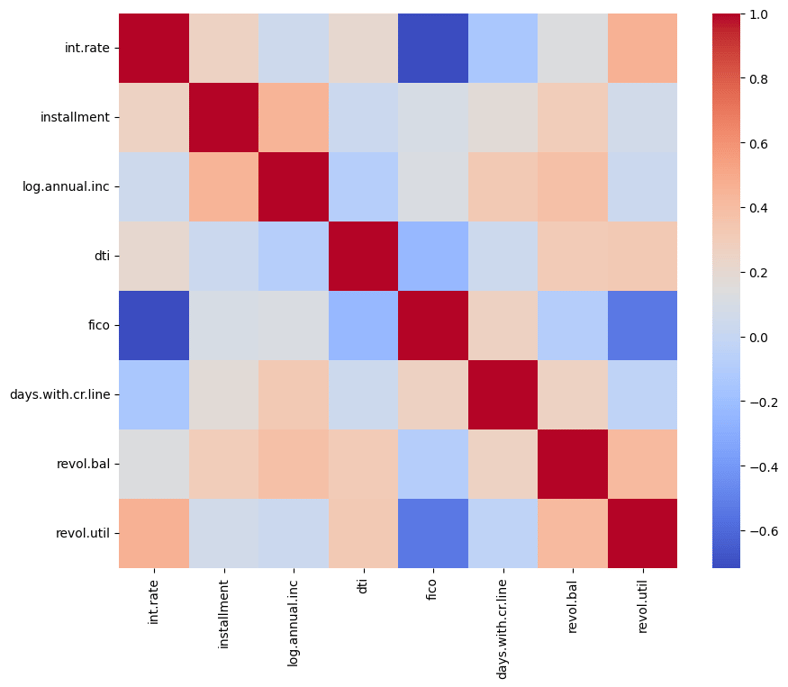
我们将创建一个热力图,显示数据中每个数值变量之间的相关系数。当前我们先保持热力图简洁,在下一节再进一步自定义。
correlation_matrix = filtered_df.corr()
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'coolwarm')
plt.show()
技术支持
自定义您的 Seaborn 热力图
颜色自定义
自定义热力图的颜色能够提升可读性,并让报告与演示中的可视化更吸睛。
Seaborn 与 Matplotlib 提供了丰富的内置颜色映射。可尝试不同的颜色映射(如 'Blues'、'coolwarm'、'viridis' 等),以找到能有效突出数据结构与模式的方案。对于从低到高具备自然顺序的数据使用顺序型配色;对具有关键中点的数据使用发散型配色;对分类型数据使用定性配色。
不过,您并不限于 Seaborn 提供的默认配色和选项。您可以使用 Matplotlib 创建自定义配色,并指定额外的自定义选项,如调整透明度。
设置 vmin 和 vmax 可控制颜色映射覆盖的数据范围。这有助于增强对比度并聚焦于特定的关注区间。
对于发散型配色,请使用 center 参数指定中点值,确保颜色对比围绕关键值锚定。
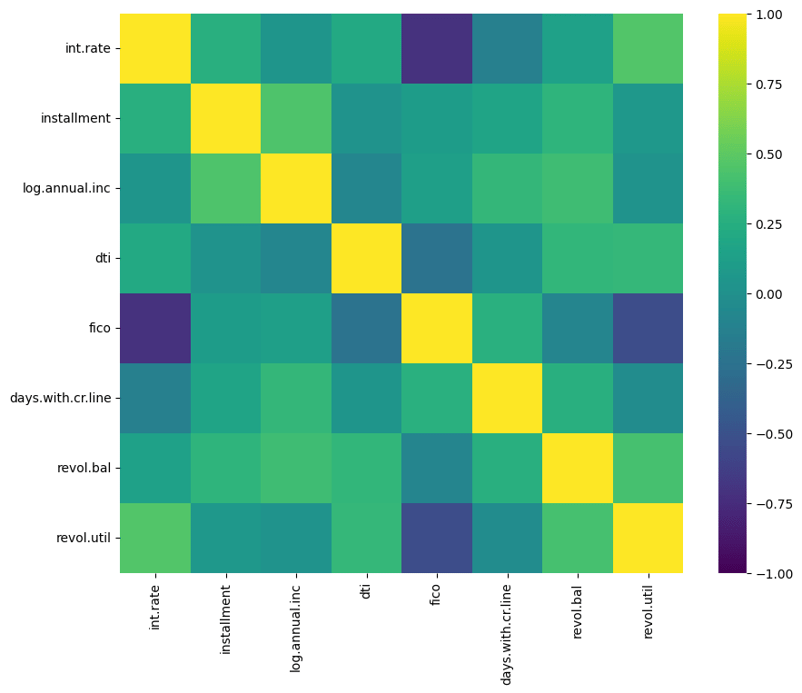
我们将调整热力图的配色,并通过指定最小值、最大值和中心值来锚定颜色。
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0)
plt.show()
技术支持
数据标注
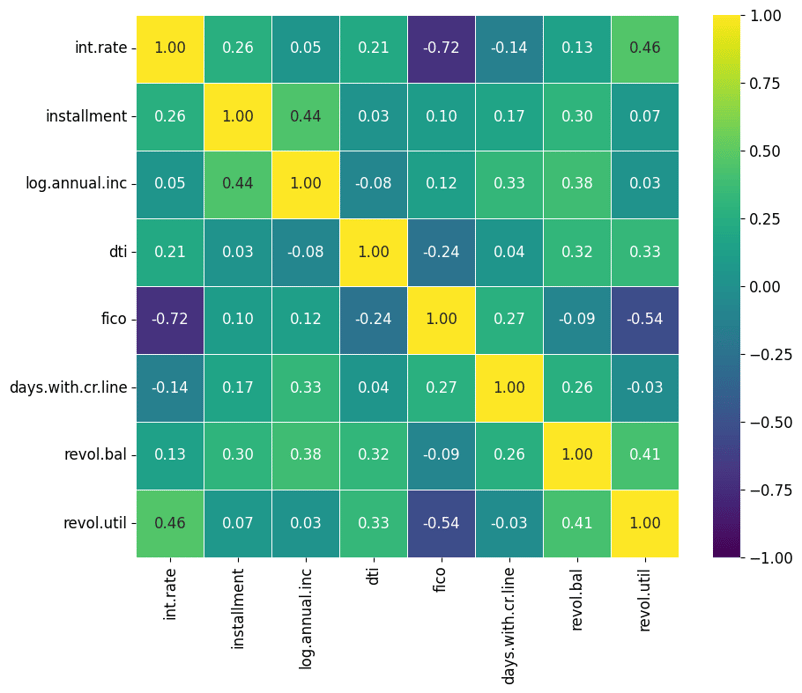
数据标注是指在每个单元格中添加标签,显示数值或文本。标注可让热力图更易读、易于快速解读,而无需根据图例推断取值。
要启用标注,将 annot 参数设为 True。这样会在热力图的每个单元格中显示数据值。
fmt 参数可用于设置标注文本的格式。例如,'d' 表示整数格式,'.2f' 表示保留两位小数的浮点数。
尽管 Seaborn 的热力图函数无法直接通过 annot 参数自定义字体大小等文本属性,但您可以通过 Matplotlib 的 rcParams 全局调整这些属性。
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5)
plt.show()
技术支持
annot 参数也可以接受与数据形状相同的类数组结构。这是一个巧妙的方法,可在标注中显示与单元格颜色不同的信息。以下是一个可供参考的示例:
annot_array = np.round(data*100, decimals=2)
sns.heatmap(data, annot=annot_array, fmt='s')技术支持
数据掩蔽
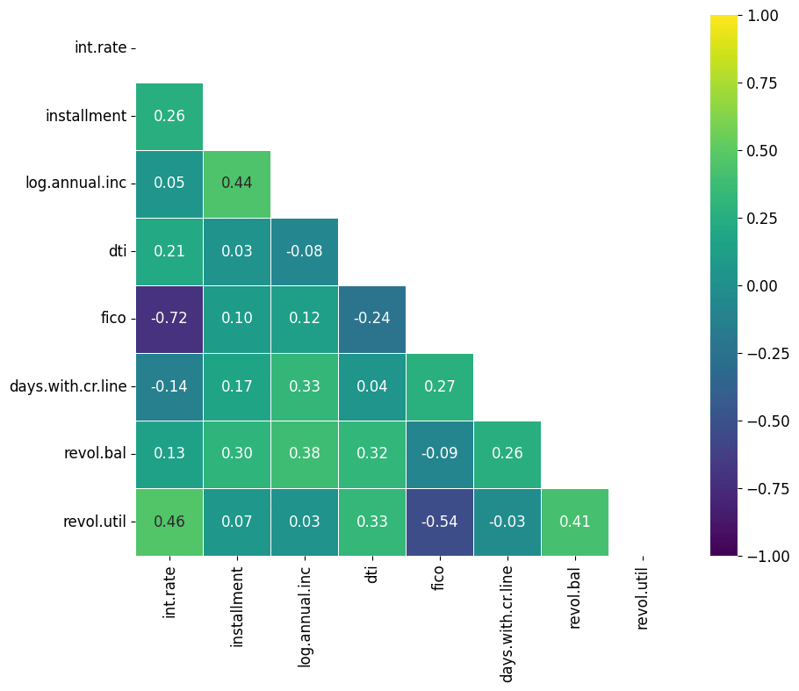
数据掩蔽是一种根据特定条件有选择地高亮或隐藏某些数据点的技术。它可以帮助将注意力集中在数据集中某些特定的关注区域或模式上。
首先,您需要创建一个与数据矩阵形状相同的布尔掩码。对于您希望隐藏(或显示)的数据点,掩码应为 True(或 False)。由于相关矩阵是对称的,我们可以使用 numpy 的 triu 函数创建一个仅覆盖热力图上半部分的三角掩码。
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))技术支持
使用 seaborn.heatmap() 函数的 mask 参数来应用掩码。掩码中对应为 True 的数据点将被隐藏。
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5, mask = mask)
plt.show()
技术支持
最佳实践与常见错误
遵循以下最佳实践,您就能使用 Seaborn 热力图为报告和演示创建引人注目的可视化。
使用 Seaborn 热力图时可考虑以下五项最佳实践:
1. 选择合适的配色方案
您选择的配色方案会直接影响数据的呈现方式。不同的配色可突出或掩盖数据中的模式。
对于从低到高递进的数据使用顺序型配色,对于具有有意义中点的数据使用发散型配色。Seaborn 提供了多种 cmap 选项,方便您根据数据集定制配色方案。阅读我们的教程 Seaborn 配色快速指南:如何选色,了解不同配色选项及其对不同图表类型的支持。
2. 周到地处理缺失数据
缺失数据可能会在热力图中形成空白,从而误导读者。绘图前,请制定处理缺失数据的策略。根据其重要性,您可以选择插补缺失值或将其完全删除。或者,使用独特的颜色或图案来表示缺失数据,在不误导读者的前提下突出其存在。
3. 正确缩放您的数据
具有大方差或离群值的数据会扭曲可视化效果,使得难以判断数据是否存在模式。请对数据进行归一化或缩放,以确保热力图能准确反映整个数据集的差异。根据数据性质,最小-最大缩放、Z 分数归一化,甚至对数变换等技术都可能有益。
4. 谨慎使用标注
虽然标注可以通过显示精确数值提供有价值的细节,但过多的标注会让热力图难以阅读,尤其是在数据集较大时。
将标注限制在关键数据点,或在较小的热力图中使用标注。
5. 调整热力图尺寸
默认的纵横比和尺寸可能不适合您的数据集,导致单元格被压缩或显示拥挤,从而掩盖模式。
自定义热力图的大小与纵横比,确保每个单元格清晰可见,整体模式易于辨识。
结语
Seaborn 的热力图函数能够创建引人注目的数据模式可视化,尤其适合可视化数值变量之间的相关性。
不过,遵循最佳实践同样重要,包括选择合适的配色方案、周到处理缺失数据、正确缩放数据、谨慎使用标注以及调整热力图尺寸。
想深入学习 Seaborn 库吗?我们的 Seaborn 数据可视化入门课程非常适合初学者;如果您已具备一定基础,可通过 Seaborn 数据可视化进阶课程加深理解。


热力图是一种常见的数据可视化技术,使用颜色来表示数据幅度的不同水平,帮助您快速识别数据集中的模式和异常。
Seaborn 库可让您轻松创建高度自定义的数据可视化,如折线图、直方图和热力图。您也可以查看我们的教程:数据图表的不同类型及其在 Python 中的创建方法。
绘图与自定义 Seaborn 可视化时,请随身参考我们的 Seaborn 速查表以便快速查询。
在本教程中,我们将探讨什么是 Seaborn 热力图、何时使用它们,以及如何创建和自定义它们以满足您的需求。
理解热力图
什么是热力图?
热力图以网格形式组织数据,用不同的颜色或色阶来表示数据幅度的不同水平。
热力图的可视化特性使您能够立即识别模式,例如聚类、趋势和异常。这使得热力图成为探索性数据分析的有效工具。
下面是一个 Seaborn 热力图示例:
何时应使用热力图?
是否选择使用热力图取决于您的需求和数据集的性质。总体而言,热力图最适用于可用颜色表示取值的 数据集,通常是连续或离散的数值型数据。不过,对于已量化或汇总的分类型数据(例如计数、均值),也可以使用热力图。
如果数据集中存在极端离群值或非常稀疏,不经过预处理或归一化,热力图的效果可能不佳。文本、图像等非结构化数据也不适合直接用于热力图,除非先将其转换为结构化的数值格式。
热力图在可视化多个变量之间的相关矩阵方面表现出色,可让您一眼识别高度正相关或负相关的变量。
热力图还适用于在两个维度上进行数据的可视化比较,例如不同时间段或类别。对于地理数据分析,热力图可以表示空间布局中事件的密度或强度,例如城市人口密度或犯罪热点。
开始使用 Seaborn 热力图
设置您的环境
在本教程中,我们将使用 DataCamp 的 AI 加持数据笔记本 DataLab 上提供的关于贷款的数据集。本教程的代码也可在相应的 DataLab 工作簿中获取。
在 DataLab 中,各大主流库都已方便地预装并可直接导入。若想了解更多,请参阅我们关于数据科学顶级 Python 库的文章。
本教程将使用以下库:
如果您不熟悉 Python、需要快速上手本教程,请查看我们的 Python 入门课程。
或者,如果您想进一步了解本教程中将使用的库,可以查看以下课程:
准备您的数据
请确保您的数据为矩阵格式,行与列表示不同的维度(例如时间段、变量、类别)。矩阵中的每个单元格应包含您希望可视化的数值。
数据清洗
在使用热力图之前,您应执行两项主要的数据清洗任务:处理缺失值和移除离群值。
处理缺失值时,您可以使用统计量(均值、中位数)填充、插值,或在不重要时直接删除。对于离群值,根据您的分析目的,您可以将其移除或调整其取值。
在我们的贷款数据集中,没有缺失值,但我们识别出了一些离群值并决定移除。请查看 DataLab 上的笔记本,了解我们如何实现的完整代码。
数据归一化或缩放
如果您的数据集跨越较大的取值范围,请考虑进行缩放或归一化。这能使热力图的颜色更准确地表示相对差异。常见方法包括最小-最大缩放和 Z 分数归一化。
对于需要分箱的连续数据,考虑将其离散化为若干区间或类别,以获得更有意义的热力图可视化。
语法与参数
要使用
seaborn.heatmap(),通常需要传入一个数据矩阵。然后,您可根据需求调整参数来自定义热力图。data:要可视化的数据集,必须为矩阵形式。cmap:指定热力图的颜色映射。Seaborn 支持多种配色方案,包括顺序型、发散型和定性方案。annot:若设为True,将在热力图的每个单元格中标注取值。fmt:当 annot 为True时,fmt决定标注数据的字符串格式代码。例如,'d' 表示整数,'.2f' 表示保留两位小数的浮点数。linewidths:设置分隔每个单元格的线宽。值越大,单元格之间的分隔越明显。linecolor:当linewidths大于 0 时,指定分隔线的颜色。cbar:布尔值,指示是否绘制颜色条。颜色条用于将数据值映射到颜色。vmin和vmax:定义颜色映射所覆盖的数据范围。center:在使用发散型配色方案时,设置颜色映射的中心值。square:若设为True,确保热力图单元格为正方形。xticklabels和yticklabels:控制 x 轴与 y 轴上显示的标签。创建您的第一个 Seaborn 热力图
我们将创建一个热力图,显示数据中每个数值变量之间的相关系数。当前我们先保持热力图简洁,在下一节再进一步自定义。
自定义您的 Seaborn 热力图
颜色自定义
自定义热力图的颜色能够提升可读性,并让报告与演示中的可视化更吸睛。
Seaborn 与 Matplotlib 提供了丰富的内置颜色映射。可尝试不同的颜色映射(如 '
Blues'、'coolwarm'、'viridis' 等),以找到能有效突出数据结构与模式的方案。对于从低到高具备自然顺序的数据使用顺序型配色;对具有关键中点的数据使用发散型配色;对分类型数据使用定性配色。不过,您并不限于 Seaborn 提供的默认配色和选项。您可以使用 Matplotlib 创建自定义配色,并指定额外的自定义选项,如调整透明度。
设置
vmin和vmax可控制颜色映射覆盖的数据范围。这有助于增强对比度并聚焦于特定的关注区间。对于发散型配色,请使用
center参数指定中点值,确保颜色对比围绕关键值锚定。我们将调整热力图的配色,并通过指定最小值、最大值和中心值来锚定颜色。
数据标注
数据标注是指在每个单元格中添加标签,显示数值或文本。标注可让热力图更易读、易于快速解读,而无需根据图例推断取值。
要启用标注,将
annot参数设为True。这样会在热力图的每个单元格中显示数据值。fmt参数可用于设置标注文本的格式。例如,'d' 表示整数格式,'.2f' 表示保留两位小数的浮点数。尽管 Seaborn 的热力图函数无法直接通过
annot参数自定义字体大小等文本属性,但您可以通过 Matplotlib 的rcParams全局调整这些属性。annot参数也可以接受与数据形状相同的类数组结构。这是一个巧妙的方法,可在标注中显示与单元格颜色不同的信息。以下是一个可供参考的示例:数据掩蔽
数据掩蔽是一种根据特定条件有选择地高亮或隐藏某些数据点的技术。它可以帮助将注意力集中在数据集中某些特定的关注区域或模式上。
首先,您需要创建一个与数据矩阵形状相同的布尔掩码。对于您希望隐藏(或显示)的数据点,掩码应为
True(或False)。由于相关矩阵是对称的,我们可以使用numpy的triu函数创建一个仅覆盖热力图上半部分的三角掩码。使用
seaborn.heatmap()函数的mask参数来应用掩码。掩码中对应为True的数据点将被隐藏。最佳实践与常见错误
遵循以下最佳实践,您就能使用 Seaborn 热力图为报告和演示创建引人注目的可视化。
使用 Seaborn 热力图时可考虑以下五项最佳实践:
1. 选择合适的配色方案
您选择的配色方案会直接影响数据的呈现方式。不同的配色可突出或掩盖数据中的模式。
对于从低到高递进的数据使用顺序型配色,对于具有有意义中点的数据使用发散型配色。Seaborn 提供了多种
cmap选项,方便您根据数据集定制配色方案。阅读我们的教程 Seaborn 配色快速指南:如何选色,了解不同配色选项及其对不同图表类型的支持。2. 周到地处理缺失数据
缺失数据可能会在热力图中形成空白,从而误导读者。绘图前,请制定处理缺失数据的策略。根据其重要性,您可以选择插补缺失值或将其完全删除。或者,使用独特的颜色或图案来表示缺失数据,在不误导读者的前提下突出其存在。
3. 正确缩放您的数据
具有大方差或离群值的数据会扭曲可视化效果,使得难以判断数据是否存在模式。请对数据进行归一化或缩放,以确保热力图能准确反映整个数据集的差异。根据数据性质,最小-最大缩放、Z 分数归一化,甚至对数变换等技术都可能有益。
4. 谨慎使用标注
虽然标注可以通过显示精确数值提供有价值的细节,但过多的标注会让热力图难以阅读,尤其是在数据集较大时。
将标注限制在关键数据点,或在较小的热力图中使用标注。
5. 调整热力图尺寸
默认的纵横比和尺寸可能不适合您的数据集,导致单元格被压缩或显示拥挤,从而掩盖模式。
自定义热力图的大小与纵横比,确保每个单元格清晰可见,整体模式易于辨识。
结语
Seaborn 的热力图函数能够创建引人注目的数据模式可视化,尤其适合可视化数值变量之间的相关性。
不过,遵循最佳实践同样重要,包括选择合适的配色方案、周到处理缺失数据、正确缩放数据、谨慎使用标注以及调整热力图尺寸。
想深入学习 Seaborn 库吗?我们的 Seaborn 数据可视化入门课程非常适合初学者;如果您已具备一定基础,可通过 Seaborn 数据可视化进阶课程加深理解。