
Kursus
Pengantar Visualisasi Data dengan Seaborn
4 jam
185.4K
Heatmap adalah teknik visualisasi data yang populer yang menggunakan warna untuk merepresentasikan tingkat magnitudo data yang berbeda, sehingga Anda dapat dengan cepat mengidentifikasi pola dan anomali dalam dataset.
Library Seaborn memungkinkan Anda dengan mudah membuat visualisasi data yang sangat terpersonalisasi, seperti line plot, histogram, dan heatmap. Anda juga dapat melihat tutorial kami tentang berbagai jenis plot data dan cara membuatnya di Python.
Simpan lembar contekan Seaborn kami sebagai referensi cepat saat membuat plot dan menyesuaikan visualisasi data menggunakan library Seaborn.
Dalam tutorial ini, kita akan membahas apa itu heatmap Seaborn, kapan menggunakannya, serta cara membuat dan menyesuaikannya agar paling sesuai dengan kebutuhan Anda.
Heatmap mengorganisasi data dalam bentuk kisi (grid), dengan warna atau gradasi yang berbeda untuk menunjukkan tingkat magnitudo data yang berbeda.
Sifat visual dari heatmap memungkinkan pengenalan pola secara cepat, seperti kluster, tren, dan anomali. Hal ini membuat heatmap menjadi alat yang efektif untuk analisis data eksploratif.
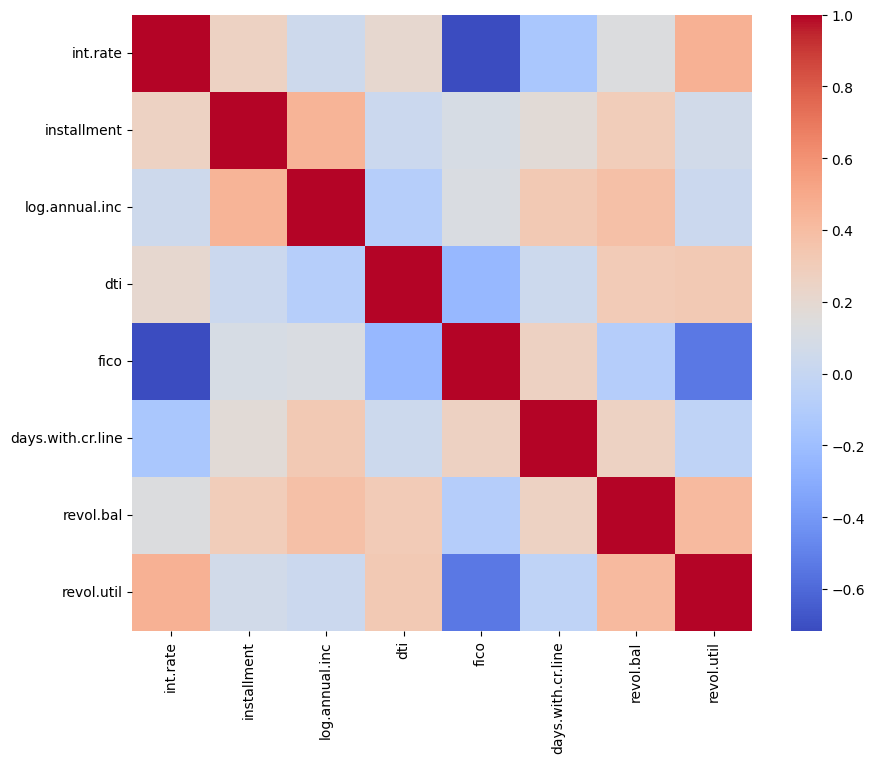
Berikut contoh heatmap Seaborn:
Keputusan untuk menggunakan heatmap bergantung pada kebutuhan dan karakteristik dataset Anda. Secara umum, heatmap paling cocok untuk dataset yang nilainya dapat direpresentasikan sebagai warna, biasanya data numerik kontinu atau diskret. Namun, Anda juga dapat menggunakannya untuk data kategorikal yang telah dikuantifikasi atau diringkas (misalnya, jumlah, rata-rata).
Jika dataset mengandung outlier ekstrem atau sangat jarang (sparse), heatmap mungkin kurang efektif tanpa prapemrosesan atau normalisasi. Teks, gambar, dan bentuk data tidak terstruktur lainnya juga tidak cocok langsung untuk heatmap kecuali Anda terlebih dahulu mentransformasikannya menjadi format numerik terstruktur.
Heatmap unggul dalam memvisualisasikan matriks korelasi antar banyak variabel, sehingga memudahkan untuk mengidentifikasi variabel yang berkorelasi tinggi atau berkorelasi negatif secara sekilas.
Heatmap juga berguna untuk membandingkan data secara visual pada dua dimensi, seperti periode waktu atau kategori yang berbeda. Untuk analisis data geografis, heatmap dapat merepresentasikan kepadatan atau intensitas kejadian pada tata letak spasial, seperti kepadatan penduduk atau titik panas kejahatan di suatu kota.
Untuk tutorial ini, kita akan menggunakan dataset yang berisi informasi tentang pinjaman yang tersedia di DataLab, notebook data bertenaga AI milik DataCamp. Kode untuk tutorial ini juga tersedia dalam workbook DataLab terkait.
Di DataLab, semua library utama sudah terpasang dan siap diimpor. Untuk mempelajari lebih lanjut, kami memiliki artikel tentang library Python terbaik untuk data science.
Kita akan menggunakan library berikut untuk tutorial ini:
# Import libraries
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
Jika Anda belum familiar dengan Python dan perlu mempelajarinya cepat untuk tutorial ini, lihat kursus Introduction to Python kami.
Sebagai alternatif, jika Anda ingin mempelajari lebih lanjut tentang library yang akan kita gunakan di tutorial ini, Anda dapat melihat kursus berikut:
Pastikan data Anda dalam format matriks, dengan baris dan kolom yang merepresentasikan dimensi berbeda (misalnya periode waktu, variabel, kategori). Setiap sel pada matriks harus berisi nilai yang ingin Anda visualisasikan.
Sebelum menggunakan heatmap, Anda perlu melakukan dua tugas pembersihan data utama: menangani nilai hilang dan menghapus outlier.
Saat menangani nilai hilang, Anda dapat mengisinya menggunakan ukuran statistik (mean, median), melakukan interpolasi, atau menghapusnya jika tidak signifikan. Untuk outlier, tergantung analisis Anda, Anda bisa menghapusnya atau memutuskan untuk menyesuaikan nilainya.
Dalam dataset pinjaman kami, tidak ada nilai hilang, tetapi kami mengidentifikasi beberapa outlier yang kami putuskan untuk dihapus. Lihat notebook di DataLab untuk kode lengkap bagaimana kami melakukannya.
Jika dataset Anda mencakup rentang nilai yang luas, pertimbangkan untuk melakukan penskalaan atau normalisasi. Ini dapat membuat warna heatmap merepresentasikan perbedaan relatif dengan lebih akurat. Metode umum termasuk min-max scaling dan normalisasi Z-score.
Untuk data kontinu yang perlu dikategorikan, pertimbangkan diskretisasi ke dalam bin atau kategori untuk visualisasi heatmap yang lebih bermakna.
Untuk menggunakan seaborn.heatmap(), Anda biasanya perlu memberikan matriks data. Kemudian, Anda dapat menyesuaikan parameter untuk mengkustomisasi heatmap sesuai kebutuhan Anda.
data: Dataset yang akan divisualisasikan, yang harus dalam bentuk matriks.
cmap: Menentukan colormap untuk heatmap. Seaborn mendukung berbagai palet warna, termasuk skema sekuensial, divergen, dan kualitatif.
annot: Jika diatur ke True, nilai di setiap sel akan diberi anotasi pada heatmap.
fmt: Saat annot bernilai True, fmt menentukan kode pemformatan string untuk memberi anotasi data. Misalnya, 'd' untuk bilangan bulat dan '.2f' untuk bilangan pecahan dengan dua desimal.
linewidths: Mengatur lebar garis yang membagi setiap sel. Nilai yang lebih besar meningkatkan jarak antar sel.
linecolor: Menentukan warna garis yang membagi setiap sel jika linewidths lebih besar dari 0.
cbar: Nilai boolean yang menunjukkan apakah akan menampilkan color bar. Color bar memberikan referensi untuk memetakan nilai data ke warna.
vmin dan vmax: Parameter ini mendefinisikan rentang data yang dicakup oleh colormap.
center: Menetapkan nilai pusat colormap saat menggunakan skema warna divergen.
square: Jika diatur ke True, memastikan sel heatmap berbentuk persegi.
xticklabels dan yticklabels: Mengontrol label yang ditampilkan pada sumbu x dan y.
Kita akan membuat heatmap yang menampilkan koefisien korelasi antara setiap variabel numerik dalam data kita. Untuk saat ini, kita akan menjaga heatmap tetap sederhana dan menyesuaikannya lebih lanjut pada bagian berikutnya.
# Calculate the correlation matrix
correlation_matrix = filtered_df.corr()

# Create the heatmap
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'coolwarm')
plt.show()
Menyesuaikan warna heatmap membuatnya lebih mudah dibaca dan menghasilkan visual yang lebih menarik untuk laporan dan presentasi.
Seaborn dan Matplotlib menawarkan beragam colormap bawaan. Bereksperimenlah dengan colormap ('Blues', 'coolwarm', 'viridis', dll.) untuk menemukan yang paling efektif menonjolkan struktur dan pola data Anda. Gunakan colormap sekuensial untuk data dengan urutan alami dari rendah ke tinggi, colormap divergen untuk data dengan titik tengah yang krusial, dan colormap kualitatif untuk data kategorikal.
Namun, Anda tidak terbatas pada colormap dan opsi default yang disediakan Seaborn. Anda dapat membuat colormap kustom menggunakan Matplotlib dan menentukan opsi kustomisasi tambahan seperti menyesuaikan transparansi.
Menetapkan vmin dan vmax memungkinkan Anda mengontrol rentang data yang dicakup oleh colormap. Ini dapat meningkatkan kontras dan memfokuskan pada rentang tertentu yang menarik.
Untuk colormap divergen, gunakan parameter center untuk menentukan nilai titik tengah. Ini memastikan kontras warna berlabuh pada nilai yang krusial.
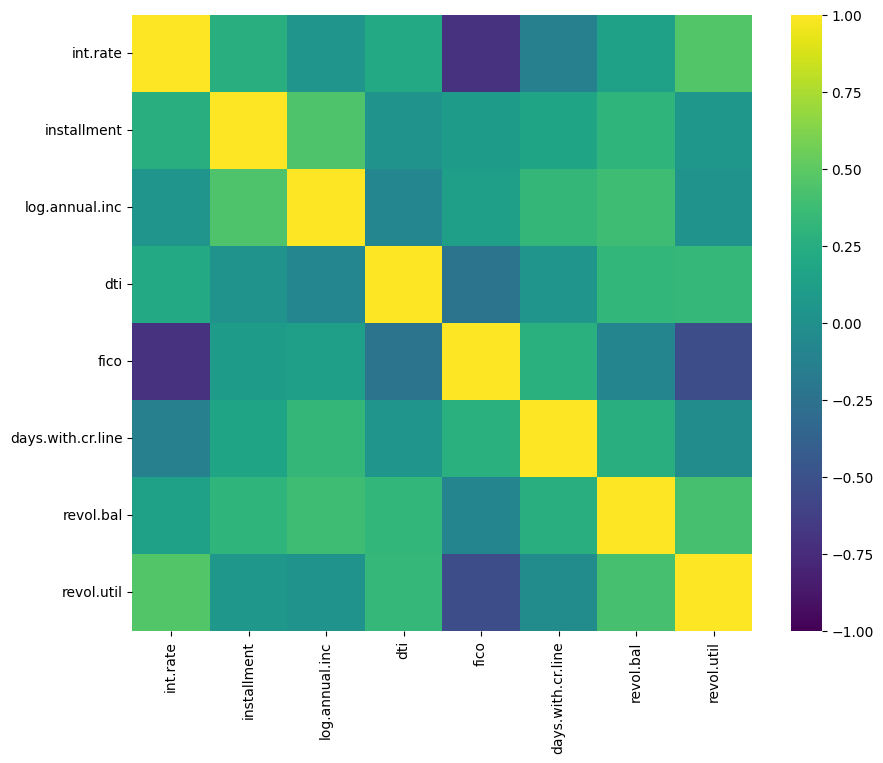
Kita akan menyesuaikan palet warna heatmap kita dan juga menambatkan warna dengan menentukan nilai minimum, maksimum, dan pusat.
# Customize heatmap colors
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0)
plt.show()
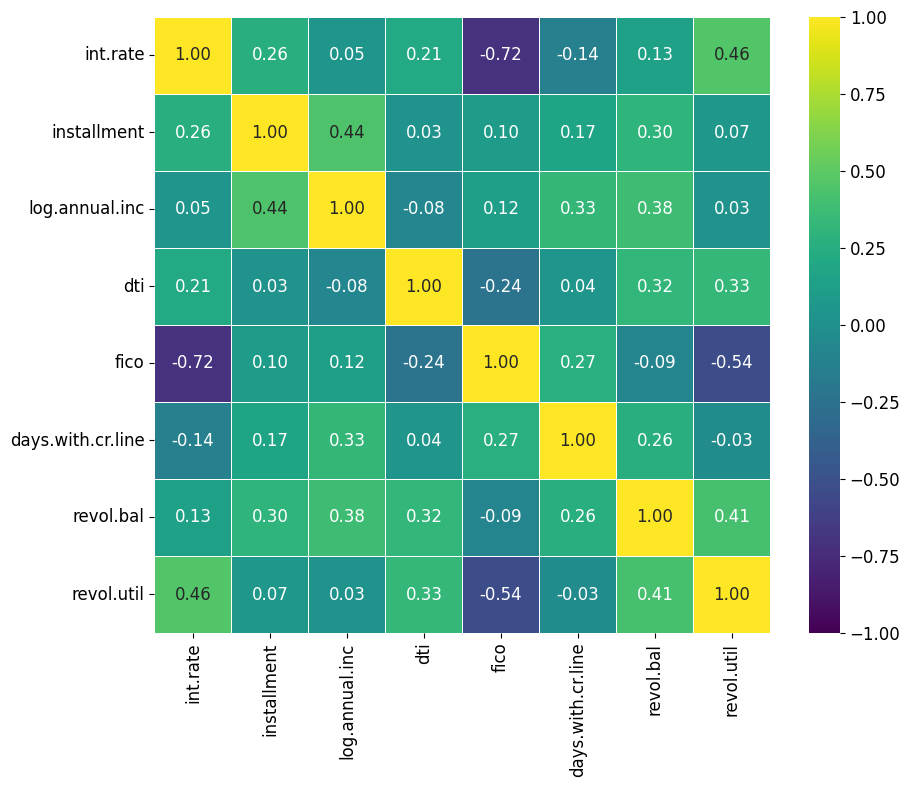
Anotasi data melibatkan penambahan label di dalam setiap sel yang dapat menampilkan nilai numerik atau teks. Anotasi memudahkan pembacaan dan interpretasi heatmap dengan cepat tanpa harus menebak nilai berdasarkan legenda.
Untuk mengaktifkan anotasi, setel parameter annot menjadi True. Ini akan menampilkan nilai data di setiap sel heatmap.
Parameter fmt memungkinkan Anda memformat teks anotasi. Misalnya, gunakan 'd' untuk pemformatan bilangan bulat dan '.2f' untuk bilangan pecahan yang ditampilkan dengan dua tempat desimal.
Meskipun fungsi heatmap Seaborn tidak secara langsung memungkinkan penyesuaian properti teks seperti ukuran font melalui parameter annot, Anda dapat menyesuaikan properti tersebut secara global menggunakan rcParams milik Matplotlib.
# Create an annotated heatmap
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5)
plt.show()
Parameter annot juga dapat menerima struktur mirip array dengan bentuk yang sama seperti data Anda. Ini trik yang berguna untuk menambahkan anotasi yang berisi informasi berbeda dari yang ditampilkan oleh warna sel. Berikut contoh cara menerapkannya:
# Example of alternative annotations
  annot_array = np.round(data*100, decimals=2)
  sns.heatmap(data, annot=annot_array, fmt='s')
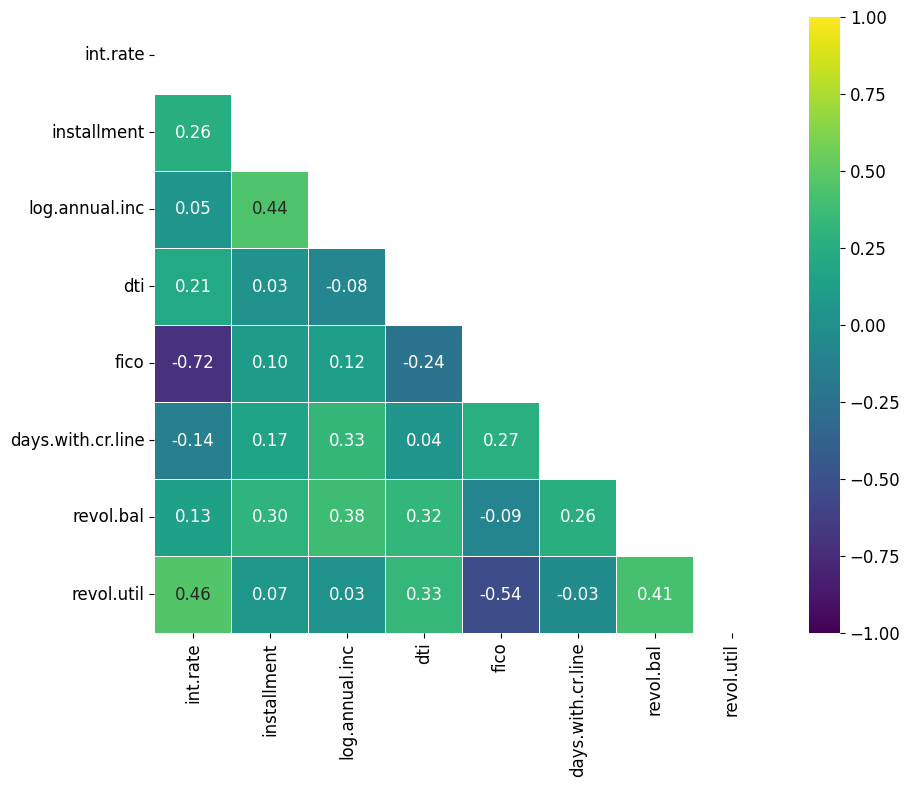
Masking data adalah teknik yang digunakan untuk menyoroti atau menyembunyikan titik data tertentu secara selektif berdasarkan kondisi spesifik. Ini dapat membantu memusatkan perhatian pada area atau pola tertentu dalam dataset.
Pertama, Anda perlu membuat mask boolean dengan bentuk yang sama seperti matriks data Anda. Mask harus bernilai True (atau False) untuk titik data yang ingin Anda sembunyikan (atau tampilkan). Karena matriks korelasi bersifat simetris, kita dapat menggunakan fungsi triu dari numpy untuk membuat mask segitiga yang hanya menutupi bagian atas heatmap kita.
# Create a mask using numpy's triu function
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))
Gunakan parameter mask pada fungsi seaborn.heatmap() untuk menerapkan mask Anda. Titik data yang sesuai dengan True pada mask akan disembunyikan.
# Create a masked heatmap
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5, mask = mask)
plt.show()
Mengikuti praktik terbaik ini akan memungkinkan Anda menggunakan heatmap Seaborn untuk membuat visualisasi yang menarik untuk laporan dan presentasi Anda.
Berikut lima praktik terbaik yang perlu dipertimbangkan saat menggunakan heatmap Seaborn:
Palet warna yang Anda pilih secara langsung memengaruhi bagaimana data Anda dipersepsikan. Skema warna yang berbeda dapat menonjolkan atau justru menyamarkan pola dalam data Anda.
Gunakan palet warna sekuensial untuk data yang berkembang dari rendah ke tinggi dan palet warna divergen untuk data dengan titik tengah yang bermakna. Seaborn menyediakan berbagai opsi melalui parameter cmap, sehingga Anda dapat menyesuaikan skema warna dengan dataset Anda. Baca tutorial kami, Seaborn Color Palette: Quick Guide to Picking Colors untuk mempelajari semua opsi palet warna dan bagaimana masing-masing mendukung jenis grafik yang berbeda.
Data hilang dapat menimbulkan celah pada heatmap Anda, yang berpotensi menyesatkan pembaca. Sebelum memplot, tentukan strategi penanganan data hilang. Bergantung pada signifikansinya, Anda dapat memilih untuk mengimputasi nilai yang hilang atau menghapusnya sepenuhnya. Alternatifnya, merepresentasikan data hilang dengan warna atau pola yang berbeda dapat menyoroti keberadaannya tanpa menyesatkan pembaca.
Data dengan varians besar atau outlier dapat menggeser visualisasi, sehingga sulit menentukan apakah data mengandung pola apa pun. Normalisasi atau skala data Anda untuk memastikan heatmap secara akurat mencerminkan perbedaan di seluruh dataset. Bergantung pada sifat data Anda, teknik seperti min-max scaling, normalisasi Z-score, atau bahkan transformasi log dapat bermanfaat.
Meskipun anotasi dapat menambahkan detail berharga dengan menampilkan nilai yang tepat, menumpuk heatmap dengan terlalu banyak anotasi dapat membuatnya sulit dibaca, terutama untuk dataset besar.
Batasi anotasi pada titik data kunci atau gunakan pada heatmap yang lebih kecil.
Rasio aspek dan ukuran default mungkin tidak sesuai untuk dataset Anda, sehingga sel menjadi gepeng atau tampilan menjadi sempit dan menyamarkan pola.
Sesuaikan ukuran dan rasio aspek heatmap agar setiap sel terlihat jelas dan pola keseluruhan mudah dikenali.
Fungsi heatmap Seaborn memungkinkan visualisasi pola data yang menarik dan sangat berguna untuk memvisualisasikan korelasi antar variabel numerik.
Namun, penting untuk mengikuti praktik terbaik. Ini termasuk memilih palet warna yang tepat, menangani data hilang dengan cermat, menskalakan data dengan benar, menggunakan anotasi secara hemat, dan menyesuaikan dimensi heatmap.
Tertarik mendalami library Seaborn? Kursus Introduction to Data Visualization with Seaborn kami cocok untuk pemula, atau jika Anda pengguna yang lebih mahir, Anda dapat memperdalam pemahaman melalui kursus Intermediate Data Visualization with Seaborn.
Mulai Perjalanan Seaborn Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



