
Khóa học
Giới thiệu trực quan dữ liệu với Seaborn
4 giờ
185.4K
Heatmap là một kỹ thuật trực quan hóa dữ liệu phổ biến sử dụng màu sắc để biểu diễn các mức độ khác nhau của độ lớn dữ liệu, giúp bạn nhanh chóng nhận diện các mẫu và điểm bất thường trong tập dữ liệu.
Thư viện Seaborn cho phép bạn dễ dàng tạo các biểu đồ tùy biến cao cho dữ liệu của mình, như biểu đồ đường, biểu đồ tần suất và heatmap. Bạn cũng có thể xem hướng dẫn về các loại biểu đồ dữ liệu và cách tạo chúng trong Python.
Hãy giữ cheat sheet Seaborn bên cạnh để tra cứu nhanh khi vẽ và tùy chỉnh trực quan hóa dữ liệu bằng thư viện Seaborn.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu heatmap trong Seaborn là gì, khi nào nên dùng và cách tạo, tùy chỉnh chúng để phù hợp nhất với nhu cầu của bạn.
Heatmap sắp xếp dữ liệu trong một lưới, với các màu sắc hoặc sắc độ khác nhau biểu thị các mức độ khác nhau của độ lớn dữ liệu.
Tính trực quan của heatmap cho phép nhận diện ngay các mẫu như cụm, xu hướng và điểm bất thường. Điều này khiến heatmap trở thành công cụ hiệu quả cho phân tích dữ liệu khám phá.
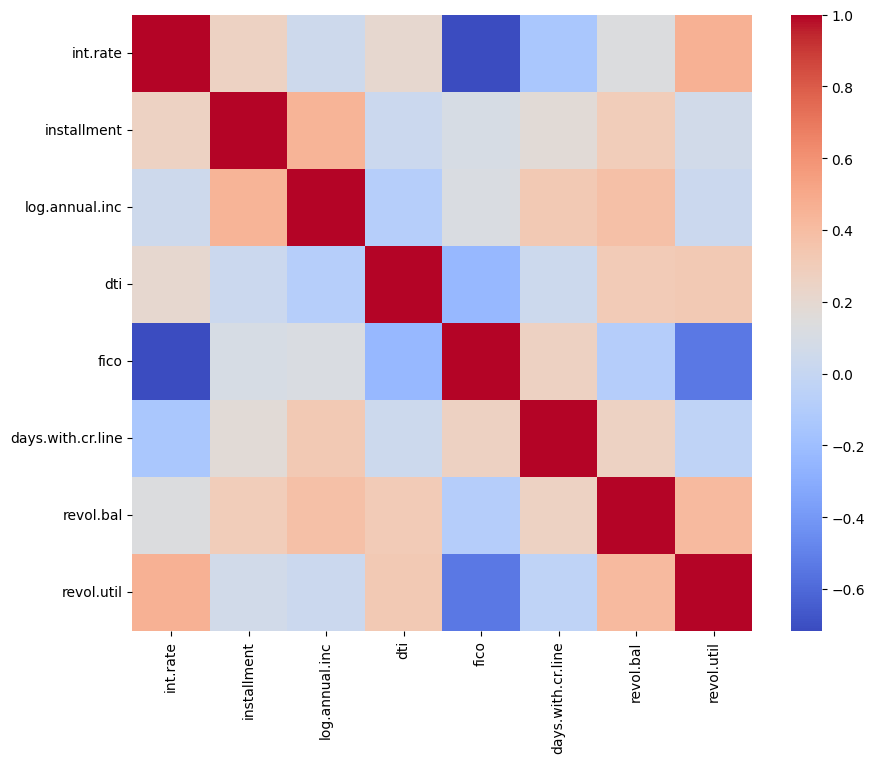
Dưới đây là một ví dụ về heatmap Seaborn:
Việc chọn dùng heatmap phụ thuộc vào yêu cầu và bản chất của tập dữ liệu. Nhìn chung, heatmap phù hợp nhất với các tập dữ liệu mà bạn có thể biểu diễn giá trị bằng màu sắc, thường là dữ liệu số liên tục hoặc rời rạc. Tuy nhiên, bạn cũng có thể dùng cho dữ liệu phân loại đã được định lượng hoặc tóm tắt (ví dụ: số đếm, giá trị trung bình).
Nếu tập dữ liệu có nhiều ngoại lệ cực đoan hoặc rất thưa thớt, heatmap có thể kém hiệu quả nếu không tiền xử lý hoặc chuẩn hóa. Văn bản, hình ảnh và các dạng dữ liệu phi cấu trúc khác cũng không phù hợp trực tiếp với heatmap trừ khi bạn biến đổi trước thành dạng cấu trúc, số hóa.
Heatmap đặc biệt xuất sắc khi trực quan hóa ma trận tương quan giữa nhiều biến, giúp dễ dàng nhận ra các biến tương quan mạnh hoặc tương quan nghịch chỉ trong nháy mắt.
Heatmap cũng hữu ích để so sánh dữ liệu trực quan theo hai chiều, như giữa các giai đoạn thời gian hoặc danh mục. Với phân tích dữ liệu địa lý, heatmap có thể biểu diễn mật độ hay cường độ sự kiện trên bố cục không gian, như mật độ dân số hoặc điểm nóng tội phạm trong thành phố.
Trong hướng dẫn này, chúng ta sẽ dùng một tập dữ liệu chứa thông tin về khoản vay có sẵn trên DataLab, sổ tay dữ liệu hỗ trợ AI của DataCamp. Mã nguồn cho hướng dẫn này cũng có trong workbook DataLab tương ứng.
Trong DataLab, tất cả các thư viện chính đã được cài đặt sẵn và sẵn sàng để import. Để tìm hiểu thêm, chúng tôi có bài viết về các thư viện Python hàng đầu cho khoa học dữ liệu.
Chúng ta sẽ dùng các thư viện sau cho hướng dẫn này:
# Import libraries
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
Nếu bạn chưa quen với Python và cần nắm bắt nhanh để theo kịp hướng dẫn, hãy xem khóa học Giới thiệu về Python của chúng tôi.
Ngoài ra, nếu bạn muốn tìm hiểu thêm về các thư viện sẽ dùng trong hướng dẫn này, bạn có thể tham khảo các khóa học sau:
Đảm bảo dữ liệu của bạn ở dạng ma trận, với các hàng và cột biểu diễn những chiều khác nhau (ví dụ: giai đoạn thời gian, biến số, danh mục). Mỗi ô trong ma trận nên chứa giá trị bạn muốn trực quan hóa.
Trước khi dùng heatmap, bạn nên thực hiện hai tác vụ làm sạch dữ liệu chính: xử lý giá trị khuyết và loại bỏ ngoại lệ.
Khi xử lý giá trị khuyết, bạn có thể điền bằng một thống kê (trung bình, trung vị), nội suy, hoặc loại bỏ nếu chúng không quan trọng. Với ngoại lệ, tùy theo phân tích, bạn có thể loại bỏ hoặc điều chỉnh giá trị của chúng.
Trong tập dữ liệu khoản vay của chúng tôi, không có giá trị khuyết nhưng chúng tôi xác định được một số ngoại lệ và đã quyết định loại bỏ. Xem notebook trên DataLab để xem đầy đủ mã cách chúng tôi thực hiện.
Nếu tập dữ liệu trải rộng trên một khoảng giá trị lớn, hãy cân nhắc scale hoặc chuẩn hóa. Điều này giúp màu sắc của heatmap biểu diễn chính xác hơn các khác biệt tương đối. Các phương pháp phổ biến gồm scale min-max và chuẩn hóa Z-score.
Với dữ liệu liên tục cần phân loại, hãy cân nhắc rời rạc hóa thành các bin hoặc danh mục để trực quan hóa heatmap có ý nghĩa hơn.
Để dùng seaborn.heatmap(), bạn thường cần truyền vào một ma trận dữ liệu. Sau đó, bạn có thể điều chỉnh các tham số để tùy biến heatmap theo yêu cầu.
data: Tập dữ liệu để trực quan hóa, phải ở dạng ma trận.
cmap: Chỉ định bản đồ màu cho heatmap. Seaborn hỗ trợ nhiều bảng màu, bao gồm chuỗi tuần tự, phân kỳ và định tính.
annot: Nếu đặt True, giá trị trong mỗi ô sẽ được hiển thị trên heatmap.
fmt: Khi annot là True, fmt quyết định mã định dạng chuỗi cho chú thích dữ liệu. Ví dụ, 'd' cho số nguyên và '.2f' cho số thực với hai chữ số thập phân.
linewidths: Thiết lập độ rộng đường kẻ phân chia các ô. Giá trị lớn hơn làm tăng khoảng cách giữa các ô.
linecolor: Chỉ định màu của đường kẻ phân chia các ô nếu linewidths lớn hơn 0.
cbar: Giá trị boolean cho biết có vẽ thanh màu hay không. Thanh màu cung cấp tham chiếu ánh xạ giá trị dữ liệu sang màu sắc.
vmin và vmax: Xác định khoảng dữ liệu mà bản đồ màu bao phủ.
center: Đặt giá trị làm tâm cho bản đồ màu khi dùng bảng màu phân kỳ.
square: Nếu đặt True, đảm bảo các ô của heatmap có dạng hình vuông.
xticklabels và yticklabels: Điều khiển nhãn hiển thị trên trục x và y.
Chúng ta sẽ tạo một heatmap hiển thị hệ số tương quan giữa mỗi biến số trong dữ liệu. Trước mắt, chúng ta sẽ giữ heatmap ở mức đơn giản và sẽ tùy chỉnh thêm trong phần tiếp theo.
# Calculate the correlation matrix
correlation_matrix = filtered_df.corr()

# Create the heatmap
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'coolwarm')
plt.show()
Tùy chỉnh màu cho heatmap giúp dễ đọc hơn và tạo nên các hình ảnh trực quan bắt mắt trong báo cáo và bài thuyết trình.
Seaborn và Matplotlib cung cấp nhiều bản đồ màu dựng sẵn. Hãy thử nghiệm với các bản đồ màu ('Blues', 'coolwarm', 'viridis', v.v.) để tìm lựa chọn làm nổi bật cấu trúc và mẫu trong dữ liệu của bạn một cách hiệu quả. Dùng bản đồ màu tuần tự cho dữ liệu có thứ tự tự nhiên từ thấp đến cao, bản đồ màu phân kỳ cho dữ liệu có điểm giữa quan trọng, và bản đồ màu định tính cho dữ liệu phân loại.
Tuy nhiên, bạn không bị giới hạn ở các bản đồ màu mặc định đi kèm Seaborn. Bạn có thể tạo bản đồ màu tùy chỉnh bằng Matplotlib và chỉ định thêm các tùy chọn như điều chỉnh độ trong suốt.
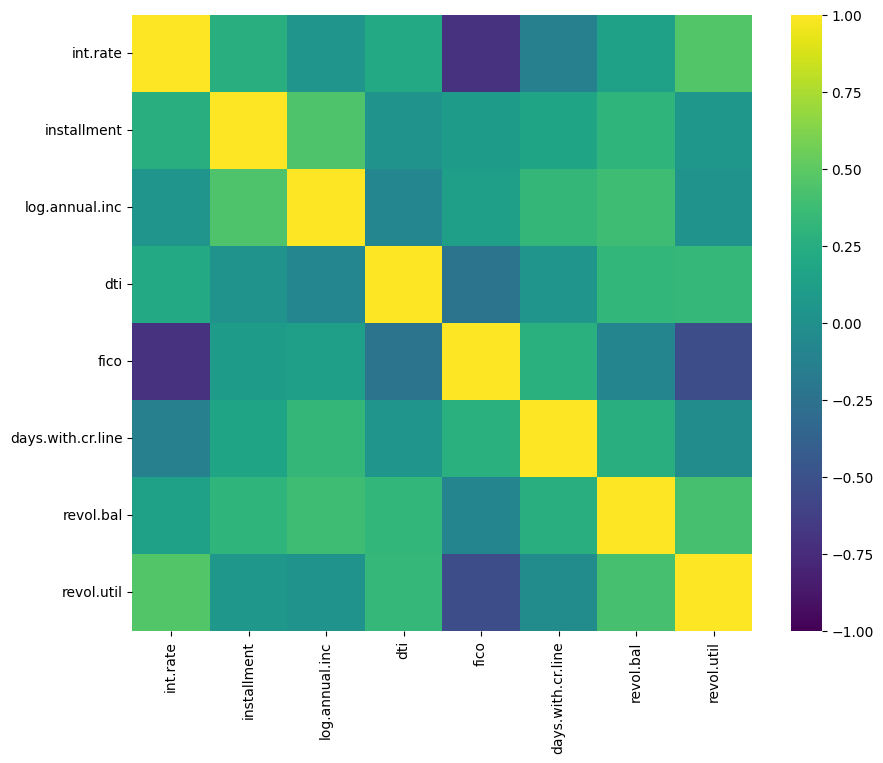
Thiết lập vmin và vmax cho phép bạn kiểm soát khoảng dữ liệu mà bản đồ màu bao phủ. Điều này có thể tăng độ tương phản và tập trung vào các khoảng quan tâm cụ thể.
Với bản đồ màu phân kỳ, hãy dùng tham số center để chỉ định giá trị điểm giữa. Điều này đảm bảo độ tương phản màu được neo quanh giá trị quan trọng.
Chúng ta sẽ điều chỉnh bảng màu của heatmap và đồng thời neo màu bằng cách chỉ định các giá trị nhỏ nhất, lớn nhất và điểm giữa.
# Customize heatmap colors
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0)
plt.show()
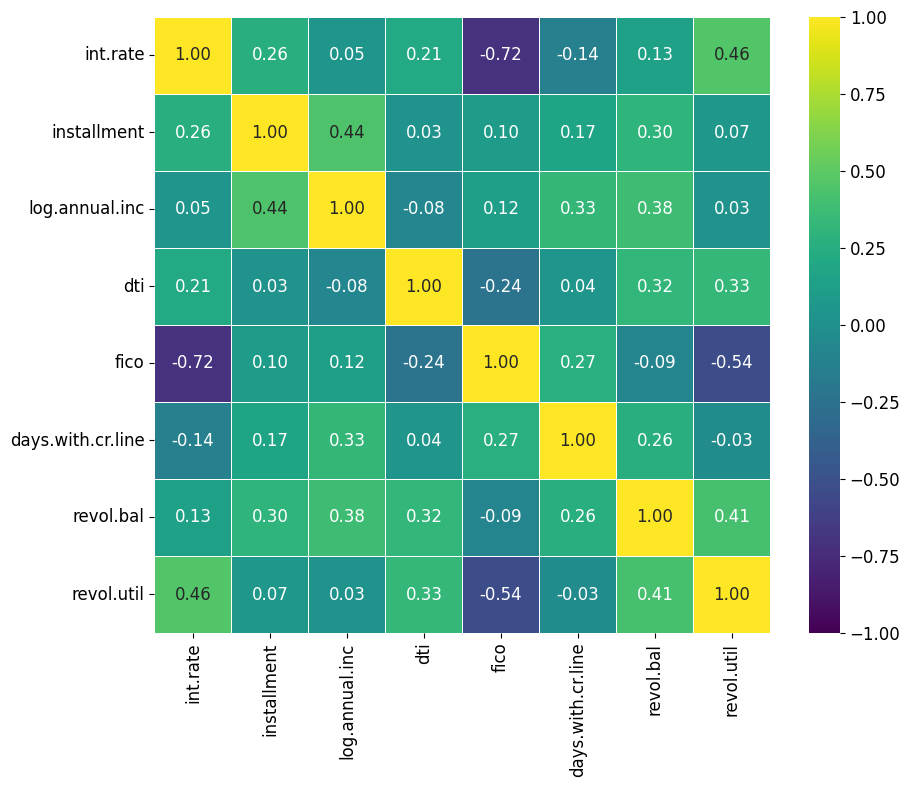
Chú thích dữ liệu là việc thêm nhãn trong mỗi ô có thể hiển thị giá trị số hoặc một đoạn văn bản. Chú thích giúp đọc và diễn giải heatmap nhanh hơn mà không cần suy ra giá trị dựa trên chú giải màu.
Để bật chú thích, đặt tham số annot thành True. Điều này sẽ hiển thị giá trị dữ liệu trong mỗi ô của heatmap.
Tham số fmt cho phép bạn định dạng văn bản chú thích. Ví dụ, dùng 'd' cho định dạng số nguyên và '.2f' cho số thực hiển thị với hai chữ số thập phân.
Mặc dù hàm heatmap của Seaborn không cho phép tùy chỉnh trực tiếp thuộc tính văn bản như cỡ chữ thông qua tham số annot, bạn có thể điều chỉnh các thuộc tính này ở phạm vi toàn cục bằng rcParams của Matplotlib.
# Create an annotated heatmap
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5)
plt.show()
Tham số annot cũng có thể nhận một cấu trúc giống mảng có cùng kích thước với dữ liệu của bạn. Đây là một mẹo hay cho phép bạn thêm chú thích chứa thông tin khác với thông tin thể hiện bằng màu của ô. Dưới đây là ví dụ cách bạn có thể áp dụng:
# Example of alternative annotations
  annot_array = np.round(data*100, decimals=2)
  sns.heatmap(data, annot=annot_array, fmt='s')
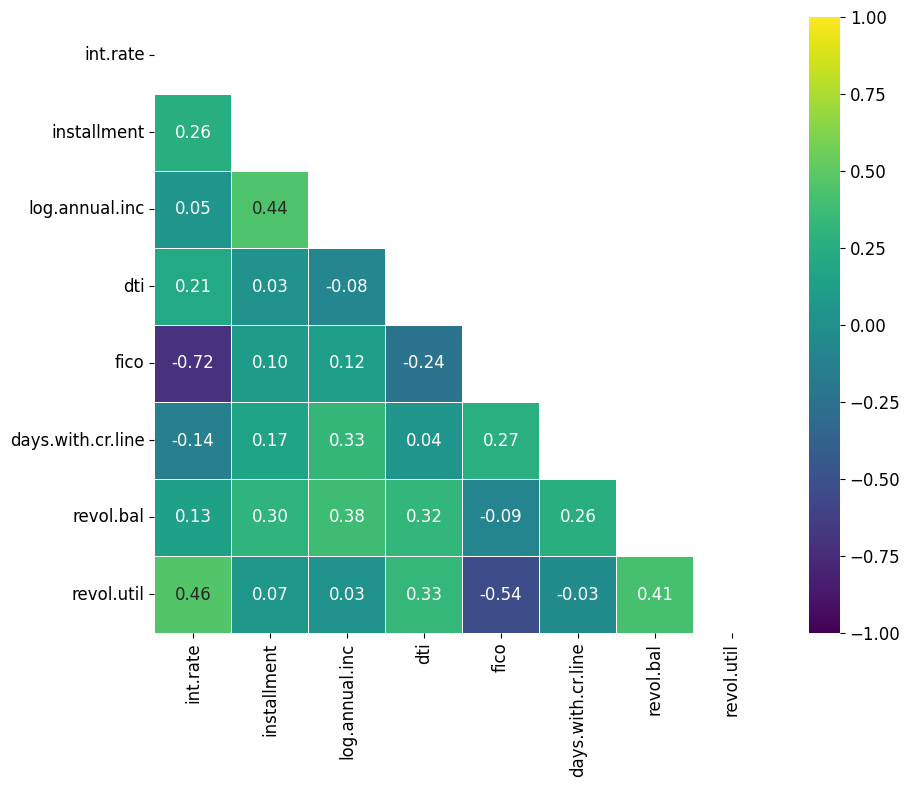
Mask dữ liệu là một kỹ thuật được dùng để làm nổi bật hoặc ẩn có chọn lọc một số điểm dữ liệu dựa trên các điều kiện cụ thể. Điều này giúp tập trung sự chú ý vào các khu vực quan trọng hoặc các mẫu trong tập dữ liệu.
Trước hết, bạn cần tạo một mask kiểu boolean có cùng kích thước với ma trận dữ liệu. Mask nên là True (hoặc False) cho các điểm dữ liệu bạn muốn ẩn (hoặc hiển thị). Vì ma trận tương quan là đối xứng, chúng ta có thể dùng hàm triu của numpy để tạo một mask tam giác chỉ bao phủ phần trên của heatmap.
# Create a mask using numpy's triu function
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))
Dùng tham số mask của hàm seaborn.heatmap() để áp dụng mask. Các điểm dữ liệu tương ứng với True trong mask sẽ bị ẩn.
# Create a masked heatmap
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5, mask = mask)
plt.show()
Tuân theo các thực hành tốt này sẽ giúp bạn dùng heatmap Seaborn để tạo nên các trực quan hóa bắt mắt cho báo cáo và bài thuyết trình.
Dưới đây là năm thực hành tốt cần cân nhắc khi dùng heatmap Seaborn:
Bảng màu bạn chọn ảnh hưởng trực tiếp đến cách dữ liệu được cảm nhận. Các hệ màu khác nhau có thể làm nổi bật hoặc che mờ các mẫu trong dữ liệu.
Dùng bảng màu tuần tự cho dữ liệu tiến triển từ thấp đến cao và bảng màu phân kỳ cho dữ liệu có điểm giữa có ý nghĩa. Seaborn cung cấp nhiều tùy chọn với tham số cmap, cho phép bạn điều chỉnh hệ màu theo tập dữ liệu. Đọc bài hướng dẫn Bảng màu Seaborn: Hướng dẫn nhanh để chọn màu để tìm hiểu mọi tùy chọn bảng màu và cách chúng hỗ trợ các loại biểu đồ khác nhau.
Dữ liệu khuyết có thể tạo ra khoảng trống trong heatmap, gây hiểu nhầm cho người xem. Trước khi vẽ, hãy quyết định chiến lược xử lý dữ liệu khuyết. Tùy mức độ quan trọng, bạn có thể nội suy hoặc loại bỏ hoàn toàn. Ngoài ra, biểu diễn dữ liệu khuyết bằng màu hoặc họa tiết riêng cũng có thể làm nổi bật sự hiện diện của chúng mà không gây hiểu nhầm.
Dữ liệu có phương sai lớn hoặc nhiều ngoại lệ có thể làm méo mó trực quan hóa, khiến khó xác định dữ liệu có mẫu hay không. Hãy chuẩn hóa hoặc scale dữ liệu để đảm bảo heatmap phản ánh chính xác khác biệt trên toàn tập dữ liệu. Tùy bản chất dữ liệu, các kỹ thuật như scale min-max, chuẩn hóa Z-score, hoặc thậm chí biến đổi log có thể hữu ích.
Dù chú thích có thể bổ sung chi tiết giá trị chính xác, việc chèn quá nhiều chú thích có thể khiến heatmap khó đọc, đặc biệt với các tập dữ liệu lớn.
Hãy giới hạn chú thích ở các điểm dữ liệu chính hoặc dùng chúng trong các heatmap nhỏ hơn.
Tỷ lệ khung và kích thước mặc định có thể không phù hợp với tập dữ liệu của bạn, dẫn đến ô bị nén hoặc hiển thị chật chội làm che mờ các mẫu.
Tùy chỉnh kích thước và tỷ lệ của heatmap để đảm bảo mỗi ô hiển thị rõ ràng và tổng thể mẫu dễ nhận diện.
Hàm heatmap của Seaborn cho phép tạo các trực quan hóa bắt mắt về mẫu dữ liệu và đặc biệt hữu ích để trực quan hóa tương quan giữa các biến số.
Tuy nhiên, điều quan trọng là tuân theo thực hành tốt. Bao gồm chọn bảng màu phù hợp, xử lý dữ liệu khuyết thận trọng, scale dữ liệu đúng cách, dùng chú thích tiết chế và điều chỉnh kích thước heatmap.
Bạn muốn đào sâu hơn vào thư viện Seaborn? Khóa học Giới thiệu trực quan hóa dữ liệu với Seaborn của chúng tôi rất phù hợp cho người mới bắt đầu; còn nếu bạn đã ở mức nâng cao hơn, bạn có thể nâng cao hiểu biết với khóa Trực quan hóa dữ liệu với Seaborn nâng cao.
Bắt đầu hành trình với Seaborn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
