

Python 中常见的数据图类型
让我们从最常见的数据图开始。这些图在许多领域广泛使用,并且大多数 Python 可视化库都能构建(极少数高度专用的库除外)。
柱状图
柱状图是最常见的可视化,用于展示分类数据的数值,以比较不同类别。类别由等宽的矩形条表示,纵向柱状图的高度(或横向柱状图的长度)与对应数值成比例。
在 matplotlib 中创建基础柱状图,可使用 matplotlib.pyplot.bar() 函数,如下:
# Data preparation
penguins_grouped = penguins[['species', 'bill_length_mm']].groupby('species').mean().reset_index()
# Creating a bar chart
plt.bar(penguins_grouped['species'], penguins_grouped['bill_length_mm'])
plt.title('Average penguin bill length by species')
plt.show()
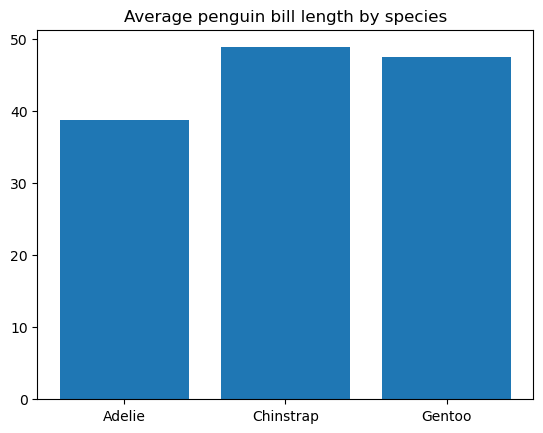
我们可以进一步自定义柱宽与颜色、边框宽度与颜色、为柱子添加刻度标签、用纹理填充柱子等。
折线图
折线图通过直线段连接的数据点,展示变量沿 x 轴从左到右的变化,最常用于展示随时间的变化。折线图常用于可视化时间序列,可参考教程Matplotlib 时间序列折线图。
在 matplotlib 中创建基础折线图,可使用 matplotlib.pyplot.plot() 函数,如下:
# Data preparation
flights_grouped = flights[['year', 'passengers']].astype({'year': 'string'}).groupby('year').sum().reset_index()
# Creating a line plot
plt.plot(flights_grouped['year'], flights_grouped['passengers'])
plt.title('Total number of passengers by year')
plt.show()
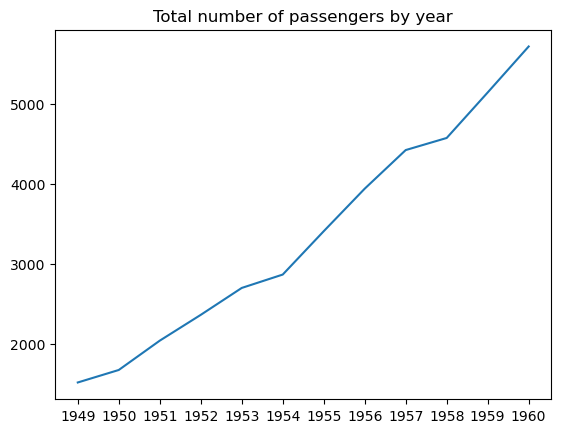
可以调整线条的宽度、样式、颜色和透明度,添加并自定义标记等。
教程Line Plots in MatplotLib with Python提供了更多在 matplotlib 中创建与自定义折线图的解释和示例。若想了解 seaborn 中的折线图,请阅读Python Seaborn 折线图教程:创建数据可视化。
散点图
散点图用于展示两个变量之间的关系,将数据点绘制在坐标平面上。通常用于检查两个变量是否相关、相关强度,以及数据中是否存在明显的簇。
下面的代码演示如何使用 matplotlib.pyplot.scatter() 创建基础散点图:
# Creating a scatter plot
plt.scatter(penguins['bill_length_mm'], penguins['bill_depth_mm'])
plt.title('Penguin bill length vs. bill depth')
plt.show()
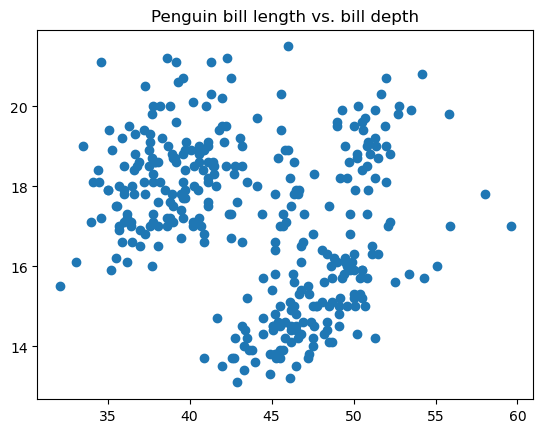
我们可以调整点的大小、样式、颜色、透明度、边框宽度、边框颜色等。
关于散点图(以及更多内容),可阅读本教程:数据解密:捕捉变量关系的可视化。
直方图
直方图用于表示数值变量的频数分布。其原理是将数据按取值范围分组(称为“箱”或“区间”),统计每个箱的点数,并将每个箱显示为竖条,条高与该箱的计数成正比。直方图可视为柱状图的一种,但由于箱是连续的,相邻条之间没有空隙。
我们可以用 matplotlib.pyplot.hist() 轻松绘制基础直方图:
# Creating a histogram
plt.hist(penguins['bill_length_mm'])
plt.title('Penguin bill length distribution')
plt.show()
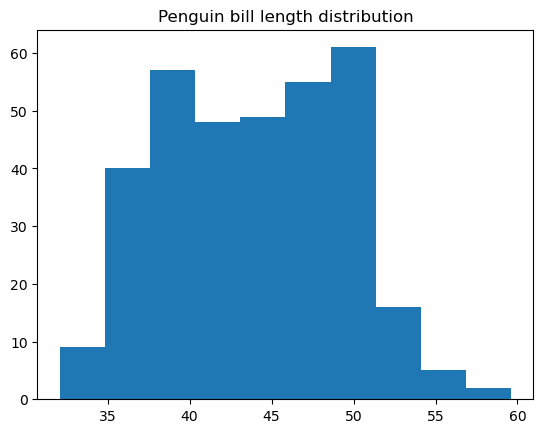
该函数可自定义的内容很多,包括颜色与样式、箱数、箱边界、箱的上下范围、是否为累积直方图等。
更多直方图示例请参阅 Histograms in Matplotlib 和 How to Create a Histogram with Plotly。
箱线图
箱线图展示数据的五个描述性统计量:最小值与最大值(不含离群值)、中位数、第一和第三四分位数。它也可以选择性地显示均值。当您只关心这些统计信息、而不深入探究真实分布形态时,箱线图是合适的选择。
在适用于各场景的 11 种数据可视化技术教程中,您可以找到关于箱线图可获取的统计信息的更细致解释。
在 matplotlib 中使用 matplotlib.pyplot.boxplot() 可创建基础箱线图,如下:
# Data preparation
penguins_cleaned = penguins.dropna()
# Creating a box plot
plt.boxplot(penguins_cleaned['bill_length_mm'])
plt.title('Penguin bill length distribution')
plt.show()
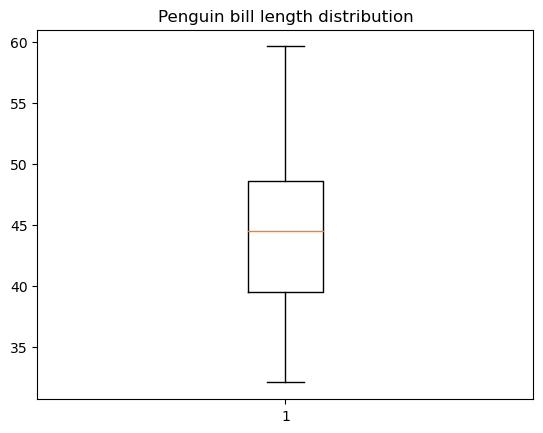
箱线图的可定制空间很大:箱体宽度与方向、箱与须的位置、各元素的可见性与样式等。
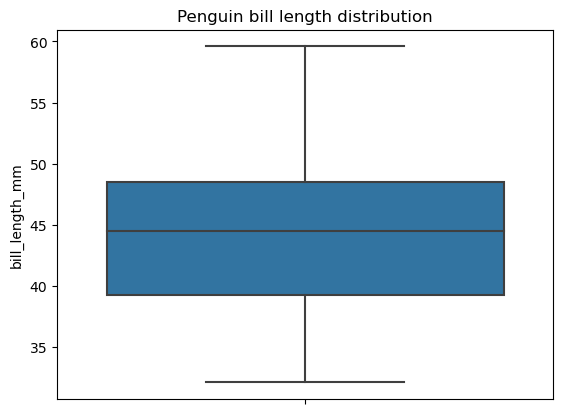
注意,使用该函数绘制箱线图前需确保数据不含缺失值。上例中我们已在绘图前删除了缺失值。相比之下,Seaborn 在幕后处理缺失值,无此限制,如下:
# Creating a box plot
sns.boxplot(data=penguins, y='bill_length_mm')
plt.title('Penguin bill length distribution')
plt.show()
饼图
饼图将整体表示为一个圆,并按类别划分为扇区,每个扇区的角度反映该类别占整体的比例。与柱状图不同,饼图旨在描绘构成整体的各类别,例如一艘船上的乘客构成。
饼图的缺点包括:
- 人眼对角度的感知不如对长度敏感,易被误导。
- 当类别达到五个或更多时,效率较低。
- 无法展示多组分类数据,即无法像柱状图那样分组。
- 不易体现具体数值。
- 当类别之间差异很小时,信息性较差。
因此,饼图应谨慎、少量使用。
在 matplotlib 中创建基础饼图,需要使用 matplotlib.pyplot.pie() 函数,如下:
# Data preparation
titanic_grouped = titanic.groupby('class')['pclass'].count().reset_index()
# Creating a pie chart
plt.pie(titanic_grouped['pclass'], labels=titanic_grouped['class'])
plt.title('Number of passengers by class')
plt.show()
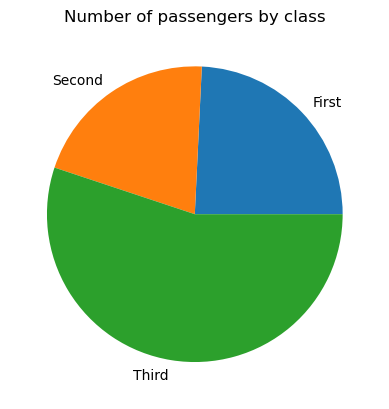
如有需要,我们可以调整饼图:更改扇区颜色、为某些(通常是很小的)扇区添加偏移、改变半径、自定义标签格式、用纹理填充扇区等。
要深入了解饼图(包括添加百分比和爆炸效果),请阅读 Python 饼图:用 Pandas 和 Matplotlib 构建与样式设置。
Python 中的高级数据图类型
本节我们将探索多种高级图表。其中有些是上一节常见图表的花式变体,另一些则是独立类型。
分组柱状图
普通柱状图用于展示单个分类变量按类别的数值,而分组柱状图在两个分类变量上实现相同目的。图形上,它包含若干组柱子,每组对应第一个变量的一个类别,组内每根柱子对应第二个变量的一个类别。第二个变量的类别不超过三类时效果最佳,否则图表会过于拥挤、信息性下降。
与普通柱状图类似,我们可以用 matplotlib 创建分组柱状图。不过,Seaborn 提供了更便捷的 seaborn.barplot() 来创建此类图。下面通过示例绘制按物种与性别分组的企鹅喙长分组柱状图:
# Creating a grouped bar chart
sns.barplot(data=penguins, x='species', y='bill_length_mm', hue='sex')
plt.title('Penguin bill length by species and sex')
plt.show()
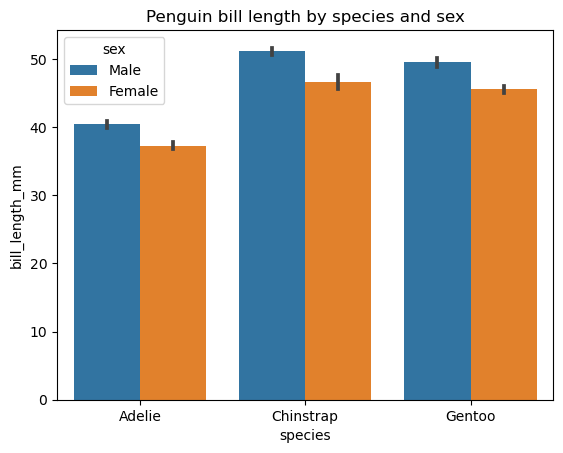
第二个分类变量通过 hue 参数引入。其他可选参数可改变柱子方向、宽度与颜色、类别顺序、统计量估计方法等。
想更深入学习 Seaborn 绘图,请参考课程:Intermediate Data Visualization with Seaborn。
堆叠面积图
堆叠面积图是在普通面积图(即为折线图下方区域着色/填充纹理)的基础上,将多个变量对应的面积叠加。它适用于同时跟踪总体趋势及各变量对该趋势的个体贡献。与折线图类似,堆叠面积图通常用于反映随时间的变化。
要注意堆叠面积图的主要限制:它更适合捕捉总体趋势,而非读取各叠加区域的精确数值。
在 matplotlib 中,可用 matplotlib.pyplot.stackplot() 构建基础堆叠面积图,如下:
# Data preparation
flights_grouped = flights.groupby(['year', 'month']).mean().reset_index()
flights_49_50 = pd.DataFrame(list(zip(flights_grouped.loc[:11, 'month'].tolist(), flights_grouped.loc[:11, 'passengers'].tolist(), flights_grouped.loc[12:23, 'passengers'].tolist())), columns=['month', '1949', '1950'])
# Creating a stacked area chart
plt.stackplot(flights_49_50['month'], flights_49_50['1949'], flights_49_50['1950'], labels=['1949', '1950'])
plt.title('Number of passengers in 1949 and 1950 by month')
plt.legend()
plt.show()
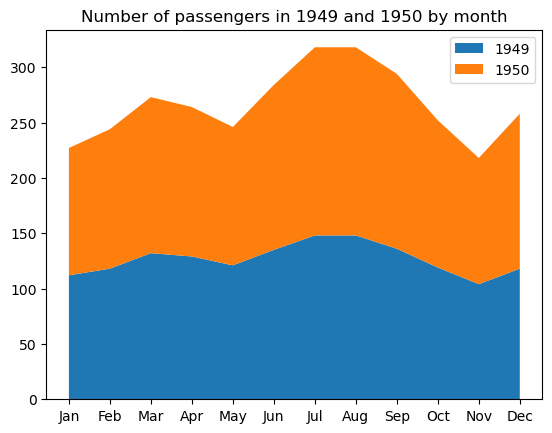
可自定义的属性包括面积颜色、透明度、填充纹理,线条宽度、样式、颜色、透明度等。
多组箱线图
在“常见图表类型”一节中,我们将箱线图定义为展示数据五大描述性统计量的可视化。有时我们希望按分类变量的各类别分别展示并比较这些统计量。此时需要在同一图中绘制多个箱线图,用 seaborn.boxplot() 即可轻松实现:
# Creating multiple box plots
sns.boxplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
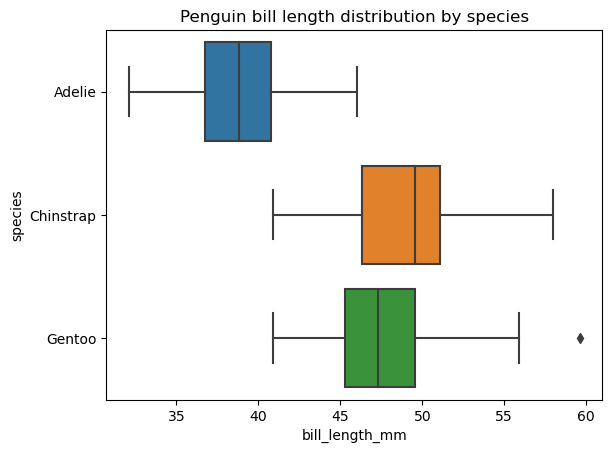
可以调整箱线图顺序、方向、颜色、透明度、宽度,定制各元素属性,添加另一个分类变量等。
小提琴图
小提琴图与箱线图相似,展示相同的总体统计信息,同时还展示数据的分布形状。与箱线图类似,我们可以为整体绘制单个小提琴图,或更常见地为分类变量的各类别分别绘制多个小提琴图。
相较 matplotlib,Seaborn 在小提琴图的创建与自定义方面更灵活。使用 seaborn.violinplot() 可构建基础小提琴图,如下:
# Creating a violin plot
sns.violinplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
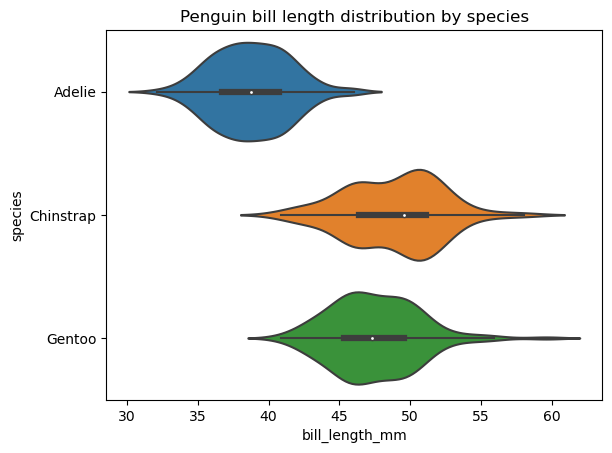
我们可以调整小提琴的顺序、方向、颜色、透明度、宽度和各元素属性,将分布延伸至极端数据点之外,添加另一个分类变量,选择小提琴内部的数据点表示方式等。
热力图
热力图是一种表格风格的可视化,每个数值型数据点根据选定的颜色尺度、并结合其在数据集中的相对大小来着色。其核心思想是突出数据中可能需要特别关注的“热点”和“冷点”。
很多情况下,绘制热力图前需要进行数据预处理,通常包括数据清洗与归一化。
下面的代码展示了如何在完成必要预处理后,使用 seaborn.heatmap() 创建基础热力图:
# Data preparation
from sklearn import preprocessing
car_crashes_cleaned = car_crashes.drop(labels='abbrev', axis=1).iloc[0:10]
min_max_scaler = preprocessing.MinMaxScaler()
car_crashes_normalized = pd.DataFrame(min_max_scaler.fit_transform(car_crashes_cleaned.values), columns=car_crashes_cleaned.columns)
# Creating a heatmap
sns.heatmap(car_crashes_normalized, annot=True)
plt.title('Car crash heatmap for the first 10 car crashes')
plt.show()
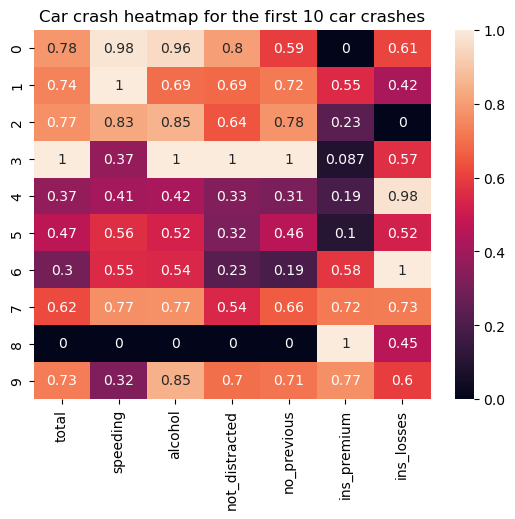
可调整之处包括选择配色方案、定义锚定值、注释格式、分隔线样式、应用掩码等。
想获取更详细的热力图指南(包括自定义配色与注释),请阅读 Seaborn Heatmaps: A Guide to Data Visualization。
Python 中非常规的数据图类型
最后,让我们看看一些很少使用或不太为人所知的可视化类型。它们中的许多在常用图表中都有至少一种对应,但在某些特定情况下,这些非常规图表可能比常见图更高效。
茎叶图
茎叶图本质上是柱状图的另一种表现形式,不过用的是细线而非实体柱,每根线顶端可带标记。虽然看起来像是多此一举,但在需要可视化大量类别时,它实际上优于柱状图。相比柱状图,茎叶图的数据墨迹比更高,可读性更强。
在 matplotlib 中创建基础茎叶图,可使用 matplotlib.pyplot.stem() 函数,如下:
# Data preparation
fmri_grouped = fmri.groupby('subject')[['subject', 'signal']].max()
# Creating a stem plot
plt.stem(fmri_grouped['subject'], fmri_grouped['signal'])
plt.title('FMRI maximum signal by subject')
plt.show()
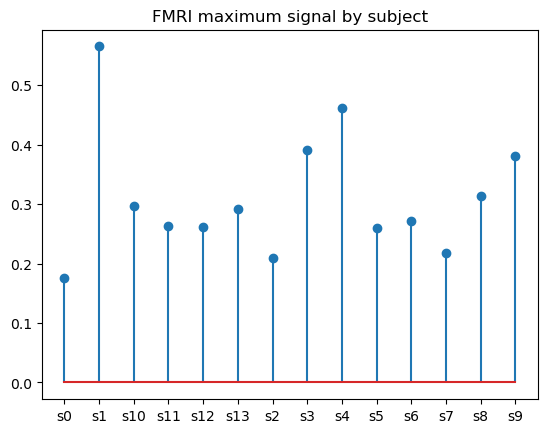
我们可以通过可选参数改变茎的方向,并自定义茎、基线和标记的属性。
条带图与蜂群图
这两种非常相似的可视化可视为“针对分类变量的散点图”:它们都能展示分布内部信息,包括样本量与单个数据点的位置,但不展示描述性统计。主要区别在于:条带图中点可重叠;而蜂群图中点不会重叠,而是沿分类轴排布。
请注意,这两种图仅在数据集相对较小时更有用。
如下使用 seaborn.stripplot() 创建条带图:
# Creating a strip plot
sns.stripplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
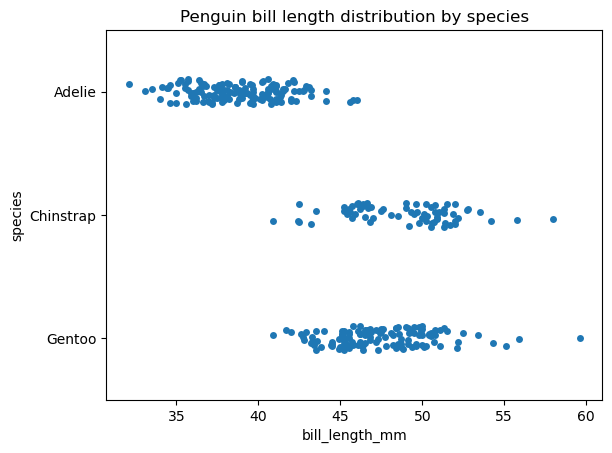
现在使用 seaborn.swarmplot() 为相同数据创建蜂群图,观察差异:
# Creating a swarm plot
sns.swarmplot(data=penguins, x='bill_length_mm', y='species')
plt.title('Penguin bill length distribution by species')
plt.show()
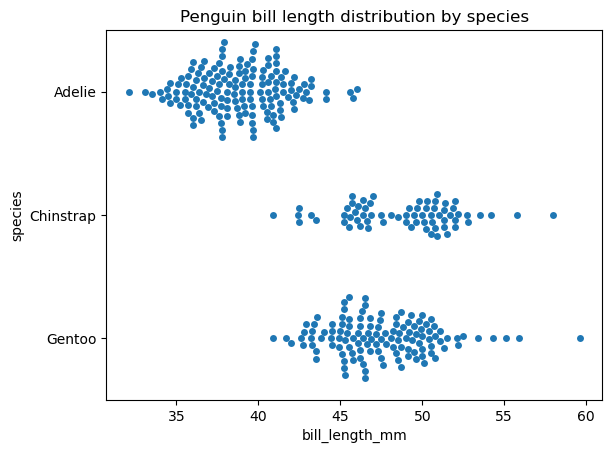
seaborn.stripplot() 和 seaborn.swarmplot() 的语法非常相似。两者都可自定义图的顺序与方向,以及标记的样式、大小、颜色、透明度等。调节标记透明度有助于缓解条带图中的点重叠问题。
矩形树图
矩形树图用于将分类数据的数值按类别显示为放置在一个矩形框中的若干矩形,其面积与对应类别的数值成比例。其用途与柱状图、饼图一致;与饼图类似,矩形树图主要用于表示构成整体的类别。当类别数量不超过十个且差异明显时,矩形树图会显得直观且吸引人。
矩形树图的劣势与饼图相似:
- 人眼对面积的感知不如对长度敏感,容易被误导。
- 当类别超过十个时,效果欠佳。
- 无法展示多组分类数据,即不能像柱状图那样分组。
- 不易体现具体数值。
- 当类别之间差异很小时,信息性较差。
需牢记以上要点,谨慎、少量使用矩形树图,仅在其最合适时采用。
在 Python 中绘制矩形树图,需要先安装并导入 squarify 库:pip install squarify,然后 import squarify。下面的代码创建一个基础矩形树图:
import squarify
# Data preparation
diamonds_grouped = diamonds[['cut', 'price']].groupby('cut').mean().reset_index()
# Creating a treemap
squarify.plot(sizes=diamonds_grouped['price'], label=diamonds_grouped['cut'])
plt.title('Average diamond price by cut')
plt.show()
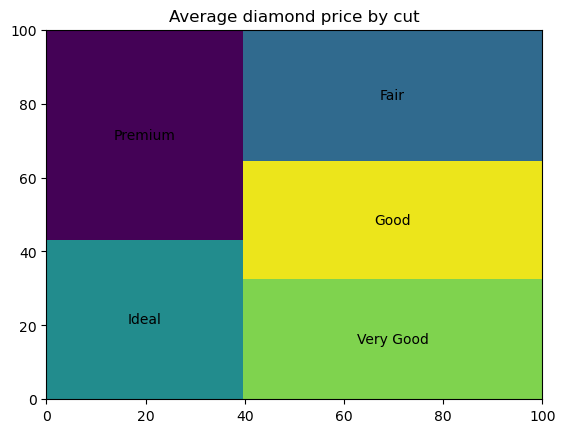
我们可以自定义矩形的颜色与透明度、用纹理填充、调整矩形边框属性、在矩形间添加小间隙,并优化标签文本属性。
另一种方法是使用 plotly 库创建矩形树图。可在教程 What is Data Visualization? A Guide for Data Scientists 中了解更多。
词云
词云是一种文本可视化方式,每个词的字体大小对应其在输入文本中的出现频率。使用词云有助于找出文本中最重要的词。
尽管词云总是醒目且直观,但我们也需了解其内在局限:
- 创建词云常常需要耗时的数据预处理。
- 与大多数文本挖掘工具一样,词云缺乏上下文,容易被误解。例如,它无法捕捉文本中的讽刺、否定或引申义。
- 无法清晰地给出词的排名。我们也许能轻松分辨最频繁的前几项,但随后就不那么容易了。
- 无法呈现精确的词频数值。
- 会造成光学错觉:相同频率下,较长的词看起来比较短的词更大。
- 包含大量竖排词或使用遮罩会降低可读性。
一个有趣且较少人知的用法是:我们可以不按词频,而按每个词的其他属性来生成词云。例如,创建一个国家字典,为每个国家赋予其人口数,并进行展示。
在 Python 中创建词云,需要使用专门的 wordcloud 库。首先安装(pip install wordcloud),然后导入 WordCloud 类和停用词:from wordcloud import WordCloud, STOPWORDS。以下代码生成一个基础词云:
from wordcloud import WordCloud, STOPWORDS
text = 'cat cat cat cat cat cat dog dog dog dog dog panda panda panda panda koala koala koala rabbit rabbit fox'
# Creating a word cloud
wordcloud = WordCloud().generate(text)
plt.imshow(wordcloud)
plt.title('Words by their frequency in the text')
plt.axis('off')
plt.show()
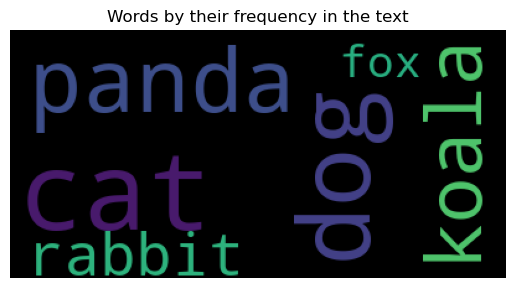
可以调整词云尺寸、更改背景色、为词分配配色方案、设置横排词优先、限制显示词的最大数量、更新停用词列表、限制字体大小、考虑词组搭配、确保结果可复现等。
若想进一步了解 Python 中的词云,请阅读:Generating WordClouds in Python Tutorial。
速查:如何选择合适的图表
| 图表类型 | 最佳用途 | 库 | 函数 |
|---|---|---|---|
| 柱状图 | 比较类别 | matplotlib | plt.bar() |
| 折线图 | 时间趋势 | matplotlib | plt.plot() |
| 散点图 | 两个变量间的相关性 | matplotlib | plt.scatter() |
| 直方图 | 单变量分布 | matplotlib | plt.hist() |
| 箱线图 | 概括统计与离群点 | seaborn | sns.boxplot() |
| 饼图 | 整体的组成部分(谨慎使用) | matplotlib | plt.pie() |
| 分组柱状图 | 跨两个变量的类别 | seaborn | sns.barplot() |
| 堆叠面积图 | 随时间推移的累积趋势 | matplotlib | plt.stackplot() |
| 小提琴图 | 分布形状 + 统计量 | seaborn | sns.violinplot() |
| 热力图 | 矩阵数据中的模式 | seaborn | sns.heatmap() |
| 茎叶图 | 类别很多时(比柱状图更清爽) | matplotlib | plt.stem() |
| 条带图 / 蜂群图 | 按类别展示单个数据点 | seaborn | sns.stripplot() / sns.swarmplot() |
| 矩形树图 | 分层的整体组成 | squarify | squarify.plot() |
| 词云 | 文本中的词频 | wordcloud | WordCloud() |
结语
本文介绍了 14 种数据图,从日常使用的柱状图、散点图,到较为少见的矩形树图与词云。每种图都有其适用场景:柱状图用于比较类别,散点图揭示相关性,热力图突出矩阵数据中的模式,等等。
文中的代码示例使用了 matplotlib 和 seaborn 的默认设置,但这两个库都支持深度自定义。选择合适图表归结为两个问题:您手头的数据是什么类型?您想展示什么样的关系?
需要快速参考选图建议,请查看 适用于各场景的 11 种数据可视化技术。
Python 只是众多可视化工具之一。如果您在其他环境工作,以下课程也值得一看:

IBM 认证数据科学家(2020)。此前曾在全球油气田担任石油地质学家/地质建模师,拥有 12 年以上国际工作经验。精通 Python、R 和 SQL。专长领域包括:数据清洗、数据处理、数据可视化、数据分析、数据建模、统计、数据叙事、机器学习。具备丰富的数据科学社区管理经验,并长期撰写与审校数据科学及职业发展相关的文章与教程。
创建数据图是探索性数据分析中的关键一步。知道要构建哪种可视化,有助于我们从数据中提取有价值、甚至出人意料的见解。
本文将带您了解多种数据图类型,从最常见的到非常规的。对于每一种图,我都会说明它展示什么、何时使用、何时避免,以及如何用 Python 实现。
要点速览
安装 Matplotlib、Seaborn 和 Pandas
为便于练习绘图,我们先下载必要的 Python 库,以及 Seaborn 库中的一些内置数据集:
对于每种数据图,我们都会创建一个基础示例,尽量不做或少做自定义,以演示其基本用法。我们会为每个图添加相应标题,使其更具意义。很多示例在绘图前需要对数据做预处理(在代码中以 # Data preparation 注释)。
我们主要使用 matplotlib 和 Seaborn。如果您对这两个库的绘图不熟悉并需要快速入门,可参考以下学习资料:
若想更深入地学习 Python 数据可视化,请查看技能路径 Data Visualization with Python。