
Cursus
Introductie tot datavisualisatie met Seaborn
4 uur
185.4K
Heatmaps zijn een populaire techniek voor datavisualisatie waarbij kleur wordt gebruikt om verschillende niveaus van datagrootte te vertegenwoordigen, zodat je snel patronen en afwijkingen in je dataset kunt herkennen.
Met de bibliotheek Seaborn kun je eenvoudig sterk aangepaste visualisaties van je data maken, zoals lijngrafieken, histogrammen en heatmaps. Bekijk ook onze tutorial over de verschillende soorten grafieken en hoe je die in Python maakt.
Houd onze Seaborn-cheatsheet bij de hand als snelle referentie bij het plotten en aanpassen van visualisaties met de Seaborn-bibliotheek.
In deze tutorial bekijken we wat Seaborn-heatmaps zijn, wanneer je ze gebruikt en hoe je ze maakt en aanpast zodat ze het beste bij jouw behoeften passen.
Heatmaps ordenen data in een raster, waarbij verschillende kleuren of tinten verschillende niveaus van de datagrootte aangeven.
Door het visuele karakter van heatmaps kun je patronen, zoals clusters, trends en afwijkingen, direct herkennen. Daardoor zijn heatmaps een effectief hulpmiddel voor verkennende data-analyse.
Hier is een voorbeeld van een Seaborn-heatmap:
De keuze voor een heatmap hangt af van je vereisten en de aard van je dataset. In het algemeen zijn heatmaps het meest geschikt voor datasets waarbij je waarden als kleuren kunt weergeven, meestal continue of discrete numerieke data. Je kunt ze echter ook gebruiken voor categorieën die gekwantificeerd of samengevat zijn (bijv. tellingen, gemiddelden).
Als de dataset extreme uitschieters bevat of erg schaars is, is een heatmap mogelijk minder effectief zonder preprocessing of normalisatie. Tekst, afbeeldingen en andere vormen van ongestructureerde data zijn ook niet direct geschikt voor heatmaps, tenzij je de data eerst transformeert naar een gestructureerd, numeriek formaat.
Heatmaps blinken uit bij het visualiseren van de correlatiematrix tussen meerdere variabelen, waardoor je in één oogopslag sterk positief of negatief gecorreleerde variabelen kunt identificeren.
Heatmaps zijn ook handig om data visueel te vergelijken over twee dimensies, zoals verschillende tijdsperioden of categorieën. Voor geografische data-analyse kunnen heatmaps de dichtheid of intensiteit van gebeurtenissen over een ruimtelijke indeling weergeven, zoals bevolkingsdichtheid of criminaliteitslocaties in een stad.
Voor deze tutorial gebruiken we een dataset met informatie over leningen die beschikbaar is op DataLab, de AI-ondersteunde datanotebook van DataCamp. De code voor deze tutorial is ook beschikbaar in een bijbehorend DataLab-werkboek.
In DataLab zijn alle belangrijke bibliotheken al handig geïnstalleerd en klaar om te importeren. Wil je meer weten, lees dan ons artikel over de beste Python-bibliotheken voor data science.
We gebruiken deze bibliotheken in deze tutorial:
# Import libraries
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
Ben je niet vertrouwd met Python en moet je snel op niveau komen voor deze tutorial? Bekijk dan onze cursus Introduction to Python.
Wil je juist meer leren over de bibliotheken die we in deze tutorial gebruiken, bekijk dan deze cursussen:
Zorg dat je data in matrixvorm staat, met rijen en kolommen die verschillende dimensies vertegenwoordigen (bijv. tijdsperioden, variabelen, categorieën). Elke cel in de matrix moet de waarde bevatten die je wilt visualiseren.
Voordat je een heatmap gebruikt, zijn er twee belangrijke opschoontaken: omgaan met missende waarden en het verwijderen van uitschieters.
Bij missende waarden kun je ze opvullen met een statistische maat (gemiddelde, mediaan), interpoleren of verwijderen als ze niet significant zijn. Voor uitschieters kun je, afhankelijk van je analyse, ervoor kiezen om ze te verwijderen of hun waarden aan te passen.
In onze leningen-dataset waren geen missende waarden, maar we identificeerden meerdere uitschieters die we hebben verwijderd. Bekijk het notebook op DataLab voor de volledige code van hoe we dit hebben gedaan.
Als je dataset een groot bereik aan waarden heeft, overweeg dan schalen of normaliseren. Zo kunnen de kleuren in de heatmap relatieve verschillen nauwkeuriger weergeven. Veelgebruikte methoden zijn min-max-schaling en Z-score-normalisatie.
Voor continue data die gecategoriseerd moet worden, kun je discretiseren in intervallen of categorieën voor een betekenisvollere heatmapvisualisatie.
Om seaborn.heatmap() te gebruiken, geef je meestal een matrix met data door. Vervolgens kun je de parameters aanpassen om je heatmaps te personaliseren op basis van je vereisten.
data: De dataset om te visualiseren, die in matrixvorm moet zijn.
cmap: Bepaalt de colormap voor de heatmap. Seaborn ondersteunt verschillende kleurpaletten, waaronder sequentiële, divergerende en kwalitatieve schema's.
annot: Als deze op True staat, wordt de waarde in elke cel op de heatmap geannoteerd.
fmt: Wanneer annot True is, bepaalt fmt de tekenreeksopmaak voor de annotaties. Bijvoorbeeld 'd' voor gehele getallen en '.2f' voor kommagetallen met twee decimalen.
linewidths: Stelt de breedte in van de lijnen die elke cel scheiden. Een grotere waarde vergroot de scheiding tussen cellen.
linecolor: Bepaalt de kleur van de lijnen die elke cel scheiden als linewidths groter is dan 0.
cbar: Een boolean die aangeeft of er een kleurenbalk moet worden getekend. De kleurenbalk geeft een referentie voor het koppelen van datapunten aan kleuren.
vmin en vmax: Deze parameters definiëren het datagebied dat de colormap dekt.
center: Stelt de waarde in waarop de colormap wordt gecentreerd bij gebruik van divergerende kleurenschema's.
square: Als deze op True staat, worden de heatmapcellen vierkant gemaakt.
xticklabels en yticklabels: Regelen de labels die op de x- en y-as worden weergegeven.
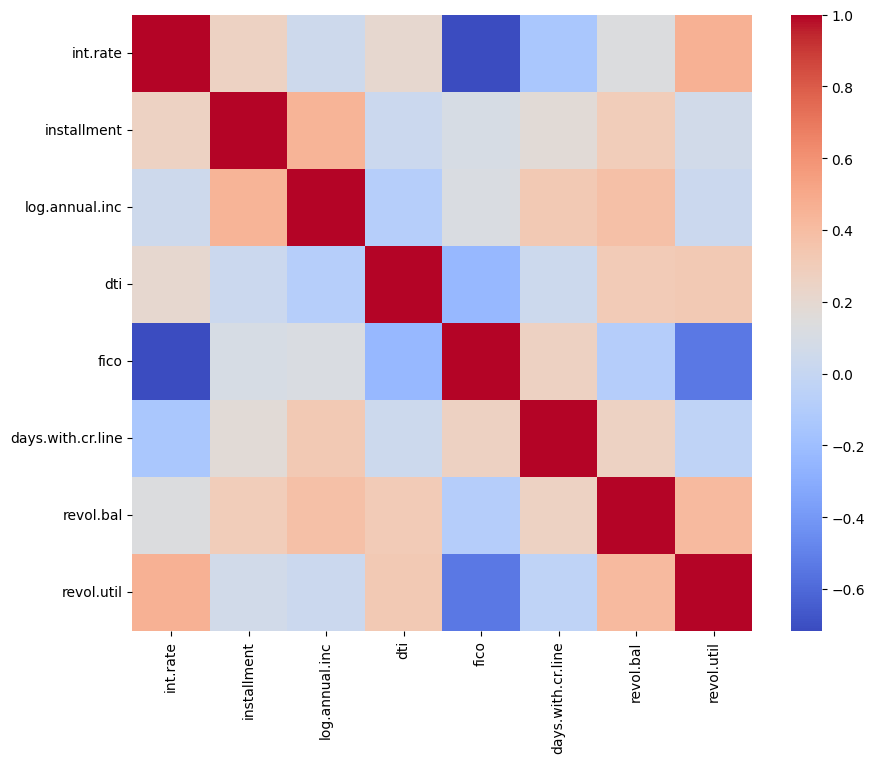
We maken een heatmap die de correlatiecoëfficiënt tussen elke numerieke variabele in onze data laat zien. We houden de heatmap nu eenvoudig en passen hem in de volgende sectie verder aan.
# Calculate the correlation matrix
correlation_matrix = filtered_df.corr()

# Create the heatmap
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'coolwarm')
plt.show()
Door de kleuren van je heatmap aan te passen, maak je hem makkelijker leesbaar en zorg je voor opvallendere visuals in rapporten en presentaties.
Seaborn en Matplotlib bieden een breed scala aan ingebouwde colormaps. Experimenteer met colormaps ('Blues', 'coolwarm', 'viridis', enz.) om er een te vinden die de structuur en patronen in je data effectief benadrukt. Gebruik sequentiële colormaps voor data met een natuurlijke volgorde van laag naar hoog, divergerende colormaps voor data met een kritisch middelpunt en kwalitatieve colormaps voor categorische data.
Je bent echter niet beperkt tot de standaardcolormaps en -opties van Seaborn. Je kunt aangepaste colormaps maken met Matplotlib en extra opties instellen, zoals het aanpassen van de transparantie.
Met vmin en vmax kun je het bereik van je data instellen dat de colormap dekt. Dit kan het contrast vergroten en de focus leggen op specifieke bereiken van interesse.
Voor divergerende colormaps gebruik je de parameter center om de middenwaarde te specificeren. Zo wordt het kleurcontrast verankerd rond een kritieke waarde.
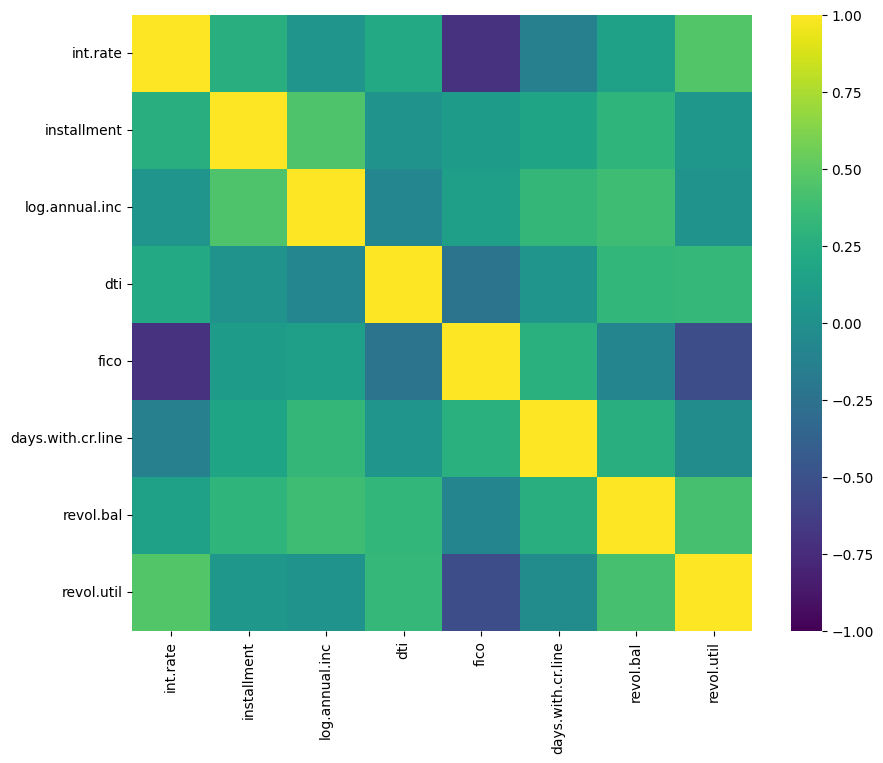
We passen het kleurpalet van onze heatmap aan en verankeren de kleuren ook door de minimale, maximale en middenwaarden te specificeren.
# Customize heatmap colors
plt.figure(figsize = (10,8))
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0)
plt.show()
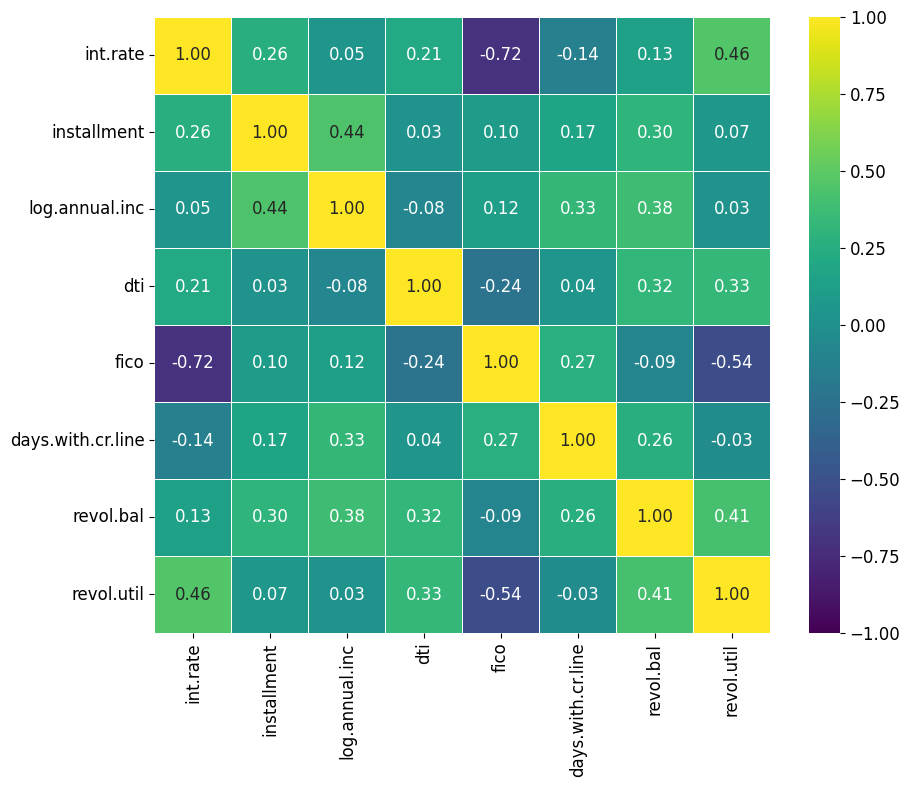
Data-annotatie betekent dat je labels aan elke cel toevoegt die numerieke waarden of tekst kunnen weergeven. Annotaties maken het makkelijker om heatmaps snel te lezen en te interpreteren zonder dat je de waarden via de legenda hoeft af te leiden.
Om annotaties in te schakelen, zet je de parameter annot op True. Hierdoor worden de datapunten in elke cel van de heatmap weergegeven.
Met de parameter fmt kun je de tekst van de annotaties opmaken. Gebruik bijvoorbeeld 'd' voor gehele getallen en '.2f' voor getallen met twee decimalen.
Hoewel de heatmapfunctie van Seaborn niet direct toelaat om tekst-eigenschappen zoals lettergrootte via de parameter annot aan te passen, kun je deze eigenschappen globaal aanpassen met de rcParams van Matplotlib.
# Create an annotated heatmap
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5)
plt.show()
De parameter annot kan ook een array-achtig object met dezelfde vorm als je data accepteren. Dit is een handige truc om annotaties toe te voegen met andere informatie dan wat de celkleuren weergeven. Hier is een voorbeeld van hoe je dit kunt toepassen:
# Example of alternative annotations
  annot_array = np.round(data*100, decimals=2)
sns.heatmap(data, annot=annot_array, fmt='s')Datamaskering is een techniek om bepaalde datapunten selectief te benadrukken of te verbergen op basis van specifieke voorwaarden. Dit helpt de aandacht te richten op bepaalde interessegebieden of patronen in de dataset.
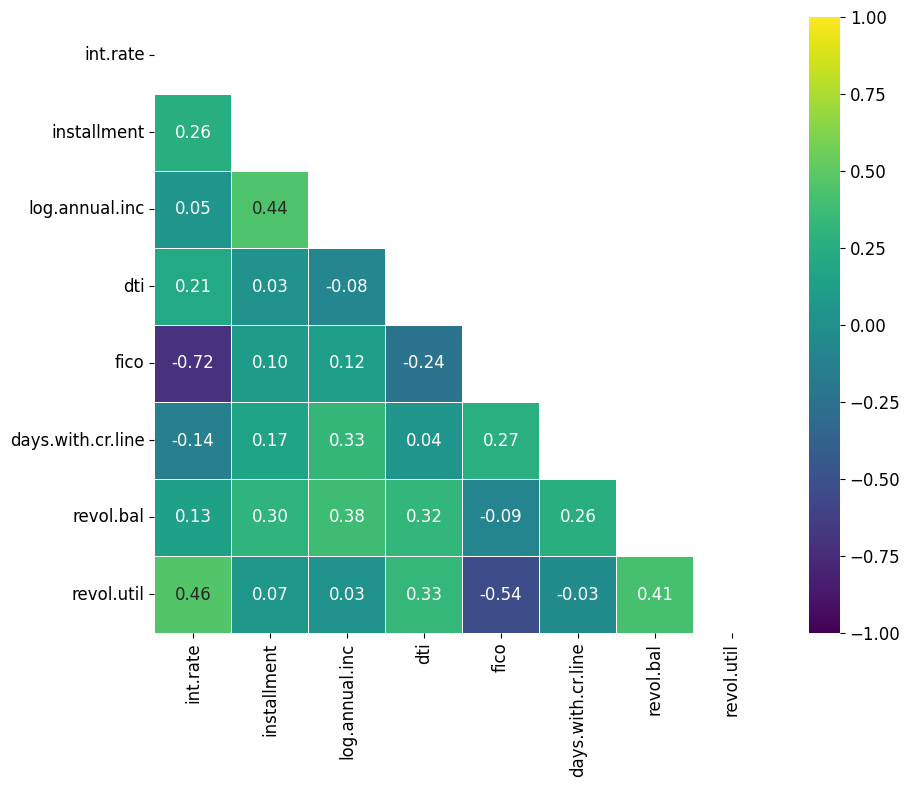
Maak eerst een booleaanse masker met dezelfde vorm als je datamatrix. Het masker moet True (of False) zijn voor de datapunten die je wilt verbergen (of weergeven). Omdat de correlatiematrix symmetrisch is, kunnen we de functie triu van numpy gebruiken om een driehoeksmasker te maken dat alleen het bovenste deel van onze heatmap bedekt.
# Create a mask using numpy's triu function
mask = np.triu(np.ones_like(correlation_matrix, dtype=bool))
Gebruik de parameter mask van de functie seaborn.heatmap() om je masker toe te passen. Datapunten die overeenkomen met True in het masker worden verborgen.
# Create a masked heatmap
plt.figure(figsize = (10,8))
plt.rcParams.update({'font.size': 12})
sns.heatmap(correlation_matrix, cmap = 'viridis', vmin = -1, vmax = 1, center = 0, annot=True, fmt=".2f", square=True, linewidths=.5, mask = mask)
plt.show()
Door deze best practices te volgen, kun je met Seaborn-heatmaps opvallende visualisaties maken voor je rapporten en presentaties.
Hier zijn vijf best practices om te overwegen wanneer je Seaborn-heatmaps gebruikt:
Het kleurenpalet dat je kiest, beïnvloedt direct hoe je data wordt waargenomen. Verschillende kleurenschema's kunnen patronen in je data benadrukken of juist verhullen.
Gebruik sequentiële kleurpaletten voor data die oploopt van laag naar hoog en divergerende kleurpaletten voor data met een betekenisvol middelpunt. Seaborn biedt diverse opties via de parameter cmap, zodat je het kleurenschema kunt afstemmen op je dataset. Lees onze tutorial Seaborn Color Palette: Quick Guide to Picking Colors om alles te leren over de verschillende kleurpaletopties en hoe ze verschillende grafiektypen ondersteunen.
Missende data kan gaten in je heatmap veroorzaken en de kijker mogelijk misleiden. Bepaal vóór het plotten een strategie voor het omgaan met missende data. Afhankelijk van hun betekenis kun je missende waarden imputeren of volledig verwijderen. Of geef missende data weer met een afwijkende kleur of patroon om de aanwezigheid te benadrukken zonder te misleiden.
Data met grote variaties of uitschieters kan de visualisatie vertekenen, waardoor het moeilijk wordt om te bepalen of de data patronen bevat. Normaliseer of schaal je data zodat de heatmap verschillen in de dataset nauwkeurig weergeeft. Afhankelijk van de aard van je data kunnen technieken zoals min-max-schaling, Z-score-normalisatie of zelfs logtransformaties nuttig zijn.
Annotaties kunnen waardevolle details toevoegen door exacte waarden te tonen, maar een overdaad aan annotaties kan de heatmap onleesbaar maken, vooral bij grote datasets.
Beperk annotaties tot kernpunten of gebruik ze in kleinere heatmaps.
De standaardverhouding en -grootte zijn mogelijk niet geschikt voor je dataset, waardoor cellen geplet raken of het geheel te krap oogt, wat patronen verhult.
Pas de grootte en beeldverhouding van je heatmap aan, zodat elke cel duidelijk zichtbaar is en het algemene patroon makkelijk te onderscheiden is.
De heatmapfunctie van Seaborn maakt opvallende visualisaties van datapatronen mogelijk en is vooral handig om correlaties tussen numerieke variabelen te visualiseren.
Het is echter belangrijk om best practices te volgen. Denk aan het kiezen van het juiste kleurenpalet, doordacht omgaan met missende data, data correct schalen, annotaties spaarzaam gebruiken en de afmetingen van je heatmap aanpassen.
Wil je je verdiepen in de Seaborn-bibliotheek? Onze cursus Introduction to Data Visualization with Seaborn is ideaal voor beginners. Ben je al wat verder, verdiep je kennis dan met Intermediate Data Visualization with Seaborn.
Begin vandaag nog met je Seaborn-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

