
课程
R 数据科学的线性代数
4 小时
21.8K
奇异矩阵是不可逆的方阵,即没有乘法逆矩阵。这个线性代数中的基础概念对数据科学应用影响深远,从机器学习算法到计算方法中的数值稳定性都与之相关。
本文将定义矩阵为何为奇异,并探讨其数学性质与特征。随后,我们将研究检测奇异矩阵的方法,理解其在数据科学中的实际影响,并学习如何有效应对。
奇异矩阵是行列式等于零的方阵,因此不可逆。
用数学语言表述,对于方阵 A,若 det(A) = 0,则 A 为奇异矩阵,且不存在逆矩阵 A⁻¹。
奇异矩阵的根本特征是其行或列线性相关,即至少有一行(或一列)可以表示为其他行(或列)的线性组合。这种相关性造成矩阵存在“亏损”,从而无法拥有唯一的逆矩阵。
也可从秩的角度理解奇异矩阵。方阵当且仅当其秩小于行(或列)数时为奇异矩阵。秩表示线性无关行或列的最大数目,因此当其小于矩阵维度时,就会出现奇异性。
这一概念之所以重要,是因为许多算法依赖矩阵求逆,从求解线性回归到实现某些机器学习技术。当矩阵为奇异时,这些操作会失败,需要采用替代方法或预处理步骤来处理这种情况。
理解奇异矩阵的数学性质,有助于在其引发计算问题前发现潜在风险。
理解了奇异矩阵的基本性质后,我们将其与非奇异矩阵进行对比。
非奇异矩阵可逆,支持可靠的数值计算;而奇异矩阵无逆,需要专门处理。这一本质差异决定了数据科学应用中的计算可行性。
这些差异体现在我们先前讨论的每个基本性质上。下表总结了奇异矩阵与非奇异矩阵的差别:
通过具体示例可以说明奇异性在实践中的表现,并帮助建立识别这类矩阵的直觉。
考虑一个基本示例,其中一行是另一行的倍数:

简单的 2×2 奇异矩阵(作者自制)
这里第二行正好是第一行的一半,形成线性相关。行列式为 (2×2) — (4×1) = 0,验证了其为奇异矩阵。
任何包含全零行或全零列的矩阵都会自动成为奇异矩阵:
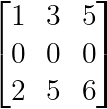
零行或零列(作者自制)
零行使矩阵不可能满秩,无论其他元素为何。
具有相同行或相同列的矩阵始终是奇异的:
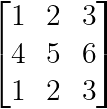
相同行或相同列(作者自制)
第一行与第三行相同,形成完全线性相关。
更为隐蔽的奇异性出现在某一行等于其他行的线性组合时:
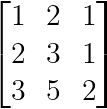
线性组合相关(作者自制)
此处第三行等于前两行之和:[3,5,2] = [1,2,1] + [2,3,1]。
上述每个示例都展示了看似不同的矩阵如何共享定义奇异性的线性相关这一基本属性。
由于真实世界数据的特性和常见分析流程,数据科学应用中经常会出现奇异矩阵。
数据科学中奇异矩阵最常见的来源是多重共线性,即数据集中多个特征完全或近乎完全相关。这会在设计矩阵的列间产生线性相关,在进行矩阵运算时导致奇异性。
例如在零售数据集中,您可能拥有 total_sales、q1_sales、q2_sales、q3_sales 和 q4_sales 等特征。若季度销售额总是精确相加等于年度总销售额,则:
total_sales = q1_sales + q2_sales + q3_sales + q4_sales当该关系在所有观测中都完全成立时,得到的设计矩阵将是奇异的。任何试图对该矩阵求逆的线性回归算法都会失败,因为其中一列可以被其他列完美预测。
类似情形也常见于如下派生特征:
当高维数据集中观测数少于特征数时,自然会产生奇异矩阵。若有 n 个样本、p 个特征且 p > n,则得到的 n×n 协方差矩阵或 Gram 矩阵的秩至多为 n;如果需要一个可逆的 p×p 矩阵,它将是奇异的。
这种“维度灾难”常常影响:
常见的数据预处理步骤可能无意间引入奇异性:
理解这些常见的奇异性来源,使数据科学家能够在工作流早期实施预防措施,例如在探索性数据分析中检查多重共线性,或主动使用正则化技术。
既然我们了解了数据科学中为何会出现奇异矩阵,接下来探讨在导致计算失败之前如何实践性地检测它们。
检测奇异矩阵最直接的方法是检查其行列式。如果方阵的行列式为零,该矩阵即为奇异、不可逆。此方法简单、数学上严谨,且在实践中被广泛使用。
下面了解如何用 Python 进行该检查:
import numpy as np

# Example 2x2 matrix
A = np.array([[2, 4],
             [1, 2]])

# Calculate the determinant
det_A = np.linalg.det(A)

print(f"Determinant of A: {det_A}")

# Check if matrix is singular
if np.isclose(det_A, 0):
   print("Matrix A is singular.")
else:
   print("Matrix A is non-singular.")
在上述示例中,我们定义了一个 2×2 矩阵A,并使用np.linalg.det()计算其行列式。由于浮点运算会引入微小数值误差,我们使用np.isclose()判断行列式是否“有效地为零”。若是,则可断定该矩阵为奇异矩阵。
如下所示的输出将确认其奇异性:
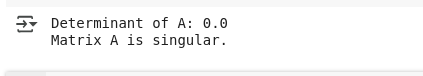
检测奇异矩阵的输出。(作者自制)
该方法直观且实用,是诊断数据科学工作流中与矩阵可逆性相关问题的可靠第一步。
在数据科学工作流中遇到奇异矩阵时,有多种策略可在保持分析严谨性的同时解决计算难题。
在对角线上加入微小值(岭回归正则化)是处理回归问题中近似奇异矩阵的最常见方法。该技术将奇异矩阵转化为可逆矩阵,同时保持数值稳定性:
# Ridge regularization approach
lambda_reg = 1e-6
A_regularized = A + lambda_reg * np.eye(A.shape[0])Moore-Penrose 伪逆为奇异矩阵提供了广义逆,以最小二乘意义给出“最优”解:
# Using pseudoinverse for singular matrices
A_pinv = np.linalg.pinv(A)
x = A_pinv @ b 移除线性相关特征可从源头消除奇异性。主成分分析或特征选择技术能够识别并移除冗余维度:
# PCA-based dimensionality reduction
from sklearn.decomposition import PCA
pca = PCA(n_components=0.95)
X_reduced = pca.fit_transform(X)有些算法专门用于处理奇异矩阵。带主元的QR 分解可以在系数矩阵为奇异时求解线性系统:当解存在时给出解,不一致时识别不一致性。
这些策略可确保奇异矩阵不至于扰乱数据科学项目,同时保持数学严谨性与结果的可解释性。
本文探讨了奇异矩阵:它是行列式为零、由于行或列之间的线性相关而不可逆的方阵。我们说明了其在数据科学中常见的出现原因,从多重共线性、高维数据到预处理过程中引入的问题。
本文还回顾了检测与处理奇异矩阵的方法,包括行列式检查、正则化、伪逆与降维等基础技术。(如果您希望继续自行深入,还可以借助条件数分析或奇异值分解等工具,进一步洞察矩阵行为与数值稳定性。)
若要加深对线性代数及其在数据科学应用中关键作用的理解,欢迎参加我们的数据科学线性代数课程,在真实场景中掌握这些基础概念及其实现。
与 DataCamp 一起学习
课程
课程
课程