
Last chance! 50% off DataCamp Premium
Sale ends in
सिंगुलर मैट्रिक्स वह वर्गमैट्रिक्स है जिसे इनवर्ट नहीं किया जा सकता, यानी उसका कोई गुणात्मक व्युत्क्रम (multiplicative inverse) मौजूद नहीं होता। रैखिक बीजगणित की यह बुनियादी अवधारणा मशीन लर्निंग एल्गोरिदम से लेकर संगणनात्मक विधियों में संख्यात्मक स्थिरता तक, डेटा साइंस के अनुप्रयोगों पर व्यापक प्रभाव डालती है।
इस लेख में, हम जानेंगे कि किसी मैट्रिक्स को सिंगुलर क्या बनाता है और उसकी गणितीय विशेषताएँ और लक्षण क्या हैं। फिर हम सिंगुलर मैट्रिसेज़ का पता लगाने की विधियों की जाँच करेंगे। हम डेटा साइंस में इनके वास्तविक निहितार्थ समझेंगे और सीखेंगे कि इन्हें प्रभावी ढंग से कैसे संभालें।
सिंगुलर मैट्रिक्स वह वर्गमैट्रिक्स है जिसका डेटर्मिनेंट शून्य होता है, जिसके कारण वह इनवर्टिबल नहीं रहता।
गणितीय रूप से, किसी वर्गमैट्रिक्स A के लिए, यदि det(A) = 0, तो A सिंगुलर है और उसका इनवर्स मैट्रिक्स A⁻¹ अस्तित्व में नहीं होता।
सिंगुलर मैट्रिक्स की मूलभूत विशेषता यह है कि उसकी पंक्तियाँ या स्तंभ रैखिक रूप से आश्रित होते हैं, यानी कम से कम एक पंक्ति (या स्तंभ) अन्य पंक्तियों (या स्तंभों) के रैखिक संयोजन के रूप में व्यक्त की जा सकती है। यह आश्रय मैट्रिक्स में एक “अपूर्णता” पैदा करता है, जो उसे अद्वितीय इनवर्स होने से रोकता है।
सिंगुलर मैट्रिक्स को उसकी रैंक के माध्यम से भी समझा जा सकता है। कोई वर्गमैट्रिक्स तभी और केवल तभी सिंगुलर होता है जब उसकी रैंक उसकी पंक्तियों (या स्तंभों) की संख्या से कम हो। रैंक रैखिक रूप से स्वतंत्र पंक्तियों या स्तंभों की अधिकतम संख्या दर्शाती है, इसलिए जब यह मैट्रिक्स के आयाम से कम हो, तो सिंगुलैरिटी होती है।
यह अवधारणा महत्वपूर्ण है क्योंकि कई एल्गोरिदम मैट्रिक्स इनवर्ज़न पर निर्भर करते हैं—रेखीय प्रतिगमन (linear regression) समस्याओं को हल करने से लेकर कुछ मशीन लर्निंग तकनीकों को लागू करने तक। जब कोई मैट्रिक्स सिंगुलर होता है, तो ये क्रियाएँ विफल हो जाती हैं और स्थिति को संभालने के लिए वैकल्पिक तरीकों या पूर्व-प्रसंस्करण चरणों की आवश्यकता होती है।
सिंगुलर मैट्रिसेज़ के गणितीय गुणों को समझना डेटा साइंस वर्कफ्लो में संगणनात्मक समस्याएँ पैदा होने से पहले संभावित मुद्दों की पहचान करने में मदद करता है।
अब जबकि हमने सिंगुलर मैट्रिक्स के बुनियादी गुण समझ लिए हैं, आइए इन्हें नॉन-सिंगुलर मैट्रिक्स के साथ तुलना करें।
नॉन-सिंगुलर मैट्रिसेज़ इनवर्टिबल होती हैं और विश्वसनीय संख्यात्मक गणनाओं का समर्थन करती हैं, जबकि सिंगुलर मैट्रिसेज़ के इनवर्स नहीं होते और विशेष संभाल की आवश्यकता होती है। यह बुनियादी विभाजन डेटा साइंस अनुप्रयोगों में संगणनात्मक व्यवहार्यता तय करता है।
ये भिन्नताएँ उन प्रत्येक बुनियादी गुणों पर लागू होती हैं जिन्हें हमने पहले देखा था। नीचे दी गई तालिका सिंगुलर और नॉन-सिंगुलर मैट्रिसेज़ के बीच के अंतर का सार प्रस्तुत करती है:
विशिष्ट उदाहरणों को देखना यह दर्शाने में मदद करता है कि व्यवहार में सिंगुलैरिटी कैसे प्रकट होती है और इन मैट्रिसेज़ को पहचानने की सहज समझ विकसित होती है।
इस बुनियादी उदाहरण पर विचार करें जहाँ एक पंक्ति दूसरी का गुणज है:

सरल 2×2 सिंगुलर मैट्रिक्स (Image by Author)
यहाँ, दूसरी पंक्ति पहली पंक्ति का ठीक आधा है, जिससे रैखिक आश्रय बनता है। डेटर्मिनेंट (2×2) — (4×1) = 0 है, जो सिंगुलैरिटी की पुष्टि करता है।
कोई भी मैट्रिक्स जिसमें पूरी तरह शून्य वाली पंक्ति या स्तंभ हो, स्वचालित रूप से सिंगुलर होता है:
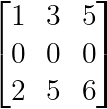
शून्य पंक्ति या स्तंभ (Image by Author)
शून्य पंक्ति मैट्रिक्स के लिए पूर्ण रैंक होना असंभव बना देती है, चाहे अन्य प्रविष्टियाँ कुछ भी हों।
समान पंक्तियों या स्तंभों वाले मैट्रिसेज़ हमेशा सिंगुलर होते हैं:
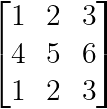
समान पंक्तियाँ या स्तंभ (Image by Author)
पहली और तीसरी पंक्तियाँ समान हैं, जो पूर्ण रैखिक आश्रय बनाती हैं।
एक अधिक सूक्ष्म सिंगुलैरिटी तब होती है जब कोई पंक्ति अन्य पंक्तियों के संयोजन के बराबर होती है:
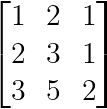
रैखिक संयोजन पर आश्रय (Image by Author)
यहाँ, तीसरी पंक्ति पहली दो पंक्तियों के योग के बराबर है: [3,5,2] = [1,2,1] + [2,3,1]।
उपरोक्त प्रत्येक उदाहरण दिखाता है कि दिखने में भिन्न मैट्रिसेज़ भी सिंगुलैरिटी को परिभाषित करने वाले रैखिक आश्रय के मूल गुण को साझा कर सकती हैं।
वास्तविक दुनिया के डेटा की प्रकृति और सामान्य विश्लेषणात्मक वर्कफ़्लोज़ के कारण डेटा साइंस अनुप्रयोगों में सिंगुलर मैट्रिसेज़ अक्सर सामने आती हैं।
डेटा साइंस में सिंगुलर मैट्रिसेज़ का सबसे सामान्य स्रोत मल्टिकॉलीनियरिटी है, जब किसी डेटासेट में कई फीचर पूरी तरह या लगभग पूरी तरह सहसम्बद्ध होते हैं। इससे डिज़ाइन मैट्रिक्स के कॉलमों के बीच रैखिक निर्भरता बनती है, जो मैट्रिक्स ऑपरेशनों के दौरान सिंगुलैरिटी की ओर ले जाती है।
एक रिटेल डेटासेट पर विचार करें, जहाँ आपके पास total_sales, q1_sales, q2_sales, q3_sales और q4_sales जैसे फीचर हैं। यदि तिमाही बिक्री के मान हमेशा ठीक-ठीक कुल बिक्री के बराबर जुड़ते हैं, तो:
total_sales = q1_sales + q2_sales + q3_sales + q4_salesजब यह संबंध सभी प्रेक्षणों में पूरी तरह लागू होता है, तो परिणामी डिज़ाइन मैट्रिक्स सिंगुलर हो जाती है। कोई भी लिनियर रिग्रेशन एल्गोरिद्म जो इस मैट्रिक्स को इनवर्ट करने की कोशिश करेगा, विफल होगा क्योंकि एक कॉलम को अन्य कॉलमों से पूरी तरह पूर्वानुमानित किया जा सकता है।
इसी तरह की स्थितियाँ व्युत्पन्न फीचर्स के साथ भी होती हैं, जैसे:
ऐसे उच्च-आयामी डेटासेट जिनमें प्रेक्षण फीचर्स से कम हों, स्वाभाविक रूप से सिंगुलर मैट्रिसेज़ पैदा करते हैं। जब आपके पास n सैंपल हों लेकिन p फीचर, जहाँ p > n, तो परिणामी n×n कोवेरिएंस मैट्रिक्स या ग्राम मैट्रिक्स की रैंक अधिकतम n होगी, जिससे वह सिंगुलर हो जाएगी यदि आपको p×p इनवर्टिबल मैट्रिक्स चाहिए।
यह “curse of dimensionality” आमतौर पर प्रभावित करता है:
आम प्रीप्रोसेसिंग चरण अनजाने में सिंगुलैरिटी ला सकते हैं:
सिंगुलैरिटी के इन सामान्य स्रोतों को समझना डेटा वैज्ञानिकों को अपने वर्कफ़्लो के शुरुआती चरणों में ही निवारक कदम उठाने में मदद देता है, जैसे एक्सप्लोरेटरी डेटा एनालिसिस के दौरान मल्टिकॉलीनियरिटी की जाँच करना या सक्रिय रूप से रेग्युलराइज़ेशन तकनीकों का उपयोग करना।
अब जब हम समझ गए हैं कि डेटा साइंस में सिंगुलर मैट्रिसेज़ क्यों उत्पन्न होती हैं, तो आइए उन्हें कम्प्यूटेशनल विफलताओं का कारण बनने से पहले पहचानने के व्यावहारिक तरीके देखें।
सिंगुलर मैट्रिक्स का पता लगाने का सबसे सीधा तरीका उसके डिटरमिनेंट की जाँच करना है। यदि किसी स्क्वायर मैट्रिक्स का डिटरमिनेंट शून्य है, तो मैट्रिक्स सिंगुलर और नॉन-इनवर्टिबल है। यह तरीका सरल, गणितीय रूप से सुदृढ़ और व्यवहार में व्यापक रूप से उपयोग किया जाता है।
आइए समझते हैं कि Python का उपयोग करके यह जाँच कैसे करें:
import numpy as np

# Example 2x2 matrix
A = np.array([[2, 4],
             [1, 2]])

# Calculate the determinant
det_A = np.linalg.det(A)

print(f"Determinant of A: {det_A}")

# Check if matrix is singular
if np.isclose(det_A, 0):
   print("Matrix A is singular.")
else:
   print("Matrix A is non-singular.")
ऊपर के उदाहरण में, हम 2×2 मैट्रिक्स A परिभाषित करते हैं और np.linalg.det() का उपयोग करके उसका डिटरमिनेंट निकालते हैं। चूँकि फ्लोटिंग-पॉइंट अंकगणित छोटे संख्यात्मक त्रुटियाँ ला सकता है, हम np.isclose() का उपयोग करते हैं यह जाँचने के लिए कि डिटरमिनेंट प्रभावी रूप से शून्य है या नहीं। यदि है, तो हम निष्कर्ष निकालते हैं कि मैट्रिक्स सिंगुलर है।
नीचे आउटपुट में सिंगुलैरिटी की पुष्टि दिखाई देगी:
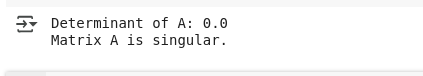
सिंगुलर मैट्रिक्स का पता लगाने वाला आउटपुट। (चित्र: लेखक)
यह तरीका सहज और व्यावहारिक दोनों है, जिससे डेटा साइंस वर्कफ़्लो में मैट्रिक्स इनवर्टिबिलिटी से जुड़े मुद्दों का निदान करते समय यह एक विश्वसनीय पहला कदम बन जाता है।
डेटा साइंस वर्कफ़्लो में सिंगुलर मैट्रिसेज़ आने पर, कई रणनीतियाँ कम्प्यूटेशनल चुनौतियों को हल कर सकती हैं, जबकि विश्लेषणात्मक अखंडता को बनाए रखती हैं।
डायगोनल में छोटे मान जोड़ना (रिज रेग्युलराइज़ेशन) रिग्रेशन समस्याओं में लगभग-सिंगुलर मैट्रिसेज़ को संभालने का सबसे सामान्य तरीका है। यह तकनीक सिंगुलर मैट्रिसेज़ को इनवर्टिबल में बदलती है और संख्यात्मक स्थिरता बनाए रखती है:
# Ridge regularization approach
lambda_reg = 1e-6
A_regularized = A + lambda_reg * np.eye(A.shape[0])मूर-पेनरोज़ प्स्यूडो-इनवर्स सिंगुलर मैट्रिसेज़ के लिए एक सामान्यीकृत इनवर्स प्रदान करता है, जो लीस्ट-स्क्वेयर्स अर्थ में “सर्वोत्तम” समाधान देता है:
# Using pseudoinverse for singular matrices
A_pinv = np.linalg.pinv(A)
x = A_pinv @ b रैखिक रूप से निर्भर फीचर्स को हटाना समस्या को उसके स्रोत पर ही सुलझा देता है। प्रिंसिपल कंपोनेंट एनालिसिस या फीचर चयन तकनीकें अतिरिक्त आयामों की पहचान कर उन्हें हटा सकती हैं:
# PCA-based dimensionality reduction
from sklearn.decomposition import PCA
pca = PCA(n_components=0.95)
X_reduced = pca.fit_transform(X)कुछ एल्गोरिद्म विशेष रूप से सिंगुलर मैट्रिसेज़ को संभालने के लिए डिज़ाइन किए गए हैं। पिवोटिंग के साथ QR डिकंपोज़िशन गुणांक मैट्रिक्स सिंगुलर होने पर भी रैखिक प्रणालियाँ हल कर सकता है, जहाँ समाधान मौजूद हों वहाँ उन्हें देता है और जहाँ न हों वहाँ असंगतियाँ दर्शाता है।
इन रणनीतियों से सुनिश्चित होता है कि सिंगुलर मैट्रिसेज़ डेटा साइंस प्रोजेक्ट्स को पटरी से नहीं उतारेंगी, साथ ही परिणामों की गणितीय दृढ़ता और व्याख्येयता भी बनी रहेगी।
इस लेख में हमने सिंगुलर मैट्रिसेज़ का अध्ययन किया—जो ऐसी स्क्वायर मैट्रिसेज़ होती हैं जिनका डिटरमिनेंट शून्य होता है—और जो पंक्तियों या कॉलमों के बीच रैखिक निर्भरता के कारण इनवर्ट नहीं की जा सकतीं। हमने देखा कि वे डेटा साइंस में आम तौर पर क्यों दिखती हैं—मल्टिकॉलीनियरिटी और उच्च-आयामी डेटा से लेकर प्रीप्रोसेसिंग के दौरान आने वाली समस्याओं तक।
इस लेख में, हमने सिंगुलर मैट्रिसेज़ का पता लगाने और संभालने के तरीके भी देखे—जैसे डिटरमिनेंट जाँच, रेग्युलराइज़ेशन, प्स्यूडो-इनवर्स, और आयामीयता में कमी। (यदि आप स्वयं आगे और देखना चाहते हैं, तो कंडीशन नंबर विश्लेषण या सिंगुलर वैल्यू डिकंपोज़िशन जैसे उपकरण मैट्रिक्स के व्यवहार और संख्यात्मक स्थिरता पर और भी अंतर्दृष्टि दे सकते हैं।)
रैखिक बीजगणित और डेटा साइंस अनुप्रयोगों में इसकी अहम भूमिका की अपनी समझ गहरी करने के लिए, हमारे Linear Algebra for Data Science कोर्स में नामांकन करें, जहाँ आप इन बुनियादी सिद्धांतों और उनके वास्तविक दुनिया के परिदृश्यों में अनुप्रयोगों में निपुणता हासिल करेंगे।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स
