
Last chance! 50% off DataCamp Premium
Sale ends in
Una matrice singolare è una matrice quadrata che non può essere invertita, cioè non ha un inverso moltiplicativo. Questo concetto fondamentale dell’algebra lineare ha un enorme impatto sulle applicazioni di data science, dagli algoritmi di machine learning alla stabilità numerica nei metodi computazionali.
In questo articolo definiremo cosa rende una matrice singolare ed esploreremo le sue proprietà e caratteristiche matematiche. Esamineremo quindi i metodi per rilevare le matrici singolari. Capiremo le loro reali implicazioni nella data science e impareremo a gestirle in modo efficace.
Una matrice singolare è una matrice quadrata il cui determinante è uguale a zero, il che la rende non invertibile.
In termini matematici, per una matrice quadrata A, se det(A) = 0, allora A è singolare e non ha una matrice inversa A⁻¹.
La caratteristica fondamentale di una matrice singolare è che le sue righe o colonne sono linearmente dipendenti, cioè almeno una riga (o colonna) può essere espressa come combinazione lineare delle altre righe (o colonne). Questa dipendenza crea una “deficienza” nella matrice che ne impedisce l’esistenza di un inverso unico.
Un altro modo per capire le matrici singolari è attraverso il loro rango. Una matrice quadrata è singolare se e solo se il suo rango è inferiore al numero di righe (o colonne). Il rango rappresenta il numero massimo di righe o colonne linearmente indipendenti, quindi quando questo è inferiore alle dimensioni della matrice, si verifica la singolarità.
Questo concetto è importante perché molti algoritmi si basano sull’inversione di matrici, dalla risoluzione di problemi di regressione lineare all’implementazione di alcune tecniche di machine learning. Quando una matrice è singolare, queste operazioni falliscono, richiedendo approcci alternativi o passaggi di preprocessamento per gestire la situazione.
Comprendere le proprietà matematiche delle matrici singolari aiuta a individuare potenziali problemi prima che causino errori computazionali nei flussi di lavoro di data science.
Ora che abbiamo compreso le proprietà fondamentali di una matrice singolare, confrontiamole con quelle delle matrici non singolari.
Le matrici non singolari sono invertibili e supportano calcoli numerici affidabili, mentre le matrici singolari non hanno inverso e richiedono una gestione specifica. Questa divisione fondamentale determina la fattibilità computazionale nelle applicazioni di data science.
Queste differenze si applicano a ciascuna delle proprietà fondamentali di una matrice singolare viste in precedenza. La tabella seguente riassume le differenze tra matrici singolari e non singolari:
Esaminare esempi specifici aiuta a illustrare come la singolarità si manifesti nella pratica e costruisce intuizione per riconoscere queste matrici.
Considera questo esempio di base in cui una riga è un multiplo di un’altra:

Semplice matrice singolare 2×2 (Immagine dell’autore)
Qui, la seconda riga è esattamente la metà della prima, creando dipendenza lineare. Il determinante è (2×2) — (4×1) = 0, confermando la singolarità.
Qualsiasi matrice che contenga una riga o una colonna composta interamente da zeri è automaticamente singolare:
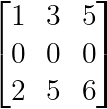
Riga o colonna nulla (Immagine dell’autore)
La riga nulla rende impossibile per la matrice avere rango pieno, indipendentemente dagli altri elementi.
Le matrici con righe o colonne identiche sono sempre singolari:
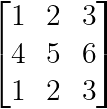
Righe o colonne identiche (Immagine dell’autore)
La prima e la terza riga sono identiche, creando perfetta dipendenza lineare.
Una singolarità più sottile si verifica quando una riga è uguale a una combinazione delle altre:
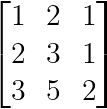
Dipendenza per combinazione lineare (Immagine dell’autore)
Qui, la terza riga è uguale alla somma delle prime due righe: [3,5,2] = [1,2,1] + [2,3,1].
Ciascuno degli esempi mostrati sopra dimostra come matrici apparentemente diverse condividano la proprietà fondamentale di dipendenza lineare che definisce la singolarità.
Le matrici singolari emergono frequentemente nelle applicazioni di data science a causa della natura dei dati reali e dei flussi di lavoro analitici comuni.
La fonte più comune di matrici singolari nella data science è la multicollinearità, quando più feature in un dataset sono perfettamente o quasi perfettamente correlate. Ciò crea dipendenza lineare tra le colonne nella matrice dei disegni, portando alla singolarità durante le operazioni sulle matrici.
Considera un dataset retail in cui hai le feature total_sales, q1_sales, q2_sales, q3_sales e q4_sales. Se i valori trimestrali sommano sempre esattamente alle vendite totali, allora:
total_sales = q1_sales + q2_sales + q3_sales + q4_salesQuando questa relazione vale perfettamente per tutte le osservazioni, la matrice dei disegni risultante diventa singolare. Qualsiasi algoritmo di regressione lineare che tenti di invertire questa matrice fallirà perché una colonna può essere prevista perfettamente dalle altre.
Si verificano scenari simili con feature derivate come:
I dataset ad alta dimensionalità con meno osservazioni che feature producono naturalmente matrici singolari. Quando hai n campioni ma p feature con p > n, la matrice di covarianza n×n o matrice di Gram risultante avrà rango al più n, rendendola singolare se ti serve una matrice p×p invertibile.
Questa “maledizione della dimensionalità” colpisce comunemente:
Passaggi comuni di preprocessamento dei dati possono introdurre involontariamente singolarità:
Comprendere queste fonti comuni di singolarità consente ai data scientist di implementare misure preventive già nelle prime fasi del flusso di lavoro, come il controllo della multicollinearità durante l’analisi esplorativa dei dati o l’uso proattivo di tecniche di regolarizzazione.
Ora che capiamo perché le matrici singolari compaiono nella data science, esploriamo metodi pratici per rilevarle prima che causino errori computazionali.
Il modo più semplice per rilevare una matrice singolare è controllarne il determinante. Se il determinante di una matrice quadrata è zero, la matrice è singolare e non invertibile. Questo metodo è semplice, matematicamente solido e ampiamente utilizzato nella pratica.
Vediamo come eseguire questo controllo usando Python:
import numpy as np

# Example 2x2 matrix
A = np.array([[2, 4],
             [1, 2]])

# Calculate the determinant
det_A = np.linalg.det(A)

print(f"Determinant of A: {det_A}")

# Check if matrix is singular
if np.isclose(det_A, 0):
   print("Matrix A is singular.")
else:
   print("Matrix A is non-singular.")
Nell’esempio sopra, definiamo una matrice 2×2 A e usiamo np.linalg.det() per calcolarne il determinante. Poiché l’aritmetica in virgola mobile può introdurre piccoli errori numerici, usiamo np.isclose() per verificare se il determinante è effettivamente zero. Se lo è, concludiamo che la matrice è singolare.
Vedremo l’output qui sotto che conferma la singolarità:
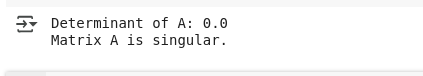
Output che rileva la matrice singolare. (Immagine dell’autore)
Questo metodo è sia intuitivo che pratico, rendendolo un primo passo affidabile quando si diagnosticano problemi legati all’invertibilità delle matrici nei flussi di lavoro di data science.
Quando si incontrano matrici singolari nei flussi di lavoro di data science, diverse strategie possono risolvere le sfide computazionali preservando l’integrità analitica.
Aggiungere piccoli valori alla diagonale (regolarizzazione Ridge) è l’a Approccio più comune per gestire matrici quasi singolari nei problemi di regressione. Questa tecnica trasforma le matrici singolari in matrici invertibili mantenendo la stabilità numerica:
# Ridge regularization approach
lambda_reg = 1e-6
A_regularized = A + lambda_reg * np.eye(A.shape[0])La pseudoinversa di Moore-Penrose fornisce un inverso generalizzato per le matrici singolari, offrendo la “migliore” soluzione in termini di minimi quadrati:
# Using pseudoinverse for singular matrices
A_pinv = np.linalg.pinv(A)
x = A_pinv @ b Rimuovere le feature linearmente dipendenti elimina la singolarità alla radice. La principal component analysis o le tecniche di selezione delle feature possono identificare e rimuovere dimensioni ridondanti:
# PCA-based dimensionality reduction
from sklearn.decomposition import PCA
pca = PCA(n_components=0.95)
X_reduced = pca.fit_transform(X)Alcuni algoritmi sono progettati specificamente per gestire matrici singolari. La decomposizione QR con pivoting può risolvere sistemi lineari anche quando la matrice dei coefficienti è singolare, fornendo soluzioni quando esistono e identificando le inconsistenze quando non esistono.
Queste strategie garantiscono che le matrici singolari non mandino fuori strada i progetti di data science, mantenendo al contempo il rigore matematico e l’interpretabilità dei risultati.
Questo articolo ha esplorato le matrici singolari, che abbiamo visto essere matrici quadrate con determinante zero che non possono essere invertite a causa di dipendenze lineari tra righe o colonne. Abbiamo visto perché compaiono spesso nella data science, dalla multicollinearità e dai dati ad alta dimensionalità a problemi introdotti durante il preprocessamento.
In questo articolo abbiamo anche esaminato come rilevare e gestire le matrici singolari usando tecniche di base come il controllo del determinante, la regolarizzazione, le pseudoinverse e la riduzione della dimensionalità. (Se vuoi approfondire per conto tuo, strumenti come l’analisi del numero di condizionamento o la decomposizione ai valori singolari possono offrire ulteriori spunti sul comportamento delle matrici e sulla stabilità numerica.)
Per approfondire la tua comprensione dell’algebra lineare e del suo ruolo cruciale nelle applicazioni di data science, iscriviti al nostro corso Linear Algebra for Data Science, dove padroneggerai questi concetti fondamentali e la loro implementazione in scenari reali.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min




