

安装 SQLAlchemy
安装该软件包并开始编码相当容易。
您可以使用 Python 包管理器(pip)安装 SQLAlchemy:
pip install sqlalchemy如果您使用的是 Anaconda 发行版,请在 conda 终端输入以下命令:
conda install -c anaconda sqlalchemy让我们检查是否已成功安装该软件包:
>>> import sqlalchemy
>>> sqlalchemy.__version__
'1.4.41'很好,我们已成功安装 SQLAlchemy 1.4.41 版本。
快速上手
本节我们将学习如何连接 SQLite 数据库、创建表对象,并使用它们运行 SQL 查询。
连接数据库
我们将使用来自 Kaggle 的European Football SQLite 数据库,其中包含两张表:divisions 和 matchs。
首先,使用 create_object 创建 SQLite 引擎对象,并传入数据库位置地址。然后,通过引擎创建连接对象。我们将使用 conn 对象来运行各种 SQL 查询。
from sqlalchemy as db
engine = db.create_engine("sqlite:///european_database.sqlite")
conn = engine.connect() 如果您想连接 PostgreSQL、MySQL、Oracle 和 Microsoft SQL Server 数据库,请查看引擎配置,以顺利连接到服务器。
本 SQLAlchemy 教程默认您已了解 Python 和 SQL 的基础。即使尚未掌握也没关系。您可以学习 SQL 基础 与 Python 基础技能路径,夯实根基。
访问数据表
要创建表对象,我们需要提供表名和元数据。您可以使用 SQLAlchemy 的 MetaData() 函数生成元数据。
metadata = db.MetaData() #extracting the metadata
division= db.Table('divisions', metadata, autoload=True,
autoload_with=engine) #Table object打印 divisions 的元数据。
print(repr(metadata.tables['divisions']))元数据包含表名、带类型的列名以及架构信息。
Table('divisions', MetaData(), Column('division', TEXT(), table=<divisions>),
Column('name', TEXT(), table=<divisions>), Column('country', TEXT(),
table=<divisions>), schema=None)使用表对象 division 打印列名。
print(division.columns.keys())该表包含 division、name 和 country 三列。
['division', 'name', 'country']简单 SQL 查询
接下来是有趣的部分。我们将使用表对象运行查询并提取结果。
在下面的代码中,我们选择了 division 表的全部列。
query = division.select() #SELECT * FROM divisions
print(query)注意:您也可以将 select 命令写为 db.select([division])。
要查看查询语句,打印查询对象即可显示 SQL 命令。
SELECT divisions.division, divisions.name, divisions.country
FROM divisionsSQL 查询结果
现在我们将使用连接对象执行查询,并提取前五行。
- fetchone():一次提取一行。
- fetchmany(n):一次提取 n 行。
- fetchall():提取全部行。
exe = conn.execute(query) #executing the query
result = exe.fetchmany(5) #extracting top 5 results
print(result)结果显示了该表的前五行。
[('B1', 'Division 1A', 'Belgium'), ('D1', 'Bundesliga', 'Deutschland'), ('D2', '2. Bundesliga', 'Deutschland'), ('E0', 'Premier League', 'England'), ('E1', 'EFL Championship', 'England')]Python SQLAlchemy 示例
本节将展示使用 SQLAlchemy 创建数据表、插入值、运行 SQL 查询、数据分析与表管理的多种示例。
您可以跟随操作,或查看此 DataLab 工作簿。其中包含数据库、源代码和结果。
创建数据表
首先,我们将创建一个名为 datacamp.sqlite 的新数据库。若不存在同名数据库,create_engine 会自动创建。因此创建与连接步骤基本相同。
随后,连接数据库并创建元数据对象。
我们将使用 SQLAlchmy 的 Table 函数创建名为“Student”的表。
该表包含以下列:
- Id:整数,主键
- Name:字符串,非空
- Major:字符串,默认值为 “Math”
- Pass:布尔型,默认值为 True
我们已经创建了表的结构。使用 `metadata.create_all(engine)` 将其添加到数据库。
engine = db.create_engine('sqlite:///datacamp.sqlite')
conn = engine.connect()
metadata = db.MetaData()
Student = db.Table('Student', metadata,
db.Column('Id', db.Integer(),primary_key=True),
db.Column('Name', db.String(255), nullable=False),
db.Column('Major', db.String(255), default="Math"),
db.Column('Pass', db.Boolean(), default=True)
)
metadata.create_all(engine) 单行插入(Insert one)
要添加单行数据,我们先使用 insert 并传入表对象。接着用 values 手动为各列赋值,其用法类似于为 Python 函数传参。
最后,使用连接执行该查询。
query = db.insert(Student).values(Id=1, Name='Matthew', Major="English", Pass=True)
Result = conn.execute(query)通过执行 select 查询并获取所有行,检查是否已将该行添加到 Student 表。
output = conn.execute(Student.select()).fetchall()
print(output)我们已成功添加数据。
[(1, 'Matthew', 'English', True)]多行插入(Insert many)
逐条添加并不高效。让我们用列表一次性添加多行。
-
为
Student表创建插入查询。 -
创建包含多行的列表,每行以列名和对应的值表示。
-
执行查询,并将
values_list作为第二个参数传入。
query = db.insert(Student)
values_list = [{'Id':'2', 'Name':'Nisha', 'Major':"Science", 'Pass':False},
{'Id':'3', 'Name':'Natasha', 'Major':"Math", 'Pass':True},
{'Id':'4', 'Name':'Ben', 'Major':"English", 'Pass':False}]
Result = conn.execute(query,values_list)为验证结果,运行简单的 select 查询。
output = conn.execute(db.select([Student])).fetchall()
print(output)表中现在包含了更多行。
[(1, 'Matthew', 'English', True), (2, 'Nisha', 'Science', False), (3, 'Natasha', 'Math', True), (4, 'Ben', 'English', False)]使用 SQLAlchemy 的简单 SQL 查询
除了使用 Python 对象,我们也可以用字符串执行 SQL 查询。
只需将字符串作为参数传给 execute() 函数,并用 fetchall() 查看结果。
output = conn.execute("SELECT * FROM Student")
print(output.fetchall())输出:
[(1, 'Matthew', 'English', 1), (2, 'Nisha', 'Science', 0), (3, 'Natasha', 'Math', 1), (4, 'Ben', 'English', 0)]您甚至可以传入更复杂的 SQL 查询。在我们的示例中,我们选择 Name 和 Major 两列,条件是学生已通过考试。
output = conn.execute("SELECT Name, Major FROM Student WHERE Pass = True")
print(output.fetchall())输出:
[('Matthew', 'English'), ('Natasha', 'Math')]使用 SQLAlchemy API
之前我们一直在使用较为简单的 SQLAlchemy API/对象。下面来看看更复杂的多步查询。
下面的示例中,我们将选择所有主修 English 的学生的全部列。
query = Student.select().where(Student.columns.Major == 'English')
output = conn.execute(query)
print(output.fetchall())输出:
[(1, 'Matthew', 'English', True), (4, 'Ben', 'English', False)]让我们在 WHERE 查询中应用 AND 逻辑。
本例中,我们查找主修 English 且考试未通过的学生。
注意:不等于 ‘!=’ True 即为 False。
query = Student.select().where(db.and_(Student.columns.Major == 'English', Student.columns.Pass != True))
output = conn.execute(query)
print(output.fetchall())只有 Ben 主修 English 且未通过考试。
[(4, 'Ben', 'English', False)]借助类似的表,我们可以运行各种命令,如下表所示。
您可以复制并粘贴这些命令自行测试结果。如果在执行过程中遇到问题,请查看DataLab 工作簿。
|
命令 |
API |
|
in |
Student.select().where(Student.columns.Major.in_(['English','Math'])) |
|
and, or, not |
Student.select().where(db.or_(Student.columns.Major == 'English', Student.columns.Pass = True)) |
|
order by |
Student.select().order_by(db.desc(Student.columns.Name)) |
|
limit |
Student.select().limit(3) |
|
sum, avg, count, min, max |
db.select([db.func.sum(Student.columns.Id)]) |
|
group by |
db.select([db.func.sum(Student.columns.Id),Student.columns.Major]).group_by(Student.columns.Pass) |
|
distinct |
db.select([Student.columns.Major.distinct()]) |
如需了解更多函数与命令,请参阅官方文档:SQL 语句与表达式 API。
输出为 Pandas DataFrame
数据科学家与分析师更偏爱pandas 的 DataFrame,并希望在其中工作。本部分我们将学习如何把 SQLAlchemy 查询结果转换为 pandas DataFrame。
首先,执行查询并保存结果。
query = Student.select().where(Student.columns.Major.in_(['English','Math']))
output = conn.execute(query)
results = output.fetchall()然后使用 DataFrame() 函数,并将 SQL 结果作为参数传入。最后,利用首行 results[0] 的 .keys() 添加列名。
注意:您可以提供任意有效行,配合 keys() 提取列名。
data = pd.DataFrame(results)
data.columns = results[0].keys()
data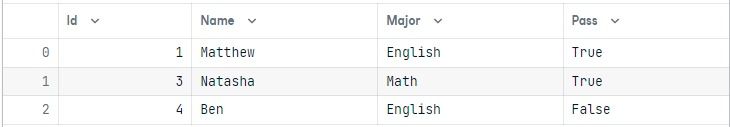
使用 SQLAlchemy 进行数据分析
本部分我们将连接 European football 数据库,执行复杂查询并对结果进行可视化。
连接两张表
照常使用 create_engine() 和 connect() 函数连接数据库。
本例需要联结两张表,因此需分别创建两个表对象:division 与 match。
engine = create_engine("sqlite:///european_database.sqlite")
conn = engine.connect()
metadata = db.MetaData()
division = db.Table('divisions', metadata, autoload=True, autoload_with=engine)
match = db.Table('matchs', metadata, autoload=True, autoload_with=engine)运行复杂查询
- 选择 division 和 match 的所有列。
- 使用公共列进行联结:division.division 与 match.Div。
- 选择 division 为 E1 且 season 为 2009 的所有列。
- 按 HomeTeam 对结果排序。
您也可以通过添加更多模块构建更复杂的查询。
注意:也可使用 db.select([division.columns.division,match.columns.Div]) 自动联结两张表。
query = db.select([division,match]).\
select_from(division.join(match,division.columns.division == match.columns.Div)).\
where(db.and_(division.columns.division == "E1", match.columns.season == 2009 )).\
order_by(match.columns.HomeTeam)
output = conn.execute(query)
results = output.fetchall()
data = pd.DataFrame(results)
data.columns = results[0].keys()
data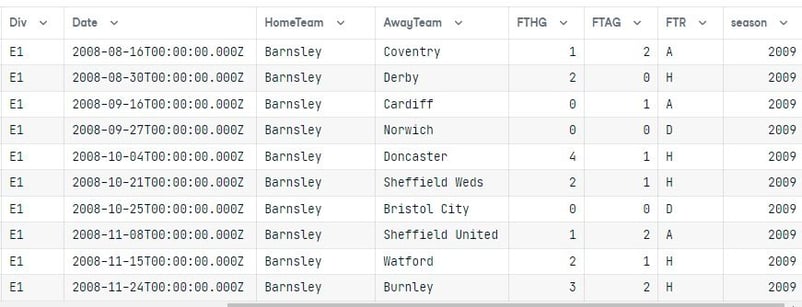
执行查询后,我们将结果转换为 pandas DataFrame。
两张表已完成联结,结果仅显示 2009 赛季 E1 组别,并按 HomeTeam 列排序。
数据可视化
有了 DataFrame,我们便可使用 Seaborn 以柱状图的形式可视化结果。
我们将:
- 将主题设为 “whitegrid”
- 将可视化尺寸调整为 15X6
- 将 x 轴刻度旋转至 90 度
- 将配色设置为 “pastels”
- 绘制 "HomeTeam" 与 "FTHG" 的柱状图,颜色为蓝色
- 绘制 "HomeTeam" 与 "FTAG" 的柱状图,颜色为红色
- 将图例显示在左上角
- 移除 x 与 y 轴标签
- 去除左侧与底部边框
本部分的主要目的是展示如何将 SQL 查询结果用于创建优秀的数据可视化。
import seaborn as sns
import matplotlib.pyplot as plt
sns.set_theme(style="whitegrid")
f, ax = plt.subplots(figsize=(15, 6))
plt.xticks(rotation=90)
sns.set_color_codes("pastel")
sns.barplot(x="HomeTeam", y="FTHG", data=data,
label="Home Team Goals", color="b")
sns.barplot(x="HomeTeam", y="FTAG", data=data,
label="Away Team Goals", color="r")
ax.legend(ncol=2, loc="upper left", frameon=True)
ax.set(ylabel="", xlabel="")
sns.despine(left=True, bottom=True)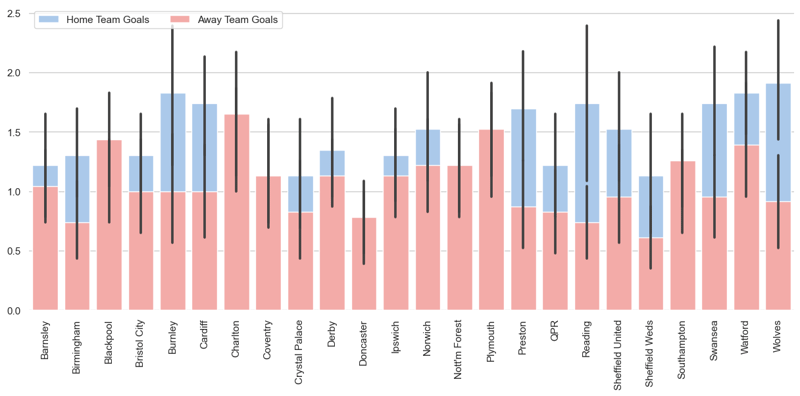
将结果保存为 CSV
将查询结果转换为 pandas DataFrame 后,您可以直接使用 .to_csv() 并传入文件名。
output = conn.execute("SELECT * FROM matchs WHERE HomeTeam LIKE 'Norwich'")
results = output.fetchall()
data = pd.DataFrame(results)
data.columns = results[0].keys()通过设置 `index=False` 避免添加名为 “Index” 的列。
data.to_csv("SQl_result.csv",index=False)将 CSV 文件导入为 SQL 表
本部分我们将把 Stock Exchange Data CSV 文件转换为 SQL 表。
首先,连接到 datacamp 的 sqlite 数据库。
engine = create_engine("sqlite:///datacamp.sqlite")然后使用 read_csv() 导入 CSV 文件。最后使用 to_sql() 将 pandas DataFrame 保存为 SQL 表。
一般而言,to_sql() 需要连接和表名作为参数。您还可以使用 if_exisits 来替换同名的现有表,以及使用 index 来去除索引列。
df = pd.read_csv('Stock Exchange Data.csv')
df.to_sql(con=engine, name="Stock_price", if_exists='replace', index=False)
>>> 2222要验证结果,我们需要连接数据库并创建表对象。
conn = engine.connect()
metadata = db.MetaData()
stock = db.Table('Stock_price', metadata, autoload=True, autoload_with=engine)然后执行查询并显示结果。
query = stock.select()
exe = conn.execute(query)
result = exe.fetchmany(5)
for r in result:
print(r)如您所见,我们已成功将 CSV 文件中的所有值转入 SQL 表。
('HSI', '1986-12-31', 2568.300049, 2568.300049, 2568.300049, 2568.300049, 2568.300049, 0, 333.87900637)
('HSI', '1987-01-02', 2540.100098, 2540.100098, 2540.100098, 2540.100098, 2540.100098, 0, 330.21301274)
('HSI', '1987-01-05', 2552.399902, 2552.399902, 2552.399902, 2552.399902, 2552.399902, 0, 331.81198726)
('HSI', '1987-01-06', 2583.899902, 2583.899902, 2583.899902, 2583.899902, 2583.899902, 0, 335.90698726)
('HSI', '1987-01-07', 2607.100098, 2607.100098, 2607.100098, 2607.100098, 2607.100098, 0, 338.92301274)SQL 表管理
更新表中值
更新值十分直接。我们将使用 update、values 和 where 来更新表中的特定值。
table.update().values(column_1=1, column_2=4,...).where(table.columns.column_5 >= 5)在我们的示例中,我们将学生 Nisha 的 Pass 值从 False 改为 True。
Student = db.Table('Student', metadata, autoload=True, autoload_with=engine)
query = Student.update().values(Pass = True).where(Student.columns.Name == "Nisha")
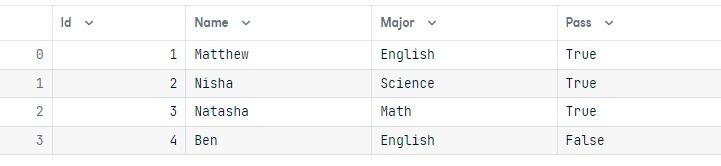
results = conn.execute(query)为验证结果,让我们执行一个简单查询,并以 pandas DataFrame 的形式展示结果。
output = conn.execute(Student.select()).fetchall()
data = pd.DataFrame(output)
data.columns = output[0].keys()
data我们已成功将名为 Nisha 的学生的 Pass 值改为 True。
删除记录
删除行与更新类似,需要使用 delete() 和 where()。
table.delete().where(table.columns.column_1 == 6)本例中,我们将删除名为 Ben 的学生记录。
Student = db.Table('Student', metadata, autoload=True, autoload_with=engine)
query = Student.delete().where(Student.columns.Name == "Ben")
results = conn.execute(query)为验证结果,我们将快速查询并以 DataFrame 展示。可以看到,名为 Ben 的学生记录已被删除。
output = conn.execute(Student.select()).fetchall()
data = pd.DataFrame(output)
data.columns = output[0].keys()
data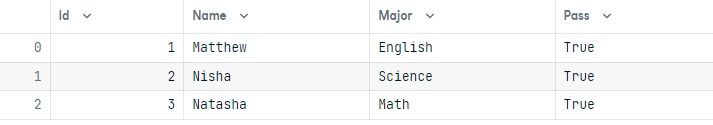
删除数据表
如果您使用的是 SQLite,删除表时可能会报错 database is locked。为什么?因为 SQLite 非常轻量,一次只能执行一个操作;当前正在执行 select 查询。我们需要在删除表之前关闭相关执行。
results.close()
exe.close()之后,使用 metadata 的 drop_all() 并选择表对象即可删除单表。您也可以使用 Student.drop(engine) 删除单个表。
metadata.drop_all(engine, [Student], checkfirst=True)如果您未在 drop_all() 中指定任何表,它将删除数据库中的所有表。
metadata.drop_all(engine)结语
本 SQLAlchemy 教程涵盖了从连接数据库到修改数据表的多种功能。如果您希望进一步学习,建议完成Python 数据库入门互动课程。您将学习关系型数据库的基础、筛选、排序与分组;此外,还将掌握用于数据处理的高级 SQLAlchemy 函数。
如果在学习过程中遇到问题,请前往DataLab 工作簿,将您的代码与其对比。您也可以复制该工作簿,在 DataLab 中直接运行。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
本文将带您了解 SQLAlchemy——一个面向 Python 的 SQL 工具包,可简化查询、构建和管理数据库等任务。
阅读本教程后,建议您报名我们的Python 数据库入门课程进行更多练习。课程亮点包括指导您完成数据筛选与分组的实践项目、更高级的 SQLAlchemy 查询,以及学习查询、构建并写入包括 SQLite、MySQL、PostgreSQL 在内的常用数据库。
什么是 SQLAlchemy?
SQLAlchemy 是 Python 的 SQL 工具包,使开发者能够用 Python 风格的领域语言访问和管理 SQL 数据库。您既可以以字符串形式编写查询,也可以通过链式组合 Python 对象来完成类似查询。使用对象带来更高的灵活性,便于构建高性能的、以 SQL 为基础的应用程序。
简单来说,它让用户可以用 Python 连接数据库,借助面向对象的方式运行 SQL 查询,并使工作流程更顺畅。