

SQLAlchemy इंस्टॉल करें
पैकेज इंस्टॉल करना और कोडिंग शुरू करना काफी आसान है.
आप Python पैकेज मैनेजर (pip) का उपयोग करके SQLAlchemy इंस्टॉल कर सकते हैं:
pip install sqlalchemyयदि आप Python का Anaconda डिस्ट्रीब्यूशन उपयोग कर रहे हैं, तो conda टर्मिनल में यह कमांड आज़माएँ:
conda install -c anaconda sqlalchemyआइए जाँचते हैं कि पैकेज सफलतापूर्वक इंस्टॉल हुआ है या नहीं:
>>> import sqlalchemy
>>> sqlalchemy.__version__
'1.4.41'बेहतरीन, हमने SQLAlchemy संस्करण 1.4.41 सफलतापूर्वक इंस्टॉल कर लिया है।
शुरूआत करें
इस खंड में, हम SQLite डेटाबेस से कनेक्ट करना, टेबल ऑब्जेक्ट बनाना, और उनका उपयोग कर SQL क्वेरी चलाना सीखेंगे।
डेटाबेस से कनेक्ट करना
हम Kaggle का European Football SQLite डेटाबेस उपयोग करेंगे, जिसमें दो टेबल हैं: divisions और matchs।
सबसे पहले, हम create_object का उपयोग करके SQLite इंजन ऑब्जेक्ट बनाएंगे और डेटाबेस का लोकेशन पता पास करेंगे। फिर, इंजन से कनेक्ट करके कनेक्शन ऑब्जेक्ट बनाएँगे। हम सभी तरह की SQL क्वेरी चलाने के लिए conn ऑब्जेक्ट का उपयोग करेंगे।
from sqlalchemy as db
engine = db.create_engine("sqlite:///european_database.sqlite")
conn = engine.connect() यदि आप PostgreSQL, MySQL, Oracle, और Microsoft SQL Server डेटाबेस से कनेक्ट करना चाहते हैं, तो सर्वर से सुचारू कनेक्टिविटी के लिए engine configuration देखें।
यह SQLAlchemy ट्यूटोरियल मानता है कि आपको Python और SQL की बुनियादी जानकारी है। यदि नहीं, तो भी कोई बात नहीं। आप मजबूत नींव बनाने के लिए SQL Fundamentals और Python Fundamentals स्किल ट्रैक कर सकते हैं।
टेबल तक पहुंचना
टेबल ऑब्जेक्ट बनाने के लिए हमें टेबल का नाम और मेटाडेटा देना होगा। आप SQLAlchemy के MetaData() फ़ंक्शन का उपयोग करके मेटाडेटा बना सकते हैं।
metadata = db.MetaData() #extracting the metadata
division= db.Table('divisions', metadata, autoload=True,
autoload_with=engine) #Table objectआइए divisions का मेटाडेटा प्रिंट करें।
print(repr(metadata.tables['divisions']))मेटाडेटा में टेबल का नाम, कॉलम नाम उनके प्रकार के साथ, और स्कीमा शामिल होता है।
Table('divisions', MetaData(), Column('division', TEXT(), table=<divisions>),
Column('name', TEXT(), table=<divisions>), Column('country', TEXT(),
table=<divisions>), schema=None)आइए टेबल ऑब्जेक्ट division का उपयोग करके कॉलम नाम प्रिंट करें।
print(division.columns.keys())टेबल में division, name, और country कॉलम हैं।
['division', 'name', 'country']सरल SQL क्वेरी
अब मजेदार हिस्सा आता है। हम क्वेरी चलाने और परिणाम निकालने के लिए टेबल ऑब्जेक्ट का उपयोग करेंगे।
नीचे दिए गए कोड में, हम division टेबल के सभी कॉलम चुन रहे हैं।
query = division.select() #SELECT * FROM divisions
print(query)नोट: आप select कमांड को db.select([division]) के रूप में भी लिख सकते हैं।
क्वेरी देखने के लिए, क्वेरी ऑब्जेक्ट प्रिंट करें, यह SQL कमांड दिखाएगा।
SELECT divisions.division, divisions.name, divisions.country
FROM divisionsSQL क्वेरी का परिणाम
अब हम कनेक्शन ऑब्जेक्ट का उपयोग करके क्वेरी निष्पादित करेंगे और पहली पाँच पंक्तियाँ निकालेंगे।
- fetchone(): यह एक समय में एक पंक्ति निकालेगा।
- fetchmany(n): यह एक समय में n पंक्तियाँ निकालेगा।
- fetchall(): यह सभी पंक्तियाँ निकाल देगा।
exe = conn.execute(query) #executing the query
result = exe.fetchmany(5) #extracting top 5 results
print(result)परिणाम टेबल की पहली पाँच पंक्तियाँ दिखाता है।
[('B1', 'Division 1A', 'Belgium'), ('D1', 'Bundesliga', 'Deutschland'), ('D2', '2. Bundesliga', 'Deutschland'), ('E0', 'Premier League', 'England'), ('E1', 'EFL Championship', 'England')]Python SQLAlchemy उदाहरण
इस खंड में, हम टेबल बनाने, मान जोड़ने, SQL क्वेरी चलाने, डेटा विश्लेषण, और टेबल प्रबंधन के लिए विभिन्न SQLAlchemy उदाहरण देखेंगे।
आप साथ-साथ चल सकते हैं या यह DataLab वर्कबुक देख सकते हैं। इसमें डेटाबेस, सोर्स कोड, और परिणाम शामिल हैं।
टेबल बनाना
सबसे पहले, हम datacamp.sqlite नाम का नया डेटाबेस बनाएँगे। यदि उसी नाम का कोई डेटाबेस नहीं है, तो create_engine अपने-आप नया डेटाबेस बना देगा। इसलिए, बनाना और कनेक्ट करना लगभग समान ही है।
उसके बाद, हम डेटाबेस से कनेक्ट करेंगे और एक मेटाडेटा ऑब्जेक्ट बनाएँगे।
हम SQLAlchemy के Table फ़ंक्शन का उपयोग करके “Student” नाम की टेबल बनाएँगे।
यह निम्न कॉलमों से मिलकर बनेगी:
- Id: Integer और primary key
- Name: String और non-nullable
- Major: String और default = “Math”
- Pass: Boolean और default = True
हमने टेबल की संरचना बना ली है। आइए इसे `metadata.create_all(engine)` का उपयोग करके डेटाबेस में जोड़ें।
engine = db.create_engine('sqlite:///datacamp.sqlite')
conn = engine.connect()
metadata = db.MetaData()
Student = db.Table('Student', metadata,
db.Column('Id', db.Integer(),primary_key=True),
db.Column('Name', db.String(255), nullable=False),
db.Column('Major', db.String(255), default="Math"),
db.Column('Pass', db.Boolean(), default=True)
)
metadata.create_all(engine) एक पंक्ति जोड़ना
एकल पंक्ति जोड़ने के लिए, हम पहले insert का उपयोग करेंगे और टेबल ऑब्जेक्ट जोड़ेंगे। उसके बाद, values का उपयोग करके कॉलमों में मान मैन्युअली जोड़ें। यह Python फ़ंक्शनों में आर्ग्युमेंट जोड़ने जैसा ही काम करता है।
अंत में, कनेक्शन का उपयोग करके क्वेरी निष्पादित करें।
query = db.insert(Student).values(Id=1, Name='Matthew', Major="English", Pass=True)
Result = conn.execute(query)आइए select क्वेरी चलाकर और सभी पंक्तियाँ निकालकर जाँचें कि हमने Student टेबल में पंक्ति जोड़ी है या नहीं।
output = conn.execute(Student.select()).fetchall()
print(output)हमने सफलतापूर्वक मान जोड़ दिए हैं।
[(1, 'Matthew', 'English', True)]कई पंक्तियाँ जोड़ना
एक-एक करके मान जोड़ना डेटाबेस भरने का व्यावहारिक तरीका नहीं है। आइए सूचियों का उपयोग करके कई मान जोड़ें।
-
Studentटेबल के लिए एक insert क्वेरी बनाएँ। -
कॉलम नाम और मानों के साथ कई पंक्तियों की एक सूची बनाएँ।
-
क्वेरी को दूसरे आर्ग्युमेंट
values_listके साथ निष्पादित करें।
query = db.insert(Student)
values_list = [{'Id':'2', 'Name':'Nisha', 'Major':"Science", 'Pass':False},
{'Id':'3', 'Name':'Natasha', 'Major':"Math", 'Pass':True},
{'Id':'4', 'Name':'Ben', 'Major':"English", 'Pass':False}]
Result = conn.execute(query,values_list)परिणाम मान्य करने के लिए, साधारण select क्वेरी चलाएँ।
output = conn.execute(db.select([Student])).fetchall()
print(output)अब टेबल में और पंक्तियाँ हैं।
[(1, 'Matthew', 'English', True), (2, 'Nisha', 'Science', False), (3, 'Natasha', 'Math', True), (4, 'Ben', 'English', False)]SQLAlchemy के साथ सरल SQL क्वेरी
Python ऑब्जेक्ट्स के बजाय, हम String का उपयोग करके भी SQL क्वेरी चला सकते हैं।
बस execute() फ़ंक्शन में आर्ग्युमेंट के रूप में String जोड़ें और fetchall() से परिणाम देखें।
output = conn.execute("SELECT * FROM Student")
print(output.fetchall())आउटपुट:
[(1, 'Matthew', 'English', 1), (2, 'Nisha', 'Science', 0), (3, 'Natasha', 'Math', 1), (4, 'Ben', 'English', 0)]आप और भी जटिल SQL क्वेरी पास कर सकते हैं। हमारे मामले में, हम उन छात्रों के Name और Major कॉलम चुन रहे हैं जिन्होंने परीक्षा पास की है।
output = conn.execute("SELECT Name, Major FROM Student WHERE Pass = True")
print(output.fetchall())आउटपुट:
[('Matthew', 'English'), ('Natasha', 'Math')]SQLAlchemy API का उपयोग
पिछले खंडों में, हम सरल SQLAlchemy API/ऑब्जेक्ट्स का उपयोग कर रहे थे। आइए अधिक जटिल और बहु-चरणीय क्वेरी में उतरते हैं।
नीचे दिए गए उदाहरण में, हम वे सभी कॉलम चुनेंगे जहाँ छात्र का major English है।
query = Student.select().where(Student.columns.Major == 'English')
output = conn.execute(query)
print(output.fetchall())आउटपुट:
[(1, 'Matthew', 'English', True), (4, 'Ben', 'English', False)]आइए WHERE क्वेरी पर AND लॉजिक लागू करें।
हमारे मामले में, हम ऐसे छात्रों को ढूँढ रहे हैं जिनका major English है, और वे फेल हुए हैं।
नोट: not equal to ‘!=’ True का अर्थ False होता है।
query = Student.select().where(db.and_(Student.columns.Major == 'English', Student.columns.Pass != True))
output = conn.execute(query)
print(output.fetchall())केवल Ben ने English major के साथ परीक्षा में फेल किया है।
[(4, 'Ben', 'English', False)]इसी तरह की टेबल का उपयोग करके, हम नीचे दी गई तालिका के अनुसार सभी तरह के कमांड चला सकते हैं।
आप इन कमांड्स को कॉपी-पेस्ट करके स्वयं परिणाम जाँच सकते हैं। यदि दिए गए किसी भी कमांड में अटकें, तो DataLab वर्कबुक देखें।
|
Commands |
API |
|
in |
Student.select().where(Student.columns.Major.in_(['English','Math'])) |
|
and, or, not |
Student.select().where(db.or_(Student.columns.Major == 'English', Student.columns.Pass = True)) |
|
order by |
Student.select().order_by(db.desc(Student.columns.Name)) |
|
limit |
Student.select().limit(3) |
|
sum, avg, count, min, max |
db.select([db.func.sum(Student.columns.Id)]) |
|
group by |
db.select([db.func.sum(Student.columns.Id),Student.columns.Major]).group_by(Student.columns.Pass) |
|
distinct |
db.select([Student.columns.Major.distinct()]) |
अन्य फ़ंक्शनों और कमांड्स के बारे में जानने के लिए, आधिकारिक दस्तावेज़ SQL Statements and Expressions API देखें।
आउटपुट को Pandas DataFrame में बदलना
डेटा वैज्ञानिक और विश्लेषक pandas डेटा फ्रेम्स को पसंद करते हैं और उनके साथ काम करना चाहेंगे। इस भाग में, हम सीखेंगे कि SQLAlchemy क्वेरी परिणाम को pandas डेटा फ्रेम में कैसे बदला जाए।
पहले, क्वेरी निष्पादित करें और परिणाम सहेजें।
query = Student.select().where(Student.columns.Major.in_(['English','Math']))
output = conn.execute(query)
results = output.fetchall()फिर, DataFrame() फ़ंक्शन का उपयोग करें और SQL परिणाम आर्ग्युमेंट के रूप में दें। अंत में, पहली पंक्ति results[0] और .keys() का उपयोग करके कॉलम नाम जोड़ें।
नोट: आप कॉलम के नाम निकालने के लिए keys() के साथ कोई भी मान्य पंक्ति दे सकते हैं।
data = pd.DataFrame(results)
data.columns = results[0].keys()
data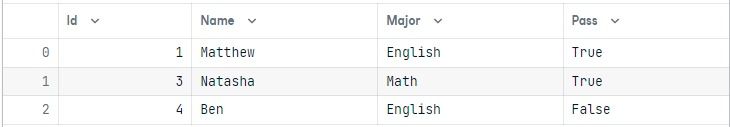
SQLAlchemy के साथ डेटा एनालिटिक्स
इस भाग में, हम European football डेटाबेस से कनेक्ट करेंगे, जटिल क्वेरी चलाएँगे, और परिणामों का विज़ुअलाइज़ेशन करेंगे।
दो टेबल जोड़ना
हम सामान्य रूप से create_engine() और connect() फ़ंक्शनों का उपयोग करके डेटाबेस से कनेक्ट करेंगे।
हमारे मामले में, हम दो टेबल जोड़ रहे हैं, इसलिए हमें दो टेबल ऑब्जेक्ट बनाने होंगे: division और match।
engine = create_engine("sqlite:///european_database.sqlite")
conn = engine.connect()
metadata = db.MetaData()
division = db.Table('divisions', metadata, autoload=True, autoload_with=engine)
match = db.Table('matchs', metadata, autoload=True, autoload_with=engine)जटिल क्वेरी चलाना
- हम division और match दोनों के कॉलम चुनेंगे।
- उन्हें एक सामान्य कॉलम से जोड़ेंगे: division.division और match.Div।
- वे सभी कॉलम चुनेंगे जहाँ division E1 है और season 2009 है।
- परिणाम को HomeTeam के आधार पर क्रमबद्ध करेंगे।
आप अतिरिक्त मॉड्यूल जोड़कर और भी जटिल क्वेरी बना सकते हैं।
नोट: दो टेबल को ऑटो-जॉइन करने के लिए आप यह भी उपयोग कर सकते हैं: db.select([division.columns.division,match.columns.Div])।
query = db.select([division,match]).\
select_from(division.join(match,division.columns.division == match.columns.Div)).\
where(db.and_(division.columns.division == "E1", match.columns.season == 2009 )).\
order_by(match.columns.HomeTeam)
output = conn.execute(query)
results = output.fetchall()
data = pd.DataFrame(results)
data.columns = results[0].keys()
data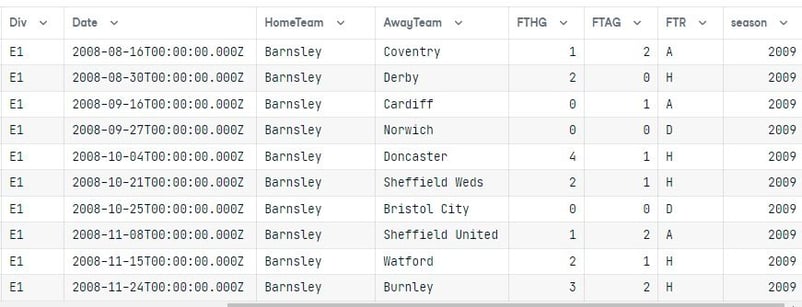
क्वेरी निष्पादित करने के बाद, हमने परिणाम को pandas डेटा फ्रेम में बदला।
दोनों टेबल जुड़ गई हैं, और परिणाम केवल 2009 सीज़न के लिए E1 division दिखाते हैं, जो HomeTeam कॉलम के अनुसार क्रमबद्ध हैं।
डेटा विज़ुअलाइज़ेशन
अब जब हमारे पास डेटा फ्रेम है, तो हम Seaborn का उपयोग करके बार चार्ट के रूप में परिणामों का विज़ुअलाइज़ेशन कर सकते हैं।
हम यह करेंगे:
- थीम को “whitegrid” पर सेट करें
- विज़ुअलाइज़ेशन का आकार 15X6 करें
- x-अक्ष के टिक 90 पर घुमाएँ
- रंग पैलेट “pastels” पर सेट करें
- "HomeTeam" बनाम "FTHG" का नीले रंग से बार चार्ट प्लॉट करें।
- "HomeTeam" बनाम "FTAG" का लाल रंग से बार चार्ट प्लॉट करें।
- लीजेंड को ऊपर-बाएँ प्रदर्शित करें।
- x और y लेबल हटाएँ।
- बाएँ और नीचे से स्पाइन हटाएँ।
इस भाग का मुख्य उद्देश्य यह दिखाना है कि आप SQL क्वेरी के आउटपुट का उपयोग करके शानदार डेटा विज़ुअलाइज़ेशन कैसे बना सकते हैं।
import seaborn as sns
import matplotlib.pyplot as plt
sns.set_theme(style="whitegrid")
f, ax = plt.subplots(figsize=(15, 6))
plt.xticks(rotation=90)
sns.set_color_codes("pastel")
sns.barplot(x="HomeTeam", y="FTHG", data=data,
label="Home Team Goals", color="b")
sns.barplot(x="HomeTeam", y="FTAG", data=data,
label="Away Team Goals", color="r")
ax.legend(ncol=2, loc="upper left", frameon=True)
ax.set(ylabel="", xlabel="")
sns.despine(left=True, bottom=True)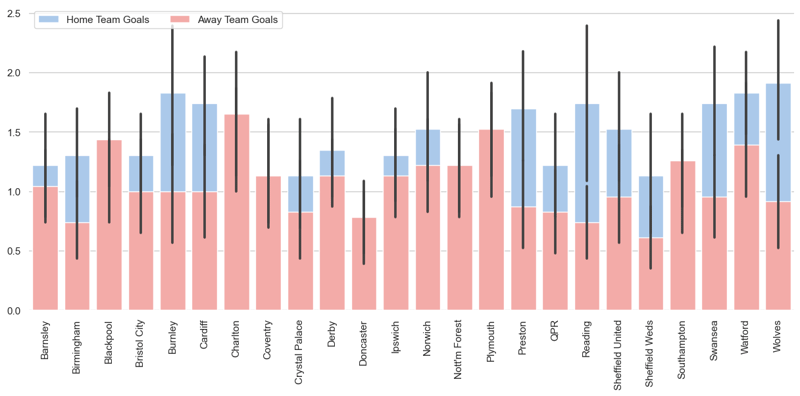
परिणामों को CSV में सहेजना
क्वेरी परिणाम को pandas डेटा फ्रेम में बदलने के बाद, आप फ़ाइल नाम के साथ .to_csv() फ़ंक्शन का सरलता से उपयोग कर सकते हैं।
output = conn.execute("SELECT * FROM matchs WHERE HomeTeam LIKE 'Norwich'")
results = output.fetchall()
data = pd.DataFrame(results)
data.columns = results[0].keys()`index=False` का उपयोग करके “Index” नाम का कॉलम जोड़ने से बचें।
data.to_csv("SQl_result.csv",index=False)CSV फ़ाइल को SQL टेबल में बदलना
इस भाग में, हम Stock Exchange Data CSV फ़ाइल को SQL टेबल में बदलेंगे।
सबसे पहले, datacamp sqlite डेटाबेस से कनेक्ट करें।
engine = create_engine("sqlite:///datacamp.sqlite")फिर, read_csv() फ़ंक्शन का उपयोग करके CSV फ़ाइल इम्पोर्ट करें। अंत में, to_sql() फ़ंक्शन का उपयोग करके pandas डेटा फ्रेम को SQL टेबल के रूप में सहेजें।
मुख्य रूप से, to_sql() फ़ंक्शन को आर्ग्युमेंट के रूप में कनेक्शन और टेबल नाम चाहिए। आप if_exisits का उपयोग उसी नाम की मौजूदा टेबल को बदलने के लिए और index का उपयोग इंडेक्स कॉलम हटाने के लिए कर सकते हैं।
df = pd.read_csv('Stock Exchange Data.csv')
df.to_sql(con=engine, name="Stock_price", if_exists='replace', index=False)
>>> 2222परिणाम मान्य करने के लिए, हमें डेटाबेस से कनेक्ट होना होगा और एक टेबल ऑब्जेक्ट बनाना होगा।
conn = engine.connect()
metadata = db.MetaData()
stock = db.Table('Stock_price', metadata, autoload=True, autoload_with=engine)फिर, क्वेरी निष्पादित करें और परिणाम दिखाएँ।
query = stock.select()
exe = conn.execute(query)
result = exe.fetchmany(5)
for r in result:
print(r)जैसा कि आप देख सकते हैं, हमने CSV फ़ाइल के सभी मान सफलतापूर्वक SQL टेबल में स्थानांतरित कर दिए हैं।
('HSI', '1986-12-31', 2568.300049, 2568.300049, 2568.300049, 2568.300049, 2568.300049, 0, 333.87900637)
('HSI', '1987-01-02', 2540.100098, 2540.100098, 2540.100098, 2540.100098, 2540.100098, 0, 330.21301274)
('HSI', '1987-01-05', 2552.399902, 2552.399902, 2552.399902, 2552.399902, 2552.399902, 0, 331.81198726)
('HSI', '1987-01-06', 2583.899902, 2583.899902, 2583.899902, 2583.899902, 2583.899902, 0, 335.90698726)
('HSI', '1987-01-07', 2607.100098, 2607.100098, 2607.100098, 2607.100098, 2607.100098, 0, 338.92301274)SQL टेबल प्रबंधन
टेबल में मान अपडेट करना
मान अपडेट करना सरल है। हम टेबल में किसी विशिष्ट मान को बदलने के लिए update, values, और where फ़ंक्शनों का उपयोग करेंगे।
table.update().values(column_1=1, column_2=4,...).where(table.columns.column_5 >= 5)हमारे मामले में, हमने उस पंक्ति में Pass का मान False से True कर दिया है जहाँ छात्र का नाम Nisha है।
Student = db.Table('Student', metadata, autoload=True, autoload_with=engine)
query = Student.update().values(Pass = True).where(Student.columns.Name == "Nisha")
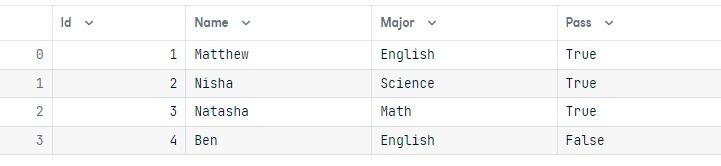
results = conn.execute(query)परिणाम मान्य करने के लिए, एक सरल क्वेरी चलाते हैं और pandas डेटा फ्रेम के रूप में परिणाम दिखाते हैं।
output = conn.execute(Student.select()).fetchall()
data = pd.DataFrame(output)
data.columns = output[0].keys()
dataहमने Nisha नाम की छात्रा के लिए Pass का मान सफलतापूर्वक True कर दिया है।
रिकॉर्ड मिटाना
पंक्तियाँ मिटाना अपडेट करने जैसा ही है। इसमें delete() और where() फ़ंक्शनों की आवश्यकता होती है।
table.delete().where(table.columns.column_1 == 6)हमारे मामले में, हम Ben नाम वाले छात्र का रिकॉर्ड मिटा रहे हैं।
Student = db.Table('Student', metadata, autoload=True, autoload_with=engine)
query = Student.delete().where(Student.columns.Name == "Ben")
results = conn.execute(query)परिणाम मान्य करने के लिए, हम एक त्वरित क्वेरी चलाएँगे और परिणामों को डेटा फ्रेम के रूप में दिखाएँगे। जैसा कि आप देख सकते हैं, हमने Ben नाम वाले छात्र वाली पंक्ति हटा दी है।
output = conn.execute(Student.select()).fetchall()
data = pd.DataFrame(output)
data.columns = output[0].keys()
data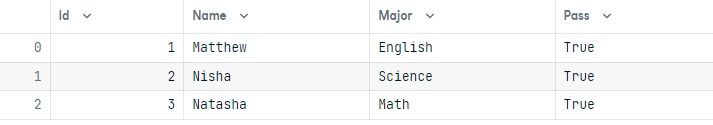
टेबल्स ड्रॉप करना
यदि आप SQLite उपयोग कर रहे हैं, तो टेबल ड्रॉप करने पर database is locked त्रुटि आएगी। क्यों? क्योंकि SQLite बहुत हल्का संस्करण है। यह एक समय में केवल एक ही फ़ंक्शन चला सकता है। वर्तमान में, यह एक select क्वेरी चला रहा है। टेबल हटाने से पहले हमें संपूर्ण निष्पादन बंद करना होगा।
results.close()
exe.close()उसके बाद, मेटाडेटा के drop_all() फ़ंक्शन का उपयोग करें और सिंगल टेबल ड्रॉप करने के लिए टेबल ऑब्जेक्ट चुनें। आप एकल टेबल ड्रॉप करने के लिए Student.drop(engine) कमांड का भी उपयोग कर सकते हैं।
metadata.drop_all(engine, [Student], checkfirst=True)यदि आप drop_all() फ़ंक्शन के लिए कोई टेबल निर्दिष्ट नहीं करते हैं, तो यह डेटाबेस की सभी टेबल्स ड्रॉप कर देगा।
metadata.drop_all(engine)निष्कर्ष
यह SQLAlchemy ट्यूटोरियल, डेटाबेस से कनेक्ट करने से लेकर टेबल्स में बदलाव तक, SQLAlchemy के विभिन्न फ़ंक्शनों को कवर करता है, और यदि आप और सीखने में रुचि रखते हैं, तो Introduction to Databases in Python इंटरएक्टिव कोर्स पूरा करने की कोशिश करें। आप रिलेशनल डेटाबेस की बुनियाद, फ़िल्टरिंग, ऑर्डरिंग, और ग्रुपिंग के बारे में सीखेंगे। इसके अलावा, आप डेटा मैनिपुलेशन के लिए उन्नत SQLAlchemy फ़ंक्शनों के बारे में भी जानेंगे।
यदि आपको ट्यूटोरियल का पालन करने में कोई समस्या आ रही है, तो DataLab वर्कबुक पर जाएँ और अपना कोड उससे तुलना करें। आप वर्कबुक की एक कॉपी बनाकर उसे सीधे DataLab में चला भी सकते हैं।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
यह लेख आपको SQLAlchemy से परिचित कराएगा—Python के लिए एक SQL टूलकिट जो क्वेरी चलाने, डेटाबेस बनाने और प्रबंधित करने जैसे कार्यों को सरल बनाता है।
यह ट्यूटोरियल पढ़ने के बाद, अधिक अभ्यास के लिए मैं आपको हमारे Introduction to Databases in Python कोर्स में नामांकन करने के लिए प्रोत्साहित करता/करती हूँ। मुख्य आकर्षणों में हैंड्स-ऑन प्रोजेक्ट शामिल हैं, जो आपको डेटा को फ़िल्टर और समूहित करने, उन्नत SQLAlchemy क्वेरी लिखने, और SQLite, MySQL, तथा PostgreSQL सहित प्रमुख डेटाबेस को क्वेरी करने, बनाने और उन पर लिखने की प्रक्रिया से मार्गदर्शन देते हैं।
SQLAlchemy क्या है?
SQLAlchemy Python का SQL टूलकिट है, जो डेवलपर्स को Pythonic डोमेन भाषा का उपयोग करके SQL डेटाबेस तक पहुँचने और उन्हें प्रबंधित करने देता है। आप क्वेरी को एक स्ट्रिंग के रूप में लिख सकते हैं या समान क्वेरी के लिए Python ऑब्जेक्ट्स को चेन कर सकते हैं। ऑब्जेक्ट्स के साथ काम करने से डेवलपर्स को लचीलापन मिलता है और उन्हें उच्च-प्रदर्शन वाले SQL-आधारित अनुप्रयोग बनाने में मदद मिलती है।
सरल शब्दों में, यह उपयोगकर्ताओं को Python भाषा के माध्यम से डेटाबेस से कनेक्ट करने, ऑब्जेक्ट-आधारित प्रोग्रामिंग का उपयोग करके SQL क्वेरी चलाने, और कार्यप्रवाह को सुव्यवस्थित करने की सुविधा देता है।